Apakah Ruang Kerja Riset AI Lebih Baik untuk Pemetaan Bukti Sistematis?
2026-08-22
Apa Perbedaan antara Status Proyek Persisten dan Pengambilan Potongan Sesuai Permintaan?
Untuk pemetaan bukti sistematis, ruang kerja riset yang memuat ulang keputusan, status, dan artefak pada awal setiap sesi merupakan lingkungan utama yang lebih baik dibandingkan peringkas satu makalah atau chatbot RAG yang hanya mengambil “potongan relevan” sesuai permintaan. Pemetaan adalah proyek pengodean longitudinal: aturan inklusi berubah, studi batasan dikodekan ulang, dan sintesis bergantung pada ingatan atas mengapa suatu sumber dibatasi minggu lalu. Alat tingkat makalah seperti Elicit, Consensus, dan NotebookLM tetap unggul untuk penemuan, ekstraksi, dan tanya jawab korpus tertutup. Ruang kerja persisten — termasuk Academic Research Assistant milik Jenova — lebih kuat ketika peta harus bertahan selama berminggu-minggu dalam perubahan protokol tanpa secara diam-diam menulis ulang keputusan kemarin.
Perbedaan yang penting pada 2026 bukanlah “model mana yang menulis abstrak lebih baik.” Yang penting adalah arsitektur memori mana yang mampu menampung peta bukti yang terus hidup.
Faktor utama yang membedakan infrastruktur pemetaan yang dapat digunakan dari chat makalah sekali pakai:
✅ Memori operasional vs. memori referensi — peta membutuhkan status proyek (kriteria, kode, eksklusi), bukan hanya kutipan yang diambil kembali ✅ Provenans keputusan — setiap keputusan inklusi/eksklusi harus tetap dapat diperiksa lintas sesi ✅ Ekstraksi terstruktur — kolom yang dapat dibandingkan lebih baik daripada ringkasan naratif satu kali ✅ Kepatuhan protokol dengan pengawasan manusia — lembaga bukti masih memperlakukan AI sebagai pelengkap, bukan pengganti peninjau ✅ Sintesis yang dapat diberi versi — laporan, gambar, dan daftar sumber harus terakumulasi alih-alih dibuat ulang dari nol
Untuk membandingkan alat-alat ini secara adil, pemetaan bukti perlu diperlakukan sebagai masalah kesinambungan empat lapisan, bukan kontes peringkasan.
Mengapa Pemetaan Bukti Sistematis Membebani Alat AI Satu Makalah?
Pemetaan bukti sistematis membebani peringkas satu makalah karena peta adalah inventaris terkode dari suatu literatur, bukan rangkaian catatan bacaan yang terisolasi. Systematic Evidence Maps (SEMs) adalah bentuk sintesis bukti yang mengategorikan dan mengorganisasi temuan ilmiah berdasarkan dimensi yang telah ditetapkan — populasi, paparan, luaran, metode, geografi, atau kesenjangan bukti — sehingga peninjau dapat melihat apa yang tersedia, di mana temuan terkonsentrasi, dan apa yang belum ada.
Alur kerja tersebut berbenturan dengan cara kerja sebagian besar produk riset LLM. Alat RAG atau “chat dengan PDF ini” menjawab pertanyaan saat ini dengan menarik potongan yang serupa secara lokal. Alat tersebut tidak secara otomatis memuat ulang kerangka pengodean Selasa lalu, tiga studi yang ditempatkan dalam kategori “mungkin”, atau keputusan bahwa model hewan berada di luar cakupan setelah protokol diperketat. Tinjauan pemetaan juga memerlukan proses penyaringan yang terdokumentasi berdasarkan kriteria inklusi dan eksklusi, yang merupakan tugas berbeda dari menghasilkan paragraf lancar tentang satu makalah (metodologi untuk tinjauan pemetaan).
Peninjauan manual masih cukup lambat sehingga jalan pintas terasa menggoda. Satu survei alat literatur tahun 2026 memperkirakan siklus tinjauan konvensional membutuhkan empat hingga enam minggu untuk penyaringan, ekstraksi, dan pembersihan sitasi. Penyaring AI khusus dapat mengurangi beban tersebut — sistem AIM Review melaporkan pengurangan beban kerja dari 20% hingga 95% pada enam tinjauan dunia nyata — tetapi kecepatan tidak menciptakan peta. Tanpa status proyek persisten, penyaringan yang lebih cepat hanya menghasilkan tumpukan ringkasan yang lebih besar dan terputus-putus.
Lembaga perpustakaan dan metodologi secara tegas menyatakan kesenjangan yang masih ada. Panduan sintesis bukti King’s College London menyatakan bahwa alat AI tidak dapat menggantikan metode pencarian, penyaringan, dan ekstraksi tradisional dan hanya boleh digunakan dengan pemahaman yang jelas mengenai bias, batas hak cipta, serta risiko halusinasi. Tinjauan sistematis tahun 2025 tentang AI generatif dalam sintesis bukti mencapai kesimpulan operasional yang sama: bukti saat ini tidak mendukung penggunaan GenAI tanpa keterlibatan atau pengawasan manusia.
Apa yang Harus Dicari dalam Alur Kerja Pemetaan Bukti Berbasis AI?
Anda sebaiknya mengevaluasi alat pemetaan AI dengan uji kesinambungan, bukan uji kualitas tulisan. Kami menggunakan tumpukan empat lapisan — sebut saja tumpukan CODE — karena setiap lapisan gagal dengan cara yang berbeda dan dapat diprediksi ketika tim mencoba mengubah chat makalah menjadi peta sistematis.
C — Coverage (Cakupan). Apakah alat dapat mencari korpus ilmiah yang nyata, atau hanya file yang sudah Anda unggah? Elicit mencari lebih dari 138 juta makalah dan 545.000 uji klinis. NotebookLM, berdasarkan desainnya, menjawab dari sumber dalam notebook. Kesalahan cakupan pada lapisan ini menjadi baris yang hilang dalam peta, bukan sekadar paragraf yang tipis.
O — Operationalization (Operasionalisasi). Apakah kriteria inklusi, dimensi pengodean, dan kolom ekstraksi dapat dinyatakan sekali lalu diterapkan kembali? Peringkas yang menafsirkan ulang “relevan” pada setiap prompt akan mengodekan uji batasan yang sama secara berbeda pada hari ketiga. Panduan pemetaan memperlakukan kriteria yang telah ditetapkan sebelumnya sebagai sesuatu yang wajib (metode tinjauan pemetaan).
D — Decision provenance (Provenans keputusan). Dapatkah Anda memulihkan alasan suatu studi diikutkan, dikecualikan, diparkir, atau dibatasi? Kelompok yang selaras dengan Cochrane, termasuk upaya Responsible AI in Evidence Synthesis (RAISE) bersama Cochrane, Campbell, dan JBI, memperlakukan transparansi sebagai persyaratan kualitas, bukan sekadar nilai tambah.
E — Extractability (Kemampuan ekstraksi). Dapatkah temuan ditempatkan dalam sel yang dapat dibandingkan — sampel, desain, arah efek, keterbatasan — alih-alih dalam prosa yang tidak dapat direkonsiliasi? Desain produk Elicit dibangun di sekitar tabel interaktif dan ekstraksi multi-tahap. Consensus lebih cepat untuk arah bukti pada tingkat hipotesis, tetapi tidak dirancang untuk penulisan tinjauan terstruktur.
Berikan bobot pada setiap lapisan berdasarkan tujuan. Penelusuran scoping dapat mentoleransi provenans yang lebih lemah. Peta bukti hidup yang akan disitasi, diperbarui, atau diserahkan kepada rekan penulis tidak bisa. Alat yang unggul dalam Cakupan dan Kemampuan ekstraksi tetap gagal untuk peta jika Operasionalisasi dan Provenans keputusan diatur ulang setiap sesi.
Bagaimana Perbandingan Elicit, Consensus, NotebookLM, dan Ruang Kerja Riset?
Elicit dan Consensus adalah lapisan penemuan serta ekstraksi makalah terkuat dalam kategori ini, NotebookLM adalah notebook korpus tertutup terkuat, dan ruang kerja riset persisten adalah lingkungan terkuat untuk menjaga peta multi-minggu tetap koheren. Tidak ada satu produk yang menang di setiap lapisan CODE, sehingga tim pemetaan yang serius biasanya memasangkan alat korpus dengan lingkungan memori proyek alih-alih mengharapkan satu chatbot menangani seluruh tinjauan.
Pada 2026, ringkasan fitur dan harga yang dipublikasikan terlihat seperti berikut:
| Fitur / Dimensi | Elicit | NotebookLM | Consensus | Ruang kerja riset Jenova |
|---|---|---|---|---|
| Model memori | Pustaka sumber tersimpan ditambah penyesuaian per laporan; bukan wadah status proyek lengkap | Kumpulan sumber dalam lingkup notebook; jawaban tetap berada dalam materi yang diunggah | Memori pertanyaan/daftar seputar kueri hipotesis | Memori persisten lintas sesi; konteks proyek dapat dimuat ulang, bukan diambil ulang |
| Cakupan | 138 juta+ makalah, 545 ribu uji | Hanya korpus yang diunggah; 50 sumber gratis, 300 di Plus | 200 juta+ makalah, tag arah bukti | Pencarian web langsung dan ilmiah ditambah basis pengetahuan terlampir; bukan indeks penerbit tetap |
| Ekstraksi terstruktur | Tabel, penyaringan, titik data dalam skala besar (hingga 1.000 makalah / 20.000 titik data) | Tanya jawab dan kerangka yang terhubung ke sumber, bukan grid ekstraksi SR | Consensus Meter dan jawaban bukti singkat | Laporan sintesis dan ringkasan berbasis sitasi melalui Deep Research; lebih lemah sebagai penyaring ganda khusus |
| Persistensi keputusan | Sumber dapat disimpan dalam pustaka; status protokol bukan fitur utama | Mempertahankan file notebook, bukan logika inklusi/eksklusi yang dikodekan | Bookmark dan daftar pada tingkat berbayar | Riwayat percakapan, memori, dan file proyek terlampir bertahan lintas sesi |
| Harga (per 2026) | Plus mulai sekitar $12/bulan | Gratis; Plus melalui Google AI Pro sekitar $19,99/bulan | Premium sekitar $10/bulan | Tingkat gratis dengan penggunaan terbatas; Plus $20/bulan untuk penggunaan 30× |
| Paling cocok untuk | Penyaringan volume tinggi dan tabel ekstraksi | Kumpulan pengajaran dan PDF yang sudah dikumpulkan | Pemeriksaan cepat “apakah literatur mendukung X?” | Peta hidup, pengodean multi-sesi, dan integrasi manuskrip |
Elicit adalah spesialis yang jujur untuk penyaringan bergaya sistematis. Elicit dapat mengotomatiskan penyaringan dan ekstraksi serta melaporkan penghematan waktu hingga 80% pada tahap tersebut. Perbandingan metode Cochrane masih menemukan bahwa sensitivitas pencarian Elicit belum cukup tinggi untuk menggantikan pencarian literatur tradisional, sehingga alat ini paling baik berfungsi sebagai pelengkap berpresisi tinggi. Elicit juga cenderung berhenti pada laporan dan tabel; pekerjaan penulisan, pemberian versi, serta manuskrip hidup biasanya berpindah ke tempat lain.
NotebookLM adalah spesialis yang jujur untuk pembacaan berbasis bukti dari kumpulan tetap. Setiap jawaban dapat diperiksa terhadap kutipan, dan Google telah menambahkan Deep Research serta jenis file yang lebih luas. NotebookLM tidak dapat menemukan makalah yang belum Anda kumpulkan, dan tidak mengodekan log keputusan bergaya PRISMA.
Consensus adalah spesialis yang jujur untuk arah hipotesis. Meter dan penandaan dukungan/kontrasnya lebih cepat daripada membangun grid ekstraksi ketika Anda hanya perlu mengetahui kecenderungan arah literatur (perbandingan alat). Consensus merupakan sistem utama yang keliru untuk peta terkode.
Academic Research Assistant Jenova paling kuat ketika unit kerja adalah proyek, bukan PDF. Alat ini dapat mencari sumber ilmiah, menyimpan konteks manuskrip dan sitasi, serta — karena platform dasarnya menyimpan riwayat chat tanpa batas dan memori lintas sesi — melanjutkan kerangka pengodean tanpa menempelkan kembali protokol. Ini bukan platform penyaringan peninjau ganda yang tervalidasi seperti Covidence atau Rayyan, dan tidak memublikasikan angka akurasi ekstraksi bergaya Elicit. Tim yang membutuhkan jejak audit setara regulasi tetap perlu menyimpan penyaring khusus dalam tumpukan mereka.
SciSpace dan Scite mengisi pekerjaan berdekatan yang lebih sempit. SciSpace berulang kali digambarkan sebagai lingkungan yang lebih baik untuk analisis mendalam makalah per makalah, dengan korpus yang sangat besar tetapi alur kerja tinjauan yang kurang terpadu. 1,6 miliar Smart Citations milik Scite yang diklasifikasikan sebagai mendukung, mengontraskan, atau menyebut suatu klaim tidak tertandingi untuk audit konteks sitasi, dan hampir tidak berguna sebagai basis data penemuan atau pemetaan jika berdiri sendiri.
Bagaimana Memori Operasional Mengubah Sintesis Literatur Multi-Sesi?
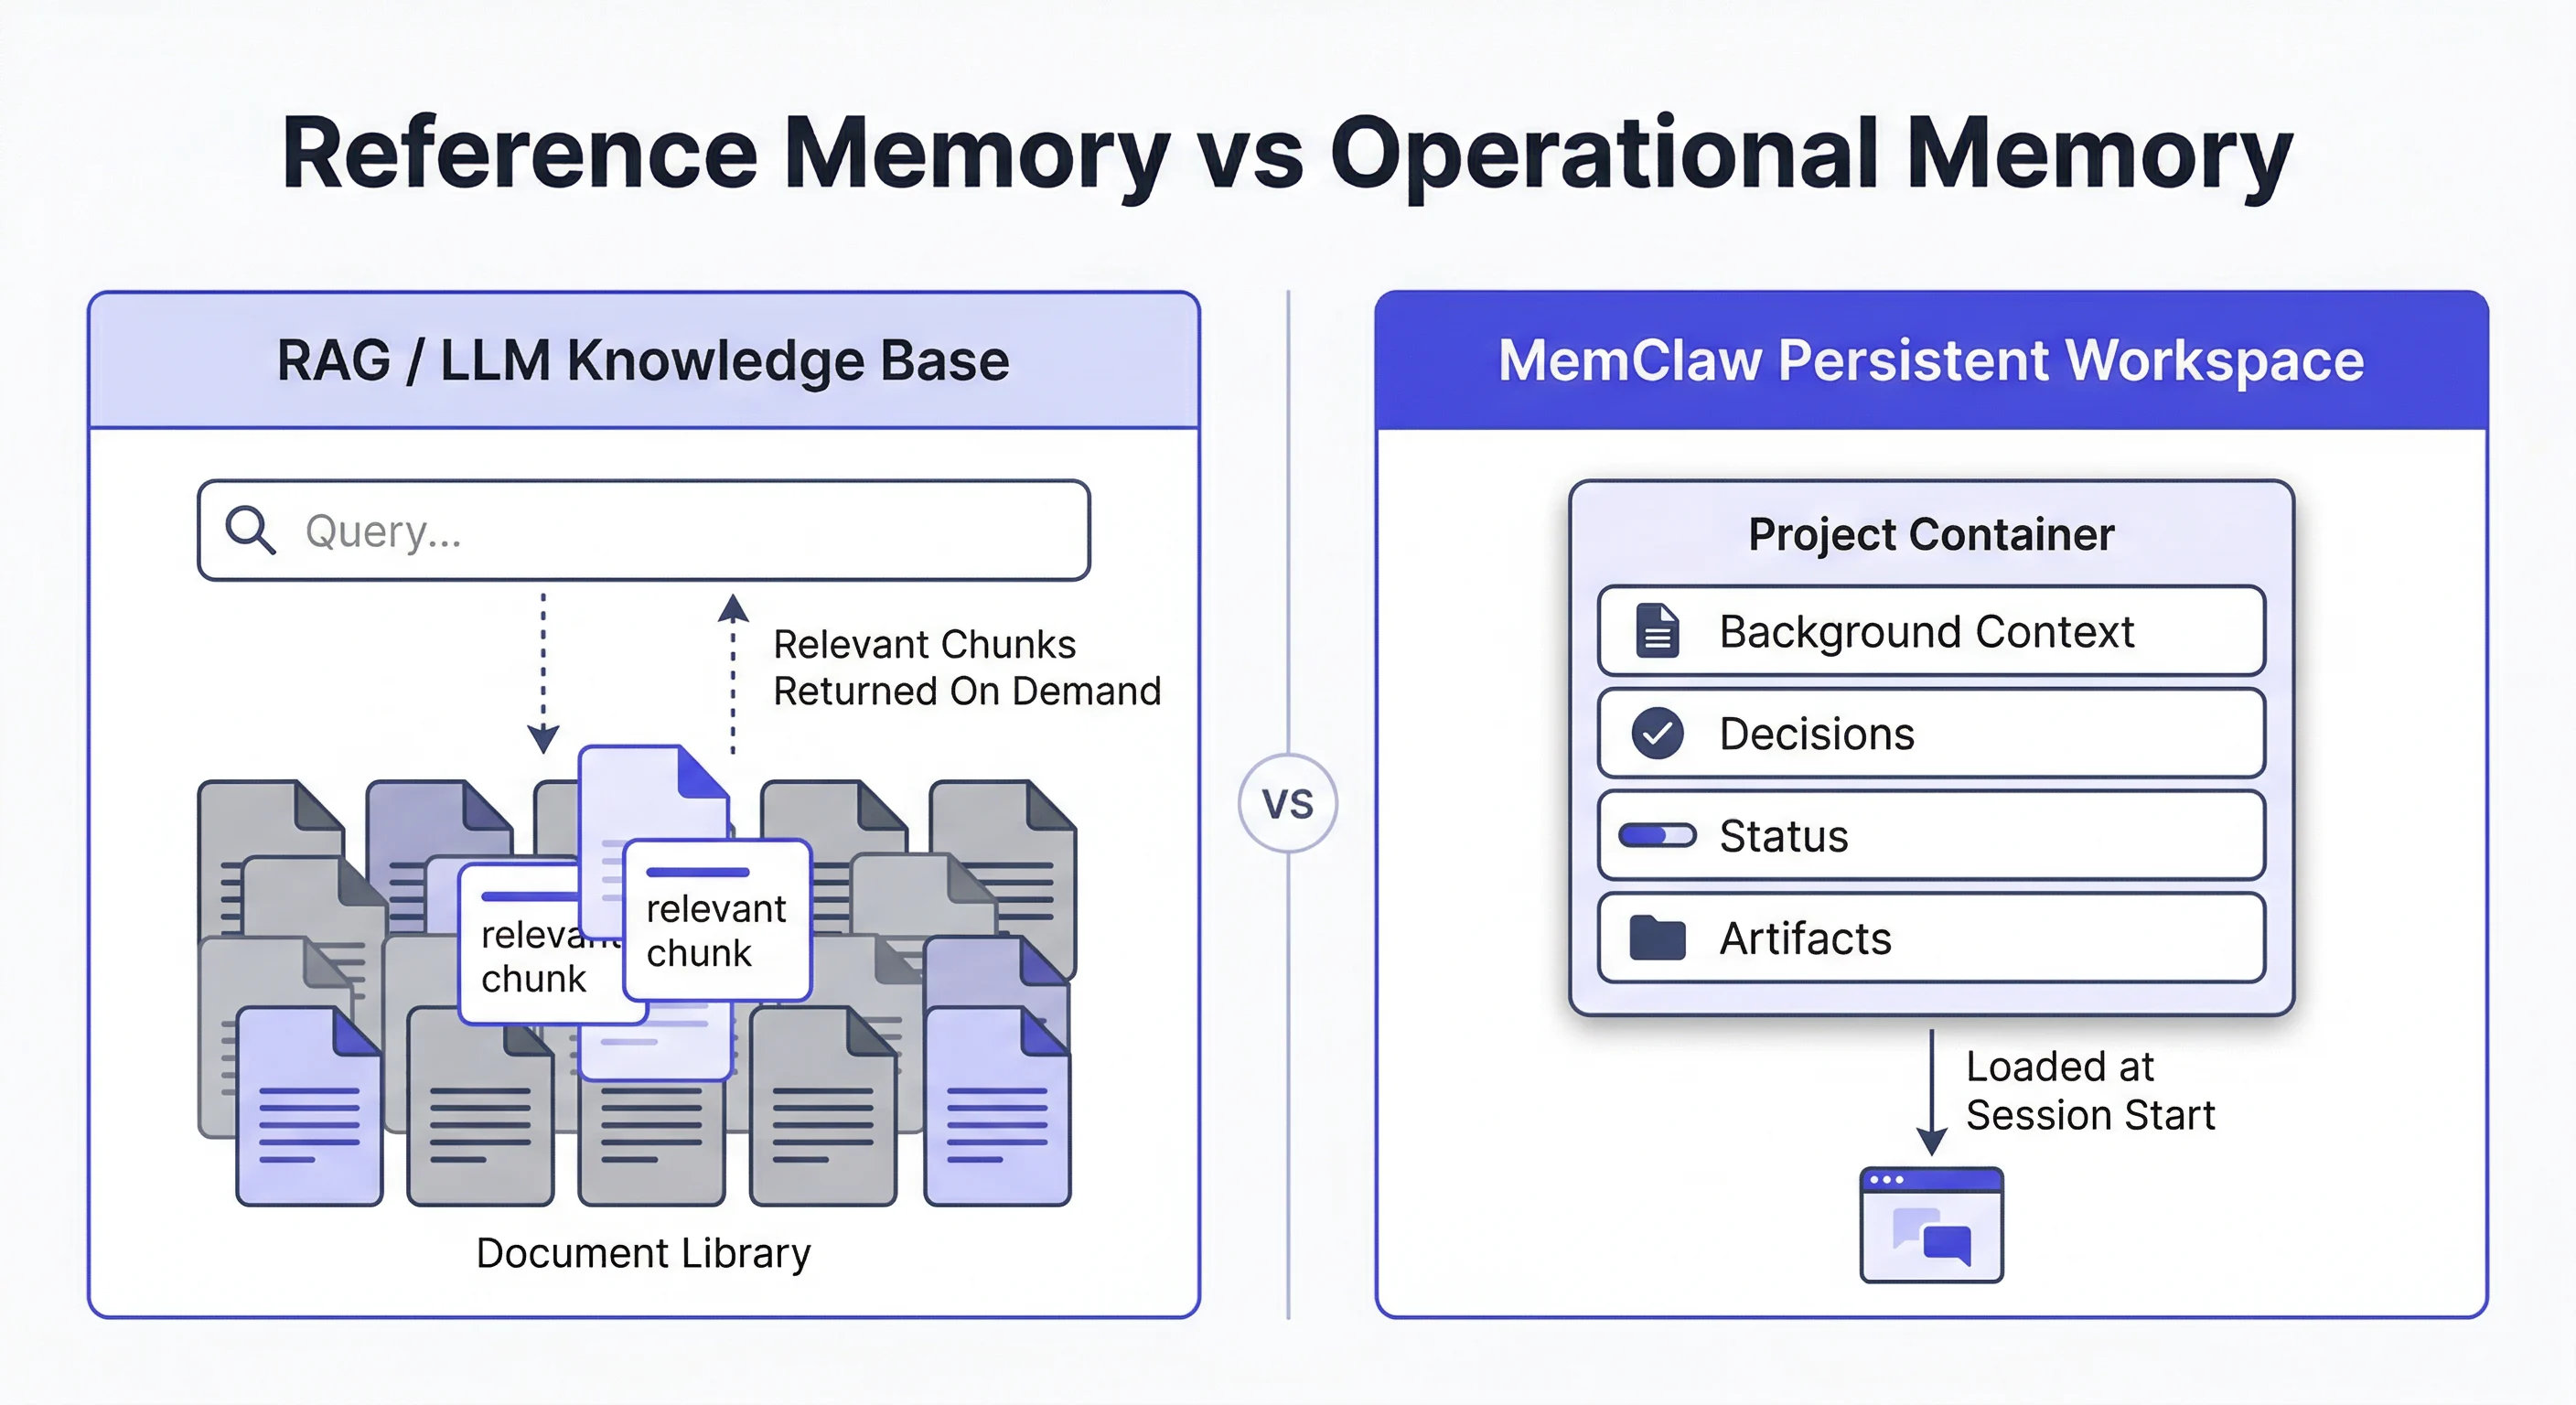
Memori operasional mengubah sintesis karena memperlakukan wadah proyek — latar belakang, keputusan, status, artefak — sebagai objek yang dimuat pada awal sesi, alih-alih memperlakukan literatur sebagai tumpukan jerami yang harus dikueri ulang. Memori referensi bertanya, “Potongan mana yang tampak seperti pertanyaan ini?” Memori operasional bertanya, “Apa yang sudah benar mengenai proyek ini, dan apa yang masih membutuhkan bukti?”
Perbedaan itu tampak dalam tiga mode kegagalan yang disembunyikan dengan baik oleh peringkas:
- Pergeseran kriteria. Jika “hanya RCT manusia dewasa” berada dalam prompt, bukan dalam status proyek, sesi berikutnya yang mengajukan pertanyaan sedikit lebih luas akan secara diam-diam memasukkan kembali studi pediatrik yang telah Anda tolak.
- Kategori mungkin yang terlantar. Makalah batasan yang diparkir untuk didiskusikan dengan rekan penulis akan hilang kecuali status menjadi kolom utama.
- Sintesis yang dibuat ulang. Jawaban RAG dapat setia secara lokal terhadap potongan yang diambil hari ini, tetapi tetap bertentangan dengan tabel kesenjangan minggu lalu, karena tidak ada yang memaksa jawaban baru mewarisi pengodean lama.
Ruang kerja persisten membalik urutan pemuatan. Konteks latar belakang, keputusan, status, dan artefak masuk sebelum kueri berikutnya. Implementasi pola ini pada platform Jenova adalah memori lintas sesi ditambah basis pengetahuan yang dapat dilampirkan: asisten dapat mengingat dimensi pemetaan, definisi kerja kesenjangan bukti, dan klaim mana yang telah memiliki dukungan cukup. Pengujian terhadap alat bergaya notebook memperlihatkan pertukaran yang jelas. Korpus tertutup NotebookLM lebih aman terhadap penemuan di luar sumber (jawaban yang terhubung ke sumber). Ruang kerja terbuka persisten lebih berguna ketika korpus masih bertumbuh dan kerangka pengodean adalah aset yang langka.
Implikasi praktis untuk SEMs sederhana. Jika luaran Anda adalah pengarahan sekali duduk tentang 15 PDF, memori operasional bersifat opsional. Jika luaran Anda adalah peta kesenjangan yang akan diperbarui setelah siklus konferensi berikutnya, memori operasional adalah produknya.
Seperti Apa Sebenarnya Pipeline Bukti Agentik Ujung ke Ujung?
Pipeline pemetaan ujung ke ujung tampak seperti sprint riset bertahap dengan gerbang, bukan seperti satu prompt “ringkas makalah-makalah ini”. Ilustrasi di bawah merupakan arsitektur referensi yang berguna: perumusan pertanyaan, triase literatur, identifikasi kandidat, formalisasi hipotesis, validasi multi-sumber, pelaporan berversi, dan paket yang dilacak dengan git.
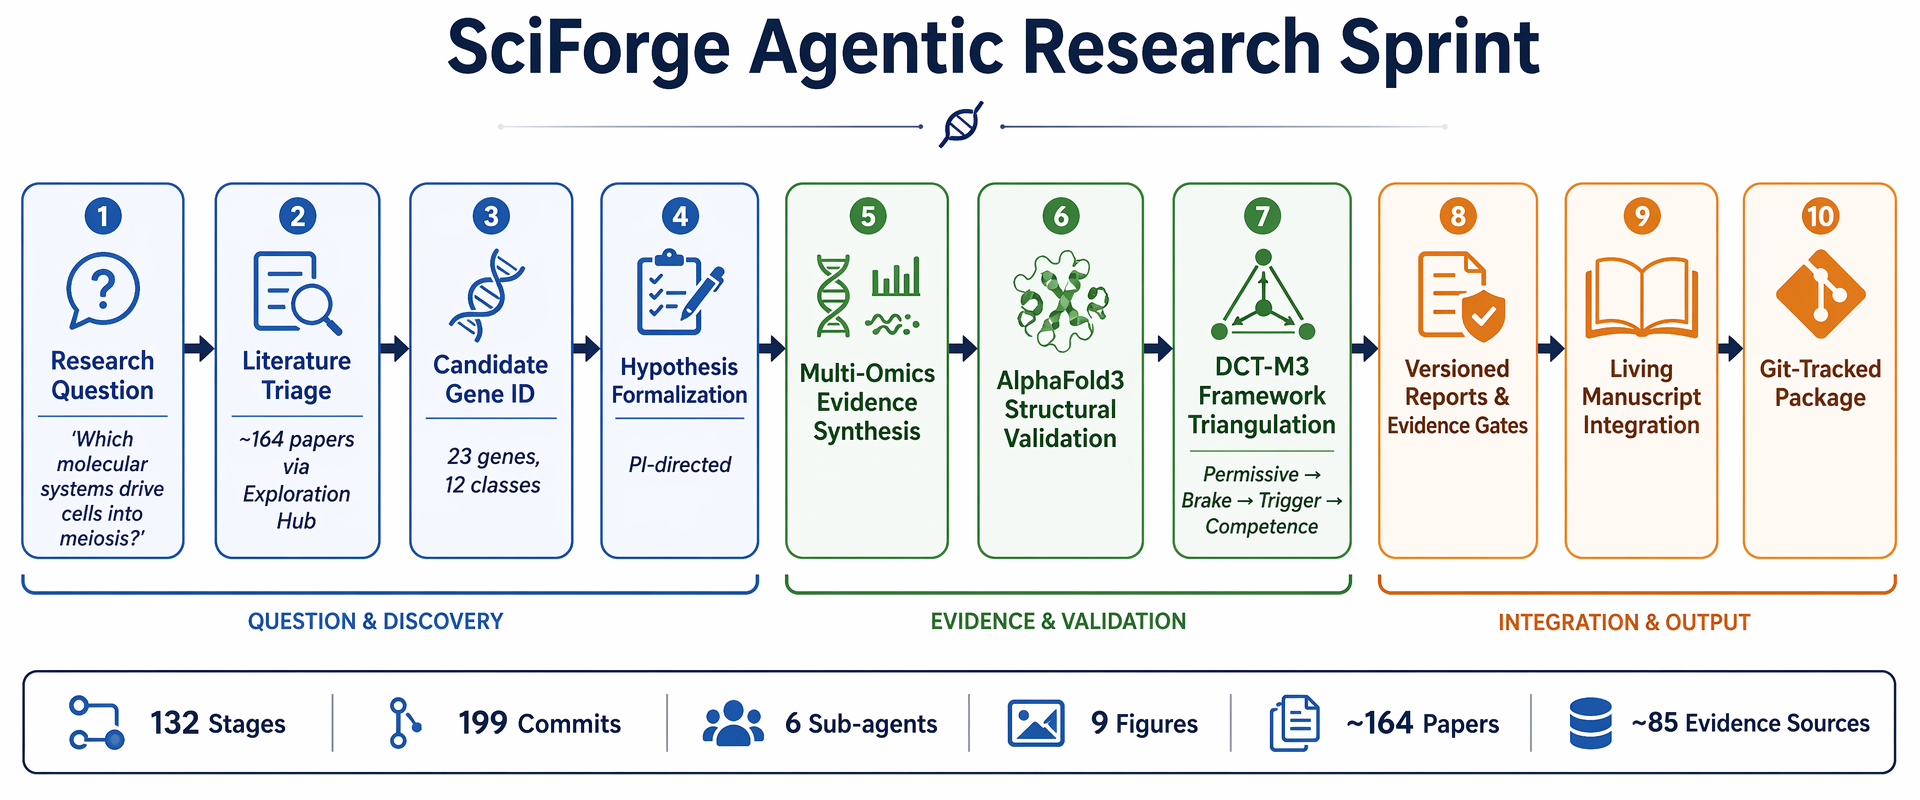
Contoh sprint tersebut sengaja dibuat besar — sekitar 164 makalah ditriase, 132 tahap, 199 commit, enam Agen, dan kira-kira 85 sumber bukti — karena pada skala inilah chat makalah runtuh. Peringkas dapat mendeskripsikan makalah ke-17. Peringkas tidak dapat menjaga rantai 10 tahap tetap koheren ketika tahap 4 mengubah aturan inklusi yang telah diterapkan tahap 2.
Tiga pilihan desain dalam pipeline tersebut lebih penting daripada detail domainnya:
- Penemuan adalah fase, bukan produk. Triase literatur memberi masukan ID kandidat dan hipotesis formal. Berhenti pada ringkasan berarti membiarkan peta tidak terbangun.
- Validasi bersifat multimodal. Sintesis bukti, pemeriksaan struktural atau kuantitatif, serta logika eksplisit “permisif → rem → pemicu” memaksa klaim melewati gerbang alih-alih meratakannya menjadi satu paragraf.
- Luaran diberi versi. Integrasi manuskrip hidup dan paket yang dilacak dengan git menjadikan peta sebagai artefak dengan riwayat. Ini berlawanan dengan transkrip chat yang tidak dapat Anda putar ulang.
Jenova dapat mendekati pola ini dengan membagi peran antar Agen alih-alih memaksa satu chat menjadi pustakawan, pengode, dan penulis. Academic Research Assistant menangani penemuan ilmiah dan konteks manuskrip. Deep Research menghasilkan sintesis berbasis sitasi dari banyak sumber. Real-Time Search berguna ketika peta juga harus mencakup preprint, repositori, atau literatur abu-abu nonjurnal. Keterbatasannya adalah disiplin orkestrasi: manusia tetap memiliki protokol, gerbang, dan keputusan untuk menaikkan suatu klaim ke dalam manuskrip hidup. Kelompok metodologi terus memperlakukan peran manusia itu sebagai sesuatu yang tidak dapat ditawar (panduan KCL / RAISE).
Platform tinjauan serba ada bergaya Paperguide berusaha merangkum rencana–cari–saring–ekstrak–hasilkan ke dalam satu alur kerja vendor, termasuk mode Extended yang menyaring 200 kandidat dan menulis dari 50 kandidat teratas. Ini lebih dekat ke ruang kerja dibandingkan Elicit-plus-Word, tetapi tetap membutuhkan log keputusan eksternal jika Anda peduli pada provenans setelah tinjauan yang dihasilkan diekspor.
Bagaimana Memaksimalkan Peta Bukti AI?
Anda mendapatkan hasil maksimal dari peta bukti AI dengan menuliskan protokol ke dalam ruang kerja sebelum meminta prosa, lalu memaksa setiap sesi berikutnya untuk mewarisi protokol tersebut. Penyiapannya serupa di berbagai alat; perbedaannya terletak pada apakah alat tersebut dapat mengingat penyiapan itu.
Untuk peta yang berpusat pada Jenova, urutan yang dapat diterapkan adalah:
- Buka Academic Research Assistant dan sebutkan nama proyek, populasi, serta dimensi pemetaan dalam pesan pertama.
- Sematkan protokol dalam bahasa yang dapat digunakan kembali oleh asisten:
“Bangun peta bukti sistematis tentang studi manusia dewasa mengenai X. Hanya sertakan RCT dan kohort prospektif. Kodekan setiap studi berdasarkan desain, sampel, intervensi, luaran utama, arah efek, dan keterbatasan. Tempatkan makalah hewan dan in-vitro dalam log eksklusi dengan alasan satu baris. Jangan buat ulang kode yang sudah diputuskan.”
- Jalankan Deep Research untuk penelusuran korpus pertama, lalu tempelkan atau lampirkan kembali tabel kerja ke thread proyek yang sama agar ekstraksi dan narasi berbagi satu memori.
- Setelah setiap sesi, mintalah tiga artefak, bukan satu esai: tabel studi yang diperbarui, log eksklusi, dan daftar kesenjangan. Tiga file tersebut adalah petanya.
Untuk Elicit, mulai dengan pertanyaan riset, buat tabel penyaringan, dan perlakukan pustaka sebagai sumber kebenaran (alur kerja tinjauan sistematis Elicit). Jangan melewatkan pencarian basis data konvensional. Studi kasus Cochrane menemukan Elicit berguna untuk pencarian awal berpresisi tinggi dan studi tambahan yang unik, bukan sebagai satu-satunya mesin pencari.
Untuk NotebookLM, kumpulkan PDF terlebih dahulu, tetap gunakan satu notebook, dan ajukan pertanyaan berdasarkan satu dimensi demi satu dimensi (“Daftarkan setiap studi yang melaporkan luaran Y beserta ukuran sampel dan masa tindak lanjut”) agar korpus tertutup tidak menyimpang. Batas unggahan — 50 sumber pada tingkat gratis, 300 di Plus — menjadikan ini alat yang keliru untuk peta berisi 400 catatan kecuali Anda melakukan prapenyaringan di tempat lain.
Dua aturan proses berlaku di setiap tumpukan. Pertama, jangan unggah PDF teks lengkap ke model konsumen jika ketentuan hak cipta melarangnya; pemegang hak umumnya melarang penggunaan tersebut. Kedua, pertahankan manusia pada posisi inklusi/eksklusi. Bantuan penyaringan adalah tugas AI dengan bukti pendukung paling banyak; sintesis tanpa pengawasan adalah tugas dengan bukti paling sedikit (tinjauan atas tinjauan tentang kesiapan AI).
Apa Pendapat Spesialis Sintesis Bukti tentang Pemetaan Berbantuan AI?
Para spesialis semakin menerima AI untuk penyaringan dan ekstraksi dengan pengawasan, tetapi mereka masih menolak AI sebagai kartografer bidang tanpa pengawasan. Konsensus ahli yang berguna pada 2026 lebih sempit daripada materi vendor: otomatisasikan lapisan repetitif, pertahankan lapisan keputusan, dan biarkan manusia bertanggung jawab atas peta.
“Mode kegagalan yang kami lihat bukanlah bahwa model tidak dapat meringkas makalah. Masalahnya adalah tim pemetaan memperlakukan ringkasan yang baik seolah-olah itu adalah catatan terkode. Peta bukti sistematis adalah sekumpulan keputusan yang dapat dibalik — masuk, keluar, diparkir, dibatasi — yang melekat pada kolom stabil. Jika keputusan-keputusan itu hanya tersimpan dalam prompt minggu lalu, peta tersebut sudah rusak, bahkan ketika setiap paragraf masih terdengar cermat.”
“Pengambilan referensi dan memori operasional menyelesaikan masalah yang berbeda. Pengambilan adalah cara menemukan kandidat bukti. Memori operasional adalah cara menghentikan pengodean ulang studi yang sama tiga kali. Alat yang sangat baik untuk pekerjaan pertama secara rutin digunakan seolah-olah melakukan pekerjaan kedua. Dari situlah muncul analisis kesenjangan yang lancar tetapi tidak dapat menjelaskan mengapa 12 uji batasan menghilang.”
“Aturan kerja kami sederhana. Gunakan mesin korpus untuk mengisi baris. Gunakan ruang kerja persisten untuk menjaga buku kode, log eksklusi, dan tabel kesenjangan tetap hidup. Gunakan peninjau manusia pada setiap gerbang yang mengubah makna peta. Apa pun yang dijual sebagai peta sistematis sekali klik meminta Anda melewati satu-satunya lapisan yang masih dianggap tidak dapat ditawar oleh kelompok metodologi.”
— Tim Produk Jenova, desain alur kerja riset, 8 tahun membangun sistem pengetahuan untuk kerja analitis multi-sesi
Sikap itu selaras dengan panduan formal. NICE, rekomendasi RAISE yang terhubung dengan Cochrane, dan layanan perpustakaan universitas semuanya menggambarkan AI sebagai pelengkap dalam metode yang sudah divalidasi. Sebuah panduan hidup tentang AI dalam pencarian dan penyaringan literatur menyampaikan alasan efisiensi yang sama — penyaringan mahal; otomatisasi membantu — tanpa mengklaim bahwa generasi dapat menggantikan protokol.
Kapan Peringkas Satu Makalah Tetap Menjadi Pilihan yang Tepat?
Peringkas satu makalah tetap merupakan pilihan tepat ketika korpus kecil, sudah dikumpulkan, dan tidak sedang dikodekan menjadi peta yang dapat digunakan kembali. Jika Anda memiliki 12 PDF, diskusi jurnal besok, dan tidak perlu memperbarui inventaris dalam tiga bulan, chat makalah bergaya NotebookLM atau SciSpace akan menyelesaikan pekerjaan dengan lebih sedikit kerumitan daripada wadah proyek.
Alat tersebut juga lebih cocok untuk tiga pekerjaan lain yang sering salah dilabeli sebagai pemetaan:
- Penjelasan mekanisme. “Jelaskan Figure 3” adalah tugas membaca. Notebook korpus tertutup dengan kutipan yang dapat diklik lebih aman daripada ruang kerja terbuka yang mungkin mencampurkan makalah.
- Pemeriksaan konteks sitasi. Jika pertanyaannya adalah apakah karya berikutnya mendukung atau mengontraskan suatu klaim, sitasi terklasifikasi Scite adalah lapisan yang dibuat khusus untuk itu (1,6 miliar+ Smart Citations).
- Pemeriksaan cepat hipotesis. Consensus tetap merupakan cara tercepat untuk melihat apakah suatu proposisi memiliki pemisahan dukungan/kontras yang terlihat sebelum Anda berinvestasi dalam peta (ikhtisar Elicit vs Consensus).
Kesalahannya adalah menggunakan kekuatan tersebut sebagai pengganti infrastruktur SEM. Peringkas dapat sangat baik secara lokal tetapi tetap menjadi sistem pencatatan yang keliru. Sebaliknya, ruang kerja persisten dapat menjaga buku kode yang berantakan tetap hidup tetapi masih merupakan alat yang keliru untuk penyaringan ganda 5.000 catatan jika Anda memerlukan perangkat lunak SR khusus. Panduan institusional masih mengarahkan tim ke platform penyaringan seperti Rayyan, Covidence, dan DistillerSR untuk tahap tersebut (panduan AI-untuk-SR CASRAI; panduan tinjauan sistematis Stony Brook).
Karena itu, aturan keputusan yang tetap bertahan dalam tinjauan nyata bersifat arsitektural, bukan berbasis merek. Jika produk kerja adalah sekumpulan keputusan pengodean yang dapat dibandingkan, diperbarui, dan dijelaskan, pilih ruang kerja riset dengan memori proyek dan tempatkan mesin korpus di sampingnya. Jika produk kerja adalah memahami makalah yang sudah ada di meja Anda, peringkas satu makalah bukan kompromi. Itulah alat dengan cakupan yang tepat.
Referensi
- ScienceDirect — Panduan melakukan peta bukti sistematis
- PubMed Central — Metodologi untuk tinjauan pemetaan, peta bukti, dan peta kesenjangan
- Paperguide — 7 Alat AI Terbaik untuk Tinjauan Literatur pada 2026
- King’s College London — Alat AI dalam sintesis bukti
- Elicit — AI untuk riset ilmiah
- NotebookLM — Alat riset AI dan mitra berpikir
- Google Blog — NotebookLM menambahkan Deep Research, DOCX, Sheets, dan lainnya
- The Drive AI — Elicit vs Consensus vs Semantic Scholar
- Omid Saffari — Alat Riset AI Terbaik 2026: Elicit vs Consensus
- Panduan Penggunaan AI dalam Pencarian dan Penyaringan Literatur
- CASRAI — Alat AI untuk Tinjauan Literatur Sistematis
- Perpustakaan Universitas Stony Brook — Panduan Tinjauan Sistematis: Kecerdasan Buatan