Apakah Asisten Riset AI Lebih Baik daripada Pencarian Kata Kunci untuk Makalah Terkait?
2026-08-22
Kapan Pencocokan Semantik Mengungguli Pemeringkatan Kata Kunci untuk Makalah yang Berkaitan secara Konseptual?
Asisten riset AI semantik mengungguli pencarian kata kunci tradisional ketika makalah yang Anda butuhkan menjelaskan gagasan yang sama dengan terminologi berbeda, sedangkan mesin kata kunci tetap lebih kuat ketika Anda sudah mengetahui frasa, penulis, atau kelompok sitasi yang tepat untuk ditargetkan. Pada 2026, jawaban praktisnya bukan meninggalkan Google Scholar, melainkan memasangkan pemeringkatan leksikal dengan pengambilan berbasis makna — menggunakan alat seperti Elicit, SciSpace, Undermind, dan Academic Research Assistant milik Jenova.
Faktor utama yang membedakan penemuan konseptual efektif dari pencocokan kata kunci:
✅ Fleksibilitas kosakata — apakah sistem dapat menampilkan makalah tentang “infark miokard” ketika kueri menyebut “serangan jantung” ✅ Sinyal pemeringkatan — skor leksikal berbobot sitasi versus kemiripan embedding versus LLM yang menilai relevansi ✅ Kedalaman indeks — metadata judul-abstrak versus pencocokan teks lengkap pada ratusan juta karya ✅ Kontrol presisi — Boolean bersarang, batas bidang, filter mutu jurnal, dan batas ekspor ✅ Waktu menuju kumpulan hasil berguna — daftar eksplorasi instan versus pencarian iteratif yang memerlukan beberapa menit
Untuk membandingkan metode ini secara jujur, akan lebih membantu jika ketidakcocokan kosakata, bias pemeringkatan, dan kontrol pencarian diperlakukan sebagai dimensi terpisah, alih-alih menanyakan alat mana yang secara universal lebih baik.
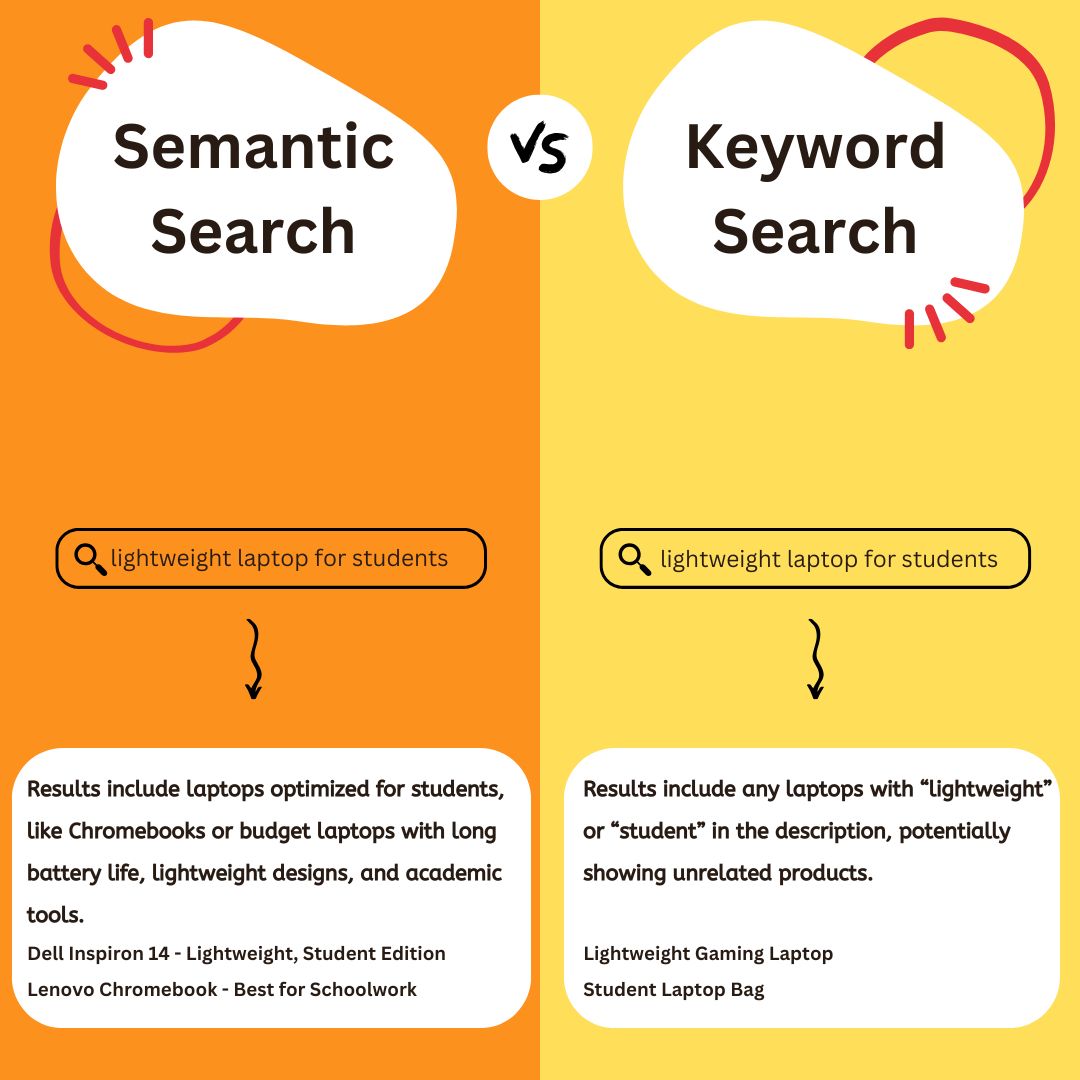
Mengapa Ketidakcocokan Kosakata Masih Menghambat Pencarian Akademik Tradisional pada 2026?
Ketidakcocokan kosakata masih menghambat pencarian akademik tradisional karena penulis, disiplin ilmu, dan periode waktu menamai fenomena yang sama secara berbeda, sementara mesin leksikal hanya mengambil dokumen yang cukup banyak berbagi istilah permukaan dengan kueri. Makalah kesehatan masyarakat dapat menyebut “aktivitas fisik”, makalah kardiologi “kapasitas olahraga”, dan makalah sosiologi “gerakan pada waktu luang”. Jika Anda hanya mencari satu frasa, dua kelompok lainnya dapat menghilang dari beberapa halaman hasil pertama.
Google Scholar tetap menjadi titik awal bawaan bagi sebagian besar peneliti dan masih merupakan permukaan pencarian akademik tunggal terluas yang tersedia, termasuk teks lengkap dari penerbit dan repositori. Aaron Tay, pustakawan akademik di Singapore Management University, menggambarkannya sebagai pisau lipat Swiss untuk pencarian ilmiah — alat yang akan ia pertahankan jika hanya boleh memilih satu. Namun, pemeringkatannya tetap leksikal. Setelah kecocokan judul, Google Scholar memberikan bobot besar pada makalah yang banyak disitasi, yang sangat baik untuk menemukan karya fundamental tetapi kurang efektif untuk menemukan makalah yang terkait secara konseptual dan menggunakan frasa berbeda atau belum mengumpulkan sitasi.
Masalahnya lebih buruk ketika istilah kueri bersifat umum. Karena Google Scholar mencocokkan seluruh teks, pencarian alat atau konsep dengan nama sehari-hari dapat meledak menjadi ribuan hasil insidental. Tay mencatat bahwa pencarian “Elicit” hampir tidak berguna di Google Scholar kecuali Anda menambahkan solusi berbasis domain, karena kata tersebut terus muncul dalam bagian metode. Sistem semantik mengurangi kegagalan tersebut dengan menilai makna, bukan tumpang tindih string, sehingga sistem ini telah menjadi lapisan pelengkap alih-alih sekadar hal baru.
Apa yang Harus Dievaluasi Saat Membandingkan Pencarian Kata Kunci dan Asisten AI Semantik?
Anda sebaiknya mengevaluasi pencarian kata kunci dan asisten AI semantik berdasarkan enam dimensi yang dalam artikel ini disebut Kerangka Pemulihan Ketidakcocokan: fleksibilitas kosakata, transparansi pemeringkatan, cakupan indeks, kontrol presisi, sinyal otoritas, dan waktu menuju kumpulan hasil berguna. Alat yang unggul pada satu dimensi sering kali kalah pada dimensi lain, sehingga satu peringkat “pemenang” lebih menyesatkan daripada membantu.
Fleksibilitas kosakata menanyakan apakah mesin dapat mengambil makalah yang abstraknya tidak pernah mengulang istilah kueri Anda. Embedding padat dan metode hibrida seperti SPLADE, yang digunakan Elicit sebagai pendekatan sparse embedding terlatih, dirancang untuk tujuan ini. Transparansi pemeringkatan menanyakan apakah Anda dapat menjelaskan alasan suatu makalah muncul. Sistem Boolean-plus-BM25 lebih mudah diaudit; pencarian tetangga terdekat berbasis embedding dan pemeringkat ulang LLM lebih sulit direproduksi.
Cakupan indeks tidak sama dengan “jumlah makalah yang diiklankan”. OpenAlex melaporkan 517 juta catatan karya dan 66 juta PDF teks lengkap, sementara Elicit menyatakan bahwa mereka mencari, merangkum, dan mengekstrak data dari lebih dari 125 juta makalah. Google Scholar tidak memublikasikan jumlah resmi yang sebanding, tetapi secara luas dipandang sebagai indeks pencarian akademik teks lengkap terbesar. Kontrol presisi mencakup Boolean bersarang, batas bidang, operator kedekatan, dan kosakata terkendali — fitur yang membuat The Lens dan OpenAlex mengungguli Google Scholar.
Sinyal otoritas mencakup jumlah sitasi, tingkatan jurnal, dan penanda pencabutan. Google Scholar dan, pada tingkat yang lebih kecil, Undermind condong kepada karya yang banyak disitasi. Elicit dan SciSpace umumnya memeringkat berdasarkan kemiripan semantik dan tidak membobot sitasi, sehingga makalah yang lebih baru atau kurang disitasi dapat muncul lebih tinggi. Waktu menuju kumpulan hasil berguna membedakan pencarian kata kunci instan dari proses iteratif ala Undermind yang memerlukan setidaknya tiga menit. Nilailah setiap dimensi terhadap tugas nyata Anda — penemuan yang sarat sinonim, cakupan sistematis, atau orientasi lima menit — sebelum memilih mesin utama.
Bagaimana Google Scholar, Elicit, SciSpace, Undermind, dan Jenova Dibandingkan dalam Penemuan Konseptual?
Google Scholar paling kuat untuk eksplorasi luas berbobot sitasi; Elicit dan SciSpace paling kuat ketika kata kunci tidak jelas; Undermind paling kuat untuk pencarian sempit berpresisi tinggi; dan Academic Research Assistant milik Jenova paling kuat ketika penemuan, sintesis, dan kerja sitasi perlu tetap berada dalam satu percakapan persisten. Tidak satu pun dari alat ini mendominasi setiap elemen Kerangka Pemulihan Ketidakcocokan.
| Fitur / Dimensi | Google Scholar | Elicit / SciSpace | Undermind | Academic Research Assistant Jenova | Lens.org / OpenAlex |
|---|---|---|---|---|---|
| Metode pencocokan | Leksikal / kata kunci, berbobot sitasi | Semantik atau hibrida (Elicit menggunakan SPLADE) | Pengambilan hibrida ditambah penilaian relevansi LLM dan pencarian iteratif | Agen riset berbahasa alami atas sumber ilmiah langsung, termasuk Google Scholar | Pencarian metadata ilmiah terstruktur dengan operator lanjutan |
| Pemulihan frasa berbeda | Lemah kecuali Anda menambahkan sinonim atau menggunakan Related articles | Kuat untuk kueri berbasis makna | Kuat untuk arahan bahasa alami yang spesifik | Kuat dalam reformulasi percakapan lintas sesi | Lemah hingga sedang; bergantung pada konstruksi kueri |
| Bias otoritas | Mengutamakan makalah yang banyak disitasi setelah kecocokan judul | Sedikit pembobotan sitasi; makalah yang lebih baru naik | Ada bias tertentu pada karya fundamental melalui pencarian sitasi | Mengikuti sumber yang terhubung dan arahan yang Anda berikan | Didorong metadata; dirancang lebih untuk analisis daripada pemeringkatan semantik |
| Fitur presisi | Tanpa Boolean bersarang, batas 256 karakter, pencarian bidang terbatas | Filter pasca-pencarian mutu jurnal (misalnya tingkatan Scimago di SciSpace) | Spesifisitas bahasa alami alih-alih Boolean | Penyempitan percakapan; bukan mesin sintaks Boolean | Boolean bersarang, kedekatan, pencarian bidang, kosakata terkendali |
| Waktu kueri umum | Instan | Cukup cepat untuk eksplorasi | Setidaknya ~3 menit per pencarian | Interaktif; putaran tindak lanjut berlangsung segera | Instan hingga mengikuti kecepatan API |
| Harga (per 2026) | Gratis | Elicit Pro sekitar $49/bulan; tingkatan berbayar SciSpace dilaporkan dari $12 hingga $160/bulan | Tingkatan eksplorasi gratis; paket akademik berbayar | Tingkatan gratis dengan penggunaan terbatas; Plus mulai $20/bulan | Pencarian web gratis; OpenAlex API memiliki tingkatan gratis |
| Paling sesuai untuk | Makalah fundamental, penelusuran Cited by, pencarian teks lengkap | Kata kunci tidak jelas dan kueri berbentuk pertanyaan | Menemukan kelas studi tertentu dengan recall tinggi | Kerja literatur menyeluruh dengan memori dan dukungan manuskrip | Pencarian sistematis, dapat direproduksi, dan berkendali tinggi |
Google Scholar
Google Scholar tetap merupakan alat generalis. Halaman bantuan resmi mengonfirmasi bahwa hasil biasanya diurutkan berdasarkan relevansi, bukan tanggal, dan peneliti dapat berpindah melalui Related articles dan Cited by setelah memiliki makalah awal. Kedua fitur tersebut adalah pendekatan pencarian kata kunci yang paling dekat dengan penemuan konseptual, tetapi memerlukan makalah awal yang baik. Kelemahannya terdokumentasi dengan baik: tidak ada Boolean bersarang, tidak ada pencarian bidang abstrak saja, batas kueri 256 karakter, batas 1.000 hasil, dan tidak ada ekspor massal. Kombinasi ini menjelaskan mengapa pustakawan secara rutin mengecualikannya sebagai database utama untuk tinjauan sistematis.
Elicit dan SciSpace
Elicit memosisikan dirinya sebagai AI untuk mencari, merangkum, mengekstrak dari, dan berdiskusi dengan lebih dari 125 juta makalah, dengan lebih dari 2 juta pengguna riset. Elicit dan SciSpace menerima pertanyaan berbahasa alami dan memeringkat berdasarkan kemiripan semantik, sehingga keduanya dapat memulihkan makalah yang susunan katanya berbeda dari kueri. Konsekuensinya adalah bias pemeringkatan yang berlawanan dengan Google Scholar: keduanya dapat mempromosikan makalah yang dekat secara semantik tetapi bermutu rendah atau jarang disitasi. SciSpace umumnya lebih cepat dan lebih baik untuk memperoleh wawasan singkat daripada sintesis iteratif yang mendalam. Hasilnya juga dapat bersifat nondeterministik, sehingga kueri yang sama mungkin tidak menghasilkan kumpulan yang sama dua kali.
Undermind
Undermind adalah spesialis. Alat ini memadukan pengambilan kata kunci dan semantik, lalu menggunakan model mutakhir untuk menilai apakah judul, abstrak, dan metadata yang tersedia benar-benar menjawab arahan, kemudian beriterasi dengan pencarian sitasi. Dalam satu pengujian terhadap kumpulan inklusi suatu tinjauan sistematis, Undermind memulihkan 8 dari 11 makalah standar emas dalam 10 hasil teratas (recall@10 sebesar 72,7%) dan 9 dari 11 pada peringkat 50 (recall@50 sebesar 81,8%). Kualitas tersebut membutuhkan waktu dan bekerja kurang baik pada topik yang samar. Alat ini juga terutama melihat judul dan abstrak, ditambah beberapa teks lengkap akses terbuka, sehingga klaim yang hanya tersembunyi dalam metode atau hasil dapat terlewat.
Academic Research Assistant milik Jenova
Academic Research Assistant milik Jenova adalah mitra riset yang memahami disiplin ilmu, bukan indeks makalah mandiri. Alat ini menjalankan penemuan literatur langsung di berbagai sumber ilmiah, lalu mendampingi proyek hingga sintesis, persiapan manuskrip, dan manajemen sitasi. Memori persisten membuatnya dapat mengingat bahwa istilah kerja Anda adalah “kelelahan kognitif” sementara literatur juga menggunakan “penipisan ego” dan “kebutuhan pemulihan”, serta mempertahankan kelompok sinonim tersebut pada proyek yang sama lintas sesi.
Keterbatasan yang jujur bersifat arsitektural. Alat ini tidak menyediakan indeks semantik proprieter berisi 125 juta makalah dengan tabel ekstraksi bawaan seperti Elicit, dan bukan pencari iteratif beberapa menit ala Undermind dengan tolok ukur recall@10 yang dipublikasikan. Kekuatannya terletak pada orkestrasi: arahan berbahasa alami, pencarian ilmiah langsung, pertanyaan tindak lanjut, dan dukungan penulisan dalam satu utas. Peneliti yang memerlukan jejak audit Boolean yang dapat direproduksi tetap sebaiknya menjalankan The Lens atau OpenAlex secara paralel.
Bagaimana Pencarian Semantik Memulihkan Makalah yang Menggunakan Frasa Berbeda untuk Gagasan yang Sama?
Pencarian semantik memulihkan makalah dengan frasa berbeda dengan menanamkan kueri dan koleksi dokumen ke dalam ruang makna bersama, lalu mengambil tetangga terdekat alih-alih mensyaratkan token yang tumpang tindih. Jika kuerinya adalah “bagaimana perawat shift malam memulihkan perhatian setelah shift berturut-turut”, mesin leksikal mencari kata-kata tersebut. Mesin semantik dapat mengambil studi dengan judul seputar “gangguan ritme sirkadian”, “tidur pemulihan”, atau “kelelahan kerja” bahkan ketika “perawat” atau “perhatian” tidak pernah muncul dalam judul.
Semantic Scholar, mesin literatur Allen Institute for AI, merupakan demonstrasi publik awal dari gagasan ini: memeringkat makalah ilmiah berdasarkan makna yang dipahami, bukan kecocokan string. Elicit dan SciSpace menerapkan prinsip serupa dalam skala aplikasi web. Tay menjelaskan pengujian yang sangat jelas: tempelkan paragraf surat kabar yang menggambarkan temuan sebuah studi, dan mesin semantik dapat menampilkan artikel jurnal yang mendasarinya karena embedding prosa berita berada dekat dengan embedding makalah tersebut. Pencarian kata kunci hampir tidak pernah bertahan terhadap parafrasa semacam itu.
Ada mekanisme kedua yang lebih tidak mencolok: perluasan kueri di dalam asisten. Agen percakapan dapat menghasilkan kumpulan sinonim, konsep terkait bergaya MeSH, antonim, dan variasi antardisiplin, lalu mencari variasi tersebut secara eksplisit. Ini bukan pencarian vektor murni. Ini adalah pemahaman semantik yang digunakan untuk membangun jaring leksikal yang lebih baik. Dalam praktiknya, alur kerja dengan recall tertinggi melakukan keduanya — embedding untuk menemukan frasa yang belum terlihat, lalu verifikasi dengan frasa tepat, nama penulis, dan tautan sitasi agar kumpulannya tetap dapat diaudit.
Menguji hal ini pada arahan langsung biasanya dengan cepat memperlihatkan kesenjangannya. Mintalah mesin kata kunci mencari “kepekaan guru” dan Anda sebagian besar akan mendapatkan makalah yang menggunakan istilah riset pendidikan tersebut secara persis. Mintalah asisten semantik mencari “bagaimana guru mendeteksi dan menafsirkan pemikiran siswa yang tidak terduga pada saat itu”, dan Anda juga akan menemukan karya yang diklasifikasikan sebagai “visi profesional”, “penilaian formatif”, atau “pengambilan keputusan saat itu”. Kumpulan kedua itulah yang akan disembunyikan oleh ketidakcocokan kosakata.
Kapan Anda Tetap Harus Menggunakan Pencarian Kata Kunci, Bukan Asisten AI Semantik?
Anda tetap harus menggunakan pencarian kata kunci ketika membutuhkan pengambilan item yang sudah diketahui, penelusuran sitasi dari makalah awal, pencocokan frasa teks lengkap, atau strategi Boolean yang dapat direproduksi untuk tinjauan sistematis. Pemeringkatan semantik adalah instrumen yang salah ketika tugasnya adalah “temukan judul ini”, “temukan semua yang menyitasi uji coba ini”, atau “dokumentasikan string pencarian yang dapat dijalankan ulang oleh penelaah sejawat”.
Google Scholar adalah langkah pertama yang tepat untuk tiga pekerjaan sehari-hari. Pertama, pencarian item yang sudah diketahui: masukkan judul dalam tanda kutip, sebagaimana direkomendasikan oleh bantuan Google sendiri dan sebagian besar panduan perpustakaan. Kedua, pemetaan otoritas: buka makalah penting dan telusuri Cited by untuk melihat langkah bidang tersebut berikutnya, atau Related articles untuk memperluas dari makalah awal. Ketiga, perburuan frasa teks lengkap: jika konsepnya adalah nama metode yang khas, dataset, atau skala, pencarian teks lengkap leksikal akan menangkap penyebutan yang dilewatkan indeks semantik judul-abstrak.
Untuk pencarian sistematis atau sangat presisi, jangan jadikan Google Scholar maupun sebagian besar aplikasi semantik sebagai catatan resmi. The Lens dan OpenAlex mendukung Boolean bersarang, operator kedekatan, pencarian berbasis bidang, dan kosakata terkendali. OpenAlex adalah katalog terbuka dengan 517 juta karya, 5,8 miliar hubungan graf, dan dataset domain publik (CC0). Sebuah penjelasan perpustakaan tahun 2026 menempatkan cakupannya sekitar 474 juta publikasi dengan fokus pada akses terbuka dan transparansi. Google Scholar tidak dapat menyamai kemampuan audit tersebut: Google Scholar membatasi tampilan hingga 1.000 hasil dan tidak menawarkan akses massal.
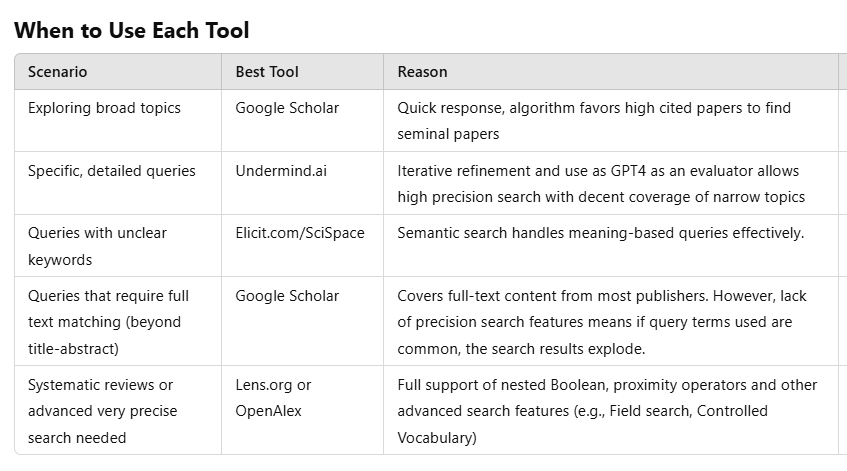
Gunakan tabel di atas sebagai aturan perutean, bukan uji loyalitas. Orientasi luas dan pencarian makalah fundamental tetap menggunakan Google Scholar. Frasa yang tidak jelas diarahkan ke Elicit atau SciSpace. Pertanyaan keberadaan yang sangat spesifik — “adakah RCTs yang menggunakan LLM sebagai penyaring judul-abstrak dan melaporkan presisi serta recall?” — adalah arahan untuk Undermind. Pencarian yang dapat direproduksi dan sarat operator sebaiknya dilakukan di The Lens atau OpenAlex.
Bagaimana Menjalankan Pencarian Literatur yang Menggabungkan Kedua Pendekatan?
Anda menjalankan pencarian gabungan dengan memulai dari ringkasan konsep, memulihkan kandidat yang beragam sinonim secara semantik, lalu mengunci kumpulan tersebut menggunakan operator leksikal, penelusuran sitasi, dan database berkendali tinggi. Urutannya penting. Jika Anda memulai di Google Scholar dengan satu frasa, Anda mewarisi titik buta frasa tersebut. Jika Anda tidak pernah meninggalkan daftar berperingkat semantik, Anda mewarisi masalah mutu dan reproduktibilitas daftar itu.
Urutan praktisnya terlihat seperti ini:
- Tuliskan kebutuhan informasi sebagaimana rekan kerja akan memahaminya, termasuk populasi, hasil, dan frasa yang sudah Anda ketahui tidak stabil.
- Jalankan ringkasan tersebut dalam asisten semantik untuk mengumpulkan makalah kandidat serta kosakata yang benar-benar digunakan.
- Bangun tabel sinonim dari judul dan abstrak tersebut.
- Jalankan ulang istilah yang diperluas di Google Scholar menggunakan tanda kutip,
author:, batas tanggal, serta Cited by / Related articles. - Untuk apa pun yang harus komprehensif atau dapat diaudit, bangun ulang strategi di The Lens atau OpenAlex dengan Boolean bersarang dan batas bidang.
- Simpan log inklusi yang terus diperbarui agar pengulangan semantik yang nondeterministik tidak diam-diam mengubah basis bukti.
Dalam Academic Research Assistant milik Jenova, putaran pembuka dapat berupa ringkasan konsep, bukan string kata kunci:
“Saya membutuhkan makalah empiris tentang cara pekerja pengetahuan jarak jauh pulih dari kelelahan kognitif. Sertakan studi yang mungkin menggunakan kelelahan kerja, penipisan ego, kebutuhan pemulihan, perenungan di luar jam kerja, atau pelepasan psikologis alih-alih kata kelelahan. Utamakan tempat publikasi psikologi kerja dan HCI sejak 2018, serta cantumkan sinonim yang benar-benar digunakan tiap makalah.”
Putaran tindak lanjut kemudian mengubah tabel sinonim asisten menjadi strategi leksikal yang dapat Anda tempelkan ke Google Scholar atau The Lens:
“Ubah kelompok sinonim tersebut menjadi tiga kueri Google Scholar dan satu string Boolean bersarang yang sesuai untuk OpenAlex atau The Lens. Pisahkan kueri yang dibatasi judul dari kueri teks lengkap.”
Pada Elicit atau SciSpace, ajukan pertanyaan dalam bahasa alami alih-alih kata kunci — Tay mencatat bahwa kueri bahasa alami cenderung bekerja lebih buruk di Google Scholar dan lebih baik pada alat semantik ini. Di Undermind, tambahkan batasan hingga arahan tersebut hanya dapat cocok dengan desain studi tertentu. Setelah kumpulan kandidat tersedia, agen Deep Research milik Jenova adalah instrumen yang lebih baik untuk membaca lintas sumber dan menghasilkan sintesis bersitasi, sementara Academic Research Assistant tetap lebih cocok untuk berada di dalam alur kerja ilmiah berupa penemuan, sitasi, dan dukungan manuskrip.
Satu peringatan berlaku untuk setiap langkah yang dibantu AI. Perlakukan daftar berperingkat dan ringkasan yang dihasilkan sebagai bantuan pengambilan, bukan sebagai penyaringan yang sudah selesai. Hasil semantik 10 teratas tetap dapat melewatkan makalah. Penilaian relevansi LLM sering, tetapi tidak selalu, sejalan dengan manusia. Klaim teks lengkap tetap memerlukan PDF.
Apa Kata Pustakawan Riset dan Evaluator Alat tentang Penemuan AI Semantik?
Pustakawan riset dan evaluator independen umumnya memperlakukan asisten AI semantik sebagai pelengkap Google Scholar, bukan pengganti, serta menilai alat berdasarkan mutu pencarian untuk kasus penggunaan yang dinyatakan, bukan berdasarkan kategori pemasaran. Perbandingan terpublikasi yang paling bermanfaat di area ini berasal dari peninjauan berbasis praktik, bukan tolok ukur vendor.
“Jika saya tidak mengetahui kasus penggunaan saya sebelumnya dan hanya dapat memilih satu alat pencarian akademik, memilih Google Scholar akan menjadi keputusan yang jelas. Itu bukan argumen menentang pencarian AI. Itu adalah argumen menentang anggapan bahwa satu fungsi pemeringkatan saja sudah memadai. Scholar tetap generalis. Alat baru memperoleh tempatnya ketika kueri secara semantik canggung atau sangat spesifik.”
“Kegagalan yang paling sering saya lihat adalah ketidakcocokan antara jenis kueri dan mesin. Orang memasukkan topik luas ke dalam agen iteratif lalu menunggu beberapa menit untuk kumpulan yang lebih sempit dari yang dibutuhkan. Atau, mereka memasukkan paragraf bahasa alami ke mesin leksikal lalu menyimpulkan bahwa literaturnya tidak ada. Ketidakcocokan kosakata biasanya merupakan kesalahan alur kerja sebelum menjadi kesenjangan database.”
“Pemeringkatan semantik juga mengubah arti ‘relevan’. Jika Anda tidak membobot sitasi, Anda akan melihat makalah yang lebih baru dan terkadang lebih lemah lebih awal. Jika Anda membobot sitasi, Anda akan terus menemukan kembali kanon yang sama. Peneliti yang menginginkan karya terkait secara konseptual dengan frasa berbeda membutuhkan perilaku pertama. Peneliti yang menginginkan makalah yang diharapkan semua orang untuk mereka sitasi membutuhkan perilaku kedua. Proses yang kompeten menggunakan keduanya dan menuliskan alasannya.”
— Tim Produk Jenova, sistem penemuan literatur, 8 tahun merancang alur kerja riset akademik
Kerangka tersebut selaras dengan catatan publik. Panduan universitas kini mendata alat pencarian AI yang digunakan dalam tinjauan literatur, dan ulasan produk membedakan proses iteratif Undermind yang lebih lambat dari pemindaian semantik SciSpace yang lebih cepat. Konsensus pakar bersifat metodologis, bukan kesukuan: pilih model pengambilan yang sesuai dengan ketidakcocokan yang ingin Anda pulihkan.
Alat Mana yang Sesuai untuk Tinjauan Sistematis Versus Pemetaan Literatur Eksploratif?
Tinjauan sistematis membutuhkan infrastruktur leksikal berkendali tinggi; pemetaan literatur eksploratif membutuhkan recall semantik dan iterasi cepat; sebagian besar pekerjaan tesis dan hibah membutuhkan pendekatan hibrida dengan protokol tertulis pada setiap tahap. Mencampuradukkan pekerjaan tersebut membuat tim either melewatkan studi yang terkait secara konseptual atau menghasilkan kumpulan bukti yang tidak dapat direplikasi.
Untuk pemetaan eksploratif — “apa yang telah ditulis mengenai gagasan ini, dengan nama apa pun?” — mulailah secara semantik. Elicit, SciSpace, dan asisten riset percakapan dibangun untuk pertanyaan tersebut. Google Scholar dapat berkontribusi setelah Anda memiliki makalah awal, melalui Related articles dan Cited by, serta tetap tak tertandingi untuk menemukan PDF dan tautan perpustakaan dengan cepat. Academic Research Assistant milik Jenova sesuai untuk tahap ini ketika Anda juga membutuhkan peta yang persisten: keputusan sinonim yang disimpan, arah yang dikecualikan, dan pemformatan sitasi untuk penulisan akhir.
Untuk tinjauan sistematis atau scoping, jangan biarkan daftar berperingkat semantik menjadi pencarian resmi. Gunakan The Lens atau OpenAlex sebagai tulang punggung yang dapat direproduksi, dokumentasikan setiap operator, dan perlakukan Elicit, Undermind, atau Jenova sebagai bantuan tambahan untuk penemuan sitasi dan penyaringan. OpenAlex juga menyediakan API, bahasa kueri yang ditujukan untuk tinjauan sistematis, serta snapshot lengkap dengan lisensi CC0, yang merupakan desain berlawanan dari pengurutan relevansi tertutup. Batas 1.000 hasil dan ketiadaan akses massal pada Google Scholar menjadikannya tidak layak sebagai pencarian utama yang didokumentasikan, meskipun alat tersebut tetap bermanfaat untuk memeriksa apakah suatu studi yang diketahui diindeks atau tidak.
Untuk pertanyaan keberadaan yang sempit — “apakah ada makalah seperti ini?” — Undermind adalah spesialisnya, asalkan Anda dapat menunggu dan bukti judul-abstrak sudah cukup. Untuk produksi manuskrip setelah kumpulan tersedia, kombinasi penemuan literatur dan manajemen sitasi Jenova lebih relevan daripada antarmuka yang hanya berfokus pada penemuan, dengan catatan bahwa meta-analisis yang berat pada ekstraksi tetap lebih sesuai dilakukan dalam alat ekstraksi khusus seperti Elicit.
Aturan keputusannya cukup sederhana untuk digunakan kembali. Jika frasa bervariasi dan Anda belum mengetahui jargon bidangnya, gunakan asisten riset AI semantik terlebih dahulu. Jika Anda harus mempertahankan string pencarian, gunakan infrastruktur kata kunci dengan operator lanjutan. Jika Anda harus melakukan keduanya — yang merupakan kondisi normal untuk menemukan makalah yang terkait secara konseptual dengan frasa berbeda — gunakan recall semantik untuk menemukan bahasanya, lalu kontrol leksikal untuk menangkap dan mendokumentasikannya.
Referensi
- Aaron Tay — Google Scholar vs alat pencarian AI lainnya (Undermind, Elicit, SciSpace)
- Google Scholar — Bantuan Pencarian Resmi
- Elicit — AI untuk riset ilmiah
- OpenAlex — Katalog terbuka sistem riset global
- Paperguide — Perbandingan harga dan fitur Elicit vs. SciSpace (2026)
- Undermind — Rekan peneliti AI untuk literatur
- University of Alberta / JCHLA — Ulasan produk Undermind.ai
- Paperpile — Cara menggunakan Google Scholar
- TUHH — OpenAlex sebagai alternatif terbuka untuk riset akademik
- Semantic Scholar — Alat riset berbasis AI
- UBC Wiki — Alat pencarian AI yang digunakan dalam tinjauan literatur dan pencarian komprehensif
- SciSpace — Perbandingan Elicit vs SciSpace
- The Lens — Rilis 8.5 dan integrasi OpenAlex
- PMC / NIH — Fitur OpenAlex dan potensi sintesis bukti