Pourquoi le même personnage AI change-t-il de visage, de vêtements ou de coiffure d’une case à l’autre ?
2026-08-13
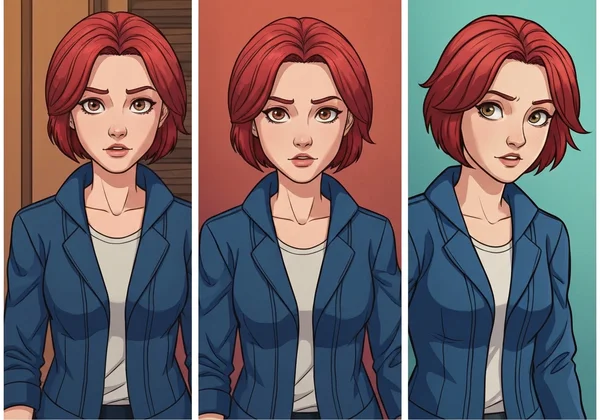
Quelles sont les vraies causes de la dérive identitaire entre les cases : le texte du prompt ou l’architecture du modèle ?
La dérive des personnages dans les comics AI est une limitation architecturale, et non une erreur de prompt : les modèles texte-image génèrent chaque case comme un événement d’échantillonnage indépendant, sans mémoire des sorties précédentes. Ainsi, une description telle que « détective roux en trench-coat » aboutit à chaque fois à une personne statistiquement plausible plutôt qu’à la même personne. Les solutions les plus fiables font passer l’identité par des images de référence et des systèmes d’actifs plutôt que par du texte : des outils comme ComicInk, LTX Studio, Figma Weave et le Comic Creator de Jenova convergent tous vers ce principe, chacun à sa manière.
Ce qui distingue les workflows résistants à la dérive de ceux qui y sont vulnérables :
✅ Génération ancrée dans des références — l’identité est portée par un actif visuel, et non redécrite en prose dans chaque case
✅ Découplage des attributs — visage, cheveux, tenue et arrière-plan sont verrouillés séparément afin qu’un changement de scène ne transforme pas le personnage
✅ Séparation premier plan/arrière-plan — la recherche montre que les détails du décor dérivent même lorsque le visage reste stable (CharaConsist, ICCV 2025)
✅ Discipline lexicale — « trench-coat marron » doit toujours rester « trench-coat marron », jamais simplement « manteau » ou « veste »
✅ Tolérance au mouvement — les méthodes de cohérence se dégradent fortement dès qu’un personnage change de pose ou effectue une action
Pour évaluer honnêtement un outil ou un workflow, il faut d’abord comprendre les quatre mécanismes de défaillance distincts qui se cachent derrière le symptôme unique : « mon personnage a l’air différent ».
Quelles sont les quatre causes techniques de la dérive des personnages ?
La dérive a quatre causes distinctes, et chacune exige une solution différente. Les traiter comme un seul problème explique pourquoi tant de créateurs enchaînent les ajustements de prompts sans jamais résoudre complètement le problème.
1. Absence de mécanisme de mémoire. Chaque génération est un événement indépendant. L’analyse technique de LTX Studio l’exprime clairement : le modèle « ne peut pas se souvenir des caractéristiques d’un personnage généré précédemment », de sorte que chaque rendu repart de la description textuelle. Un prompt est une distribution de probabilités, pas une spécification : « yeux verts, milieu de la trentaine » décrit des millions de visages valides.
2. Enchevêtrement du style et de l’identité. Les modèles peinent à séparer qui est le personnage de l’apparence de l’image. Changez la direction artistique entre les cases — éclairage dramatique, plan plus large — et la géométrie du visage change avec elle, car le modèle n’a jamais appris que ces variables sont indépendantes.
3. Lacunes de raisonnement sur la perspective et la 3D. Représenter la même personne sous un nouvel angle exige une compréhension 3D implicite que le modèle ne possède pas. C’est pourquoi les vues de profil et de dos dérivent le plus, et pourquoi LTX recommande spécifiquement des références de face pour conserver de la flexibilité dans la suite du workflow.
4. Dispersion de l’attention. Le modèle répartit une attention limitée entre personnage, tenue, arrière-plan et style simultanément. Ajoutez de la complexité narrative, et les détails du personnage perdent la compétition.
🎯 Pourquoi les vêtements dérivent-ils davantage que les visages ?
La tenue est le mode de défaillance dont on parle le moins. L’article CharaConsist de l’ICCV 2025 a constaté que les méthodes de référence d’identité, notamment IP-Adapter et PhotoMaker, « se concentrent uniquement sur la préservation de l’identité faciale et ne peuvent pas assurer la cohérence d’autres attributs tels que les vêtements ou les scènes ». Les outils de verrouillage du visage peuvent maintenir un visage stable tandis que la veste change de couleur, que le col est redessiné et que les accessoires disparaissent, car ces systèmes n’ont jamais été entraînés à préserver ces éléments.
Quel niveau de cohérence les méthodes actuelles permettent-elles réellement d’atteindre ?
La cohérence mesurée est réelle, mais partielle : aucune méthode ne verrouille totalement l’identité, et les chiffres indiquent précisément où chaque approche échoue. L’équipe de CharaConsist a comparé quatre approches de premier plan à l’aide de la similarité d’image CLIP, séparée en composantes de premier plan (CLIP-I-fg) et d’arrière-plan (CLIP-I-bg), ainsi que de la similarité d’embeddings faciaux (ID Sim).
Leurs résultats publiés placent CharaConsist à 0.883 en CLIP-I-fg et à 0.916 en CLIP-I-bg pour les tâches de maintien de l’arrière-plan, contre 0.876 et 0.895 pour ConsiStory. L’écart se creuse tout particulièrement pour la cohérence de l’arrière-plan, une dimension que la plupart des méthodes ignorent complètement.
Dans une étude de préférence humaine rapportée dans le même article, les évaluateurs ont préféré CharaConsist aux méthodes de référence 64 % du temps pour la cohérence des vêtements et 98 % du temps pour la cohérence de l’arrière-plan, tandis que la préférence pour l’alignement textuel n’atteignait que 57 % : un compromis mesurable entre le verrouillage de l’identité et le suivi du prompt.
Ce compromis est la tension centrale de toute cette catégorie. Chaque mécanisme de cohérence contraint le générateur, et cette contrainte réduit sa réactivité au prompt. La propre étude d’ablation de l’article montre que FLUX.1 avec CharaConsist appliqué obtient un score CLIP-T d’alignement textuel inférieur à celui du modèle de base non modifié.
📊 Le problème du mouvement
Les méthodes de cohérence se dégradent avec le mouvement. Les auteurs de CharaConsist l’indiquent directement : « lorsque le personnage au premier plan subit d’importantes variations de mouvement, les incohérences d’identité et de détails vestimentaires deviennent manifestes ». Pour les comics — un média fondé sur des personnages qui courent, se battent, gesticulent et réagissent — c’est la contrainte la plus difficile. Une case de personnages en train de parler tient bien mieux qu’une case d’action, et toute comparaison d’outils ne testant que des portraits statiques surestime leurs performances réelles.
Quelles approches sont disponibles et comment se comparent-elles ?
Quatre approches architecturales distinctes existent, et elles s’échangent toutes les mêmes trois facteurs : coût de mise en place, force de la cohérence et flexibilité créative.
| Dimension | Générateurs généralistes (Midjourney, DALL·E) | ComfyUI + IP-Adapter/ControlNet | Plateformes à actifs de référence (LTX, Figma Weave, ComicInk) | Jenova Comic Creator |
|---|---|---|---|---|
| Mécanisme de cohérence | Réutilisation du seed + répétition du prompt | Adaptateurs entraînés, LoRA, embeddings faciaux | Actifs de personnages enregistrés et réutilisés à chaque génération | Mémoire conversationnelle persistante + définitions de personnages enregistrées |
| Cohérence du visage | Faible — principal échec signalé par les utilisateurs | Forte ; IP-Adapter FaceID est optimisé pour l’identité | Forte ; ancrée dans les actifs | Forte pour les personnages définis ; variable selon le modèle sélectionné |
| Cohérence de la tenue | Faible | Faible — lacune documentée des méthodes de référence d’identité | Gérée par des variantes de tenue (duplication et modification dans LTX) | Maintenue par des fiches de personnage explicites dans la mémoire de session |
| Coût de mise en place | Minimal | Élevé — construction de workflow, poids de modèles, GPU | Modéré — création préalable d’une bibliothèque de personnages | Faible — configuration conversationnelle, sans paramétrage technique |
| Flexibilité des poses et de l’action | Élevée mais incohérente | Modérée ; ControlNet apporte le contrôle des poses | Modérée ; le biais en faveur des références de face limite les angles | Modérée ; la dérive augmente avec les actions extrêmes |
| Matériel local | Aucun | 3–37 GB de VRAM selon le mode d’offload | Aucun | Aucun |
| Tarification | Niveaux d’abonnement Midjourney/DALL·E | Logiciel gratuit ; coût du matériel et de l’électricité | Offre gratuite Figma Weave + formules payantes ; essai gratuit ComicInk de 4 pages | Offre gratuite ; Plus à 20 $/mois avec 30× l’utilisation gratuite |
| Idéal pour | Images uniques marquantes, concept art | Créateurs techniques ayant besoin d’un contrôle maximal | Équipes standardisant une distribution récurrente | Créateurs orientés histoire écrivant des récits à plusieurs cases de façon conversationnelle |
Générateurs généralistes
Midjourney et DALL·E produisent la meilleure qualité esthétique par image et la pire cohérence entre les cases. Les forums de créateurs documentent régulièrement le même schéma : les utilisateurs signalent « l’impossibilité d’avoir les mêmes personnages, ou même des personnages similaires, tout au long de l’œuvre ». La communauté de développeurs OpenAI possède une demande ouverte concernant la cohérence des personnages et le verrouillage du style, réclamant explicitement la préservation des « traits du visage, de la morphologie, du teint, des vêtements et de la pose entre les requêtes ». La réutilisation du seed et l’ancrage sur une image source unique apportent une aide : les utilisateurs expérimentés de Midjourney constatent une meilleure stabilité des vêtements lorsqu’ils s’en tiennent à une seule image source et à un seed fixe. Toutefois, aucune de ces approches ne garantit l’identité.
Piles d’adaptateurs ComfyUI
Le plafond technique le plus élevé, mais aussi la courbe d’apprentissage la plus raide. IP-Adapter préserve l’apparence et le style, tandis que ControlNet régit la structure ; les utilisateurs avancés combinent les deux parce qu’aucun ne suffit seul. Le dépôt CharaConsist expose clairement la réalité matérielle : 37 GB de VRAM pour un fonctionnement sur un seul GPU, un chiffre qui descend à 3 GB uniquement avec l’offload séquentiel vers CPU, au prix d’une forte pénalité de vitesse. Cette voie exclut à elle seule la plupart des créateurs de comics pour des raisons de matériel.
Plateformes à actifs de référence
L’entre-deux pragmatique. Le système Elements de LTX Studio stocke les personnages comme des actifs persistants, identifiables par tags et invoqués avec des mentions @. Figma Weave adopte une approche fondée sur des nœuds, dans laquelle « la cohérence est structurelle, et non accidentelle ». ComicInk génère d’abord des images de référence pour les personnages, puis les attache à chaque rendu de page. Les trois font le même pari architectural : cessez de décrire le personnage, commencez à le référencer.
Comment empêcher concrètement la dérive dans un comic en production ?
Le changement ayant le plus fort impact consiste à transformer votre personnage, de description, en actif avant de générer la moindre case. Tout le reste relève de l’optimisation.
Étapes universelles de préproduction :
- Créez d’abord une fiche de personnage. Verrouillez visage, cheveux, carrure, tenue et palette dans un rendu canonique avant même que la première case n’existe.
- Figez votre vocabulaire. Les recommandations de LTX sont explicites : « “Trench-coat marron” doit toujours rester “trench-coat marron”, et non devenir “manteau” ou “veste” dans les descriptions suivantes. » La dérive des synonymes entraîne une dérive visuelle.
- Utilisez des références de face, avec un éclairage neutre. Les ombres directionnelles et les angles de profil s’impriment dans la référence et entrent en conflit avec les scènes ultérieures.
- Créez intentionnellement des variantes de tenue plutôt que de redécrire les vêtements. LTX procède en dupliquant un personnage et en ne modifiant que les champs vestimentaires, ce qui préserve l’identité faciale entre
@Sarah_casualet@Sarah_formal.
Dans le Comic Creator de Jenova, la mémoire persistante de la session effectue le travail d’ancrage : vous établissez une fois le personnage dans la conversation, et l’Agent conserve cette définition :
« Créez une fiche de personnage pour Mara Voss : 34 ans, mâchoire marquée, cheveux argentés très courts, veste de terrain olive délavée avec une manchette gauche déchirée, pantalon cargo gris foncé. Expression neutre, vue de face, éclairage de studio doux et uniforme, arrière-plan neutre uni. Style d’encrage de comics occidentaux. »
Ensuite, pour chaque case, référencez au lieu de redécrire :
« Case 3 : Mara Voss — même fiche de personnage, même veste de terrain olive avec la manchette gauche déchirée — accroupie derrière une voiture renversée, regardant vers la gauche. Gardez le visage, les cheveux et la tenue identiques à la fiche. »
Dans LTX Studio, le flux équivalent est le suivant : ouvrez Elements → Create New Element → Character → importez 5 à 12 images de référence ou générez-en une → donnez-lui un nom → puis ajoutez le tag @CharacterName dans le prompt de chaque plan. Les mises à jour de l’Element enregistré se propagent automatiquement à chaque apparition marquée.
Dans ComfyUI, vous construisez un graphe : chargez un nœud IP-Adapter FaceID pour l’identité, enchaînez ControlNet pour la structure de pose, puis entraînez soit un LoRA sur votre personnage, soit utilisez une image de référence fixe comme source d’identité dans tous les rendus.
⚠️ Ce qui ne fonctionnera pas
Ajouter « personnage cohérent » ou « même personne qu’avant » dans un prompt ne change rien. Le modèle n’a aucun « avant ». La documentation communautaire sur cet échec est sans détour : « la plupart des gens disent à l’AI ce qu’ils veulent » au lieu de fournir une référence à laquelle le système peut s’ancrer. Le texte ne peut pas compenser l’absence d’un mécanisme de mémoire.
Pourquoi les arrière-plans dérivent-ils même lorsque le personnage reste stable ?
Les arrière-plans dérivent parce que presque toutes les méthodes de cohérence optimisent exclusivement le sujet au premier plan, laissant l’environnement se régénérer librement dans chaque case. Les auteurs de CharaConsist identifient cela comme une lacune majeure des travaux antérieurs : les méthodes existantes sans entraînement « échouent à maintenir des détails d’arrière-plan cohérents, ce qui limite leur applicabilité ».
Le coût mesuré est important. Dans l’étude de préférence humaine, la cohérence de l’arrière-plan présentait la marge la plus large de toutes les dimensions : 98 % de préférence pour la méthode qui la traite explicitement, contre 2 % et 0 % pour les deux méthodes de référence. Il ne s’agit pas d’une amélioration marginale : cela indique que les méthodes de référence ne tentent pratiquement pas de préserver l’arrière-plan.
Pour les comics, cela compte plus que pour des illustrations isolées. Une conversation de deux pages dans une cuisine exige que cette cuisine reste la même. Lorsque les placards changent de couleur entre les cases, les lecteurs perçoivent la scène comme discontinue, même s’ils ne savent pas expliquer pourquoi.
La solution technique de CharaConsist est un masque premier plan/arrière-plan dérivé des différences d’attention, qui permet un « contrôle découplé de la cohérence du premier plan et de l’arrière-plan ». Vous pouvez ainsi figer la scène dans une séquence continue, ou la libérer délibérément lors d’un changement de lieu. La plupart des outils grand public n’exposent pas ce contrôle ; la solution pratique consiste donc à générer séparément un arrière-plan d’établissement et à le réutiliser comme référence visuelle dans toute la séquence.
Quels compromis faut-il prévoir lorsque vous verrouillez un personnage ?
Chaque gain de cohérence a un coût, et les deux coûts les plus fréquents sont la réactivité au prompt et la variété des scènes. Les comprendre évite le cycle frustrant qui consiste à renforcer les contraintes puis à se demander pourquoi le modèle ne suit plus les instructions.
Cohérence contre respect du prompt. L’étude d’ablation de CharaConsist est exceptionnellement franche sur ce point : l’application de la méthode de cohérence à FLUX.1 a réduit le score d’alignement textuel CLIP-T par rapport au modèle de base. Les tests de préférence ont relevé un alignement textuel de 57 %, le plus faible de tous les critères mesurés. Un ancrage fort dans des références attire la génération vers la référence et l’éloigne de vos nouvelles instructions.
Biais de référence contre diversité des angles. Les références de face maximisent la réutilisabilité ultérieure, mais elles biaisent aussi le modèle en faveur de sorties frontales. Obtenir une véritable case en trois quarts ou en plongée à partir d’un personnage verrouillé de face exige de lutter contre cet ancrage.
Fidélité statique contre action. Les benchmarks de cohérence sont généralement mesurés sur des scènes relativement composées. Les comics ont besoin de mouvement, et le mouvement est précisément là où l’article CharaConsist constate une dégradation.
Investissement initial contre flexibilité. Les pipelines LoRA et adaptateurs de ComfyUI offrent le plafond le plus élevé, mais les utilisateurs avancés soulignent la charge pratique. L’auteur d’un workflow décrit ainsi l’intérêt de ne pas avoir à « enregistrer chaque fichier de checkpoint de personnage », ce qui implique que la plupart des workflows imposent précisément cette tâche.
Que disent les utilisateurs expérimentés sur l’état réel de cette technologie ?
Le consensus parmi les personnes qui construisent des workflows de production de comics est que l’ancrage dans des références a résolu la majeure partie du problème, et que les échecs restants se concentrent dans le mouvement et la tenue.
« Le modèle mental que la plupart des gens appliquent aux comics AI est erroné dès la première case. Ils considèrent le prompt comme une fiche de spécifications que le modèle lit et exécute. Ce n’est pas le cas : c’est une contrainte d’échantillonnage. Lorsque vous écrivez “détective aux cheveux roux”, vous réduisez l’espace des visages possibles de milliards à des millions, pas à un seul. Chaque case est un nouveau tirage dans cet espace réduit. Une fois que les créateurs l’ont intégré, ils cessent de réécrire leurs prompts et commencent à créer des actifs de référence ; le problème disparaît alors en grande partie. »
« Ce qui surprend les gens, c’est que les visages étaient la partie facile. Le verrouillage du visage dispose de solutions solides et bien entraînées dans de multiples architectures. La tenue reste le point récalcitrant, car les vêtements possèdent davantage de degrés de liberté qu’un visage et bénéficient de beaucoup moins de données d’entraînement dédiées à leur préservation. Dans nos propres tests, un personnage garde son visage pendant une séquence de douze cases alors que la veste change discrètement de col à trois reprises. Nous conseillons aux créateurs de traiter la tenue comme une entité nommée avec un vocabulaire fixe — une manchette gauche déchirée, précisément — plutôt que comme une description générale. Les détails distinctifs et nommables survivent ; les détails génériques, non. »
« La limite honnête que personne ne met en avant, c’est l’action. Les benchmarks de cohérence s’exécutent sur des plans relativement composés. Les comics ne sont pas des plans composés : ce sont des personnes en plein coup de poing, en pleine chute, en plein sprint. C’est exactement là que toutes les méthodes actuelles perdent leur emprise. Si vous préparez une séquence de combat, prévoyez des itérations et envisagez d’ancrer la séquence dans une seule grande case d’établissement plutôt que d’attendre de huit cases d’action indépendantes qu’elles soient cohérentes entre elles. »
— Équipe produit Jenova, 6 ans de création de workflows de génération AI à plusieurs cases
Quelle approche correspond à votre situation ?
Le bon outil dépend de trois variables : votre niveau technique, le nombre de cases dont vous avez besoin et l’importance de la génération d’histoire par rapport à la génération d’images.
Choisissez un générateur généraliste si vous avez besoin d’un petit nombre d’images marquantes et acceptez l’incohérence visuelle, ou si vous produisez du concept art plutôt qu’un récit séquentiel. Midjourney reste l’option la plus forte en matière d’esthétique pure de l’image.
Choisissez ComfyUI avec IP-Adapter et ControlNet si vous avez accès à un GPU, de la patience technique et besoin d’un contrôle maximal, notamment si votre volume de production justifie l’entraînement d’un LoRA de personnage. Les workflows FaceID Plus V2 constituent la référence pratique actuelle.
Choisissez une plateforme à actifs de référence si vous produisez régulièrement avec une distribution fixe et souhaitez une gestion centralisée des actifs. Figma Weave convient aux équipes partageant des standards de personnages ; LTX Studio convient aux travaux proches de la vidéo ; ComicInk convient à une production de comics rapide de bout en bout.
Choisissez le Comic Creator de Jenova si votre goulot d’étranglement concerne autant l’histoire que l’art : l’Agent gère le script, le découpage en cases et la génération dans un même fil conversationnel, tandis que la mémoire de session conserve les définitions des personnages sur les projets longs. Il est disponible sur jenova.ai/a/comic-creator. Pour les formats à défilement vertical, le Webtoon Creator gère la structure des épisodes et le rythme de défilement ; le Manga Creator couvre les conventions des cases monochromes. La limite honnête s’applique également ici : les poses d’action extrêmes et les cases complexes avec plusieurs personnages exigent encore des itérations, et la plateforme n’expose pas le contrôle de masquage premier plan/arrière-plan proposé par les méthodes de niveau recherche. L’offre gratuite inclut une utilisation limitée ; Plus coûte 20 $/mois pour une allocation 30× supérieure.
Quel que soit le chemin choisi, le principe sous-jacent est identique. La cohérence des personnages est un problème de gestion d’actifs déguisé en problème d’ingénierie de prompts. Créez d’abord la référence, nommez chaque détail distinctif, réutilisez les mêmes mots et acceptez que les cases d’action demandent davantage de tentatives.
Références
- CharaConsist : génération cohérente de personnages avec des détails fins — article ICCV 2025 avec données de benchmark et étude de préférence humaine
- Dépôt GitHub CharaConsist — implémentation officielle et exigences matérielles
- LTX Studio — comment créer un personnage AI cohérent, y compris les quatre limites techniques de la génération AI
- Communauté de développeurs OpenAI — besoin de cohérence des personnages et de verrouillage du style dans la génération d’images
- ComicInk — meilleurs générateurs de comics AI en 2026, comparaison des approches de génération
- Figma Weave — générateur de personnages AI cohérents, approche de cohérence fondée sur des nœuds
- Medium — comment résoudre la cohérence des personnages dans ComfyUI après avoir essayé ControlNet et IPAdapter
- RunComfy — workflow de personnages cohérents IPAdapter FaceID Plus V2
- Medium — gérer tous les facteurs liés à la cohérence des personnages dans Midjourney
- Discussion communautaire sur les raisons de la dérive de la coiffure, de la mâchoire et du teint dans la génération de personnages AI