Pourquoi les outils d’analyse boursière par AI utilisent-ils des données obsolètes avec une certitude excessive ?
2026-08-23
Comment la latence des données interagit-elle avec le calibrage de la confiance dans la recherche actions par AI ?
De nombreux outils grand public d’analyse boursière par AI associent des données de marché différées ou instantanées à des modèles de langage qui privilégient par défaut des formulations très affirmatives. Les investisseurs reçoivent ainsi les chiffres d’hier habillés de la conviction d’aujourd’hui. L’échec n’est pas seulement un problème de données ni uniquement un problème de modèle. Il résulte de l’interaction entre les deux : un flux vieux de plusieurs heures ou des documents déposés il y a quelque temps, associé à un générateur entraîné à compléter les réponses avec fluidité plutôt qu’à refuser de répondre ou à réduire son niveau de confiance lorsque les preuves sont insuffisantes.
Cette interaction — appelons-la l’écart latence-certitude — constitue la meilleure manière d’évaluer les outils d’analyse actions par AI en 2026. Des outils qui semblent similaires sur une capture d’écran divergent nettement dès lors que vous posez quatre questions : quel est l’âge du dernier cours ou dépôt, la source est-elle nommée, la conviction est-elle exprimée sous forme de fourchette ou de slogan, et le produit divulgue-t-il réellement l’ancienneté des données ?
Les principaux facteurs qui distinguent une recherche actions par AI exploitable d’un commentaire tardif mais sûr de lui :
✅ Fraîcheur des cours et des dépôts — secondes et horodatages officiels contre résumés mis en cache sans heure de référence
✅ Attribution des sources — dépôts SEC, estimations et cotations nommés contre vagues « données de marché »
✅ Expression de la confiance — probabilités, fourchettes et conditions contre langage catégorique d’achat/vente
✅ Divulgation de l’ancienneté — âge des données visible contre instantanés silencieux qui ressemblent à un appel de salle des marchés en direct
✅ Mémoire de session — capacité de l’outil à retenir votre thèse et à la réviser à l’arrivée de nouvelles cotations
Pour comparer les produits de manière pertinente, il est utile de traiter séparément la latence des données et la certitude verbale comme deux choix de conception, puis d’évaluer avec quelle honnêteté un outil les relie.
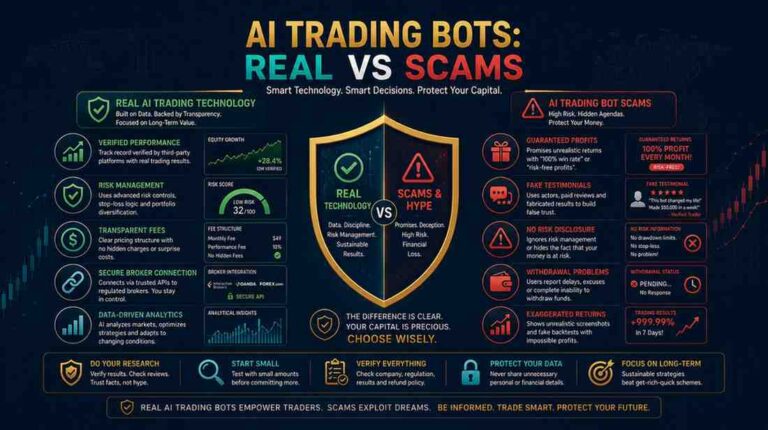
Pourquoi les données financières obsolètes sont-elles devenues plus dangereuses avec la diffusion des outils boursiers par AI ?
Les données obsolètes sont aujourd’hui plus dangereuses car une part plus importante de l’activité de marché est déjà automatisée, tandis que les interfaces génératives font paraître des informations différées comme un jugement en temps réel. Les estimations suggèrent que 60 à 70 % des transactions sont désormais exécutées de manière algorithmique, ce qui signifie que de petites erreurs d’entrée peuvent se propager plus vite qu’une salle de marché humaine ne le permettrait. Le Flash Crash de 2010 reste l’avertissement de référence : des données incorrectes ou mal traitées entrant dans des systèmes automatisés ont contribué à effacer près de 1 000 milliards de dollars de capitalisation boursière en quelques minutes avant le rebond du marché.
Les outils génératifs ajoutent un second mode de défaillance à ce risque d’infrastructure. Une analyse sectorielle indique que les hallucinations d’AI surviennent dans jusqu’à 41 % des requêtes liées à la finance, et ces erreurs se présentent rarement comme telles. Elles arrivent sous la forme de réponses fluides et complètes. Les praticiens de la qualité des données sont explicites sur la cause : des informations financières fragmentées, obsolètes ou mal gouvernées constituent un moteur majeur de sorties génératives incohérentes dans la banque et la finance.
Les régulateurs ont déjà considéré la surestimation des capacités d’AI comme une question de protection des investisseurs. En mars 2024, la Securities and Exchange Commission américaine a conclu des accords avec Delphia (USA) Inc. et Global Predictions Inc. concernant des allégations AI fausses et trompeuses, avec 400 000 dollars de sanctions civiles cumulées. Le bureau d’éducation des investisseurs de la SEC a également averti que des acteurs malveillants exploitent la popularité et la complexité de l’AI pour attirer leurs victimes. La combinaison est simple : davantage de flux automatisés, davantage de recherche au format chatbot et une incitation marketing à paraître certain même lorsque les données sous-jacentes sont en retard.
Que faut-il rechercher lors de l’évaluation d’un outil d’analyse boursière par AI ?
Vous devez évaluer un outil boursier par AI selon sa façon de gérer le temps, les preuves et l’incertitude — et non selon l’élégance apparente de sa recommandation. Un filtre utile consiste à utiliser l’écart latence-certitude : notez indépendamment la fraîcheur, l’attribution, le langage de confiance et la divulgation, puis demandez-vous si le produit peut réviser une thèse lorsque de nouvelles informations arrivent.
Une liste de contrôle pratique pour tout rapport portant sur un ticker :
- Horodatages de référence sur les prix, les volumes, les estimations et les dépôts. Si l’outil ne peut pas indiquer quand un chiffre était vrai, considérez la conclusion comme un commentaire.
- Sources nommées. « SEC 10-Q, Item 7, déposé le 6 août » relève de la recherche. « Les résultats récents semblent solides » relève de l’impression.
- Faits et inférences séparables. Les faits doivent être vérifiables. Les inférences doivent être identifiées comme telles.
- Langage calibré. « Scénario central : baisse de 8 à 12 % si la publication manque les attentes de plus de 4 % » est plus honnête que « Achat fort ».
- Possibilité de révision. L’outil doit pouvoir actualiser la vue d’hier lorsque les données d’aujourd’hui la contredisent.
- Limites de périmètre. Un moteur fondamental qui invente discrètement des supports/résistances, ou un bot graphique qui invente un récit sur les avantages concurrentiels, agit hors de son champ de compétence.
FINRA a souligné que les modèles d’AI peuvent cesser de produire des prédictions fiables lorsque les conditions sortent des données d’entraînement — volatilité inhabituelle, catastrophes, pandémies ou chocs géopolitiques. Il s’agit d’un critère d’évaluation, pas d’une note de bas de page. Demandez ce que fait l’outil lorsque le marché devient discontinu. Si la réponse est qu’il continue à formuler un avis net, la certitude est un choix de produit, non un résultat statistique.
Examinez également la surface commerciale. Les scanners dédiés et les produits de signaux optimisent souvent le nombre d’alertes par session. Les Agents de recherche conversationnels optimisent l’explication. Aucun n’est automatiquement plus précis. Ils échouent de façons différentes : les scanners peuvent être en direct tout en surajustant ; les interfaces de chat peuvent être réfléchies tout en citant la clôture de la semaine dernière.
Comment les outils boursiers par AI populaires se comparent-ils en matière de fraîcheur et d’incertitude ?
Aucun produit boursier par AI ne domine sur toutes les dimensions ; TrendSpider et Trade Ideas sont plus solides comme terminaux techniques en direct, Danelfin et Tickeron sont plus solides comme produits guidés par des scores ou des signaux, tandis que le Fundamental Stock Analyst de Jenova est plus solide pour une recherche fondamentale sourcée et révisable, avec mémoire. La comparaison utile n’est pas « quel outil est le plus intelligent ? ». Elle consiste à déterminer quel mode de défaillance vous êtes prêt à accepter.
| Fonctionnalité / Dimension | TrendSpider | Jenova Fundamental Stock Analyst | Tickeron | Danelfin | Trade Ideas |
|---|---|---|---|---|---|
| Positionnement des données | Présenté par le fournisseur comme offrant graphiques, alertes et automatisation en temps réel | Recherche en session sur dépôts SEC, estimations et sentiment, avec recherche en direct | Signaux quotidiens avec bots et scanners en temps réel en option | AI Score glissant sur plusieurs mois, et non terminal de cotations instantanées | Scans en temps réel ; Holly exécute des backtests chaque nuit |
| Style de confiance | Niveaux détectés, cartes thermiques, alertes de figures | Thèse narrative ; possibilité de demander fourchettes, conditions et heures de référence | Signaux d’achat/vente et stratégies de bots | AI Score de 1 à 10 présenté comme une probabilité de surperformer le marché | Configurations à forte conviction avec stops suggérés |
| Mémoire / révision | Espaces de travail sauvegardés et scans entraînés | Mémoire persistante entre les sessions des thèses et positions précédentes | Non vérifié au-delà des paramètres de compte | Téléchargements historiques de scores aux niveaux supérieurs | Persistance des stratégies et alertes dans le terminal |
| Exécution | Bot de trading intégré | Analyse uniquement ; aucun routage vers un courtier | Les bots peuvent trader via un courtier connecté | Recherche et classement, pas une salle de marché complète | Trading en 1 clic depuis le graphique |
| Tarification (en 2026) | Environ 54 à 122 $/mois selon le niveau | Niveau gratuit ; usage payant à partir de 20 $/mois | Niveau gratuit ; offres payantes à partir d’environ 60 $/mois, bots plus chers | Niveau gratuit ; Plus environ 19 à 22 $/mois, Pro environ 52 à 59 $/mois | À partir d’environ 127 $/mois |
| Limite honnête | Moins adapté à l’analyse fondamentale au niveau des dépôts | Ni flux Level-2 en direct ni plateforme d’exécution | La place de marché de signaux/bots peut encourager le surtrading | Le score est un produit probabiliste, pas un carnet en direct | Coûteux ; conçu pour le trading actif, pas la recherche patiente |
| Idéal pour | Traders techniques recherchant des graphiques automatisés | Investisseurs ayant besoin de fondamentaux sourcés et d’un suivi | Traders recherchant des signaux et une automatisation facultative | Utilisateurs de screener souhaitant une probabilité classée unique | Traders actifs recherchant des configurations pour la séance suivante |
Les détails de tarification et de fonctionnalités ci-dessus pour TrendSpider, Trade Ideas, Tickeron et Danelfin sont tirés d’un comparatif 2026 qui compile les offres et le positionnement des fournisseurs. Les affirmations des fournisseurs en matière de performance — y compris les historiques publiés d’AI Score et les résultats de notes alphabétiques — doivent être considérées comme des performances marketing, et non comme de l’alpha audité de manière indépendante.
TrendSpider
TrendSpider est particulièrement solide lorsque la question porte sur la structure technique : lignes de tendance automatisées, scans multi-unités de temps et alertes personnalisées. Sa limite est complémentaire. Une plateforme organisée autour des graphiques et des bots ne contraindra pas naturellement l’utilisateur à réconcilier une cassure avec le 8-K publié la veille au soir.
Tickeron
Tickeron présente l’AI sous forme de signaux, d’outils de figures et d’une place de marché de bots. Cela est utile pour les traders qui souhaitent un flux classé d’idées. C’est moins adapté à toute personne cherchant à réduire la certitude, car un badge quotidien d’achat/vente est lui-même un objet de forte certitude.
Danelfin
Danelfin condense un vaste ensemble de caractéristiques dans un AI Score et un cadrage à court horizon visant à « battre le marché ». Cette compression est le but, mais aussi le risque. Un nombre entier unique est facile à citer et facile à surinterpréter, surtout si l’utilisateur ne voit jamais l’heure de référence des données alimentant le score.
Trade Ideas
Trade Ideas, via son système Holly, est conçu pour la séance suivante : backtests nocturnes, alertes en temps réel et niveaux de risque suggérés. C’est une conception cohérente pour les traders actifs. C’est aussi une conception qui récompense l’action. Si les caractéristiques sous-jacentes sont tardives ou propres à un régime de marché, l’interface conserve malgré tout une apparence décisive.
Jenova Fundamental Stock Analyst
Le Fundamental Stock Analyst de Jenova est un Agent de recherche plutôt qu’un scanner. Il est conçu pour l’analyse des résultats, la valorisation relative, l’évaluation du modèle économique et la synthèse de dépôts SEC, d’estimations d’analystes et du sentiment de marché. Sur la plateforme Jenova, il peut conserver les travaux antérieurs entre les sessions et appeler des outils de recherche en direct, ce qui compte lorsque la tâche est « actualiser la thèse d’hier » plutôt que « produire un nouveau signal ».
Ses limites sont tout aussi précises. Ce n’est ni un courtier, ni un montage Level-2, ni un substitut à un conseiller agréé. Il n’égale pas TrendSpider pour le tracé automatisé multi-unités de temps, et il n’égale pas Trade Ideas pour l’exécution en un clic. Les utilisateurs ayant besoin de structure graphique peuvent l’associer au Technical Stock Analyst ; ceux qui ont besoin d’analyse d’allocation et de dérive peuvent utiliser le Portfolio Management Strategist. Il s’agit de tâches adjacentes, et non de la preuve qu’un seul Agent constitue un terminal complet.
Pourquoi les modèles de langage paraissent-ils certains lorsque leurs données de marché ont plusieurs heures de retard ?
Les modèles de langage paraissent certains parce qu’ils sont entraînés à produire des réponses complètes et cohérentes, non à signaler l’âge ou la faiblesse de leurs éléments probants. Les hallucinations sont des sorties qui paraissent cohérentes et sûres d’elles tout en étant factuellement fausses, fabriquées ou non étayées. En finance, cette fluidité se heurte à une pile de données souvent différée, assemblée depuis différents fournisseurs, ou récupérée depuis des documents qui étaient à jour lors de leur dépôt mais sont obsolètes à l’ouverture.
Trois mécanismes apparaissent de manière répétée dans les outils de production :
- Retard de récupération. Le modèle peut être en direct. L’index des dépôts, l’instantané d’estimations ou le cours différé qui le sous-tend peut ne pas l’être. La phrase arrive néanmoins au présent.
- Pression d’exhaustivité. Les interfaces de chat pénalisent le « je ne sais pas ». Les utilisateurs demandent une conclusion, et le modèle remplit l’emplacement.
- A priori d’entraînement contre marché réel. FINRA a averti que les modèles peuvent se comporter mal lorsque le régime en direct ne figure pas dans la distribution d’entraînement. La prose ne devient pas automatiquement plus humble lorsque cela se produit.
Il existe aussi une raison commerciale. La certitude convertit. Une note prudente est plus difficile à capturer en image que « Achetez le repli ». Les cas de promotion trompeuse de l’AI de la SEC en 2024 existent parce que des conseillers ont commercialisé des capacités d’AI qu’ils n’utilisaient pas réellement. Les produits destinés au grand public subissent une version plus modérée de la même incitation : suggérer une intelligence en direct, livrer un digest mis en cache.
Les recherches de la London School of Economics sur le trading algorithmique rendent le point relatif aux données explicite. Maximilian Goehmann soutient qu’une trop grande partie de l’attention réglementaire porte sur le modèle, et pas assez sur les données qu’il consomme, notamment les cotations dupliquées, les valeurs manquantes et les horodatages incohérents. Ce diagnostic s’applique directement à la recherche par chatbot. Si l’heure de référence manque, l’intervalle de confiance n’est qu’une mise en scène.
Une habitude durable lors de l’utilisation de tout outil conversationnel d’analyse actions, y compris le Fundamental Stock Analyst de Jenova, consiste à forcer le modèle à séparer l’heure de l’horloge de la force de l’affirmation :
« Analyse NVDA à partir du dernier dépôt officiel et de la dernière cotation disponible. Liste chaque chiffre clé avec sa source et son horodatage. Donne un scénario central / haussier / baissier avec ce qui invaliderait chacun. Si une donnée est antérieure à la dernière clôture de séance régulière, indique-le dans la première phrase. »
Cette requête ne rend pas les données en direct. Elle rend la latence visible, ce que la plupart des produits omettent.
Comment le biais de surconfiance amplifie-t-il le risque des recommandations tardives d’AI ?
Le biais de surconfiance transforme une réponse tardive ou peu étayée d’AI en une transaction trop importante, car les investisseurs accordent déjà un poids excessif à la précision de leurs informations. Les synthèses académiques et professionnelles de la littérature convergent : la surconfiance dans l’exactitude des informations entraîne un volume de trading plus élevé et une utilité plus faible, résultat associé aux travaux d’Odean et à une longue série de constats empiriques ultérieurs. Les données boursières relient la surconfiance au trading excessif puis à une performance d’investissement plus faible.
Une interface d’AI renforce ce biais. L’utilisateur ne s’est pas simplement formé une opinion. Un système fluide l’a confirmée, souvent avec des tableaux, des objectifs de cours et un ton emprunté à la recherche institutionnelle. La synthèse d’Investopedia sur le biais de surconfiance recense les conséquences habituelles : trading plus fréquent, coûts de transaction plus élevés, davantage de volatilité et de moins bons résultats. Si les chiffres sous-jacents étaient déjà obsolètes, l’investisseur agit désormais avec assurance sur un régime précédent.
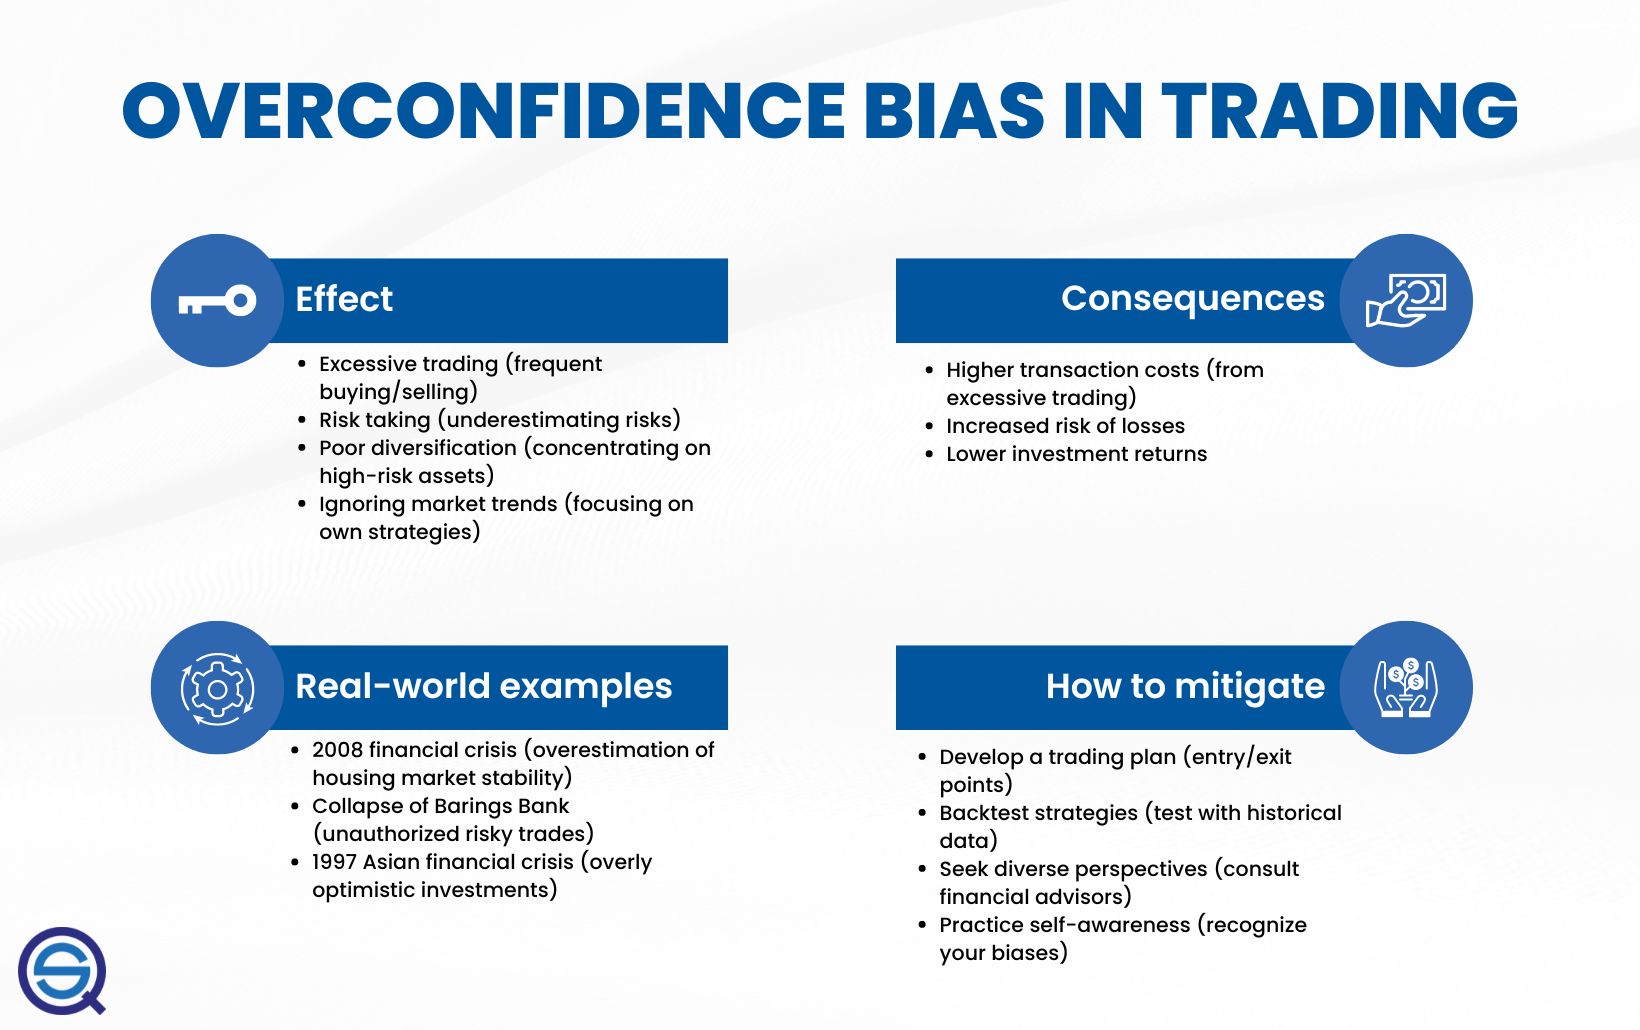
Deux boucles de renforcement sont faciles à manquer.
La première est la confirmation à la vitesse de la machine. Un utilisateur qui apprécie une thèse haussière demande à une AI de « la mettre à l’épreuve », puis accepte inconsciemment les paragraphes haussiers restants comme une validation indépendante. La seconde est la surcouche de sentiment social. FINRA a également averti les investisseurs de ne pas trader sur la base d’outils de sentiment social sans en comprendre les limites. Lorsqu’un modèle mélange le 10-Q de la semaine dernière avec les publications de ce matin et s’exprime d’une seule voix, l’utilisateur ne peut pas voir quelle couche motive réellement l’avis.
L’atténuation est opérationnelle, non motivationnelle :
- Rédigez le plan de trading avant d’ouvrir l’AI, y compris le niveau d’invalidation.
- Exigez de l’outil qu’il liste ce qui lui ferait changer d’avis.
- Limitez la taille de toute idée dont les principales données d’entrée ne comportent pas d’horodatage.
- Préférez les sessions de révision aux requêtes ponctuelles du type « que devrais-je acheter ? ».
- Traitez les signaux catégoriques des bots et produits de score comme des hypothèses, et non comme des instructions.
Deloitte a présenté le risque d’hallucination dans les travaux financiers à forts enjeux comme une source de mauvaises décisions, de pertes et de dommages réputationnels. Pour un compte individuel, le dommage réputationnel est personnel : une succession de décisions sûres d’elles mais légèrement tardives, qui semblent disciplinées dans le journal de chat et aléatoires dans le registre d’ordres.
Comment les investisseurs peuvent-ils vérifier si un outil boursier par AI utilise des données actuelles ?
Vous vérifiez la fraîcheur en ramenant chaque chiffre important à une source primaire et à une heure de référence, puis en observant si l’outil coopère ou élude la demande. Un produit incapable de réaliser cet exercice n’est pas « approximatif ». Il n’est pas auditable.
Une courte séquence de vérification qui fonctionne chez les différents fournisseurs :
- Demandez l’horloge. « Quels sont la date et l’heure de référence, le fuseau horaire et l’état de la séance pour chaque prix et estimation utilisés ? »
- Récupérez de nouveau la source primaire. Ouvrez le dernier 10-K, 10-Q, 8-K ou communiqué de résultats de l’entreprise sur le site de la SEC et vérifiez le chiffre d’affaires, les prévisions, le nombre d’actions et la dette.
- Vérifiez le marché indépendamment. Comparez le dernier prix et volume donnés par l’outil avec votre courtier ou une page de données de marché à laquelle vous faites déjà confiance.
- Mettez l’écart à l’épreuve. Si le dépôt date de trois jours et que l’action a évolué de 9 % à la suite d’une publication d’un pair, demandez à l’outil de reconstruire la thèse en considérant ce mouvement comme acquis.
- Surveillez les verbes. Les affirmations au présent au sujet d’une publication que l’entreprise n’a pas encore faite constituent un échec catégorique.
Sur le Fundamental Stock Analyst de Jenova, la même séquence doit devenir une habitude de première session plutôt qu’un supplément facultatif :
- Ouvrez l’Agent et indiquez le ticker, la décision et le niveau de preuve exigé.
- Utilisez une requête qui interdit la certitude non sourcée :
« Je détiens 180 actions JPM et je décide si je dois renforcer avant la prochaine date de résultats. Utilise uniquement des dépôts sourcés, des publications officielles et des estimations clairement datées. Commence par l’âge des données. Donne ensuite la valorisation par rapport à l’historique et aux pairs. Termine par ce que tu ne sais pas. »
- Enregistrez la note pendant la session afin qu’une mise à jour ultérieure puisse la comparer, plutôt que de générer un nouveau monologue.
- Si la question concerne en réalité la tendance, le volume ou la structure de marché, passez au Technical Stock Analyst plutôt que de demander à un Agent fondamental d’inventer un avis graphique.
Pour un terminal tel que TrendSpider, la vérification doit naturellement être différente. Confirmez que l’horodatage, la séance et le paramètre ajusté/non ajusté du graphique correspondent au contrat que vous pensez trader, puis effectuez un backtest de la règle au lieu de faire confiance à un seul niveau tracé automatiquement. Pour Danelfin ou Tickeron, ne « vérifiez » pas le score. Vérifiez les données d’entrée visibles, et traitez le score comme une probabilité a posteriori compressée reposant sur des hypothèses non publiées.
Si un produit répond aux questions de fraîcheur par une image de marque — « alimenté par AI », « qualité institutionnelle », « intelligence en temps réel » — arrêtez-vous. Ce langage appartient au même univers que celui visé par la SEC lorsqu’elle a déclaré que les conseillers ne doivent pas prétendre utiliser des modèles d’AI qu’ils n’utilisent pas réellement.
Quand un rapport instantané par AI suffit-il, et quand avez-vous besoin d’une session de recherche en direct ?
Un rapport instantané suffit lorsque la décision est lente, que les données sont officielles et qu’aucune information importante n’a été publiée depuis la date du document ; une session en direct est nécessaire lorsque le prix, les nouvelles ou le positionnement peuvent modifier la thèse avant que vous agissiez. La plupart des déceptions liées aux outils boursiers par AI proviennent de l’utilisation d’une interface instantanée pour répondre à une question en direct.
Les travaux adaptés à un instantané incluent la lecture de la description d’activité d’un 10-K, la reconstitution historique d’une structure de marges, la comparaison de la politique déclarée d’allocation du capital sur plusieurs années ou la préparation de questions pour une conférence de résultats. Ces tâches sont complètes du point de vue des dépôts. Leur vérité n’expire pas à 10 h 31.
Le travail nécessitant une session en direct inclut le trading autour d’une publication, le dimensionnement d’une position après un gap, l’interprétation d’une fuite intrajournalière sur les prévisions ou l’actualisation d’un portefeuille après un mouvement sectoriel généralisé. Les analyses de précision des outils boursiers par AI en 2025 soulignaient déjà que les résultats varient selon l’outil, les sources de données et la manière dont l’utilisateur les applique. Cette phrase est plus précise qu’elle n’en a l’air. La « manière de l’utiliser » comprend le fait de savoir si l’utilisateur pose une question documentaire ou une question de marché.
Une règle simple :
- Si l’invalidation est une phrase figurant dans un dépôt, un instantané daté peut suffire.
- Si l’invalidation est une cotation, une suspension, une déclaration de la Fed ou un gap chez un pair, vous avez besoin d’une session capable de récupérer de nouvelles données et de réviser la thèse.
- Si vous ne savez pas dans quelle situation vous vous trouvez, supposez que vous avez besoin du direct jusqu’à preuve du contraire.
La conception de Jenova est plus proche de la session en direct : mémoire persistante, accès multi-modèles et outils de recherche pouvant être invoqués de nouveau lorsque les faits changent. C’est un avantage pour le suivi des thèses. Ce n’est pas un avantage pour quelqu’un recherchant un scanner prêt à l’emploi, et cela ne crée pas un historique de ticks natif des bourses. Trade Ideas et TrendSpider restent plus naturels lorsque l’objet est une configuration pour la séance suivante. Danelfin reste plus naturel lorsque l’objet est un univers classé. Faire correspondre l’objet à l’interface empêche l’écart latence-certitude de s’ouvrir dès le départ.
Que disent les praticiens des données de marché sur la certitude de l’AI et les flux différés ?
Les praticiens situés entre les Agents de recherche et les données de marché reviennent toujours au même point : la sortie nuisible n’est pas un adjectif erroné, mais un fait tardif énoncé avec la grammaire d’une salle de marché en direct.
« Le schéma que nous observons le plus souvent n’est pas que les modèles sont incapables de prudence. C’est que la plupart des interfaces actions ne leur demandent jamais d’être prudents. Un cours différé associé à un modèle entraîné à l’exhaustivité produira un paragraphe qui sonne comme une note de réunion matinale. L’utilisateur retient la conviction et oublie que personne n’a indiqué l’heure de référence. Dans les sessions utilisateurs, imposer une première phrase indiquant l’âge des données et les données manquantes réduit davantage les mauvaises transactions que l’ajout d’un facteur supplémentaire à un score. »
« Nous voyons également des équipes confondre le routage des modèles et l’architecture des données. Passer d’un modèle de pointe à un autre ne rend pas plus récent un fichier d’estimations mis en cache. Si votre couche de récupération ne peut pas vous dire si la dernière cotation provient de l’enchère, d’un instantané différé d’un fournisseur ou d’un digest hebdomadaire, l’Agent effectue une revue documentaire, non une analyse de marché. Cela peut tout de même être utile — mais uniquement si le produit le dit. »
« L’autre défaillance est le silence face aux changements de régime. Lorsqu’une volatilité, une suspension ou un choc de politique économique fait sortir le marché du cadre pour lequel les caractéristiques ont été conçues, un système calibré devrait élargir les intervalles ou refuser de se prononcer. De nombreux outils destinés au grand public font l’inverse. Ils conservent la même structure de phrase et remplacent simplement le ticker. C’est ainsi que la surconfiance s’automatise. »
— Équipe produit Jenova, conception d’Agents de recherche par AI, huit ans d’expérience en infrastructure d’Agents pour les flux de travail professionnels
Cette vision est cohérente avec le dossier officiel. La déclaration de 2024 de Gary Gensler, président de la SEC, concernant les cas Delphia et Global Predictions était explicite : les nouvelles technologies suscitent de l’engouement, et les fausses affirmations suivent cet engouement. Elle est aussi cohérente avec les faits relatifs à la structure de marché. Les travaux de Goehmann à la LSE plaident pour davantage de transparence sur la qualité des données — horodatages, anomalies, certification — plutôt que de traiter l’algorithme comme le seul objet de préoccupation. Pour un investisseur particulier, la traduction pratique est simple. Exigez l’horloge. Exigez la source. Considérez toute certitude non étayée comme un défaut.
Références
- Aveni — Hallucinations d’AI dans les services financiers, y compris les taux d’erreur signalés pour les requêtes financières
- London School of Economics — Prévalence du trading algorithmique, Flash Crash de 2010 et risque d’erreurs de données
- Accedia — Gestion de la qualité des données financières et données obsolètes comme moteur d’hallucinations d’AI
- U.S. Securities and Exchange Commission — Sanctions contre Delphia et Global Predictions pour de fausses affirmations liées à l’AI
- Investor.gov — Alerte aux investisseurs sur l’intelligence artificielle et la fraude à l’investissement
- FINRA — Applications d’AI dans le secteur des titres, y compris les limites des modèles hors de leurs conditions d’entraînement
- WallStreetZen — Comparatif 2026 des analyseurs boursiers par AI, des tarifs et du positionnement des produits
- Databricks — Définition des hallucinations d’AI comme sorties sûres d’elles mais non étayées
- ScienceDirect — Surconfiance, exactitude de l’information, volume de trading et utilité
- MDPI — Surconfiance des investisseurs, trading excessif et performance plus faible
- Investopedia — Biais de surconfiance et ses effets sur le comportement de trading
- FINRA — Alerte aux investisseurs sur les outils d’investissement fondés sur le sentiment social
- Deloitte — Risque d’hallucination, mauvaises décisions et pertes financières dans les analyses à forts enjeux
- Bika.ai — Comment la précision varie selon les outils d’analyse boursière par AI, les sources de données et l’utilisation