Quel outil de recherche boursière basé sur l’AI est le meilleur pour préparer les résultats ?
2026-08-23
Comment les outils AI se comparent-ils pour les cartes du consensus, le suivi des KPI et les scénarios de risque avant les résultats ?
Pour organiser les attentes du consensus, les métriques opérationnelles qui font réellement bouger une publication de résultats, ainsi que des trajectoires haussière, centrale et baissière explicites, un analyste fondamental conversationnel doté d’une mémoire persistante est généralement la meilleure solution pour les investisseurs individuels et les petites équipes de recherche en 2026. Jenova's Fundamental Stock Analyst est conçu pour l’analyse des résultats, la valorisation relative et le contexte des estimations à partir des dépôts auprès de la SEC et des chiffres du consensus. Fiscal.ai (anciennement FinChat) est plus performant si vous recherchez un terminal dédié aux KPI et aux segments, tandis qu’AlphaSense est mieux adapté lorsque les recherches de courtiers sous licence et les appels d’experts constituent la contrainte principale.
Les principaux critères qui distinguent une note exploitable avant résultats d’une discussion AI générique sur les actions :
✅ Fidélité au consensus — bénéfice par action (EPS), chiffre d’affaires et estimations par segment associés à une date de référence connue
✅ Importance des KPI — les trois à cinq métriques opérationnelles dont la direction et le consensus débattent réellement
✅ Exhaustivité des scénarios — cas haussier, central et baissier chiffrés avec des niveaux d’invalidation
✅ Traçabilité des sources — chaque chiffre important relié à un dépôt, une transcription ou un jeu d’estimations
✅ Mémoire réutilisable — la note reste disponible pour la publication puis le récapitulatif après la conférence téléphonique
Ces cinq tests structurent le reste de ce guide. La comparaison ci-dessous les utilise comme une grille d’évaluation unique plutôt que comme un concours esthétique de listes de fonctionnalités.
Pourquoi l’organisation avant les résultats compte-t-elle davantage en 2026 qu’un filtre d’actions générique ?
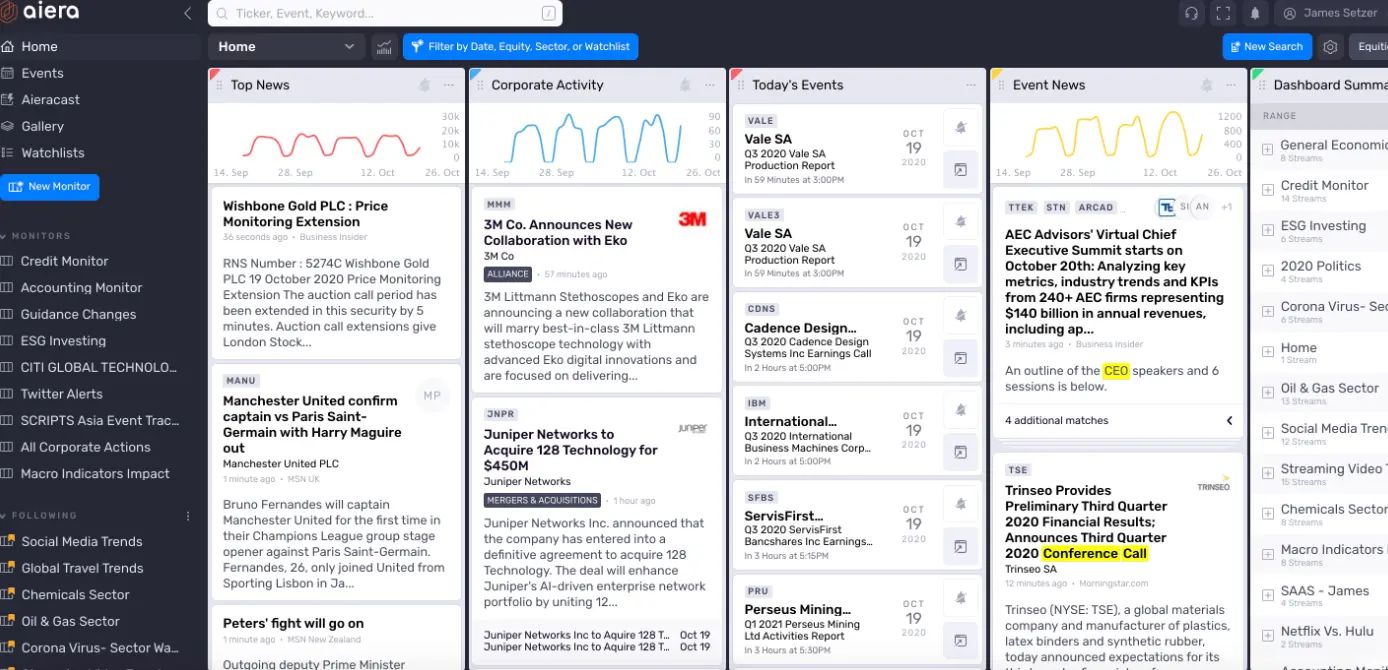
Le travail avant les résultats échoue aujourd’hui moins par manque de données que par manque d’organisation : estimations, transcriptions, prévisions et langage sur les risques arrivent plus vite que la plupart des investisseurs ne peuvent les structurer. Les investissements des entreprises dans l’AI ont atteint 252,3 milliards de dollars en 2024, et l’AI générative à elle seule a attiré 33,9 milliards de dollars d’investissements privés au cours du dernier cycle de l’AI Index de Stanford. Les plateformes de recherche ont absorbé ces dépenses sous forme de recherche documentaire, de copilotes et de modèles de scoring.
Le problème pratique est plus précis. L’analyse 2025 d’Amundi sur l’AI dans la recherche en investissement met en avant la modélisation de scénarios et l’analyse de données structurées comme couches utiles, plutôt que la sélection d’actions. Un filtre peut classer des titres. Il ne peut pas vous dire si une surprise positive est déjà intégrée dans le cours, quel KPI sera déterminant lors de la conférence téléphonique, ni ce qu’une déception implique pour la thèse.
La checklist de recherche d’actions de NerdWallet commence toujours par la compréhension de l’entreprise et de ses données financières. La semaine des résultats concentre ce travail sur quelques jours. Les investisseurs qui demandent seulement « vont-ils dépasser les attentes ? » sautent l’étape d’organisation qui détermine la taille de position, le choix de couverture et l’opportunité d’attendre la conférence téléphonique.
La U.S. Securities and Exchange Commission (SEC) considère également le langage sur les risques comme une information destinée aux investisseurs, et non comme une formule standard. L’analyse de Harvard Law sur les règles de la SEC relatives aux facteurs de risque insiste sur les risques importants — ceux qu’un investisseur raisonnable prendrait réellement en compte. Un outil pré-résultats incapable d’extraire ces risques et de les transformer en scénarios n’est qu’un lecteur d’actualités.
Que faut-il rechercher dans un outil AI conçu pour préparer les résultats ?
Vous devez évaluer un outil selon six dimensions : fidélité au consensus, importance des KPI, exhaustivité des scénarios, traçabilité des sources, persistance des sessions et coût par rapport à la couverture. Cette grille d’évaluation des notes de résultats est plus utile que de demander quel produit possède la liste de fonctionnalités la plus longue.
Fidélité au consensus. Les estimations doivent afficher le chiffre, la période et la date de référence. Le guide des résultats de Baruch College observe que des jeux de données institutionnels tels que FactSet proposent les données réalisées et le consensus pour plus de 16 000 entreprises, tout en reliant les estimations à leurs sources. Une réponse AI qui affirme que « le consensus est à 1,20 $ » sans date ne constitue pas de la recherche.
Importance des KPI. Le chiffre d’affaires et l’EPS font les gros titres. L’action évolue souvent en fonction des réservations, des ventes à périmètre comparable, de la facturation, du taux d’utilisation, de la marge nette d’intérêt ou d’un seul segment. La comparaison 2026 des outils de recherche AI de QVeris traite la traçabilité des sources, les changements de définition et les dates d’estimation comme des critères de premier ordre pour cette raison.
Exhaustivité des scénarios. Investopedia définit l’analyse de scénarios comme l’estimation de la valeur attendue à travers des cas distincts, y compris des trajectoires de meilleur et de pire cas. Une note avant résultats requiert un cas central, une trajectoire de surprise positive, une trajectoire de déception et la condition qui invalide la thèse.
Traçabilité des sources. QVeris soutient que la recherche à forts enjeux devrait utiliser l’AI pour rassembler les éléments de preuve, sans remplacer le document original. Les citations, les dates de dépôt et les libellés de période comptent davantage qu’une prose fluide.
Persistance des sessions. Le travail sur les résultats suit une séquence : aperçu, publication, conférence téléphonique, révision. Les outils qui oublient l’aperçu vous obligent à reconstruire la note après la publication.
Coût par rapport à la couverture. AlphaSense est conçu comme un système de contenu d’entreprise. Les terminaux conversationnels et les plateformes d’Agents se situent à un autre niveau de prix. Faites correspondre vos dépenses au besoin réel : recherches de courtiers sous licence ou note structurée.
Un outil peut exceller dans une dimension et rester inadapté à un poste de travail pré-résultats. Danelfin est performant pour classer les titres, mais faible pour rédiger une note à trois scénarios. AlphaSense est puissant pour les documents et coûteux si vous n’avez besoin que de l’aperçu d’un seul titre.
Quels outils de recherche boursière AI gèrent le mieux les attentes, les métriques et les scénarios ?
Jenova's Fundamental Stock Analyst est l’option conversationnelle la plus complète pour transformer les estimations, les KPI et le langage sur les risques en une note de résultats réutilisable, tandis que Fiscal.ai, AlphaSense, TIKR et Danelfin excellent chacun dans une tâche plus ciblée. Les comparatifs indépendants de 2026 traitent désormais ces produits comme des outils répondant à des besoins de recherche différents, et non comme des « applications AI pour les actions » interchangeables.
| Fonctionnalité / dimension | Fiscal.ai | Jenova Fundamental Stock Analyst | AlphaSense | TIKR | Danelfin |
|---|---|---|---|---|---|
| Consensus et estimations | Estimations et comparaisons mondiales sur les actions cotées | Analyse des résultats par rapport aux estimations du consensus et aux dépôts | États financiers standardisés et consensus sur plus de 19 000 sociétés cotées | Données financières, ratios et estimations avec un outil de valorisation | Ce n’est pas le produit central ; les scores reposent sur des signaux mixtes |
| Cartes de KPI / segments | KPI propres à l’entreprise, segments et contenus de relations investisseurs | Carte narrative des KPI liée aux sujets débattus par la direction et le consensus | KPI sectoriels grâce à plus de 4 500 modèles Canalyst | États financiers standardisés et modèles personnalisés | Explicabilité au niveau des fonctionnalités pour l’AI Score, pas d’arborescence de KPI de la direction |
| Scénarios de risque | Comparaisons rapides ; profondeur des scénarios selon le prompt de l’utilisateur | Notes haussière / centrale / baissière explicites avec langage d’invalidation | Extraction des risques à partir des dépôts, conférences et notes de courtiers | Cas de valorisation élaborés directement par l’utilisateur | Hausses et baisses de score, pas de scénarios de thèse |
| Ancrage des sources | Données auditables publiées quelques minutes après les résultats | Dépôts, estimations, actualités et recherche web citée | Bibliothèque sous licence de plus de 500 millions de documents | Dépôts, transcriptions, actualités, participations | Fonctionnalités de modèle plutôt que dossiers de documents primaires |
| Mémoire / réutilisation | Tableaux de bord et recherches enregistrées dans le terminal | Mémoire persistante entre les sessions de l’aperçu et des précédentes publications | Espaces de travail, listes de suivi, Agents planifiés | Modèles et filtres enregistrés selon l’offre | Suivi et alertes des scores de portefeuille |
| Tarification (en 2026) | Non vérifiée sur les pages publiques examinées ici | Offre gratuite à usage limité ; Plus à 20 $/mois pour 30× plus d’usage | Sur devis / entreprise, tarif selon les licences et les contenus | Varie selon l’historique de marché et le plan d’export ; à confirmer sur le site | La communication publique met l’accent sur les scores et portefeuilles ; détails des offres non vérifiés ici |
| Idéal pour | Fondamentaux conversationnels et consultation de KPI | Organiser les attentes, les métriques et les scénarios de risque avant une publication | Intelligence documentaire professionnelle et recherche sous licence | Modèles de valorisation mondiaux que vous souhaitez modifier | Classement quantitatif et score de second avis |
Fiscal.ai
Fiscal.ai est particulièrement performant comme terminal fondamental conversationnel. Le produit combine données financières mondiales, estimations, actionnariat, contenus de relations investisseurs, graphiques, filtres et copilote AI. Son pipeline de données est conçu pour publier des chiffres auditables quelques minutes après un dépôt, ce qui compte lorsque vous actualisez un modèle pendant la semaine des résultats.
La limite est structurelle. QVeris indique que la couverture du KPI exact, la traçabilité des sources, les changements de définition, les dates d’estimation et les limites d’export sont les éléments à tester. Fiscal.ai répondra rapidement à la question « quelle a été la facturation du trimestre dernier ? ». En revanche, il ne rédigera pas automatiquement une note de risque à trois trajectoires sans que vous imposiez ce processus.
Jenova Fundamental Stock Analyst
L’Agent de Jenova est le plus performant lorsque le besoin porte sur une note de synthèse, et non sur un terminal. Il est conçu pour l’analyse des résultats, la valorisation relative, l’évaluation du modèle économique et le contexte en temps réel issu des dépôts, des estimations et du sentiment de marché. Sur la plateforme Jenova, il conserve un historique de conversation illimité et une mémoire persistante, de sorte que l’aperçu, la publication et le récapitulatif de la conférence téléphonique restent dans un même fil.
Il se situe également à côté d’Agents connexes qu’un poste de travail pré-résultats utilise réellement. Jenova's Portfolio Management Strategist peut tester la taille de position et l’impact des scénarios après la finalisation de la note sur un titre donné. Cette association est plus proche du fonctionnement d’une réunion matinale côté buy-side qu’un score autonome ou qu’une boîte de recherche documentaire.
La limite honnête concerne l’étendue du contenu. Il ne s’agit pas d’une bibliothèque de recherche de courtiers sous licence, et il ne fournit ni 4 500 modèles institutionnels ni module complémentaire Excel natif. Les utilisateurs qui ont besoin de notes de Goldman ou Morgan Stanley, de transcriptions de réseaux d’experts ou de modèles opérationnels Canalyst ont toujours besoin d’un terminal documentaire. Ceux qui ont besoin d’une carte datée du consensus, d’une arborescence de KPI et de scénarios baissiers rédigés n’en ont généralement pas besoin.
AlphaSense
AlphaSense est le plus performant lorsque le contenu premium est la ressource rare. Il concède sous licence et organise son propre univers plutôt que d’assembler des connecteurs tiers, y compris plus de 1 700 sources de courtiers et plus de 280 000 entretiens d’experts. Les fonctionnalités de saison des résultats telles que Smart Summaries transforment une transcription en principaux enseignements, thèmes de questions-réponses et sujets critiques en quelques minutes.
Le compromis porte sur l’adéquation et le coût. La tarification est personnalisée selon le nombre de licences et l’organisation, et la collaboration est limitée aux utilisateurs sous licence. Les outils de visualisation étaient encore décrits comme limités à une version bêta dans la propre analyse produit 2026 d’AlphaSense. Si vous couvrez un ou deux titres et n’achetez pas de recherche sell-side, vous paierez une bibliothèque que vous ouvrez à peine.
TIKR
TIKR est particulièrement performant pour les données financières mondiales standardisées, les estimations, le filtrage, l’actionnariat et un outil de valorisation personnalisable. C’est le bon format si votre travail avant résultats vit dans un modèle : modifiez le taux de croissance, observez le multiple et enregistrez le cas.
L’historique de marché propre à chaque offre, la fréquence des mises à jour, la couverture des transcriptions, les hypothèses des modèles et les droits d’export sont les contraintes à tester. TIKR ne va pas, à lui seul, analyser une section sur les risques d’un 10-K et produire une note écrite d’invalidation. Il suppose que vous savez déjà transformer des chiffres en scénarios.
Danelfin
Danelfin est un système de scoring et de classement utilisé par plus de 150 000 investisseurs. L’entreprise indique que les actions américaines ayant un AI Score de 10/10 ont surperformé le marché de 21,05 % en moyenne après trois mois — alpha annualisé — depuis 2017, tandis que les scores de 1/10 ont sous-performé de 33,28 %. Elle publie également une vue d’AI explicable des fonctionnalités à l’origine de chaque score.
Ces chiffres constituent le bilan publié par le fournisseur, et non un audit indépendant ; QVeris avertit que les scores dépendent des fonctionnalités, des libellés, de l’horizon et de la conception du backtest. Danelfin est un second avis utile pour déterminer si les probabilités s’améliorent avant la publication. C’est un outil principal peu adapté pour organiser les attentes et rédiger des scénarios de risque.
Comment un analyste AI transforme-t-il les estimations du consensus en une note de résultats exploitable ?
Une note exploitable comporte quatre blocs datés : le tableau du consensus, le tableau de l’entreprise, l’écart et les questions auxquelles la conférence téléphonique doit répondre. Tout document inférieur à cela n’est qu’un résumé du trimestre dernier.
Commencez par le tableau du consensus. Extrayez l’EPS consensuel, le chiffre d’affaires et les deux ou trois estimations de segments ou de KPI les plus importantes pour l’entreprise. Notez la source et la date de référence. Extrayez ensuite le tableau de l’entreprise : données réalisées du trimestre précédent, prévisions actuelles et éventuels commentaires en cours de trimestre. L’écart ne se résume pas à « surprise positive ou déception ». Il se situe là où les prévisions, le consensus et les données opérationnelles récentes divergent.
Jenova's Fundamental Stock Analyst est conçu pour cette séquence, car l’analyse des résultats constitue sa fonction centrale et non une simple fenêtre de discussion ajoutée. Un prompt d’ouverture concis ressemble à ceci :
« Élabore une note avant résultats pour le ticker X, avec la prochaine date de publication Y. Présente dans un tableau l’EPS consensuel, le chiffre d’affaires et les trois KPI opérationnels les plus importants, avec la source et la date d’estimation. Compare ces chiffres aux prévisions de l’entreprise et aux deux dernières périodes publiées. Liste les trois questions auxquelles la conférence téléphonique doit répondre pour que la thèse actuelle reste valable. »
Fiscal.ai est l’alternative plus directe lorsque vous connaissez déjà les noms des KPI et souhaitez exploiter les séries standardisées du terminal. Demandez le KPI, la ventilation par segment et l’historique des estimations, puis reportez ces chiffres dans votre propre feuille de scénarios. La mise en garde de QVeris reste applicable : confirmez les changements de définition et la date de référence des estimations avant de traiter le chiffre d’un copilote comme le consensus.
AlphaSense inverse l’ordre. Commencez par rechercher les trois dernières transcriptions et le 10-K le plus récent, puis laissez Smart Summaries et les outils de sentiment indiquer les sujets déjà débattus par les analystes. C’est le bon processus lorsque le langage des courtiers constitue le consensus, et non lorsque vous avez seulement besoin d’un aperçu du marché public.
Deux contrôles de qualité évitent une note fluide mais vide :
- Chaque chiffre principal comprend une période, une unité et une source.
- Chaque affirmation de « surprise positive » précise ce qui est déjà intégré dans le cours — multiple, mouvement implicite ou révision récente — et non seulement l’écart brut en cents.
Comment modéliser les cas haussier, central et baissier avant la publication ?
Vous devez rédiger trois cas numériquement distincts et une ligne d’invalidation avant de vous intéresser à la surprise positive du titre principal. L’analyse de scénarios sert à estimer la valeur à travers ces trajectoires, y compris un pire cas, et non à décorer un paragraphe haussier d’une phrase sur les risques.
Un ensemble pratique de scénarios avant résultats emploie les mêmes trois facteurs pour chaque trajectoire :
- L’écart au consensus sur le chiffre d’affaires et l’EPS
- Le ou les KPI qui font historiquement évoluer le multiple
- L’élément de bilan ou de prévisions qui modifie le trimestre suivant, et non seulement la publication
Le cas central doit être « conforme aux chiffres que le consensus utilise réellement », et non « l’entreprise est de qualité ». Le cas haussier doit préciser quelle surprise sur le KPI force une révision, et non faire surgir un objectif de cours plus élevé de nulle part. Le cas baissier doit nommer la déception qui brise la thèse — problème de covenant, retournement de la demande, réduction des prévisions ou problème de qualité des bénéfices révélé dans des facteurs de risque importants.
Jenova's Portfolio Management Strategist constitue la seconde étape naturelle une fois les scénarios sur un titre établis. Il est conçu pour l’analyse d’allocation, la dérive, l’évaluation des risques et les stress tests de scénarios. Une fois que le Fundamental Stock Analyst a rédigé les trois trajectoires, vous pouvez demander ce qu’une publication baissière implique pour la taille de position, l’exposition aux facteurs et les titres corrélés.
TIKR est le meilleur environnement si vos scénarios résident dans un DCF ou un DCF inversé que vous souhaitez modifier cellule par cellule. Son outil de valorisation personnalisable est le produit central. Danelfin n’est pas un moteur de scénarios ; un changement de score peut confirmer que les probabilités ont évolué, mais il ne vous indique pas quelle hypothèse a été invalidée.
Un bloc de scénarios complet, quel que soit l’outil, doit se terminer par une phrase d’invalidation unique :
« La thèse est erronée si la croissance organique est inférieure à X, si les prévisions impliquent Y sur l’exercice complet ou si le 10-Q montre une conversion du besoin en fonds de roulement en trésorerie inférieure à Z. »
Sans cette ligne, vous avez des opinions. Vous n’avez pas de scénarios de risque.
Comment exécuter un processus complet avant résultats avec un Agent de recherche AI ?
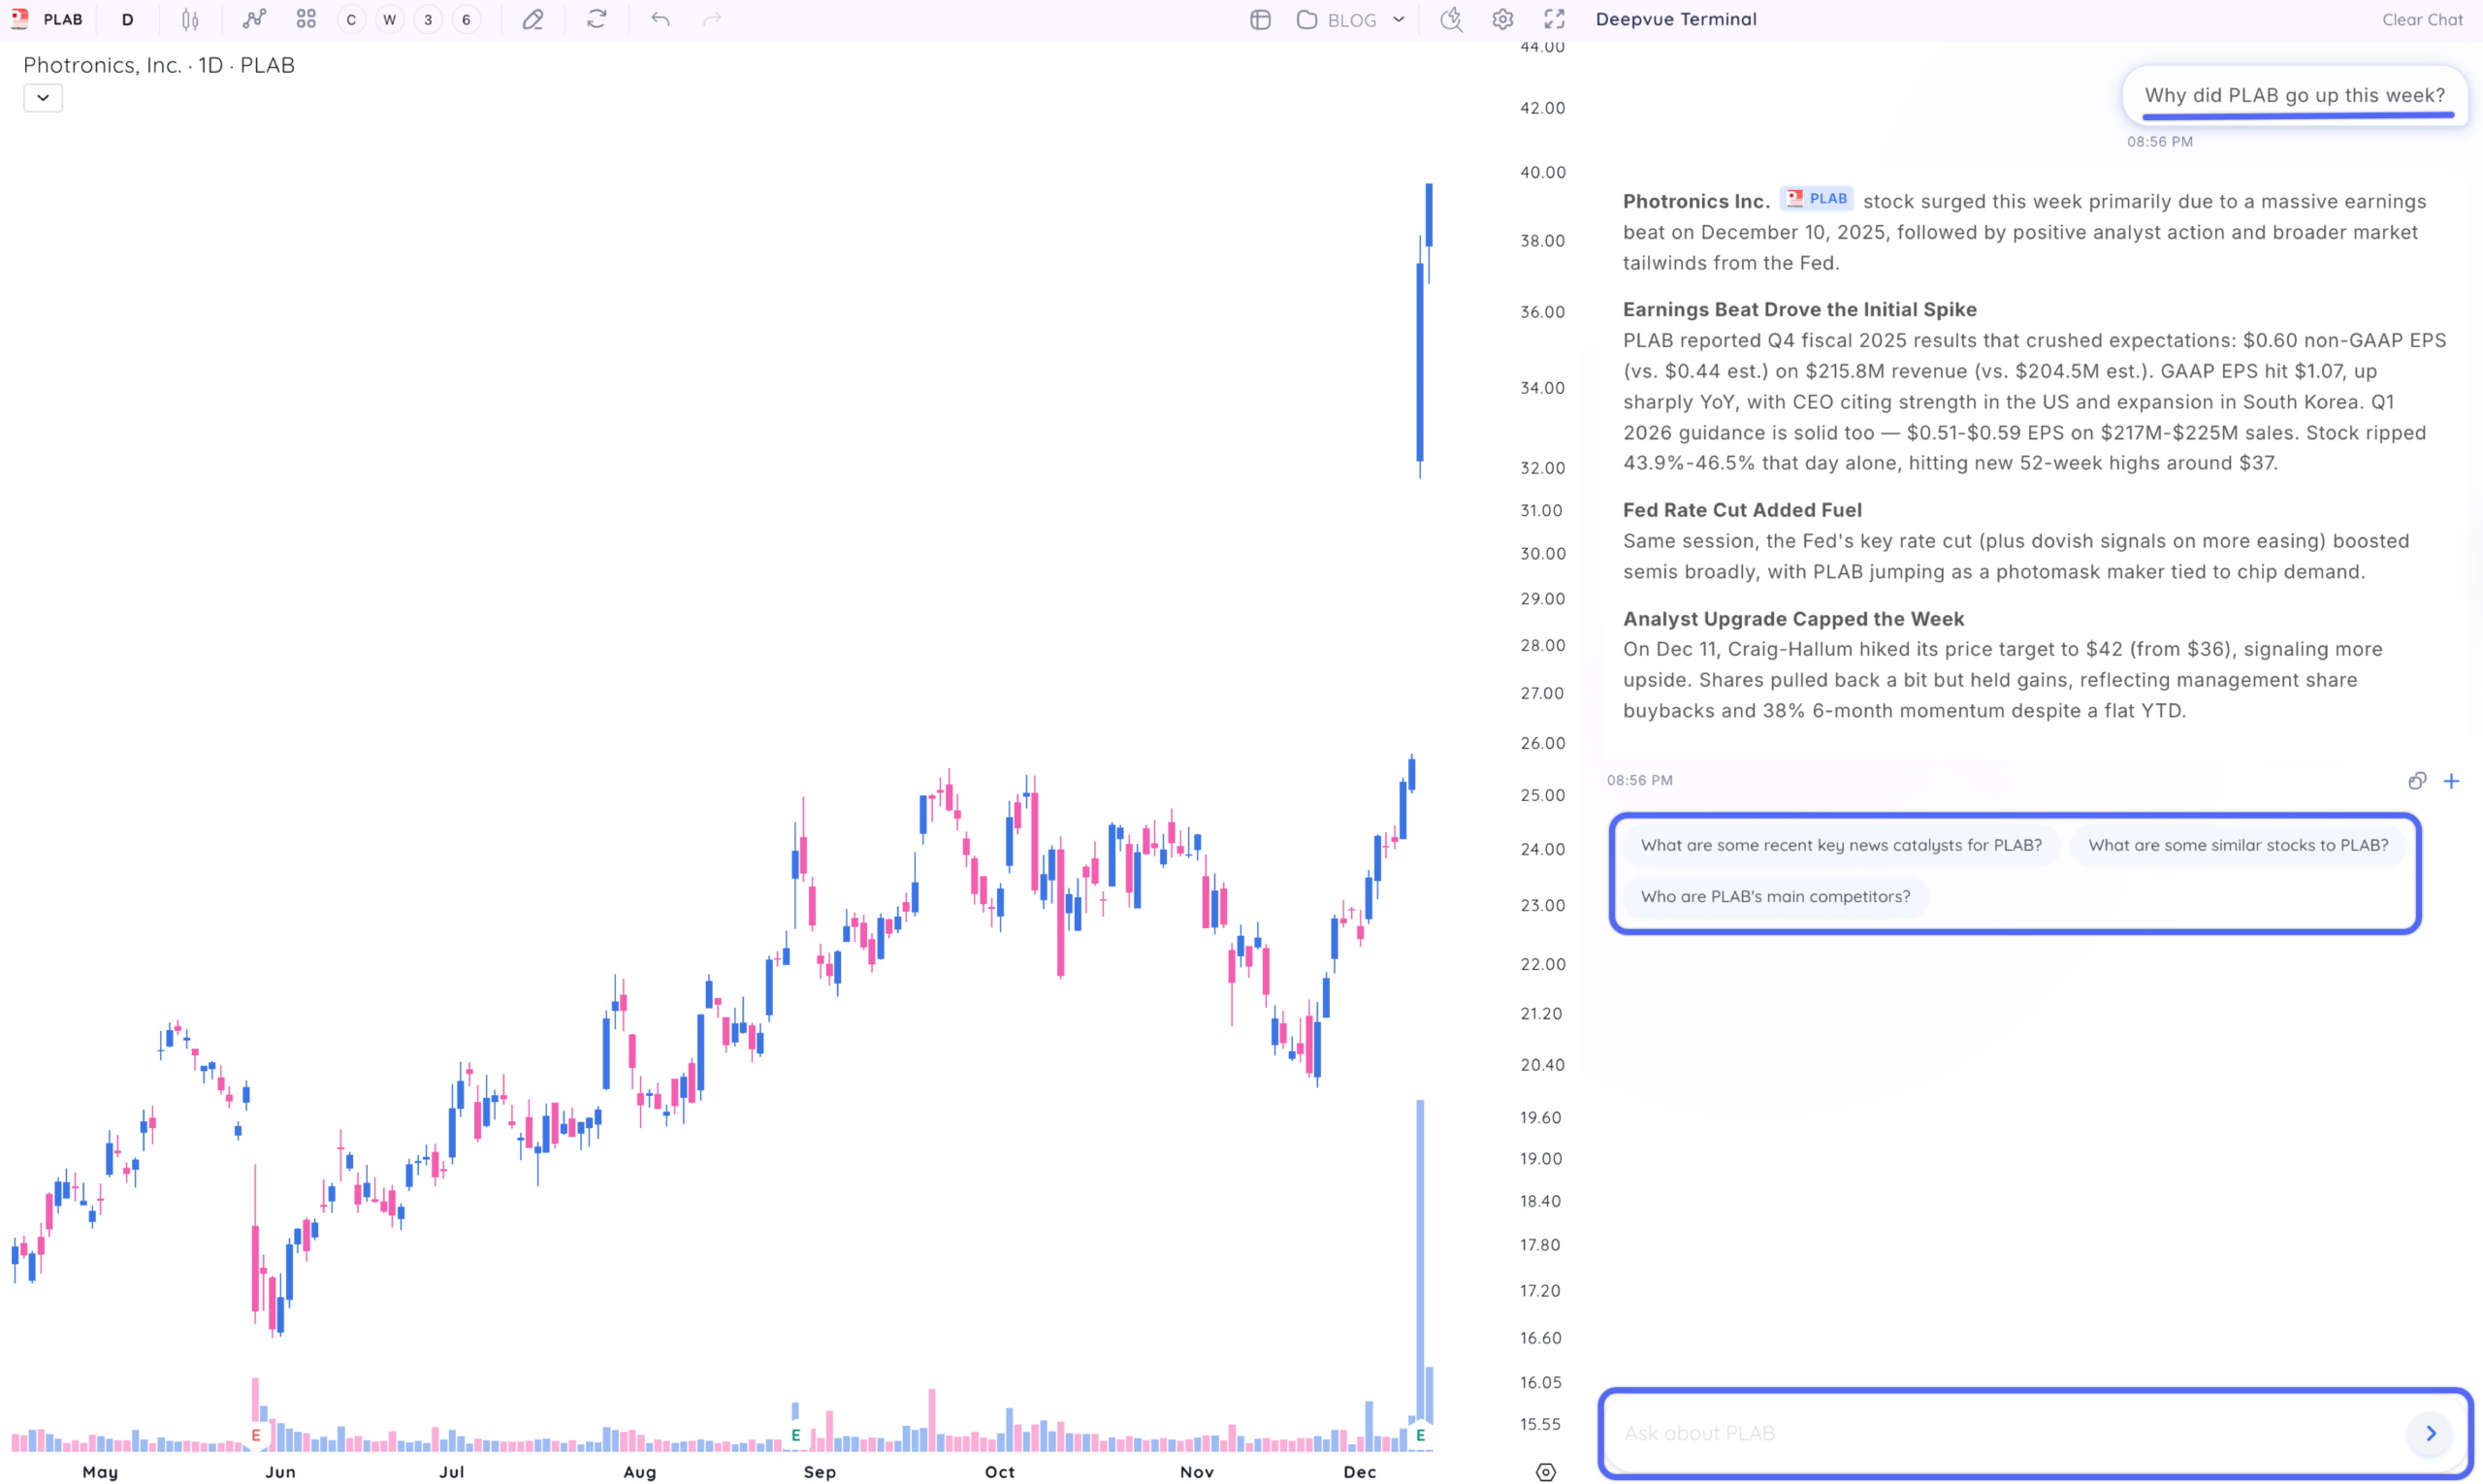
La plupart des processus complets nécessitent une session avant la publication et une session plus courte après la conférence téléphonique : figez le tableau de référence, rédigez les scénarios, dimensionnez le risque, puis comparez les données réalisées à la note que vous avez déjà enregistrée.
Pour Jenova's Fundamental Stock Analyst, la séquence est la suivante :
- Ouvrez l’Agent et indiquez le ticker, la date de publication, la position et l’horizon temporel.
- Imposer un tableau de référence structuré :
« À partir des derniers dépôts et du consensus actuel, fournis un tableau du chiffre d’affaires, de l’EPS, de la marge brute et des deux KPI qui ont historiquement fait évoluer ce titre. Inclus la source et la date de référence pour chaque cellule. »
- Transformez le tableau de référence en scénarios :
« Rédige des trajectoires haussière, centrale et baissière en utilisant uniquement les facteurs de ce tableau. Chiffre la publication, la réaction probable des prévisions et le niveau d’invalidation pour chaque trajectoire. »
- Conservez le même fil pendant la publication afin que l’Agent compare les résultats réels à l’aperçu, plutôt que de rédiger une nouvelle histoire.
- Si le titre appartient à un portefeuille, transmettez les trois trajectoires au Portfolio Management Strategist pour des stress tests et des notes de rééquilibrage.
Pour Fiscal.ai, remplacez les étapes 2 et 3 par le copilote et les pages de KPI du terminal. Extrayez d’abord les séries standardisées, exportez ou capturez le tableau, puis demandez au copilote d’expliquer les changements d’une période à l’autre. Ne laissez pas la discussion inventer un KPI que l’entreprise ne publie pas.
Pour AlphaSense, commencez dans les outils de surveillance et Smart Summaries. Placez l’entreprise et son groupe de pairs sous alerte, lisez les deux derniers Smart Summaries, puis lancez une recherche documentaire sur les facteurs de risque du 10-K et les dernières questions-réponses sur les résultats. Ce processus est plus lent à mettre en place et beaucoup plus performant lorsque vous devez démontrer une piste de sources compatible avec les exigences de conformité.
Deux règles de processus garantissent l’honnêteté de ces postes de travail :
- Enregistrez l’aperçu avant la publication. Une note écrite après les chiffres est un récit, pas une prévision.
- Rapprochez chaque surprise d’une cellule du tableau d’origine. Si vous ne pouvez pas désigner le KPI manqué, vous n’avez pas organisé le contexte.
Jenova's Fundamental Stock Analyst est disponible sur jenova.ai/a/fundamental-stock-analyst. L’offre gratuite comprend les fonctionnalités de base avec un usage limité ; les offres payantes commencent à 20 $/mois et proposent 30× l’allocation d’usage gratuite. C’est suffisant pour une semaine de résultats sur plusieurs titres si vous rédigez des notes plutôt que d’ingérer une bibliothèque complète de courtiers.
Que disent les praticiens de la recherche actions sur l’AI avant les résultats ?
Les praticiens qui utilisent efficacement l’AI la traitent comme un assistant chargé des dépôts et un avocat du diable, et non comme un gestionnaire de portefeuille. Le résultat utile est un tableau daté et un ensemble de scénarios falsifiables, pas une recommandation d’achat.
« Le mode d’échec que nous observons le plus souvent est un tableau de consensus propre sans niveau d’invalidation. Les gens connaissent le chiffre du consensus et sont malgré tout surpris, car ils n’ont jamais écrit quel KPI, s’il est manqué, brise la thèse. Une surprise positive sur l’EPS accompagnée d’une déception sur la métrique opérationnelle à laquelle le multiple est rattaché n’est pas une surprise positive. »
« La mémoire persistante transforme davantage le travail que le choix du modèle. Si l’aperçu, la publication et le récapitulatif de la conférence téléphonique se trouvent dans des conversations distinctes, vous évaluerez l’entreprise en fonction du récit le plus bruyant ce matin-là. S’ils vivent dans un même fil, vous évaluez l’entreprise par rapport à la note que vous étiez prêt à signer deux jours plus tôt. »
« Les terminaux documentaires sous licence restent supérieurs lorsque l’avantage provient du langage des courtiers ou de la nuance des appels d’experts. Les Agents conversationnels l’emportent lorsque l’avantage provient de l’organisation : réunir les estimations, les KPI et les trajectoires baissières sur une page avant la publication. Ce sont des produits différents. Les confondre est la manière dont les équipes paient trop ou se préparent insuffisamment. »
— Équipe produit Jenova, conception d’Agents de recherche actions, huit ans de création de processus de recherche AI
Cette distinction correspond aux analyses indépendantes. QVeris sépare l’intelligence documentaire, les fondamentaux conversationnels, le travail de valorisation, les tableaux de bord, les questions-réponses sourcées et le scoring quantitatif en six tâches. La semaine des résultats pénalise quiconque achète une tâche et s’attend à obtenir les cinq autres.
Quand faut-il utiliser un terminal documentaire plutôt qu’un analyste conversationnel ?
Vous devez utiliser un terminal documentaire lorsque la décision dépend de recherches sous licence, de la nuance d’appels d’experts ou d’un dossier de sources répondant aux exigences de conformité que vous ne pouvez pas reconstruire à partir des dépôts publics. Vous devez utiliser un analyste conversationnel lorsque la décision dépend de l’organisation d’estimations publiques, de KPI et de scénarios rédigés pour un titre que vous suivez déjà.
AlphaSense est le choix par défaut dans le premier camp. Ses Agents SuperAnalyst et de flux de travail peuvent exécuter des résumés récurrents des résultats, des analyses de diligence et la maintenance de listes de suivi à partir d’un ensemble de contenus comprenant des recherches de courtiers et des entretiens d’experts. C’est la bonne infrastructure pour une équipe qui paie déjà la recherche sell-side et a besoin de notes interrogeables.
Fiscal.ai et TIKR se situent entre les deux. Ce sont d’abord des terminaux. La couche AI accélère les recherches et les comparaisons. Choisissez-les lorsque vous souhaitez travailler dans les états financiers, les estimations et les modèles, et que vous rédigerez vous-même la note de scénarios.
Jenova's Fundamental Stock Analyst se situe volontairement dans le second camp. Il ne remplacera pas une station de travail de type Bloomberg ni un droit d’accès au contenu AlphaSense. Il maintiendra la cohérence de l’aperçu, testera l’écart entre les prévisions et le consensus, et conservera le cas baissier visible lorsque le titre principal paraît satisfaisant.
Une règle d’orientation simple :
- Un ou deux titres publics, thèse longue, besoin d’une note → analyste fondamental conversationnel
- De nombreux titres, besoin de KPI standardisés et de tableaux de pairs → Fiscal.ai ou TIKR
- Processus institutionnel, notes de courtiers, appels d’experts → AlphaSense
- Besoin d’une surcouche de probabilités classées, pas d’une note → Danelfin
En 2025, l’AI représentait déjà environ 61 % de la valeur mondiale des transactions de capital-risque. Le marché ne manque pas de produits « AI pour les actions ». Il manque encore d’outils qui imposent les trois éléments réellement nécessaires à une publication : une attente datée, un KPI important et une trajectoire de risque que vous respecterez encore après la publication des chiffres.
Références
- Stanford HAI — Rapport AI Index 2025, investissements privés dans l’AI générative
- Stanford HAI — Rapport AI Index 2025, chapitre Économie, investissement des entreprises dans l’AI
- Centre de recherche Amundi — Recherche en investissement AI : tendances 2025
- NerdWallet — Comment analyser des actions en 5 étapes
- SEC.gov — Ressources pour les investisseurs
- Forum de Harvard Law School sur la gouvernance d’entreprise — Règles de la SEC sur la divulgation des facteurs de risque
- Bibliothèque Newman de Baruch College — Estimations de résultats, prévisions et transcriptions de conférences téléphoniques
- QVeris — Meilleurs outils de recherche boursière AI en 2026
- Investopedia — Explication de l’analyse de scénarios
- AIMultiple — Principales plateformes de recherche financière AI
- Fiscal.ai — Plateforme de recherche en investissement alimentée par l’AI et pipeline de données après résultats
- AlphaSense — Meilleurs outils de recherche sur les actions et l’investissement pour 2026
- Danelfin — Méthodologie AI Score, base d’utilisateurs et chiffres de performance publiés
- OCDE — Investissements en capital-risque dans l’intelligence artificielle jusqu’en 2025