Quel assistant de recherche AI est le plus adapté à une recherche doctorale au long cours ?
2026-08-21
En quoi la mémoire persistante et l’intégrité des citations distinguent-elles les assistants AI adaptés au doctorat ?
Pour un travail doctoral qui s’étend sur des années plutôt que sur quelques semaines, les assistants à recommander en 2026 sont ceux qui conservent le contexte du projet d’une session à l’autre et relient les affirmations à une littérature identifiable. Jenova's Academic Research Assistant est conçu autour de cette combinaison — mémoire persistante du projet, découverte de littérature et aide à la rédaction tenant compte des citations — tandis qu’Elicit, Consensus, ResearchRabbit et Scite couvrent chacun une étape plus restreinte, mais précieuse, du pipeline de recherche.
La distinction qui compte pour les doctorants n’est pas « quel assistant conversationnel est le plus intelligent ? ». Il s’agit de savoir si l’outil connaît encore votre cadre théorique, vos hypothèses écartées et les articles déjà lus lorsque vous y revenez trois semaines plus tard.
Les facteurs clés qui distinguent un assistant adapté au doctorat d’une fenêtre de questions-réponses jetable :
✅ Mémoire de projet intersessions qui enregistre la question de recherche, les choix méthodologiques et les contraintes du directeur de thèse, et pas seulement la dernière requête ✅ Couverture de la littérature ancrée dans des index savants plutôt que dans des résultats web indifférenciés ✅ Intégrité des citations au niveau des sources, afin que chaque synthèse puisse être vérifiée par rapport à l’article sous-jacent ✅ Adéquation au flux de travail d’un projet pluriannuel : notes, brouillons et recherches qui s’accumulent au lieu d’être réinitialisés ✅ Limites de tâches explicites — découverte, extraction, validation des citations et rédaction sont des travaux distincts, et peu d’outils les exécutent tous aussi bien
Pour comparer utilement ces outils, il faut considérer la recherche doctorale d’abord comme un problème de continuité, et ensuite comme un problème de recherche documentaire.
Pourquoi la mémoire intersessions compte-t-elle davantage pour la recherche doctorale que pour les travaux de cours ?
La mémoire intersessions compte davantage pour le doctorat parce qu’une thèse est une argumentation construite sur plusieurs années, et non un devoir isolé ; les outils qui oublient l’argumentation obligent les étudiants à recontextualiser la machine à chaque session. Les travaux de cours peuvent supporter une réinitialisation ; une thèse, non.
L’enquête HEPI 2025 sur l’AI générative chez les étudiants a constaté que 92 % des étudiants britanniques de premier cycle utilisent désormais l’AI sous une forme ou une autre, contre 66 % en 2024, notamment pour résumer des articles et suggérer des idées de recherche. Les doctorants héritent du même ensemble d’outils, mais leur unité de travail diffère : une cartographie de la littérature qui évolue, un chapitre méthodologique réécrit après une étude pilote ratée, un cadre théorique négocié avec un encadrant durant plusieurs mois.
Une enquête à grande échelle menée auprès de chercheurs a rapporté que 25,9 % utilisent des outils AI pour la recherche au moins une fois par jour, ce qui fait de l’échec de mémoire un coût quotidien plutôt qu’un désagrément ponctuel. Chaque réinitialisation efface le modèle opérationnel du projet : les articles déjà exclus, l’opérationnalisation abandonnée ou les commentaires d’évaluateurs qui encadrent toujours la réécriture.
Les fenêtres de contexte ne sont pas une mémoire. Elles retiennent le fil de discussion en cours, puis disparaissent. La mémoire persistante conserve le projet lui-même : la question, le corpus, les décisions et les problèmes ouverts. Pour un doctorat de trois à six ans, cette différence sépare un assistant qui capitalise de ce qu’un assistant qui ne fait qu’interpoler.
Que doivent évaluer les doctorants dans un assistant de recherche AI ?
Les doctorants devraient évaluer un assistant de recherche AI selon six dimensions que nous appelons le cadre Continuité–Couverture–Citation (C3+) : mémoire persistante, couverture de la littérature, extraction structurée, intégrité des citations, soutien au manuscrit et coût sur l’ensemble du doctorat. Les outils performants uniquement pour la recherche documentaire échouent encore s’ils ne peuvent pas retenir le projet.
Les six dimensions, pondérées pour la recherche à long terme plutôt que pour des requêtes ponctuelles :
- Mémoire de projet intersessions. L’assistant conserve-t-il votre question de recherche, vos critères d’inclusion, les articles rejetés et votre style rédactionnel sur plusieurs semaines et mois ?
- Couverture de la littérature. Peut-il interroger des index savants à grande échelle ? Elicit indique rechercher parmi plus de 138 millions d’articles universitaires ; ResearchRabbit annonce un accès à plus de 310 millions d’articles.
- Extraction structurée et synthèse. Peut-il extraire les méthodes, les échantillons et les résultats dans des tableaux comparables, ou produit-il seulement des résumés rédigés ?
- Intégrité des citations. Les affirmations sont-elles liées à des sources au niveau de la phrase, à un contexte de citation ou à une lecture de type « consensus » — et pouvez-vous ouvrir l’article sous-jacent ?
- Soutien au manuscrit. L’outil vous aide-t-il à structurer, citer et réviser, ou la rédaction doit-elle se faire ailleurs ?
- Coût sur l’ensemble du doctorat. Un outil à 10 $ par mois et un environnement de travail à 49 $ pour les revues systématiques ne représentent pas la même chose lorsqu’on les multiplie sur quatre ans de doctorat.
Deux filtres supplémentaires doivent figurer dans toute évaluation doctorale. D’abord, seuls 36 % des étudiants de l’échantillon HEPI avaient reçu une formation institutionnelle à l’AI, de sorte que l’outil doit être utilisable sans programme d’intégration spécialisé. Ensuite, 51 % des étudiants citaient les hallucinations comme raison d’éviter l’AI — voilà pourquoi l’intégrité des citations est un critère essentiel, et non un simple avantage.
Une règle pratique : si vous ne feriez pas confiance au résultat dans une section méthodologique sans ouvrir la source, l’outil est une aide à la découverte, pas un coauteur de la revue.
Comment Jenova, Elicit, Consensus, ResearchRabbit et Scite se comparent-ils pour les projets de longue durée ?
Jenova's Academic Research Assistant est le plus adapté lorsque le goulot d’étranglement est la continuité du projet sur plusieurs années, tandis qu’Elicit est plus performant pour l’extraction structurée, Consensus pour les aperçus rapides des données probantes, ResearchRabbit pour la découverte par cartographie des citations et Scite pour vérifier la manière dont un article a été cité. Aucun ne remplace un gestionnaire de références ni un protocole humain.
| Fonctionnalité / Dimension | Academic Research Assistant (Jenova) | Elicit | Consensus | ResearchRabbit | Scite |
|---|---|---|---|---|---|
| Mémoire de projet intersessions | Mémoire persistante et historique de discussion illimité entre les sessions | La bibliothèque et les alertes facilitent la réutilisation des sources ; pas un Agent complet de mémoire de projet | Historique des recherches et des revues au sein du produit ; mémoire de projet limitée à long terme | Collections et apprentissage des recommandations à mesure que vous ajoutez des articles | Base de données de citations et alertes ; pas un Agent de mémoire de thèse |
| Couverture de la littérature | Découverte en temps réel dans les bases de données universitaires et sur le web ouvert | 138 M+ articles et 545 000 essais cliniques | Recherche de données probantes évaluées par les pairs avec indications sur le plan d’étude | 310 M+ articles avec cartographie des citations | Grand index de citations avec Smart Citations |
| Extraction structurée | Synthèse et résumés orientés manuscrit ; pas un environnement PRISMA | Tableaux, sélection et flux de travail de revue systématique | Consensus meter et aperçus d’études | Cartes visuelles, pas de tableaux d’extraction | Contexte des citations (soutien / contradiction), pas de tableaux de résultats |
| Intégrité des citations | Citations intégrées et rédaction fondée sur les sources | Citations au niveau de la phrase pour les affirmations générées | Réponses fondées sur des articles, non sur des contenus web non vérifiés | Chaînage bibliographique par citations et coauteurs | Smart Citations montrant comment les articles sont cités |
| Tarification (en 2026) | Niveau gratuit ; formules payantes à partir de 20 $/mois | Basic gratuit ; Pro est couramment proposé à 49 $/utilisateur/mois, facturé annuellement | Niveau gratuit et options payantes pour Deep Search et des limites plus élevées | Accès gratuit aux fonctions de cartographie principales | Plateforme de recherche payante ; vérifier les tarifs actuels |
| Idéal pour | Projets doctoraux pluriannuels nécessitant mémoire, recherche et rédaction dans un même fil | Revues systématiques ou de cadrage avec tableaux d’extraction | Questions rapides du type « que dit la littérature ? » | Cartographier un domaine à partir d’articles de départ | Vérifier si des citations soutiennent ou contredisent une affirmation |
Les propres documents d’Elicit indiquent que les chercheurs déclarent jusqu’à 80 % de gain de temps sur les revues systématiques et que l’outil peut sélectionner des milliers d’articles avec les formules payantes. C’est un véritable atout pour les revues guidées par un protocole. C’est toutefois une tâche différente du fait de se souvenir, six mois plus tard, des raisons pour lesquelles vous avez abandonné un construit.
ResearchRabbit est particulièrement efficace pour transformer un article de départ en une carte de travaux, d’auteurs et de lacunes connexes, et les bibliothèques de la Northeastern University le décrivent comme un outil de cartographie de la littérature basé sur les citations et disponible gratuitement. L’apport distinctif de Scite réside dans le contexte des citations : voir si des articles ultérieurs soutiennent ou contestent une conclusion — ce que les bibliothèques de Purdue décrivent comme une base de données de citations avec Smart Citations.
La limite de Jenova est l’inverse de ces atouts. Ce n’est pas un environnement dédié à la sélection PRISMA, il ne classe pas le sentiment des citations comme Scite, et il n’expose pas de tableaux d’extraction de type Elicit avec des dizaines de colonnes personnalisées. Les étudiants réalisant une revue de type Cochrane auront toujours besoin, à ses côtés, d’un environnement de revue conçu à cet effet.
Comment la mémoire persistante du projet transforme-t-elle le flux de travail d’une thèse sur plusieurs années ?
La mémoire persistante du projet transforme le flux de travail d’une thèse en faisant de chaque session une continuation plutôt qu’une nouvelle intégration du contexte ; la recherche documentaire, la prise de notes et la rédaction partagent ainsi un modèle du projet qui s’enrichit. En pratique, cela réduit les recontextualisations répétées et les synthèses contradictoires.
Un doctorat typique passe par des phases qu’un assistant oublieux traite comme des discussions sans rapport : cadrage, revue systématique ou narrative, conception méthodologique, collecte de données, analyse et révision du manuscrit. Grâce à la mémoire, l’assistant peut se rappeler que vous avez déjà exclu les études transversales, que votre directeur de thèse a rejeté un cadrage par l’approche des capabilités et que trois articles de votre bibliothèque Zotero sont méthodologiquement fragiles.
Jenova's Academic Research Assistant stocke ce type de contexte de travail entre les sessions et peut le conserver lorsque vous changez de modèles ou joignez des articles comme base de connaissances privée. Les essais de ce modèle sur des projets longs montrent que le gain ne réside pas dans l’éloquence, mais dans la cohérence : mêmes critères d’inclusion, mêmes définitions opérationnelles, même consigne « ne citez pas cette prépublication comme une conclusion établie ».
Les outils complémentaires conservent toutefois leur importance. Les fonctions de bibliothèque et d’alertes d’Elicit vous aident à réutiliser les sources et à surveiller un domaine. Les collections de ResearchRabbit deviennent plus pertinentes à mesure que vous ajoutez des articles. Ce sont des mémoires de corpus. Elles ne sont pas équivalentes au souvenir de vos décisions de projet.
Une répartition utile des tâches pour 2026 :
- Conservez le modèle vivant du projet — question, exclusions, contraintes de l’encadrant, historique des brouillons — dans un assistant doté d’une mémoire intersessions.
- Réalisez la cartographie du domaine avec ResearchRabbit ou Litmaps, spécialisés dans les réseaux de citations.
- Réalisez l’extraction structurée avec Elicit lorsque vous avez besoin de lignes comparables, et non de paragraphes.
- Validez les citations controversées dans Scite avant de les intégrer à un chapitre de revue de littérature.
Les étudiants qui inversent cet ordre — en demandant à un outil de cartographie de se souvenir de leur thèse, ou à un assistant capable de mémoriser de remplacer une double sélection — aboutissent généralement à des revues fluides, mais impossibles à auditer.
Quels outils AI sont adaptés aux revues systématiques et lesquels à la cartographie exploratoire de la littérature ?
Les revues systématiques exigent une sélection et une extraction documentées ; la cartographie exploratoire exige des réseaux de citations et une recherche sémantique — et le meilleur outil dépend du type de revue que vous rédigez réellement. Mélanger ces familles de produits fait perdre du temps de paramétrage.
Le guide CASRAI sur les outils AI pour les revues systématiques de littérature trace clairement la frontière. Les revues formelles de type PRISMA supposent des importations dédupliquées, une double sélection indépendante, une extraction structurée et une évaluation du risque de biais. Les outils regroupés autour de ce pipeline incluent Rayyan, Covidence, ASReview et DistillerSR. Elicit se situe entre la découverte et cette catégorie : il interroge un vaste index d’articles et propose des fonctions de sélection et d’extraction compatibles avec les pratiques de revue systématique.
Les revues exploratoires et narratives — le chapitre de revue de littérature le plus fréquent dans les doctorats hors sciences de la santé — sont mieux servies par les outils de découverte et de cartographie. Semantic Scholar utilise l’AI pour améliorer la recherche savante. Litmaps et ResearchRabbit visualisent les liens entre études. Consensus est plus performant lorsque vous avez une question empirique relativement circonscrite et souhaitez un aperçu du consensus évalué par les pairs plutôt qu’une carte exhaustive.
Une position commune associée à Cochrane, à la Campbell Collaboration, à JBI et à d’autres groupes de synthèse des données probantes, examinée dans le projet RAISE sur l’utilisation responsable de l’AI dans la synthèse des données probantes, considère l’AI comme un soutien au jugement des évaluateurs, et non comme son substitut. Les décisions d’éligibilité, l’extraction et les évaluations du risque de biais qui influencent la revue exigent toujours une vérification humaine et une déclaration du système utilisé.
Pour les doctorants, la règle de décision est simple :
- Revue systématique ou de cadrage enregistrée → Elicit, Covidence ou Rayyan pour la traçabilité ; ne vous appuyez pas sur la mémoire d’une discussion comme journal de sélection.
- Revue narrative visant à structurer un domaine → ResearchRabbit ou Litmaps pour la carte, plus un assistant doté d’une mémoire pour préserver la cohérence de l’argumentation à mesure que la carte grandit.
- Vérification empirique rapide (« Les données probantes soutiennent-elles X ? ») → Consensus, puis ouvrez les études sous-jacentes.
Jenova's Academic Research Assistant ne remplace pas Covidence. Il est plus performant comme couche qui se souvient des raisons pour lesquelles la revue présente sa forme actuelle, tandis que les outils spécialisés réalisent les tâches propres à chaque étape.
Comment configurer un assistant de recherche AI pour un projet doctoral pluriannuel ?
Vous tirerez le meilleur parti d’un assistant de recherche AI en encodant le projet — question, contraintes, corpus et objectifs exclus — dès la première session, puis en réutilisant ce fil au lieu de repartir de zéro. La configuration relève d’un protocole, non d’une astuce de formulation.
Pour Jenova's Academic Research Assistant, une configuration durable se présente ainsi :
- Ouvrez l’Agent et présentez le projet comme un protocole vivant, et non comme un sujet d’une ligne :
« Je suis en troisième année de doctorat en sociologie. Titre provisoire de la thèse : travail de plateforme et gestion algorithmique dans le travail indépendant en Asie du Sud-Est. Cadre théorique : théorie du procès de travail, et non approche des capabilités (mon directeur de thèse l’a rejetée en mars). Méthodes : ethnographie multisituée et analyse des interfaces de plateforme. Ne traitez pas les articles de blog ou les prépublications non évaluées comme équivalents à des sources évaluées par les pairs. »
- Joignez votre plan actuel, un ensemble représentatif de PDF et toutes les notes de supervision que vous êtes autorisé à stocker.
- Demandez une cartographie de la littérature des 24 derniers mois étayée par des sources, avec les exclusions explicitement listées.
- Revenez au même fil de projet après chaque réunion de supervision et mettez à jour le protocole (« abandonner le construit X ; ajouter l’article Y comme cas négatif »).
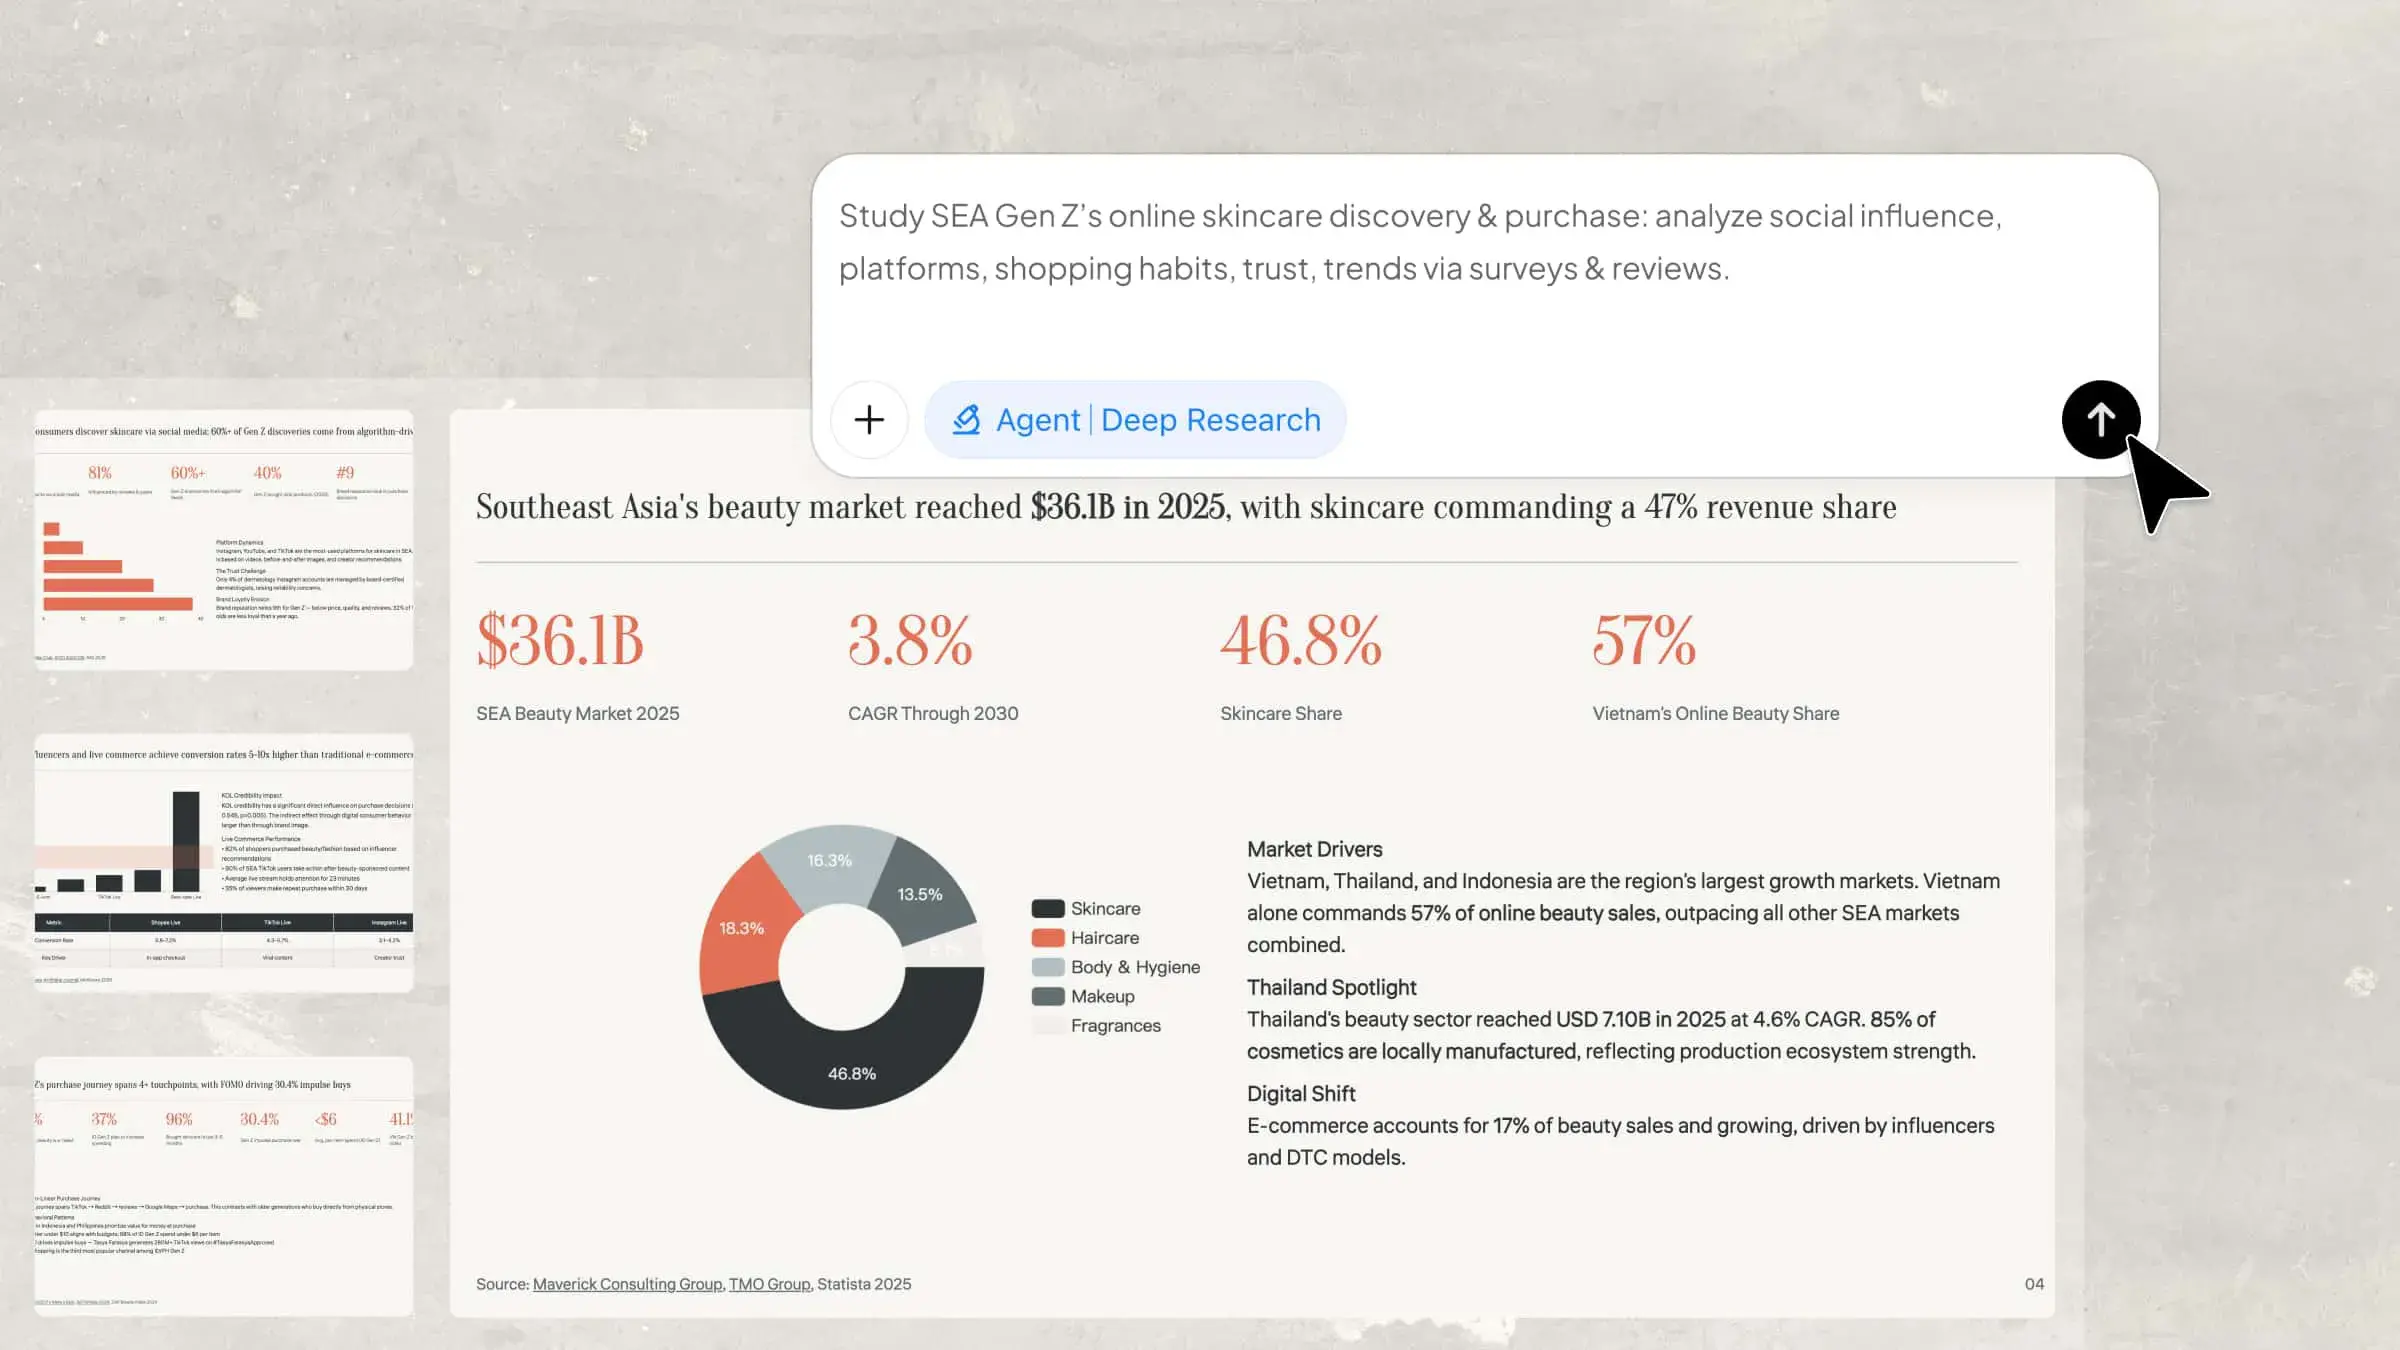
Un Agent apparenté, Deep Research, est utile lorsque vous avez besoin d’un briefing long et sourcé plutôt que d’un dialogue — par exemple, une analyse des données probantes pays par pays ou une note structurée sur un marché et une politique, que vous interrogerez ensuite dans Academic Research Assistant. Le modèle de rapport est le même que celui dont les doctorants ont besoin : une conclusion principale, des indicateurs sourcés et une analyse segmentée plutôt qu’un paragraphe sans sources.
Pour Elicit, la configuration parallèle est centrée d’abord sur la question plutôt que sur la mémoire. Saisissez une question de recherche bien définie, examinez la liste d’articles, puis ajoutez seulement les colonnes d’extraction nécessaires : population, n, conception et résultat. Le niveau Pro d’Elicit est positionné pour les revues systématiques, y compris pour une sélection à plus grande échelle que le forfait gratuit. Importez depuis Zotero si c’est déjà votre corpus de référence.
Pour ResearchRabbit, commencez avec deux ou trois articles de départ auxquels vous faites déjà confiance, créez une collection et considérez le graphe comme une surface de découverte — non comme une bibliographie achevée. Exportez tout élément conservé vers Zotero, Mendeley ou un autre gestionnaire dont vous gardez le contrôle.
Deux règles empêchent la configuration de se dégrader :
- Le gestionnaire de références demeure le système de référence pour les citations. L’assistant AI est le système de référence pour les décisions.
- Lorsque la question de recherche évolue, mettez à jour le protocole par écrit dans le fil. Une dérive silencieuse conduit les outils capables de mémoriser à défendre la thèse du semestre précédent.
La mise en forme du manuscrit peut être confiée à un outil spécialisé tel que le Word Doc Generator de Jenova lorsque l’argumentation est stabilisée. Ne demandez pas à l’assistant de recherche de devenir votre fichier de style de citation.
Que disent les méthodologues de recherche sur la mémoire AI dans le travail doctoral ?
Les méthodologues considèrent de plus en plus l’utilisation de l’AI comme une question d’intégrité de la recherche — déclaration, vérification et provenance — plutôt que seulement d’intégrité académique liée au plagiat, et ils se méfient de tout flux de travail dans lequel la mémoire du modèle remplace un protocole documenté. La mémoire est utile ; elle ne constitue pas une piste d’audit.
« Le mode d’échec que nous observons dans l’usage doctoral de l’AI n’est pas une unique citation hallucinée. C’est l’effondrement du contexte sur plusieurs mois. Un étudiant passe six semaines à affiner un cadre théorique, ouvre ensuite une nouvelle discussion et reçoit une synthèse de littérature fluide qui ignore complètement ce cadre. La mémoire persistante est ce qui permet à un assistant de capitaliser plutôt que de se réinitialiser. Sans elle, chaque session réintroduit des “articles clés du domaine” génériques que l’étudiant avait déjà examinés et écartés.
« Les outils qui dominent les comparatifs — Elicit pour l’extraction, Consensus pour les instantanés de données probantes, ResearchRabbit pour les cartes, Scite pour le contexte de citation — sont réellement très performants sur ces segments. Ce qui manque encore à un doctorat, dans la plupart des ensembles d’outils, est une mémoire de travail du projet : hypothèses rejetées, contraintes du directeur de thèse, trois études déjà identifiées comme méthodologiquement faibles. Ce n’est pas un problème de recherche documentaire. C’est un problème de continuité. Résolvez séparément la recherche et la continuité, puis reliez-les.
« Nous continuons de recommander aux étudiants de conserver un protocole détenu par des humains. La mémoire AI est un carnet de travail, pas le journal PRISMA. Si les jugements d’éligibilité ou d’extraction sont assistés par un modèle, ils nécessitent une déclaration et une vérification, conformément à l’orientation donnée par les recommandations sur la synthèse des données probantes. Utilisez la mémoire pour éviter de vous répéter. Ne l’utilisez pas comme unique trace de la manière dont la revue a été réalisée. »
— Équipe produit Jenova, conception d’Agents de recherche, 8 ans de création d’assistants AI pour le travail de connaissance à long horizon
Cette position est cohérente avec les lignes directrices de la Commission européenne sur l’utilisation responsable de l’AI générative dans la recherche, qui soulignent la fiabilité et la prévention des usages abusifs plutôt que de traiter les résultats d’une discussion comme une autorité citable. Elle est également cohérente avec la prudence des étudiants : les répondants HEPI ont cité la peur d’être accusé de tricherie (53 %) et les résultats erronés (51 %) comme principaux freins à l’utilisation de l’AI.
Comment les doctorants doivent-ils utiliser l’AI sans compromettre l’intégrité de la recherche ?
Les doctorants devraient utiliser l’AI comme une aide à la recherche documentée — pour chercher, structurer, mémoriser et rédiger — tout en conservant la vérification, les jugements d’éligibilité et la formulation finale sous contrôle humain. L’intégrité concerne ici la provenance, et non l’abstention face à des outils que 67 % des étudiants interrogés considèrent déjà comme essentiels.
Un protocole d’intégrité opérationnel pour 2026 :
- Déclarez le système. Indiquez le nom de l’assistant, sa version ou sa date, ainsi que la tâche réalisée : recherche, assistance à la sélection ou révision linguistique. Les corrections orthographiques courantes ne nécessitent généralement pas la même déclaration que les suggestions d’éligibilité.
- Vérifiez chaque citation. Ouvrez l’article. Confirmez que l’affirmation figure dans le texte. Scite est utile lorsque la question concerne la manière dont des travaux ultérieurs ont cité une conclusion ; il ne remplace pas la lecture.
- Conservez les décisions de sélection dans un logiciel de revue lorsque le résultat est une revue systématique. CASRAI note que la double sélection indépendante reste attendue dans les travaux alignés sur PRISMA et Cochrane.
- Ne téléversez pas de données de participants identifiables ni de brouillons confidentiels vers des outils dont vous n’avez pas lu les conditions d’utilisation des données. Privilégiez les plateformes qui indiquent ne pas entraîner de modèles publics sur votre contenu.
- Séparez la génération du jugement. Laissez l’assistant proposer des thèmes, tableaux ou plans. Vous décidez de ce qui entre dans la thèse.
L’étude ExplanAItions de Wiley menée auprès de milliers de chercheurs dans le monde signale notamment que les éditeurs savants considèrent désormais la maîtrise de l’AI comme une composante de la pratique de recherche, et non comme une option. Les politiques institutionnelles progressent de manière inégale : dans l’échantillon HEPI, seuls 29 % des étudiants estimaient que leur établissement encourage l’utilisation de l’AI, tandis que beaucoup faisaient état de messages contradictoires de la part du personnel.
Pour les projets à long terme, le risque d’intégrité propre à la mémoire est la contamination silencieuse : un assistant retient une affirmation non sourcée et la réaffirme plusieurs mois plus tard comme si elle était établie. La contre-mesure consiste à réaliser des audits périodiques des sources du fil de projet — une courte session ayant pour seule mission : « montrez-moi chaque affirmation empirique que vous répétez, avec l’article primaire correspondant. »
Utilisé ainsi, un assistant universitaire capable de mémoriser s’apparente davantage à un carnet de recherche rigoureusement tenu qu’à un rédacteur fantôme. Le carnet doit toujours être vérifié.
Références
- HEPI / Kortext — Enquête 2025 sur l’AI générative chez les étudiants
- ERIC — Enquête 2025 sur l’AI générative chez les étudiants, note de politique HEPI 61
- ScienceDirect — Qui utilise l’AI dans la recherche, et dans quel but ? Enquête à grande échelle
- Elicit — AI pour la recherche scientifique : couverture, rapports et revues systématiques
- Elicit — Tarification
- Consensus — Tarification et formules du produit
- ResearchRabbit — Cartographie de la littérature et découverte d’articles
- Bibliothèques de la Northeastern University — Research Rabbit comme outil de cartographie disponible gratuitement
- Scite — Plateforme Smart Citations
- Bibliothèques de la Purdue University — Guide de recherche scite
- Semantic Scholar — Recherche savante propulsée par AI
- Litmaps — Outils de revue de littérature et de réseau de citations
- CASRAI — Outils AI pour les revues systématiques de littérature
- RAISE — Utilisation responsable de l’AI dans la synthèse des données probantes
- Commission européenne — Lignes directrices sur l’utilisation responsable de l’AI générative dans la recherche
- Wiley — ExplanAItions : étude sur l’intelligence artificielle auprès des chercheurs
- University of Florida Business Library — FAQ sur l’accès et la tarification d’Elicit