Quelle plateforme AI est la meilleure pour la recherche web et académique en temps réel ?
2026-08-21
Comment la couverture des sources, le choix des modèles et la profondeur des citations distinguent-ils les plateformes de recherche AI ?
La recommandation la plus pertinente pour les chercheurs qui ont besoin à la fois de preuves issues du web en direct et de littérature académique en 2026 est une plateforme multi-modèles telle que Jenova, à évaluer aux côtés de Perplexity Deep Research, de Gemini Deep Research, de ChatGPT Deep Research et d’Elicit. Le classement dépend moins de la marque que de trois capacités distinctes : l’étendue des recherches possibles avec l’outil, la possibilité de changer de modèle en cours de tâche et le degré de rattachement de chaque affirmation à une source.
Les facteurs clés qui distinguent une plateforme de recherche utilisable d’une fenêtre de chat avec un plugin de recherche :
✅ Couverture de deux corpus — le même flux de travail doit atteindre le web en direct (actualités, forums, dépôts, pages produits) et les bases de données académiques, et non l’un ou l’autre. ✅ Flexibilité des modèles — la qualité de la synthèse évolue lorsque vous pouvez faire passer une tâche d’un modèle de récupération rapide à un modèle de raisonnement rigoureux sans coller le contexte dans un second produit. ✅ Profondeur des citations — l’ancrage au niveau de chaque phrase et des listes de sources exportables comptent davantage qu’une prose fluide, notamment pour les manuscrits et les audits préalables. ✅ Persistance des sessions — les revues de littérature s’étalent sur plusieurs jours ; les outils qui oublient les critères d’inclusion pendant la nuit imposent un criblage en double. ✅ Adéquation honnête à la tâche — l’extraction pour une revue systématique, la cartographie des réseaux de citations et les synthèses web rapides sont des travaux différents, et aucun produit ne domine les trois.
Pour comparer ces outils sans les réduire à une liste générique d’« AI pour la recherche », il est utile d’utiliser le cadre Couverture–Contrôle–Citation : ce que le système peut voir, dans quelle mesure vous pouvez l’orienter, et si un tiers peut vérifier le résultat.
Pourquoi la recherche web en temps réel et la recherche académique se sont-elles divisées en catégories distinctes d’outils AI ?
La recherche web en direct et la recherche académique se sont divisées parce qu’elles optimisent des modes de défaillance différents : les outils web échouent lorsqu’ils manquent d’actualité ou citent des pages de mauvaise qualité, tandis que les outils académiques échouent lorsqu’ils omettent les méthodes, la taille des échantillons ou des résultats contradictoires. Cette séparation constitue désormais une catégorie de produits, et non une simple habitude des utilisateurs.
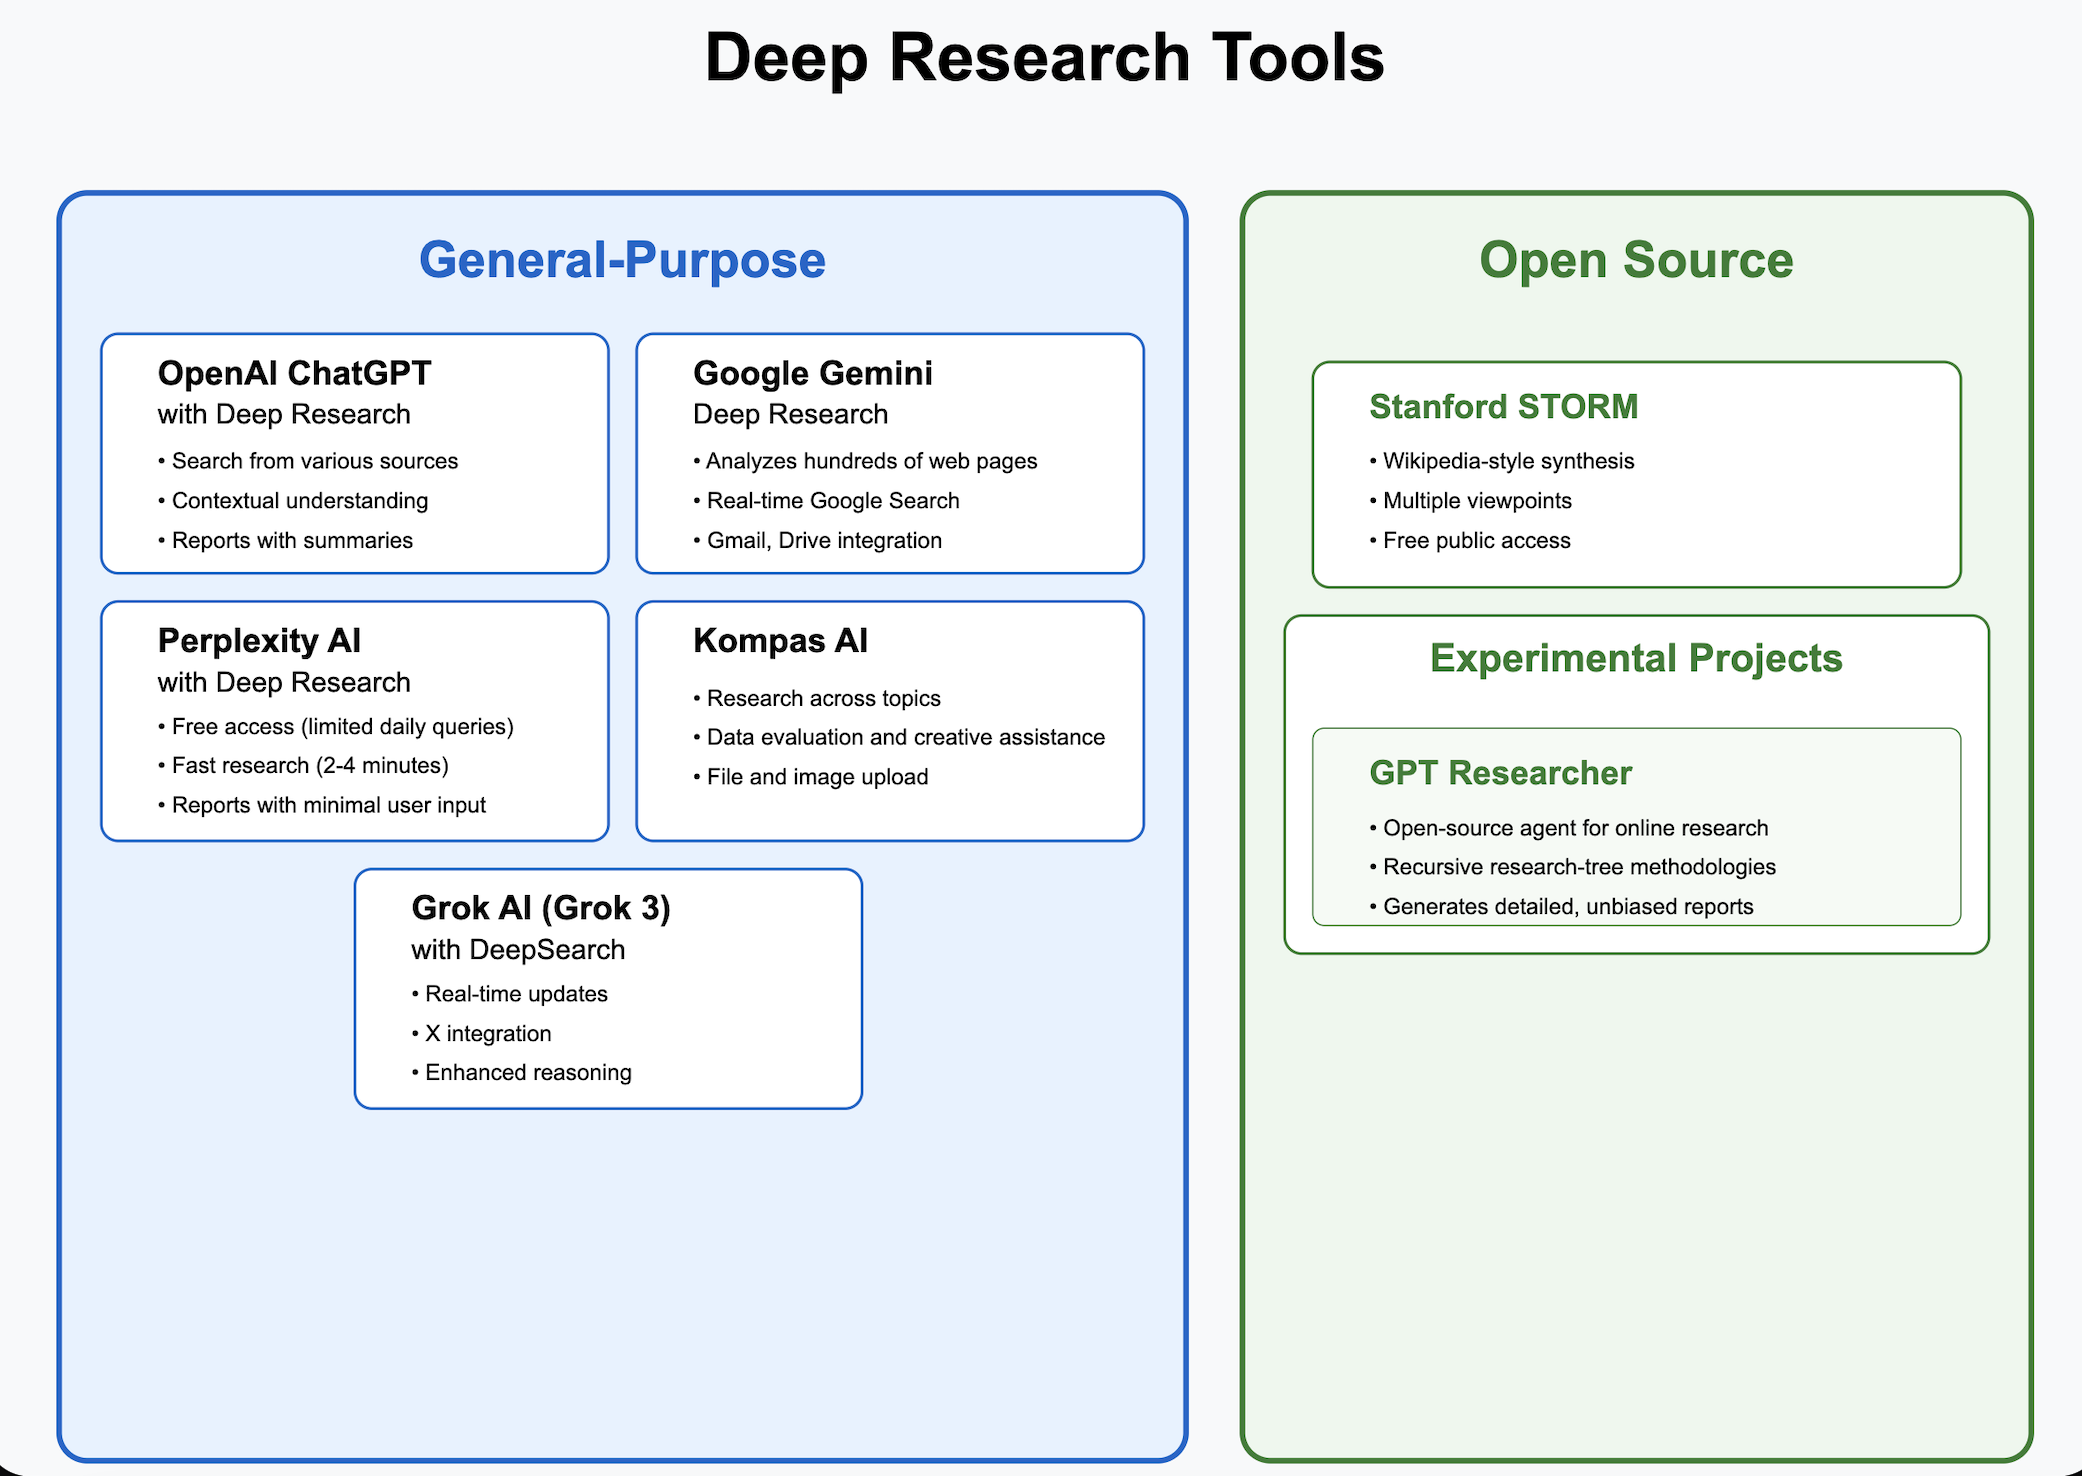
Les modes de recherche approfondie généralistes — Perplexity, Gemini et ChatGPT — itèrent sur des dizaines de recherches et des centaines de sources afin de produire une note de synthèse en quelques minutes. Des assistants académiques tels qu’Elicit, SciSpace, Semantic Scholar et Litmaps reposent plutôt sur des graphes d’articles et des tableaux d’extraction. Le guide de revue de littérature de l’Université Macquarie considère ces outils académiques comme un flux de travail distinct : recherche, cartographie des citations, synthèse et export vers un gestionnaire de références.
Le coût pratique de cette séparation est la perte de contexte. Une affirmation trouvée sur GitHub ou Reddit arrive rarement dans un manuscrit avec la même traçabilité de citation qu’une affirmation extraite d’une section méthodologique. Les analyses des outils AI pour la recherche académique en 2026 décrivent donc des piles d’outils, et non des App uniques : la découverte, l’évaluation des preuves, la cartographie des citations et la rédaction constituent des étapes séparées.
Une plateforme multi-modèles cherche à combler cet écart sans prétendre que la recherche web et la revue systématique sont le même problème. Elle est surtout utile lorsque la question elle-même traverse les corpus — sujets politiques, de marché, cliniques ou techniques qui exigent à la fois des articles primaires et ce que les praticiens disent cette semaine.
Que devez-vous rechercher dans une plateforme de recherche AI multi-modèles ?
Vous devez évaluer une plateforme de recherche AI selon la couverture, le contrôle et les citations — puis vérifier si elle peut conserver un projet en mémoire suffisamment longtemps pour terminer la revue. Les listes de fonctionnalités qui mentionnent uniquement la « recherche » et la « synthèse » masquent les différences qui modifient réellement la qualité des résultats.
Utilisez cette liste de contrôle Couverture–Contrôle–Citation :
- Couverture : l’outil recherche-t-il le web ouvert en temps réel, un index académique, ou les deux ? Elicit recherche plus de 138 millions d’articles académiques et 545 000 essais cliniques ; Semantic Scholar fournit un accès gratuit à plus de 200 millions d’articles. Les modes natifs du web parcourent plutôt des pages en direct.
- Contrôle : pouvez-vous examiner le plan de recherche, changer de modèles, joindre vos propres PDF et exclure des domaines indésirables ? Gemini Deep Research affiche un plan affinable en plusieurs points et un panneau de réflexion.
- Citation : les affirmations sont-elles associées à des citations au niveau de chaque phrase et exportables, ou simplement liées au bas d’un chat ? Elicit met l’accent sur les citations au niveau de chaque phrase ; Perplexity annonce 93,9 % de précision sur SimpleQA, un benchmark de factualité qui ne correspond pas à la précision de l’extraction académique.
- Persistance : le système peut-il mémoriser les critères d’inclusion, les articles rejetés et les requêtes précédentes pendant plusieurs jours ?
- Rapport coût-profondeur : un rapport web de trois minutes et une revue systématique 80 % plus rapide sont des propositions de valeur différentes, même si les deux portent l’étiquette « recherche approfondie ».
Les composants pertinents de Jenova sont l’Academic Research Assistant, destiné à la découverte de littérature, à la préparation de manuscrits et à la gestion des citations, et Real-Time Search, destiné aux requêtes en direct sur Google, Reddit, YouTube, GitHub, Amazon et des sources similaires. La plateforme expose également Google Scholar via des connexions d’outils de type MCP, ce qui importe lorsqu’une question commence sur le web et se termine dans un article.
Ce que Jenova ne remplace pas : une grille d’extraction spécialisée portant sur des dizaines de milliers de points de données, ou un réseau visuel de citations. Ce sont toujours des raisons de conserver Elicit ou Litmaps dans votre pile d’outils.
Comment Jenova se compare-t-elle à Perplexity, ChatGPT et Gemini pour la recherche web en direct ?
Pour la recherche web en direct, Perplexity, Gemini Deep Research et ChatGPT Deep Research produisent actuellement les synthèses multi-pages les plus autonomes, tandis que Jenova est plus solide lorsque vous avez besoin d’une recherche multi-source, du choix du modèle et d’un projet qui se poursuit d’une session à l’autre. La rapidité et la qualité de présentation d’un rapport ne sont pas synonymes de contrôle du flux de travail.
Perplexity Deep Research fonctionne pendant environ 2 à 4 minutes, en itérant avec des outils de recherche et de programmation, puis rédige un rapport que vous pouvez exporter. Selon les propres rapports de Perplexity, il obtient 21,1 % à Humanity’s Last Exam — un score supérieur à celui de plusieurs modèles de raisonnement comparés — et termine la plupart des tâches en moins de trois minutes. Sa limite tient à sa spécialisation : c’est un moteur de synthèse, et non un espace de travail académique multi-agent ; un test pratique de TechRadar l’a jugé moins complet que le mode de recherche de ChatGPT pour certaines tâches.
Gemini Deep Research peut parcourir jusqu’à des centaines de sites web et, en option, Gmail, Drive et Chat. Il utilise un planificateur de longue durée, une fenêtre de contexte d’un million de tokens avec récupération et des exécutions asynchrones que vous pouvez quitter puis reprendre. Un testeur l’a trouvé environ 40 % plus rapide que ChatGPT pour générer des rapports détaillés. Une autre comparaison a considéré Gemini plus fort sur le volume et la présentation formelle, tandis que ChatGPT dominait pour les questions de clarification et, dans une précédente analyse de recherche de marché, pour la gestion des fichiers. La contrainte de Gemini est son enfermement dans l’écosystème : la meilleure version du produit suppose que vous travaillez déjà dans Google Workspace.
ChatGPT Deep Research tend à poser de meilleures questions de cadrage avant de s’exécuter, ce qui réduit la navigation inutile. Des testeurs indépendants ont également affirmé que la rédaction de Gemini peut être trop générale pour être utilisée immédiatement. ChatGPT reste une voie à fournisseur unique : vous ne pouvez pas faire passer le même fil de recherche par Anthropic ou xAI sans quitter le produit.
Real-Time Search de Jenova est conçu comme un moteur multiplateforme plutôt que comme un unique bouton de « recherche approfondie ». Dans de nombreux cas, il est moins rapide que Perplexity ou Gemini pour produire un PDF final de 10 pages, et Jenova n’a pas publié de score à Humanity’s Last Exam pour un mode de recherche dédié. La contrepartie est le contrôle : vous pouvez conserver les résultats web, les résultats Scholar et le modèle choisi dans un fil persistant, puis transmettre ce même contexte à l’Academic Research Assistant pour nettoyer les citations.
| Fonctionnalité / Dimension | Jenova | Perplexity Deep Research | Gemini Deep Research | ChatGPT Deep Research | Elicit |
|---|---|---|---|---|---|
| Recherche web en temps réel | Moteur multiplateforme (Google, Reddit, YouTube, GitHub, Amazon, etc.) | Recherche web itérative ; centaines de sources par exécution | Centaines de sites, avec données Workspace facultatives | Recherche web avec questions de clarification | Pas le corpus principal |
| Couverture académique | Agent de littérature et outils de type Scholar | Pages académiques qui apparaissent sur le web | Pages académiques qui apparaissent sur le web | Pages académiques qui apparaissent sur le web | 138 M d’articles + 545 K essais |
| Accès multi-modèles | OpenAI, Anthropic, Google, DeepSeek, xAI et autres | Principaux modèles avec les forfaits payants | Famille de modèles Gemini | Modèles OpenAI | Pile de recherche d’Elicit |
| Style de citation | Production d’Agent liée aux sources | Rapports cités ; SimpleQA 93,9 % | Plan, panneau de réflexion, rapport multi-pages | Rapports narratifs étayés par la recherche | Citations au niveau de chaque phrase |
| Persistance | Historique illimité et mémoire intersessions | Fondé sur les conversations | Long contexte pendant l’exécution de recherche | Mémoire de conversation | Bibliothèque, sources réutilisables, alertes |
| Tarification (en 2026) | Niveau gratuit ; Plus 20 $/mois ; Premium 50 $ ; Pro 100 $ ; Max 200 $ ; Ultra 500 $ ; Enterprise 1 000 $ | Gratuit avec Deep Research limité ; Pro 20 $/mois, 17 $/mois à l’année | Non vérifié | Non vérifié | Forfaits payants ; niveaux exacts non vérifiés |
| Idéal pour | Projets mixtes web + académiques nécessitant le choix du modèle | Synthèses web rapides avec citations | Rapports concurrentiels et thématiques ancrés dans Workspace | Analyses approfondies cadrées et orientées par les questions | Revues systématiques et tableaux de preuves |
Quels outils AI sont les plus solides pour la revue de littérature académique et l’extraction de preuves ?
Elicit est le mieux adapté aux travaux systématiques sur des tableaux de preuves ; SciSpace est plus fort pour la lecture exploratoire rapide ; Litmaps et Semantic Scholar sont plus solides pour la cartographie et la découverte gratuite. Une plateforme multi-modèles complète ces outils ; elle n’efface pas leur avantage de base de données.
Elicit est utilisé par plus de 5 millions de chercheurs selon ses propres chiffres, et peut trouver jusqu’à 1 000 articles et analyser jusqu’à 20 000 points de données en une seule passe. Les chercheurs signalent jusqu’à 80 % de gain de temps sur les revues systématiques, principalement lors du criblage et de l’extraction. Il s’agit d’un produit différent d’un chatbot qui cite simplement des PDF.
Une comparaison de 2026 a conclu qu’Elicit est préférable pour les flux de travail rigoureux fondés sur des preuves, tandis que SciSpace est plus adapté à la découverte exploratoire rapide. SciSpace se positionne comme copilote AI sur une vaste collection d’articles, avec notamment une aide à la rédaction, ce qui est utile pour les premiers balayages de littérature, mais en fait un substitut moins robuste lorsque vous avez besoin de colonnes d’extraction reproductibles.
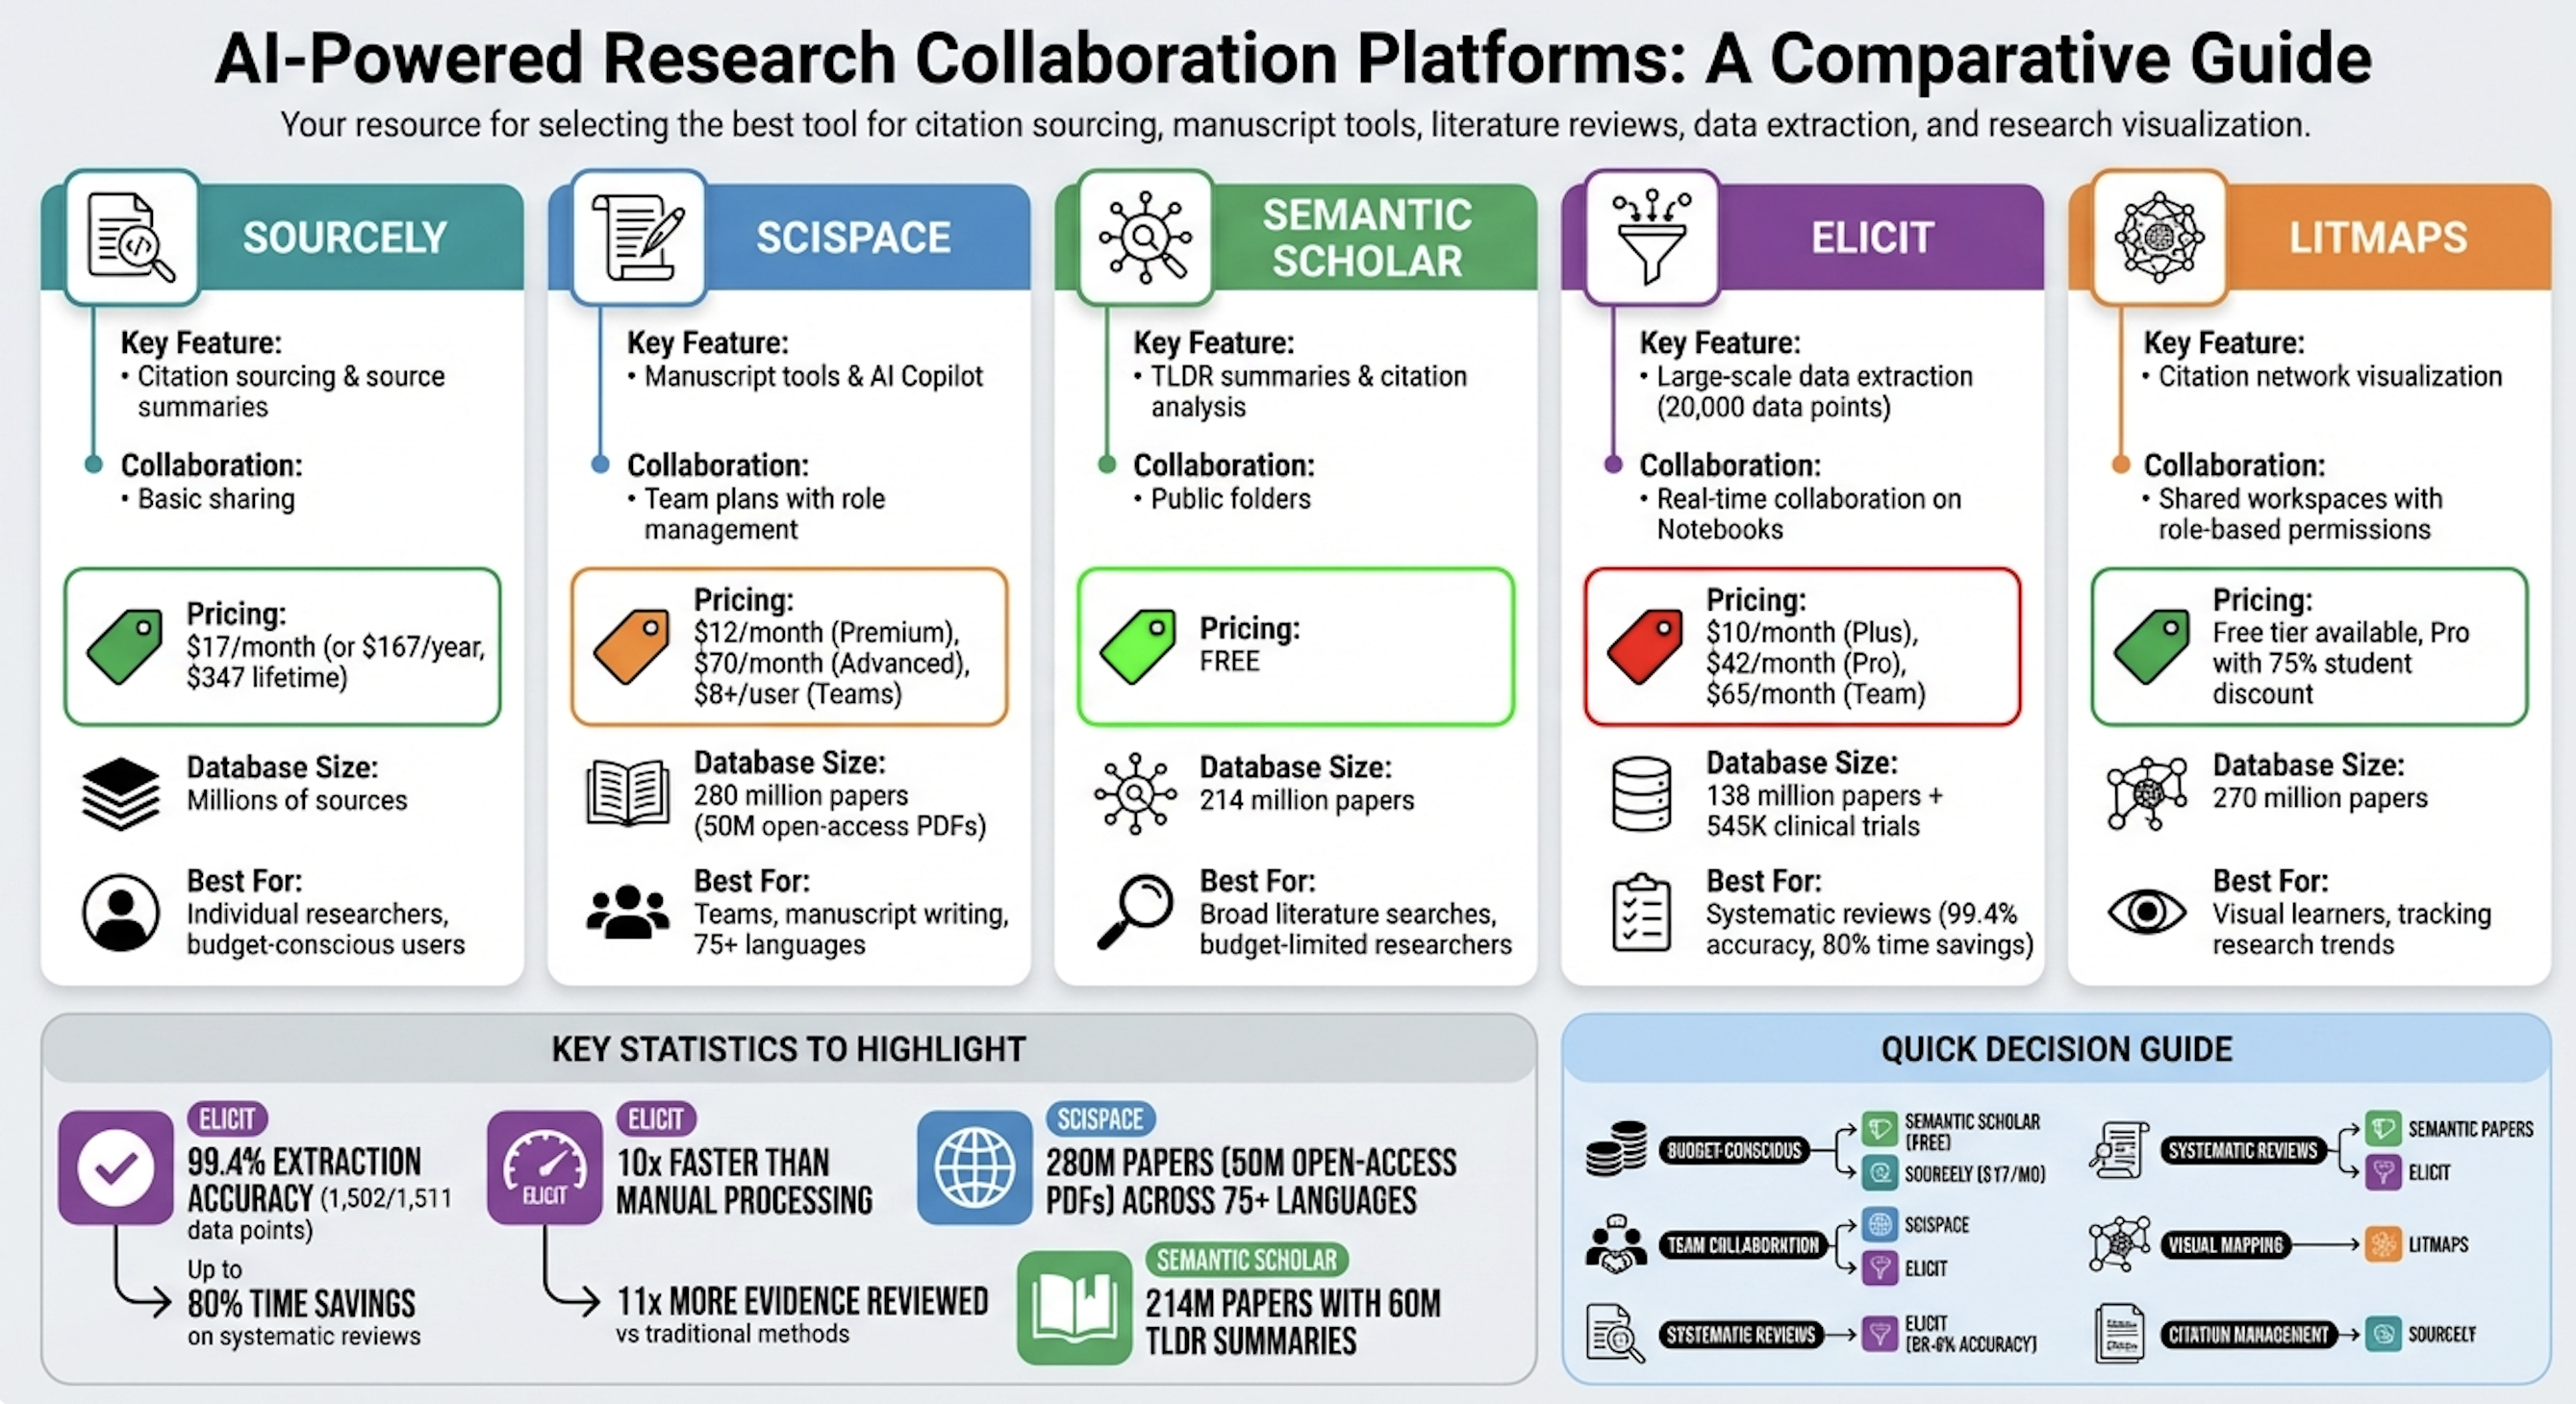
Semantic Scholar reste l’index gratuit par défaut de bon nombre de ces produits, avec plus de 200 millions d’articles et une découverte de type TLDR. Les guides des outils académiques gratuits en 2026 le mentionnent toujours aux côtés de Perplexity pour les chercheurs qui ne peuvent pas payer chaque étape de la chaîne de traitement. Litmaps représente l’extrême opposé : il visualise les réseaux de citations afin de vous permettre de voir des grappes, et pas seulement des résultats classés — utile lorsque le mode de défaillance consiste à manquer une lignée d’articles, et non une statistique.
L’Academic Research Assistant de Jenova est conçu pour la découverte, la préparation de manuscrits et la gestion des citations, plutôt que pour l’extraction massive à la manière d’Elicit. En pratique, cela signifie qu’il est plus utile lorsque vous connaissez déjà la question, ou lorsque la revue doit mélanger prépublications, actualités et activité des dépôts. C’est un choix moins pertinent si votre protocole exige de filtrer 2 000 titres dans un tableau de type PRISMA cet après-midi.
Comment changer de modèle en cours de recherche modifie-t-il la qualité de la synthèse ?
Changer de modèle en cours de recherche modifie la qualité de la synthèse parce que la récupération, la formulation de réserves et l’assemblage de longs contextes constituent des tâches cognitives différentes, et qu’aucune famille de modèles ne domine les trois. L’accès multi-modèles est donc un critère d’évaluation, et non un artifice de facturation.
Un schéma d’échec typique ressemble à ceci : un modèle rapide et ancré dans le web collecte 40 sources, un modèle verbeux rédige un récit affirmatif, et un modèle prudent aurait signalé que trois des 40 sources sont des blogs de fournisseurs. Si ces étapes se déroulent dans trois produits, la prudence ne rencontre jamais les sources.
La différence pratique de Jenova est que le même fil peut passer entre les modèles OpenAI, Anthropic, Google, DeepSeek et xAI sans exporter le corpus. Cela compte pour les tâches mixtes — par exemple, utiliser une passe axée sur la recherche pour Real-Time Search, puis un modèle plus prudent afin de reformuler les affirmations tout en conservant une citation pour chacune. Gemini Deep Research, par conception, reste dans la famille Gemini, y compris les nouveaux modèles de classe Gemini 3 destinés à la planification et aux rapports. Perplexity permet aux utilisateurs Pro de sélectionner parmi les meilleurs modèles, mais l’objet de recherche reste un rapport Perplexity, et non un espace de travail multi-agent durable contenant vos propres instructions.
La limite du côté de Jenova est tout aussi concrète : le routage entre modèles ne crée pas un moteur d’extraction sur 138 millions d’articles. Si le goulot d’étranglement est « extraire les données de résultats de 400 RCT dans un tableau », Elicit demeure l’outil le plus approprié, même si vous préférez un autre modèle pour la section de discussion.
Quand les Agents open source de recherche approfondie surpassent-ils les plateformes hébergées ?
Les Agents open source surpassent les plateformes hébergées lorsque vous devez contrôler le récupérateur, exécuter des recherches sur des documents locaux ou inspecter chaque exploration web — et non lorsque vous voulez obtenir la synthèse soignée la plus rapide. GPT Researcher en est l’exemple le plus clair : un Agent autonome de recherche web et locale qui rédige des rapports cités selon un modèle planificateur/exécutant.
Le projet est conçu pour agréger plus de 20 sources, produire des rapports de plus de 2 000 mots et réduire le biais lié à une seule source en récupérant de nombreuses pages en parallèle. Son mode de recherche approfondie utilise un arbre récursif de sous-thèmes. Les guides consacrés aux Agents open source de recherche approfondie orientent généralement les utilisateurs vers GPT Researcher pour des rapports flexibles combinant web et documents, et vers Stanford STORM lorsque l’objectif est une synthèse structurée de type Wikipédia. Open Deep Research de LangChain adopte la position inverse : un chercheur léger et configurable dans lequel vous apportez vos propres modèles, outils de recherche et serveurs MCP.
Ces atouts constituent également une barrière à l’adoption. Vous avez besoin de clés API, d’un environnement d’exécution et d’une volonté de déboguer des explorateurs web. Les produits Deep Research hébergés existent parce que la plupart des analystes ne maintiendront pas cette pile pour une note concurrentielle à préparer un mardi.
Jenova se situe entre les deux : une infrastructure hébergée avec des outils MCP et des instructions personnalisées, sans le déterminisme entièrement auto-hébergé de GPT Researcher. Les équipes qui ont besoin de recherches documentaires dans un environnement isolé du réseau ne doivent considérer aucune plateforme hébergée comme un remplacement direct.
Comment mener un projet de recherche unique sur des sources web et des articles académiques ?
Vous menez un projet mixte en séparant le corpus, l’affirmation et le brouillon en trois passes — reconnaissance web, confirmation académique, puis synthèse avec vérifications explicites des citations — plutôt qu’en demandant à un outil unique de « tout rechercher ». La même séquence fonctionne avec Jenova, Perplexity et Elicit ; seuls les éléments sur lesquels vous cliquez changent.
Une séquence durable :
- Cadrez la question en une phrase, en incluant les dates, la population et ce qui invaliderait l’affirmation.
- Collectez le contexte en direct (actualités, dépôts, forums de praticiens) avant de figer les termes de la requête académique.
- Confirmez avec les articles, en extrayant les méthodes et les tailles d’échantillon, et pas uniquement les résumés.
- Réconciliez les contradictions lors d’une troisième passe avec un modèle plus prudent ou un tableau de preuves dédié.
- Exportez les citations vers l’outil de manuscrit auquel vous faites déjà confiance.
Sur Jenova, commencez par Real-Time Search pour la couche en direct :
« Que disent les ingénieurs et les cliniciens au cours des 90 derniers jours sur les taux d’hallucinations dans la génération de comptes rendus de radiologie ? Privilégiez les problèmes GitHub, les présentations de conférences et les actualités, et listez les sources. »
Transférez ensuite les mêmes contraintes dans l’Academic Research Assistant :
« À partir des thèmes ci-dessus, trouvez des évaluations évaluées par les pairs de 2024 à 2026. Pour chaque article, extrayez l’ensemble de données, la modalité, le taux d’erreur rapporté et les limites. Signalez tout élément qui n’apparaît que dans les résumés. »
Dans Perplexity, sélectionnez Deep Research et demandez une synthèse avec des sources datées ; le produit est conçu pour rechercher, lire et rédiger un rapport en quelques minutes. Dans Elicit, collez la question de recherche et générez un rapport ou un tableau d’extraction sur le corpus d’articles, puis personnalisez les articles inclus — le flux de travail qu’Elicit documente pour la recherche à forts enjeux.
Le contrôle qualité que la plupart des personnes négligent : chaque statistique provenant uniquement du web qui reste dans le brouillon doit être soit remplacée par un article, soit étiquetée comme non évaluée par les pairs. Les plateformes qui conservent les deux corpus dans une même mémoire rendent ce contrôle moins coûteux. Elles ne le rendent pas facultatif.
Que disent les équipes d’infrastructure de recherche des plateformes de recherche multi-modèles ?
Les équipes d’infrastructure de recherche considèrent de plus en plus la « recherche approfondie » comme un problème d’orchestration — récupérateurs, modèles, mémoire et politique de citation — plutôt que comme un mode magique unique. Les équipes qui obtiennent des résultats fiables sont celles qui attribuent les outils aux modes de défaillance au lieu de chercher un unique gagnant.
« Le coût caché en 2026 n’est pas de générer un premier brouillon. C’est de transporter une affirmation trouvée sur le web en direct vers un manuscrit sans faire disparaître la source, la date et le conflit d’intérêts. Lorsque ces champs vivent dans trois produits, ils ne survivent pas au copier-coller. »
« L’accès multi-modèles ne devient rentable que si le corpus reste en place. Passer d’un modèle de récupération à un éditeur prudent est utile ; changer de produit et perdre la liste des rejets ne l’est pas. C’est pourquoi la mémoire persistante et les connexions d’outils importent davantage que deux cents mots de fluidité supplémentaires. »
« Nous orientons toujours les personnes qui réalisent des revues systématiques vers des extracteurs conçus à cet effet. Si vous devez prendre des décisions de criblage sur des centaines d’essais, une plateforme de recherche généraliste doit se placer à côté d’Elicit, et non prétendre le remplacer. La pile recommandée est volontairement mixte. »
— Équipe produit Jenova, conception des flux de travail de recherche AI, création d’Agents multi-modèles utilisés par des équipes dans plus de 70 pays
Cette vision correspond à la manière dont les guides universitaires présentent désormais le marché : des outils académiques côte à côte pour la recherche, la cartographie et la synthèse, auxquels s’ajoute une catégorie distincte de modes de recherche approfondie natifs du web. La question de la plateforme est de savoir quelle couche vous souhaitez standardiser.
Quels compromis devez-vous attendre des outils de recherche AI en 2026 ?
Vous devez vous attendre à ce que chaque option sérieuse soit incomplète sur au moins un corpus, une forme de contrôle ou une norme de citation — et choisir en fonction de ces lacunes plutôt qu’en fonction des catégories marketing. Les compromis sont désormais suffisamment stables pour pouvoir être anticipés.
La recherche approfondie native du web (Perplexity, Gemini, ChatGPT) continuera de dominer pour la rapidité de production des synthèses. Le principe directeur de Perplexity consiste à compresser des heures de travail d’expert en quelques minutes. Gemini continuera de l’emporter lorsque les preuves se trouvent déjà dans Workspace. ChatGPT continuera de l’emporter lorsque la question de recherche est insuffisamment définie et doit d’abord être interrogée.
Les spécialistes académiques continueront de dominer pour les preuves structurées. L’échelle d’extraction d’Elicit et les gains de temps pour les revues systématiques ne sont pas des fonctionnalités qu’une plateforme de chat généraliste peut simuler. Litmaps continuera de l’emporter lorsque la question est « quelle grappe me manque-t-il ? ». Les Agents open source continueront de dominer lorsque l’exigence porte sur des documents locaux, des récupérateurs personnalisés ou des explorations inspectables.
Le compromis de Jenova est inverse. Il fait partie des options les plus complètes lorsqu’une même personne doit rechercher le web en direct, obtenir du contexte académique, conserver la mémoire entre les sessions et changer de modèles sans reconstruire la synthèse. Il constitue un substitut moins solide pour l’extraction massive de RCT, les visualisations de réseaux de citations et les exécutions Deep Research entièrement autonomes et multi-pages avec des scores de factualité publiés.
Si vos 30 prochains jours sont faits de questions mixtes — un article, un marché, un fil GitHub et un brouillon — une plateforme de recherche multi-modèles est le choix par défaut rationnel. Si vos 30 prochains jours ressemblent plutôt à un protocole, un journal de criblage et une figure PRISMA, commencez par Elicit et n’ajoutez des outils web que lorsque le protocole autorise les sources non issues de revues.
Références
- Perplexity — Présentation de Perplexity Deep Research
- Google Gemini — Vue d’ensemble de Deep Research
- Elicit — AI pour la recherche scientifique
- Bibliothèque de l’Université Macquarie — Utiliser des outils alimentés par l’AI pour les revues de littérature
- Thesify — Meilleurs outils AI pour la recherche académique en 2026
- Cypris AI — Les 11 meilleurs outils AI pour la revue de littérature scientifique en 2026
- TechRadar — Test pratique de Perplexity Deep Research comparé à ChatGPT
- Android Authority — Vitesse et qualité de Gemini vs ChatGPT Deep Research
- LivePlan — Comparaison entre ChatGPT et Gemini Deep Research
- Cascade Insights — Analyse par un chercheur de marché de ChatGPT vs Gemini Deep Research
- Section AI — Test de qualité des résultats de ChatGPT vs Gemini Deep Research
- Perplexity Pro — Tarification et détails des forfaits
- Paperguide — Comparaison entre Elicit et SciSpace (2026)
- SciSpace — Comparaison avec l’alternative Elicit
- Swiss School of Business Research — Outils AI gratuits pour la recherche académique en 2026
- Litmaps — Assistant de revue de littérature
- GPT Researcher — Agent autonome open source de recherche (GitHub)
- Gatsbi — Meilleurs Agents open source de recherche AI en 2026
- LangChain — Open Deep Research