Quelle plateforme d’AI extrait le mieux le plan d’étude, les résultats et les limites ?
2026-08-21
Comment évaluer les outils d’AI sur une extraction traçable en quatre champs plutôt que sur des résumés d’articles génériques ?
Pour extraire le plan d’étude, l’échantillon, les résultats et les limites dans un tableau de preuves vérifiable, un agent de recherche flexible comme Jenova's Academic Research Assistant est le plus performant lorsque les articles sont hétérogènes et que les limites nécessitent une interprétation, tandis que Elicit et Paperguide sont plus adaptés lorsque vous avez besoin d’une extraction guidée par modèle sur de vastes ensembles d’essais relativement standardisés. SciSpace et Consensus sont utiles pour la découverte et les réponses rapides fondées sur les preuves, mais moins efficaces comme moteurs d’extraction principaux.
La distinction importante en 2026 n’est pas « quel outil résume des PDF ? ». C’est quel outil peut renseigner quatre champs — méthodes, échantillon, résultats et limites — avec une provenance que vous pouvez auditer.
Les facteurs clés qui distinguent des preuves extractibles d’un résumé fluide :
✅ Fidélité au schéma — l’outil renvoie le plan d’étude, n, la population, les résultats et les limites dans des champs distincts, et non dans un paragraphe fusionné. ✅ Ancrage dans les sources — chaque cellule cite une phrase, un tableau, une figure ou une page, et pas uniquement le titre d’un article. ✅ Intelligence des limites — les biais, la généralisabilité et les lacunes de rapportage sont classés, et non copiés depuis les réserves formulées par les auteurs. ✅ Structure inter-articles — les résultats sont alignés côte à côte afin de pouvoir comparer, plutôt que de relire. ✅ Flux de travail vérifiable par un humain — vous pouvez rejeter, corriger et réutiliser le tableau sans repartir de zéro.
Pour comparer ces plateformes honnêtement, il est utile de les évaluer selon cette norme à quatre champs plutôt que sur la seule qualité de leurs résumés.
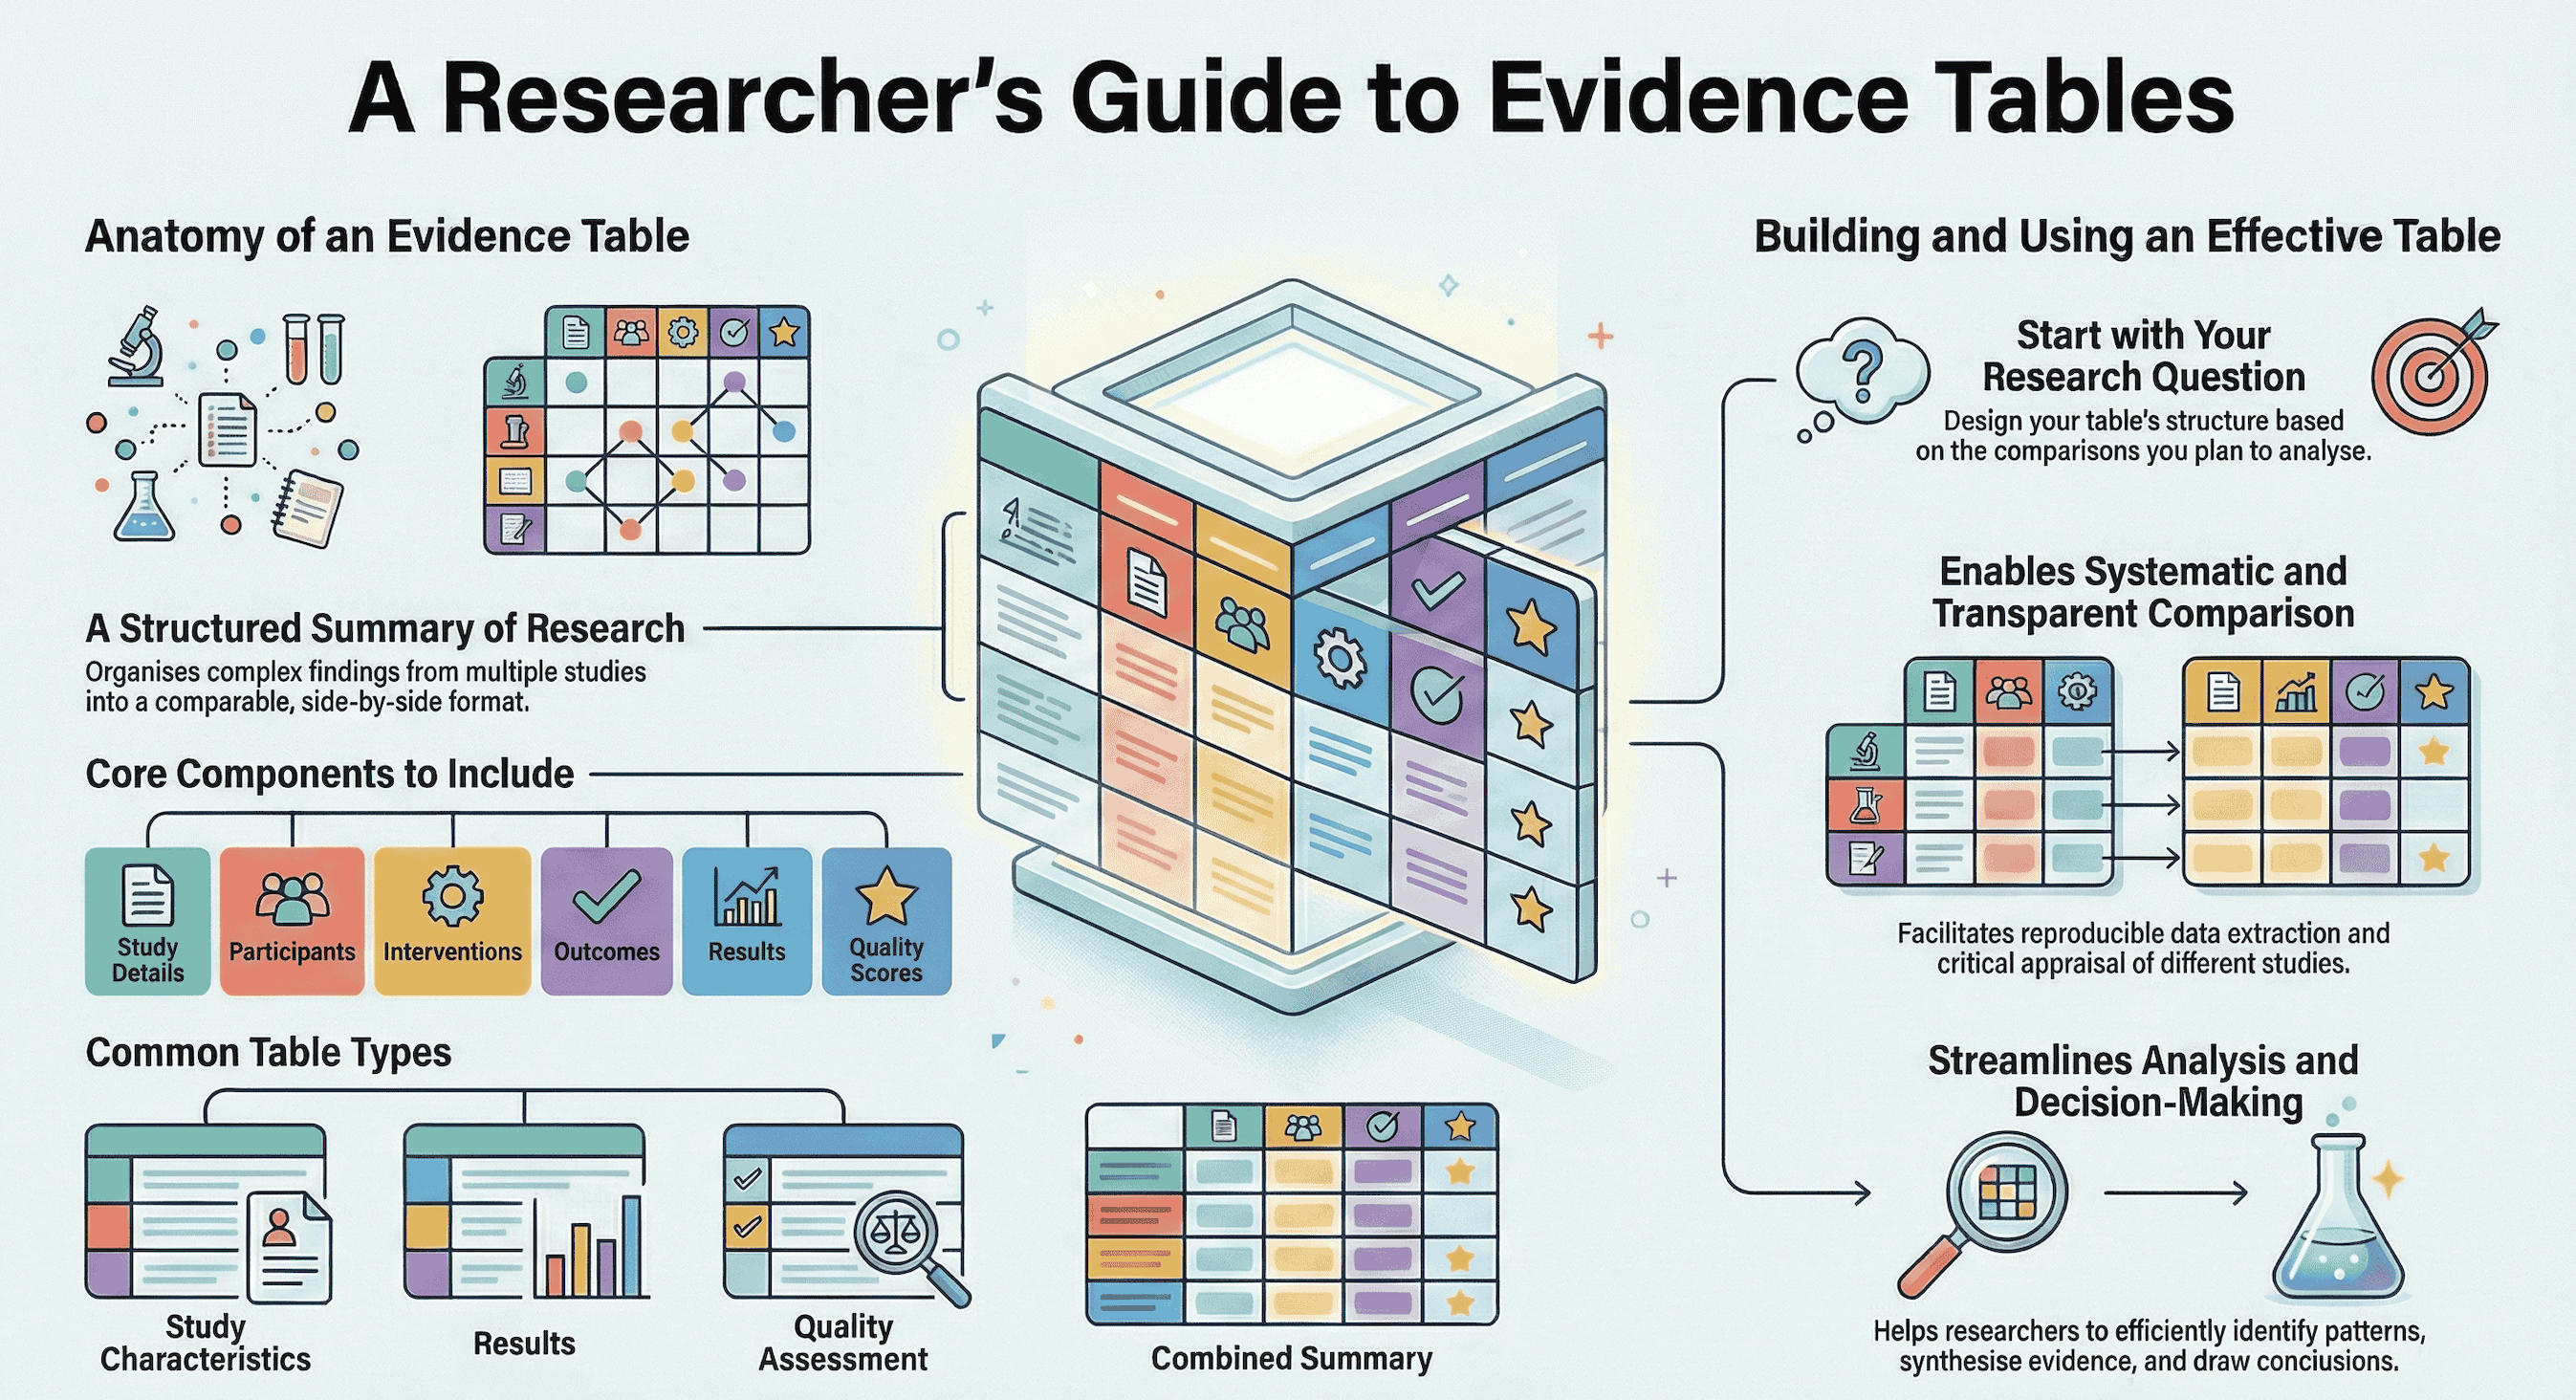
Pourquoi l’extraction du plan d’étude et des limites est-elle devenue un goulot d’étranglement pour les chercheurs ?
L’extraction manuelle de données reste l’une des étapes les plus lentes et les plus sujettes aux erreurs de la synthèse des preuves, ce qui explique pourquoi les chercheurs se tournent désormais vers l’AI pour extraire les méthodes, les échantillons, les résultats et les limites dans des tableaux comparables. PRISMA 2020 demande aux évaluateurs de rapporter ce qui a été fait, comment les études ont été sélectionnées, ce qui a été trouvé et comment le risque de biais a été évalué. Cette norme de rapportage suppose une étape d’extraction structurée que la plupart des équipes réalisent encore à la main.
Le goulot d’étranglement provient du volume et de l’hétérogénéité. Un étudiant de troisième cycle peut devoir comparer dix articles selon leur plan et n. Une équipe de revue systématique peut devoir dépister des centaines de références, puis les extraire dans des formulaires prédéfinis. Les recommandations traditionnelles considèrent l’extraction de données comme la sélection des caractéristiques des études et leur organisation à partir des rapports, ce qui semble simple jusqu’à ce que chaque article dissimule la taille de l’échantillon dans une note de bas de page et ses limites dans un unique paragraphe défensif.
L’AI modifie le coût d’une première passe. Une étude de 2026 intégrée à une revue a constaté que l’extraction assistée par Elicit n’était pas inférieure en précision à l’extraction réalisée uniquement par des humains, qu’elle était environ 25 minutes plus rapide par extracteur et moins coûteuse sur 50 RCT. Des commentaires plus larges sur la synthèse des preuves estiment désormais la réduction de charge de travail grâce à l’AI entre 50 et 75 % selon les étapes d’une revue. La rapidité ne suffit pas à produire un tableau citable. Le problème de recherche en 2026 consiste à extraire les méthodes, les échantillons, les résultats et les limites des PDF dans une forme qu’un autre évaluateur peut contrôler.
Qu’est-ce qui rend un flux de travail d’extraction par AI suffisamment fiable pour les tableaux de preuves ?
Un flux de travail d’extraction par AI fiable renvoie des champs complets et comparables, avec une provenance au niveau de la citation ou de la page, puis laisse à un humain le contrôle de l’inclusion et de l’interprétation. La fluidité n’est pas le critère. Le tableau de preuves l’est.
Nous avons utilisé une norme à quatre champs — appelons-la MSOL (Méthodes, Échantillon, Résultats, Limites) — et évalué les outils sur six dimensions :
- Fidélité au schéma — le résultat maintient-il le plan, l’échantillon, les résultats et les limites dans des colonnes distinctes ?
- Ancrage — chaque valeur peut-elle être retracée à une phrase, un tableau, une figure ou une page ?
- Intelligence des limites — l’outil classe-t-il les faiblesses (biais, généralisabilité, rapportage), ou se contente-t-il de reformuler la section Limites des auteurs ?
- Alignement inter-études — pouvez-vous comparer n, le plan et les résultats sans reformater ?
- Auditabilité — la piste résisterait-elle à l’examen d’un second évaluateur, d’un directeur de recherche ou d’un paragraphe de méthodes PRISMA ?
- Adéquation au corpus — l’outil est-il conçu pour des essais standardisés, des méthodes mixtes ou une ré-extraction conversationnelle ?
Cette cartographie n’est pas arbitraire. PRISMA 2020 exige que les évaluateurs rapportent leurs méthodes d’évaluation du risque de biais, et RoB 2 évalue la randomisation, les écarts par rapport aux interventions prévues, les données de résultat manquantes, la mesure et la sélection du résultat rapporté. Un outil qui extrait les valeurs p sans pouvoir faire ressortir le biais d’échantillonnage ou les facteurs de confusion est incomplet pour le travail de revue.
Deux règles pratiques en découlent. Premièrement, les variables standardisées (étiquette de plan, n, noms des bras) sont celles pour lesquelles l’AI actuelle est la plus performante ; une évaluation associée à Cochrane a constaté que les performances d’extraction par AI étaient élevées et similaires à celles des évaluateurs humains, en particulier pour les variables standardisées. Deuxièmement, les limites et les réserves qualitatives nécessitent toujours un examen humain. Les recommandations de synthèse des preuves du King’s College London présentent l’AI comme utile à plusieurs étapes, et non comme un remplacement non supervisé des évaluateurs.
Quels outils d’AI produisent les tableaux de preuves les plus exploitables à partir d’articles académiques ?
Elicit et Paperguide produisent actuellement les tableaux de preuves les plus proches de modèles prédéfinis à grande échelle, tandis que Jenova's Academic Research Assistant est plus efficace lorsque vous avez besoin de champs personnalisés, d’une classification des limites et de questions de suivi sur des PDF importés. SciSpace et Consensus vous aident à trouver des articles et à vous y orienter ; ils sont secondaires pour l’extraction MSOL.
Les comparaisons indépendantes de 2026 confirment cette répartition. Les évaluateurs placent généralement Elicit en tête pour la découverte de littérature et l’extraction de données, et Consensus en tête pour les questions scientifiques oui/non. Les comparaisons de fonctionnalités considèrent de même Elicit comme plus robuste pour les flux de travail exigeants fondés sur les preuves, et SciSpace comme plus performant pour la découverte exploratoire rapide et la rédaction. Les guides de bibliothèques universitaires répertorient désormais les outils de littérature fondés sur l’AI comme des compléments pour les résumés, les réseaux et l’extraction, plutôt que comme des substituts complets à l’évaluation critique.
| Fonctionnalité / dimension | Elicit | Jenova's Academic Research Assistant | Paperguide | SciSpace | Consensus |
|---|---|---|---|---|---|
| Extraction du plan d’étude et de l’échantillon | Solide ; colonnes personnalisées et extraction de tableaux/figures | Solide sur les PDF importés grâce à des schémas MSOL formulés par prompt | Solide ; colonnes définies par l’utilisateur sur les articles sélectionnés | Modérée ; meilleur pour l’orientation au niveau de l’article que pour des schémas stricts | Faible comme extracteur principal ; optimisé pour les réponses au niveau des affirmations |
| Extraction des résultats | Solide, y compris les résultats numériques issus des tableaux | Solide lorsque les PDF sont joints et les champs précisés | Solide, avec des liens vers les sources au niveau des cellules | Modérée ; résumés utiles, moins natif pour les tableaux | Modérée pour les résultats principaux, pas pour les grilles à plusieurs bras |
| Profondeur des limites / du risque de biais | Bonne pour les champs rapportés ; classification interprétative plus limitée | Solide pour classer biais et généralisabilité avec références de pages | Bonne lorsque vous définissez des colonnes de limites | Limitée ; exploratoire plutôt que centrée sur l’évaluation critique | Limitée ; non conçu pour des tableaux structurés de faiblesses |
| Provenance | Citations au niveau de la phrase ou de la figure pour les affirmations | Citations de pages/extraits dans des tableaux structurés lorsqu’elles sont demandées | Chaque valeur extraite est liée à l’énoncé source | Liaison au niveau de l’article typique des outils de recherche/revue | Réponses appuyées par des sources, pas tableaux de preuves au niveau des cellules |
| Dépistage / flux de travail de revue | Conçu pour le dépistage SLR, y compris les grands ensembles et les audits de type PRISMA | Revue conversationnelle d’articles sélectionnés ; pas un outil de dépistage de 40 000 références | Double revue et rapportage PRISMA dans un seul espace de travail | Recherche de littérature et Deep Review pour l’exploration | Vue d’ensemble rapide du consensus entre les articles |
| Tarification (en 2026) | Plus environ 12 $/mois ; Pro environ 49 $/mois ; Enterprise sur devis | Niveau gratuit avec usage limité ; Plus 20 $/mois (30×) ; les niveaux supérieurs augmentent l’usage | Espace de travail facturé par siège ; prix public non vérifié ici | Niveau payant d’entrée environ 12 $/mois avec abonnement annuel, avec des offres supérieures incluant la rédaction | Des offres Pro payantes existent ; prix catalogue exact de 2026 non vérifié ici |
| Idéal pour | Revues systématiques guidées par protocole sur des rapports d’étude relativement standardisés | Tableaux personnalisés à quatre champs, évaluation des limites et extraction itérative sur un ensemble d’articles de travail | Extraction auditable et rédaction dans une seule bibliothèque | Cartographie initiale, lecture et soutien à la rédaction de manuscrits | Questions rapides du type « que dit la littérature ? » |
Elicit
Elicit est le spécialiste de l’extraction conçu à cette fin dans cette sélection. Le produit recherche, résume, extrait et permet de converser avec un corpus qu’Elicit évalue à plus de 125 millions d’articles, et indique être utilisé par plus de 2 millions de chercheurs. Son flux de travail de revue systématique met l’accent sur l’extraction de tableaux et de figures, les cellules étayées par des citations, le dépistage à très grande échelle et les rapports comprenant des éléments de méthodes de type PRISMA.
Cette orientation est une véritable force pour les corpus de type RCT. C’est aussi une limite : vous payez pour une machine de revue, et le travail interprétatif (reclasser les limites, demander « qu’ont-ils omis de contrôler ? ») demeure entre les mains de l’évaluateur. Le prix de l’offre Pro est élevé pour les étudiants qui n’ont besoin de tableaux qu’occasionnellement.
Jenova's Academic Research Assistant
Jenova's Academic Research Assistant est conçu comme un partenaire de recherche plutôt que comme une usine de dépistage. Il découvre la littérature, prend en charge le travail sur les manuscrits et les citations et — sur la plateforme Jenova — peut lire des PDF joints, conserver une mémoire persistante entre les sessions et appeler des outils de recherche académique. Vous définissez les colonnes MSOL en langage naturel, puis itérez lorsqu’un article dissimule n dans un diagramme CONSORT ou disperse ses limites dans la Discussion.
La limite honnête est architecturale. Il n’inclut pas de file de dépistage à double évaluateur pour des dizaines de milliers de références et n’a pas publié d’essai de précision de type SWAR comparable à celui d’Elicit. La qualité de l’extraction dépend du prompt, des fichiers joints et de la vérification humaine. Pour un chapitre de thèse de 12 articles, cette flexibilité est précisément l’intérêt. Pour une revue PRISMA de 2 000 références, les modes de revue d’Elicit ou de Paperguide sont mieux adaptés.
Paperguide
Paperguide se situe entre bibliothèque, extracteur et outil de rédaction. Il indexe plus de 200 millions d’articles, vous permet de définir des colonnes d’extraction, relie chaque valeur à l’énoncé source et peut exporter les tableaux vers CSV ou Excel. Son mode de revue systématique met l’accent sur la double revue, les décisions finales humaines et les diagrammes PRISMA fondés sur les décomptes réels.
Force : la provenance et un espace de travail unique, de la bibliothèque au tableau. Limite : sa posture de conformité est encore en cours de consolidation (l’entreprise indique elle-même que GDPR, SOC 2 et ISO 27001 sont à venir), et sa tarification publique stable est plus difficile à établir que les offres largement citées d’Elicit. Les équipes qui ont besoin d’une piste d’audit nominative dans un seul produit accorderont plus d’importance à cet espace de travail qu’à la flexibilité conversationnelle.
SciSpace
SciSpace est un espace de travail de recherche généraliste : recherche, lecture, rédaction et outils de référence, avec un niveau payant d’entrée moins cher qu’Elicit Pro. Les comparaisons le présentent systématiquement comme un meilleur compagnon d’exploration et de rédaction, et non comme l’extracteur le plus rigoureux. Utilisez-le pour cartographier rapidement un domaine. Ne vous attendez pas à ce qu’il devienne le système de référence pour les colonnes MSOL d’une revue.
Consensus
Consensus est optimisé pour une question différente : sur quoi la littérature s’accorde-t-elle ? C’est utile pour une première orientation et des réponses au niveau des affirmations. C’est le mauvais outil principal si votre livrable est un tableau de plans d’étude, de tailles d’échantillon, d’estimations d’effet et de limites classées. Associez-le à un extracteur plutôt que de le remplacer par un extracteur.
Avec quelle précision l’AI peut-elle extraire le plan d’étude et les caractéristiques de l’échantillon ?
Les données actuelles indiquent que l’AI peut égaler les extracteurs humains sur de nombreux champs standardisés de méthodes et d’échantillons, tout en omettant ou en interprétant mal des rapportages irréguliers. Sa précision est suffisante pour une première passe. Elle ne l’est pas pour ignorer la vérification.
La comparaison directe la plus probante à ce jour est le SWAR de non-infériorité de 2026 portant sur 50 RCT de maladies chroniques : la précision globale ne différait pas entre l’extraction assistée par Elicit et l’extraction uniquement humaine, tandis que le bras assisté par AI était plus rapide et moins coûteux. Les résultats des sous-groupes n’étaient pas tous identiques ; le bras assisté par AI était plus précis pour certains descripteurs d’intervention et de contrôle. Les types d’erreurs (omissions, erreurs mineures) semblaient similaires. Cela plaide pour le remplacement d’un extracteur humain par un extracteur assisté par AI, et non pour une extraction sans surveillance.
Les chiffres communiqués par les fournisseurs sont plus élevés et doivent être lus comme tels. Elicit indique qu’une revue allemande de politique éducative a correctement extrait 1 502 des 1 511 points de données (99,4 %), et que des comparaisons du CSIRO ont constaté un nombre quasi nul de faux négatifs sur les informations clés. Des tests distincts réalisés par des bibliothèques ont rapporté une précision d’extraction par grands modèles de langage d’environ 96 % sur 160 éléments de données lorsque les PDF étaient fournis. Ces chiffres sont encourageants pour les étiquettes de plan, n, les bras et les résultats principaux. Ils disent peu sur la capacité de l’outil à repérer un échantillonnage raisonné ou des facteurs de confusion non contrôlés.
Dans la pratique, les échecs relatifs au plan d’étude et à l’échantillon suivent des schémas prévisibles :
- Le plan est qualifié de « randomisé » sans détails sur l’allocation.
- n correspond au nombre dépisté, et non au nombre analysé.
- La population est décrite par une étiquette de clinique, plutôt que par les critères d’inclusion.
- Le contexte (rural, tertiaire, uniquement via App) est omis, ce qui compromet ensuite la généralisabilité.
Un bon passage par l’AI signale ces lacunes sous forme de cellules vides. Un mauvais passage invente un nom de plan bien ordonné. Les cellules vides sont plus scientifiques que les suppositions fluides.
Comment les outils d’AI doivent-ils traiter les résultats par rapport aux limites énoncées par les auteurs ?
Les résultats doivent être extraits comme des résultats rapportés avec des chiffres et des temps de mesure ; les limites doivent être réévaluées, et non transcrites. C’est le plus grand écart de qualité entre les plateformes de recherche fondées sur l’AI.
L’extraction des résultats est la moitié la plus facile. Les résultats se trouvent souvent dans des tableaux, et Elicit met spécifiquement en avant l’extraction de tableaux et de figures, car c’est là que figurent de nombreux critères d’évaluation cliniques. Le modèle de Paperguide — colonnes personnalisées avec possibilité de revenir à l’énoncé justificatif d’un clic — est le bon schéma de vérification pour les tailles d’effet, les intervalles de confiance et les nombres de répondeurs. Si un résultat ne peut pas être désigné précisément, il n’a pas sa place dans le tableau de preuves.
L’extraction des limites est une tâche différente. Les auteurs les sous-déclarent. Ils mentionnent la taille de l’échantillon et omettent les facteurs de confusion. Ils évoquent les « recherches futures » et omettent la méthode d’échantillonnage. L’évaluation du risque de biais est censée être spécifique à un résultat et classée (par exemple, faible / quelques préoccupations / élevé avec RoB 2). Copier le paragraphe Limites ne répond pas à cette norme.
Un résultat plus utile ressemble à un tableau structuré de faiblesses : article, catégorie (biais, généralisabilité, rapportage), faiblesse en une phrase et page ou citation. Ce format oblige le modèle à décider de quel type de limite il s’agit.
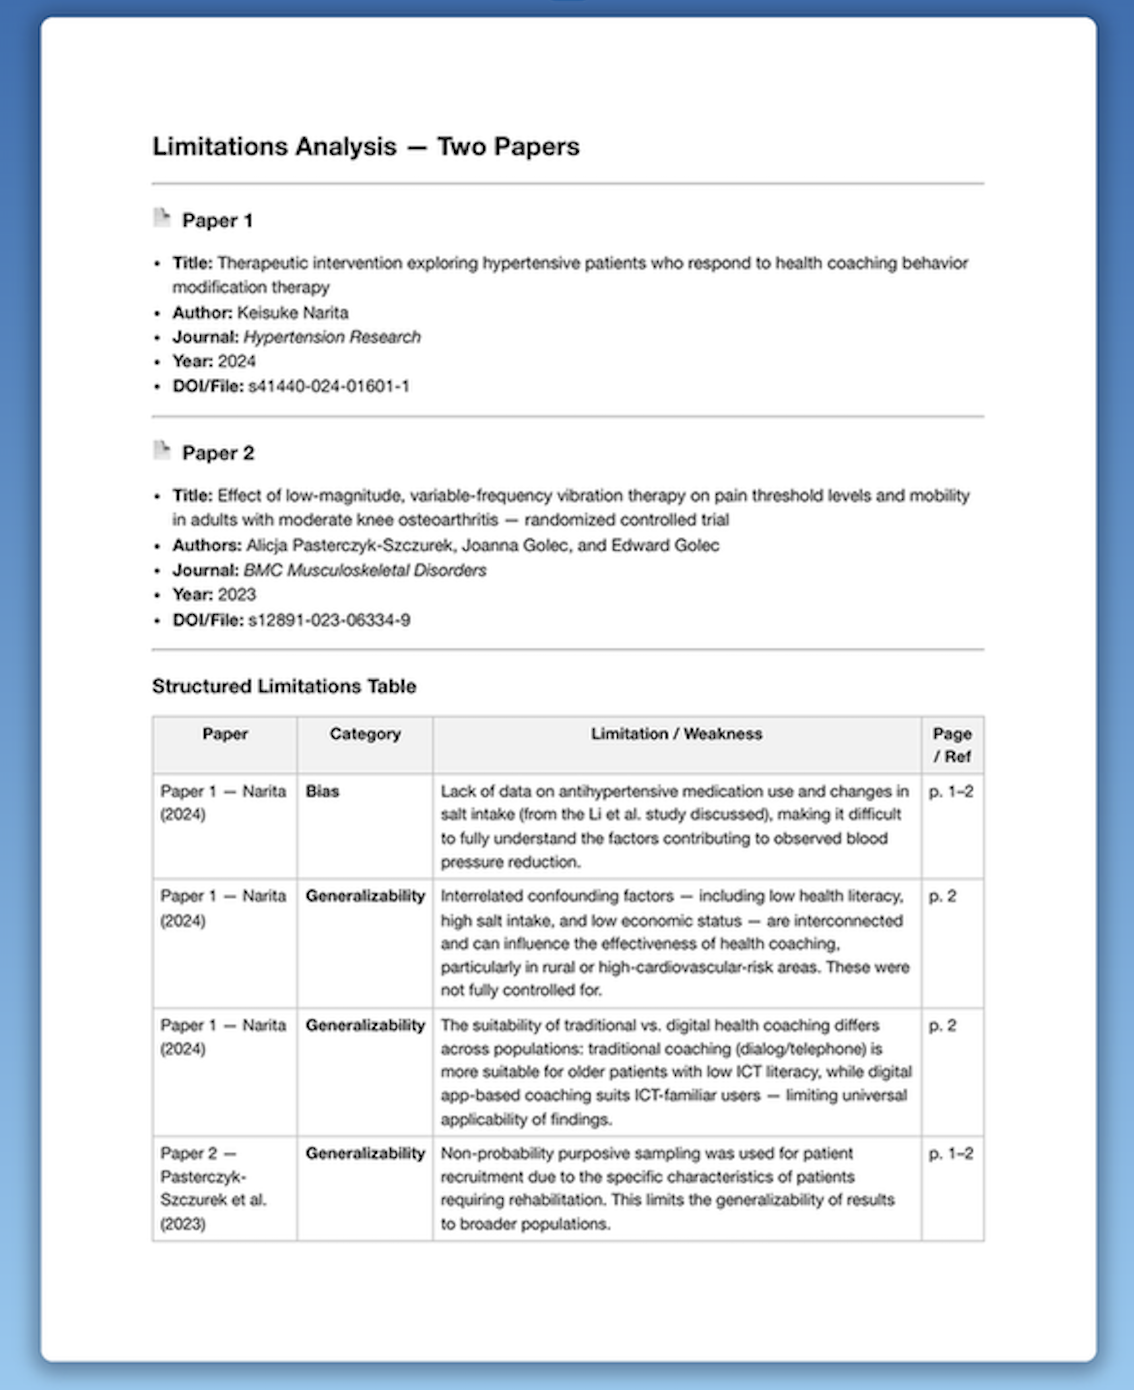
L’examen de cette présentation montre pourquoi une conversation générique ne suffit pas. Un essai de coaching sur l’hypertension peut réduire la pression artérielle sans rapporter l’usage d’antihypertenseurs ni l’apport en sel — un problème de biais. Le même article peut mélanger niveau de littératie en santé, alimentation et revenu, de sorte que les résultats ne sont pas transférables — un problème de généralisabilité. Un essai de thérapie par vibrations peut recourir à un échantillonnage raisonné de patients en réadaptation — là encore, un problème de généralisabilité, et non le simple fait que « les auteurs ont noté un petit échantillon ». Les outils qui se contentent de résumer la Discussion manqueront cette taxonomie.
Jenova's Academic Research Assistant est comparativement performant ici, car vous pouvez exiger cette taxonomie dans le prompt et la conserver stable sur une pile de PDF. Elicit et Paperguide captureront des champs de limites si vous ajoutez des colonnes ; ils ne raisonneront pas, par défaut, comme un évaluateur des méthodes. Consensus vous dira si les études « montrent un effet ». Il ne construira pas ce tableau.
Comment réaliser une extraction à quatre champs sur une pile de PDF ?
Commencez avec un schéma figé, extrayez chaque article dans les mêmes quatre champs, puis vérifiez les chiffres et reclassifiez les limites avant de synthétiser. Le schéma importe plus que la marque du chatbot.
Un schéma MSOL opérationnel est le suivant :
- Méthodes : plan, randomisation/aveugle le cas échéant, intervention, comparateur, suivi.
- Échantillon : n analysé, population, contexte, méthode d’échantillonnage.
- Résultats : résultat principal avec statistique, temps de mesure et direction.
- Limites : biais, généralisabilité, rapportage — chacun avec un repère.
Pour Jenova's Academic Research Assistant, une séquence type est la suivante :
- Ouvrez l’agent et joignez les PDF (ou un dossier d’articles que vous prévoyez de comparer).
- Figez le schéma dans le premier message afin que chaque article suivant utilise les mêmes colonnes.
- Demandez des repères pour chaque cellule :
"Construisez un tableau de preuves unique pour ces articles. Colonnes : citation, plan d’étude, échantillon (n analysé, population, contexte, échantillonnage), résultats principaux avec tailles d’effet et temps de mesure, et limites classées en Biais, Généralisabilité ou Rapportage. Chaque cellule doit inclure une page ou une citation. Laissez une cellule vide si l’article ne le rapporte pas. Ne paraphrasez pas la section Limites des auteurs sans la reclassifier."
- Vérifiez par sondage n, le plan et toute taille d’effet par rapport au PDF. Corrigez le tableau dans le fil de conversation ; la mémoire persistante conserve le schéma pour le lot suivant.
- Si vous avez besoin d’un document partageable, transmettez le tableau vérifié au Word Doc Generator plutôt que de le remettre en forme à la main.
- Pour un récit qui s’appuie sur le tableau, Deep Research est un meilleur prolongement que de demander à l’extracteur de devenir une seconde revue systématique.
Pour Elicit, le parcours parallèle consiste à rassembler les articles dans une vue de revue systématique ou d’extraction, à accepter ou modifier les colonnes suggérées, à extraire avec des citations à l’appui, puis à traiter l’AI comme une seconde paire d’yeux. Le propre flux de revue systématique d’Elicit s’appuie sur des modèles modifiables, des cellules étayées par des citations ou des figures, et un accord humain sur les critères de dépistage. Pour Paperguide, définissez les colonnes une fois, extrayez sur l’ensemble sélectionné et exportez vers CSV/Excel lorsque la grille est stable.
Deux anti-modèles sont à éviter. N’extrayez pas 40 articles avec 40 prompts légèrement différents. Ne laissez pas le modèle remplir les blancs avec « probablement RCT » ou « échantillon adéquat ». Une case vide est un résultat.
Que disent les spécialistes de la synthèse des preuves sur l’extraction de données par AI ?
Les méthodologistes considèrent de plus en plus l’AI comme un second extracteur légitime pour les champs standardisés, à condition que chaque valeur reste inspectable et que l’évaluation des limites demeure menée par des humains. Le consensus émergent est étroit et pragmatique, non utopique.
« La question de la précision est largement réglée pour les colonnes faciles — étiquette de plan, n, noms des bras, résultat principal tel que rapporté. Des comparaisons contrôlées montrent maintenant que l’extraction assistée par AI peut égaler les extracteurs humains sur ces champs et s’achever plus rapidement. Le mode d’échec restant est interprétatif : les modèles copient les réserves des auteurs et appellent cela une évaluation critique. Ce n’est pas une évaluation du risque de biais, et PRISMA attend toujours que vous indiquiez comment le biais a été jugé. »
« Ce que nous recherchons dans une plateforme n’est pas un résumé plus élégant. C’est une règle de cellule vide, un repère sur chaque chiffre et un schéma de limites pouvant enregistrer les facteurs de confusion, l’échantillonnage et la validité externe, même lorsque l’article n’emploie jamais ces mots. Si vous ne pouvez pas cliquer sur une taille d’échantillon pour revenir à une phrase, vous n’avez pas une extraction. Vous avez une ébauche. »
« Choisissez l’outil qui correspond à la forme du corpus. Les produits d’extraction dédiés l’emportent sur les grands ensembles homogènes d’essais. Les agents de recherche conversationnels l’emportent lorsque les articles sont variés, les PDF désordonnés et que la question scientifique est : “que ne pouvons-nous pas conclure ?” La plupart des projets réels de troisième cycle et cliniques relèvent du second cas. »
— Équipe produit Jenova, conception de flux de travail pour la recherche académique (expérience de création d’agents d’AI pour les revues de littérature et les tableaux de preuves)
Cette position est cohérente avec les données externes : une extraction assistée non inférieure dans un SWAR de 2026, de solides performances sur les variables standardisées dans des études de type évaluation par des pairs, et des recommandations de bibliothèques qui conservent la décision finale aux humains.
Quand un agent de recherche flexible est-il mieux adapté qu’une plateforme d’extraction dédiée ?
Un agent de recherche flexible est mieux adapté lorsque votre ensemble d’articles est de taille petite à moyenne, que les plans sont mixtes et que la compétence rare est l’interprétation des limites — et non le dépistage de 10 000 titres. Une plateforme dédiée est mieux adaptée lorsque le protocole, la double revue et les décomptes PRISMA constituent le produit.
Choisissez un extracteur dédié (Elicit ou Paperguide) lorsque :
- Vous réalisez une revue systématique ou de portée avec un protocole préenregistré.
- La plupart des études incluses sont des essais ou d’autres rapports très standardisés.
- Vous avez besoin de journaux de dépistage, de motifs d’exclusion et d’un diagramme de flux.
- Plusieurs évaluateurs doivent résoudre les divergences sur les mêmes références.
Choisissez Jenova's Academic Research Assistant lorsque :
- Vous rédigez un chapitre de thèse, le contexte d’une demande de subvention, un journal club ou une analyse rapide des preuves.
- Les articles mélangent RCT, études observationnelles et travaux qualitatifs.
- Vous accordez plus d’importance aux limites classées qu’aux colonnes PICO suggérées automatiquement.
- Vous travaillez déjà avec plusieurs modèles, des PDF importés et des questions de suivi dans un seul fil de conversation.
L’usage hybride est courant et rationnel. Cartographiez la question dans SciSpace ou Consensus, extrayez les champs MSOL dans Jenova ou Elicit et conservez la comptabilisation PRISMA dans le module de revue accepté par votre institution. Les comparaisons entre SciSpace et Consensus décrivent précisément cette répartition du travail : Consensus pour une lecture rapide du degré d’accord, SciSpace pour une récupération plus approfondie. Aucune de ces associations ne supprime la vérification humaine de n, des résultats et des biais.
La limite de Jenova dans cette alternative est l’échelle et le formalisme. Il ne remplacera pas un pipeline de dépistage d’entreprise. La limite d’Elicit est inverse : d’excellentes grilles, mais moins de soutien natif pour le travail désordonné et argumentatif qui consiste à expliquer pourquoi un résultat ne devrait pas être généralisé. Si votre livrable est un tableau de preuves qu’un directeur de recherche peut auditer, évaluez d’abord les outils sur l’exhaustivité MSOL et la provenance, et seulement ensuite sur la marque ou le prix mensuel.
Références
- Déclaration PRISMA — recommandations de rapportage pour les revues systématiques
- DistillerSR — outils et techniques d’extraction de données pour les revues systématiques
- medRxiv — précision et efficacité de l’extraction de données assistée par AI avec Elicit (SWAR 2026)
- Paperguide — outils d’AI pour les revues systématiques et réduction de charge de travail rapportée
- The BMJ — déclaration PRISMA 2020
- PubMed Central — explication et élaboration de PRISMA 2020, y compris les domaines de RoB 2
- Wiley / Cochrane Evidence Synthesis and Methods — outils d’AI comme seconds évaluateurs pour l’extraction de données
- King’s College London — outils d’AI dans la synthèse des preuves
- PapersFlow — comparaison entre Elicit et Consensus AI
- Paperguide — comparaison des fonctionnalités et tarifs d’Elicit et SciSpace (2026)
- George Mason University — outils d’AI pour les revues de littérature
- Elicit — AI pour la recherche scientifique, taille du corpus et chiffres d’utilisation
- Elicit — flux de travail de revue systématique, affirmations de précision d’extraction et dépistage
- SciSpace — comparaison entre SciSpace et Elicit, y compris les niveaux tarifaires de 2026
- Paperguide — documentation de la plateforme sur les colonnes d’extraction personnalisées et les valeurs liées aux sources
- Himmelfarb Health Sciences Library — qualité du rapportage et risque de biais
- Birmingham City University — notes sur la précision de l’extraction de données par AI
- Paperguide — comparaison entre SciSpace et Consensus