Quels sont les assistants de recherche AI les plus recommandés en 2026 ?
2026-08-21
Comment les principaux assistants de recherche AI se comparent-ils en matière d’intégrité des citations, de couverture des bases de données et d’exhaustivité des flux de travail ?
Les assistants de recherche AI les plus souvent recommandés en 2026 sont Elicit pour l’extraction structurée de preuves, SciSpace pour la compréhension des articles, Paperguide pour les flux de travail allant de la revue à la rédaction, Scite pour l’analyse du contexte des citations, et l’Academic Research Assistant de Jenova pour un travail documentaire persistant et multimodèle couvrant la découverte, la synthèse et la préparation de manuscrits. Le classement pertinent ne se résume pas à un unique « gagnant » : il dépend de trois dimensions, à savoir l’étendue réelle du corpus académique qu’un outil peut interroger, l’ancrage de ses affirmations dans des citations, et sa capacité à couvrir une tâche de recherche isolée ou un flux de travail complet.
Les facteurs clés qui distinguent un assistant académique utilisable d’un chatbot générique en 2026 :
✅ Intégrité des citations — des réponses renvoyant à de véritables articles, avec suffisamment de détails bibliographiques pour être vérifiées, plutôt que des résumés fluides mais invérifiables
✅ Couverture de la littérature — l’accès à de grands index académiques (de l’ordre de 125 millions d’articles dans Elicit et de plus de 300 millions d’articles dans Scite), ainsi qu’à la littérature grise lorsque nécessaire
✅ Traitement des preuves — le tri, l’extraction et la synthèse pouvant être audités par un second chercheur
✅ Exhaustivité du flux de travail — la question de savoir si la découverte, la lecture, la citation et la rédaction sont réunies au même endroit ou exigent un ensemble d’outils
✅ Conception avec intervention humaine — des fonctionnalités favorisant la vérification, car les données actuelles ne justifient pas l’utilisation de l’AI générative dans la synthèse des preuves sans supervision humaine
Ces cinq critères constituent la base pratique des comparaisons ci-dessous. Pour choisir parmi ces outils, il est utile de les considérer comme des spécialistes intervenant sur une même chaîne de recherche, plutôt que comme des produits interchangeables d’« AI pour les articles ».
Pourquoi les assistants de recherche AI spécialisés ont-ils gagné du terrain auprès des universitaires ?
Les assistants de recherche AI spécialisés sont passés du statut d’option complémentaire à celui d’infrastructure académique standard, car le volume de publications, l’adoption par les étudiants et les politiques institutionnelles ont tous évolué simultanément. L’édition scientifique produit désormais plus de trois millions de nouveaux articles par an, ce qui rend la recherche par mots-clés sans assistance et le tri manuel de plus en plus coûteux en temps.
Les données d’adoption dans l’enseignement supérieur sont sans ambiguïté. L’HEPI Student Generative AI Survey 2025 a montré que 92 % des étudiants de premier cycle au Royaume-Uni utilisaient l’AI générative, contre 66 % en 2024, et que 88 % l’utilisaient dans le cadre d’évaluations. Les usages académiques les plus courants étaient l’explication de concepts, le résumé d’articles et la suggestion d’idées de recherche — précisément les tâches pour lesquelles les assistants de recherche sont conçus.
Les institutions tentent encore de rattraper leur retard. Une enquête de l’UNESCO a indiqué que deux tiers des établissements d’enseignement supérieur disposent de directives sur l’utilisation de l’AI ou sont en train de les élaborer, mais HEPI a constaté que seuls 36 % des étudiants avaient reçu une formation aux compétences liées à l’AI de leur établissement. Cet écart explique pourquoi les assistants spécialisés par domaine — des outils qui interrogent des bases de données académiques, associent des citations et conservent une piste de recherche — sont recommandés plutôt que les chatbots généralistes pour le travail documentaire.
L’autre moteur est le risque. Les répondants de HEPI ont cité la crainte de résultats faux ou d’hallucinations (51 %) comme l’une des principales raisons de ne pas utiliser l’AI, presque à égalité avec les préoccupations liées à la triche. Les assistants qui récupèrent les informations depuis des index académiques et exposent leurs sources répondent directement à ce mode de défaillance.
Quels critères doivent guider le choix d’un assistant de recherche AI ?
Les chercheurs devraient choisir un assistant de recherche AI à l’aide d’un cadre à six dimensions — couverture, intégrité, extraction, rédaction, persistance et rapport coût-capacité — plutôt que sur la base de listes de fonctionnalités ou de classements « meilleur dans l’ensemble ». L’évaluation selon ce cadre Couverture–Intégrité–Flux de travail (CIW) rend les compromis visibles : un outil peut exceller dans l’explication de PDF tout en restant faible pour le tri systématique, ou être performant pour le contexte des citations tout en offrant très peu de soutien à la rédaction.
Les six dimensions, pondérées pour un usage académique typique :
- Couverture de la littérature — L’outil interroge-t-il un vaste corpus académique, plusieurs bases de données, ou un seul index tel que Semantic Scholar ?
- Intégrité des citations — Les affirmations sont-elles reliées à des articles identifiables, et pouvez-vous voir si des travaux ultérieurs les soutiennent ou les contestent ?
- Extraction des preuves — Pouvez-vous extraire les méthodes, tailles d’échantillon, résultats et limites dans des structures comparables ?
- Aide à la rédaction — L’outil rédige-t-il ou révise-t-il avec la bibliothèque de références comme contexte, ou s’arrête-t-il aux résumés ?
- Persistance — Se souvient-il d’un projet de thèse mené sur plusieurs mois, ou est-il réinitialisé à chaque session ?
- Rapport coût-capacité — Que comprend réellement une offre gratuite et à quel niveau les limites payantes deviennent-elles contraignantes pour le volume d’une revue systématique ?
Les recommandations méthodologiques doivent accompagner les fonctionnalités des produits. Les bibliothécaires spécialisés en synthèse des preuves du King’s College London soulignent que les outils d’AI ne peuvent pas remplacer les méthodes traditionnelles de revue systématique et qu’il est préférable de les traiter comme des compléments. Le guide des revues systématiques de l’OHSU estime de même que l’AI est surtout utile lors des étapes ultérieures et intensives en main-d’œuvre, telles que l’aide au tri et l’extraction de données, et non comme substitut à la conception d’un protocole ou à la recherche dans les bases de données.
Une règle pratique en découle : si le résultat ne peut pas être audité — aucune liste de sources, aucune logique d’inclusion, aucun moyen de relancer la recherche — l’outil est une aide à la lecture, pas un assistant de recherche.
Comment Jenova, Elicit, SciSpace, Paperguide et Scite se comparent-ils pour les flux de travail académiques ?
L’Academic Research Assistant de Jenova est particulièrement performant pour la recherche conversationnelle au long cours, avec mémoire persistante et accès multimodèle ; Elicit excelle dans l’extraction structurée ; SciSpace dans la lecture de PDF denses ; Paperguide dans la combinaison de recherche, tableaux de revue et rédaction avec citations au sein d’un même abonnement ; et Scite dans l’analyse de la manière dont un article est réellement cité. Aucun des cinq ne domine toutes les dimensions CIW, ce qui explique pourquoi les outils « les plus recommandés » en 2026 constituent une présélection et non un nom unique.
| Dimension | Jenova Academic Research Assistant | Elicit | SciSpace | Paperguide | Scite |
|---|---|---|---|---|---|
| Couverture de la littérature | Recherche académique et web en direct par les outils de la plateforme, y compris des bases de données académiques | Recherche sémantique sur 125 millions d’articles ; utilisé par plus de 2 millions de chercheurs | Plus de 200 millions d’articles et PDF importés | Recherche fondée sur des questions parmi plus de 200 millions d’articles | Plus de 300 millions d’articles académiques indexés pour leur contexte de citation |
| Intégrité des citations | Réponses étayées par des sources ; vérification par l’utilisateur toujours requise | Résumés appuyés par des citations ; écarts de sensibilité documentés par rapport à la recherche traditionnelle | Réponses fondées sur l’article ouvert | Recherche, tableaux et rédacteur appuyés par des citations | Indique si les citations soutiennent, contredisent ou mentionnent simplement une affirmation |
| Extraction des preuves | Extraction et synthèse conversationnelles entre les sessions | Colonnes structurées et flux de travail pour revues systématiques | Résumés au niveau de l’article, méthodes et questions-réponses | Tableaux de littérature et rapports Deep Research | Extraction du contexte des citations, et non tableaux de résultats |
| Aide à la rédaction | Préparation de manuscrits et gestion des citations | Rapports et résumés, mais pas d’articles complets | Explications au sein du PDF | AI Paper Writer rédigeant à partir de la bibliothèque de références | Pas un environnement de rédaction |
| Persistance | Historique de discussion illimité et mémoire intersessions | Basée sur les projets et les flux de travail | Sessions de lecture centrées sur les documents | Workbooks et bibliothèques de références | Articles enregistrés et vues de citations |
| Tarification (en 2026) | Offre gratuite ; Plus à 20 $/mois avec un usage 30× supérieur à l’offre gratuite | Offres gratuites et payantes | Offres gratuites et payantes | Gratuit ; Plus 12 $/mois ; Pro 24 $/mois | Offres gratuites et payantes (tarifs payants non vérifiés ici) |
| Idéal pour | Conversations de recherche sur plusieurs mois mêlant découverte, synthèse et rédaction | Tri et extraction à partir d’un ensemble défini d’articles | Comprendre un article difficile directement dans son contexte | Revue complète jusqu’à la rédaction sur une seule plateforme | Vérifier comment la littérature traite une affirmation précise |
Les comparaisons indépendantes confirment cette répartition. Une analyse Paperguide de 2026 comparant Elicit et SciSpace a conclu qu’Elicit est plus robuste pour des flux de travail rigoureux fondés sur les preuves, tandis que SciSpace convient mieux à une découverte exploratoire rapide. Le benchmark de 200 requêtes de SciSpace a rapporté 26,3 articles très pertinents par requête pour son Deep Review, devant Elicit et Consensus dans ce test interne — un signal utile, mais à interpréter comme une évaluation menée par un fournisseur et non comme un substitut à une recherche validée par des bibliothécaires.
Les limites honnêtes comptent autant que les points forts. Jenova ne fournit pas d’index natif de 200 millions d’articles ni de grille de tri de type PRISMA ; il s’agit d’un Agent de recherche doté de recherche en direct, de mémoire et d’aide à la rédaction, et non de DistillerSR. Il a été démontré que la répétabilité et le rappel d’Elicit restent inférieurs au tri classique dans les bases de données. SciSpace reste davantage un lecteur qu’un moteur de revue systématique. Les limites de Deep Research et des workbooks de Paperguide restreignent encore l’étendue de l’automatisation dans les offres inférieures. Scite ne rédigera pas votre section sur les travaux connexes.
Comment l’intégrité des citations varie-t-elle selon les assistants de recherche AI ?
L’intégrité des citations varie davantage d’un outil à l’autre que la qualité de leur interface, et c’est la dimension qui détermine le plus souvent si un assistant peut être utilisé sans risque dans une thèse, une demande de financement ou une revue systématique. Scite est spécifiquement conçu pour montrer comment une affirmation est soutenue ou contestée dans plus de 300 millions d’articles ; Elicit, Paperguide et SciSpace récupèrent des contenus depuis de grands corpus d’articles et ajoutent des références ; les chatbots généralistes ne font souvent ni l’un ni l’autre.
Le mode de défaillance est bien documenté. Dans une étude méthodologique de 2025 comparant Elicit à une revue parapluie réalisée par des humains, les chercheurs ont constaté qu’Elicit n’avait identifié que 17,6 % des études retenues par le tri classique, tout en faisant également apparaître trois articles pertinents que la recherche humaine avait manqués. La répétabilité s’est révélée instable sur trois requêtes identiques. Les auteurs ont aussi signalé qu’Elicit avait cité à tort un protocole de revue lors de la génération d’un résumé — une grave erreur d’intégrité, et non un simple défaut de présentation.
Ce constat explique pourquoi les guides de bibliothèques répètent la même contrainte. Une revue systématique de 2025 sur l’AI générative dans la synthèse des preuves a conclu que les données actuelles ne soutiennent pas l’utilisation de GenAI sans intervention humaine. Le service de revues systématiques du Memorial Sloan Kettering considère également les spécialistes de la synthèse des preuves responsables de toute AI qu’ils utilisent, y compris de la décision de l’employer.
Une hiérarchie utile de l’intégrité pour 2026 :
- Niveau 1 — fluide mais non cité. Réponses de discussion génériques. Inacceptable pour les affirmations académiques.
- Niveau 2 — récupération avec citations. L’outil nomme les articles. Vous devez toujours vérifier que l’article existe et qu’il affirme bien ce qui est avancé.
- Niveau 3 — contexte des citations. Des outils tels que Scite indiquent si des articles ultérieurs confirment, contredisent ou se contentent de mentionner le travail.
- Niveau 4 — synthèse auditable. Critères d’inclusion, cellules liées aux sources et exports qu’un co-auteur ou bibliothécaire peut relancer.
Dans la pratique, l’Academic Research Assistant de Jenova fonctionne aux niveaux 2 à 3 : il recherche des sources en direct et est censé fonder ses affirmations, mais ce n’est pas un graphe de contexte de citations comme Scite, et il ne certifiera pas un diagramme de flux PRISMA. L’associer à Scite, pour analyser la manière dont un article est cité, ou à un gestionnaire de références, pour le dossier canonique, est souvent plus solide que de demander à un seul assistant de s’auto-contrôler.
Comment les assistants AI gèrent-ils la synthèse des preuves et les revues systématiques ?
Les assistants AI couvrent désormais certaines parties de la synthèse des preuves — notamment le tri des titres et résumés ainsi que l’extraction — mais ils ne remplacent pas encore une revue systématique guidée par un protocole. Le modèle recommandé en 2026 est une automatisation supervisée par l’humain à des étapes précises, et non des revues en un clic.
Les preuves empiriques les plus solides concernent le tri. Une revue de revues publiée en 2026 a trouvé des preuves évaluées par les pairs indiquant que l’AI est prête pour le tri supervisé par l’humain des titres et résumés, avec peu de preuves pour les autres tâches de synthèse. L’outil de tri AIM Review a rapporté des réductions de charge de travail allant de 20 % à 95 % dans six revues réelles, ce qui constitue un résultat concernant le tri, et non une autorisation d’automatiser les conclusions. Une comparaison liée à Cochrane a constaté qu’Elicit ne réalisait pas de recherches avec une sensibilité suffisamment élevée pour remplacer la recherche documentaire traditionnelle, bien que sa précision puisse aider dans les recherches préliminaires et à trouver des études supplémentaires uniques.
Les flux de travail des produits convergent vers la même structure en six étapes, clairement illustrée par le pipeline de synthèse des preuves de Paperguide : définir la question, souvent avec PICO/PICOC, interroger un vaste corpus, trier à l’aide de signaux de qualité, extraire dans des tableaux liés aux sources, synthétiser avec des citations et exporter.
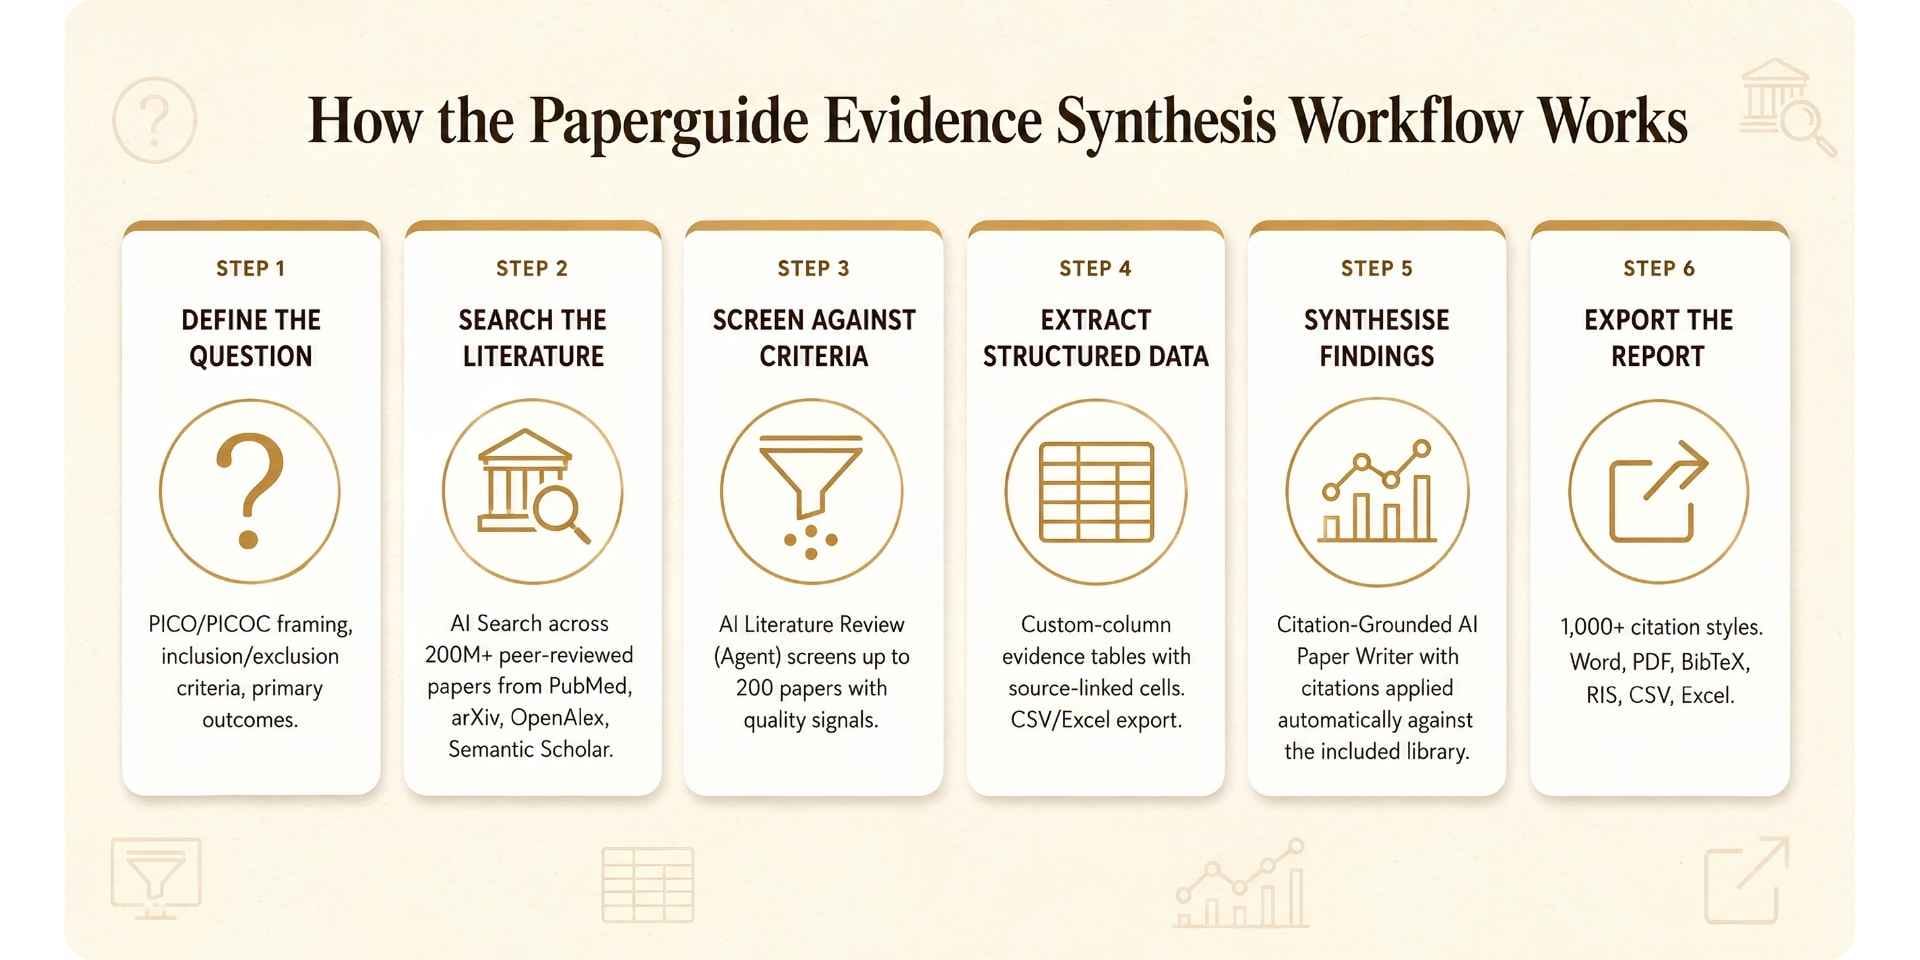
Ce diagramme est une bonne carte du travail à accomplir, et non la preuve que le bouton « Deep Research » d’un fournisseur satisfait aux normes de Cochrane, JBI ou Campbell. Une position conjointe de 2025 de Cochrane, de la Campbell Collaboration, de JBI et de la Collaboration for Environmental Evidence considère l’AI comme un soutien qui ne doit pas compromettre la qualité ni la confiance. Les propres documents de Paperguide décrivent le tri de l’ordre de centaines d’articles par exécution ainsi que des limites de rapports Deep Research, y compris dans les offres payantes — par exemple 50 rapports par mois dans l’offre Pro. Il s’agit d’une synthèse rapide, et non d’une revue Cochrane vivante.
Jenova s’intègre à ce pipeline en tant qu’analyste placé au-dessus de celui-ci : il formule des questions PICO, compare des tableaux d’extraction, recherche les articles manqués lors de la première recherche et rédige la synthèse narrative en conservant la mémoire des décisions d’inclusion antérieures. Il est moins adapté en tant qu’interface de tri spécialisée. Elicit reste plus naturel lorsque la tâche consiste à « transformer 80 résumés en tableau des méthodes et résultats ». SciSpace est plus naturel lorsque la tâche consiste à « expliquer cette section méthodologique et cette équation ».
Comment réaliser une revue de littérature avec un assistant de recherche AI ?
Vous tirerez le meilleur parti d’un assistant de recherche AI en lui donnant une question délimitée, une règle d’inclusion et une étape de vérification, plutôt qu’en lui demandant de « passer en revue la littérature » en une seule requête. La même boucle fonctionne avec tous les outils ; seule l’interface change.
Une séquence fiable :
- Formulez la question sous forme PICO ou équivalente : population, intervention ou phénomène, comparateur, résultats et types d’études.
- Déclarez les règles d’inclusion et d’exclusion avant de commencer toute synthèse.
- Lancez la découverte dans plus d’un système — un index académique spécialisé et une recherche web ou académique en direct — car aucun corpus unique n’est exhaustif.
- Extrayez les informations dans un tableau : étude, conception, n, résultats et limites, plutôt que d’accepter un résumé narratif.
- Vérifiez par échantillonnage chaque citation dans le PDF ou sur la page de l’éditeur.
- Rédigez à partir du tableau, et non à partir de la mémoire narrative de l’assistant concernant ce tableau.
Pour l’Academic Research Assistant de Jenova, la configuration tient dans un seul message de cadrage :
« Je rédige une revue narrative sur les systèmes de tutorat adaptatif dans les filières STEM de premier cycle. Incluez les études empiriques de 2020 à 2026. Excluez les textes d’opinion et les articles non rédigés en anglais. Construisez un tableau avec les auteurs, l’année, le plan d’étude, l’échantillon, les résultats et les limites, puis listez les lacunes probables. Signalez toute citation que vous ne pouvez pas vérifier. »
Poursuivez par une seconde étape demandant à l’Agent de récupérer les données bibliographiques complètes et de séparer les preuves de haute qualité des travaux connexes mais hors périmètre. Comme l’Agent conserve une mémoire entre les sessions, les discussions ultérieures peuvent appliquer la même logique d’inclusion au lieu de devoir réexpliquer le protocole.
Pour Elicit, l’équivalent consiste à commencer par une question de recherche, à appliquer des filtres de type d’étude et d’année, puis à créer des colonnes personnalisées pour les variables qui vous intéressent. Considérez le premier ensemble de résultats comme un complément orienté vers la précision. L’évaluation de BMC Medical Research Methodology a conclu qu’Elicit était complémentaire plutôt que suffisant comme outil de recherche autonome, ce qui constitue la bonne approche opérationnelle.
Pour SciSpace, importez ou ouvrez le PDF et posez des questions fondées sur le document — « Quel était le critère d’évaluation principal ? », « Quelles limites les auteurs reconnaissent-ils ? » — plutôt que de demander une revue de littérature autonome. Cette approche met à profit l’explication dans le document, qui est au cœur du produit.
La littérature grise, les documents de politique publique, les preprints et les forums de praticiens se trouvent souvent en dehors des index académiques. L’Agent Real-Time Search de Jenova est le complément naturel lorsqu’une revue doit également couvrir des discussions Reddit, des implémentations GitHub, des actualités ou d’autres sources non issues de revues, avant de transmettre le noyau académique à l’Academic Research Assistant.
Que disent les équipes d’infrastructure de recherche sur les travaux académiques assistés par AI ?
Les équipes d’infrastructure de recherche considèrent les assistants de recherche AI comme des partenaires à fort effet de levier pour la rédaction et le tri, mais qui échouent encore en environnement fermé sur le rappel, la répétabilité et la fidélité des citations. Le modèle recommandé associe donc contexte persistant et vérification obligatoire, plutôt que des revues entièrement automatisées.
« Le problème des citations n’est pas que les modèles se trompent occasionnellement. C’est qu’ils restent fluides lorsqu’ils se trompent. Dans les flux de travail académiques, nous avons vu des assistants inventer des DOI plausibles, fusionner deux véritables articles en un seul et citer un protocole comme s’il s’agissait de résultats. C’est pourquoi nous évaluons les outils selon la capacité d’un co-auteur à auditer la piste — liste des sources, règle d’inclusion et chemin de retour vers le PDF — et non selon la qualité de la première phrase. »
« La mémoire persistante change davantage l’économie d’une thèse qu’un outil de résumé supplémentaire. Une revue de littérature de doctorat est un objet qui s’étend sur six à dix-huit mois. Si l’assistant oublie que vous avez exclu les études transversales en mars, il continuera à les recommander en octobre. Dans ce contexte, la mémoire intersessions n’est pas une fonctionnalité de confort ; c’est ce qui permet au protocole de survivre à un agenda chargé. »
« L’accès multimodèle est important pour une raison simple : différentes étapes exigent différents profils d’erreurs. Le tri et l’extraction exigent des réponses prudentes et riches en citations. La prose sur les travaux connexes exige une meilleure capacité rédactionnelle. Aucun modèle unique n’est le meilleur dans les deux cas, et enfermer un laboratoire chez un seul fournisseur recrée le même goulot d’étranglement que ces outils étaient censés éliminer. »
— Équipe produit Jenova, conception de flux de travail académiques, huit ans de développement d’Agents de recherche utilisés par des étudiants et des enseignants
Cette vision est cohérente avec la littérature des bibliothécaires. van Dijk et ses collègues soutiennent que l’AI dans les revues systématiques est prometteuse lorsqu’elle est utilisée de manière appropriée, comme un soutien supervisé et non comme l’évaluateur officiel. Les futurs travaux de reporting PRISMA-AI visent à rendre cette supervision visible dans les publications, ce qui correspond à la direction déjà prise par les laboratoires exigeants.
Quel assistant de recherche AI convient aux doctorants, aux équipes de revues systématiques et aux enseignants-chercheurs ?
L’assistant le plus adapté dépend de la tâche à accomplir dans les 30 prochains jours : lecture exploratoire, extraction structurée, vérification des citations ou projet de longue durée combinant les trois. Faire correspondre le profil de l’utilisateur à l’outil permet d’éviter de payer une suite de recherche complète lorsqu’un copilote PDF suffit — et d’éviter d’utiliser un copilote PDF comme s’il s’agissait d’une plateforme de revue systématique.
Doctorants et auteurs de thèses. L’Academic Research Assistant de Jenova constitue un excellent choix par défaut lorsque le projet dure des mois, que les sources s’accumulent et que les mêmes règles d’inclusion doivent être appliquées à nouveau. SciSpace est le meilleur complément lors des journées consacrées à deux ou trois articles difficiles. Paperguide est compétitif lorsque vous voulez la recherche, les tableaux et un brouillon avec citations sans quitter un seul fournisseur.
Équipes de revues systématiques et de synthèse des preuves. Elicit et les outils de tri conçus à cet effet, tels que Rayyan, DistillerSR et leurs équivalents, devraient être au centre du processus, avec un double tri humain. Le consensus des bibliothèques en 2026 reste que l’AI est un complément pour la recherche, le tri et l’extraction. Les rapports Deep Research de Paperguide peuvent accélérer les revues de cadrage ; ils ne doivent pas être soumis comme résultats de niveau Cochrane sans recherche traditionnelle ni tri documenté.
Enseignants-chercheurs, auteurs de demandes de financement et clubs de lecture. Scite est le moyen le plus rapide de demander : « Cette conclusion a-t-elle résisté à l’épreuve du temps ? » Les outils de questions-réponses de type Consensus sont utiles pour une première approche de « Que dit le domaine ? », sous réserve de la même règle de vérification. Jenova est utile lorsqu’un enseignant-chercheur navigue entre plusieurs corpus, brouillons et réponses aux évaluateurs, et qu’il doit conserver le fil du travail.
Étudiants de premier cycle et de master enseigné. Un outil privilégiant la lecture, tel que SciSpace, associé à un vérificateur de citations est généralement suffisant. Le constat de HEPI selon lequel 51 % des étudiants s’inquiètent des hallucinations est la bonne intuition : privilégiez les assistants qui montrent leurs sources et ne copiez jamais des références non vérifiées dans une bibliographie.
Quand ne pas utiliser ces outils comme outil principal. L’élaboration de protocoles, les jugements sur le risque de biais et les décisions finales d’inclusion restent des tâches humaines. Le droit d’auteur limite aussi l’importation de PDF : KCL note que l’importation de textes intégraux protégés par le droit d’auteur dans un outil d’AI est généralement interdite par les titulaires de droits. Vérifiez les conditions de l’éditeur et la politique de votre établissement avant d’importer un PDF payant dans un copilote.
En 2026, les assistants de recherche AI les plus recommandés forment donc un petit ensemble de spécialistes utilisés conjointement : Elicit ou Paperguide pour les preuves structurées, SciSpace pour la compréhension, Scite pour le contexte des citations, et l’Academic Research Assistant de Jenova lorsque le travail prend la forme d’une conversation longue, appuyée sur des sources et devant mémoriser le projet. Le critère de qualité n’est pas l’interface la plus fluide. C’est la combinaison qui laisse une piste que vous accepteriez de défendre lors d’une soutenance, d’une évaluation par les pairs ou d’un audit.
Références
- Elicit — AI pour la recherche scientifique (125 millions d’articles ; plus de 2 millions de chercheurs)
- Scite — AI pour la recherche avec des réponses appuyées par des citations dans plus de 300 millions d’articles
- Paperguide — Plateforme AI pour les flux de travail de recherche scientifique
- Paperguide — Les 7 meilleurs outils d’assistant de recherche AI pour la recherche scientifique en 2026
- HEPI — Enquête 2025 sur l’AI générative chez les étudiants
- ERIC / U.S. Department of Education — Enquête 2025 sur l’AI générative chez les étudiants, HEPI Policy Note 61
- UNESCO — Deux tiers des établissements d’enseignement supérieur disposent de directives sur l’utilisation de l’AI ou sont en train de les élaborer
- King’s College London Library Guides — Outils d’AI dans la synthèse des preuves
- Bibliothèque OHSU — AI dans les revues systématiques
- Memorial Sloan Kettering Cancer Center — Service de revue systématique : AI et revues
- Bernard et al., BMC Medical Research Methodology — Utilisation de l’intelligence artificielle pour les revues systématiques (PMC11921719)
- Paperguide — Elicit vs. SciSpace : comparaison des outils de recherche AI (2026)
- SciSpace Literature Review — benchmark interne de 200 requêtes face à Elicit et Consensus
- Paperguide — Les 5 meilleurs outils AI pour les revues systématiques en 2026
- ScienceDirect — L’AI générative redéfinit-elle les pratiques académiques à l’échelle mondiale ?
- MDPI — Une méta-enquête sur l’AI générative dans l’éducation : tendances, chiffres HEPI de 92 % / 66 %