Chat IA à mémoire vectorielle : rappel sémantique persistant pour les Agents
2026-09-15
Jenova vous propose un chat IA à mémoire vectorielle — des conversations qui retiennent le sens, et pas seulement les derniers messages. En septembre 2026, la plupart des assistants oublient encore les préférences, perdent le contexte des projets et vous obligent à réexpliquer les mêmes fichiers. Cette plateforme stocke les dialogues, les documents et les préférences afin que des Agents spécialisés puissent récupérer le bon contexte lorsque vous en avez besoin.
✅ Mémoire persistante entre les sessions, et non fenêtre glissante qui s'efface d'elle-même
✅ Récupération sémantique plutôt que par mots-clés — trouvez ce que vous vouliez dire, pas seulement ce que vous avez saisi
✅ Bases de connaissances que vous joignez une fois et réutilisez pour la recherche, le code et la rédaction
✅ Le même modèle de mémoire sur le web, iOS et Android
Le chat sans état est peu coûteux à exploiter et coûteux à utiliser. Pour comprendre pourquoi la mémoire vectorielle est désormais au cœur d'un chat IA utile, il faut examiner la manière dont les embeddings, la récupération et le contexte à long terme échouent réellement dans le travail quotidien.
Réponse rapide : qu'est-ce qu'un chat IA à mémoire vectorielle ?
Le chat IA à mémoire vectorielle est un système de récupération qui stocke le sens des conversations sous forme d'embeddings afin qu'une IA puisse rappeler le contexte, les documents et les préférences pertinents entre les sessions. C'est la différence entre un chatbot qui recommence chaque fil de discussion et un Agent qui poursuit le travail.
Fonctionnalités clés :
- Intégrer les messages, fichiers et faits sous forme de vecteurs pour la recherche de similarité
- Injecter uniquement les souvenirs les plus pertinents dans la fenêtre de contexte du modèle
- Conserver un historique de chat illimité et des préférences intersessions sur une seule plateforme
- Fonder les réponses sur les bases de connaissances jointes plutôt que sur des approximations paramétriques
- Retrouver la même mémoire d'une session de bureau sur un téléphone, sans devoir briefer à nouveau l'Agent
Pourquoi la plupart des chats IA oublient encore
Les grands modèles de langage sont de bons raisonneurs et de mauvais archivistes. Leurs poids contiennent des connaissances générales ; ils ne contiennent pas votre backlog, votre schéma ou votre dernière décision. La génération augmentée par récupération existe précisément parce que la mémoire paramétrique est incohérente et difficile à mettre à jour pour un domaine privé, un point synthétisé dans une étude de 2025 sur les architectures RAG.
La demande du secteur pour cette couche de récupération n'est plus expérimentale :
2 652,1 millions USD → 8 945,7 millions USD — Marché mondial projeté des bases de données vectorielles de 2025 à 2030, avec un CAGR de 27,5 %
Ces dépenses sont un symptôme. Les équipes achètent une infrastructure vectorielle parce que le chat sans mémoire échoue continuellement de la même façon :
- Les fenêtres de contexte débordent, si bien que les anciennes décisions disparaissent au milieu d'un projet
- La recherche par mots-clés manque les paraphrases, synonymes et intentions implicites
- Les stacks RAG conçues en interne (découpage, index, évaluation, authentification) bloquent avant la production
- La personnalisation reste enfermée dans l'historique de chat d'un seul fournisseur
- Les réponses dérivent lorsque le modèle ne peut pas s'appuyer sur vos fichiers
Pourtant, intégrer une mémoire durable, privée et consultable sémantiquement au chat quotidien reste encore d'une difficulté frustrante :
Les fenêtres de contexte ne sont pas de la mémoire
Une fenêtre de contexte est un tampon, pas une archive. L'historique des conversations, une question utilisateur et quelques « faits enregistrés » sont concaténés dans un prompt ; tout ce qui ne tient pas est abandonné. C'est pourquoi un Agent de code oublie l'erreur que vous avez collée hier et pourquoi un tuteur vous redemande votre score cible. La mémoire vectorielle se situe en dehors de la fenêtre : elle récupère à l'inférence une petite portion pertinente au lieu d'espérer que la transcription complète tienne encore.
La recherche par mots-clés ne peut pas représenter le sens
La recherche classique privilégie les jetons exacts. La recherche vectorielle compare des embeddings — des représentations numériques multidimensionnelles du sens — à l'aide de métriques telles que la similarité cosinus ou la distance euclidienne. Les embeddings associés à un index vectoriel constituent la couche de récupération qui rend possibles les applications LLM modernes. Sans cette couche, « plan de recrutement T3 » ne récupérera pas la note que vous avez intitulée « effectifs pour l'automne ».
Le RAG conçu en interne est un projet d'infrastructure
Un pipeline de récupération de production nécessite une stratégie de découpage, le choix des embeddings, un index ANN, des filtres de métadonnées, une évaluation et des tâches d'actualisation. Les benchmarks ANN publiés montrent pourquoi les équipes s'y intéressent : les moteurs sont comparés simultanément sur la latence, le débit et la précision, car la vitesse sans rappel correspond à un produit différent. La plupart des personnes qui souhaitent simplement un chat qui se souvient ne devraient pas avoir à exploiter cette stack.
Une personnalisation sans mémoire portable est fragile
Le Digital Economy Lab de Stanford affirme que l'avantage durable dans l'IA proviendra d'un contexte personnel persistant et gouverné par l'utilisateur — et non d'un chatbot isolé supplémentaire. Aujourd'hui, la mémoire est généralement une fonctionnalité de fournisseur : elle ne vous suit pas et peut discrètement façonner ce qui vous est présenté. Les reportages de la Columbia Journalism Review sur la mémoire des chatbots indiquent que le rappel de l'utilisateur peut modifier les informations que les personnes reçoivent.
C'est exactement pour cela que Jenova a été conçu.
La solution Jenova
Jenova considère le chat IA à mémoire vectorielle comme une fonctionnalité par défaut, et non comme un ajout à configurer ultérieurement. L'historique de chat illimité, la mémoire persistante entre les sessions et les bases de connaissances joignables sont disponibles sous chaque Agent spécialisé. Vous vous exprimez en langage naturel ; la plateforme récupère les bons embeddings, outils et fichiers avant que le modèle ne réponde.
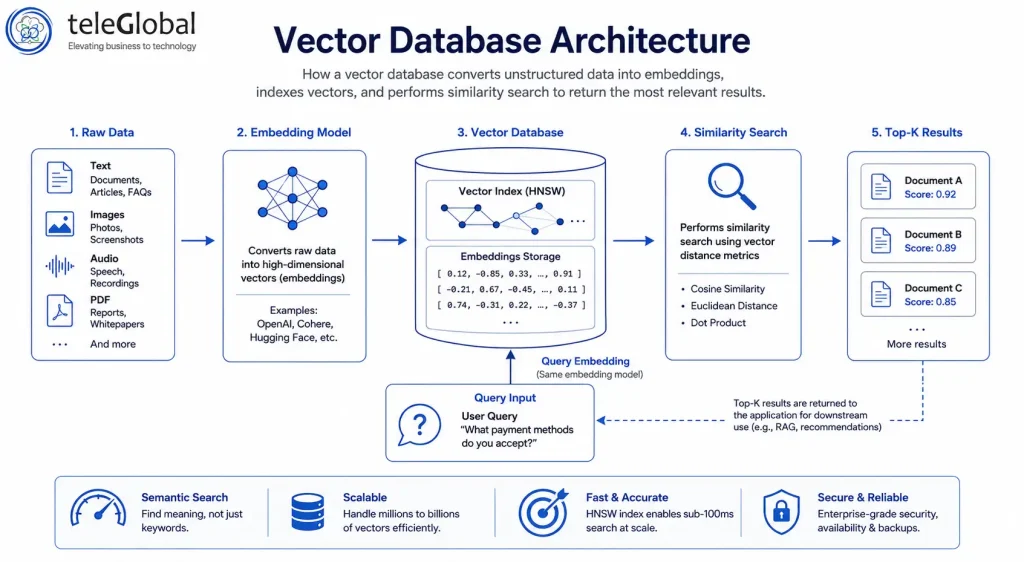
Le diagramme ci-dessus illustre les mécanismes à l'origine de cette expérience : les textes, images et documents non structurés deviennent des embeddings, sont placés dans un index vectoriel et renvoyés comme correspondances top-k pour une requête. Vous ne configurez jamais de paramètres HNSW et ne choisissez pas de métrique de distance. Vous démarrez un fil de discussion.
| Approche traditionnelle | Jenova |
|---|---|
| Coller le même brief dans chaque nouveau chat | Mémoire persistante entre les sessions et les Agents |
| Recherche par mots-clés dans les notes et les PDF | Récupération sémantique à partir d'embeddings |
| Héberger vous-même une base de données vectorielle, un générateur d'embeddings et une évaluation RAG | Stockage et récupération entièrement gérés |
| Un fournisseur de modèles, un silo de mémoire | Accès multi-modèles avec contexte partagé |
| Historique limité au bureau qui disparaît sur mobile | Parité complète sur le web, iOS et Android |
Une recherche qui s'enrichit au lieu de recommencer
Les revues de littérature et les analyses de marché échouent lorsque l'assistant ne se souvient pas des articles que vous avez déjà écartés. Real-Time Search extrait des résultats en direct de Google, Reddit, YouTube, GitHub et plus encore, tandis que la mémoire vectorielle maintient vos critères d'inclusion, citations antérieures et règles « ne pas utiliser cette source ». Vous ne recommencez pas une nouvelle requête booléenne chaque matin ; vous poursuivez une enquête soutenue par la récupération.
Des bases de code que l'Agent connaît réellement
Python Coding Assistant est utile dès le premier jour pour un script. Il devient durable au douzième jour, lorsqu'il connaît toujours l'organisation de votre packaging, le test instable que vous avez décidé d'ignorer et le contrat API que vous avez figé la semaine dernière. Joignez une fois les notes du dépôt ou un document de conception. Les prompts suivants récupèrent ce contexte au lieu d'inventer une architecture parallèle.
Une rédaction qui préserve votre voix et vos faits
Les brouillons s'éteignent dans un chat sans état, car le ton, les formulations interdites et les URL de référence sortent de la fenêtre. Un Agent axé sur l'écriture sur la plateforme peut stocker vos échantillons de style et vos décisions de plan comme mémoire, puis les récupérer lorsque vous dites « même voix que la publication de lancement ». Associé aux pièces jointes de documents, c'est la mémoire vectorielle au service de la continuité éditoriale — et non un prompt plus long.
Une vie et un apprentissage qui ne devraient pas être réinitialisés
Le coaching et la pratique linguistique ne fonctionnent que si l'Agent retient les contraintes : blessures, dates d'examen, vocabulaire que vous maîtrisez déjà. La mémoire persistante transforme un tuteur générique en tuteur qui cesse de répéter les exercices de la première semaine. Le même stockage qui récupère une traceback Python peut récupérer le fait que vous apprenez mieux par le jeu de rôle qu'avec des tableaux de grammaire.
Essayez la plateforme gratuitement — aucune carte bancaire requise.
Agents IA spécialisés pour le chat IA à mémoire vectorielle
La mémoire n'est utile qu'à la hauteur du workflow qu'elle sert. Ces Agents sont conçus pour les tâches où oublier coûte cher — longues recherches, logistique récurrente, pratique immersive et jeux cohérents avec leurs personnages.
Deep Research
La recherche de plusieurs heures est le cas d'école du chat IA à mémoire vectorielle. Cet Agent explore des centaines de sources, synthétise les résultats avec des citations intégrées et fournit des rapports que vous pouvez reprendre demain sans redéfinir la question.
- Stocke la question de recherche, les sources exclues et la thèse de travail
- Récupère les résultats antérieurs afin que les sections ultérieures ne contredisent pas les précédentes
- Fonde les affirmations sur des sources citées plutôt que sur le seul rappel du modèle
Academic Research Assistant
Les workflows de doctorants et d'enseignants-chercheurs couvrent des mois de littérature, de styles de citation et de versions de manuscrits. L'assistant découvre des articles dans les principales bases de données et aide à préparer les manuscrits, tandis que la mémoire conserve votre revue, votre méthodologie et l'ensemble des articles déjà lus.
- Découverte de littérature en temps réel dans les dépôts académiques
- Assistance pour les citations et manuscrits liée à votre brouillon en cours
- Continuité entre les articles liés, et non réponses de chat isolées
Personal Secretary
La logistique est un problème de mémoire : fournisseurs récurrents, préférences de voyage, destinataires de la mise à jour du vendredi. Cet Agent coordonne calendrier, e-mails et opérations quotidiennes avec un contexte personnel approfondi afin que vous n'ayez pas à réenseigner votre routine tous les lundis.
- Retient les préférences permanentes et les personnes avec lesquelles vous travaillez
- Connecte la planification aux outils que vous utilisez déjà
- Transporte le contexte d'un briefing matinal au suivi de l'après-midi
Roleplay Game Master
La cohérence narrative est impossible sans mémoire à long terme. Cet Agent est conçu pour le jeu de rôle immersif avec une mémoire illimitée et des personnages stables — les promesses d'intrigue, les noms de factions et le ton ne se réinitialisent pas lorsque la fenêtre de contexte aurait débordé.
- Mémoire illimitée pour l'état de l'histoire et la voix des personnages
- Récupération de scènes antérieures lorsqu'un chapitre ultérieur en a besoin
- Étendue créative sans perdre la continuité
Learn Russian Through Roleplay
L'acquisition d'une langue dépend d'un contexte espacé et personnel : mots que vous avez manqués, niveau de formalité, histoires que vous avez déjà vécues. Ce mentor utilise des scénarios illimités et une mémoire illimitée afin que la pratique s'accumule au lieu de répéter des scripts pour débutants.
- Retient vos lacunes de vocabulaire et vos types de scénarios préférés
- Maintient la cohérence des personnages et du cadre entre les sessions
- Transforme chaque conversation en exercice soutenu par la récupération
Comment fonctionne le chat IA à mémoire vectorielle
Vous ne déployez pas une base de données vectorielle. Vous démarrez une conversation ; la plateforme gère les embeddings, la récupération et la fenêtre de contexte.
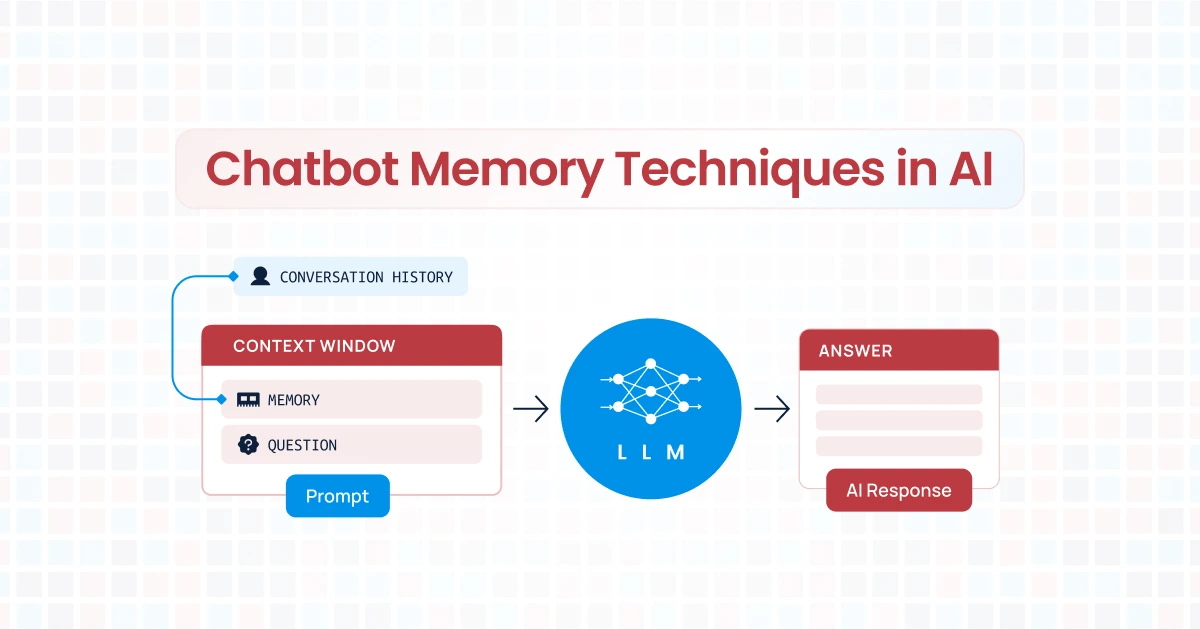
Ce deuxième diagramme représente la boucle visible par l'utilisateur. L'historique, la mémoire stockée et la nouvelle question sont assemblés dans un prompt ; le modèle répond. La récupération vectorielle détermine quels souvenirs appartiennent à ce prompt afin que la fenêtre reste ciblée.
Étape 1 : ouvrez un Agent et définissez le résultat attendu
Choisissez le spécialiste adapté à la tâche — recherche, code, voyage, tutorat — et indiquez à quoi ressemble le résultat final. Le premier message devient un embedding comme tous ceux qui suivent.
« Je rédige une revue systématique sur la génération augmentée par récupération. Privilégiez les études de synthèse à partir de 2024, excluez les blogs de fournisseurs et utilisez le style de citation IEEE. »
Étape 2 : joignez les connaissances auxquelles le modèle doit se fier
Importez des briefs, PDF, notes ou spécifications. Ces documents sont indexés pour la recherche sémantique afin que les questions ultérieures récupèrent des passages par leur sens. C'est le même schéma que les entreprises financent aujourd'hui comme infrastructure RAG, sans que vous ayez à exploiter l'index.
« Utilisez la matrice de littérature jointe. Si un article est marqué comme rejeté, ne le citez plus. »
Étape 3 : continuez à travailler entre les sessions
Fermez l'ordinateur portable. Le lendemain, posez une question de suivi. La mémoire persistante et l'historique illimité permettent à l'Agent de récupérer le périmètre de la revue, la liste des rejets et le dernier titre du plan, au lieu de vous accueillir comme un inconnu.
« Reprenez à partir de la section sur les limites et récupérez les trois articles que nous avons sélectionnés pour la discussion. »
Étape 4 : changez d'appareil sans refaire le briefing
Ouvrez le même fil sur iOS ou Android. Les paramètres et l'historique se synchronisent. Un prompt dans les transports peut récupérer les mêmes vecteurs que la session de bureau ; c'est l'objectif du chat IA à mémoire vectorielle : la continuité, et non un nouveau silo de chat par appareil.
« Je suis en route pour le campus — interrogez-moi sur les trois modes de défaillance du RAG que nous avons listés hier. »
Résultats et cas d'usage
La mémoire vectorielle se manifeste par des heures qui ne sont plus répétées, et non par un graphique de benchmark. Ces scénarios illustrent ce qui change lorsqu'un chat récupère le sens.
📊 Synthèse de littérature sur plusieurs semaines
Scénario : Un étudiant en cycle supérieur a besoin d'une cartographie citée des articles sur la robustesse du RAG, mise à jour tous les quelques jours à mesure que de nouveaux preprints paraissent.
Approche traditionnelle : Un dossier de PDF, une feuille de calcul contenant des notes et un chatbot qui oublie la liste d'exclusion. Le brief est recollé à chaque session. Il est facile de citer deux fois une source ou de manquer une contradiction.
Deep Research : La question, les exclusions et le plan de travail persistent. Les nouvelles exécutions récupèrent la synthèse antérieure afin que le rapport s'enrichisse au lieu de bifurquer.
- Les citations restent alignées avec les sections antérieures
- Les sources rejetées restent rejetées
- Les suivis coûtent moins cher qu'une recherche initiale
💼 Un service Python qui couvre plusieurs sprints
Scénario : Vous développez un service FastAPI avec une spécification OpenAPI figée, un test instable connu et une contrainte de déploiement sur Python 3.11.
Approche traditionnelle : Chaque nouveau chat invente une structure de dossiers différente. Vous passez les dix premières minutes à réexpliquer des décisions que le modèle ne peut pas voir.
Python Coding Assistant : Les notes d'architecture et la spécification résident dans la mémoire et les pièces jointes. Un rapport de bug le jeudi récupère la liste des contraintes du mercredi.
- Moins de refactorisations contradictoires
- Le débogage part de la stack réelle
- L'intégration de votre futur vous-même (ou d'un collègue qui lit le fil) est plus rapide
🎭 Une campagne qui ne doit pas se contredire
Scénario : Une partie hebdomadaire avec des PNJ nommés, un secret que le groupe n'a pas découvert et un ton déjà établi lors de la première session.
Approche traditionnelle : Les notes de session sont dans une autre App ; le chatbot introduit de force un nouveau méchant parce qu'il ne peut pas récupérer l'ancienne promesse.
Roleplay Game Master : L'état de l'histoire est la mémoire. Lorsqu'un joueur cite un détail lancé au passage il y a trois sessions, la récupération peut le ramener dans la scène.
- La voix des personnages reste stable
- Les promesses d'intrigue restent consultables
- Les arcs longs restent cohérents
📱 Planification de voyage depuis la file d'attente à l'aéroport
Scénario : Vous avez planifié un voyage dans trois villes sur votre bureau — plafond budgétaire, journées privilégiant la marche, aucun vol de nuit. À la porte d'embarquement, vous avez besoin d'une révision de demain uniquement, tenant compte de la météo.
Approche traditionnelle : Vous prenez une capture d'écran de vos propres notes. Vous espérez que le chatbot mobile déduira des contraintes qu'il n'a jamais vues.
Travel Planning Advisor : Les préférences et l'itinéraire sont déjà en mémoire. Un prompt depuis le téléphone les récupère et modifie une journée sans reconstruire le voyage.
- Les contraintes survivent au changement d'appareil
- Les suivis locaux respectent le budget
- Vous ne retapez pas le brief dans la passerelle d'embarquement
L'examen des usages réels révèle le même schéma pour lequel les acheteurs d'entreprise de bases de données vectorielles paient : une récupération sémantique à faible latence lors de questions en direct, et non une boîte de chat plus grande.
FAQ
Qu'est-ce qu'un chat IA à mémoire vectorielle ?
Le chat IA à mémoire vectorielle stocke les messages, fichiers et faits comme embeddings, puis récupère les correspondances les plus proches lorsque vous posez une question. Ces correspondances sont insérées dans la fenêtre de contexte du modèle afin que la réponse puisse utiliser votre historique et vos documents. Sur Jenova, cette récupération est intégrée aux Agents spécialisés plutôt que proposée sous la forme d'une base de données distincte que vous devez maintenir.
Jenova est-il gratuit pour le chat IA à mémoire vectorielle ?
Oui. Une offre gratuite inclut les fonctionnalités essentielles avec un usage mensuel limité. Les offres payantes augmentent la capacité d'utilisation et ajoutent des options telles que la sélection de modèles personnalisés. L'usage est réinitialisé à la date de facturation, avec l'intégralité de l'allocation disponible dès le premier jour plutôt qu'une distribution quotidienne.
En quoi cela diffère-t-il d'un chatbot qui « enregistre des souvenirs » ?
De nombreux produits stockent une courte liste de faits ou une transcription évolutive. La mémoire vectorielle récupère selon la similarité sémantique à travers un historique illimité et des connaissances jointes, ce qui est plus proche du RAG que d'un post-it. Les travaux indépendants sur la mémoire à long terme de production pour les Agents considèrent la mémoire évolutive comme un problème de systèmes à part entière — et non comme un simple bouton dans les paramètres. OpenAI a également étendu la capacité de ChatGPT à référencer le contexte de chats antérieurs ; la question architecturale est de savoir si la mémoire est un silo de fournisseur ou une infrastructure sous chaque workflow que vous exécutez.
Puis-je fonder le chat sur mes propres documents ?
Oui. Joignez les fichiers qui doivent prévaloir sur les connaissances préalables du modèle — spécifications, programmes de cours, transcriptions, guides de marque. La récupération privilégie ce corpus lorsque vous posez des questions associées, ce qui vous aide à réduire les hallucinations sur du contenu privé. Un Writing Assistant peut continuer d'utiliser ces échantillons pour le ton ; un Agent de recherche peut continuer de les utiliser pour les affirmations.
Le chat IA à mémoire vectorielle fonctionne-t-il sur mobile ?
Oui. Le web, iOS et Android partagent l'historique, les paramètres et la mémoire. La conversion de la parole en texte est disponible lorsque vous ne pouvez pas saisir de texte. Le scénario de voyage présenté plus haut correspond à la conception prévue : récupérer depuis un téléphone les mêmes vecteurs que vous avez créés à un bureau.
Un Agent avec mémoire est-il suffisamment précis pour les sujets sensibles ?
La mémoire améliore la cohérence ; elle ne rend pas un modèle infaillible. Les études sur le RAG signalent encore la qualité de récupération, le contexte bruité et la fidélité comme des problèmes ouverts (Sharma, 2025). Pour les décisions médicales, juridiques ou financières, considérez l'Agent comme un soutien et vérifiez les informations auprès de sources primaires. Un Personal Therapist peut retenir les thèmes que vous lui avez demandé de garder en mémoire, ce qui est utile pour la continuité — mais ne remplace pas des soins dispensés par un professionnel agréé.
La mémoire vectorielle est l'interface de chat qui s'enrichit enfin
Le chat IA sans état gaspille la seule ressource rare dont vous disposez : le temps passé à vous expliquer. Le chat IA à mémoire vectorielle stocke le sens sous forme d'embeddings, le récupère à la demande et permet aux Agents spécialisés de poursuivre le travail. Le marché de cette couche de récupération progresse, car le problème est universel — de la recherche sémantique dans les systèmes de production au contexte personnel qui devrait appartenir à l'utilisateur.
Jenova place cette mémoire sous la recherche, le code, le récit et la planification sans vous demander d'exploiter une base de données vectorielle. Poursuivez un rapport Deep Research, un service Python ou une campagne de jeu de rôle comme si l'Agent était resté dans la pièce tout ce temps.
Découvrez la bibliothèque complète d'Agents sur Jenova.
Pour les développeurs : Chaque Agent présenté dans cet article est disponible par programmation via l'API Jenova — intégrez la mémoire vectorielle, la récupération et des Agents multi-modèles à votre application avec une seule intégration. Documentation complète →