L'infrastructure de mémoire de Jenova AI dépasse 1 million de dollars d'ARR avec plus de 200 000 utilisateurs dans plus de 70 pays
2026-06-20
NEW YORK, NY — 18 juin 2026 — Azeroth Inc., une entreprise technologique basée à New York et développeur de la plateforme d'agents IA Jenova, a annoncé aujourd'hui que son architecture de mémoire persistante a permis à la plateforme de dépasser 1 million de dollars de revenus annuels récurrents et plus de 200 000 inscriptions d'utilisateurs dans plus de 70 pays, avec une croissance organique de près de 100 %.
Le principe fondamental de Jenova est que les agents IA devraient devenir plus intelligents à mesure que vous les utilisez. Chaque interaction, chaque document téléchargé, chaque préférence exprimée dans un contexte est reportée au suivant. La mémoire n'est pas un ajout. C'est le fondement du produit, et c'est ce qui distingue Jenova des outils d'IA à usage général qui se réinitialisent à chaque session.
Pinecone, dont la base de données vectorielle soutient la couche de récupération de Jenova, a publié une étude de cas détaillée couvrant l'architecture et son impact.
Comment fonctionne la mémoire de Jenova
Jenova propose des centaines d'agents IA spécialisés, du Créateur de Manga qui orchestre la cohérence visuelle sur des centaines de pages, à l'Analyste Fondamental d'Actions qui exécute des pipelines de recherche multi-sources, en passant par le Maître de Jeu de Rôle qui maintient un état du monde persistant sur un nombre illimité de sessions. Chaque agent est un système expert automatisé conçu pour un domaine spécifique avec des flux de travail encodés, et non un simple emballage de prompt sur un modèle à usage général.
Ce qui fait que la valeur de ces agents augmente avec le temps, c'est la mémoire. Chaque conversation, chaque fichier téléchargé, chaque élément de contexte fourni par un utilisateur est conservé, indexé et récupérable. Lorsqu'un utilisateur envoie un message, le pipeline d'orchestration de Jenova détermine quelles connaissances antérieures sont pertinentes, les récupère et les injecte dans le contexte de l'agent avant de générer une réponse. L'agent opère avec une vue organisée de l'historique complet de l'utilisateur, pas seulement de la fenêtre de conversation immédiate.
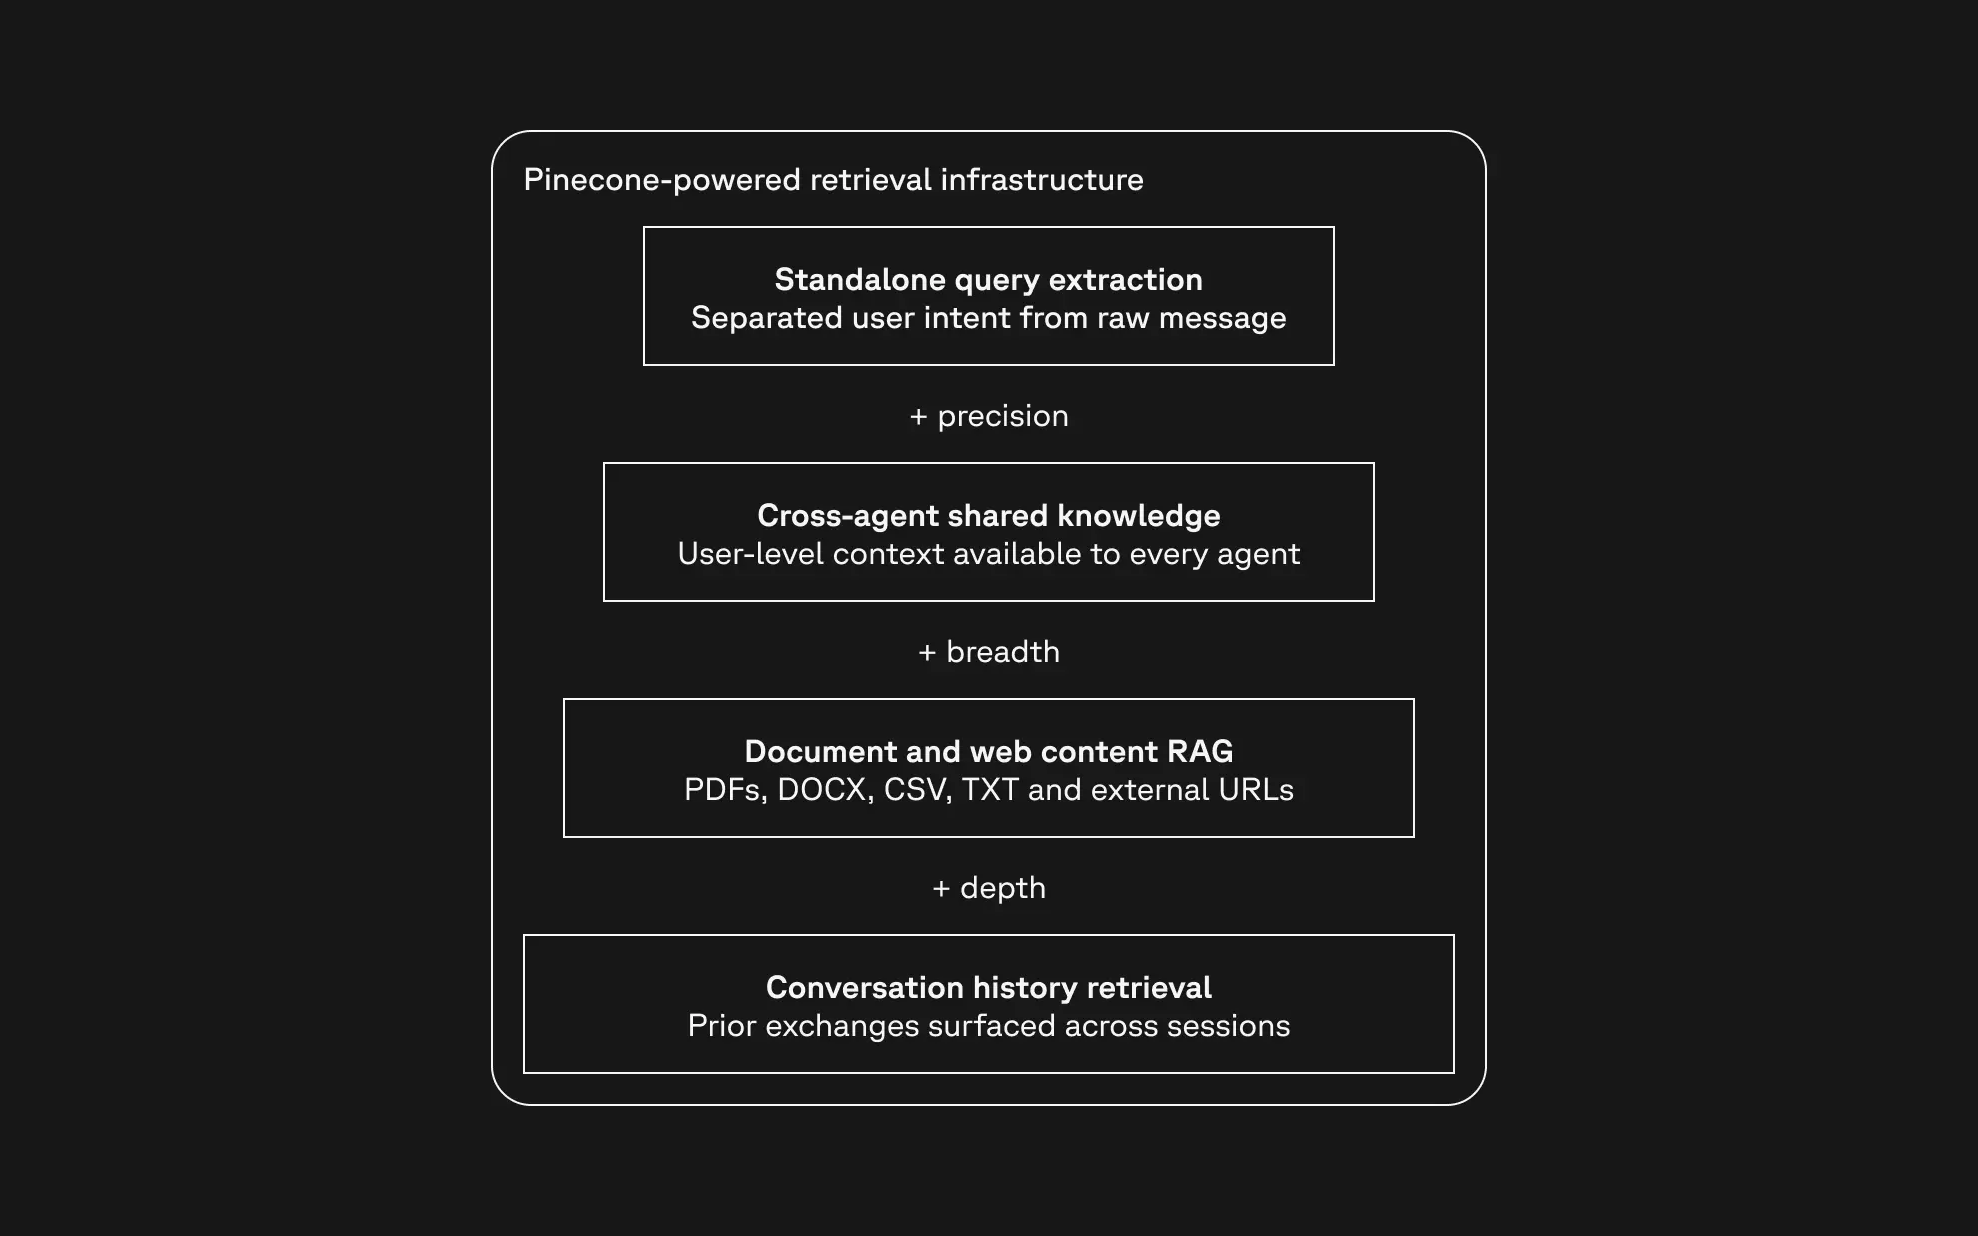
Le système de mémoire a évolué à travers quatre étapes majeures :
- Historique de conversation illimité. Chaque échange est stocké sans compression ni expiration. La plus longue session active sur la plateforme a accumulé plus de 16 millions de tokens. Plutôt que de forcer tout cet historique dans le contexte, le système de récupération de Jenova fait remonter sélectivement ce qui est pertinent pour l'interaction en cours. Rien n'est perdu, mais rien d'inutile n'encombre l'attention de l'agent.
- Intégration de documents et de contenu web. La couche de mémoire s'étend au-delà de la conversation pour indexer les fichiers téléchargés dans plus de 40 formats (PDF, DOCX, XLSX, CSV, TXT, fichiers de code, images, etc.) ainsi que le contenu web externe. Les agents s'appuient sur les matériaux fournis par l'utilisateur ainsi que sur l'historique de la session pour construire leurs réponses.
- Mémoire partagée entre agents. Une couche de mémoire structurée donne à chaque agent de la plateforme un accès au contexte au niveau de l'utilisateur qui persiste entre les agents, et pas seulement entre les sessions. Ce qu'un agent apprend sur un utilisateur est disponible pour tout autre agent avec lequel l'utilisateur interagit. Environ un utilisateur sur quatre sur la plateforme a la mémoire inter-agents active.
- Récupération basée sur l'intention. Le changement d'architecture le plus récent sépare l'intention de l'utilisateur du texte brut du message avant la récupération. Les évaluations internes ont montré une amélioration de 20 à 25 points de pourcentage de la précision de la récupération, ce qui signifie que les agents font remonter le bon contexte antérieur beaucoup plus souvent, en particulier dans les sessions de longue durée où l'historique consultable est vaste.
Résultats
L'architecture de mémoire offre des résultats mesurables sur toutes les métriques critiques. Comme le documente indépendamment l'étude de cas publiée par Pinecone :
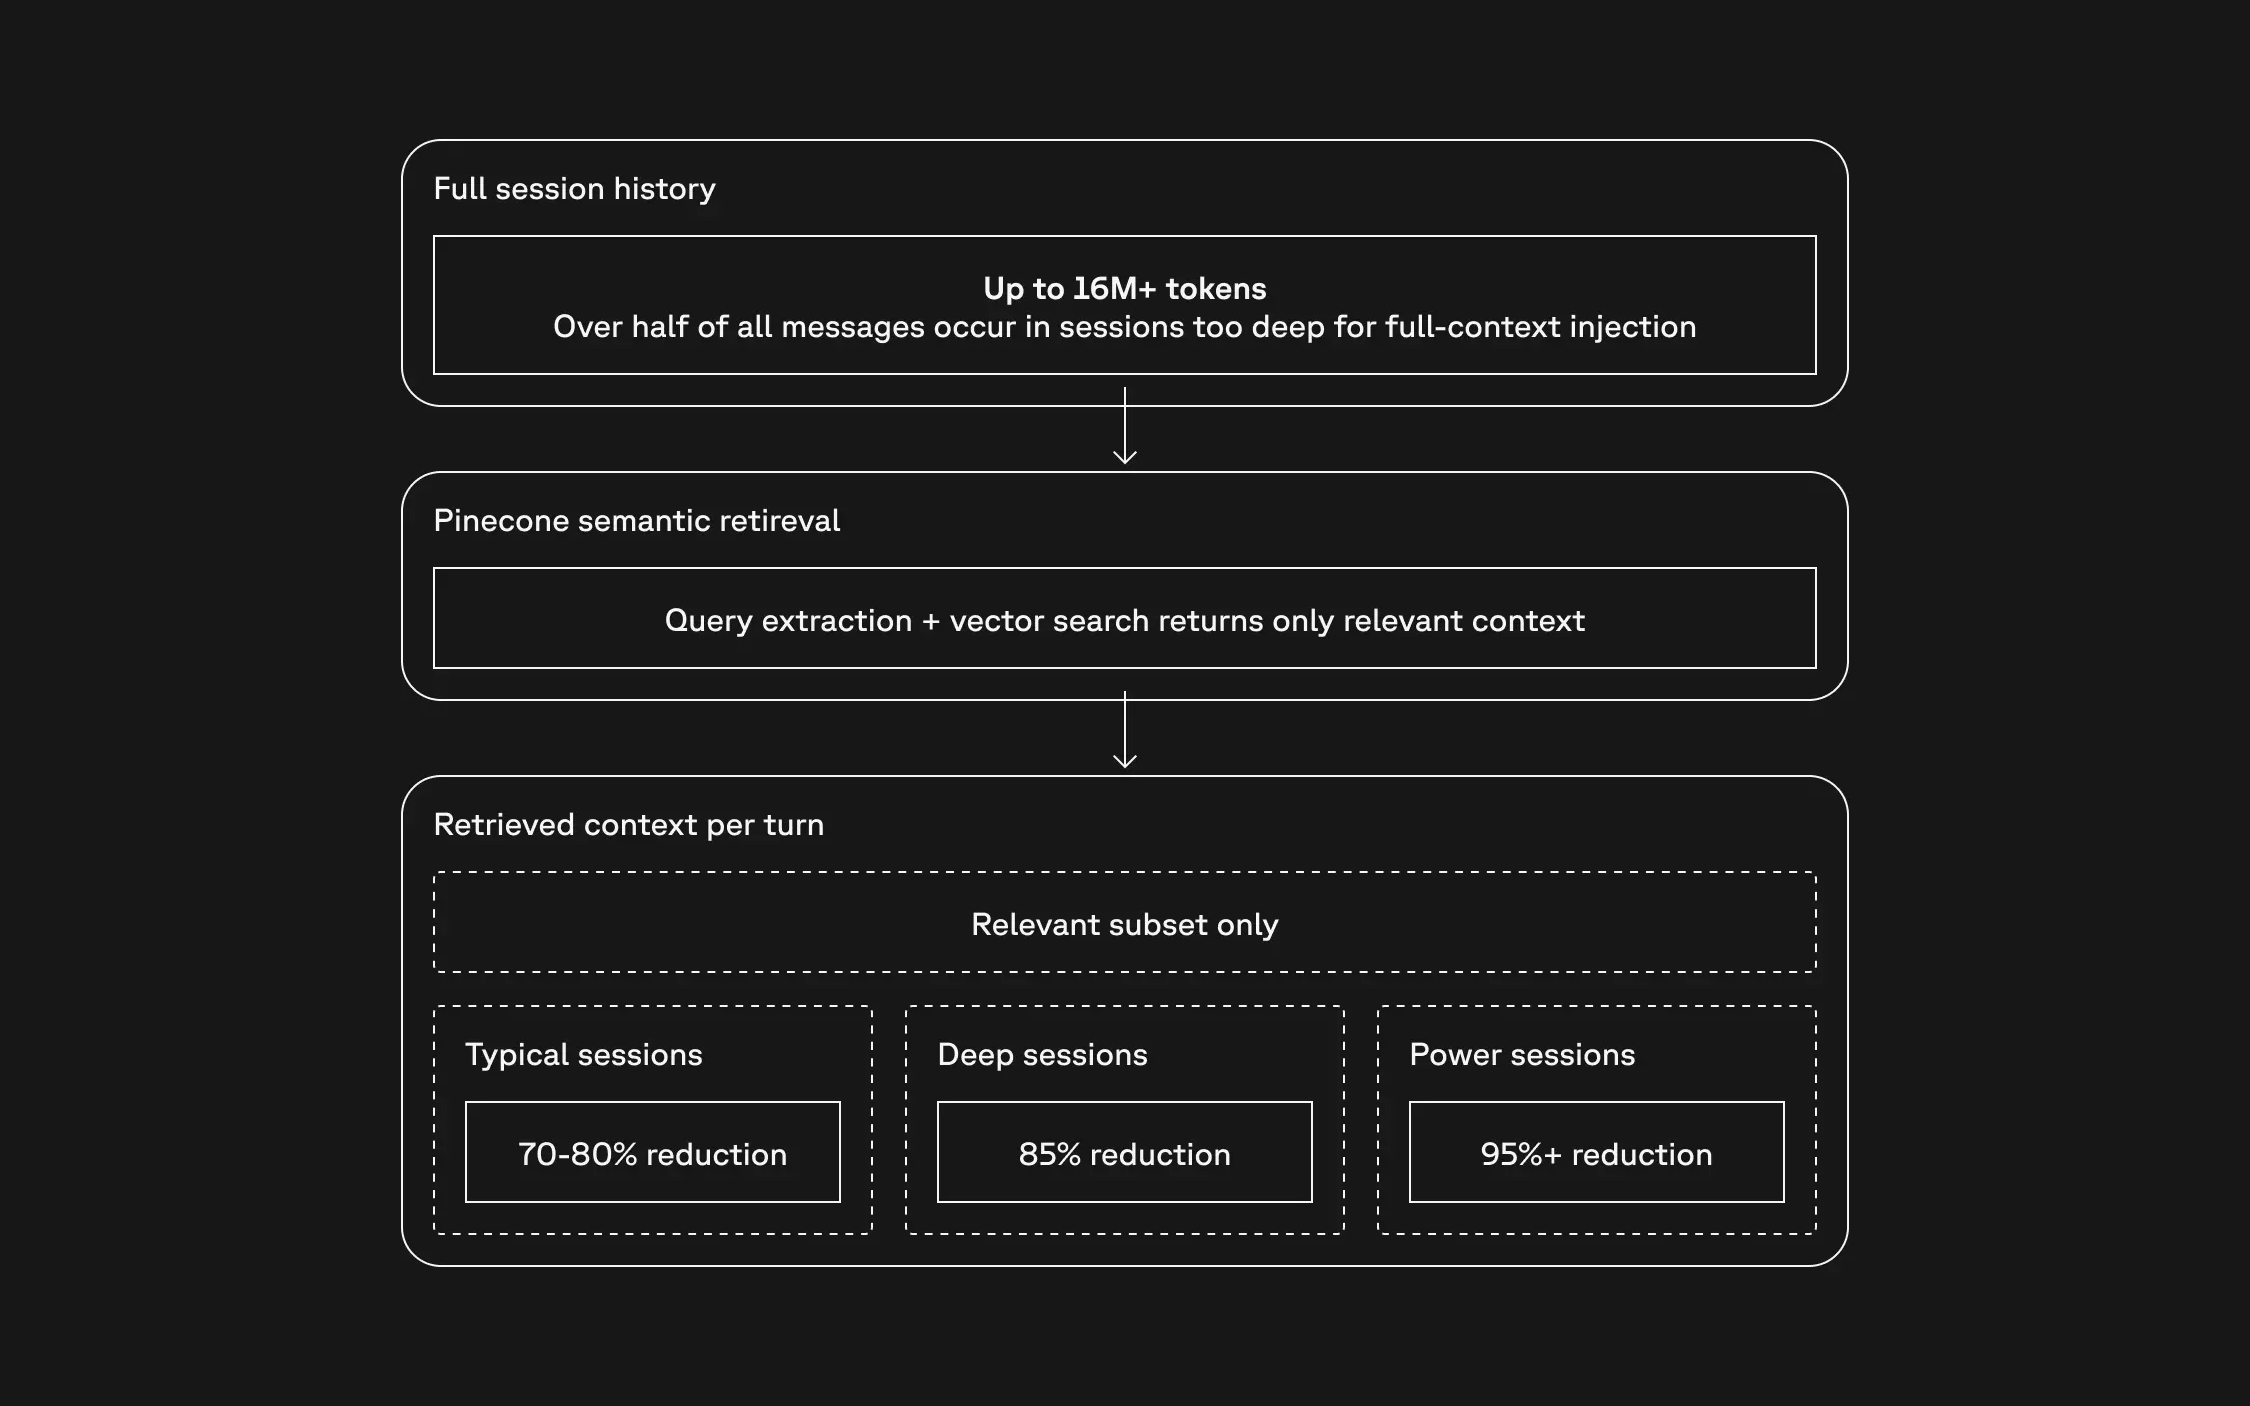
- Réduction de 70 à 95 % de la consommation de tokens par agent. Plus de la moitié de tous les messages sur la plateforme se produisent dans des sessions suffisamment longues pour que l'injection de l'historique complet soit prohibitivement coûteuse ou dépasse entièrement les limites du modèle. La récupération sélective remplace l'injection de contexte par la force brute. Pour les sessions engagées typiques, cela réduit la consommation de tokens de 70 à 80 %. Pour les sessions profondes, de 85 %. Pour les sessions intensives les plus longues, la réduction dépasse 95 %. Ces économies se traduisent directement en marge brute.
- Latence de récupération inférieure à 10 ms. La récupération de la mémoire s'effectue en quelques millisecondes, assez rapidement pour être invisible dans une interaction conversationnelle où les utilisateurs attendent des réponses immédiates.
- Rétention de grande valeur grâce aux connaissances accumulées. Les principaux utilisateurs intensifs de la plateforme, concentrés sur des flux de travail gourmands en mémoire comme le jeu de rôle, l'écriture créative et la recherche spécialisée de longue durée, dépensent de 500 à 2 000 dollars par mois. Des centaines de sessions de contexte accumulé créent un corpus de connaissances qui ne peut être recréé ailleurs. Cet historique représente un coût de changement qui s'accroît à chaque interaction.
- Croissance organique tirée par la qualité de la mémoire. La croissance de Jenova a été presque entièrement organique. Le segment du jeu de rôle, qui représente environ 30 % de tous les utilisateurs, illustre le plus clairement ce schéma : environ 60 % des nouveaux utilisateurs payants de cette catégorie arrivent par le bouche-à-oreille. Lorsque les utilisateurs expliquent pourquoi ils recommandent la plateforme, la qualité de la mémoire est la fonctionnalité qu'ils mentionnent le plus. Les utilisateurs qui ont essayé des produits d'IA dédiés au jeu de rôle citent systématiquement la couche de connaissances persistantes de Jenova comme la raison de leur changement.
- Zéro incident de production lié à la mémoire depuis le lancement. Pour une plateforme où la fiabilité de la mémoire fait partie de la promesse du produit, ce bilan opérationnel est fondamental.
Capacités de la plateforme
La couche de mémoire fonctionne aux côtés de l'infrastructure plus large de Jenova :
- Utilisation avancée des outils agentiques. Taux de réussite de 97,3 % des appels d'outils sur toutes les intégrations MCP avec une mise à l'échelle illimitée des outils.
- Support multi-modèles. Les modèles de pointe d'OpenAI, Anthropic, Google et d'autres grands fournisseurs sont disponibles via une interface unique.
- Parité complète des fonctionnalités. Web, iOS et Android avec tous les paramètres synchronisés sur tous les appareils.
Prochaines étapes
La feuille de route de Jenova approfondit son investissement dans la mémoire et la récupération sur trois horizons :
- Mémoire multimodale. Étendre la récupération pour couvrir le contenu image via des embeddings multimodaux, donnant à des agents comme le Créateur de Manga la capacité de récupérer l'historique visuel d'un utilisateur de manière sémantique plutôt que structurelle.
- Agents proactifs. Les capacités d'agents asynchrones et en arrière-plan permettront aux agents de récupérer et de traiter le contexte de manière proactive. Un analyste boursier qui fait remonter le contexte pertinent du portefeuille avant que l'utilisateur ne le demande. Un agent créatif qui prépare le contexte de continuité avant le début d'une session.
- API d'Agent gérée. Lorsque Jenova ouvrira sa plateforme aux développeurs externes, les agents tiers s'appuieront sur la même infrastructure de mémoire que celle qui alimente les agents internes de Jenova, avec une gestion entièrement gérée de la mémoire, du RAG et de l'orchestration des flux de travail des agents. La connaissance persistante et basée sur la récupération devient une capacité au niveau de la plateforme plutôt que quelque chose que chaque développeur doit construire à partir de zéro.
À propos de Jenova
Jenova héberge un écosystème en pleine expansion d'agents IA spécialisés, conçus pour des cas d'utilisation professionnels et créatifs spécifiques, combinant une connaissance approfondie du domaine, une orchestration de flux de travail en plusieurs étapes et une mémoire persistante pour fournir des systèmes experts dont la valeur augmente avec le temps. La plateforme est utilisée par des utilisateurs dans plus de 70 pays, des étudiants et chercheurs individuels aux équipes au sein d'entreprises du Fortune 500.
Contact
Azeroth Inc. Email : [email protected] Site web : www.jenova.ai