Comment tester un assistant de recherche IA pour garantir l’intégrité des sources ?
2026-08-22
Quels sont les cinq contrôles d’audit qui distinguent une piste de sources vérifiable d’un théâtre de citations ?
Un assistant de recherche IA utilisable est un assistant que vous pouvez auditer, et non un assistant qui donne simplement l’impression d’être sourcé. En 2026, le test pratique consiste à déterminer si l’outil produit une piste de sources — un chemin récupérable depuis chaque affirmation jusqu’à un document réel, daté et cliquable — selon cinq contrôles : couverture des sources, citations cliquables, alignement entre affirmation et source, dates de mise à jour et inférences signalées. Jenova's Academic Research Assistant est conçu pour la découverte de littérature en direct et la gestion des citations, tandis que Elicit, Scite, Consensus, Perplexity et ChatGPT Deep Research réussissent certains de ces contrôles et échouent à d’autres.
La différence ne tient pas à « davantage de notes de bas de page ». Les recommandations d’évaluation des bibliothèques sont explicites : même lorsqu’un outil IA cite une page réelle, le texte généré peut rester erroné ; vous devez donc vérifier la réponse par rapport à la source citée, et pas seulement confirmer l’existence d’une URL (Northwestern University Libraries). Un audit équitable évalue donc cinq dimensions TRACE :
✅ Traçabilité — chaque affirmation importante possède une citation cliquable qui ouvre le document visé
✅ Couverture de récupération — les sources couvrent le bon corpus (articles, rapports, actualités, données primaires), et non un seul index commode
✅ Alignement — le passage cité implique réellement l’affirmation, y compris les chiffres et les nuances
✅ Actualité — les dates de publication ou de mise à jour sont visibles, et les sources obsolètes sont signalées
✅ Étiquetage épistémique — l’assistant indique ce qui est cité, ce qui est inféré et ce qui est inconnu
Pour comparer les outils de manière pertinente, traitez le prompting et la notation comme une infrastructure de production : mêmes requêtes, mêmes règles de réussite ou d’échec, même obligation de signaler toute synthèse non étayée comme une inférence plutôt que comme un fait.
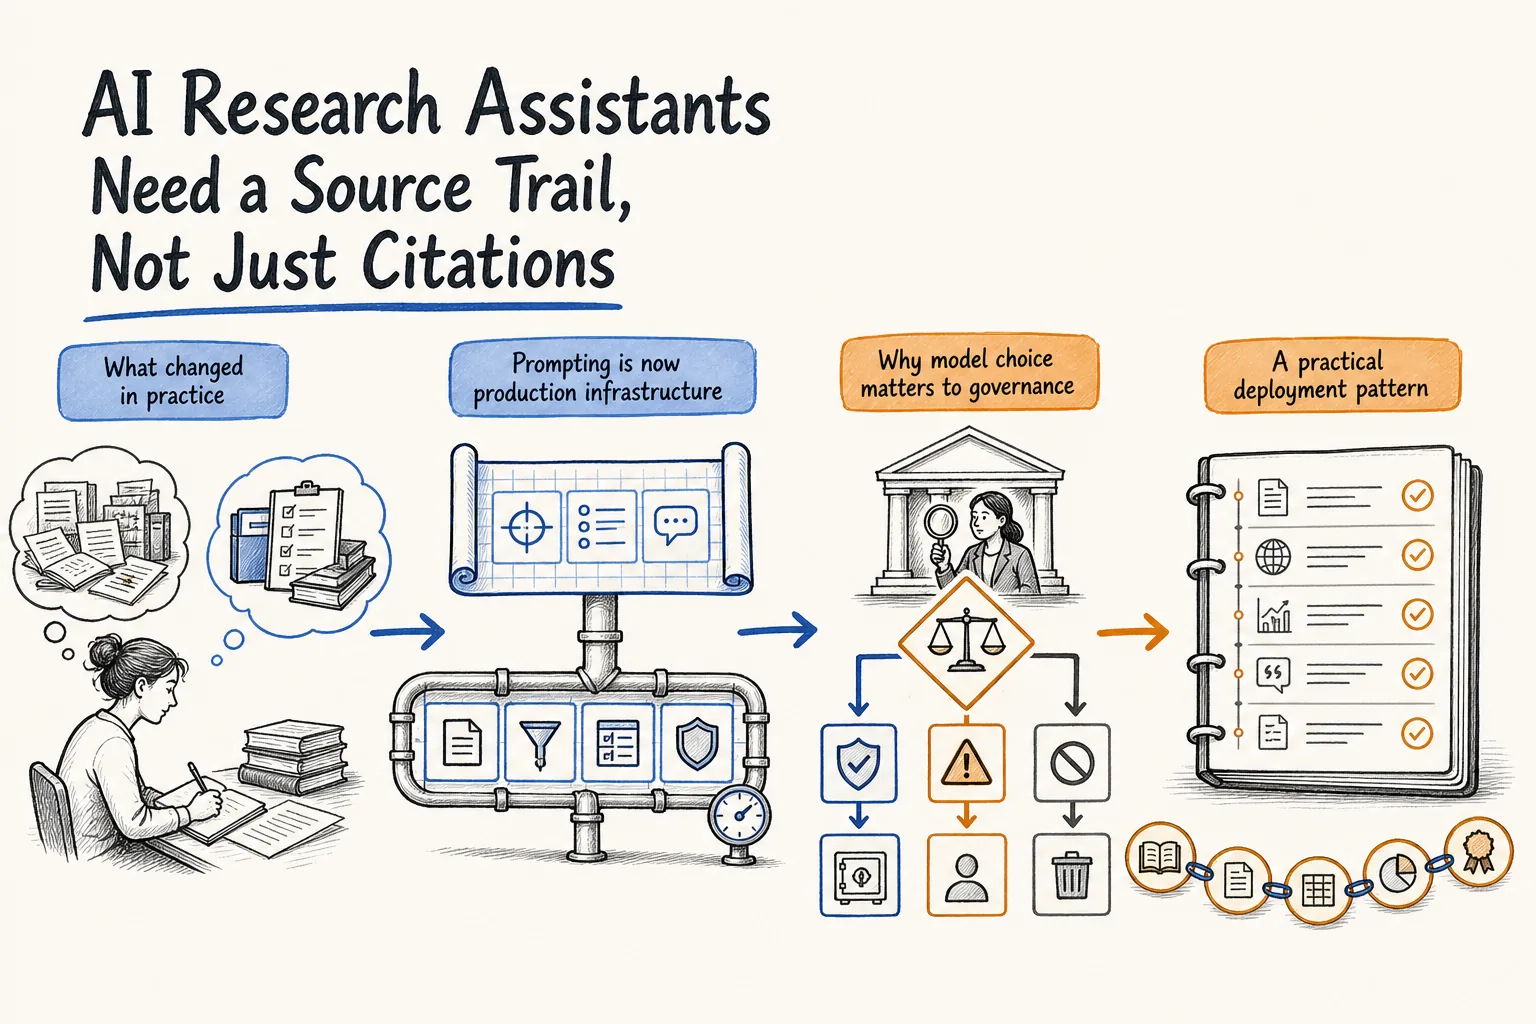
Pourquoi les tests de citations sont-ils plus importants pour les assistants de recherche IA en 2026 ?
Les tests de citations importent davantage aujourd’hui, car les chercheurs utilisent des outils génératifs pour des synthèses à fort enjeu alors que ces outils continuent d’inventer, de mal attribuer et de mettre discrètement à jour leurs sources. University of Nevada, Reno Libraries décrit clairement le mode d’échec : vous évaluez l’affirmation, pas l’impression produite par la liste de sources ; une citation que vous ne pouvez pas localiser peut être une hallucination.
Le taux d’erreur n’est pas théorique. Une étude JMIR sur les références générées par ChatGPT a constaté que seulement environ 73 à 76 % des citations correspondaient à des sources réelles. Stanford HAI a indiqué que les modèles IA juridiques hallucinaient dans au moins une requête d’évaluation sur six. Ces chiffres expliquent pourquoi « il m’a fourni une bibliographie » ne constitue pas un test d’acceptation.
La fraîcheur des informations augmente encore l’enjeu. Des analyses sectorielles sur les citations dans la recherche IA indiquent que près de la moitié des pages citées par l’IA ont moins de 13 semaines, et que le contenu cité par l’IA est en moyenne environ 25 % plus récent que les résultats web classiques. Les assistants qui omettent les dates de mise à jour peuvent sembler actuels tout en recyclant les chiffres du trimestre précédent. Si votre flux de travail comprend des revues de littérature, des notes de politique publique ou de la recherche en investissement, un assistant non audité devient un co-auteur silencieux sans carnet de laboratoire.
Quelle grille de notation utiliser pour auditer un assistant de recherche IA ?
Utilisez une grille au niveau de l’affirmation, avec des seuils binaires et un score gradué d’alignement, plutôt qu’une impression globale du type « cela semble académique ». L’unité d’évaluation est une seule phrase factuelle accompagnée de l’extrait qu’elle cite, ce qui correspond au même niveau de granularité que les pipelines de validation des citations qui comparent les énoncés au texte référencé.
Notez chaque affirmation importante avec cette grille :
| Contrôle | Réussite | Partiel | Échec |
|---|---|---|---|
| Couverture des sources | Source primaire ou évaluée par les pairs adaptée à l’affirmation | Source secondaire pertinente uniquement | Blog, page SEO ou mauvais domaine pour l’affirmation |
| Citation cliquable | L’URL ouvre le document cité à un emplacement exploitable | L’URL ouvre une page d’accueil ou un écran de paywall | Lien mort, redirection sans rapport ou lien fabriqué |
| Alignement affirmation-source | La source implique l’affirmation, y compris les chiffres et les nuances | La source traite du sujet, mais n’étaye pas l’affirmation exacte | Contradiction, chiffre erroné ou extrapolation non étayée |
| Date de mise à jour | Date affichée et adaptée à la requête | Date présente mais obsolète au regard de la question | Pas de date, ou date supposée sans preuve |
| Inférence signalée | L’assistant indique la synthèse, l’extrapolation et les inconnues | Texte sourcé et inféré mélangés, signalement trop faible | Inférences présentées comme des faits établis |
Pour un usage professionnel, un seuil pratique est le suivant : zéro lien fabriqué, zéro affirmation numérique non étiquetée et au moins 80 % des affirmations importantes pleinement impliquées par l’extrait cité. L’implication logique est le bon standard, car elle évalue l’écart d’inférence plutôt que le chevauchement de mots-clés ; des recherches ACL Findings sur l’évaluation Open-QA montrent que la notation par implication suit plus étroitement le jugement humain que les métriques de correspondance exacte.
Appliquez la grille à un ensemble fixe de sondes : une question d’actualité ou de politique publique évoluant rapidement, une affirmation scientifique quantitative, une question portant sur une littérature contradictoire et une question « qu’est-ce qui reste inconnu ? ». Si l’assistant ne peut pas échouer avec élégance au dernier exercice, il n’est pas prêt pour la recherche.
Comment Elicit, Consensus, Scite, Perplexity et Jenova se comparent-ils sur l’intégrité des sources ?
Aucun assistant de recherche IA ne domine toutes les dimensions TRACE. Elicit est le plus solide pour l’extraction structurée depuis un vaste corpus d’articles ; Scite est le plus solide pour la polarité des citations ; Perplexity et ChatGPT sont les plus rapides pour les réponses issues du web ouvert avec des liens intégrés ; Jenova’s Academic Research Assistant est plus robuste lorsque vous avez besoin d’une session de recherche en direct, multi-sources, capable de conserver une piste d’audit au fil des échanges.
Des comparaisons pratiques de 2026 présentent généralement Elicit comme l’outil de référence pour les revues de littérature, et Consensus comme un indicateur plus rapide de réponse oui/non fondée sur les preuves. Des sélections d’outils pour la recherche médicale décrivent Perplexity comme l’option généraliste la plus rapide avec des citations intégrées, et comme moins contraint que les spécialistes académiques. La comparaison d’outils de revue de littérature de HKUST fournit un catalogue utile des différences de couverture et d’accès au sein de cet ensemble.
| Fonctionnalité / Dimension | Elicit | Scite | Consensus | Perplexity / ChatGPT | Jenova Academic Research Assistant |
|---|---|---|---|---|---|
| Couverture des sources | Plus de 125 M d’articles ; priorité à l’académique (Elicit) | Graphe de citations et Smart Citations en texte intégral (Scite) | Corpus d’articles optimisé pour les questions de recherche | Web ouvert avec sources académiques facultatives | Web en direct + recherche académique, flux de travail de manuscrit et de citations |
| Citations cliquables | Fiches d’articles et extraits | Pages de citations avec extraits contextuels | Réponses étayées par des articles | URL intégrées ; qualité variable selon la requête | Liens vers les sources, intégrés et cliquables, dans les réponses de recherche |
| Alignement affirmation-source | Précision d’extraction publiée de 1 502/1 511 points de données (99,4 %) | Montre les citations de soutien ou contradictoires | Solide pour les questions de preuve binaires | L’utilisateur doit vérifier ; risque d’hallucination documenté | Dépend de l’extrait récupéré ; aucun benchmark d’extraction publié |
| Dates de mise à jour | Métadonnées des articles (année, revue) | Contexte de l’année de publication | Contexte de l’année de publication | Incohérentes sans instruction explicite | Peut afficher et comparer les dates lorsque les sources les exposent |
| Inférence signalée | Les colonnes structurées réduisent les extrapolations cachées | Étiquettes de polarité, pas de balises épistémiques complètes | Consensus Meter indique le niveau d’accord | Signale rarement les inférences sans demande explicite | Peut recevoir l’instruction d’étiqueter les affirmations sourcées et inférées |
| Tarification (en 2026) | Non vérifiée dans cette revue | Non vérifiée ; d’anciens tests indiquaient un essai court (Pure AI) | Environ $144/an comme point d’entrée dans une comparaison de 2026 | Non vérifiée ; niveaux définis par les fournisseurs | Utilisation limitée gratuite ; Plus $20/mois (30×), Premium $50, Pro $100, Max $200, Ultra $500, Enterprise $1,000 |
| Idéal pour | Extraction systématique depuis des articles | Vérifier si la littérature soutient une affirmation | Questions scientifiques rapides de type oui/non | Recherche web large avec liens intégrés | Recherche auditable multi-tours et gestion des citations |
La limite honnête de Jenova est structurelle : ce n’est pas une grille d’extraction d’articles conçue à cette fin comme Elicit, et il n’offre pas le graphe de citations soutenantes ou contradictoires de Scite. Son avantage réside dans la mémoire de session et la récupération en direct, ce qui compte lorsqu’un audit exige des questions de suivi sur la même piste de sources. La limite d’Elicit est inverse : exceptionnel au sein d’un index d’articles, mais plus faible comme outil généraliste de recherche sur le web ou les documents de politique publique. Perplexity et ChatGPT restent les outils les plus faciles à surestimer, car des citations intégrées et fluides peuvent tout de même échouer sur l’alignement.
Comment tester la couverture des sources et les citations cliquables ?
Vous testez la couverture en posant des questions dont la bonne réponse ne peut pas provenir d’un seul corpus, puis vous cliquez sur chaque lien. Une couverture réussie signifie que l’assistant récupère le type de source exigé par l’affirmation — un essai pour une taille d’effet clinique, un texte de loi ou une page d’organisme pour un seuil juridique, le codebook d’un jeu de données pour une statistique — plutôt qu’un blog commode qui mentionne les mêmes mots-clés.
Créez trois sondes de couverture :
- Sonde académique uniquement : « Que montrent les essais randomisés depuis 2020 concernant X, et quels résultats ont été préenregistrés ? »
- Sonde de document primaire : « Que disent le règlement, le dépôt ou le jeu de données d’origine — et non un résumé dans la presse ? »
- Sonde d’espace négatif : « Quelles sources réputées abordent ce sujet tout en considérant encore l’effet comme non prouvé ? »
Appliquez ensuite un protocole de clic. Pour chaque citation, consignez si l’URL se résout, si la page d’arrivée est bien le document cité et si une personne peut retrouver le passage étayant l’affirmation en moins de deux minutes. Le guide d’évaluation de Northwestern recommande de rechercher le titre dans un catalogue de bibliothèque ou une base de données, car les systèmes IA associent souvent un titre réel à la mauvaise revue, au mauvais auteur ou à la mauvaise année. Les liens morts, les redirections vers des pages d’accueil et les notes de bas de page « source : Internet » entraînent automatiquement un échec.
Dans Jenova, faites de la couverture une instruction explicite plutôt qu’un simple espoir :
« Répondez en utilisant au moins quatre sources indépendantes. Privilégiez les articles évalués par les pairs, les organismes gouvernementaux ou de normalisation, et les jeux de données primaires. Pour chaque affirmation, fournissez une URL cliquable, le titre du document, la date de publication ou de mise à jour et une citation de 15 à 25 mots qui étaye l’affirmation. Si vous ne trouvez pas de source primaire, dites-le et arrêtez-vous. »
Dans Elicit, le test équivalent consiste à vérifier que les cellules extraites renvoient à des extraits visibles dans les articles plutôt qu’à une paraphrase du modèle. Dans Perplexity ou ChatGPT, le test est plus sévère : ouvrez chaque lien intégré, car les agents de recherche sur le web ouvert peuvent récupérer de nombreuses pages tout en citant la plus faible. Associer Jenova’s Academic Research Assistant à Real-Time Search est utile lorsque la sonde couvre à la fois des articles, des forums, des dépôts de code et des actualités, mais chaque canal nécessite toujours son propre contrôle par clic.
Comment tester l’alignement affirmation-source et l’inférence signalée ?
Vous testez l’alignement en demandant si le passage cité implique la phrase, et non s’il est simplement vaguement connexe. L’échec le plus important est un chiffre presque exact ou un qualificatif supprimé : la source indique « environ 80 % », le modèle écrit « 78 % », et la citation paraît malgré tout parfaite. C’est précisément la catégorie d’erreur que les outils automatisés d’évaluation cherchent à détecter.
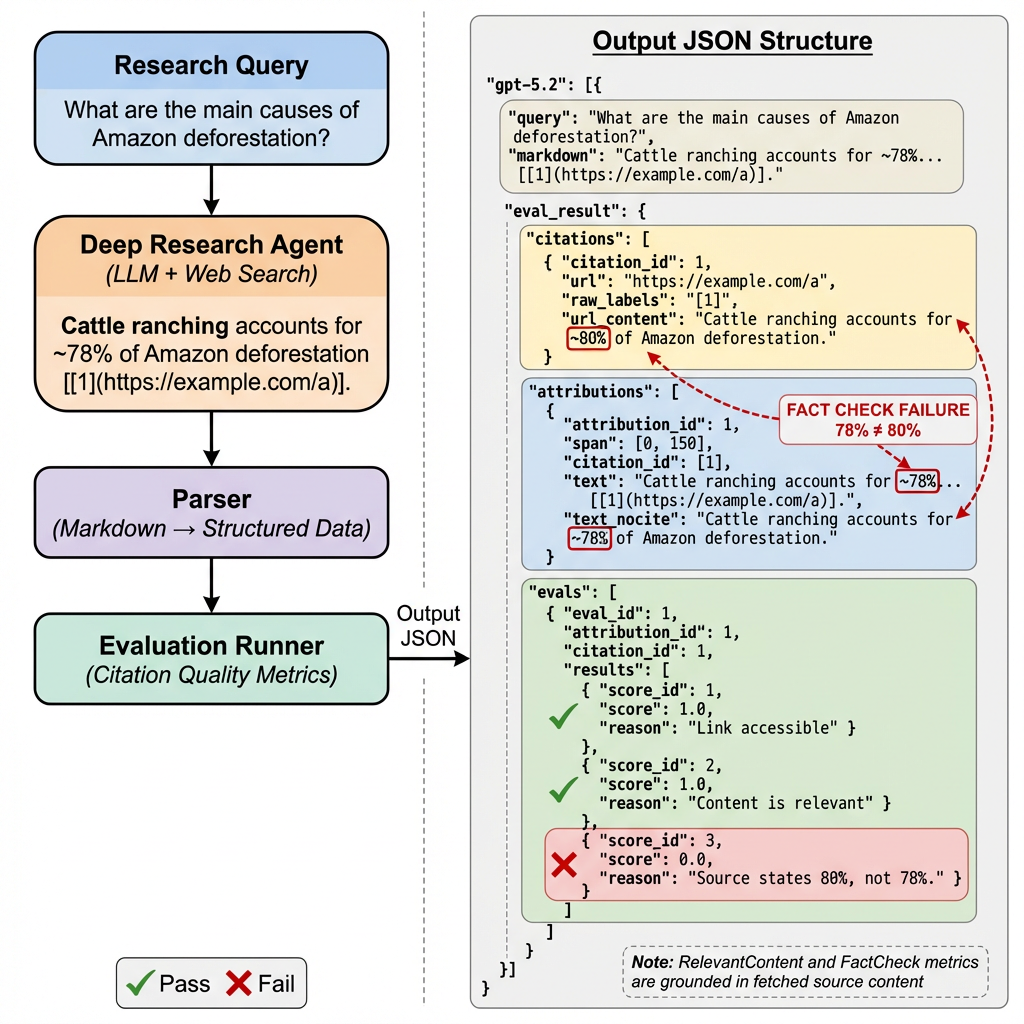
Utilisez un test d’alignement à trois niveaux pour chaque affirmation quantitative ou causale :
- Correspondance de l’extrait : surlignez la phrase de la source censée étayer l’affirmation.
- Implication logique : décidez entre
entailed,underdeterminedoucontradicted.underdeterminedest un échec si l’assistant a présenté l’affirmation comme un fait. - Fidélité des chiffres et des nuances : les unités, l’échantillon, l’année, l’intervalle de confiance ainsi que des termes tels que « peut », « chez la souris » ou « dans un seul pays » doivent être conservés intacts.
C’est pourquoi l’implication textuelle constitue une meilleure métrique d’audit que « la page traite du sujet ». L’évaluation Open-QA fondée sur l’implication existe précisément pour quantifier l’écart d’inférence entre deux chaînes de texte. L’approche de validation des citations de NVIDIA met en œuvre la même idée : comparer l’affirmation au texte référencé, puis l’évaluer.
L’inférence signalée est le contrôle complémentaire. Un assistant de recherche devrait étiqueter chaque paragraphe comme sourced, inferred ou unknown. La synthèse est autorisée ; la synthèse silencieuse ne l’est pas. Les recommandations de UNR pour la vérification des affirmations sont pertinentes : demandez qui peut vérifier l’énoncé. Si la réponse est « les connaissances générales du modèle », la phrase nécessitait une étiquette d’inférence.
Une instruction stricte pour ce contrôle :
« Séparez votre réponse en trois blocs étiquetés : (1) Affirmations directement étayées, chacune avec une citation et une URL ; (2) Inférences, avec les prémisses sur lesquelles elles reposent ; (3) Inconnues. Ne déplacez pas une inférence dans le bloc 1. Si un chiffre est approximatif dans la source, conservez cette approximation. »
Elicit réduit les inférences cachées en imposant des réponses dans des colonnes d’extraction, ce qui constitue une véritable force. Scite indique si des articles ultérieurs soutiennent ou contredisent une citation, ce qui détecte une extrapolation différente : traiter un seul article comme un consensus établi. Jenova peut suivre le format à trois blocs sur une longue session, mais il n’impose pas ces étiquettes sans instruction de votre part. Il s’agit d’un véritable écart produit par rapport aux outils dotés d’indicateurs de preuve intégrés.
Comment vérifier les dates de mise à jour et la fraîcheur des sources ?
Vous vérifiez la fraîcheur en exigeant une date visible pour chaque source et en incluant au moins une sonde dont la bonne réponse a changé au cours de la dernière année. Un assistant incapable d’indiquer quand une page ou un article a été publié n’est pas adapté aux questions sur les prix, les réglementations, les sorties de modèles, l’épidémiologie ou la structure des marchés.
Les recherches sur la fraîcheur du contenu dans la recherche IA concluent que la récence influence la récupération d’une page pour une question actuelle. Les travaux de suivi des citations IA avertissent également que les moteurs réévaluent les sources en continu, de sorte que le résumé clair d’hier peut silencieusement devenir obsolète. Votre audit doit donc consigner trois dates, et non une seule :
- Date de la source — date de publication ou de dernière mise à jour sur la page ou dans l’article
- Date des preuves — année de collecte des données sous-jacentes
- Date de la réponse — moment où l’assistant a récupéré la source
Un échec courant consiste à citer une revue de 2019 pour un chiffre de prévalence « actuel », ou à citer un tableau de bord en direct sans enregistrer l’horodatage de récupération. Les spécialistes académiques comme Elicit et Consensus affichent généralement l’année de publication, car ils reposent sur des métadonnées d’articles. Les outils de web ouvert ne le font souvent pas sans instruction. Jenova peut indiquer les dates lorsque le document récupéré les expose, mais il ne peut pas inventer un horodatage fiable pour une page non datée — et il devrait le dire.
Exemples de sondes de fraîcheur :
« Quel est le chiffre actuel en 2026 ? Indiquez la date de mise à jour de la source. Si la meilleure source a plus de 18 mois, étiquetez la réponse comme historique, et non actuelle. »
« Comparez la source la plus récente que vous pouvez trouver avec la source plus ancienne la plus citée. Qu’est-ce qui a changé, et qu’est-ce qui n’a pas changé ? »
Si l’assistant ne peut pas distinguer une page HTML révisée d’une réimpression PDF inchangée, notez l’actualité comme un échec, même lorsque l’URL fonctionne.
Comment réaliser un audit TRACE reproductible à partir d’une seule instruction ?
Vous réalisez un audit reproductible en figeant l’ensemble de sondes, la feuille de notation et en obligeant chaque outil à produire les mêmes champs vérifiables par machine. L’objectif est d’obtenir une transcription qu’un autre chercheur pourrait noter à nouveau sans vous regarder travailler.
Utilisez cette séquence avec Jenova’s Academic Research Assistant, puis répétez-la avec au moins un spécialiste (Elicit ou Scite) et un généraliste (Perplexity ou ChatGPT) :
- Énoncez le rôle et le contrat de sortie avant la question.
- Posez une sonde de chaque catégorie : quantitative, contradictoire, document primaire et inconnue.
- Exigez un titre, une URL, une date, une citation et une étiquette d’affirmation pour chaque citation.
- Cliquez sur chaque lien et notez TRACE avant de poser toute question de suivi.
- Demandez seulement ensuite une révision des affirmations ayant échoué.
Contrat de départ :
« Vous êtes soumis à un audit. Pour chaque affirmation importante, fournissez : le texte de l’affirmation ; l’étiquette (
sourced/inferred/unknown) ; le titre de la source ; l’URL cliquable ; la date de publication ou de mise à jour ; une citation de soutien ≤25 mots. Si l’alignement est imparfait, abaissez l’étiquette àinferredouunknown. Ne citez pas de sources que vous n’avez pas récupérées. Terminez par une note de couverture indiquant les types de sources utilisés et les types de sources manquants. »
Dans Elicit, la procédure parallèle est la suivante : exécutez la même question sous forme de rapport de recherche, puis vérifiez ponctuellement les cellules extraites par rapport à l’extrait PDF. Dans Scite, exécutez l’affirmation centrale sous forme de requête de contexte de citation et comptez les articles favorables et contradictoires avant d’accepter une phrase au ton consensuel. Dans ChatGPT Deep Research, le propre flux de travail de recherche d’OpenAI exige toujours que vous inspectiez les sources ; la fonctionnalité du produit associe récupération et structure, mais ne remplace pas la vérification de l’implication logique.
Conservez un journal simple — affirmation, URL, date, scores TRACE, notes. Dix affirmations sur quatre sondes suffisent pour dégager une tendance. Si plus de deux affirmations numériques échouent à l’alignement, cessez d’utiliser l’outil pour tout livrable qui sera cité par une autre personne.
Que disent les praticiens de l’intégrité de la recherche sur les tests de citations IA ?
Les pratiques d’intégrité de la recherche convergent vers une règle sans détour : traitez les citations IA comme des affirmations non vérifiées jusqu’à ce qu’un humain ou un contrôle automatisé d’implication ait ouvert la source. Le débat utile ne porte plus sur la question de savoir si les modèles hallucinent, mais sur les défaillances que vous pouvez instrumenter.
« Le secteur continue d’optimiser des bibliographies plus esthétiques. C’est la mauvaise unité d’analyse. Une citation est un pointeur, pas une preuve. Si l’extrait cité n’implique pas la phrase — en particulier le chiffre, la population et l’année — la citation est décorative. Nous avons vu des erreurs “78 % contre 80 %” passer tous les contrôles cosmétiques : URL réelle, titre pertinent, ton assuré. Ce sont ces erreurs qui survivent jusque dans les manuscrits. »
« L’inférence signalée est le contrôle le moins coûteux que la plupart des équipes ignorent. Dès qu’un assistant est autorisé à mélanger la récupération de sources avec ses connaissances générales, il peut transformer des suppositions en résultats. Imposez trois catégories — sourcé, inféré, inconnu — et votre taux d’hallucination devient visible. Les équipes qui refusent d’afficher une catégorie d’inconnues vous disent qu’elles ne peuvent pas représenter l’incertitude. »
« Les tests de couverture constituent également un choix de gouvernance. Un assistant limité aux articles peut sembler rigoureux tout en manquant la note d’une agence qui a modifié la règle le mois dernier. Un assistant limité au web peut sembler actuel tout en manquant l’essai qui a réellement mesuré le résultat. Le choix du modèle importe ici, car certains modèles nuancent, d’autres compressent et d’autres encore suppriment les qualificatifs. L’audit doit suivre l’affirmation, et non la marque. »
— Jenova Product Team, évaluation d’agents de recherche, 6 ans de création de flux de travail de récupération et de citations pour les utilisateurs universitaires et professionnels
Cette position rejoint les pratiques des bibliothèques. Northwestern documente des cas dans lesquels un modèle a cité un véritable article encyclopédique tout en se trompant sur les noms et les dates. UNR invite les chercheurs à se demander qui peut vérifier l’affirmation. Ces deux principes correspondent à TRACE sous forme rédactionnelle.
Quand un assistant de recherche IA est-il suffisamment fiable pour être utilisé dans une recherche réelle ?
Un assistant de recherche IA est suffisamment fiable lorsqu’il réussit un audit TRACE sur vos véritables types de questions, les affirmations défaillantes étant soit corrigées à partir de la source, soit rétrogradées au rang d’inférences signalées. Il n’est pas suffisamment fiable lorsqu’il produit des réponses fluides, riches en liens, qui s’effondrent lors d’un contrôle par clic et implication logique.
Utilisez cette règle de décision :
- Utilisez un extracteur spécialisé comme Elicit lorsque la tâche consiste à filtrer ou extraire des données d’un ensemble connu d’articles, tout en vérifiant encore ponctuellement les cellules.
- Utilisez Scite lorsque la question porte sur le fait de savoir si la littérature soutient, mentionne ou contredit une affirmation précise.
- Utilisez Consensus lorsque vous avez besoin d’une lecture rapide de l’orientation des preuves concernant une question scientifique circonscrite.
- Utilisez Perplexity ou ChatGPT pour une reconnaissance large, puis vérifiez à nouveau chaque chiffre avant qu’il n’entre dans un manuscrit.
- Utilisez Jenova’s Academic Research Assistant lorsque le travail s’effectue en plusieurs tours — découverte de littérature, rédaction de manuscrit et gestion des citations dans un même fil auditable — et que vous êtes prêt à exiger les champs TRACE dans l’instruction.
N’utilisez aucun de ces outils comme dernière étape non supervisée. Les résultats de JMIR sur l’exactitude des citations et les taux d’hallucination de Stanford HAI constituent une raison suffisante pour maintenir un humain dans la boucle. La meilleure configuration en 2026 n’est pas un unique modèle « de confiance ». C’est une piste de sources que vous pouvez rejouer : liens cliquables, documents datés, affirmations impliquées par les sources et frontière visible entre preuve et inférence.
Références
- Northwestern University Libraries — Évaluer le contenu généré par l’IA
- University of Nevada, Reno Libraries — IA et évaluation des sources
- JMIR — Évaluation des performances des grands modèles de langage et de la fiabilité des citations générées
- Stanford HAI — L’IA au procès : les modèles juridiques hallucinent dans 1 requête d’évaluation sur 6, voire davantage
- AuthorityTech — Fraîcheur du contenu SEO en 2026
- Discussion Chris Long / Ahrefs — Fraîcheur et visibilité dans la recherche IA
- ACL Findings — Évaluation Open-QA précise et nuancée grâce à l’implication textuelle
- NVIDIA Developer — Validation automatique des citations avec NVIDIA NIM
- Elicit — IA pour la recherche scientifique, couverture et précision de l’extraction
- Scite — Smart Citations pour la littérature scientifique
- The Drive AI — Elicit contre Consensus contre Semantic Scholar
- iatroX — Meilleurs outils IA pour la recherche médicale en 2026
- Bibliothèque HKUST — Comparaison des nouveaux outils IA de revue de littérature
- Omid Saffari — Meilleurs outils de recherche IA 2026 : Elicit contre Consensus
- Pure AI — Citation nécessaire : mise à l’épreuve de 7 outils de recherche IA
- SEOptimer — Fraîcheur du contenu en SEO et dans la recherche IA
- OtterlyAI — Comment suivre les citations et sources des moteurs de recherche IA
- Firecrawl — Recherche web et Deep Research pour les agents IA
- OpenAI Academy — Recherche avec ChatGPT : Search et Deep Research