Dans quelle mesure la mémoire persistante transforme-t-elle réellement le jeu de rôle avec l’AI ?
2026-08-07
La mémoire persistante entre les sessions transforme le jeu de rôle avec l’AI davantage que tout autre facteur technique : elle fait la différence entre une histoire qui s’accumule et une histoire qui repart à zéro. La mémoire limitée à la session conserve une conversation dans une fenêtre de contexte fixe ; une fois cette fenêtre remplie ou la session terminée, le personnage oublie la promesse que vous avez faite, l’allié que vous avez trahi et l’arc émotionnel construit pendant vingt heures. La mémoire persistante enregistre ces détails dans un stockage extérieur à la conversation et les récupère ultérieurement, afin que la continuité survive au passage d’une session à l’autre.
L’écart pratique se manifeste de manière mesurable. Le benchmark LoCoMo de Snap Research — construit à partir de conversations comptant en moyenne 300 tours et 9 000 tokens sur jusqu’à 35 sessions — a révélé que les modèles à contexte long et les approches augmentées par récupération ont amélioré les réponses aux questions dépendantes de la mémoire de 22 à 66 % par rapport aux références à contexte court. Ils restaient toutefois en retrait de 56 % par rapport aux performances humaines, et de 73 % pour le raisonnement temporel. Cet écart correspond exactement à ce que les joueurs ressentent lorsqu’ils disent : « le personnage a oublié ».
Les facteurs clés qui distinguent une véritable persistance des promesses marketing :
✅ Emplacement du stockage — une mémoire écrite hors de la fenêtre de contexte survit à la fin de la session ; une mémoire qui ne vit que dans le prompt n’y survit pas ✅ Qualité de la récupération — stocker des faits est facile ; faire remonter le bon fait au bon moment narratif est la partie difficile ✅ Raisonnement temporel — savoir quand quelque chose s’est produit, et pas seulement que cela s’est produit, est le domaine où les benchmarks montrent l’écart d’échec le plus important ✅ Cohérence du personnage — mémoire persistante de la personnalité et de la voix, pas seulement des événements de l’intrigue ✅ Contrôles de suppression et d’exportation — la persistance crée une archive durable de conversations intimes, ce qui en fait autant un risque pour la confidentialité qu’une fonctionnalité
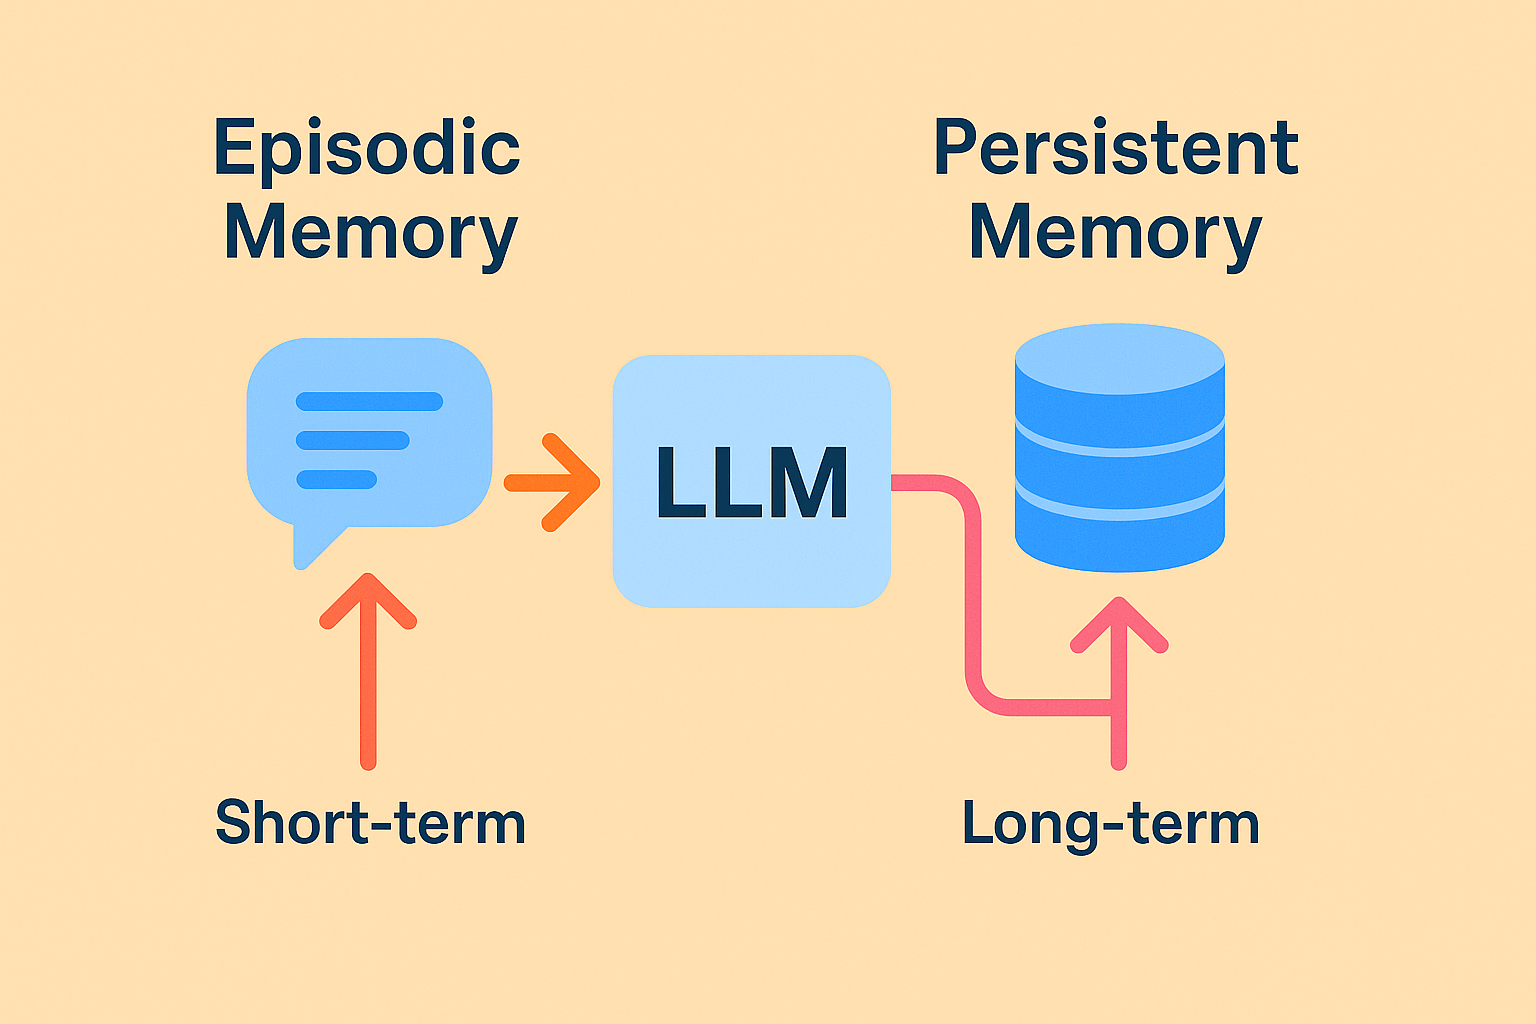
Pour comparer utilement les plateformes de jeu de rôle, il faut distinguer précisément ces deux architectures de mémoire, car la plupart des plateformes utilisent les deux et le langage marketing les différencie rarement.
Quelle est la différence entre la mémoire limitée à la session et la mémoire persistante entre les sessions ?
La mémoire limitée à la session est la fenêtre de contexte du modèle : la transcription continue que le modèle relit à chaque tour. La mémoire persistante est un stockage externe dans lequel le système écrit et récupère des informations, indépendamment de toute conversation unique.
La distinction relève de l’architecture, et non d’une simple question de degré :
Mémoire limitée à la session (épisodique) :
- Réside entièrement dans la fenêtre de contexte active
- Est retraitée pour chaque message généré par le modèle
- Est limitée par un plafond strict de tokens : une fois celui-ci atteint, le contenu antérieur est tronqué ou réduit à des résumés
- Disparaît complètement à la fermeture de la session
- Est rapide et sans perte dans ses limites : rien n’est « récupéré », tout est simplement présent
Mémoire persistante (à long terme) :
- Contient des faits extraits, des résumés ou des embeddings enregistrés dans une base de données extérieure à la conversation
- Est récupérée de manière sélective et injectée dans le contexte lorsqu’elle est pertinente
- Survit à la fin de la session, aux redémarrages de l’App et souvent aux changements de modèle
- Est pratiquement illimitée en capacité, mais imparfaite lors de la récupération : le système doit décider correctement quoi faire remonter
L’asymétrie critique est la suivante : la mémoire limitée à la session offre un rappel parfait dans ses limites, tandis que la mémoire persistante offre un rappel imparfait sans limite. Une fenêtre de contexte de 200 000 tokens se souvient parfaitement de tout ce qu’elle contient. Un système de mémoire persistante se souvient de tout ce que vous avez jamais dit, mais ne fait remonter que ce que sa couche de récupération juge pertinent, et c’est là que les erreurs apparaissent.
C’est pourquoi les recherches recensant les architectures de mémoire AI à long terme associent les systèmes de mémoire AI à des catégories humaines — mémoire épisodique, sémantique et procédurale — plutôt que de traiter la mémoire comme une capacité unique. Un système de jeu de rôle a besoin simultanément d’un rappel épisodique (« vous avez tué le capitaine de la garde au chapitre trois »), d’un rappel sémantique (« ce personnage méprise la noblesse ») et d’une cohérence procédurale (« ce personnage parle toujours par phrases brèves »).
Pourquoi les personnages de jeu de rôle AI oublient-ils votre histoire ?
Les personnages oublient parce que les architectures limitées à la session écartent physiquement le contenu lorsque la fenêtre de contexte est pleine, et parce que les systèmes de mémoire persistante échouent à récupérer l’information même lorsque les données existent encore. Ces deux modes de défaillance produisent le même symptôme côté utilisateur.
Mode de défaillance 1 : dépassement de la fenêtre de contexte. Dans une longue session de jeu de rôle, les premières scènes sont tronquées ou compressées dans des résumés avec perte. Le personnage n’« oublie » pas : l’information n’est tout simplement plus présente devant le modèle.
Mode de défaillance 2 : échec de récupération. Le stockage persistant contient le fait, mais la couche de récupération ne le fait pas remonter parce que le tour actuel ne correspond pas sémantiquement. C’est l’échec le plus insidieux, car la plateforme peut honnêtement affirmer qu’elle dispose d’une mémoire.
Mode de défaillance 3 : confusion temporelle. Le système se rappelle un fait, mais le place mal dans la chronologie. Les résultats du benchmark LoCoMo l’isolent précisément : le raisonnement temporel présente le plus grand écart entre humains et modèles, à 73 %, bien au-delà du rappel général.
Mode de défaillance 4 : rappel halluciné. L’évaluation LoCoMo a constaté que les modèles à contexte long « présentent des hallucinations importantes, ce qui les rend vulnérables aux questions adversariales » : le modèle invente donc avec assurance une histoire commune qui n’a jamais existé. Pour le jeu de rôle, un faux souvenir est sans doute pire que l’absence de souvenir, car il corrompt silencieusement la continuité.
Il s’agit d’un problème largement ressenti, et non d’une plainte marginale. Les joueurs de rôle sur
comme leur principal point de friction, en citant « les personnages qui oublient des événements majeurs passés » comme schéma de rupture précis. La le présente comme un problème technique non résolu dans l’ensemble de la catégorie, malgré l’ampleur de Character.AI.Dans quelle mesure la mémoire améliore-t-elle réellement l’expérience de jeu de rôle ?
La mémoire améliore de manière mesurable l’intelligence perçue et l’engagement, mais les recherches suggèrent que la relation n’est pas purement positive : elle comporte une dimension de confiance qui peut produire l’effet inverse.
Ce qui s’améliore avec la mémoire persistante :
| Dimension | Limité à la session | Persistant entre les sessions |
|---|---|---|
| Aboutissement narratif | Rappels limités à la session en cours | Des éléments posés il y a des mois peuvent trouver leur résolution |
| Cohérence du personnage | La personnalité dérive lorsque la définition initiale est tronquée | La voix et les traits sont ancrés dans un stockage externe |
| Progression relationnelle | Repart de zéro à chaque session | S’accumule sur l’ensemble de l’historique |
| Profondeur de l’univers | Le lore doit être réétabli ou collé dans la conversation | Factions, lieux et règles persistent |
| Friction de démarrage | Élevée : il faut réexpliquer le contexte à chaque session | Presque nulle après la configuration initiale |
Là où la situation se complique. Une étude pilote de l’ACM intitulée « Se souvenir de choses rend les chatbots plus intelligents, mais... » a étudié comment la mémoire sémantique à long terme affecte l’évaluation par les utilisateurs de la sympathie, de l’intelligence perçue et de la sécurité perçue d’un chatbot. Son titre même indique que les gains ne sont pas uniformes sur ces trois dimensions. Une mémoire qui fait paraître un système plus intelligent peut aussi le faire paraître davantage surveillant.
C’est le compromis que le marketing de la plupart des plateformes omet. Un personnage qui se souvient de votre traumatisme d’enfance évoqué il y a quatre mois est à la fois plus immersif et plus troublant qu’un personnage qui ne s’en souvient pas. Le fait qu’il s’agisse d’une fonctionnalité dépend entièrement de l’intention de l’utilisateur : le jeu de rôle narratif et le jeu de rôle avec un compagnon ont réellement des besoins de mémoire différents.
Notre cadre d’évaluation. Évaluer utilement la mémoire pour le jeu de rôle exige six dimensions, et non une seule :
- Étendue de rétention — jusqu’où peut-elle remonter ?
- Précision de récupération — fait-elle remonter le bon souvenir ?
- Exactitude temporelle — place-t-elle les événements correctement dans leur séquence ?
- Fidélité du personnage — la personnalité survit-elle en même temps que l’intrigue ?
- Continuité entre les sessions — fonctionne-t-elle après avoir fermé l’App ?
- Contrôle de l’utilisateur — pouvez-vous examiner, modifier et supprimer ce qui a été stocké ?
La plupart des plateformes optimisent les points 1 et 5, qui sont les plus faciles à promouvoir. Les dimensions 2, 3 et 6 sont celles où se trouve la vraie différenciation.
Quelles plateformes de jeu de rôle AI gèrent le mieux la mémoire ?
Aucune plateforme ne domine toutes les dimensions de la mémoire : le meilleur choix dépend de votre priorité entre l’état du monde, le contrôle de la prose, la variété des personnages et la persistance entre les sessions.
🎭 Character.AI
La plus grande bibliothèque de personnages et le point d’entrée le plus accessible. Character.AI aurait atteint environ 20 millions d’utilisateurs actifs mensuels en février 2026. Sa mémoire repose sur le contexte de conversation et les comparatifs du secteur soulignent une « simulation du monde limitée, l’absence de visuels de scène intégrés et une continuité des longues histoires plus faible que dans les univers de jeu de rôle dédiés ».
Idéal pour : discussions décontractées avec des personnages, découverte, scènes courtes. Limité par : la continuité des longues histoires, la plainte la plus fréquente dans sa propre communauté.
📖 NovelAI
Un studio de prose plutôt qu’un jeu de conversation. Son approche de la mémoire utilise des lorebooks : des entrées organisées manuellement qui injectent les informations pertinentes sur l’univers dans le contexte à partir de déclencheurs par mots-clés. Il s’agit d’une mémoire déterministe : vous contrôlez exactement ce qui remonte.
Idéal pour : fiction en solo, création d’univers et narration dirigée par l’auteur lorsque vous voulez contrôler explicitement ce que le modèle rappelle. Limité par : la nécessité d’une maintenance manuelle ; il n’est pas conçu autour de sessions multijoueurs ou de boucles de jeu.
🃏 Janitor AI
Orienté cartes de personnages avec une grande flexibilité de modèles. La qualité de la mémoire « dépend fortement du choix du modèle, de la configuration et de la conception du personnage », ce qui signifie que la mémoire dépend essentiellement de la configuration de l’utilisateur plutôt que d’être une garantie de la plateforme.
Idéal pour : vaste bibliothèque gratuite de personnages, expérimentation, changement de modèles. Limité par : comportement de mémoire inégal selon les configurations.
🛠️ SillyTavern + modèles locaux
La pile destinée aux utilisateurs avancés. Informations sur l’univers, extensions et contrôle complet du prompt, avec la possibilité d’exécuter l’ensemble localement. La confidentialité est maximale, car aucune donnée ne quitte votre machine.
Idéal pour : utilisateurs techniques qui recherchent contrôle et confidentialité. Limité par : la configuration, le choix du modèle, le matériel et le dépannage font partie de l’expérience : il s’agit d’une pile technique, pas d’un produit fini.
🎲 Jenova's Roleplay Game Master
Roleplay Game Master est conçu autour d’une mémoire illimitée et de la cohérence des personnages, avec une mémoire persistante entre les sessions qui opère au niveau de la plateforme plutôt qu’au niveau de chaque personnage. Comme Jenova conserve un historique de chat illimité et une mémoire persistante dans toutes les sessions, une campagne peut être interrompue pendant des semaines puis reprise sans perdre sa continuité. L’Agent bénéficie également d’un accès à plusieurs modèles : vous pouvez changer le modèle sous-jacent sans perdre l’état narratif accumulé, ce qui est rare dans cette catégorie.
Idéal pour : campagnes de longue durée, liberté créative totale, continuité entre les sessions, flexibilité des modèles au sein d’une même histoire. Limité par : il s’agit d’une plateforme d’Agents à usage général plutôt que d’un produit social de jeu de rôle conçu à cette seule fin. Il n’existe pas de place de marché de découverte de personnages, de cartes de personnages partagées par la communauté, de sessions coopératives multijoueurs ni de génération d’images de scènes intégrée au flux de jeu de rôle. Si votre priorité est de parcourir des milliers de personnages communautaires ou de jouer avec des amis dans un monde partagé, les plateformes de jeu de rôle spécialisées répondent mieux à ce besoin.
Tableau comparatif
| Dimension | Character.AI | NovelAI | Janitor AI | SillyTavern | Jenova Roleplay Game Master |
|---|---|---|---|---|---|
| Type de mémoire | Contexte de conversation | Lorebook + contexte long | Contexte dépendant du modèle | Informations sur l’univers + extensions | Persistante entre les sessions |
| Continuité entre les sessions | Faible pour les longues histoires | Guidée par les lorebooks | Dépendante de la configuration | Dépendante de la configuration | Persistante par défaut |
| Cohérence du personnage | Basée sur les cartes de personnages | Contrôlée par l’auteur | Dépendante de la carte et du modèle | Entièrement personnalisable | Cohérence au niveau de la plateforme |
| Flexibilité des modèles | Modèle de la plateforme | Modèles de la plateforme | Élevée | Complète (local ou hébergé) | Multi-fournisseur, changement possible en cours d’histoire |
| Personnages communautaires | Très grande bibliothèque | Sans objet | Grande bibliothèque gratuite | Import de cartes | Aucun |
| Multijoueur | Fonctionnalités de discussion de groupe | Pas orienté groupe | Priorité au solo | Dépend de la configuration | Non pris en charge |
| Tarification | Niveau gratuit + payant | Niveaux payants | Niveau gratuit | Logiciel gratuit, coût matériel/API | Niveau gratuit ; Plus 20 $/mois (utilisation ×30) |
| Idéal pour | Discussion décontractée avec des personnages | Prose solo et lorebooks | Variété de personnages gratuite | Contrôle et confidentialité maximums | Longues campagnes nécessitant de la continuité |
Les fonctionnalités et tarifs des plateformes évoluent fréquemment. Vérifiez les informations actuelles sur le site de chaque fournisseur avant de faire votre choix.

Comment configurer le jeu de rôle pour maximiser la continuité de la mémoire ?
Quelle que soit la plateforme, la continuité de la mémoire s’améliore considérablement avec une configuration délibérée : la plupart des dégradations peuvent être évitées grâce à la structure plutôt qu’à une technologie supérieure.
Technique universelle : le résumé d’ancrage. Tous les 20 à 30 tours, rédigez un bref résumé dans la session des faits établis. Cela fonctionne avec les systèmes limités à la session (les faits restent dans la fenêtre de contexte) comme avec les systèmes persistants (cela crée un enregistrement riche en signal que la récupération pourra trouver).
« Avant de continuer, récapitule l’état actuel : le nom et les traits de mon personnage, nos alliés, nos antagonistes, les fils narratifs non résolus et notre lieu actuel. »
Pour l’approche par lorebook de NovelAI :
- Créez une entrée de lorebook pour chaque personnage principal, faction et lieu.
- Définissez les déclencheurs par mots-clés sur les noms qui apparaissent dans la prose normale.
- Gardez chaque entrée sous environ 200 tokens : les longues entrées évinceraient le contexte narratif réel.
- Mettez les entrées à jour après les grands développements de l’intrigue plutôt que de vous fier à la transcription.
Pour Jenova's Roleplay Game Master :
- Ouvrez l’Agent sur jenova.ai/a/roleplay-game-master.
- Établissez l’univers et le personnage dans le message d’ouverture plutôt que progressivement :
« Cadre : une cité marchande en déclin où la magie est illégale. J’incarne Kael, un ancien inquisiteur qui fait désormais passer des artefacts interdits en contrebande. Cynique, humour sec, évite la violence directe. Suis ma réputation auprès de trois factions : la Garde, la Guilde et le Chœur Cendré. »
- Continuez dans la même session de chat au fil des jours ou des semaines : la persistance fonctionne au niveau de la session, et le retour au même chat préserve l’état accumulé.
- Pour vérifier la continuité après une longue interruption, demandez un état des lieux :
« Récapitule où nous en étions : ma position auprès de chaque faction, les fils narratifs ouverts et ce que j’allais faire. »
Pour SillyTavern :
- Configurez les entrées World Info avec une profondeur d’analyse et un budget de tokens appropriés.
- Utilisez l’extension de résumé pour maintenir un historique condensé continu.
- Choisissez un modèle doté d’une grande fenêtre de contexte : la qualité de la mémoire est ici directement limitée par votre choix de modèle et votre matériel.
Habitude valable sur toutes les plateformes : nommez les éléments explicitement et réutilisez exactement les mêmes noms. Les systèmes de récupération s’appuient sur la similarité sémantique, et une dénomination incohérente (« le capitaine » contre « Vell » contre « ce type de la garde ») fragmente en trois souvenirs faibles ce qui devrait n’en être qu’un seul.
Quels sont les risques de confidentialité de la mémoire persistante pour le jeu de rôle ?
La mémoire persistante signifie que votre historique conversationnel intime est stocké, conservé et potentiellement difficile à supprimer. Les recherches sur cette catégorie spécifique mettent en évidence d’importantes lacunes en matière de gouvernance.
Une étude arXiv de 2026 analysant 2 909 publications Reddit dans 79 subreddits sur une année a identifié quatre schémas de confidentialité récurrents dans les AI de compagnons et de jeu de rôle :
- Exigences d’accès disproportionnées — vérification d’identité et intégrations étendues qui semblent excessives dans un contexte de compagnon.
- Sensibilité accrue dans les usages intimes — les conversations deviennent « reclassées comme des archives de type journal intime ou hautement intimes ».
- Incertitude interprétative et surveillance perçue — des signaux contradictoires sur la confidentialité produisent une sensation généralisée d’être observé.
- Irréversibilité, persistance et charge pour l’utilisateur — la suppression et la migration deviennent difficiles, et la charge de la protection de la confidentialité est transférée aux utilisateurs.
L’argument central de l’étude est directement pertinent pour la question de la mémoire : la confidentialité dans ces systèmes « dépend non seulement des données collectées ou réutilisées, mais aussi de la manière dont la gouvernance est organisée à travers l’accès, l’interprétation, la rétention et la sortie ». La mémoire persistante est de la rétention par conception. La fonctionnalité et le risque reposent sur le même mécanisme.
L’article relève également que l’autorité italienne de protection des données a infligé une amende à Replika pour des violations de la confidentialité, notamment liées à des défaillances de vérification de l’âge. Cela prouve que l’examen réglementaire de cette catégorie est actif, et non théorique.
Liste de contrôle pratique avant d’activer la mémoire persistante :
- ☐ Pouvez-vous consulter ce que le système a enregistré à votre sujet ?
- ☐ Pouvez-vous supprimer des souvenirs individuels, ou uniquement l’ensemble du compte ?
- ☐ La suppression efface-t-elle réellement les données, ou les masque-t-elle seulement dans l’interface ?
- ☐ Vos données conversationnelles sont-elles utilisées pour entraîner des modèles AI publics ?
- ☐ Pouvez-vous exporter votre historique si vous souhaitez migrer ?
Jenova indique que les données utilisateur ne sont jamais utilisées pour entraîner des modèles AI publics, qu’elles sont chiffrées en transit et au repos, et qu’elles ne sont ni vendues ni partagées avec des annonceurs. Global Memory — la couche entre les sessions — peut être entièrement désactivée dans Settings, ce qui désactive à la fois le stockage et la récupération. Les configurations locales telles que SillyTavern avec des modèles locaux offrent le meilleur niveau de confidentialité disponible, puisque les données ne quittent jamais votre matériel, au prix d’une plus grande complexité de configuration.
Que disent les chercheurs sur la mémoire conversationnelle à long terme ?
Le consensus de la recherche est que la mémoire persistante apporte de vrais gains, mais reste largement en deçà des performances humaines, particulièrement pour le raisonnement temporel. L’écart de fiabilité, et non l’écart de capacité, constitue le goulet d’étranglement actuel.
« Le résultat le plus souvent mal interprété dans la littérature sur la mémoire est le chiffre d’amélioration mis en avant. LoCoMo a montré que les approches augmentées par récupération et à contexte long amélioraient les QA dépendantes de la mémoire de 22 à 66 %, ce qui donne l’impression que le problème est presque résolu. Mais le même benchmark a révélé un écart global de 56 % avec les performances humaines et de 73 % sur le raisonnement temporel. Pour le jeu de rôle en particulier, le raisonnement temporel est le produit. Une histoire est une séquence. Si le système sait qu’une trahison a eu lieu mais ne peut pas la situer par rapport à l’alliance qui l’a précédée, la logique narrative s’effondre, même si le rappel a techniquement réussi. »
« Le deuxième point à souligner est que le rappel halluciné constitue un mode de défaillance distinct de l’oubli, et qu’il est plus dommageable dans les contextes créatifs. L’évaluation LoCoMo a constaté que les modèles à contexte long avaient des difficultés avec les questions adversariales : ils confirmaient avec assurance des événements qui n’avaient jamais eu lieu. Pour un assistant factuel, c’est une erreur que vous pouvez détecter. Dans une campagne de jeu de rôle de 40 heures, un souvenir partagé inventé avec assurance devient canon, et l’utilisateur n’a aucune référence externe pour le vérifier. C’est précisément pourquoi nous considérons la précision de récupération comme plus importante que le rappel de récupération. »
« L’implication architecturale est que le stockage illimité n’a jamais été la partie difficile. Tout noter est trivial. La difficulté consiste à décider quels trois faits parmi dix mille doivent se trouver dans la fenêtre de contexte pour ce tour. C’est un problème de classement, et c’est là que se concentre réellement l’effort d’ingénierie restant dans cette catégorie. »
— Équipe Produit Jenova, mémoire et orchestration des Agents AI, plus de 6 ans de création de systèmes conversationnels de production
La littérature de recherche soutient largement ce cadrage. L’évaluation par Aveni Labs de la mémoire à long terme pour les LLMs explore plusieurs types de mémoire distincts plutôt que de traiter la mémoire comme un bloc monolithique, tandis que des recherches ACL Findings sur l’évaluation de la mémoire à long terme proposent des méthodes d’évaluation plus précises, signe que la mesure elle-même demeure un problème ouvert.
Fait notable, les auteurs de LoCoMo ont constaté que RAG offre un compromis équilibré, « combinant la précision des LLMs à contexte court avec la compréhension étendue des LLMs à contexte large », et qu’il fonctionne « particulièrement bien lorsque les dialogues sont transformés en une base de données d’assertions (observations) sur la vie et la personnalité de chaque locuteur ». Pour choisir une plateforme de jeu de rôle, cela favorise les systèmes qui extraient des faits structurés plutôt que ceux qui se contentent de stocker des transcriptions brutes.
Quelle approche de mémoire choisir selon votre style de jeu de rôle ?
La bonne architecture dépend de la durée des sessions, de la complexité de l’histoire et du niveau de maintenance manuelle que vous êtes prêt à assumer : aucune option n’est universellement supérieure.
Choisissez la mémoire limitée à la session si :
- Vos scènes sont autonomes et durent moins de quelques heures
- Vous aimez recommencer avec des variations plutôt que poursuivre un même fil
- La confidentialité est primordiale et vous ne souhaitez aucune archive conservée
- Vous explorez des personnages plutôt que de construire une campagne
Choisissez une mémoire organisée de type lorebook (NovelAI, SillyTavern World Info) si :
- Vous écrivez de la fiction longue dans un univers défini par une bible
- Vous souhaitez un contrôle déterministe sur ce que le modèle rappelle
- Vous êtes prêt à maintenir les entrées manuellement
- La précision éditoriale compte davantage que la commodité
Choisissez une mémoire persistante automatique (Jenova Roleplay Game Master et solutions similaires) si :
- Votre campagne s’étend sur des semaines ou des mois, à travers de nombreuses sessions
- Vous voulez de la continuité sans la charge de maintenance manuelle
- La progression des relations et de la réputation est centrale dans l’expérience
- Vous appréciez de pouvoir fermer l’App et revenir sans devoir rétablir le contexte
Choisissez une solution locale ou auto-hébergée si :
- La confidentialité n’est pas négociable
- Vous voulez examiner et modifier directement la couche de mémoire
- Vous disposez du matériel nécessaire et tolérez le travail de configuration
Le résumé honnête : la mémoire persistante entre les sessions fait une grande différence, probablement la plus grande différence actuellement disponible dans les outils de jeu de rôle, mais elle n’est pas gratuite. Elle augmente la surface de risque pour la confidentialité, introduit un risque de rappel halluciné que les systèmes limités à la session n’ont pas, et échoue encore au raisonnement temporel d’une manière qui rompra parfois l’immersion. La choisir implique d’accepter ces compromis en échange d’histoires qui s’accumulent réellement.
Si vous menez une campagne au long cours et souhaitez une mémoire illimitée avec des personnages cohérents d’une session à l’autre, le Roleplay Game Master est conçu précisément pour cela.