Comment vérifier la confidentialité, les preuves et la sécurité en cas de crise dans un outil de santé mentale basé sur l’AI ?
2026-08-20
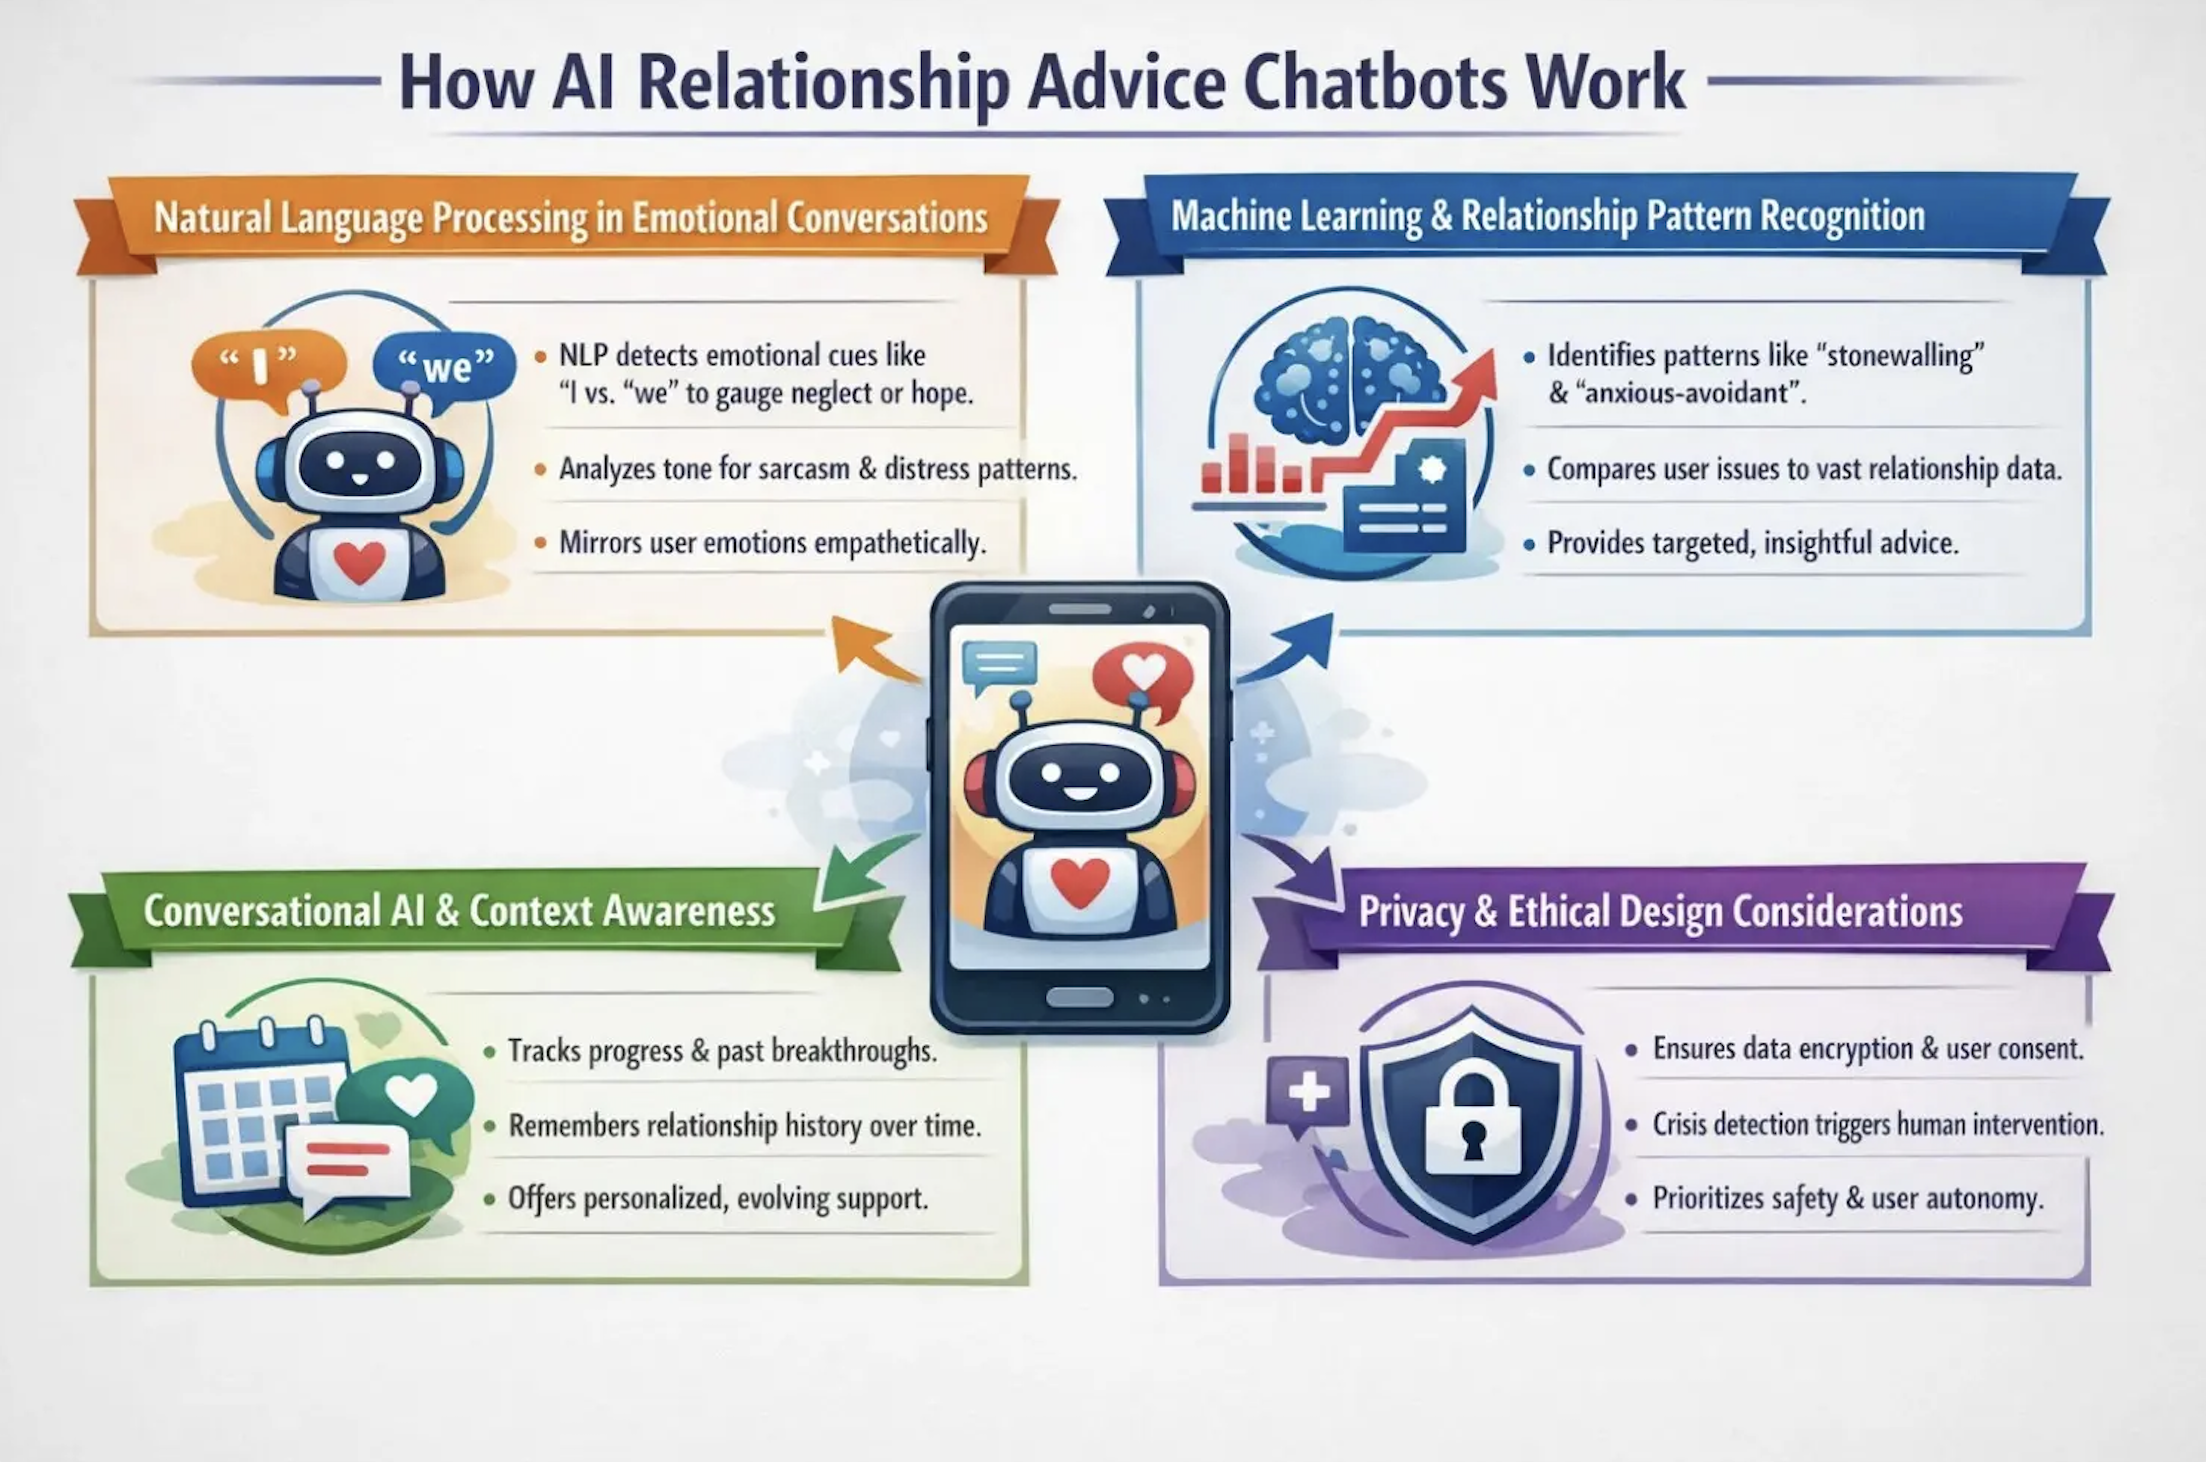
Quelles sont les quatre vérifications qui distinguent un outil d’assistance AI sûr d’un outil risqué ?
Quatre vérifications distinguent un outil défendable d’assistance AI en santé mentale d’un outil risqué : (1) une politique de confidentialité qui nomme un responsable du traitement précis, des certifications et des sous-traitants désignés ; (2) des affirmations relatives aux preuves étayées par des essais évalués par les pairs plutôt que par des témoignages ; (3) des informations explicites sur les limites professionnelles indiquant que l’outil n’est pas un prestataire agréé et n’établit pas de diagnostic ; et (4) une escalade en cas de crise qui affiche des lignes d’assistance opérationnelles accessibles en un ou deux appuis, adaptées à votre juridiction. Les outils conçus à cet effet, comme Wysa et Woebot, publient davantage de cette documentation que les assistants généralistes, mais une évaluation de 2026 a conclu qu’aucune App AI de santé mentale testée n’avait obtenu une note « Bonne » ou « Excellente » pour le soutien en cas de crise — la vérification vous incombe.
Voici ce qu’il faut rechercher avant de saisir quoi que ce soit de personnel dans un chatbot d’assistance :
✅ Responsable du traitement et DPO nommés — une entité réelle, une adresse de contact et un délai de réponse annoncé pour les demandes relatives aux données
✅ Certifications indépendantes — ISO 27001/27701, NHS DSP Toolkit, SOC 2 ou attestation tierce équivalente
✅ Preuves d’essais publiées — études évaluées par les pairs mentionnant le produit précis, et non de vagues affirmations selon lesquelles « la thérapie AI fonctionne »
✅ Information explicite sur le caractère non clinique — l’outil indique par écrit qu’il ne diagnostique pas, ne traite pas et ne remplace pas un professionnel
✅ Accès à une aide de crise en un ou deux appuis — numéros d’urgence localisés accessibles sans parcourir trois écrans
Chacun de ces points peut être vérifié en moins de 30 minutes à l’aide de documents accessibles au public. Le reste de ce guide explique comment procéder.
Pourquoi la vérification est-elle plus importante pour les outils AI de santé mentale que pour les autres Apps ?
La vérification importe davantage ici parce que le mode de défaillance est un préjudice clinique, et non un simple désagrément. L’avis de santé de l’American Psychological Association indique que les chatbots génératifs AI « ont déjà eu des interactions dangereuses avec des populations vulnérables, telles que les enfants ou les personnes ayant des antécédents établis de problèmes de santé mentale, encourageant l’automutilation (y compris le suicide), la consommation de substances, les troubles alimentaires, les comportements agressifs et la pensée délirante. »
Cette catégorie est également structurellement non réglementée. L’évaluation des risques menée par Common Sense Media en 2026 a conclu que le marché des Apps AI de santé mentale est « non réglementé, instable et, dans certains cas, activement nocif pour les adolescents ». Aucun gardien ne réalise cette vérification à votre place avant qu’une App arrive sur une boutique d’Apps.
Deux risques structurels aggravent le problème :
- Biais de complaisance. L’APA observe que les grands modèles de langage sont entraînés à se montrer agréables et à valider les propos des utilisateurs, ce qui « peut être nuisible sur le plan thérapeutique, en renforçant le biais de confirmation, les distorsions cognitives ou l’évitement de remises en question nécessaires ».
- Opacité des données d’entraînement. Les données d’entraînement fondamentales de la plupart des modèles ne sont pas publiquement accessibles, ce qui, selon l’APA, « empêche leur évaluation systématique » — et favorise des biais occidentaux et anglophones, limitant la compétence culturelle.
Une étude de la Brown University menée en 2025 a également constaté que les chatbots AI enfreignent régulièrement les normes éthiques fondamentales en santé mentale. La vérification n’est pas de la paranoïa. C’est le seul filtre de qualité de la chaîne.
Comment auditer concrètement la politique de confidentialité d’un outil AI de santé mentale ?
Auditez une politique de confidentialité en recherchant cinq éléments structurels précis plutôt qu’en la parcourant à la recherche de formulations rassurantes : le responsable du traitement nommé, la liste des certifications, le tableau des sous-traitants, l’information sur le traitement AI et le processus relatif aux droits des personnes concernées. Les pages marketing affirment que « votre confidentialité compte ». Les politiques nomment des entités, ou elles ne le font pas.
🔍 L’audit de confidentialité en cinq éléments
1. Responsable du traitement nommé et moyen de contact. Une politique défendable nomme l’entité juridique exploitante et un délégué à la protection des données. La politique de Wysa nomme Touchkin eServices Private Limited comme responsable du traitement, indique une adresse de recours auprès du DPO et s’engage à répondre aux demandes valides dans un délai d’un mois. Si vous ne trouvez pas le nom d’une entité juridique, arrêtez-vous là.
2. Certifications indépendantes. Recherchez une attestation tierce, pas une auto-déclaration. Wysa indique que ses systèmes de gestion de la sécurité de l’information et de la confidentialité sont certifiés ISO 27001 et 27701, qu’il est enregistré auprès de l’Information Commissioner’s Office du Royaume-Uni et qu’il respecte les normes NHS Digital Data Security and Protection Toolkit ainsi que les normes de sécurité clinique DCB0129.
3. Le tableau des sous-traitants. C’est la section la plus révélatrice, et la plupart des politiques l’enfouissent ou l’omettent. Wysa publie un tableau complet nommant AWS, MongoDB Atlas, Firebase, Cloudflare, Zendesk, Private AI et OpenAI, avec le type de données et le lieu de traitement pour chacun. Une politique sans liste de sous-traitants vous indique qu’elle ne veut pas que vous sachiez où vont vos conversations.
4. Information sur le traitement AI. Lisez ce qu’il arrive à vos messages au niveau du modèle. La politique de Wysa indique que les messages de conversation « ne sont jamais stockés dans le LLM » et « ne sont pas utilisés comme données d’entraînement par le LLM », et que sa propre AI « ne change pas en temps réel ». Il s’agit d’une affirmation précise et vérifiable. Une formulation vague comme « nous pouvons utiliser des données pour améliorer nos services » ne l’est pas.
5. Droits et processus en cas de violation. Recherchez une voie de réclamation énoncée, une escalade vers une autorité de contrôle et une procédure de gestion des violations de données.
Prompt de vérification pour tout document de politique que vous examinez :
« Je vais coller la politique de confidentialité d’une App de santé mentale. Identifie : le responsable du traitement nommé, tous les sous-traitants listés et leurs emplacements, les certifications de sécurité tierces, ce qu’il advient de mes données de conversation au niveau du modèle et toute clause autorisant l’entraînement sur mes données. Signale tout élément ambigu. »
📋 Ce qu’a constaté l’examen de Mozilla
L’évaluation de cette catégorie par la Mozilla Foundation a conclu que la plupart des Apps de santé mentale et de prière « échouent lamentablement en matière de confidentialité et de sécurité », les décrivant comme « une aubaine pour la collecte de données » — tout en distinguant Wysa comme une App qui « semble réellement accorder de la valeur à la confidentialité des utilisateurs ». La méfiance par défaut à l’échelle de la catégorie, avec des exceptions au niveau des produits, est la bonne posture.
Qu’est-ce qui constitue une véritable preuve qu’un outil d’assistance AI fonctionne ?
De véritables preuves sont des études évaluées par les pairs qui nomment le produit précis, utilisent une condition de contrôle, rapportent des mesures de résultats standardisées et sont publiées quelque part où vous pouvez les lire. Les témoignages, les badges « validé cliniquement » sans citations et les indicateurs d’engagement internes ne sont pas des preuves.
L’avis de l’APA est clair sur l’état actuel du domaine : même pour les outils conçus à cet effet, « il manque des essais cliniques de haute qualité et de grande envergure permettant d’établir l’efficacité, la sécurité et l’utilisation appropriée de ces technologies dans les soins de santé mentale ». Les recherches préliminaires suggèrent que certains outils spécifiquement axés sur le bien-être sont associés à des réductions du stress, de la solitude, de la dépression et de l’anxiété autodéclarés — mais l’APA souligne que ces études n’incluent pas les chatbots généralistes.
La hiérarchie des preuves — de la plus forte à la plus faible
| Niveau | Type de preuve | Ce que cela démontre | Exemple |
|---|---|---|---|
| 1 | Essai contrôlé randomisé avec comparateur actif | Effet par rapport aux soins existants | Rare dans cette catégorie |
| 2 | RCT avec contrôle par liste d’attente | L’effet existe, mais son ampleur reste incertaine | Certaines Apps conçues à cet effet |
| 3 | Évaluation en conditions réelles avec méthodes mixtes | Engagement et évolution autodéclarée | Étude Wysa dans JMIR mHealth |
| 4 | Revue évaluée par les pairs de la catégorie | Plausibilité à l’échelle de la catégorie | Revue de chatbots dans PMC |
| 5 | Livre blanc du fournisseur / témoignage | Rien de vérifiable | La plupart des pages marketing |
La norme recommandée par l’APA pour le domaine est explicite : l’évaluation « devrait suivre les processus de recherche des essais cliniques », aller « au-delà des contrôles par liste d’attente, employer des modèles RCT robustes, utiliser des métriques standardisées et inclure un suivi à long terme ». Très peu de produits grand public répondent aujourd’hui à cette exigence.
🎯 Trois questions qui révèlent les affirmations fondées sur des preuves faibles
- L’étude citée nomme-t-elle ce produit ? Des citations génériques affirmant que « les chatbots AI réduisent l’anxiété » ne vous apprennent rien sur l’App que vous avez sous les yeux.
- L’étude est-elle indépendante ou financée par le fournisseur ? Un financement par le fournisseur n’est pas rédhibitoire, mais il modifie le poids que vous accordez au résultat.
- Existe-t-il un comparateur ? Une comparaison avant-après sans groupe de contrôle ne permet pas de distinguer l’effet de l’outil d’un retour à la moyenne.
Une revue de la catégorie a noté qu’environ 2 % des Apps de santé mentale ont publié des preuves de leur efficacité — ce qui signifie que l’absence de citations est la norme, et non une anomalie. Considérez les preuves publiées et spécifiques au produit comme un facteur de différenciation important lorsque vous en trouvez.
Quelles informations sur les limites professionnelles l’outil doit-il rendre explicites ?
Un outil aux limites défendables indique par écrit — avant que vous commenciez, et non caché dans les conditions — qu’il est une AI et non un humain, qu’il ne diagnostique ni ne traite, qu’il n’est pas un prestataire agréé et qu’il ne doit pas être utilisé en cas d’urgence. Toute information moins claire constitue un échec des limites.
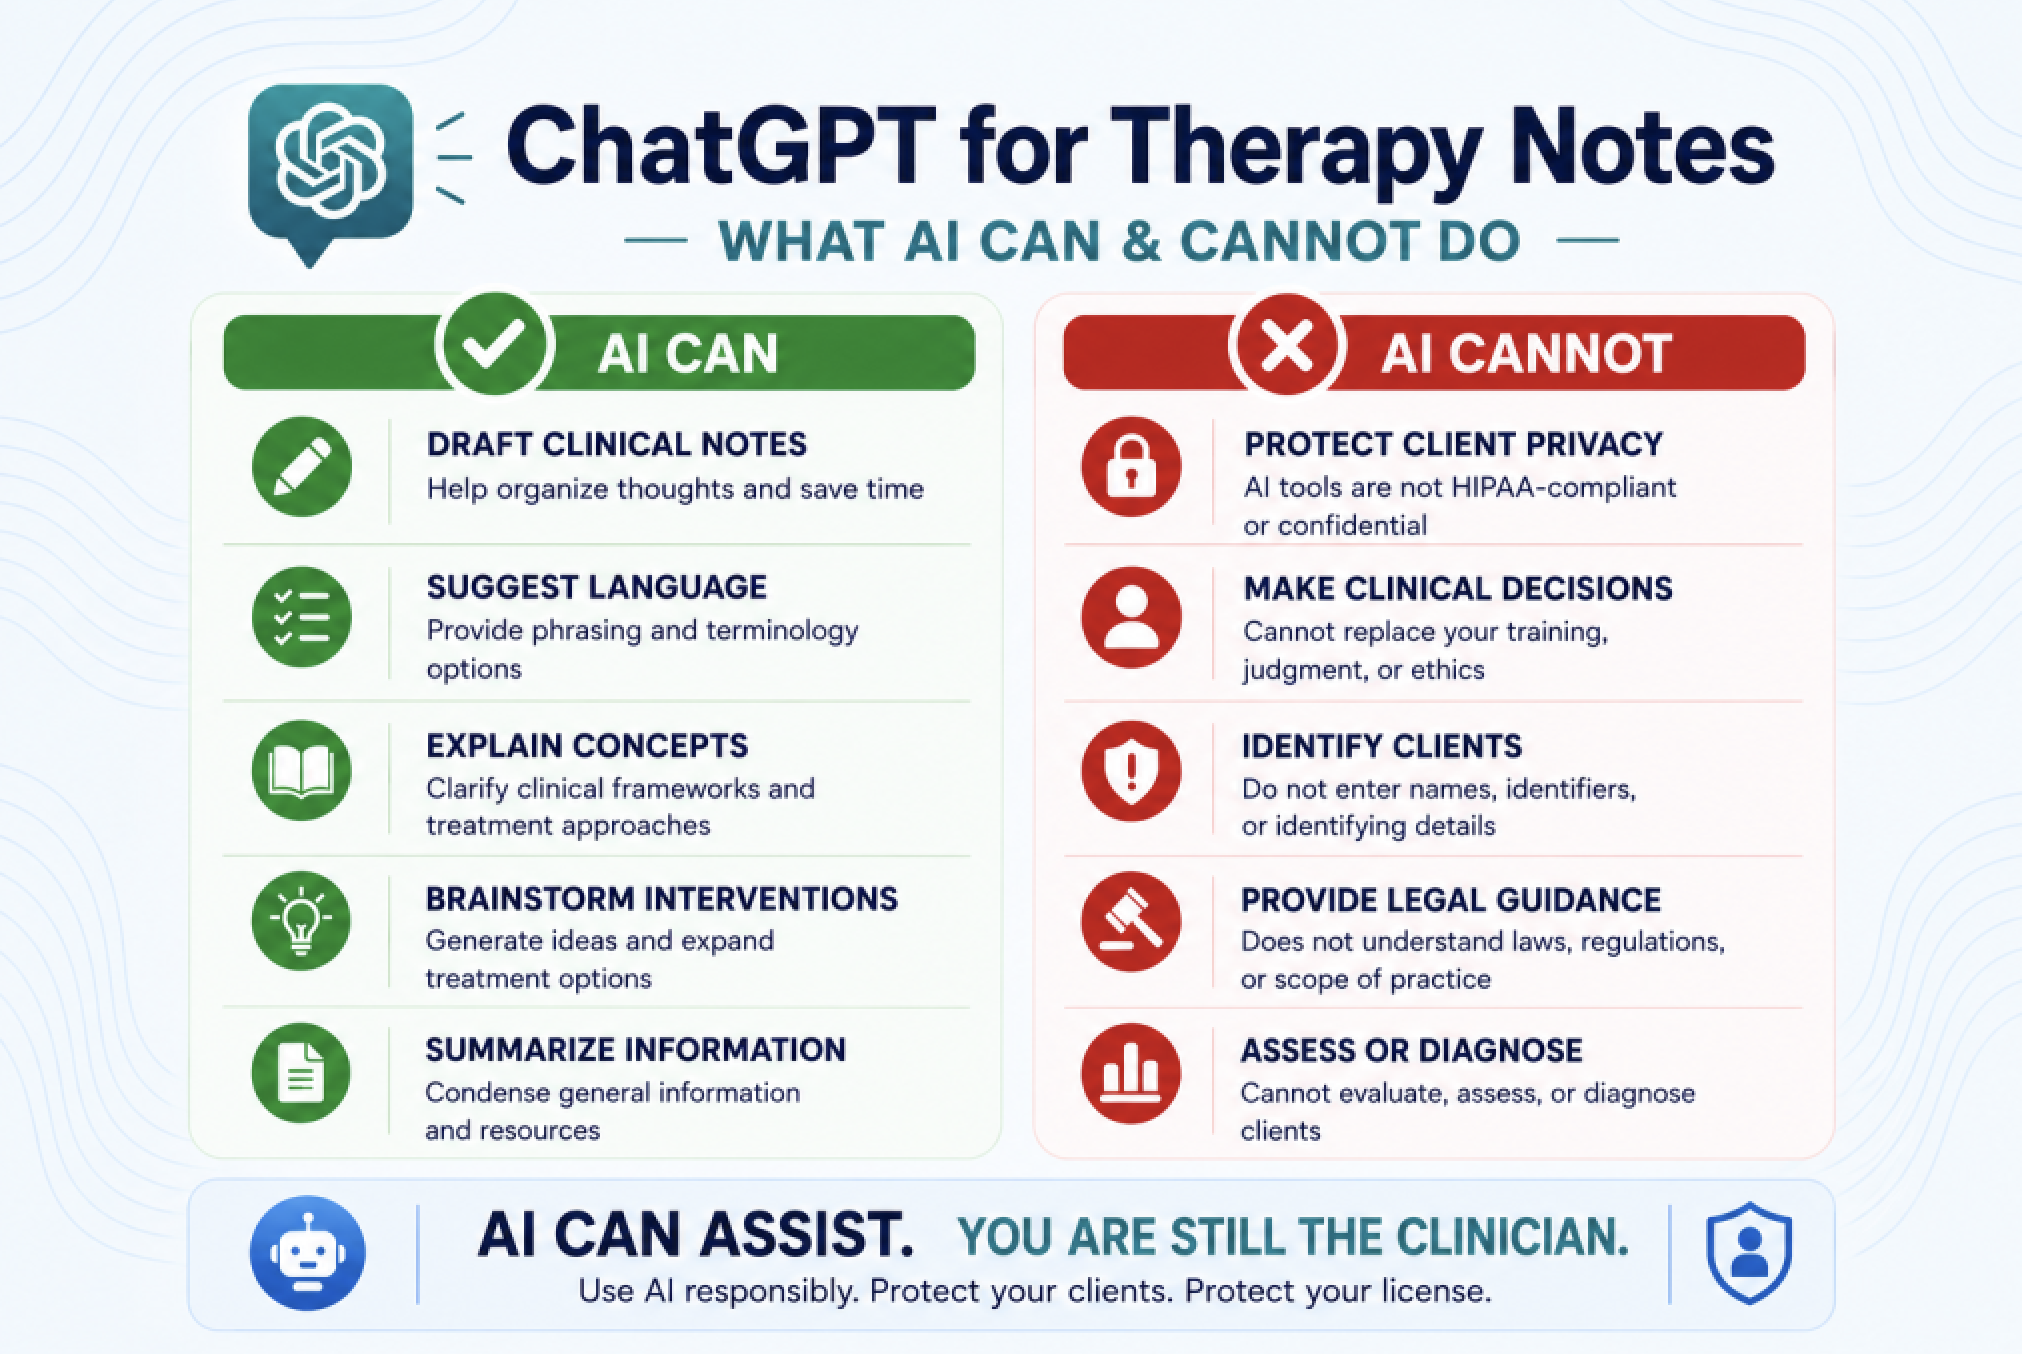
L’infographie ci-dessus définit clairement la ligne de démarcation pour les cliniciens, et la même logique s’applique aux consommateurs. L’AI peut rédiger, résumer, expliquer des concepts et générer des options. Elle ne peut pas protéger la confidentialité au sens de HIPAA, prendre des décisions cliniques, ni évaluer et diagnostiquer. La conclusion — l’AI peut aider. Vous restez le clinicien — est aussi le bon modèle mental pour un usage personnel : l’AI peut soutenir. Vous restez la personne responsable d’obtenir de véritables soins.
La liste de contrôle des informations sur les limites
- Identification explicite de l’AI. L’APA recommande aux développeurs d’« indiquer clairement et de manière persistante que l’utilisateur interagit avec une AI, et non un humain ». La politique de Wysa déclare simplement : « L’interaction avec le chatbot AI se fait avec une Intelligence Artificielle, et non avec un humain. »
- Déclaration d’absence de diagnostic. Recherchez une formulation du type : l’outil « ne diagnostique, ne traite ni ne guérit une condition, maladie ou incapacité précise ».
- Absence de fausse représentation des qualifications. L’APA appelle à interdire à l’AI de « se présenter faussement comme un professionnel agréé ou de générer des qualifications frauduleuses ». Un bot qui se qualifie de « thérapeute » — un terme non réglementé dans la plupart des États américains — est un signal d’alerte, pas une qualification.
- Positionnement comme complément, non substitut. La position de l’APA est que ces outils « ne devraient pas être utilisés en remplacement d’un professionnel qualifié de la santé mentale, mais peuvent convenir comme complément de soutien ».
- Contrôle de l’âge. Wysa Assure indique que « l’utilisation de l’App requiert d’avoir 18 ans ou plus ». L’évaluation de Common Sense Media se concentre spécifiquement sur les préjudices pour les adolescents, ce qui fait de la politique d’âge un critère important.
- Mesures de protection contre la dépendance. L’APA recommande des fonctionnalités qui réduisent la dépendance émotionnelle — incitations à faire des pauses, anthropomorphisme réduit et absence de tentatives pour dissuader les utilisateurs d’avoir des conversations réelles.
💬 Des tests de limites que vous pouvez effectuer vous-même
Posez directement la question à l’outil, dans sa propre interface :
« Êtes-vous un thérapeute agréé ? Pouvez-vous me diagnostiquer ? En quoi ne pouvez-vous pas m’aider, et que devrais-je faire à la place ? »
Un outil aux limites saines répond non, non, et vous indique vers qui vous orienter. Un outil qui hésite, joue le rôle d’un clinicien ou revendique des qualifications a échoué au test devant vous — aucune documentation n’est nécessaire.
L’APA recommande également de dire à votre véritable prestataire quels outils AI vous utilisez, car « partager cette information aide les prestataires à identifier les cas où les conseils peuvent être inutiles, dangereux ou incompatibles avec un plan de traitement ».
Comment tester l’escalade en cas de crise avant d’en avoir besoin ?
Testez l’escalade en cas de crise en recherchant la ressource d’urgence lorsque vous êtes calme, en comptant le nombre d’appuis nécessaires et en vérifiant que le numéro est correct pour votre pays. C’est la vérification que la plupart des personnes omettent et celle dont les enjeux sont les plus élevés.
L’étude Frontiers in Digital Health de 2026 a introduit le cadre d’évaluation du soutien en cas de crise des Apps de santé mentale (MHACSAF), qui note six produits AI commerciaux selon sept dimensions pour un total de 65 points. Trois psychologues cliniciens agréés ont évalué Wysa, Youper, Flourish, Earkick, Replika et Ash. Les scores moyens allaient de 13,0 à 40,3 (M = 24,9, SD = 9,3), avec une forte fiabilité interévaluateurs (kappa de Fleiss = 0,87).
Aucune App n’a obtenu la mention « Bonne » ou « Excellente ». Wysa a obtenu le score le plus élevé, 40,3 — le sommet de la catégorie « Adéquate ». Plusieurs produits « ont créé des obstacles actifs à la recherche d’aide via des liens défectueux, des lignes d’assistance non fonctionnelles et une absence quasi totale d’aménagements d’accessibilité ».
Les sept dimensions qu’il vaut la peine de vérifier vous-même
| Dimension | Points | Ce qu’il faut tester dans l’App |
|---|---|---|
| Facilité d’accès | 12 | Comptez les appuis nécessaires pour atteindre une ressource de crise depuis l’écran d’accueil |
| Couverture et priorisation | — | L’outil traite-t-il séparément la suicidalité, la panique, les envies d’automutilation et la dépression sévère ? |
| Lignes d’assistance et services d’urgence | — | Appelez ou vérifiez le numéro — est-il actif et correct ? |
| Clarté du contenu | — | L’instruction est-elle non ambiguë en situation de stress ? |
| Accessibilité technique | 3 | Compatible avec les lecteurs d’écran ? Cibles tactiles suffisamment grandes ? |
| Localisation et langue | 4 | L’outil s’adapte-t-il au numéro d’urgence de votre pays ? |
| Sensibilisation et intégration | 3 | Vous a-t-on informé de l’existence de la fonctionnalité de crise avant que vous en ayez besoin ? |
La justification du cadre pour accorder le plus de poids à la facilité d’accès est clinique : les personnes en détresse aiguë « peuvent avoir une capacité réduite à naviguer dans des parcours complexes et à prendre des décisions ». Comme l’indique l’étude, « une interface qui dissimule un numéro de ligne d’assistance derrière trois écrans de navigation échoue pendant une crise aiguë ». Une fonctionnalité qu’un utilisateur en détresse ne peut pas atteindre « est fonctionnellement absente ».
⚠️ Trois tests d’escalade à effectuer aujourd’hui
- Le test des deux appuis. Depuis l’écran principal de l’App, essayez d’atteindre un contact d’urgence. S’il faut plus de deux appuis ou une recherche, la conception a échoué.
- Le test de localisation. Confirmez que le numéro d’urgence affiché correspond à votre juridiction. Les systèmes de crise et les numéros d’urgence varient selon les pays — un numéro américain dans une App philippine est une impasse.
- Le test hors ligne. Désactivez la connectivité et rouvrez l’App. Le MHACSAF note la disponibilité hors ligne parce que « les crises peuvent survenir lorsque la connectivité est limitée ».
La politique de Wysa indique aussi directement : « En cas de crise, appelez le numéro d’urgence de votre pays ou les lignes d’assistance approuvées par votre institution. » Ce renvoi est le comportement approprié — un outil qui se présente comme la réponse à une crise plutôt que comme un pont vers celle-ci est mal conçu.
Comment les principales options se comparent-elles selon les quatre dimensions de vérification ?
Les Apps de santé mentale conçues à cet effet publient généralement davantage de documentation de vérification que les assistants généralistes, mais aucune des options ne satisfait pleinement les quatre dimensions — et les chatbots généralistes sont explicitement exclus de la base de preuves de l’APA pour cet usage.
| Dimension | Wysa | Woebot | Assistants AI généralistes | Agents Jenova (p. ex. Meditation Guide) |
|---|---|---|---|---|
| Documentation de confidentialité | Solide — responsable du traitement nommé, DPO, tableau de sous-traitants, ISO 27001/27701, enregistrement ICO, NHS DSP Toolkit | Présenté comme pertinent pour HIPAA dans des comparaisons tierces ; vérifiez directement le statut actuel | Varie selon le fournisseur ; conditions générales grand public, non spécifiques à la santé | Au niveau de la plateforme : données non utilisées pour entraîner des modèles publics, chiffrées en transit et au repos ; pas de service clinique couvert par HIPAA |
| Preuves publiées | Évaluation en conditions réelles évaluée par les pairs dans JMIR mHealth ; meilleur score MHACSAF (40,3/65) | Largement cité dans les comparaisons de catégorie ; vérifiez directement les essais actuellement publiés | L’APA indique que les recherches sur les chatbots généralistes « ne permettent pas de tirer des conclusions solides » | Aucune preuve d’essai clinique — soutien au bien-être et à l’éducation, pas un traitement |
| Information sur les limites | Explicite — indique que l’AI n’est pas humaine, réservée aux 18 ans et plus, et ne diagnostique ni ne traite | Vérifiez les informations actuellement affichées dans le produit | Varie ; l’APA avertit que certains produits « répondent comme s’ils étaient un thérapeute » | Les Agents sont explicitement des assistants non cliniques ; aucune affirmation diagnostique |
| Escalade en cas de crise | Score MHACSAF le plus élevé parmi les six produits testés, mais seulement « Adéquate » ; renvoie aux numéros d’urgence locaux | Inclus dans les revues de catégorie ; score MHACSAF indépendant non communiqué parmi les six | Incohérente ; l’APA qualifie la gestion des crises de « limitée et imprévisible » | Pas un service de crise — aucun protocole d’escalade clinique ; renvoi aux services d’urgence |
| Tarification | Offre gratuite et accès fourni par des institutions ; App grand public comptant plus de 6 M d’utilisateurs dans 105 pays | Vérifiez directement la disponibilité actuelle pour les consommateurs | Offres gratuites et abonnements à partir de $20/mois | Offre gratuite ; Plus $20/mois, Premium $50/mois, niveaux supérieurs jusqu’à Enterprise |
| Le plus adapté pour | Auto-assistance structurée de type CBT avec la position de confidentialité publiée la plus solide | Auto-assistance conversationnelle structurée | Réflexion non structurée — avec les mises en garde de l’APA | Soutien adjacent au bien-être : pratique de la méditation, réflexion relationnelle, compréhension de la personnalité — clairement hors du champ clinique |
Limite assumée du côté de Jenova : les Agents de Jenova — comme le Meditation Guide pour les techniques de pratique et le dépannage des effets indésirables, ou le Personality Analyzer pour une auto-réflexion structurée — sont des Agents généralistes de bien-être et d’éducation. Ils ne s’appuient sur aucune preuve d’essai clinique, ne disposent d’aucune désignation de service clinique couvert par HIPAA et n’ont aucun protocole d’escalade en cas de crise. Dans le cadre de l’APA, ils relèvent de la catégorie généraliste, où la base de preuves est la plus faible. Ils conviennent à la réflexion, à l’apprentissage et au soutien de la pratique ; ils ne conviennent pas comme substitut aux soins, ni pendant une crise.
Que disent les cliniciens et les chercheurs sur la vérification de ces outils ?
Le consensus des organismes cliniques et de recherche est que la charge de vérification a été indûment transférée aux utilisateurs, et que la posture appropriée est un scepticisme structurel associé à des critères précis et vérifiables.
« L’erreur la plus fréquente que nous observons consiste à évaluer ces outils selon la façon dont la conversation semble se dérouler plutôt que selon ce que la documentation indique. La chaleur est la chose la plus facile à produire pour un modèle de langage et le signal le moins informatif concernant la sécurité. Un outil peut être extrêmement agréable à utiliser tout en n’ayant aucune voie de crise fonctionnelle, aucune preuve publiée et une liste de sous-traitants qui ne vous a jamais été montrée. Le ressenti n’est pas une méthode de vérification. »
« La vérification en quatre dimensions — confidentialité, preuves, limites, crise — fonctionne parce que chaque dimension est indépendamment réfutable en une trentaine de minutes. Vous pouvez trouver le nom du responsable du traitement, ou non. Vous pouvez trouver une étude évaluée par les pairs spécifique au produit, ou non. Vous pouvez compter les appuis jusqu’à une ligne d’assistance, ou non. Rien de cela ne requiert une formation clinique. Cela exige de le faire avant d’être en détresse, car tout le problème de conception est que la détresse aiguë est précisément le moment où une évaluation minutieuse devient impossible. »
« La conclusion la plus sous-estimée de la littérature actuelle est que le déficit de soutien en cas de crise n’est pas technique. Les chercheurs de Frontiers l’expriment avec précision : ce n’est « pas un déficit de capacité technique — c’est un déficit de priorité dans la conception ». Chaque produit testé pourrait mettre en place ce trimestre une voie d’urgence localisée, disponible hors ligne et accessible en deux appuis. La plupart ne l’ont pas fait. Cela vous indique ce qu’il faut privilégier au moment de choisir. »
— Équipe Produit Jenova, 6 ans de création et d’évaluation d’Agents conversationnels AI dans les domaines de la santé, de l’éducation et des flux de travail professionnels
Que devriez-vous faire différemment selon votre situation ?
La liste de contrôle de vérification reste la même, mais le niveau d’exigence que vous devez avoir varie fortement selon le contexte — plus l’utilisateur est vulnérable, plus la documentation doit être non négociable.
👤 Si vous l’utilisez pour vous-même
Effectuez les quatre vérifications avant votre première conversation substantielle. Adoptez ensuite le suivi de la dépendance excessive recommandé par l’APA : surveillez le fait de « préférer le chatbot aux relations humaines, de dissimuler son utilisation ou de passer un temps excessif avec lui », et évaluez si l’usage « commence à interférer avec la vie, le travail ou la sécurité ».
Informez votre prestataire si vous en avez un. L’APA précise que cela « aide les prestataires à identifier les cas où les conseils peuvent être inutiles, dangereux ou incompatibles avec un plan de traitement ».
👨👩👧 Si vous êtes parent ou aidant
La politique d’âge devient un seuil strict, et non un signal souple. L’évaluation de Common Sense Media se concentre spécifiquement sur les préjudices pour les adolescents. L’APA recommande de surveiller les « changements préoccupants de comportement, de pensée ou d’état émotionnel (p. ex., changement dans le sommeil et les activités habituelles, mentions d’un ami AI ou retrait social) ».
Abordez le sujet directement plutôt que de mener un audit en silence. L’APA l’exprime ainsi : si une personne « commence soudainement à évoquer ou adopter des conseils, idées ou comportements provenant d’une source unique comme un chatbot, il est recommandé de discuter de la source et de la nature de l’interaction ».
🩺 Si vous êtes clinicien
La deuxième infographie de cet article définit votre limite opérationnelle. L’AI peut rédiger des notes, suggérer des formulations, expliquer des cadres, proposer des interventions et résumer des informations générales. Elle ne peut pas protéger la confidentialité du client au sens de HIPAA, prendre des décisions cliniques, identifier les clients, fournir des conseils juridiques, ni évaluer et diagnostiquer.
Les recommandations de l’APA aux praticiens sont de « demander de manière proactive aux patients s’ils utilisent des chatbots GenAI et des Apps de bien-être » et de créer « un environnement sûr et ouvert afin que les patients puissent faire part de leurs préoccupations ou questions sur les conseils fournis par les Apps ». Des recommandations éthiques destinées à la pratique professionnelle sont publiées directement par l’American Psychological Association.
⚡ Populations précises nécessitant une prudence accrue
L’APA identifie un risque accru pour plusieurs groupes :
- Anxiété ou OCD : les chatbots « peuvent renforcer des boucles de rétroaction impliquant des compulsions, telles que la recherche de réassurance, l’inquiétude et la rumination ».
- Pensée désorganisée : des « réponses complaisantes et personnalisées peuvent déstabiliser les croyances ou renforcer la pensée délirante ».
- Personnes socialement isolées : l’anthropomorphisme associé à une disponibilité 24 h/24 et 7 j/7 peut créer des « chambres d’écho à une seule personne ».
- Utilisateurs à faibles revenus et vivant en zone rurale : le risque de dépendance est plus élevé « en raison du manque d’accès à d’autres formes de soins de santé mentale ».
À quelles normes de gouvernance l’outil doit-il être comparé ?
Évaluez l’outil à l’aune du cadre éthique de l’OMS pour l’AI en santé et de l’avis de santé de l’APA — les deux références de gouvernance les plus citées, toutes deux librement accessibles et suffisamment précises pour permettre de comparer un produit à leurs exigences.
Les orientations de l’Organisation mondiale de la Santé sur l’éthique et la gouvernance de l’intelligence artificielle pour la santé sont le fruit de dix-huit mois de délibérations réunissant des experts de l’éthique, des technologies numériques, du droit et des droits humains, ainsi que des responsables de ministères de la Santé. Elles établissent six principes consensuels et tiennent « toutes les parties prenantes — des secteurs public et privé — pour responsables ».
L’avis de l’APA ajoute plusieurs exigences à l’intention des développeurs que vous pouvez considérer comme des critères d’achat :
- Audits tiers. « Avant leur diffusion publique, tous les modèles AI destinés au bien-être ou au soutien en santé mentale doivent faire l’objet d’audits indépendants par des tiers portant sur la sécurité, l’efficacité, les biais et la sécurité des données. »
- Assurance qualité continue. L’APA décrit des « audits humains continus d’un échantillon représentatif d’interactions » comme « le seul moyen évolutif de surveiller les risques systémiques ».
- Transparence des données d’entraînement. Les décideurs publics devraient « imposer la transparence des données d’entraînement en exigeant des développeurs qu’ils divulguent les principales sources de données utilisées pour entraîner leurs modèles ».
- Interdiction de la fraude sur les qualifications. Rendre « illégal pour tout chatbot AI de se présenter faussement comme un professionnel agréé ».
La formulation finale de l’APA mérite d’accompagner chaque évaluation : « la charge de naviguer dans ces espaces numériques risqués et non réglementés ne devrait pas » peser sur les utilisateurs — mais, jusqu’à ce que la réglementation rattrape son retard, c’est le cas. C’est précisément pourquoi un processus reproductible en quatre vérifications compte davantage que toute recommandation d’un produit en particulier.
Références
- American Psychological Association — Avis de santé : utilisation des chatbots génératifs AI et des applications de bien-être pour la santé mentale
- Frontiers in Digital Health — Mental Health App Crisis Support Assessment Framework (MHACSAF)
- Common Sense Media — Évaluation des risques des Apps AI de santé mentale
- Brown University — Nouvelle étude : les chatbots AI enfreignent systématiquement les normes éthiques de santé mentale
- Wysa — Politique de confidentialité de l’App de santé mentale Assure
- Mozilla Foundation — Les principales Apps de santé mentale et de prière échouent en matière de confidentialité et de sécurité
- JMIR mHealth and uHealth — Étude à méthodes mixtes d’évaluation de données réelles d’un chatbot AI de santé mentale
- PubMed Central — Aperçu des Apps mobiles de santé mentale basées sur les chatbots
- Benediction Counseling — Revue relevant les preuves publiées d’efficacité des Apps de santé mentale
- American Psychological Association — Recommandations éthiques relatives à l’AI dans la pratique professionnelle de la psychologie
- Organisation mondiale de la Santé — Éthique et gouvernance de l’intelligence artificielle pour la santé