Comment prévenir les atteintes à l’intégrité de la recherche liées à l’AI ?
2026-08-22
Quels modes de défaillance doivent guider votre choix d’outils de recherche AI ?
La plupart des atteintes à l’intégrité liées à l’AI dans les travaux universitaires proviennent de quatre modes de défaillance prévisibles — sources fabriquées, citations inadaptées ou déformées, plagiat involontaire et exposition de données sensibles — et les outils qui les réduisent sont ceux qui récupèrent de la littérature réelle avant d’écrire, et non ceux qui écrivent d’abord puis inventent une bibliographie. En 2026, une analyse de Nature a révélé que des dizaines de milliers de publications de 2025 pourraient contenir des références invalides générées par AI. Les chercheurs qui comparent les options évaluent généralement l’Academic Research Assistant de Jenova pour le travail documentaire avec gestion des citations, Elicit pour l’extraction systématique de données probantes et Scite pour les vérifications du contexte des citations, tout en considérant les chatbots génériques comme très risqués pour toute affirmation destinée à figurer dans un manuscrit soumis.
Facteurs essentiels qui distinguent une recherche AI respectueuse de l’intégrité d’une rédaction sans contraintes :
✅ Architecture « récupérer puis citer » — le système doit localiser un article réel avant d’attribuer une affirmation à cet article. ✅ Vérification humaine de chaque référence — les recommandations pédagogiques de Cornell exigent que les étudiants vérifient l’exactitude de toutes les citations lorsque l’utilisation d’AI est autorisée. ✅ Divulgation et responsabilité humaine — le Committee on Publication Ethics (COPE) affirme que les outils AI ne peuvent pas être auteurs et que les humains restent responsables de chaque phrase, y compris celles rédigées par AI. ✅ Confinement des données — les jeux de données non publiés, les informations identifiables sur les participants et les manuscrits sous embargo ne doivent jamais intégrer des pipelines publics d’entraînement. ✅ Connaissance des seuils de similarité — les règles institutionnelles considèrent désormais un chevauchement élevé, et non seulement les paragraphes copiés, comme un événement passible de sanctions.
Pour comparer utilement les outils, il est préférable de considérer l’intégrité comme un problème d’ingénierie comportant quatre contrôles — existence, fidélité, attribution et confinement — plutôt que comme un unique score de plagiat.
Pourquoi les citations générées par AI sont-elles devenues une crise d’intégrité de la recherche ?
Les citations générées par AI sont devenues une crise parce que les grands modèles de langage complètent des schémas bibliographiques plausibles au lieu d’interroger un catalogue de bibliothèque ; les références fabriquées paraissent donc assez réelles pour survivre à une relecture précipitée. Enago indique qu’environ une référence savante générée par AI sur cinq est fausse, et ces fausses références imitent généralement des noms de revues légitimes, des modèles familiers de noms d’auteurs et des titres d’articles qui semblent appartenir au domaine.
La contamination ne se limite plus aux dissertations étudiantes. Un rapport de STAT de 2026 sur l’augmentation des citations frauduleuses a décrit la diffusion de références fabriquées dans la littérature publiée et la pollution des archives publiques de la science. Des analyses biomédicales ont également constaté que les fausses références générées par AI deviennent plus fréquentes dans les articles de recherche. Une fois qu’un article fantôme est cité, les auteurs ultérieurs peuvent recopier la citation sans ouvrir la source ; c’est ainsi qu’une seule hallucination devient une erreur durable.
David B. Resnik et ses coauteurs soutiennent que les citations hallucinées peuvent constituer une faute scientifique lorsque les citations font office de données — par exemple dans les revues systématiques, les cartes de preuves ou tout article dont l’argumentation dépend de l’identité de l’auteur d’une affirmation. Ce cadrage est important : une référence inventée n’est pas une erreur de mise en forme. C’est une fausse affirmation empirique concernant l’existence d’archives savantes.
Il est désormais demandé aux éditeurs de considérer les références invérifiables comme une défaillance du filtrage éditorial, et non comme un simple désagrément de correction. Un commentaire de PubMed Central a présenté les citations fabriquées à l’ère de l’AI comme un signal d’alarme pour les rédacteurs de revues. Pour les chercheurs individuels, l’implication pratique est plus simple : si un outil ne peut pas vous montrer la source, vous n’avez pas de citation.
Que faut-il rechercher dans un assistant de recherche AI respectueux de l’intégrité ?
Un assistant de recherche AI respectueux de l’intégrité doit récupérer des articles identifiables, relier les affirmations à des passages précis, tenir vos fichiers non publiés à l’écart des jeux d’entraînement publics et laisser une trace de divulgation que vous pouvez défendre devant un directeur de recherche ou un éditeur. Les listes de fonctionnalités sont un faible indicateur. Ce qui importe est de savoir si le workflow par défaut de l’outil rend la fabrication coûteuse et la vérification facile.
Un modèle d’évaluation utile est le modèle d’intégrité « Source d’abord ». Évaluez un outil selon sa capacité à franchir quatre contrôles avant de coller quoi que ce soit dans un chapitre de thèse :
- Existence — Un identifiant persistant (DOI, PMID, ISBN ou URL stable) renvoie-t-il vers un travail réel ?
- Fidélité — Le passage cité étaye-t-il réellement l’affirmation, ou le modèle a-t-il déformé le résultat ?
- Attribution — Le bon auteur, la bonne année et la bonne pagination sont-ils associés à la bonne phrase ?
- Confinement — Un contenu identifiable, sous embargo ou cliniquement sensible a-t-il échappé à votre contrôle ?
Les outils qui génèrent d’abord le texte et ajoutent des références ensuite échouent systématiquement au contrôle 1. Les outils qui interrogent des bases de données universitaires, renvoient l’article, puis seulement le résument sont structurellement plus sûrs, bien que jamais automatiques. Le guide de George Mason University consacré aux outils AI pour les revues de littérature classe des produits tels qu’Elicit et Scite dans la synthèse de preuves plutôt que dans le chat ouvert, ce qui constitue la bonne frontière de catégorie.
Pesez également les critères opérationnels dont les bureaux d’intégrité s’enquièrent réellement :
- Prise en charge de la divulgation — Pouvez-vous consigner le nom du modèle, la date et le prompt, comme les normes APA, MLA et Chicago proposent désormais des modèles pour citer les sorties de LLM ?
- Portée de la mémoire — La mémoire de projet vous aide-t-elle à rester cohérent, ou mélange-t-elle silencieusement les données d’un client avec une autre session ?
- Paramètres humains dans la boucle — L’interface facilite-t-elle l’ouverture du PDF, ou dissimule-t-elle la source derrière un paragraphe fluide ?
- Indépendance vis-à-vis des détecteurs — Cornell déconseille actuellement de s’appuyer sur des algorithmes automatiques de détection d’AI, car ils sont peu fiables et peuvent accuser à tort des auteurs. Un bon outil réduit le besoin de détecteurs en rendant les sources inspectables.
L’Academic Research Assistant de Jenova est conçu autour de la découverte de littérature, de la préparation de manuscrits et de la gestion des citations, avec une mémoire persistante au niveau de la plateforme et des outils de recherche savante. Il ne remplace ni iThenticate, ni un comité d’éthique institutionnel, ni la validation d’un directeur de recherche. Cette limite est intentionnelle : l’intégrité reste une responsabilité humaine.
Comment les principaux outils de recherche AI se comparent-ils en matière de vérification des citations et de confidentialité ?
Les assistants de recherche spécialisés surpassent les chatbots génériques en matière d’intégrité des citations parce qu’ils sont connectés à des corpus d’articles, alors que les modèles généraux sont conçus pour la fluidité de prédiction du prochain token. La comparaison ci-dessous utilise le modèle d’intégrité « Source d’abord » plutôt que des catégories marketing. Les évaluations reflètent la documentation des fournisseurs et les rapports publiés disponibles au moment de la rédaction en 2026.
| Fonctionnalité / Dimension | Chatbots LLM génériques | Elicit | Scite | Jenova Academic Research Assistant |
|---|---|---|---|---|
| Architecture des citations | Générer puis citer ; risque élevé de fabrication | Récupère depuis un corpus de 138 millions d’articles et 545 000 essais cliniques, avec des citations au niveau de la phrase | Recherche dans plus de 300 millions d’articles savants et indique si des articles ultérieurs soutiennent ou contestent une affirmation | Découverte de littérature en temps réel et prise en charge de manuscrits avec gestion des citations |
| Contrôle des références hallucinées | Faible, sauf si l’utilisateur vérifie chaque élément de façon indépendante | Plus solide pour les tableaux de preuves ; des vérifications humaines restent nécessaires | Solide pour le contexte des citations ; moins adapté comme environnement complet de rédaction | Plus solide lorsque les outils Scholar/de recherche sont utilisés avant la rédaction ; vérification toujours nécessaire |
| Risque de plagiat involontaire | Élevé si les utilisateurs collent une sortie fluide sans la modifier | Plus faible pour les tableaux d’extraction ; les résumés peuvent toujours être trop proches de la formulation source | Plus faible pour la vérification des affirmations ; ce n’est pas avant tout un outil de rédaction | Plus faible lorsqu’il est utilisé pour les plans et les cartes de sources ; les brouillons nécessitent toujours une revue d’originalité |
| Posture vis-à-vis des données sensibles | Varie selon le fournisseur et le forfait ; les modèles publics constituent un mauvais choix par défaut pour les données identifiables | Espace de travail de recherche ; les conditions d’entraînement et de conservation doivent être lues pour chaque forfait | Espace de travail de recherche ; les conditions d’entraînement et de conservation doivent être lues pour chaque forfait | Politique de plateforme : les données des utilisateurs ne servent pas à entraîner des modèles AI publics |
| Tarification (en 2026) | Non vérifiée dans cette analyse | Non vérifiée dans cette analyse | Non vérifiée dans cette analyse | Offre gratuite avec usage limité ; Plus à $20/mois (allocation 30× supérieure à l’offre gratuite) ; les offres supérieures augmentent l’usage |
| Idéal pour | Réfléchir à des questions dont vous trouverez ensuite les sources vous-même | Sélection systématique, extraction de données, tableaux de preuves | Valider la manière dont un article est cité dans la littérature | Workflows universitaires de bout en bout combinant découverte, notes et rédaction consciente des citations |
Elicit est particulièrement performant lorsque la tâche consiste en une revue structurée. L’entreprise indique que les chercheurs déclarent jusqu’à 80 % de gain de temps dans les workflows de revue systématique et que chaque affirmation générée par AI est étayée par des citations au niveau de la phrase. Les comparaisons indépendantes de 2026 considèrent généralement Elicit comme l’outil le plus vaste pour les opérations de revue et Scite comme le spécialiste de l’intelligence des citations. Une comparaison directe a placé Elicit devant pour les opérations et Scite devant pour la validation des preuves.
Les produits de type Consensus, tels qu’ils sont décrits dans des comparaisons d’outils de 2026, répondent aux questions de recherche à partir de preuves évaluées par les pairs plutôt qu’à partir de textes du web ouvert. Cette conception réduit la fabrication par rapport à un chatbot, mais elle n’élimine pas le problème de fidélité : un article réel peut toujours être résumé de façon incorrecte.
La limite honnête de Jenova est la même que celle que tout agent de recherche responsable devrait afficher. Il peut récupérer, organiser et rédiger ; il ne peut pas garantir qu’un PDF payant dit ce qu’un modèle pense qu’il dit. Les chercheurs qui ont besoin de décomptes du contexte des citations peuvent encore préférer Scite pour cette tâche précise. Les chercheurs qui effectuent une sélection de type PRISMA peuvent encore préférer les tableaux d’Elicit. Le gain d’intégrité consiste à utiliser un outil « source d’abord », puis à vérifier.
Comment détecter et bloquer les citations fabriquées ou déformées ?
Vous détectez les citations fabriquées et déformées en résolvant chaque référence vers un enregistrement actif, puis en lisant le passage cité par rapport à votre phrase, car l’existence et la fidélité sont deux types de défaillances distincts. Un DOI qui renvoie une erreur 404 signale une fabrication ou une erreur de métadonnées fatale. Un article réel cité pour un résultat qu’il n’a jamais établi est une déformation. Les deux peuvent déclencher des examens pour faute scientifique.
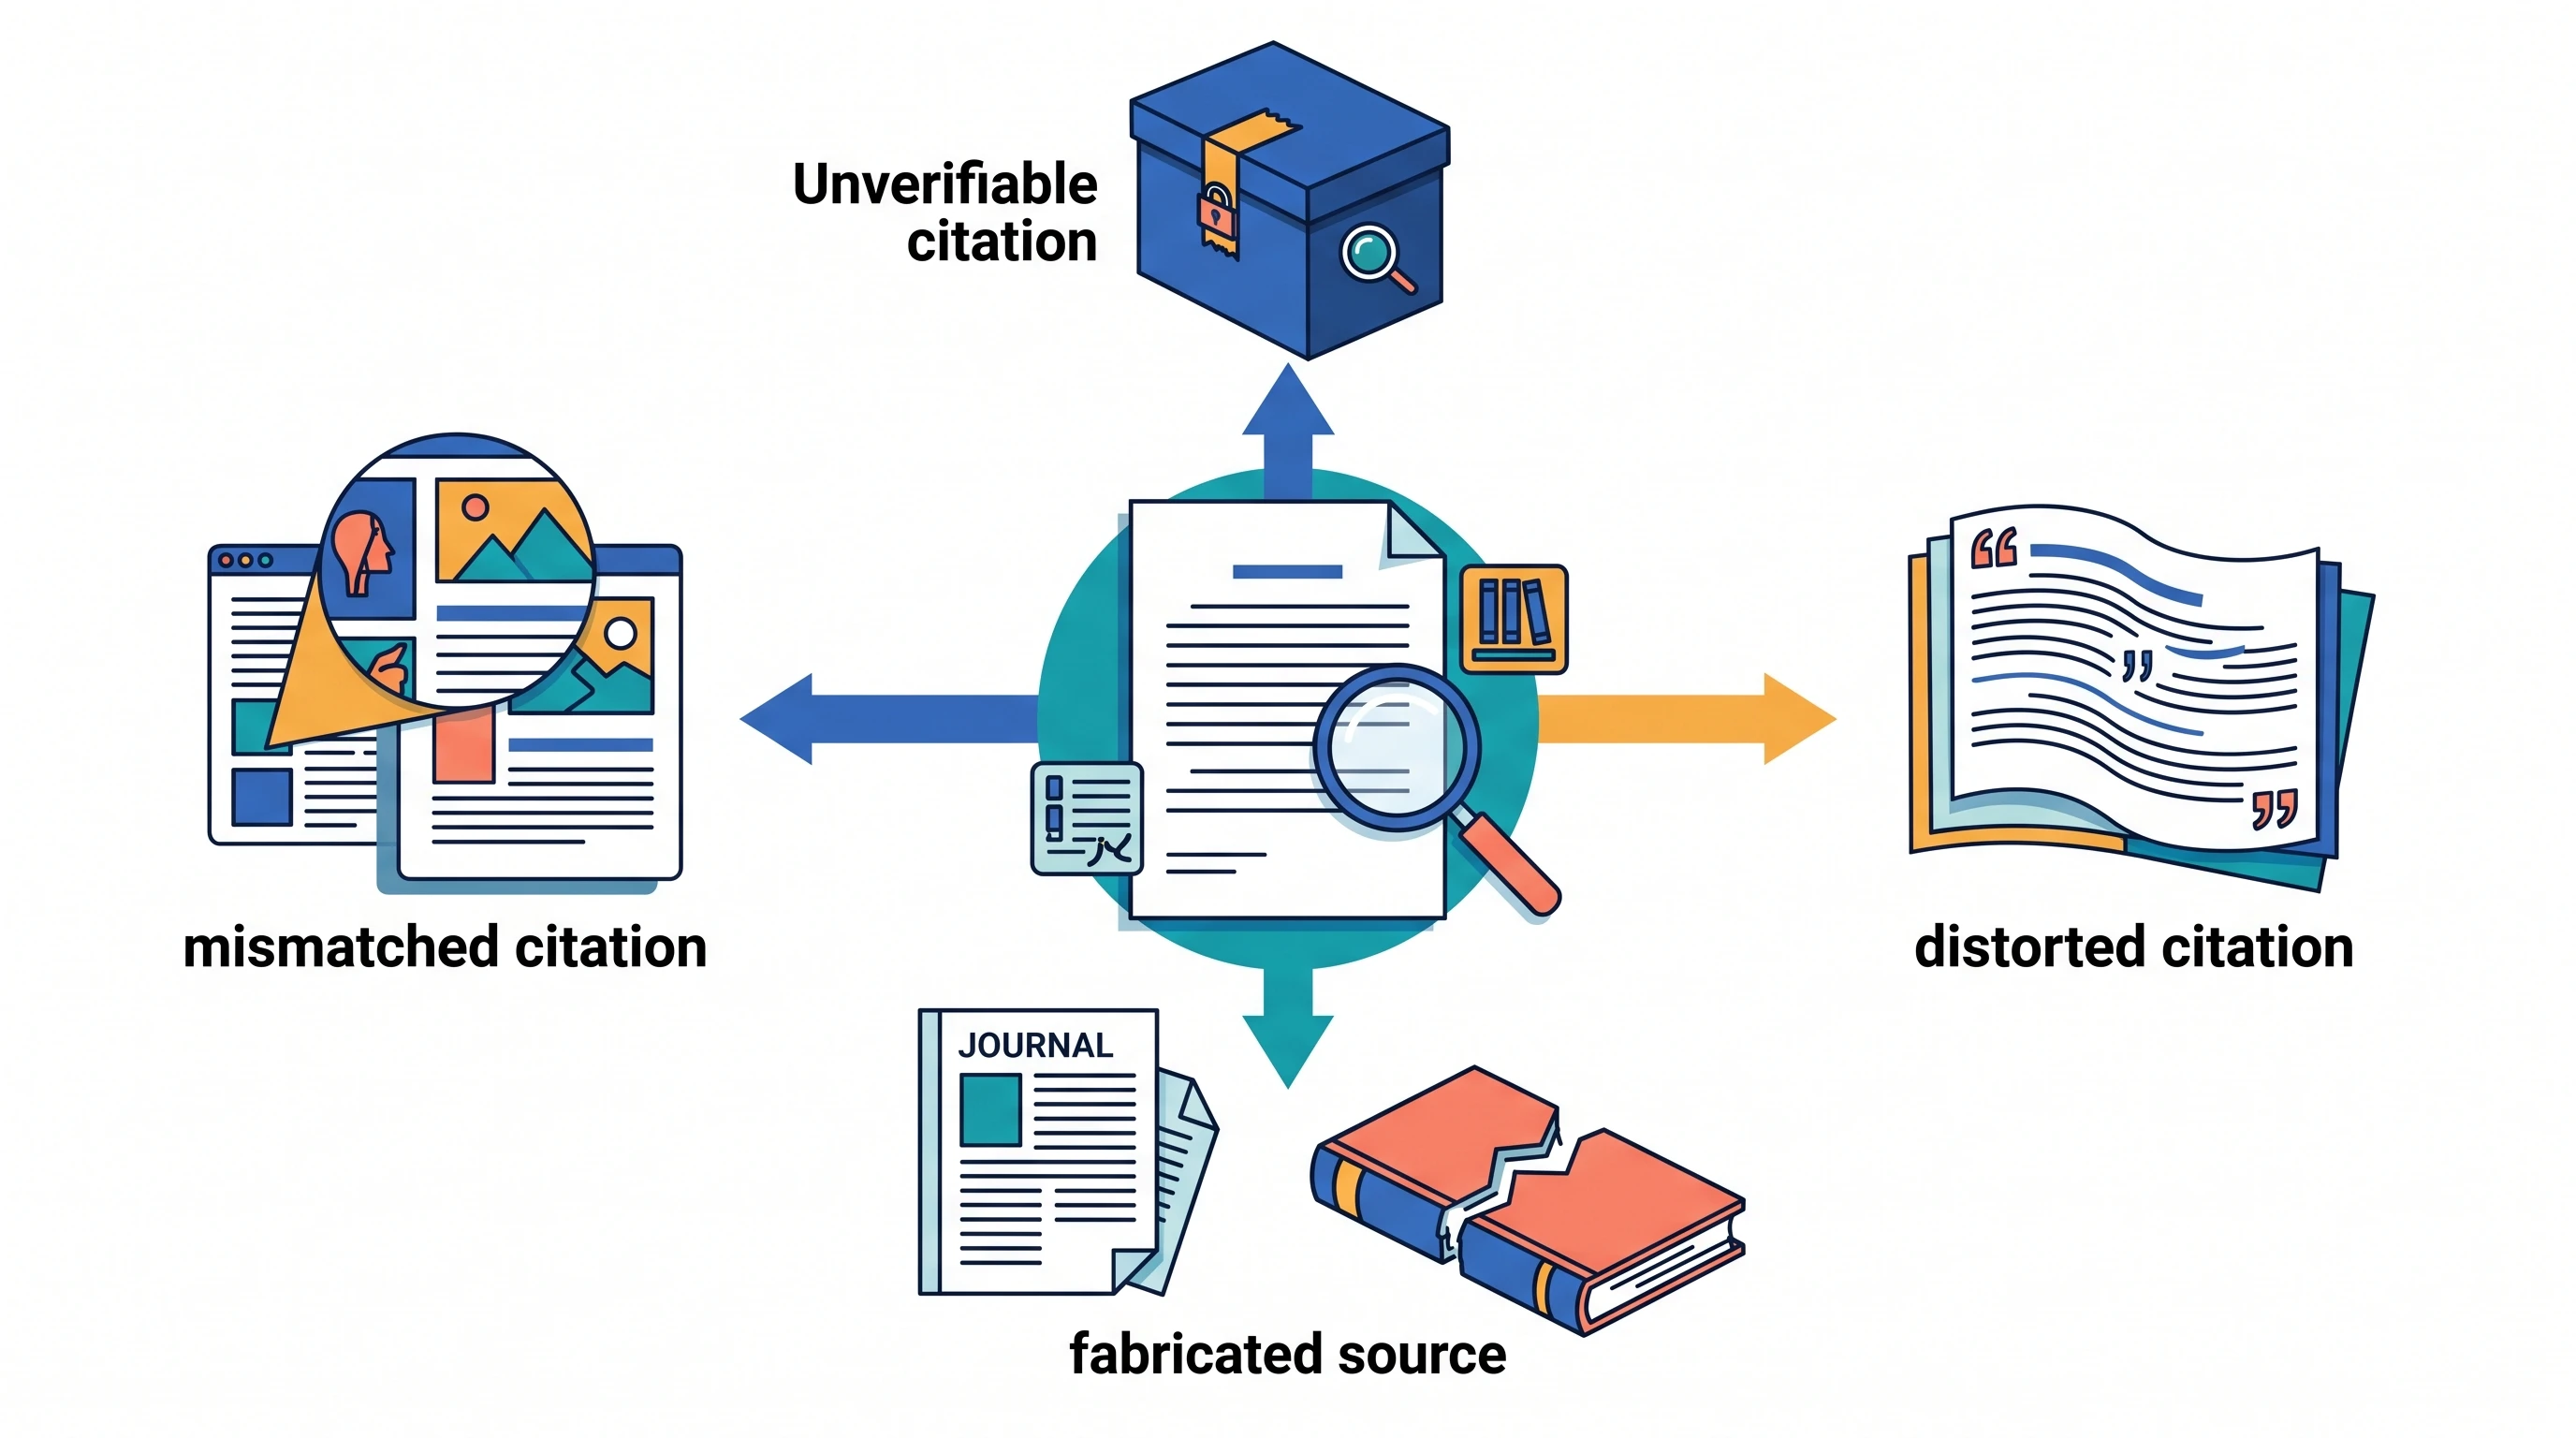
Quatre types de violations apparaissent régulièrement dans les bibliographies assistées par AI :
- Source fabriquée — l’article, le jeu de données ou le livre n’existe pas.
- Citation invérifiable — l’élément peut exister, mais aucun enregistrement accessible, DOI ou exemplaire archivé ne peut être localisé.
- Citation inadaptée — un travail réel est rattaché à la mauvaise affirmation, au mauvais auteur ou à la mauvaise année.
- Citation déformée — la source existe et porte sur le sujet, mais le modèle a inversé un résultat, supprimé une nuance ou traité une limite comme une conclusion.
Un protocole de blocage pratique prend environ deux minutes par affirmation essentielle, et bien moins lorsqu’il devient une habitude :
- Copiez la référence dans Crossref, PubMed, Google Scholar ou le site de la revue et confirmez le triplet titre–auteur–année.
- Ouvrez le PDF ou le HTML et trouvez le passage. Si vous ne le trouvez pas, supprimez la citation.
- Vérifiez que les nuances ont survécu. « Associé à » ne signifie pas « cause ». « Chez la souris » ne signifie pas « chez les patients ».
- Rejetez toute source que le modèle ne peut pas produire sur demande. « Je me souviens d’un article de 2019 dans Nature Neuroscience… » n’est pas une citation.
- Tenez un journal de vérification (tableur ou note du gestionnaire de références) pour les chapitres de thèse et les soumissions à des revues.
L’Academic Research Assistant de Jenova est le plus utile à l’étape 1, lorsque vous lui demandez de récupérer des articles candidats et de construire une carte de sources avant que tout texte n’existe. Associez-le à Scite lorsque vous devez savoir si la littérature ultérieure soutient ou conteste l’article sur lequel vous êtes sur le point de vous appuyer. Associez-le à Elicit lorsque vous extrayez des méthodes et des résultats d’un ensemble d’essais.
Un prompt à haute intégrité ressemble à ceci :
« Trouvez des articles évalués par les pairs de 2020 à 2026 sur [sujet]. Pour chaque article, fournissez le titre, les auteurs, l’année, le DOI, le support de publication et une affirmation de 25 mots explicitement formulée dans le résumé ou les résultats. Si vous ne pouvez pas vérifier un DOI, omettez l’article. N’inventez pas de références. »
Les chatbots génériques échoueront encore parfois face à ce prompt. La différence est qu’un workflow « source d’abord » rend l’échec visible.
Comment prévenir le plagiat involontaire lors de la rédaction avec AI ?
Vous prévenez le plagiat involontaire en traitant la sortie de l’AI comme une matière première non autorisée — jamais comme un texte qui vous appartient — et en réécrivant à partir de notes plutôt qu’à partir des phrases fluides du modèle. Le plagiat involontaire est désormais le cas le plus fréquent : l’utilisateur n’avait pas l’intention de voler, mais le modèle a condensé une source d’une manière si proche qu’un outil de similarité, un examinateur ou un évaluateur peut toujours retrouver la formulation.
Le COPE exige que les auteurs qui utilisent l’AI dans l’écriture, les figures ou l’analyse divulguent l’outil et son utilisation, généralement dans la section Méthodes ou une section équivalente. Les auteurs restent « pleinement responsables du contenu de leur manuscrit, y compris des parties produites par un outil AI ». Cette phrase constitue toute la structure juridique. Le modèle ne peut pas détenir de droits d’auteur, gérer les conflits d’intérêts ni répondre à un avis de rétractation. Vous le pouvez.
Trois voies de plagiat apparaissent dans les brouillons assistés par AI :
- Écho de source — le modèle paraphrase un article que vous avez collé ou qu’il a récupéré, en conservant la syntaxe originale.
- Autoplagiat — le modèle recycle votre paragraphe de méthodes publié antérieurement parce que vous l’avez téléversé comme « contexte ».
- Rédaction par assemblage à grande échelle — de nombreuses phrases légèrement modifiées provenant de nombreux articles, que les logiciels de similarité signalent malgré tout.
Une séquence de rédaction plus sûre :
- Lisez vous-même la source et rédigez un point dans vos propres mots avec un numéro de page.
- Demandez au modèle de réorganiser vos points, et non le PDF.
- Exécutez l’outil de similarité de votre établissement sur le chapitre, et non le « score d’originalité » d’un chatbot.
- Divulguez l’assistance AI dans la forme exigée par votre revue ou votre établissement d’études supérieures.
Un prompt qui réduit l’écho :
« Je vais coller mes propres notes de plan, et non des PDF de sources. Réorganisez-les en une argumentation logique. N’ajoutez pas de nouvelles citations. Ne développez aucun point en un langage pouvant passer pour une phrase savante achevée. Signalez tout point qui nécessite encore une source. »
L’Academic Research Assistant de Jenova est utile ici lorsque vous conservez le texte source dans une couche de notes et rédigez dans un fil distinct. La mémoire persistante est un avantage pour les longues thèses, car l’agent peut retenir votre question de recherche et les articles exclus. C’est aussi un risque si vous collez le brouillon non publié d’un coauteur dans le même projet. Le confinement fait partie de l’originalité : ne laissez pas un manuscrit contaminer un autre.
Le European Network for Academic Integrity publie des lignes directrices générales sur l’intégrité que les établissements utilisent toujours comme vocabulaire de base. Une revue ScienceDirect de 2025 a soutenu que les universités doivent développer les compétences des étudiants et des politiques AI explicites, et non simplement acheter des détecteurs. C’est la bonne priorité. Les détecteurs émettent des hypothèses. La divulgation et les journaux de sources apportent des preuves.
Comment empêcher les données de recherche sensibles d’entrer dans des systèmes AI publics ?
Vous empêchez les données de recherche sensibles d’entrer dans des systèmes AI publics en ne collant jamais de contenu identifiable, sous embargo ou contractuellement restreint dans un outil dont vous ne pouvez pas nommer les pratiques d’entraînement, de conservation ou les sous-traitants. IBM définit la confidentialité de l’AI comme la protection des informations personnelles ou sensibles collectées, utilisées, partagées ou stockées par les systèmes AI. Les travaux universitaires contiennent précisément ce type d’informations : transcriptions d’entretiens, notes de patients, dossiers scolaires, résultats négatifs non publiés et descriptions de projets de subvention.
Les principes classiques de confidentialité se heurtent à une utilisation naïve de l’AI. Le commissaire à l’information de l’État de Victoria note que l’AI remet en cause la limitation de la collecte, la spécification des finalités et la limitation de l’utilisation — l’idée selon laquelle vous ne collectez que ce dont vous avez besoin, expliquez pourquoi et ne le réutilisez pas dans un nouvel objectif. Coller un jeu de données qualitatif complet dans un chatbot public pour « trouver des thèmes » constitue un nouvel objectif que les participants n’ont pas approuvé.
Une liste de contrôle de confinement solide lors d’un examen éthique :
- Minimisez — envoyez le code, l’extrait désidentifié ou le dictionnaire de variables, et non le fichier brut. Les recommandations de minimisation des données pour les systèmes AI préconisent de ne collecter et stocker que ce que la tâche exige.
- Désidentifiez avant le téléversement — supprimez les noms, lieux, diagnostics rares et métadonnées de fichiers.
- Préférez les plateformes qui déclarent ne pas entraîner de modèles publics sur votre contenu — la politique de plateforme de Jenova indique que les données des utilisateurs ne sont pas utilisées pour entraîner des modèles AI publics et qu’elles sont chiffrées en transit et au repos. Lisez les conditions de tout concurrent avec le même niveau de précision ; « nous prenons la confidentialité au sérieux » n’est pas un contrôle.
- Séparez les projets — un fil d’agent par étude, afin qu’un jeu de données hospitalier ne puisse pas être rappelé pendant la rédaction d’un billet de blog public.
- Vérifiez les contrats — les travaux financés par l’industrie, les résultats à double usage et les accords d’utilisation de données interdisent souvent totalement les processeurs tiers.
Jenova est plus robuste qu’un chatbot grand public sur cette dimension grâce à sa position de non-entraînement public et à la mémoire de projet que vous contrôlez. Il ne constitue pas un dossier médical électronique certifié HIPAA, un moteur d’anonymisation ou un substitut à l’environnement sécurisé de votre université. Si un protocole IRB désigne des logiciels approuvés, cette liste prévaut.
Pour la recherche par entretien, un prompt sûr est :
« Voici six extraits désidentifiés dont les noms et les lieux ont déjà été supprimés. Proposez uniquement des codes thématiques. Ne devinez pas les identités. Ne stockez pas ces extraits au-delà de cette tâche si je vous demande plus tard de les oublier. »
Si vous ne pouvez pas écrire ce prompt parce que le texte permet encore l’identification, vous n’êtes pas prêt à utiliser l’AI dessus.
Comment construire un workflow de recherche AI respectueux de l’intégrité ?
Un workflow respectueux de l’intégrité commence par la question de recherche et une bibliothèque de sources, utilise l’AI uniquement à l’intérieur d’étapes nommées et se termine par un paragraphe de divulgation et un journal de vérification. La séquence ci-dessous fonctionne dans l’Academic Research Assistant de Jenova et peut être reproduite, avec des forces différentes, dans Elicit ou Scite.
Étape 1 — Délimiter sans sources. Demandez à l’agent de répertorier les définitions concurrentes, les bases de données probables et les règles d’exclusion. N’acceptez encore aucune citation.
« Je rédige un chapitre de méthodes sur [question]. Répertoriez les sous-questions qu’une recherche systématique devrait couvrir. Ne citez pas d’articles. Signalez les endroits où ma question est trop large. »
Étape 2 — Récupérer, puis figer une bibliothèque. Utilisez l’Academic Research Assistant (ou Elicit, si vous sélectionnez des centaines d’essais) pour collecter des enregistrements candidats avec des DOI. Exportez-les vers Zotero, EndNote ou le gestionnaire de votre établissement. Le gestionnaire de références — et non la transcription du chat — devient le système de référence.
L’agent Deep Research associé de Jenova est utile lorsque vous avez besoin d’un briefing large et riche en citations avant de restreindre le corpus. Considérez ce briefing comme une carte, et non comme de la littérature que vous avez lue.
Étape 3 — Extraire à l’aide d’un tableau, pas d’un paragraphe. Demandez le plan de l’étude, l’échantillon, le résultat et la limite dans des colonnes. Elicit est conçu pour cela ; Jenova peut rédiger le même tableau si vous lui fournissez des articles que vous avez déjà ouverts.
Étape 4 — Rédiger à partir de vos notes. Écrivez ou dictez des points. Autorisez l’agent à établir un plan et à tester la logique. Ne le laissez pas « lisser » le langage avant que les sources soient fixées.
Étape 5 — Vérifier et divulguer. Résolvez chaque DOI. Lisez chaque passage que vous citez. Ajoutez une phrase dans les méthodes telle que : « Un grand modèle de langage (nom du modèle, date) a été utilisé pour organiser les notes et suggérer des termes de recherche ; toutes les citations ont été vérifiées par l’auteur par rapport aux sources primaires. »
La configuration dans Jenova prend quelques minutes : ouvrez l’Academic Research Assistant, indiquez votre domaine et vos contraintes d’intégrité dans le premier message, puis joignez uniquement les fichiers que vous êtes autorisé à traiter. L’offre gratuite couvre un usage limité ; Plus commence à $20 par mois avec une allocation 30 fois supérieure à celle de l’offre gratuite. L’usage est un crédit mensuel plutôt qu’un plafond quotidien, ce qui importe lors d’une phase intensive de révision.
Pour Elicit, le parcours parallèle consiste à poser une question de revue, générer un tableau de preuves, personnaliser les articles inclus dans le rapport, puis exporter et vérifier. Pour Scite, le parcours parallèle consiste à ajouter vos articles essentiels et à examiner les citations favorables et contestataires avant d’affirmer qu’il existe un consensus.
La règle non négociable du workflow est l’ordre. La recherche avant les phrases. Les passages avant les paraphrases. La divulgation avant la soumission.
Que disent les experts en intégrité de la recherche à propos des travaux universitaires assistés par AI ?
Les spécialistes de l’intégrité de la recherche considèrent de plus en plus les citations hallucinées, la rédaction par AI non divulguée et les téléversements de données non contrôlés comme des défaillances de processus contre lesquelles les établissements peuvent concevoir des protections, et non comme de rares cas de triche étudiante.
« L’erreur que nous observons n’est pas que les chercheurs utilisent des modèles. C’est qu’ils utilisent une boucle “générer puis citer” pour des tâches où la citation est elle-même une donnée. Si votre section de résultats dépend de l’existence d’un article, une fausse référence fluide se rapproche davantage de la fabrication de données que d’une mise en forme négligée. La solution est architecturale : récupérez l’enregistrement, extrayez l’affirmation, puis écrivez. Les outils qui inversent cet ordre continueront à semer des fantômes dans la littérature. »
« Les défaillances de confidentialité suivent la même inversion. Les gens collent le fichier le plus riche dont ils disposent parce que c’est pratique, ce qui est l’opposé de la limitation de la collecte. Désidentifiez d’abord, minimisez ensuite et choisissez un système qui n’entraînera pas de modèles publics sur les résidus. La commodité n’est pas une exemption éthique. »
« Nous conseillons également aux laboratoires de cesser de sous-traiter l’intégrité aux détecteurs AI. Les détecteurs ne peuvent pas montrer une source, ne peuvent pas prouver l’intention et produisent des faux positifs qui pénalisent les auteurs non natifs. Un journal de vérification et une divulgation de type COPE sont plus lents le premier jour et beaucoup plus rapides lorsqu’un évaluateur demande : “D’où vient cette référence ?” »
— Équipe produit Jenova, recherche sur les workflows universitaires AI, huit années de conception d’agents de recherche conscients des citations
Cette perspective s’aligne sur les recommandations formelles. Le COPE attribue la responsabilité aux auteurs humains. Cornell demande aux enseignants d’exiger la vérification des citations et de recueillir des preuves objectives — références inexistantes, méthodes que l’étudiant ne peut pas expliquer — plutôt qu’un score de détecteur. Le traitement par Cambridge de l’intégrité universitaire à l’ère de l’AI part de la même prémisse : si les évaluations ne reflètent plus l’apprentissage, c’est le diplôme lui-même qui en paie le prix.
Que se passe-t-il lorsque l’utilisation de l’AI franchit les seuils institutionnels d’intégrité ?
Lorsque l’utilisation de l’AI franchit les seuils institutionnels, les sanctions s’appliquent à l’auteur humain et, de plus en plus, aux directeurs de recherche — allant d’une révision obligatoire à une soumission bloquée ou à l’annulation de l’inscription. Les politiques varient selon les pays et les établissements, mais la tendance en 2026 est à des seuils de similarité plus stricts, à un examen explicite de l’utilisation de l’AI et à moins de tolérance envers l’excuse « le modèle l’a inventé ».
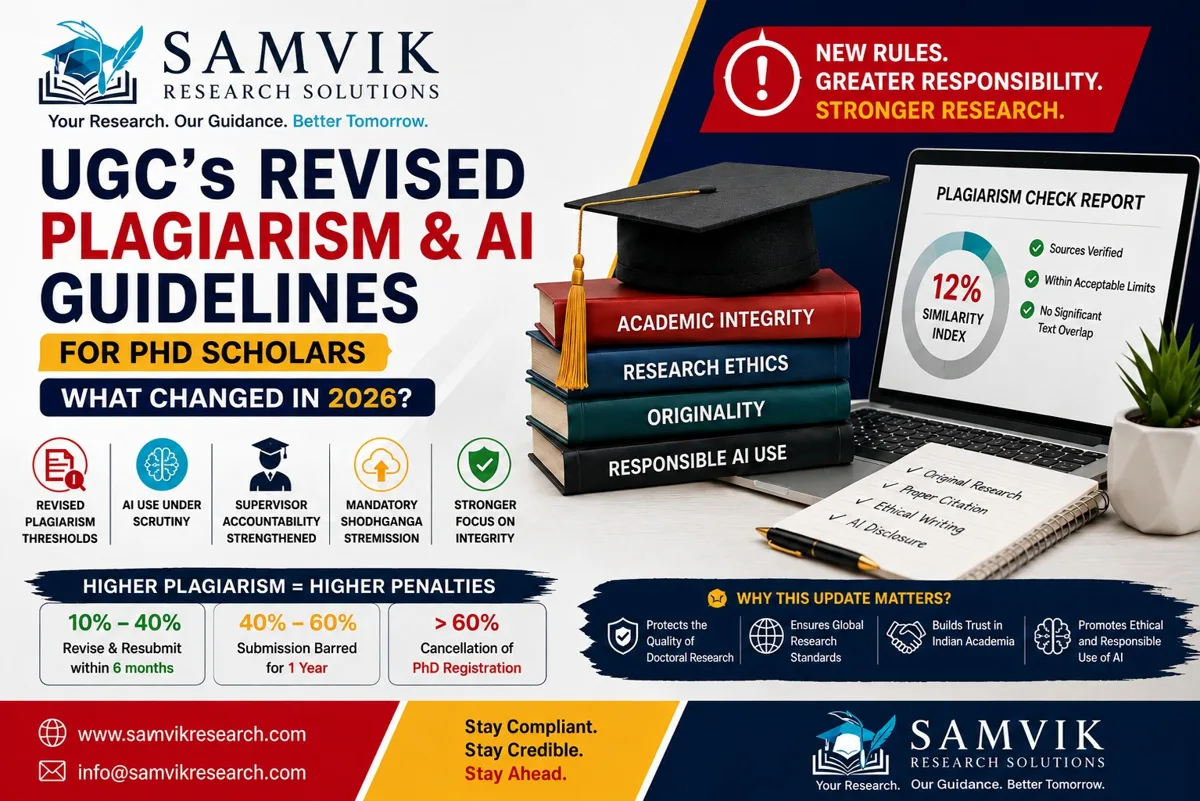
Les orientations diffusées aux doctorants en 2026 autour de la révision de la University Grants Commission (UGC) illustrent la façon dont les seuils numériques deviennent des événements de carrière. Dans ce cadre, une similarité entre 10 % et 40 % entraîne une révision et une nouvelle soumission dans les six mois ; entre 40 % et 60 %, elle peut interdire la soumission pendant un an ; et une similarité supérieure à 60 % peut annuler l’inscription au doctorat. Les mêmes orientations associent ces seuils à un examen plus approfondi de l’utilisation de l’AI, à une responsabilité accrue des directeurs de recherche et au dépôt obligatoire dans un répertoire. Même si votre université applique des seuils différents, la logique est transposable : le chevauchement est considéré comme un signal d’intégrité mesurable, et « l’AI a aidé » n’est pas une défense si le texte n’est pas le vôtre ou si les références ne sont pas réelles.
Les revues ajoutent une seconde couche. La position du COPE sur la paternité signifie que vous ne pouvez pas inscrire ChatGPT, Elicit, Scite ou Jenova comme coauteur. Vous pouvez, et devez souvent, nommer l’outil dans les méthodes. L’absence de divulgation est de plus en plus considérée comme une atteinte à la transparence, même lorsque la science est solide. Les références fabriquées, en revanche, peuvent justifier un rejet ou une rétractation parce qu’elles falsifient les archives savantes.
Implications pratiques pour toute personne qui soumet un travail en 2026 :
- Connaissez votre seuil local de similarité avant de rédiger, et non après l’exécution du vérificateur.
- Conservez les prompts et les versions de modèles afin de pouvoir reconstituer ce que l’outil a apporté.
- Ne considérez pas un faible score de détecteur AI comme une autorisation. Considérez une bibliographie complète et résoluble comme une autorisation.
- Si vous encadrez des étudiants, examinez leurs journaux de sources. La responsabilité remonte la chaîne.
Utilisée dans ces contraintes, l’AI demeure un accélérateur légitime pour la recherche, l’extraction et l’organisation. Utilisée comme un coauteur invisible avec une liste de références inventées, elle constitue désormais l’un des moyens les plus rapides de retarder un diplôme ou un article.
Références
- Nature — Les citations hallucinées polluent la littérature scientifique
- Enago — Références générées par AI : 1 sur 5 est fausse
- STAT — Les citations frauduleuses, attribuées aux hallucinations de l’AI, se propagent dans les articles universitaires
- Today’s Clinical Lab — Les fausses références générées par AI augmentent dans la littérature biomédicale
- Accountability in Research (Taylor & Francis) — Citations hallucinées produites par l’intelligence artificielle générative
- PubMed Central — Citations fabriquées à l’ère de l’AI : un signal d’alarme pour les éditeurs
- Cornell University Center for Teaching Innovation — AI et intégrité universitaire
- COPE — Paternité et outils AI
- Elicit — AI pour la recherche scientifique (taille du corpus, citations au niveau de la phrase, workflow de revue systématique)
- Scite — Réponses étayées par des citations dans plus de 300 millions d’articles savants
- Paperguide — Comparaison Elicit vs Scite pour les chercheurs (2026)
- The Drive AI — Elicit vs Consensus vs Semantic Scholar
- Bibliothèques de George Mason University — Outils AI pour les revues de littérature
- IBM — Explorer les enjeux de confidentialité à l’ère de l’AI
- Office of the Victorian Information Commissioner — Intelligence artificielle et confidentialité : enjeux et défis
- Fortra — Confidentialité des données AI : défis et solutions
- European Network for Academic Integrity — Lignes directrices générales pour l’intégrité universitaire
- ScienceDirect — Réévaluer l’intégrité universitaire à l’ère de l’AI
- Cambridge University Press — L’intégrité universitaire à l’ère de l’AI