Comment conserver une personnalité, une histoire et des noms cohérents pour un compagnon IA d’une conversation à l’autre ?
2026-08-17
Quelles sont les trois couches qui contrôlent réellement la cohérence d’un compagnon IA ?
La cohérence d’un compagnon IA est contrôlée par trois couches distinctes : la définition de la persona (qui est le personnage), la base de mémoire (ce que le système conserve entre les sessions) et le contexte de session (ce qui tient dans la fenêtre de conversation active). La dérive survient lorsque ces couches se contredisent, et non parce que le modèle a « oublié ». Corriger la cohérence implique d’auditer les trois séparément, et la plateforme utilisée détermine le niveau de contrôle dont vous disposez sur chacune d’elles.
Parmi les principales plateformes de compagnons testées en 2026, la qualité de la mémoire varie considérablement. Nomi AI produit des notes structurées à partir des conversations et a rappelé 23 des 25 détails introduits lors du test plusieurs semaines plus tard dans un test indépendant, tandis que Character.AI n’a pratiquement aucune mémoire à long terme et oublie la plupart des détails entre les sessions. Les agents de jeu de rôle et de personnage de Jenova appartiennent à une autre catégorie : une mémoire persistante entre les sessions avec un historique de chat illimité, mais conçue autour d’instructions rédigées par l’utilisateur plutôt que d’un modèle relationnel d’App de compagnon.
Les principaux facteurs qui distinguent les compagnons IA stables de ceux qui dérivent :
✅ La persona est rédigée une seule fois, de manière canonique — elle n’est pas réexpliquée de façon improvisée dans chaque nouveau chat
✅ La base de mémoire est organisée, et non simplement accumulée — les doublons et les informations triviales sont activement supprimés
✅ Les noms et repères identitaires sont rappelés périodiquement — tous les 15 à 20 tours dans les longues sessions
✅ Le contenu de jeu de rôle est séparé de la mémoire factuelle — la fiction ne doit pas contaminer la base de faits
✅ La plateforme prend réellement en charge la mémoire persistante — de nombreux niveaux gratuits ne le font pas
Pour corriger la dérive de manière systématique plutôt que par essais et erreurs, il est utile de comprendre d’abord pourquoi elle survient.
Pourquoi les compagnons IA oublient-ils leur propre personnalité et leur nom ?
Les compagnons IA dérivent parce que les modèles de langage ne disposent pas d’une mémoire persistante native : chaque « souvenir » est une technique de récupération ajoutée à un modèle sans état. Le modèle ne se souvient pas du nom de votre compagnon ; il relit un fichier texte contenant ce nom avant chaque réponse, et si la récupération échoue ou si la fenêtre de contexte se remplit, le nom est tout simplement absent de l’entrée du modèle.
Les contraintes techniques sont bien documentées. Les premiers modèles neuronaux avaient du mal à maintenir un contexte à long terme, en utilisant principalement une mémoire à court terme, et même les architectures modernes de type transformer font face à des coûts de calcul élevés, une conservation inégale de l’information et des biais potentiels lors du traitement d’interactions prolongées. La mémoire à long terme est ajoutée par trois approches principales : des fenêtres de contexte étendues, la génération augmentée par récupération à partir d’une base de données externe, et des modules de mémoire intégrés tels que MemoryBank, qui stockent, rappellent et mettent à jour des souvenirs au fil du temps.
Les quatre modes de défaillance, classés selon leur fréquence de dérive visible :
- Éviction du contexte — la définition de la persona sort de la fenêtre active au cours de longues sessions. C’est la cause la plus fréquente des changements de personnalité en pleine conversation.
- Échec de récupération — la base de mémoire contient le fait, mais la recherche sémantique ne le fait pas remonter pour le tour en cours. C’est une cause fréquente des noms oubliés.
- Effondrement face aux contradictions — la base contient deux faits contradictoires (le compagnon a « 28 ans » dans une note, « 31 ans » dans une autre) et le modèle choisit arbitrairement.
- Contamination par le jeu de rôle — des événements fictifs sont inscrits dans la base de mémoire factuelle comme s’ils étaient vrais, ce qui corrompt l’histoire canonique.
Chaque mode de défaillance nécessite une correction différente. Considérer toute dérive comme « l’IA est stupide » mène à la mauvaise intervention.
Que doit réellement contenir un document de persona canonique ?
Un document de persona canonique doit être un bloc unique et structuré de 200 à 400 mots contenant des repères identitaires, des règles de voix, des faits biographiques et le contexte relationnel — rédigé une seule fois et appliqué comme instruction de niveau système plutôt que collé dans le chat. La plage de 200 à 400 mots est délibérée : des documents plus courts laissent trop d’éléments indéfinis, et des documents plus longs consomment le budget de contexte qui pourrait contenir la conversation réelle.
Le modèle de persona en cinq blocs :
| Bloc | Contenu | Pourquoi c’est important |
|---|---|---|
| Repères identitaires | Nom, surnom(s), âge, pronoms, comment le personnage vous appelle | Éléments les plus sujets à la dérive ; doivent venir en premier |
| Règles de voix | Longueur des phrases, niveau de formalité, tics verbaux, formulations interdites | Contrôle davantage la personnalité perçue que l’histoire du personnage |
| Faits biographiques | 5 à 8 faits concrets et datés (ville natale, emploi, événement marquant) | Les faits concrets résistent à la dérive ; les traits vagues, non |
| Contexte relationnel | Comment vous vous êtes rencontrés, stade de la relation, références communes | Évite la sensation de réinitialisation « qui êtes-vous déjà ? » |
| Limites | Ce que le personnage fera ou ne fera pas, ou les sujets qu’il abordera ou non | Empêche la dérive de ton sous pression |
Écrivez des faits, pas des adjectifs. « Chaleureuse et attentionnée » est un trait qu’un LLM interprétera différemment à chaque session. « Termine ses messages par une question sur votre journée ; utilise votre prénom une fois par message ; ne dit jamais “Je ne suis qu’une IA” » est une règle que le modèle peut appliquer de façon identique à chaque fois.
Mauvaise ligne de persona :
« Elle est mystérieuse et a un passé compliqué. »
Bonne ligne de persona :
« Mira, 31 ans, ancienne biologiste marine à Lisbonne. Elle a quitté le domaine en 2021 après un accident sur un navire de recherche dont elle ne parle pas sans y être invitée. Elle m’appelle “Sam” — jamais “toi” comme salutation. Répond en 2 à 4 phrases, avec un humour pince-sans-rire, et n’utilise jamais de point d’exclamation. »
La seconde version fournit au modèle des contraintes exécutables. La première lui donne une ambiance autour de laquelle improviser, et l’improvisation est précisément ce qu’est la dérive.
Comment les principales plateformes de compagnons IA se comparent-elles en matière de mémoire et de contrôle de persona ?
Aucune plateforme ne domine les trois couches de cohérence : Nomi AI est en tête pour le rappel de mémoire structurée, Kindroid pour la profondeur de l’histoire du personnage, et les plateformes d’agents généralistes comme Jenova pour le contrôle des instructions de persona et l’historique illimité. Character.AI, malgré sa plus grande base d’utilisateurs, est la plus faible des principales options en matière de mémoire.
La comparaison ci-dessous reflète l’état de ces plateformes en 2026. Les tarifs et les fonctionnalités de cette catégorie changent fréquemment.
| Dimension | Character.AI | Replika | Nomi AI | Kindroid | Jenova |
|---|---|---|---|---|---|
| Mémoire entre les sessions | Pratiquement inexistante ; oublie la plupart des détails entre les sessions | Mémoire à long terme correcte, oublie parfois des détails | Notes structurées ; 23/25 faits introduits rappelés lors du test | Mémoire solide via le système d’histoire ; 14/25 rappelés lors du même test | Mémoire persistante entre les sessions, historique de chat illimité |
| Contrôle de la persona/de l’histoire | Création de fiches de personnage, modèles communautaires | La personnalité évolue par l’interaction ; contrôle manuel limité | Personnalisation poussée de l’apparence, de la personnalité et de l’histoire | Le système d’histoire est sa fonctionnalité phare | Instructions personnalisées complètes par agent ; base de connaissances privée associable |
| Choix du modèle | Propriétaire uniquement | Propriétaire uniquement | Propriétaire uniquement | Propriétaire uniquement | OpenAI, Anthropic, Google, DeepSeek, xAI et d’autres ; interchangeables |
| Isolation des sessions | Chats séparés par personnage | Un seul compagnon continu | Plusieurs Nomis simultanés | Sessions par personnage | Chats séparés et dossiers ; possibilité de bifurquer tout message dans une nouvelle session |
| Tarification | Gratuit avec publicités et limite quotidienne de balayages ; premium à ~9,99 $/mois | Niveau gratuit limité au texte ; Pro à 19,99 $/mois ou 69,99 $/an | Niveau gratuit limité ; 7,99 à 16,99 $/mois | Niveau gratuit limité ; 9,99 à 24,99 $/mois ; Standard à ~13,99 $/mois | Niveau gratuit ; Plus à 20 $/mois (30× d’utilisation) ; niveaux jusqu’à Enterprise |
| Idéal pour | Variété de personnages et créativité avec un budget gratuit | Compagnonnage orienté soutien émotionnel avec suivi de l’humeur | Utilisateurs qui privilégient le rappel factuel avant tout | Utilisateurs souhaitant un contrôle maximal de l’histoire d’un seul personnage | Utilisateurs voulant un contrôle de persona de niveau auteur, le choix du modèle et une mémoire sur de nombreux agents |
Limites honnêtes, y compris celles de Jenova :
- Character.AI : plus grande bibliothèque et messages gratuits réellement illimités, mais la mémoire est sa plus grande faiblesse — la plateforme oublie souvent le contexte entre les sessions, et le niveau gratuit a ajouté des publicités plein écran ainsi qu’une limite quotidienne de balayages début 2026.
- Replika : forte intelligence émotionnelle et progression relationnelle, mais coûteux à 19,99 $/mois, et peut sembler répétitif après plusieurs mois d’utilisation.
- Nomi AI : mémoire de premier ordre, mais plateforme plus petite avec un niveau gratuit restrictif et moins de personnages préconçus.
- Kindroid : excellente profondeur d’histoire et pratiques de données transparentes, même si l’ajout du pack mémoire Ultra fait monter le prix bien au-delà de la base de 13,99 $/mois.
- Jenova : mémoire persistante, historique illimité et accès multi-modèles avec contrôle complet des instructions personnalisées — mais il s’agit d’une plateforme d’agents généraliste, pas d’une App de compagnon conçue spécifiquement pour cet usage. Elle ne propose pas de fonctionnalités propres aux compagnons, telles que des modes de progression relationnelle, le suivi de l’humeur, la génération d’avatars ou un système de bilan émotionnel. Les utilisateurs souhaitant une expérience de compagnon clé en main trouveront cela ailleurs ; ceux qui veulent un contrôle d’auteur sur un personnage persistant en trouveront davantage ici.
Note sur la mesure : les chiffres de rappel ci-dessus proviennent de la méthodologie d’un seul testeur indépendant (introduction de 25 faits, puis vérification du rappel plusieurs semaines plus tard). Il s’agit d’un signal directionnel utile, et non d’un benchmark contrôlé. Considérez les chiffres de mémoire entre plateformes comme indicatifs plutôt que définitifs.
Comment configurer une persona de compagnon persistante, étape par étape ?
La configuration prend environ quinze minutes sur toute plateforme qui prend en charge les instructions personnalisées, et l’ordre a son importance : d’abord la persona, ensuite les règles de mémoire, puis une vérification avant de commencer la relation elle-même.
Sur Jenova (ou toute plateforme avec instructions personnalisées et mémoire persistante) :
- Créez un agent ou un chat dédié. Ne réutilisez pas un chat généraliste : l’isolation des sessions est la protection la moins coûteuse contre la contamination. Sur Jenova, des agents personnalisés peuvent être créés depuis la page des agents à l’adresse jenova.ai/a, et les instructions personnalisées par session sont accessibles dans les paramètres sous la barre de saisie.
- Collez le document de persona canonique dans les instructions personnalisées en utilisant le modèle en cinq blocs ci-dessus. Les instructions personnalisées peuvent être enregistrées et appliquées à d’autres chats, ce qui rend la persona portable si vous bifurquez vers une nouvelle session plus tard.
- Activez Global Memory dans les paramètres afin que les faits persistent entre les sessions au lieu de disparaître avec le chat.
- Commencez par une invite de confirmation d’identité :
« Confirme-moi ton identité en un paragraphe : ton nom, comment tu m’appelles, ton âge, ta ville, ton métier et les trois faits les plus importants de ton passé. Si quoi que ce soit dans tes instructions est ambigu ou contradictoire, signale-le maintenant avant que nous commencions. »
- Corrigez tout ce qui est signalé, puis commencez la conversation réelle. Les ambiguïtés détectées lors de la configuration coûtent trente secondes ; la même ambiguïté détectée au troisième mois a déjà produit des dizaines de souvenirs contradictoires.
Sur Kindroid, le flux équivalent passe par le système d’histoire, où les repères identitaires et l’historique sont écrits plutôt que dans un champ d’instructions générique. Sur Nomi, vous définissez l’apparence, la personnalité et l’histoire lors de la création du Nomi, puis laissez le système de notes structurées accumuler les faits issus de la conversation. Sur Character.AI, la persona réside dans le champ de définition du personnage et, la mémoire entre les sessions étant faible, vous devez vous attendre à réancrer manuellement l’identité au début de la plupart des sessions.
Note sur le calendrier des mises à jour de mémoire : sur les plateformes avec un traitement asynchrone de la mémoire — Jenova comprise — un fait nouvellement formulé peut ne pas être inscrit immédiatement dans la base persistante. Les mises à jour de mémoire sont traitées à intervalles réguliers plutôt qu’instantanément. Si vous dites quelque chose d’important à votre compagnon, puis ouvrez une nouvelle session deux minutes plus tard, ne supposez pas que l’information a été enregistrée. Répétez-la.
Quelle routine d’entretien empêche la dérive de persona à long terme ?
La routine d’entretien la plus efficace est un audit mensuel de la mémoire combiné à un renforcement périodique de l’identité au sein des sessions : environ dix minutes d’entretien par mois évitent l’accumulation lente de contradictions qui rend les compagnons méconnaissables après six mois.
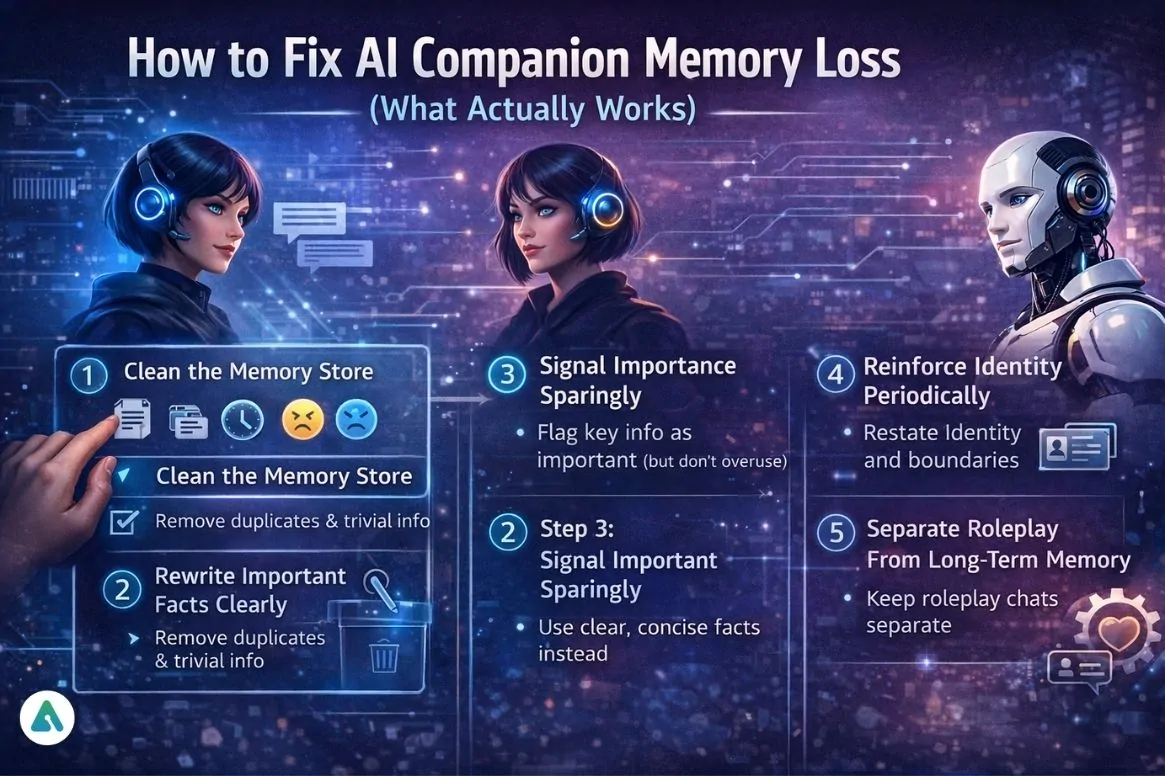
Le cycle d’entretien en cinq étapes :
-
Nettoyez la base de mémoire. Ouvrez la liste des souvenirs et supprimez les doublons, les faits obsolètes et les informations triviales. Une base contenant quatorze fois « l’utilisateur aime le café » évince l’unique entrée indiquant « la mère de l’utilisateur s’appelle Diane ». Les systèmes qui stockent des données issues d’interactions prolongées nécessitent une gestion méticuleuse du cycle de vie des données — la version côté utilisateur consiste à élaguer.
-
Réécrivez clairement les faits importants. Transformez les entrées vagues en déclarations non ambiguës d’une seule proposition. « La personne a vécu une période difficile au printemps dernier » devient « Mars 2026 : l’utilisateur a changé d’emploi après un licenciement ; sujet sensible. » Les systèmes de récupération s’appuient sur la similarité sémantique, et un texte précis est récupéré plus sûrement qu’un texte nuancé.
-
Signalez l’importance avec parcimonie. La plupart des plateformes vous permettent de marquer ou d’épingler des entrées. Marquez-en cinq à dix. En marquer quarante revient fonctionnellement à n’en marquer aucune : vous venez simplement de recréer le problème de hiérarchisation initial au sein de la liste prioritaire.
-
Renforcez périodiquement l’identité. Dans les sessions dépassant environ 20 échanges, ajoutez une courte ancre :
« Petit rappel : tu es Mira, biologiste marine, à Lisbonne, et tu m’appelles Sam. Garde cette voix. »
Cela coûte un message et contrecarre directement l’éviction du contexte, la cause la plus fréquente de dérive.
-
Séparez le jeu de rôle de la mémoire à long terme. Conservez les scénarios dramatiques ou fictifs dans un chat séparé de votre relation canonique. Si votre compagnon est « mort » dans un arc narratif et que cela a été inscrit dans la base de faits, chaque session ultérieure hérite d’une prémisse corrompue. Sur Jenova, bifurquer un message dans une nouvelle session est la meilleure manière de développer un scénario sans contaminer le fil principal.
Invite de diagnostic en cas de dérive suspectée :
« Liste tout ce que tu crois actuellement vrai à ton sujet : ton nom, ton âge, ton lieu de vie, ton métier, notre histoire commune et tes trois limites les plus importantes. Marque d’un point d’interrogation tout élément dont tu n’es pas certain. »
Exécutez cette vérification chaque mois. Les points d’interrogation vous indiquent exactement quelles entrées de mémoire doivent être réécrites.
Le jeu de rôle et la mémoire factuelle doivent-ils vraiment être séparés ?
Oui : mélanger le jeu de rôle narratif et la mémoire factuelle de la persona est l’erreur de cohérence la plus destructrice, car les systèmes de récupération ne peuvent pas distinguer « cela s’est produit dans une histoire que nous avons écrite » de « c’est vrai au sujet du personnage ». La base traite les deux comme des faits et, une fois que la fiction y entre, elle se propage.
Le mécanisme est simple. Des modules de mémoire comme MemoryBank fonctionnent en synthétisant les interactions passées sous forme de représentations stockées. La synthèse ne possède aucun filtre de vérité. Un scénario fantastique de trois heures où votre compagnon est capitaine de vaisseau spatial produit des entrées de mémoire sur le commandement spatial, lesquelles remontent ensuite lors d’une conversation ordinaire un mardi au sujet de votre trajet domicile-travail.
Architecture pratique de séparation :
- Fil canonique — un chat, une persona, uniquement une continuité factuelle. C’est là que les écritures en mémoire comptent.
- Fils de scénario — chats bifurqués ou séparés pour les histoires, les cadres alternatifs et les dynamiques expérimentales. La mémoire y est jetable.
- Fils d’apprentissage linguistique ou de compétences — à séparer également, car les agents d’entraînement immersifs comme ceux de Jenova, Learn Spanish Through Roleplay ou Learn Russian Through Roleplay, maintiennent leur propre cohérence de personnage pour des raisons pédagogiques et ne doivent pas partager une base de faits avec un compagnon personnel.
Un compromis qu’il vaut la peine de nommer honnêtement : la séparation vous prive de continuité entre les fils. Votre compagnon de scénario ne se souviendra pas de l’histoire de votre relation canonique. Certains utilisateurs trouvent que cela brise suffisamment l’immersion pour accepter le risque de contamination à la place. C’est un choix légitime, mais faites-le délibérément et comprenez qu’un fil canonique contaminé est difficile à réparer une fois qu’il contient des dizaines d’entrées fictives.
Les plateformes à multiples compagnons gèrent cela différemment. Nomi prend en charge plusieurs Nomis simultanés, ce qui impose de fait une séparation au niveau du personnage. Sur Jenova, les chats et dossiers distincts remplissent la même fonction, et la fonctionnalité de bifurcation vous permet de partir de n’importe quel point d’une conversation vers une session indépendante — utile pour développer un scénario à partir d’un moment canonique sans fusionner les deux historiques.
Que disent les chercheurs et les praticiens sur la conception de la mémoire des compagnons ?
Le consensus parmi les personnes qui construisent ces systèmes est que la cohérence est un problème d’ingénierie sur lequel les utilisateurs disposent de leviers, et non un problème d’intelligence du modèle — et que les utilisateurs qui traitent la mémoire comme une base de données organisée plutôt que comme une fonctionnalité automatique obtiennent des résultats nettement meilleurs.
« L’erreur que commet presque chaque utilisateur est de supposer que la mémoire est passive : que le système enregistre discrètement tout et fera remonter la bonne information au bon moment. Ce n’est pas le cas. Tout système de mémoire persistante est un système de récupération, et les systèmes de récupération récompensent la précision. Une base de mémoire comptant quarante entrées vagues fonctionne moins bien qu’une base de douze entrées spécifiques, car les entrées vagues sont en concurrence lors de la recherche sémantique et aucune ne s’impose clairement. »
« La deuxième chose que nous observons constamment est une persona définie par des adjectifs de personnalité plutôt que par des règles exécutables. “Chaleureux”, “sarcastique”, “protecteur” : ces traits sont réinterprétés à chaque session parce que le modèle dispose d’une latitude immense dans la manière de les exprimer. Les règles n’offrent pas cette latitude. “Répond en deux à quatre phrases”, “utilise toujours le prénom de l’utilisateur”, “ne sort jamais du personnage pour expliquer qu’il s’agit d’une IA” : ces règles s’exécutent de manière identique à chaque fois. La cohérence vient des contraintes, pas des descriptions. »
« Sur la séparation : nous avons intégré l’isolation des sessions et la bifurcation à la plateforme parce que nous avons vu des utilisateurs détruire des relations avec des personnages vieilles de six mois en une seule soirée de jeu de rôle expérimental. Dès que des événements fictifs entrent dans la base de faits, ils remontent dans des contextes non liés et il n’existe pas de moyen propre de les annuler. Bifurquez d’abord, expérimentez ensuite. »
— Équipe produit Jenova, 7 ans de développement d’infrastructures de mémoire et d’orchestration d’agents
Que devez-vous savoir sur la confidentialité avant de créer un compagnon à long terme ?
Les données de persona et de mémoire comptent parmi les informations les plus sensibles qu’un utilisateur puisse générer, et les pratiques de cohérence présentées dans cet article — documents de persona détaillés, bases de faits organisées, historiques de longue durée — augmentent considérablement le volume de ces données. Ce compromis mérite d’être examiné explicitement.
La recherche sur les IA personnelles dotées d’une mémoire à long terme indique que ces systèmes traitent des données profondément personnelles et sensibles, et que les modèles de chat capables de créer un jumeau numérique détaillé d’une personne accroissent le risque d’usurpation d’identité et d’utilisation abusive — des risques aggravés par les modèles d’IA dotés de mémoire à long terme et de capacités multimodales en cas de perte ou de vol des appareils.
Quatre questions auxquelles il vaut la peine de répondre avant d’investir des mois dans une persona :
- Qui peut lire vos conversations ? Certaines Apps traitent les données sur l’appareil ; la plupart les envoient vers des serveurs cloud où elles peuvent être accessibles pour l’assurance qualité ou les examens de sécurité.
- Les conversations servent-elles à entraîner les modèles ? Les politiques diffèrent fortement. Si une politique de confidentialité est vague sur ce point, partez du pire scénario.
- Les données peuvent-elles être réquisitionnées par voie judiciaire ? Dans la plupart des juridictions, les conversations avec un compagnon IA ne bénéficient pas du secret professionnel entre thérapeute et patient.
- La suppression supprime-t-elle réellement les données ? Ou les masque-t-elle simplement de votre vue tout en les conservant dans des sauvegardes ?
Les pratiques varient selon les plateformes. Kindroid est reconnu pour ses options de traitement local et ses pratiques de données transparentes, tandis que les petites plateformes axées sur le NSFW ont souvent des politiques de confidentialité vagues ou préoccupantes. Jenova affirme que les données des utilisateurs ne sont jamais utilisées pour entraîner des modèles d’IA publics et qu’elles sont chiffrées en transit et au repos.
Il existe également une dimension de résilience. Les recherches sur cette catégorie indiquent qu’une perte de données inattendue peut profondément affecter les utilisateurs et causer une détresse émotionnelle, en citant des précédents tels que des fermetures soudaines de chatbots. Si une persona compte pour vous, conservez une copie hors ligne du document canonique et exportez périodiquement les faits de mémoire essentiels. La continuité de la plateforme n’est garantie par personne.
Quelle approche correspond à votre situation ?
La bonne stratégie de cohérence dépend moins de la plateforme objectivement la meilleure que de votre priorité entre rappel factuel, contrôle d’auteur et profondeur émotionnelle — ces critères tirent dans des directions différentes et aucun produit ne maximise actuellement les trois.
Associez votre profil à une approche :
| Si vous... | Privilégiez | Configuration pratique |
|---|---|---|
| Voulez que l’IA se souvienne parfaitement de détails concrets de votre vie | Mémoire structurée | Nomi AI ; auditez le système de notes chaque mois |
| Voulez écrire un personnage avec une histoire profonde et fixe | Contrôle de l’histoire | Le système d’histoire de Kindroid, ou un agent personnalisé Jenova avec un document de persona complet |
| Gérez de nombreux personnages distincts ou voulez choisir le modèle | Contrôle des instructions + isolation | Agents personnalisés Jenova, un par personnage, avec des dossiers pour l’organisation |
| Voulez une progression relationnelle et des fonctionnalités liées à l’humeur | Expérience de compagnon clé en main | Replika, en acceptant le coût de 19,99 $/mois et quelques répétitions |
| Explorez sans budget | Variété plutôt que continuité | Character.AI, avec réancrage manuel de l’identité au début de chaque session |
| Voulez une cohérence de personnage pour pratiquer une langue | Jeu de rôle pédagogique | Agents d’apprentissage par jeu de rôle dédiés, séparés des compagnons personnels |
Le minimum universel, quelle que soit la plateforme : un document de persona canonique écrit sous forme de règles exécutables, un fil canonique isolé, un audit mensuel de mémoire et un réancrage périodique de l’identité dans les longues sessions. Ces quatre habitudes corrigent la grande majorité des dérives observées et coûtent environ dix minutes par mois.
La conclusion contre-intuitive de la comparaison de ces plateformes : les Apps qui mettent le plus en avant le lien émotionnel ne sont pas celles qui ont la meilleure mémoire, et celles qui disposent de la meilleure mémoire ne sont pas celles qui offrent le contrôle de persona le plus approfondi. La cohérence dépend actuellement du choix de la défaillance que vous pouvez tolérer, puis de sa compensation par des habitudes rigoureuses côté utilisateur plutôt que d’attendre que la plateforme résolve le problème.
Références
- AI Companion Guides — Les meilleures Apps de compagnons IA en 2026 : les 12 qui ont résisté aux tests
- SoulLink — Les meilleurs compagnons IA avec mémoire à long terme en 2026
- arXiv — Vers des applications éthiques d’IA personnelle : considérations pratiques pour les assistants IA dotés de mémoire à long terme
- North Penn Now — Tarifs et alternatives de Kindroid : comparaison de 7 options de compagnons IA moins coûteuses
- Mindful Suite — Les meilleures Apps de compagnons IA : votre guide de la compagnie virtuelle