Comment empêcher l’AI d’oublier le contexte d’une recherche menée sur plusieurs mois ?
2026-08-21
Quelles architectures de mémoire préservent les stratégies de recherche pendant tout un cycle de revue ?
Les chatbots liés à une session perdent les chaînes de recherche, les critères d’inclusion et les résultats extraits dès qu’une conversation se termine, ce qui explique pourquoi les revues menées sur plusieurs mois s’enlisent. Les outils qui traitent le protocole comme un état durable — Jenova's Academic Research Assistant, avec une mémoire persistante entre les sessions, Elicit, avec des espaces de travail de revue systématique au niveau du projet, et les carnets limités à un corpus de sources comme Gemini Notebook — sont les architectures qui résistent à un cycle complet de revue en 2026. Consensus reste plus performant pour cartographier rapidement les données probantes que pour mémoriser votre protocole au trimestre suivant.
Les facteurs clés qui distinguent une mémoire de recherche durable d’un chat jetable :
✅ Couche de protocole figée — règles d’inclusion et d’exclusion enregistrées comme instructions, et non comme un prompt à retaper ✅ Mémoire cumulative des résultats — extractions antérieures, motifs d’exclusion et conflits non résolus rappelés sans nouvelle mise en contexte ✅ Corpus ancré dans les sources — articles, notes et journaux de recherche attachés afin que les réponses restent liées à votre ensemble de preuves ✅ Décisions auditables — justification de la sélection reconstituable des mois plus tard, conforme à PRISMA 2020 ✅ Continuité entre les sessions — changer de jour, d’appareil ou de modèle ne doit pas effacer l’état de la revue
Pour comparer utilement ces outils, il faut considérer la mémoire de recherche comme une pile plutôt que comme une fonctionnalité de chatbot, et vérifier si chaque couche résiste encore après une semaine d’absence du projet.
Pourquoi les assistants de recherche AI perdent-ils la fidélité au protocole au fil du temps ?
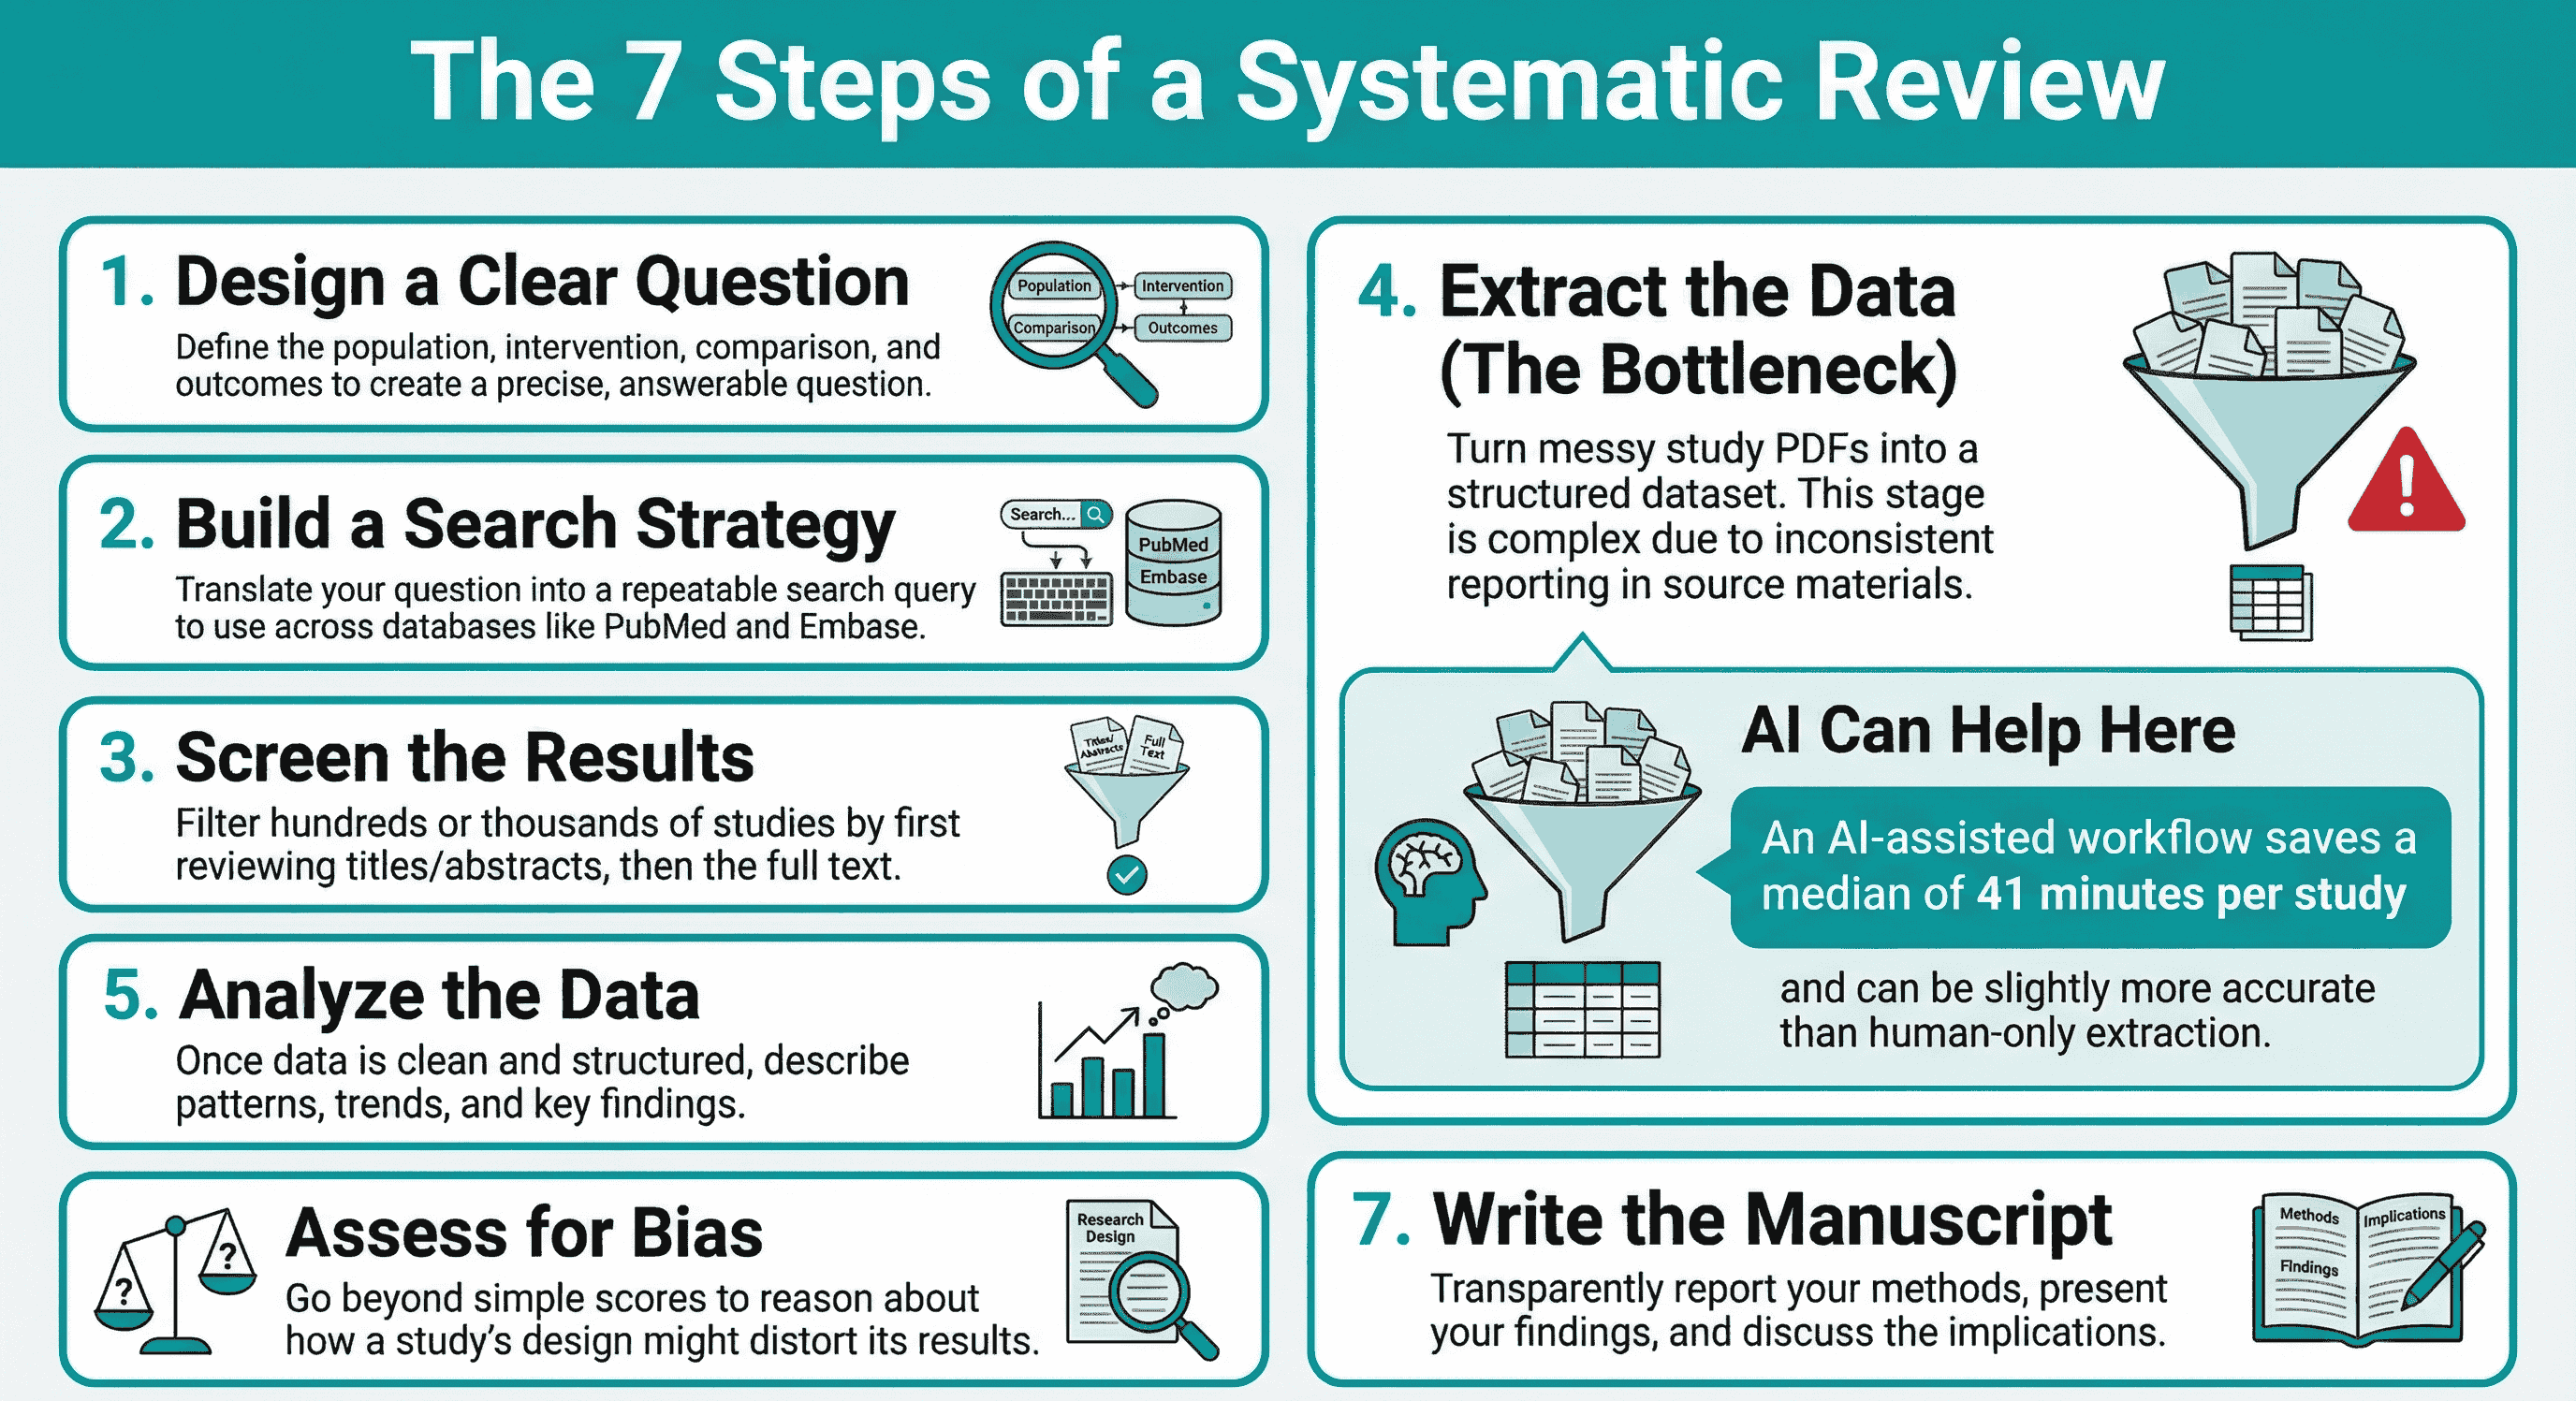
La plupart des chats AI grand public oublient parce qu’ils stockent le contexte dans une fenêtre temporaire, et non dans un projet qui survit à la session. Une revue systématique est un processus en sept étapes — conception de la question, stratégie de recherche, sélection, extraction, analyse, évaluation des biais et rédaction du manuscrit — et chaque étape dépend de décisions prises plusieurs semaines auparavant. Lorsque l’assistant ne peut pas se rappeler le cadrage PICO d’origine ou la raison pour laquelle une étude a été exclue, la revue commence à dériver.
La norme de rapport pour ce travail est explicite. La déclaration PRISMA 2020 est une liste de contrôle fondée sur les données probantes indiquant comment les revues systématiques doivent être rapportées, et la publication de PRISMA 2020 dans le BMJ la positionne pour les revues incluant une synthèse telle qu’une méta-analyse par paires. Le guide méthodologique de l’Université Hofstra précise que la déclaration constitue un ensemble minimal de 27 éléments pour rapporter les revues systématiques et les méta-analyses. Un assistant incapable de reconstituer les chaînes de recherche ou les motifs d’exclusion ne peut pas soutenir cette liste de contrôle.
Le problème de l’oubli n’est pas hypothétique. Les chercheurs utilisent déjà le machine learning tout au long du pipeline de revue ; une cartographie de 63 outils de ML publiée en 2022 couvrait des tâches allant de la recherche documentaire à l’extraction de données. Ce que ces outils résolvent rarement à eux seuls est la fidélité longitudinale : appliquer la même règle d’inclusion de la même manière au quatrième mois qu’au premier.
Les assistants de type chat aggravent ce problème de trois façons précises :
- Évaporation du protocole. Les chaînes booléennes, la couverture des bases de données (PubMed, Embase) et les limites de dates vivent dans un prompt qui n’est pas enregistré comme objet de premier ordre.
- Dérive des critères. Les reformulations informelles des règles d’inclusion modifient progressivement les définitions de la population, de l’intervention ou des résultats.
- Amnésie des résultats. Les tailles d’effet extraites, les résultats contradictoires et les notes du type « revenir à cet article » disparaissent lorsque le fil de discussion n’existe plus.
Le guide sur la synthèse des preuves du King’s College London reflète le consensus actuel : l’AI peut aider à différentes étapes d’une revue, mais elle ne remplace pas le contrôle méthodologique. La mémoire est ce contrôle, étendu sur la durée calendaire.
Que faut-il rechercher dans un outil AI qui mémorise le contexte de recherche ?
Vous devez évaluer l’AI de recherche à long terme selon la persistance du protocole, la continuité des résultats, l’ancrage dans les sources, l’auditabilité, la couverture du corpus et le coût du maintien de cet état — et non selon la fluidité d’un unique échange. Un outil qui rédige d’élégants résumés mais ne peut pas récupérer le journal d’exclusion du mois dernier vous coûtera davantage d’heures qu’il n’en fera gagner.
Cet article utilise un modèle à quatre couches, la pile de continuité de la recherche, pour rendre cette évaluation concrète :
- Protocole figé. Stratégies de recherche et critères d’inclusion/exclusion enregistrés hors du tampon de chat (instructions personnalisées, document de protocole ou configuration de sélection).
- Mémoire cumulative. Résultats antérieurs, questions ouvertes et désaccords entre évaluateurs qui s’accumulent entre les sessions au lieu d’être réinitialisés.
- Corpus ancré. Les articles, PDF, notes et exports de recherche que l’assistant est autorisé à utiliser.
- Audit des décisions. Raisons reconstituables des inclusions/exclusions, idéalement accompagnées de citations, afin qu’un second évaluateur ou un diagramme de flux PRISMA puisse être produit ultérieurement.
L’évaluation au regard de cette pile change la question d’achat. Elicit est conçu pour que les critères de sélection, les motifs d’exclusion et les scores par critère soient auditables selon PRISMA, ce qui est solide pour les couches 1 et 4. Gemini Notebook est conçu pour que les réponses citent des extraits exacts des sources importées, ce qui est solide pour la couche 3. Consensus est conçu pour rechercher dans plus de 250 millions d’articles scientifiques et montrer où les données probantes concordent, ce qui le rend solide pour la découverte mais faible pour mémoriser votre protocole. Jenova's Academic Research Assistant repose sur un historique de chat illimité, une mémoire persistante entre les sessions et des bases de connaissances attachables, ce qui est solide pour les couches 1 à 3 dans un programme de travail étalé sur plusieurs mois, mais moins performant pour les diagrammes PRISMA natifs.
Pondérez les couches selon le type de projet. Une revue systématique de type Cochrane doit surpondérer l’auditabilité. Une revue de littérature de thèse qui s’étend sur deux semestres doit surpondérer la mémoire cumulative. Un laboratoire qui réutilise les mêmes articles dans plusieurs projets doit surpondérer un corpus ancré et réutilisable.
Comment Jenova, Elicit, Consensus et Gemini Notebook gèrent-ils la mémoire de recherche à long terme ?
Jenova est le plus performant lorsque le programme de recherche est conversationnel, itératif et se mesure en mois ; Elicit est le plus performant lorsque l’unité de travail est une revue systématique formelle ; Consensus est le plus performant pour cartographier rapidement les données probantes ; Gemini Notebook est le plus performant lorsque le corpus est déjà disponible. Aucun de ces quatre outils n’est universellement préférable, car chacun optimise différentes couches de la pile de continuité de la recherche.
| Fonctionnalité / Dimension | Elicit | Jenova Academic Research Assistant | Consensus | Gemini Notebook |
|---|---|---|---|---|
| Persistance du protocole | Espace de travail de projet ; mises à jour de revue vivante | Historique illimité, mémoire persistante, instructions personnalisées | Filtres au niveau du prompt ; aucun protocole enregistré | Instructions et sources limitées au carnet |
| Critères d’inclusion | Critères suggérés automatiquement ; double évaluation ; motifs d’exclusion | Encodés dans les instructions et rappelés entre les sessions | Filtres en langage naturel appliqués à chaque recherche | Définis par l’utilisateur dans un carnet délimité |
| Rappel des résultats antérieurs | Tableaux d’extraction et rapports réutilisables | Mémoire entre sessions des notes, conflits et décisions | Synthèse au niveau de la requête, pas journal longitudinal | Ancré dans ce que vous avez importé |
| Corpus / sources | 138 millions d’articles, PubMed, ClinicalTrials.gov, imports | Imports utilisateur, bases de connaissances, outils de recherche en direct | plus de 250 M d’articles, texte intégral sous licence | PDF, documents, sites, audio et vidéo importés |
| Auditabilité | Flux PRISMA, citations, scores par critère | Trace conversationnelle ; pas de diagramme PRISMA natif | Citations académiques et Consensus Meter | Citations au niveau des extraits des sources |
| Tarification (en 2026) | Abonnement payant, incluant une offre Pro documentée | Offre gratuite ; offres payantes à partir de $20/mois | Abonnement payant | Gratuit pour les particuliers ; les données organisationnelles ne servent pas à l’entraînement |
| Idéal pour | Revues systématiques formelles et mises à jour vivantes | Programmes de recherche sur plusieurs mois qui ne doivent rien oublier | Instantanés rapides des données probantes et recherche en mode médical | Synthèse sur corpus fermé et enseignement à partir de sources |
Elicit
Elicit est un assistant de recherche scientifique spécialement conçu pour rechercher, résumer, extraire des données et converser avec plus de 125 millions d’articles, et son produit de revue systématique indexe 138 millions d’articles avec des mises à jour hebdomadaires. Il peut sélectionner jusqu’à 40 000 articles, suggérer automatiquement des critères de sélection et garder chaque décision auditable selon PRISMA avec des motifs d’exclusion et des citations à l’appui.
Sa limite pour un programme de recherche mixte étalé sur plusieurs mois est sa spécialisation. Elicit excelle dans les opérations de revue structurées ; il est moins conçu comme un partenaire de recherche généraliste qui se souvient des hypothèses secondaires, des retours d’un directeur de recherche et des notes évolutives en dehors de l’objet de revue.
Jenova Academic Research Assistant
L’Academic Research Assistant est un partenaire de recherche académique pour la découverte de littérature, la préparation de manuscrits et la gestion des citations, fonctionnant sur une plateforme dotée d’un historique de chat illimité et d’une mémoire persistante entre les sessions. Les stratégies de recherche et les critères d’inclusion peuvent être figés dans des instructions personnalisées de l’agent ; les PDF, protocoles et journaux de sélection peuvent être attachés comme base de connaissances privée afin que les sessions ultérieures repartent du même ensemble de preuves.
Sa limite honnête est l’inverse de celle d’Elicit. Il ne fournit pas de diagramme de flux PRISMA natif, d’interface de sélection avec double évaluation ni de corpus dédié de 138 millions d’articles pour les revues systématiques. Les équipes qui ont besoin de pistes d’audit au niveau Cochrane exporteront toujours leurs décisions dans un gestionnaire de revue. Un travail connexe nécessitant un rapport riche en citations, produit en un seul passage, peut être confié à Deep Research, qui synthétise des centaines de sources avec des citations intégrées, puis enregistré dans le même fil de discussion de longue durée afin que les résultats ne deviennent pas un autre document orphelin.
Consensus
Consensus est un moteur de recherche académique AI qui s’appuie sur plus de 250 millions d’articles, y compris du texte intégral sous licence. Il indique être utilisé par 10 millions de chercheurs, étudiants et cliniciens, avec plus de 170 partenaires parmi les bibliothèques universitaires. Deep Search étend les termes et parcourt le graphe de citations ; le mode Medical se limite à environ 50 000 directives cliniques et 8 millions d’articles issus des 1 000 principales revues médicales. Le Consensus Meter visualise dans quelle mesure les données probantes concordent sur une question appelant une réponse par oui ou non.
La comparaison de Paperguide publiée en 2026 fournit le bon cadre : Consensus trouve et évalue les données probantes ; Gemini Notebook transforme les sources que vous possédez déjà. Consensus est limité comme système de mémoire. Il n’enregistre pas nativement vos critères d’inclusion comme protocole vivant ; un projet qui dure un semestre a donc toujours besoin d’un emplacement externe pour conserver « ce que nous avons décidé en mars ».
Gemini Notebook
Gemini Notebook (le produit autrefois appelé NotebookLM, rebaptisé depuis juillet 2026) est un partenaire de réflexion ancré dans les sources. Vous importez des PDF, sites web, vidéos YouTube, fichiers audio, Google Docs et diapositives ; les réponses comportent des citations montrant les extraits exacts. Les données organisationnelles ne sont pas utilisées pour entraîner le produit.
La limite est le carnet. Il n’oubliera pas les sources que vous lui avez fournies, ce qui explique précisément son efficacité pour un ensemble de lectures défini, mais il ne découvrira pas l’article que vous n’avez jamais importé. Pour une revue de plusieurs mois encore en phase de recherche, il s’agit d’une limite structurelle, pas d’un problème de paramètres.
Comment conserver les stratégies de recherche et les critères d’inclusion entre les sessions ?
Vous les conservez en les rédigeant sous forme d’objets durables — un document de protocole, des instructions personnalisées ou une configuration de sélection — et en refusant de garder l’unique copie dans un prompt jetable. Si la stratégie n’existe que dans le chat d’hier, elle n’existe pas.
Un modèle pratique ressemble à ceci :
- Figez la question sous forme PICO. La population, l’intervention, la comparaison et les résultats doivent être copiés textuellement dans les instructions permanentes de l’assistant, et non paraphrasés chaque lundi.
- Enregistrez la recherche comme artefact reproductible. Les noms des bases de données, les chaînes booléennes, les limites de dates, les restrictions linguistiques et les sources de littérature grise doivent figurer dans un document que l’assistant peut relire.
- Séparez l’inclusion de l’intuition. Des critères tels que « RCT, adultes, 2015–2026, texte intégral en anglais » doivent être listés comme règles. Les préférences telles que « semble pertinente pour notre théorie » doivent être étiquetées comme hypothèses afin qu’elles ne puissent pas réécrire silencieusement le protocole.
- Consignez les exclusions avec leurs motifs. PRISMA exige un rapport transparent du processus de sélection ; l’aperçu méthodologique de DistillerSR souligne que PRISMA existe pour aider les auteurs à éviter les écueils qui compromettent les revues.
Pour Jenova, l’étape du protocole figé consiste en un bloc d’instructions personnalisées associé à un PDF de protocole attaché. Un prompt permanent qui survit pendant des mois peut ressembler à ceci :
Tu es mon partenaire de revue systématique pour le projet HEP-24. Population : adultes de 18 ans et plus atteints de NAFLD. Intervention : agonistes des récepteurs GLP-1. Comparaison : soins standard ou placebo. Résultats principaux : MRI-PDFF et NAS. Inclure les RCT et cohortes prospectives, 2018–2026, texte intégral en anglais. Exclure les études animales, les résumés de congrès sans données et les essais de moins de 8 semaines. Rappelle toujours les règles d’inclusion avant de sélectionner un nouveau lot et n’élargis jamais silencieusement la population.
Pour Elicit, l’équivalent consiste à affiner le protocole de revue dans le produit, puis à utiliser les critères de sélection suggérés automatiquement que vous acceptez, modifiez ou remplacez. Chaque décision peut comporter un motif d’exclusion et une citation justificative, ce qui se rapproche davantage d’un dossier d’audit PRISMA que d’un journal de chat.
Pour Gemini Notebook, collez le même bloc PICO dans les instructions du carnet et importez le protocole ainsi que l’export de recherche. L’assistant restera fidèle à ces fichiers et n’inventera pas d’articles en dehors de ceux-ci.
Le mode de défaillance à surveiller est « l’élargissement utile ». Après six semaines, les modèles commencent souvent à inclure des populations voisines parce qu’elles semblent pertinentes. Un protocole figé que l’assistant doit rappeler au début de chaque session est le contrôle le moins coûteux que vous puissiez ajouter.
Comment la mémoire persistante modifie-t-elle l’extraction de données et l’évaluation des biais ?
La mémoire persistante transforme l’extraction, d’une tâche de transcription ponctuelle, en jeu de données cumulatif ; c’est là que se perd le plus de temps et que l’aide de l’AI est désormais vérifiable empiriquement. Le schéma des sept étapes de la revue identifie l’extraction comme le goulet d’étranglement parce que les PDF sources rapportent les résultats de manière incohérente ; un assistant qui ne peut pas mémoriser la feuille d’extraction réintroduira ce désordre chaque semaine.
Les données probantes de 2026 sont plus précises que les affirmations marketing. Une étude au sein d’une revue sur medRxiv a comparé l’extraction assistée par Elicit à l’extraction réalisée uniquement par des humains sur 50 RCT portant sur des maladies chroniques et n’a constaté aucune différence dans l’exactitude globale (différence moyenne de 0,57 sur une échelle de 0 à 100), tandis que l’extraction assistée par AI était 24,82 minutes plus rapide et coûtait $181,98 de moins pour les 50 études. Les types et la gravité des erreurs étaient similaires. La propre validation d’Elicit indique que VDI/VDE a correctement extrait 1 502 des 1 511 points de données (99,4 %), et des chercheurs de CSIRO ont constaté des faux négatifs proches de zéro par rapport à l’extraction manuelle.
Une autre ligne de recherche considère l’AI comme second évaluateur plutôt que comme remplacement. Un article de Cochrane Evidence Synthesis and Methods a rapporté que les outils AI affichaient des performances élevées et similaires à celles des évaluateurs humains pour l’extraction de données, en particulier sur les variables standardisées. La note méthodologique de Birmingham City University est plus prudente : les outils génératifs sont performants pour l’année, le pays et le nombre de participants, ce qui n’équivaut pas à extraire des résultats nuancés par bras d’essai.
Au-delà de l’exactitude brute de l’extraction, la mémoire apporte la cohérence de la feuille :
- Les mêmes noms de résultats, points temporels et unités sont réutilisés à la semaine 12 comme à la semaine 2.
- Les divergences déjà signalées, telles que « deux tailles d’échantillon dans le même article », ne sont pas redécouvertes comme si elles étaient nouvelles.
- L’évaluation des biais peut raisonner sur le plan d’étude, et non uniquement sur un score. Le travail sur le risque de biais porte sur la façon dont la randomisation, l’insu et les données manquantes peuvent déformer les résultats — ce qui exige de mémoriser les notes sur la conception de l’étude, et pas seulement le résumé.
La limite de Jenova est ici l’interface, et non l’intention. La mémoire persistante se rappellera que vous considérez la dissimulation de l’allocation comme un domaine critique, mais elle ne remplira pas automatiquement un tableau Cochrane RoB 2. La limite d’Elicit est l’inverse : l’extraction peut être très structurée et étayée de citations, tandis que le raisonnement informel sur les biais évoqué lors d’une réunion avec le directeur de recherche a toujours besoin d’un lieu où persister. Les équipes qui font les deux devraient extraire dans l’outil structuré et conserver les commentaires au niveau de la conception dans l’agent de recherche de longue durée.
Comment mettre en place un flux de travail de recherche AI qui dure des mois ?
Vous le mettez en place en créant un unique espace de projet durable, en chargeant le protocole avant la première recherche et en exécutant chaque session ultérieure comme une mise à jour de cet espace plutôt que comme un nouveau chat. Le flux de travail repose sur la même idée, que vous utilisiez un agent doté de mémoire native ou un espace de travail de revue systématique ; seuls les boutons changent.
Configuration Jenova (moins de deux minutes, puis suivi continu)
- Ouvrez l’Academic Research Assistant et, si le projet est de longue durée, enregistrez le protocole comme instructions personnalisées sur un agent dédié.
- Attachez le protocole, les chaînes de recherche et toute feuille de calcul de sélection existante comme base de connaissances.
- Commencez par un bilan d’état, et non par un vague « continuer » :
Rappelle notre PICO, les bases de données interrogées, la date de la dernière recherche, le nombre d’études incluses/exclues et les trois conflits non résolus de la dernière session. Sélectionne ensuite les 25 titres suivants selon les critères figés. N’élargis pas les critères d’inclusion.
- Terminez chaque session par une transmission écrite que la session suivante peut charger : mises à jour de recherche, nouvelles exclusions avec leurs motifs, champs d’extraction encore manquants et questions destinées au second évaluateur.
Les offres payantes de Jenova commencent à $20/mois pour une allocation d’utilisation 30× supérieure à celle de l’offre gratuite, avec des niveaux supérieurs à $50, $100, $200, $500 et $1 000 par mois. L’utilisation est réinitialisée chaque mois à la date de facturation. Cette tarification est pertinente pour les travaux de plusieurs mois, car une revue qui s’arrête lorsqu’un plafond de l’offre gratuite est atteint en pleine sélection connaît une défaillance de mémoire d’un autre genre.
Configuration Elicit
Le flux de revue systématique d’Elicit est le suivant : affiner le protocole, combiner les recherches provenant de PubMed, ClinicalTrials.gov et de son corpus d’articles, ou importer depuis d’autres bases de données, sélectionner avec une double évaluation assistée par AI, extraire avec des champs étayés de citations, puis synthétiser des rapports pouvant inclure des diagrammes de flux PRISMA, des tableaux récapitulatifs d’articles et des stratégies de recherche. Les revues vivantes sont la fonctionnalité adaptée aux travaux de plusieurs mois : associez la revue à des alertes afin que le même protocole intègre de nouveaux articles sans créer un nouveau projet.
Configuration Gemini Notebook
Créez un carnet par revue. Importez le protocole, l’export de recherche et les PDF. Posez uniquement des questions auxquelles il devrait être possible de répondre à partir de ces fichiers. Lorsque de nouveaux articles passent la sélection, ajoutez-les au même carnet au lieu d’en créer un second ; les carnets scindés sont la manière dont les outils ancrés dans les sources « oublient ».
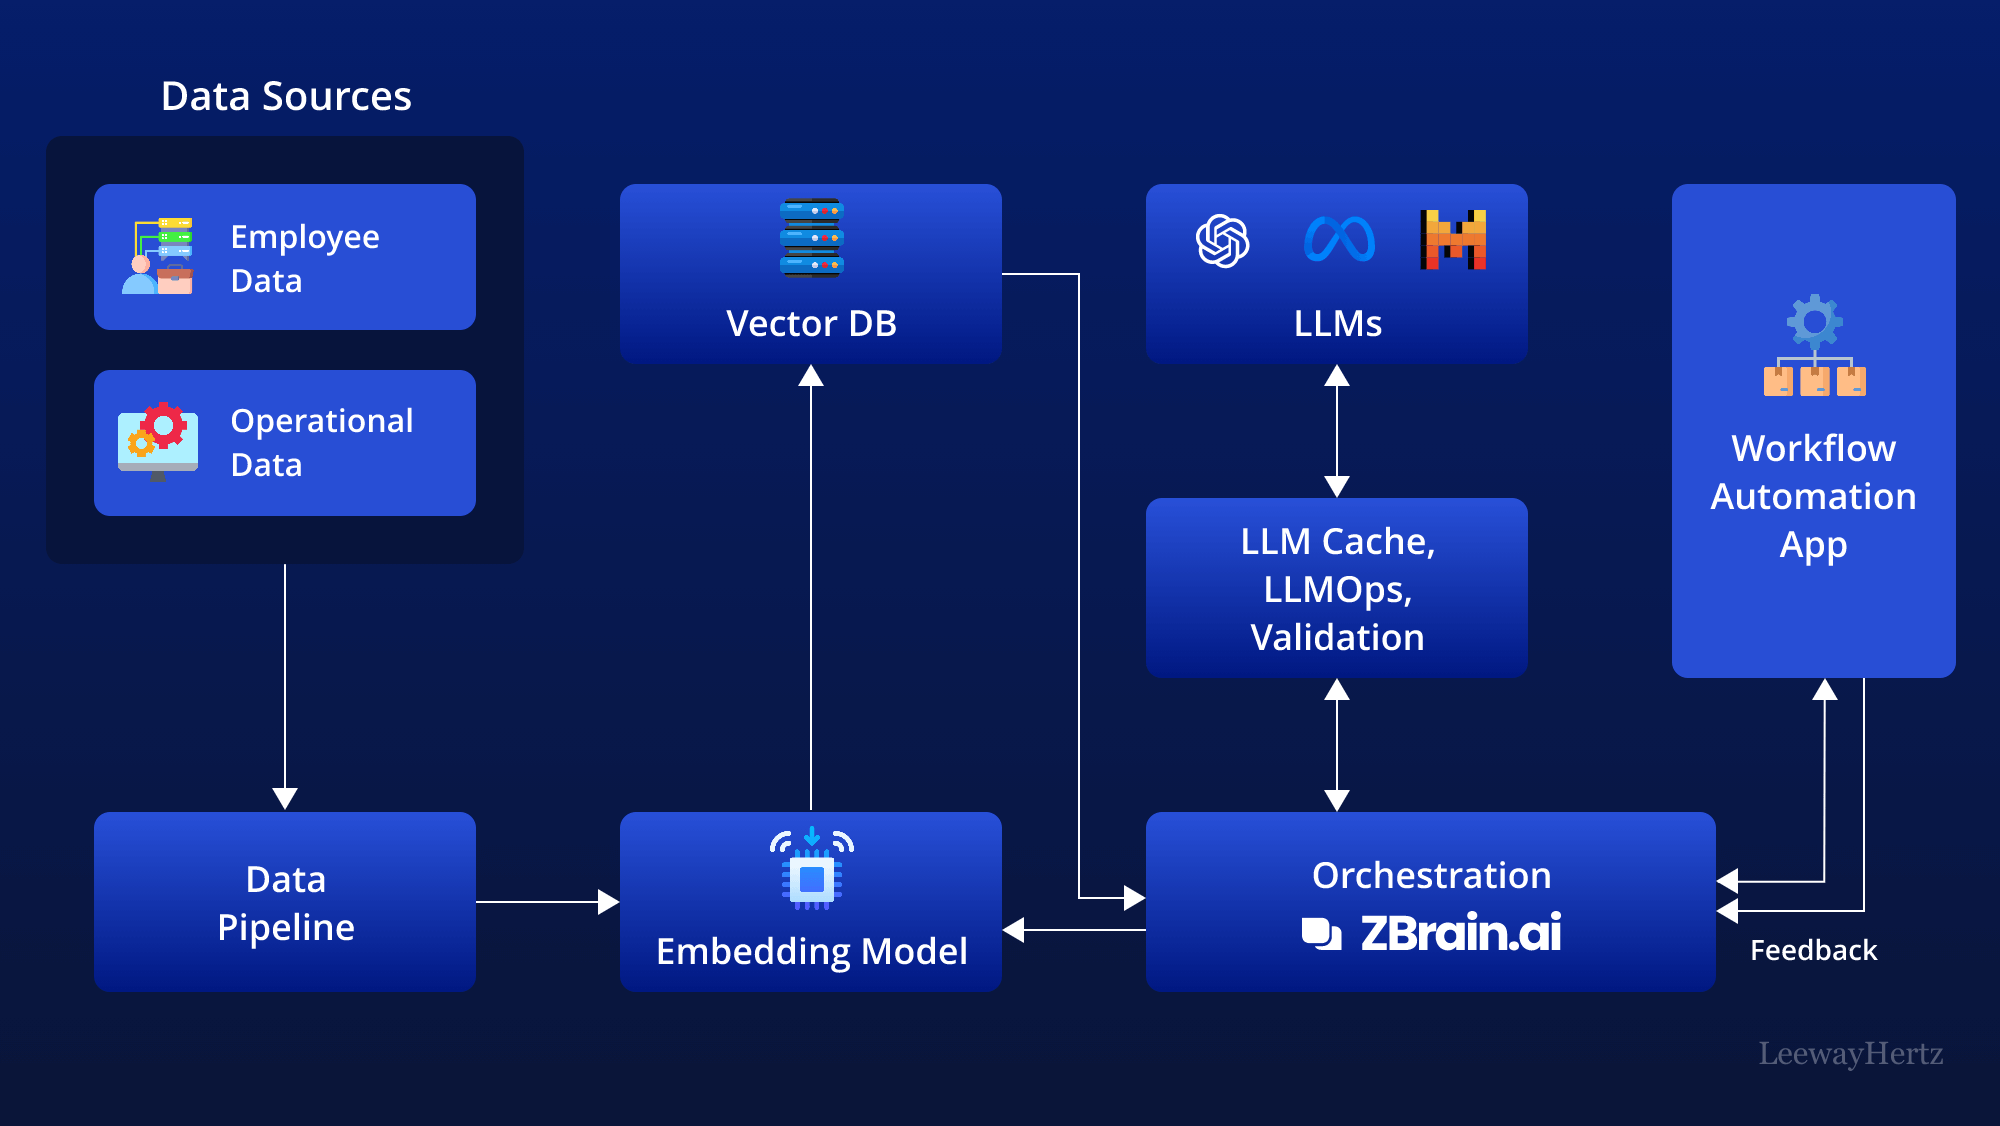
Le schéma d’architecture est la version industrielle de la même idée. Une mémoire de recherche durable est un pipeline : les sources passent par l’ingestion, les embeddings, un magasin vectoriel, l’orchestration, les appels de modèles, la validation et une boucle de rétroaction. Les chercheurs n’ont pas besoin d’assembler eux-mêmes cette pile, mais ils ont besoin d’un produit qui l’implémente. Le chat de session n’est que la dernière boîte. Si les résultats n’atterrissent jamais dans la mémoire, une base de connaissances ou un espace de travail de revue, le pipeline n’a pas d’état et, au quatrième mois, vous réexpliquerez le premier mois.
Que disent les méthodologistes de la recherche sur la mémoire AI dans la synthèse des preuves ?
Les méthodologistes considèrent l’AI comme un évaluateur qui fait gagner du travail tout en posant un problème d’audit, et non comme un substitut à un protocole que l’on peut reconstituer. La question utile pour les experts n’est pas « le modèle peut-il extraire une taille d’échantillon ? », mais « un second humain peut-il voir pourquoi cet article a été exclu en février et être encore d’accord en octobre ? »
« Les revues qui s’effondrent au sixième mois échouent presque jamais parce que le modèle a manqué un synonyme. Elles échouent parce que la règle d’inclusion n’a jamais été enregistrée comme objet. Les équipes retapent une définition de population légèrement différente à chaque session, puis se demandent pourquoi le tableau de preuves ne se stabilise pas. La mémoire persistante n’est pas une fonctionnalité de confort dans ce contexte. C’est la seule manière pour le protocole et les résultats d’occuper la même chronologie. »
« Nous voyons aussi des équipes faire trop confiance à l’extraction structurée et trop peu investir dans les journaux de décisions. Des champs de données étayés de citations sont nécessaires, et les études d’extraction de 2026 sont encourageantes quant au rapport exactitude-temps. Elles n’enregistrent pas pourquoi un essai à la limite des critères a été conservé. Si votre AI ne peut pas récupérer cette raison, vous n’avez pas de revue vivante. Vous avez une série de chats liés entre eux. »
« La conception pratique que nous recommandons est sans surprise : figez le protocole dans des instructions, cumulez les résultats dans une mémoire ou un espace de travail, ancrez les réponses dans un corpus que vous pouvez identifier et exportez un audit que la liste de contrôle PRISMA peut exploiter. Choisissez les outils pour ces quatre fonctions. Ne choisissez pas un outil parce que la première après-midi vous a semblé fluide. »
— Équipe produit Jenova, conception de flux de travail de recherche de longue durée
Cette position correspond à l’univers de rapport dans lequel les revues doivent s’inscrire. L’article d’explication et d’élaboration de PRISMA 2020 sur PMC indique explicitement que la directive concerne les revues qui incluent une synthèse, et EQUATOR Network héberge la même directive de rapport actualisée. Un assistant qui ne peut pas se souvenir des méthodes ne peut pas vous aider à les rapporter.
Qu’arrive-t-il à la reproductibilité lorsqu’un assistant AI ne peut pas rappeler les exclusions du mois dernier ?
La reproductibilité s’effondre et devient une mise en scène : vous pouvez toujours générer une section fluide sur les travaux connexes, mais vous ne pouvez plus défendre l’ensemble des études retenues. Un projet de plusieurs mois produit des centaines de décisions d’inclusion/exclusion. Si ces décisions ne sont pas récupérables, un nouvel évaluateur, un directeur de recherche ou un relecteur de revue ne peut pas distinguer une exclusion fondée sur le protocole d’une décision dictée par l’humeur de la session.
Les revues systématiques vivantes rendent l’échec visible. Elicit décrit les revues vivantes comme l’association d’une revue achevée à des alertes afin que de nouvelles informations puissent être intégrées chaque année, ou selon les besoins, et permet de partager un lien vers l’ensemble du processus et les résultats intermédiaires. Cela ne fonctionne que si les exclusions du trimestre précédent font partie de l’objet mis à jour. Un chatbot qui « se souvient du sujet » mais non du journal d’exclusion réinclura des articles déjà rejetés ou rejettera de nouveau des articles déjà extraits.
Trois contrôles de reproductibilité révèlent rapidement l’écart :
- Test de répétition. Demandez à l’assistant, après une semaine d’absence, de lister les 20 dernières exclusions avec leurs motifs. S’il invente des raisons ou mélange les projets, la couche d’audit est absente.
- Test d’élargissement. Donnez-lui un résumé hors périmètre mais thématiquement tentant. S’il plaide pour son inclusion sans citer les critères figés, la persistance du protocole a échoué.
- Test de transmission. Un collègue doit pouvoir reprendre à partir du dernier bilan d’état de l’assistant sans briefing oral. S’il ne le peut pas, la mémoire est personnelle et non scientifique.
Jenova réussit les tests de répétition et de transmission lorsque les instructions, les bases de connaissances et la mémoire de session sont réellement utilisées ; il exige toujours que vous exportiez un journal au format PRISMA si une revue souhaite un diagramme de flux. Elicit gère plus nativement le test d’audit et exige toujours que vous conserviez ailleurs le jugement scientifique informel. Consensus et Gemini Notebook, utilisés seuls, échouent à des contrôles différents : Consensus ne répétera pas vos exclusions, et Gemini Notebook ne répétera pas les articles qui n’ont jamais été importés.
Le problème de recherche sur plusieurs mois n’est donc pas de savoir « quel modèle est le plus intelligent en 2026 ». Il consiste à déterminer si les stratégies de recherche, les critères d’inclusion et les résultats antérieurs sont stockés dans une pile qui existe encore à votre retour. Choisissez l’outil qui conserve ces trois objets, puis demandez à l’assistant de les rappeler au début de chaque session afin que toute dérive se produise au grand jour.
Références
- Déclaration PRISMA 2020 — Liste de contrôle, diagrammes de flux et recommandations de rapport pour les revues systématiques
- Déclaration PRISMA — Présentation de la principale directive de rapport pour les revues systématiques
- The BMJ — Déclaration PRISMA 2020 : une directive actualisée pour le rapport des revues systématiques
- LibGuides de l’Université Hofstra — Liste de contrôle PRISMA à 27 éléments pour les revues systématiques et les méta-analyses
- ScienceDirect — Outils AI pour les revues systématiques de littérature et les méta-analyses, incluant une cartographie de 63 outils de ML
- King’s College London — Outils AI dans la synthèse des preuves
- Elicit — Revues systématiques de littérature : sélection, extraction, audit PRISMA, revues vivantes et résultats de validation
- Elicit — Présentation du produit et de la tarification, incluant la taille du corpus et la base de chercheurs
- Consensus — Moteur de recherche académique AI, taille du corpus, Deep Search et mode Medical
- Paperguide — Consensus face à NotebookLM : découverte de preuves contre transformation de sources (2026)
- Gemini Notebook, anciennement NotebookLM — Carnets ancrés dans les sources, citations au niveau des extraits et politique d’utilisation des données
- DistillerSR — Directives PRISMA et écueils qui compromettent les revues systématiques
- medRxiv — Exactitude et efficacité de l’extraction de données assistée par AI avec Elicit par rapport à l’extraction humaine seule (2026)
- Wiley / Cochrane Evidence Synthesis and Methods — Outils AI comme seconds évaluateurs pour l’extraction de données
- Birmingham City University — Performances de l’AI générative dans l’extraction de données pour les revues de littérature
- PubMed Central — Explication et élaboration de PRISMA 2020
- EQUATOR Network — Fiche de la directive de rapport PRISMA 2020