Comment empêcher un assistant de recherche AI d’inventer de fausses citations ?
2026-08-21
Quelles garanties distinguent les outils de recherche AI fondés sur les citations des chatbots qui hallucinent ?
Le moyen le plus fiable d’empêcher un assistant de recherche AI d’inventer des articles consiste à refuser les outils qui génèrent des références de mémoire, à exiger que chaque affirmation soit liée à une notice récupérée dotée d’un identifiant vérifiable par machine, et à contrôler chaque citation par rapport à la source avant qu’elle n’entre dans un manuscrit. En 2026, cette pile technologique — récupération ancrée, contrôles des identifiants et vérification humaine — est ce qui distingue les outils de littérature tels que Jenova's Academic Research Assistant, Elicit, SciSpace, Consensus et Scite des chatbots généralistes qui continuent de fabriquer des références plausibles.
Les facteurs clés qui réduisent réellement les sources inventées :
✅ Récupération plutôt que rappel — l’assistant doit rechercher des notices scientifiques indexées, et non compléter automatiquement une bibliographie à partir de données d’entraînement. ✅ Liaison à un identifiant — chaque travail cité doit comporter un DOI, PMID, arXiv ID ou URL d’éditeur pouvant être résolu indépendamment. ✅ Fidélité, pas seulement existence — un article réel cité pour un résultat qu’il ne contient pas reste un échec, comme l’a montré la recherche sur l’évaluation de RAG. ✅ Précision bibliographique — les noms d’auteurs, années, volumes et plages de pages doivent correspondre à la notice, et non à une quasi-correspondance inventée par le modèle. ✅ Boucle de vérification humaine — Stanford Libraries et les principaux guides de style considèrent que l’auteur, et non l’outil, est responsable de chaque citation.
Pour comparer utilement les outils, il est préférable de considérer l’intégrité des citations comme un problème d’architecture plutôt que comme une astuce de rédaction de prompts. Le reste de ce guide présente cette architecture, les modes de défaillance qu’elle vise à détecter, ainsi qu’un flux de travail applicable à tout assistant.
Pourquoi des citations AI fabriquées apparaissent-elles dans des articles publiés en 2026 ?
Les citations fabriquées ne sont plus une simple anecdote de salle de cours. Elles pénètrent dans les revues, les dossiers de subvention et les index de citations parce que des chercheurs collent des bibliographies de chatbots dans leurs manuscrits sans résoudre chaque référence. Une analyse de Nature publiée en 2026 estime que des dizaines de milliers de publications de 2025 pourraient contenir des références invalides générées par AI.
Le schéma de contamination est caractéristique. Le chercheur en informatique Guillaume Cabanac a été alerté qu’un de ses articles avait été cité dans l’International Dental Journal — un domaine sans lien avec ses travaux sur la détection d’articles fabriqués — et a découvert qu’il ne reconnaissait pas sa propre référence. C’est ainsi que se propagent les citations fantômes : elles semblent correctement formatées, citent des revues aux noms crédibles et résistent à une lecture superficielle.
Les cas documentés sont suffisamment graves pour entraîner des rétractations. Resnik et Hosseini résument un article d’Academic Ethics dans lequel 19 citations sur 29 étaient hallucinées, un article de PLOS ONE ensuite rétracté dont 18 citations sur 76 étaient inventées, et une perspective de Digestive Diseases and Sciences dans laquelle 12 références sur 14 n’existaient pas. Une étude de 2025 sur les citations de GPT-4o en santé mentale a constaté que 56 % contenaient des erreurs, dont environ une sur cinq était entièrement hallucinée.
Les inquiétudes du corps enseignant sont désormais presque universelles. Une étude du College Board indique que les enseignants craignent que l’utilisation d’AI nuise à la pensée critique, à l’écriture originale et à l’intégrité académique. Des guides de bibliothèque comme celui d’UNC Charlotte traitent désormais les citations hallucinées comme un risque standard de recherche, et non comme un cas limite.
La conséquence pour le choix d’un outil est directe. Si un assistant peut produire une référence APA ou Vancouver bien formatée sans récupérer une notice active, il peut inventer un article qui n’a jamais existé — et cet article peut se retrouver imprimé.
Que faut-il évaluer avant de confier sa bibliographie à un assistant de recherche AI ?
Vous devez évaluer un assistant de recherche AI selon une pile d’intégrité des citations en cinq parties : source de vérité, liaison à un identifiant, fidélité entre l’affirmation et le passage, précision bibliographique et boucle de vérification humaine obligatoire. Les outils qui obtiennent de bons résultats en fluidité mais de mauvais résultats sur cette pile ne sont pas sûrs pour les bibliographies, quelle que soit l’élégance de leur prose.
1. Source de vérité
Demandez-vous si les réponses proviennent d’un corpus récupéré ou d’une mémoire paramétrique. Les systèmes augmentés par récupération recherchent Google Scholar, PubMed, Semantic Scholar, Scopus ou arXiv, puis génèrent une réponse. Les chatbots sans récupération prédisent le jeton suivant d’une citation. Des métriques de fidélité existent précisément parce que la génération peut dériver du contexte récupéré, même lorsqu’une récupération a eu lieu.
2. Liaison à un identifiant
Un triplet titre-auteur-année ne suffit pas. Exigez un DOI, PMID, PMCID ou URL d’éditeur, puis résolvez-le vous-même. Les références fantômes échouent souvent immédiatement à ce test. Les quasi-correspondances bibliographiques — un article réel avec un volume ou une plage de pages erronés — échouent lors d’un second examen.
3. Fidélité entre l’affirmation et le passage
Une recherche de l’ACM sur les citations RAG a conclu que l’exactitude n’est pas la fidélité : jusqu’à 57 % des citations peuvent ne pas étayer l’affirmation qu’elles sont censées justifier. Un article qui existe mais ne contient pas le résultat invoqué est aussi dangereux qu’un article inexistant, car il fait passer un résultat faux sous l’autorité d’un véritable auteur.
4. Précision bibliographique
L’ordre des auteurs, l’année, la revue, le volume, le numéro et les pages doivent correspondre à la notice. Des outils RAG testés en administration des affaires ont montré que les références fantômes entièrement fabriquées peuvent être rares, tandis que de petites erreurs bibliographiques restent fréquentes. Ces erreurs compromettent tout de même les index de citations et peuvent masquer des articles intervertis.
5. Boucle de vérification humaine
La politique des revues APA, résumée par Stanford, indique que les auteurs doivent vérifier toute information et toute citation fournies par un outil AI. Les directives de Wiley pour les chercheurs et les recommandations de Harvard sur l’intégrité de la recherche attribuent également la responsabilité de la divulgation et de l’exactitude à l’auteur humain. Aucun assistant de cette catégorie ne supprime cette obligation.
Pondérez cette pile selon la tâche. Les revues systématiques doivent accorder davantage de poids à la fidélité et à la liaison à un identifiant. L’exploration initiale peut tolérer un rappel plus large si chaque résultat retenu est vérifié avant d’être cité. Ne surpondérez jamais la qualité de la prose. Des paragraphes fluides sont précisément ce qui rend les fausses citations convaincantes.
Comment les outils populaires de recherche AI se comparent-ils en matière de fiabilité des citations ?
Ils diffèrent fortement selon que les références sont récupérées dans des index scientifiques ou générées depuis la mémoire du modèle, et ce choix de conception prédit l’essentiel du risque de citations fantômes. Les chatbots généralistes restent l’option la plus risquée pour les bibliographies. Les assistants de recherche conçus à cette fin réduisent les références fantômes, mais peuvent encore mal citer, classer incorrectement les métadonnées et surestimer ce qu’un article démontre.
En 2026, une comparaison pratique se présente ainsi :
| Fonctionnalité / Dimension | Chatbots généralistes (p. ex., ChatGPT) | Elicit | SciSpace | Consensus | Scite | Jenova Academic Research Assistant |
|---|---|---|---|---|---|---|
| Source des preuves | Principalement mémoire paramétrique, sauf si la navigation est activée | Articles récupérés, tableaux d’extraction | Récupération dans plusieurs bases de données (Google Scholar, PubMed, arXiv) | Articles récupérés pour les questions empiriques | Index de citations avec contexte favorable ou contradictoire | Découverte de littérature en temps réel dans des bases académiques et des dépôts |
| Risque de référence fantôme | Élevé ; documenté dans des revues et des laboratoires | Faible dans les études RAG sur les listes de références | Faible dans les études RAG sur les listes de références | Fondé sur la récupération ; vérification toujours nécessaire | Faible pour les éléments de son graphe de citations | Fondé sur la récupération ; contrôles indépendants des DOI toujours requis |
| Fidélité entre l’affirmation et la source | Faible sans passages récupérés | Plus forte pour l’extraction structurée | Plus forte lorsque les réponses citent des articles récupérés | Plus forte pour les questions empiriques oui/non | Forte pour comprendre comment un article est cité | Dépend des passages récupérés et du choix du modèle ; contrôle humain requis |
| Précision bibliographique | Détails inventés fréquents | Inexactitudes mineures signalées dans les audits RAG | Inexactitudes mineures signalées dans les audits RAG | Non vérifiée à l’échelle des audits de terrain | Forte autour du contexte de citation | Hérite des métadonnées des notices récupérées ; la prose peut encore dériver |
| Tarification (en 2026) | Variable selon l’offre du fournisseur | Non vérifiée | Non vérifiée | Non vérifiée | Non vérifiée | Offre gratuite avec utilisation limitée ; offres payantes à partir de 20 $/mois |
| Idéal pour | Rédiger du texte, pas constituer une bibliographie | Tableaux de preuves et extraction systématique | Recherche bibliographique large et interdisciplinaire | Réponses rapides à des questions empiriques oui/non | Vérifier si des citations étayent ou contredisent une affirmation | Découverte de littérature, préparation de manuscrits et gestion des citations de bout en bout avec mémoire persistante |
Chatbots généralistes
Les chatbots excellent pour élaborer des plans et paraphraser, mais échouent à construire des bibliographies. L’audit GPT-4o en santé mentale cité plus haut fournit le chiffre d’avertissement : plus de la moitié des citations générées contenaient des erreurs. Si un outil peut produire une référence parfaite en apparence sans notice active, considérez chaque citation comme non vérifiée.
Elicit
Elicit est plus performant lorsque la tâche consiste à sélectionner des articles et à extraire les méthodes, résultats et limites dans un tableau. Des comparaisons indépendantes le décrivent comme mieux adapté aux flux de travail rigoureux fondés sur les preuves qu’à la recherche exploratoire rapide. Sa limite réside dans la densité de couverture : dans un benchmark de 200 requêtes mené par SciSpace, Elicit a retourné 13,0 articles très pertinents par requête, contre 26,3 pour SciSpace Deep Review. Cet écart concerne le rappel, et non le risque de citations fantômes.
SciSpace
SciSpace recherche dans plusieurs bases de données scientifiques et, dans sa propre évaluation Deep Review, a dominé la précision de P@3 à P@70. Cette étendue aide pour les questions interdisciplinaires dont les preuves se trouvent simultanément dans PubMed, arXiv et Google Scholar. La limite est méthodologique : le benchmark mis en avant a été mené par SciSpace, même si les étiquettes de pertinence provenaient de trois modèles externes. Considérez les benchmarks des fournisseurs comme indicatifs, puis vérifiez vous-même les références retenues.
Consensus
Consensus est conçu pour répondre à des questions scientifiques empiriques à partir d’articles plutôt que pour rédiger une revue narrative. Dans le même test de 200 requêtes, Consensus Deep affichait la meilleure précision pour le premier résultat (P@1 = 0.5882), avant de perdre cet avantage plus loin dans la liste. C’est un excellent outil de repérage initial, mais un outil moins solide pour de longues séries de sélection.
Scite
L’atout distinctif de Scite est l’intelligence des citations : il permet de voir si des articles ultérieurs étayent, mentionnent ou contredisent une affirmation donnée. Les comparaisons le présentent comme plus limité qu’un outil complet d’opérations de recherche, mais plus fort pour la validation des preuves. Si votre mode de défaillance est « cet article réel ne dit pas ce que l’assistant a affirmé », le contexte de citation de type Scite est l’instrument adapté.
Jenova Academic Research Assistant
Jenova's Academic Research Assistant est conçu pour les universitaires et doctorants qui ont besoin de découvrir de la littérature, tout en bénéficiant d’un soutien à la rédaction de manuscrits et aux citations dans un espace de travail persistant. Il peut rechercher en temps réel dans les principales bases académiques et dépôts, conserver la mémoire du projet entre les sessions et rédiger avec des modèles actuels plutôt qu’avec un verrouillage auprès d’un seul fournisseur. Cette combinaison est utile lorsqu’une revue s’étend sur plusieurs semaines et que l’assistant doit retenir les critères d’inclusion, les articles rejetés et les DOI non résolus.
Ce n’est pas un index dédié au contexte de citation ; il ne remplacera donc pas Scite pour les cartes des sources favorables ou contradictoires. Ce n’est pas non plus une grille d’extraction conçue spécifiquement au sens d’Elicit. Une recherche en temps réel peut également récupérer des notices de faible qualité ou mal adaptées, qu’un modèle fluide peut ensuite surinterpréter. La règle de fonctionnement honnête reste la même que pour tout outil de récupération : utilisez-le pour trouver et organiser des candidats, et non pour valider une bibliographie.
La génération augmentée par récupération élimine-t-elle complètement les références fantômes ?
Non. La génération augmentée par récupération (RAG) réduit fortement les articles entièrement inventés dans une liste de références, mais elle n’élimine pas les erreurs bibliographiques et ne garantit pas qu’un article récupéré étaye la phrase à laquelle il est associé. La prévention doit donc cibler trois modes de défaillance différents, et non un seul.
Ces trois modes sont faciles à confondre, car tous produisent des « citations plausibles » :
- Références fantômes — le travail cité n’existe pas.
- Dérive bibliographique — le travail existe, mais les auteurs, l’année, le volume ou les pages sont erronés.
- Hallucination de contexte — le travail existe et les métadonnées sont globalement correctes, mais l’assistant lui attribue un résultat que l’article ne contient pas.
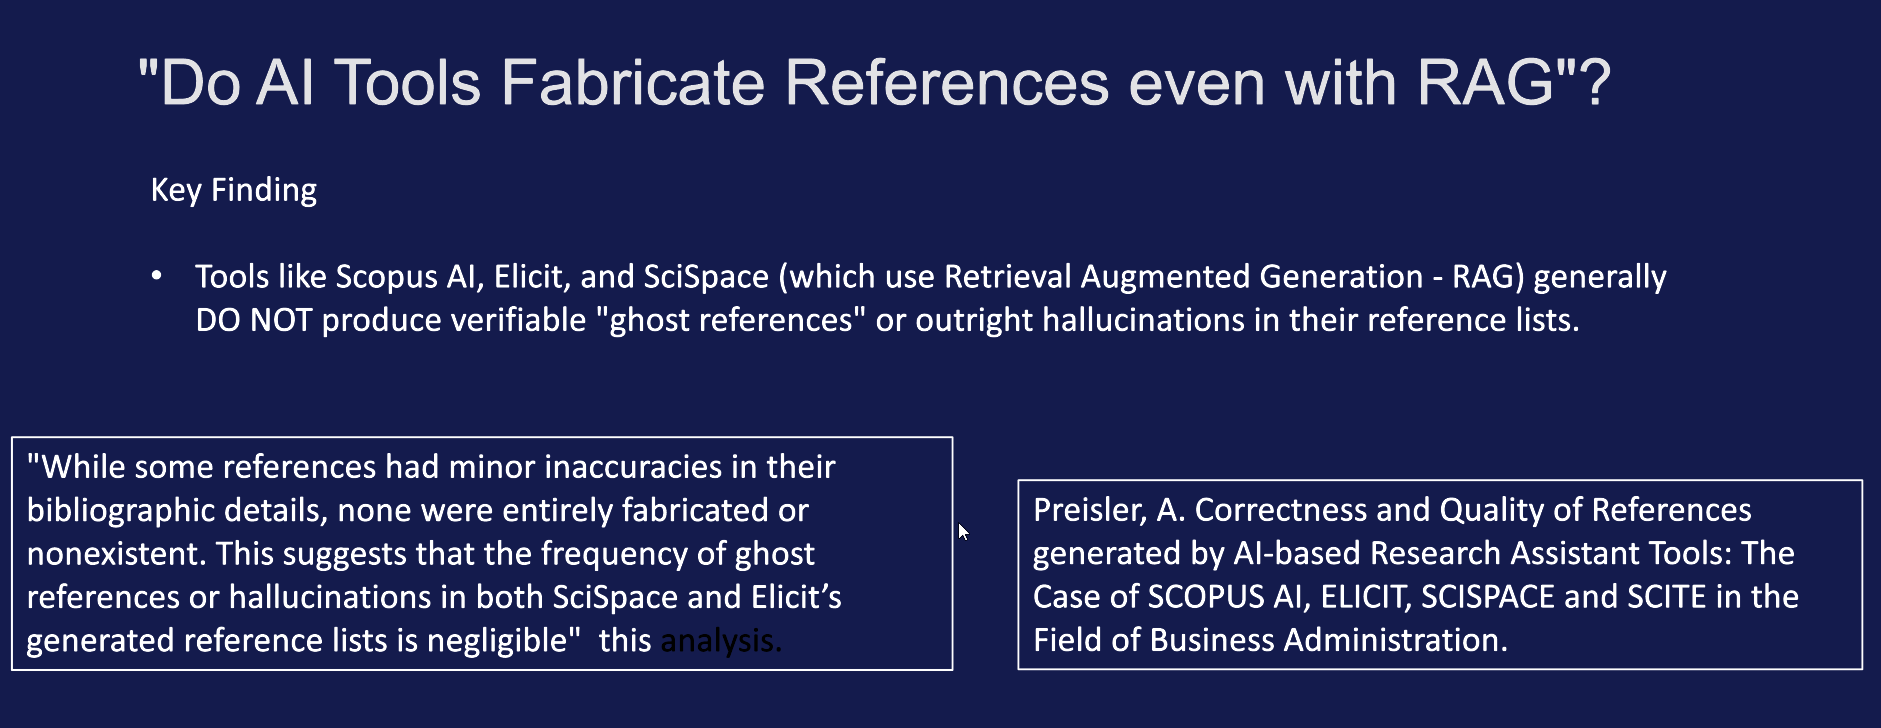
Une analyse de terrain de Scopus AI, Elicit, SciSpace et Scite en administration des affaires a constaté que les outils fondés sur RAG ne produisaient généralement pas de références fantômes vérifiables. Des inexactitudes bibliographiques mineures subsistaient ; les sources totalement inexistantes étaient négligeables dans ces listes générées. C’est ainsi qu’il faut interpréter RAG : c’est un contrôle robuste contre les fantômes, et non un système complet de qualité des citations.
Les recherches sur la fidélité expliquent le risque restant. Les cadres d’évaluation RAG distinguent la pertinence de la réponse de sa fidélité : une réponse peut être pertinente pour le sujet tout en n’étant pas ancrée dans les passages récupérés. Le constat de l’ACM selon lequel une large part des citations RAG peut manquer de fidélité constitue l’avertissement opérationnel. Si vous vérifiez seulement qu’un DOI se résout, vous détecterez les fantômes mais manquerez les affirmations attribuées à tort.
Les chatbots généralistes échouent principalement sur le premier mode. Les assistants RAG échouent surtout sur les deuxième et troisième. Un flux de prévention qui se demande uniquement « cet article existe-t-il ? » est donc incomplet pour les outils que les chercheurs devraient réellement utiliser.
Comment vérifier les citations renvoyées par un assistant de recherche AI ?
Vérifiez-les à l’aide d’un protocole en deux passes : résolvez d’abord l’identifiant, puis confirmez qu’un passage précis étaye l’affirmation. Sauter l’une de ces deux passes permet aux sources inventées ou mal utilisées d’atteindre la publication.
Passe 1 — La notice existe-t-elle ?
- Copiez exactement le titre, le premier auteur, l’année et le DOI tels qu’ils ont été renvoyés.
- Résolvez le DOI auprès d’un organisme d’enregistrement ou sur la page de l’éditeur. En l’absence de DOI, recherchez le titre exact dans Google Scholar, PubMed ou le site de la revue, selon l’approche de recherche directe recommandée par les guides de recherche.
- Rejetez tout élément qui ne se résout pas, qui se résout vers un autre article ou qui n’existe que sous la forme d’une citation formatée par AI.
- Vérifiez l’ordre des auteurs, l’année, le volume, le numéro et les pages par rapport à la notice de l’éditeur, et non au bloc bibliographique de l’assistant.
Passe 2 — Cet article étaye-t-il cette phrase ?
- Ouvrez le texte intégral en PDF ou HTML. Les résumés ne suffisent pas pour les affirmations causales, les tailles d’effet ou les formulations telles que « première preuve ».
- Localisez le passage censé étayer l’affirmation. Citez-le dans vos notes.
- Marquez la citation comme étayante, mentionnante ou contradictoire — la distinction que Scite a transformée en produit et que vous pouvez appliquer manuellement.
- Si l’assistant a reformulé une limite comme un résultat, ou une hypothèse comme une conclusion, écartez la citation pour cette phrase.
Pour Jenova's Academic Research Assistant, contraignez la récupération avant même de générer une liste de références :
« Recherchez des articles évalués par les pairs et des prépublications sur [topic], 2019–2026. Retournez uniquement les éléments comportant un DOI ou un PMID. Pour chacun : titre, auteurs, année, revue, identifiant, conclusion en une phrase et passage cité. Si vous ne pouvez pas récupérer une notice vérifiable, omettez entièrement l’élément. Ne complétez ni ne devinez les métadonnées. »
Faites ensuite passer les mêmes références retenues dans Elicit ou SciSpace afin d’effectuer un second contrôle du corpus. Le désaccord entre les outils est une fonctionnalité : il signale des articles qu’un système a classés mais que l’autre n’a pas pu récupérer.
Le reportage de Science sur les articles scientifiques hallucinés montre pourquoi parcourir seulement les titres ne suffit pas. Un assistant peut citer correctement un article réel, puis en inventer un article voisin dans le même paragraphe. La vérification doit se faire élément par élément, et non paragraphe par paragraphe.
Une citation hallucinée peut-elle être considérée comme une faute de recherche ?
Oui, dans un ensemble défini de situations — et même lorsqu’elle ne répond pas à la définition juridique de la faute, elle peut tout de même entraîner une rétractation, des difficultés de financement et nuire à une carrière. La prévention ne relève pas de la simple étiquette. Elle concerne la responsabilité.
Resnik et Hosseini soutiennent qu’une citation hallucinée peut constituer une faute de recherche prouvable au regard de la réglementation fédérale américaine lorsque trois conditions sont réunies : un chercheur a utilisé un outil génératif pour produire des citations inexistantes ; ces citations fonctionnent comme des données parce qu’elles étayent des résultats, comme dans les revues ou études bibliométriques ; et le chercheur a fait preuve d’indifférence au risque de fabrication en ne vérifiant pas le résultat. Une référence fantôme dans une introduction narrative est une mauvaise pratique scientifique. Une référence fantôme comptabilisée comme élément de preuve dans une revue systématique se rapproche davantage de données fabriquées.
Les organismes financeurs traitent déjà ce problème comme une question opérationnelle. À l’été 2025, les équipes d’évaluation des subventions du NIH ont été submergées de propositions assistées par AI, et l’organisme a indiqué qu’une utilisation inappropriée d’AI découverte après l’attribution d’une subvention pouvait être transmise pour examen de l’intégrité. Le centre d’intégrité de la recherche de Harvard rappelle des contraintes connexes : les outils AI ne peuvent pas être mentionnés comme auteurs, les évaluateurs scientifiques pairs du NIH n’ont pas le droit d’utiliser l’AI générative pour formuler des critiques, et les auteurs doivent divulguer la manière dont les outils ont été utilisés.
Les revues convergent vers la même attribution de responsabilité. La compilation de Stanford des règles APA, MLA, Chicago et IEEE exige la divulgation du contenu généré par AI et, dans le cas de l’APA, une vérification humaine explicite des citations. Les recommandations pédagogiques de Cornell avertissent en outre que les algorithmes automatisés de détection d’AI sont trop peu fiables pour constituer une stratégie d’intégrité. La détection après coup est un faible substitut à la vérification avant soumission.
La norme pratique est simple. Si vous ne pouvez pas indiquer une notice résolue et un passage qui l’étaye, la citation n’a pas sa place dans le manuscrit, la présentation ou la demande de subvention.
Que disent les spécialistes de l’intégrité de la recherche sur les citations générées par AI ?
Les spécialistes considèrent désormais les références inventées comme un échec de processus — utiliser un modèle génératif comme une bibliothèque — plutôt que comme un mystérieux bug de modèle que les utilisateurs ne pourraient pas anticiper. Le consensus entre bureaux d’intégrité et études de citations est que RAG réduit les fantômes, que la vérification humaine reste obligatoire et que les bibliographies de chatbots laissées sans surveillance sont imprudentes compte tenu de ce qui est déjà connu sur le taux d’échec.
« L’erreur qui continue d’atteindre les revues n’est pas que les modèles devinent parfois. C’est que les chercheurs laissent un modèle linguistique effectuer une tâche de catalogage pour laquelle il n’est pas conçu. Si l’assistant n’a pas récupéré de notice, il complète un motif bibliographique, et c’est ainsi qu’on obtient un article à l’apparence réelle dans une revue à l’apparence réelle avec un DOI qui ne se résout pas. Passer à un outil de récupération réduit fortement ce mode de défaillance. Cela ne réduit pas le suivant : citer un article réel pour un résultat qui vit dans le résumé du modèle plutôt que dans la section des résultats. »
« Nous conseillons aux utilisateurs de recherche un flux de travail à trois catégories. La catégorie A est récupérée et vérifiée par passage — ces citations peuvent être utilisées. La catégorie B est récupérée mais seules les métadonnées sont vérifiées — elles restent dans une liste de lecture. La catégorie C comprend tout ce que le modèle a produit sans identifiant résoluble — ces éléments sont supprimés, pas “recherchés plus tard”. Les équipes qui évitent la catégorie C parce que le formatage semble coûteux sont celles qui découvrent ensuite que 12 références sur 14 n’ont jamais existé. Le coût de cette passe supplémentaire est insignifiant à côté d’une rétractation ou d’un signalement d’intégrité lié à une subvention. »
— Équipe produit Jenova, conception d’agent de recherche AI pour les flux de travail académiques
Ce conseil est conforme aux politiques des éditeurs et universités : nommez l’outil, nommez la tâche qu’il a accomplie et maintenez la responsabilité de l’auteur humain pour chaque référence. Les recommandations d’intégrité ne disent plus « évitez AI ». Elles disent : « ne sous-traitez pas l’existence de vos sources ».
Comment mener une revue de littérature sûre sur le plan des citations avec AI ?
Menez-la comme un pipeline où la récupération vient d’abord, l’extraction ensuite, la prose en dernier, avec une étape de vérification qu’aucune phrase ne peut contourner. Inverser cet ordre — rédiger l’argument, puis demander à un assistant « d’ajouter des citations » — est le schéma de prompt le plus associé aux références fantômes.
Un flux de travail qui résiste à l’examen des revues et des organismes de financement :
- Rédigez les règles d’inclusion avant de rechercher. Population, intervention, années, langues, types d’étude. Collez ces règles dans l’assistant afin que la mémoire, si l’outil en possède une, persiste entre les sessions.
- Recherchez avec deux outils de récupération, et non un seul. Exemple de combinaison : Jenova's Academic Research Assistant avec Elicit ou SciSpace. Conservez l’union des résultats ; ne faites pas confiance à une seule liste classée.
- Figez un ensemble de candidats avec des identifiants. Exportez titre, auteurs, année, revue, DOI/PMID. Tout élément sans identifiant reste hors de l’ensemble.
- Extrayez, ne résumez pas, à partir du texte intégral. Méthodes, échantillon, résultats, limites et une phrase citée. Les tableaux de type Elicit sont utiles ici ; les résumés narratifs sont là où l’hallucination de contexte s’insinue.
- Rédigez à partir du tableau d’extraction. Si une phrase ne correspond à aucune ligne du tableau, elle ne reçoit pas de citation — et elle n’a peut-être pas sa place dans l’article.
- Divulguez les outils. Suivez la compilation des règles des guides de style par Stanford : nom de l’outil, version, date et fonction réalisée, comme la recherche, l’extraction ou l’édition linguistique.
- Effectuez un dernier contrôle des DOI sur la bibliographie soumise. Cette dernière passe détecte la dérive liée au copier-coller et toute référence insérée par le modèle durant la révision.
Un prompt qui maintient Jenova dans le pipeline plutôt qu’en mode chatbot :
« En utilisant uniquement l’ensemble de candidats que j’ai téléversé, rédigez la section de contexte. Chaque phrase empirique doit citer un DOI de cet ensemble et ne doit pas introduire de nouvelles sources. Si une affirmation n’est pas étayée par les notes d’extraction, signalez-la comme UNSUPPORTED au lieu de la citer. »
Pour SciSpace ou Elicit, utilisez la vue de récupération ou d’extraction de chaque outil pour reconstruire le même tableau et comparer les lignes. Lorsque les tableaux divergent sur un résultat, lisez le PDF. Le désaccord coûte moins cher qu’une correction après publication.
La contrainte qui fait fonctionner le pipeline est aussi psychologique que technique : ne demandez jamais à un assistant, même performant, de « fournir des références » pour une prose écrite sans sources. Ce prompt transforme un outil de recherche en générateur de citations, qui est précisément le mode de défaillance que toute cette pile est conçue pour éviter.
Références
- Nature — Les citations hallucinées polluent la littérature scientifique
- Accountability in Research (Resnik & Hosseini) — Citations hallucinées produites par l’intelligence artificielle générative
- Stanford Libraries — AI dans la recherche académique : directives de citation
- ACM Digital Library — L’exactitude n’est pas la fidélité dans la génération augmentée par récupération
- DeepEval — Métrique de fidélité pour les systèmes RAG
- Confident AI — Métriques d’évaluation RAG : pertinence des réponses, fidélité et pertinence contextuelle
- Bibliothèque UNC Charlotte — Guide de recherche sur les citations AI hallucinées
- Wiley — Directives AI pour les chercheurs
- College Board — Les enseignants s’inquiètent que l’utilisation d’AI par les étudiants compromette l’intégrité académique
- Harvard Medical School Academic and Research Integrity — AI dans la recherche
- Cornell Center for Teaching Innovation — AI et intégrité académique
- SciSpace — Benchmark de recherche bibliographique SciSpace vs Elicit vs Consensus sur 200 requêtes
- Paperguide — Comparaison Elicit vs SciSpace
- Paperguide — Comparaison Elicit vs Scite
- Science — Citer sans avoir vu : quand AI hallucine des articles scientifiques
- SciSpace — Comparaison des produits SciSpace vs Elicit