Comment un assistant de recherche AI peut-il cartographier les lacunes probantes d’un nouveau sujet ?
2026-08-22
Qu’est-ce qui distingue un flux de travail traçable de recherche-filtrage-cartographie des synthèses génériques de la littérature ?
Un assistant de recherche AI fiable ne commence pas par résumer les articles qu’il parvient à trouver. Il construit une stratégie de recherche reproductible, filtre un ensemble délimité d’études selon des critères explicites, puis cartographie ce que ces études couvrent — et ne couvrent pas — afin que les cellules vides correspondent à des lacunes probantes plutôt qu’à des artefacts de recherche. En 2026, cette distinction est importante, car des synthèses génériques produites par chat peuvent sembler exhaustives tout en inventant des citations ou en fusionnant des conceptions d’étude incompatibles dans une même affirmation.
Pour un nouveau sujet, l’unité de travail pratique est souvent un ensemble central de 50 articles : suffisamment vaste pour révéler des regroupements, mais assez restreint pour qu’un chercheur puisse encore vérifier chaque décision d’inclusion ou d’exclusion. Les outils qui soutiennent ce flux de travail comprennent Jenova's Academic Research Assistant, le flux de travail de revue systématique d’Elicit, Rayyan et des outils de cartographie des réseaux de citations tels que ResearchRabbit.
Ce qui sépare un processus de recherche-filtrage-cartographie citable d’un inventaire de littérature jetable :
✅ Requêtes traçables — les chaînes booléennes, les bases de données, les fenêtres temporelles et les synonymes sont consignés avant le début du filtrage
✅ Filtrage auditable — chaque article reçoit une étiquette d’inclusion, d’exclusion ou d’incertitude associée à un critère explicite
✅ Données extraites, non paraphrasées — les résultats, méthodes et limites restent rattachés à une source vérifiable
✅ Cartes multidimensionnelles des lacunes — les cellules vides sont codées par population, méthode, géographie et résultat, et non à l’intuition
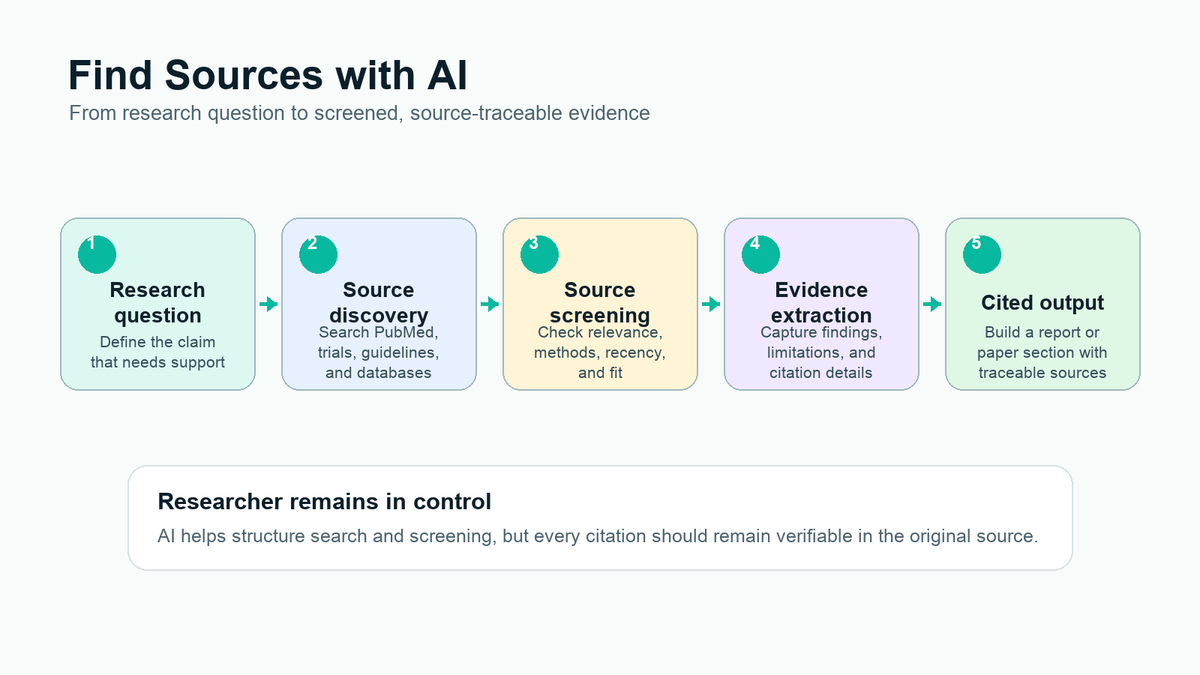
✅ Vérification humaine — l’AI prépare la carte ; le chercheur confirme que chaque citation existe dans l’article original
Pour comparer les assistants de manière pertinente, il est utile de considérer la recherche, le filtrage et la cartographie des lacunes comme trois tâches aux modes de défaillance distincts, plutôt que comme une unique fonctionnalité de « revue de littérature ».
Pourquoi les cartes des lacunes probantes deviennent-elles indispensables pour les nouveaux sujets de recherche ?
Les cartes des données probantes et des lacunes sont devenues un moyen standard de voir, en un coup d’œil, où un domaine est dense et où il est silencieux avant qu’un chercheur ne s’engage dans la conception d’une nouvelle étude. Une carte des données probantes et des lacunes est une présentation visuelle systématique de la disponibilité des données pertinentes pour un domaine de politique publique ou de recherche, recensées au moyen d’un protocole de recherche défini à l’avance plutôt que d’une liste de lectures ad hoc.
Cette définition, élaborée pour la Campbell Collaboration, est facile à mal utiliser. De nombreuses cartes indiquent quelles données existent, et non ce que les données concluent. Confondre les deux crée une fausse confiance : une cellule dense peut rester méthodologiquement faible, et une cellule vide peut refléter une recherche défaillante plutôt qu’une véritable inconnue.
La méthode n’est plus marginale. Une revue du secteur de la santé réalisée en 2016 a recensé 145 titres de cartographie, dont 34 publications présentant des cartes de données probantes explicites. Les revues de cartographie et les cartes des lacunes probantes sont désormais considérées comme des produits de synthèse distincts servant à naviguer dans des corpus de recherche complexes, se situant entre une revue de portée et une revue systématique complète.
Pour une personne qui aborde un nouveau sujet en 2026, la pression est concrète. Elicit indique que les revues systématiques commencent souvent avec jusqu’à 20 000 dossiers et sont réduites à 30–100 articles inclus, un processus qui peut prendre de trois mois à plus d’un an manuellement. Un filtrage de 50 articles ne remplace pas cette procédure de référence. C’est le bon premier instrument lorsque l’objectif consiste à décider si une revue systématique, une étude primaire ou une question plus restreinte est justifiée.
L’AI accélère la première passe. Elle ne supprime pas les obligations de déclaration prévues par PRISMA 2020, qui exige toujours des méthodes transparentes d’identification, de sélection et d’extraction.
Que faut-il rechercher dans un assistant de recherche AI pour le filtrage de la littérature ?
Vous devez évaluer un assistant de recherche AI selon sa capacité à maintenir une stratégie de recherche reproductible, une décision de filtrage contrôlable et une affirmation de lacune réfutable — non selon la fluidité avec laquelle il rédige une revue de littérature. La liste de contrôle TRACE-GAP ci-dessous constitue le cadre utilisé dans cet article.
Dimensions d’évaluation TRACE-GAP
- T — Requêtes traçables. L’outil peut-il produire les bases de données exactes, les chaînes de recherche, les limites et la période qu’un autre chercheur pourrait réexécuter ?
- R — Critères de pertinence. Les règles d’inclusion et d’exclusion peuvent-elles être définies avant l’évaluation de tout article ?
- A — Filtrage auditable. Chaque décision comporte-t-elle une justification, plutôt qu’un simple oui/non ?
- C — Extraction au niveau de la citation. Les résultats sont-ils rattachés à un passage ou au moins à un article précis, plutôt qu’à une synthèse fusionnée ?
- E — Codage de la force probante. La conception de l’étude, l’échantillon et les limites peuvent-ils être enregistrés à côté du résultat ?
- G — Dimensions des lacunes. La carte peut-elle utiliser au moins deux axes, généralement intervention × résultat ou population × méthode ?
- A — Validation inter-regroupements. Le flux de travail impose-t-il un second examen avant qu’une cellule vide ne soit qualifiée de lacune ?
- P — Questions hiérarchisées. Le résultat transforme-t-il les lacunes validées en questions de recherche, plutôt qu’en carte thermique décorative ?
Un benchmark de guide d’achat de 2026 évaluant les assistants selon l’ancrage de leurs citations a constaté que les liens vers les sources au niveau du paragraphe produisaient le plus faible ratio hallucinations-vérification, avec Atlas à 0,05, Elicit à 0,07, Consensus à 0,09 et SciSpace à 0,16. La même revue a considéré ResearchRabbit comme un outil de cartographie de réseau plutôt que comme un générateur de réponses, ce qui est la bonne catégorie pour l’expansion à partir d’articles de départ.
Deux autres tests sont importants pour un usage universitaire. Premièrement, PRISMA 2020 exige toujours que les auteurs vérifient les valeurs extraites ; tout outil qui masque la citation justificative échoue à ce test. Deuxièmement, les citations hallucinées ont atteint les brouillons d’experts et les chaînes de publication scientifique, de sorte que « cela semble académique » n’est pas un critère d’acceptation.
Jenova's Academic Research Assistant est particulièrement performant pour l’élaboration de stratégies, la découverte multi-bases de données, la mémoire persistante de projet et la rédaction tenant compte des citations. Il est moins performant comme plateforme dédiée au double filtrage : il ne génère pas de diagramme de flux PRISMA et ne gère pas la résolution aveugle des conflits comme le font Rayyan et Covidence.
Comment Jenova, Elicit, Rayyan et ResearchRabbit se comparent-ils pour la recherche, le filtrage et la cartographie des lacunes ?
Jenova est le plus performant comme partenaire de stratégie et de synthèse, Elicit comme moteur d’extraction structurée, Rayyan comme poste de filtrage à haut volume et ResearchRabbit comme explorateur de réseaux de citations — et aucun ne devrait être utilisé comme système fermé unique pour un nouveau sujet. La comparaison utile consiste à déterminer quelle tâche chaque outil doit prendre en charge.
| Fonctionnalité / Dimension | Jenova Academic Research Assistant | Elicit | Rayyan | ResearchRabbit / Scite |
|---|---|---|---|---|
| Soutien à la stratégie de recherche | Élaboration conversationnelle de PICO/chaînes booléennes avec Scholar et recherche web ; mémoire persistante de projet | Recherche sémantique dans plus de 125 M d’articles ; suggère des champs de filtrage à partir de la question | Importe les exportations traditionnelles des bases de données ; n’est pas principalement un concepteur de recherche | ResearchRabbit élargit à partir d’articles de départ ; Scite vérifie ensuite la position des citations |
| Filtrage d’environ 50 articles | Tableaux d’inclusion/exclusion fondés sur des critères dans le chat, avec motifs et limites | Filtrage classé et lignes d’extraction étayées par des citations | Conçu spécifiquement pour le filtrage des titres/résumés, la déduplication et les flux de travail d’équipe | Faible comme outil de filtrage ; fort comme outil de recherche d’articles liés ou d’audit des citations |
| Cartographie des lacunes probantes | Codage des regroupements, validation des cellules vides et traduction en questions de recherche | Bons tableaux d’extraction pour construire ensuite une carte | Le journal de filtrage soutient les cartes ; la cartographie elle-même est surtout réalisée en aval | Les cartes de réseau révèlent des liens manquants, et non des lacunes probantes validées |
| Ancrage des citations | Réponses multi-modèles avec prompts donnant priorité aux sources ; vérification humaine toujours requise | Citations au niveau de l’article pour les champs extraits | Le journal de décisions est auditable ; la synthèse n’est pas le produit | Scite signale les citations de soutien, de contradiction ou de simple mention |
| Tarification (en 2026) | Niveau gratuit avec usage limité ; Plus à partir de 20 $/mois | Pro, Team et Enterprise (prix affichés variables selon le forfait) | Gratuit à vie pour l’usage de base | ResearchRabbit gratuit ; Scite Student environ 10 $/mois, Premium environ 20 $/mois |
| Idéal pour | Stratégie pour un nouveau sujet, compréhension d’un ensemble de 50 articles et transformation des lacunes en justification d’étude | Extraction structurée sur de nombreux articles | Filtrage en équipe à l’échelle d’une revue systématique | Entrer dans un domaine à partir d’un article de départ, puis auditer les citations clés |
Rayyan indique être utilisé par plus d’un million de chercheurs dans plus de 20 000 institutions réparties dans plus de 190 pays et est conçu autour de l’auditabilité, de la reproductibilité et de la priorisation assistée par AI. Une revue comparative de logiciels publiée en 2026 présentait encore le choix comme Covidence pour la gestion institutionnelle des revues, Rayyan pour un filtrage accessible, et Elicit pour la recherche et l’extraction par AI.
La limite de Jenova concerne l’interface, non l’intention. Un filtrage de 50 articles dans un chat est contrôlable si vous imposez un tableau, mais il ne remplacera pas deux évaluateurs indépendants sur une exportation de 5 000 dossiers. La limite d’Elicit est inverse : le tableau est excellent, mais Elicit précise lui-même que les revues de qualité publication doivent toujours effectuer des recherches traditionnelles par mots-clés et traiter la recherche sémantique comme un complément. La limite de ResearchRabbit tient à son honnêteté quant à son périmètre : il cartographie ce qui est connecté, et non ce qui manque après l’évaluation de la qualité.
Pour un nouveau sujet, l’assemblage le plus productif est généralement Jenova ou Semantic Scholar pour la stratégie, Rayyan ou Elicit pour le filtrage, Scite pour la position des citations, puis Jenova de nouveau pour le récit des lacunes. L’Agent Deep Research de Jenova constitue le meilleur relais lorsque la carte de 50 articles nécessite une note plus longue et riche en citations.
Comment construire une stratégie de recherche reproductible avec un assistant de recherche AI ?
Vous construisez une stratégie de recherche reproductible en verrouillant la question, les concepts, les sources et les limites avant de demander à un modèle de trouver des articles. Le rôle de l’assistant est de révéler les synonymes manquants et les limites biaisées, non d’improviser une liste de lectures.
Commencez par un ancrage de recherche : population ou contexte, intervention ou exposition, comparateur s’il est pertinent, résultats, ainsi que les conceptions d’étude que vous accepterez. Les revues de cartographie peuvent être plus larges qu’une question PICO unique, mais elles nécessitent toujours une stratégie de recherche et un formulaire de codage définis a priori. Les guides universitaires décrivent les cartes de données probantes ou de lacunes comme un tableau principal avec des lignes, des colonnes et des filtres pour des variables précises. Ces lignes et ces colonnes doivent exister sur papier avant l’exécution de la première requête.
Un premier prompt utile dans Jenova's Academic Research Assistant ressemble à ceci :
"J’ouvre un nouveau domaine de recherche sur [sujet]. Prépare une stratégie de recherche reproductible comprenant : (1) les éléments PICO ou PECO, (2) les critères d’inclusion et d’exclusion, (3) les bases de données et sources de littérature grise, (4) les chaînes booléennes avec synonymes et vocabulaire contrôlé, et (5) une fenêtre temporelle 2019–2026. Indique les termes qui risquent de manquer et toute limite susceptible de masquer des conceptions d’étude pertinentes."
Imposez ensuite une vérification méthodologique :
"Réécris la stratégie afin qu’un autre chercheur puisse la réexécuter. Sépare les termes indispensables des synonymes optionnels. Indique où la recherche sémantique améliorerait le rappel et où seule une syntaxe exacte de base de données est acceptable."
Les bons assistants vous orienteront vers plusieurs sources. Un sujet biomédical nécessite toujours MEDLINE/PubMed ainsi qu’au moins un index complémentaire ; l’éducation et les politiques sociales nécessitent souvent ERIC, PsycINFO ou une bibliothèque spécialisée de cartes. Le guide de synthèse de l’Université de Toronto considère les revues de cartographie comme un moyen de visualiser les lacunes avant de s’engager dans une revue systématique plus ciblée.
Deux erreurs de stratégie reviennent constamment dans les tests. La première consiste à surfiltrer trop tôt par « revue » ou « RCT », ce qui efface précisément les cellules vides que vous cherchez à identifier. La seconde consiste à laisser le modèle choisir les bases de données après qu’il a déjà repéré quelques résultats faciles d’accès. Figez le protocole, puis lancez la recherche.
Jenova est utile ici parce que la conversation persiste d’une session à l’autre et peut garder en mémoire l’ancrage, les chaînes de recherche et la liste d’exclusion. Il ne remplace pas une stratégie de recherche examinée par un bibliothécaire pour une revue systématique destinée à une publication scientifique, et vous ne devez pas prétendre le contraire.
Comment filtrer environ 50 articles clés sans perdre en rigueur méthodologique ?
Vous devez filtrer 50 articles sous la forme d’un journal de décisions codé : une ligne par étude, un motif par décision, et aucun article admis parce que son résumé « semble pertinent ». Cinquante constituent un corpus de travail pour un nouveau sujet, et non l’affirmation que la littérature a été recherchée de façon exhaustive.
Empruntez la rigueur du filtrage systématique, même si vous ne rédigez pas encore une revue PRISMA. PRISMA 2020 est la directive de déclaration actuelle pour les revues qui identifient, sélectionnent et synthétisent des études. La liste de contrôle associée de 27 éléments vise à rendre ces méthodes transparentes. Votre journal de 50 articles ne satisfera pas aux exigences d’une revue systématique complète, mais il devrait pouvoir répondre aux mêmes questions fondamentales : qu’a-t-on trouvé, qu’a-t-on conservé et pourquoi ?
Un prompt de filtrage pratique :
"Filtre les 50 articles suivants selon ces critères d’inclusion et d’exclusion. Pour chaque article, renvoie : décision (
include / exclude / unsure), le critère unique qui a déterminé cette décision, la conception de l’étude, la population, le contexte, le résultat principal et une limite. Cite la phrase qui a justifié la décision. N’ajoute aucun article qui ne figure pas dans cette liste."
Effectuez ensuite vous-même une passe d’étalonnage sur les dix premiers dossiers. Si l’assistant et le chercheur divergent sur plus de deux ou trois dossiers, les critères restent imprécis. Resserrez les définitions de la population, de la conception et du résultat avant d’évaluer les quarante restants.
Rayyan est le meilleur instrument lorsque l’ensemble s’agrandit ou qu’un second évaluateur intervient. Les comparaisons indépendantes de Covidence et Rayyan considèrent depuis longtemps les deux outils comme des plateformes viables de filtrage pour les revues systématiques, avec des modèles de collaboration différents. Elicit est le meilleur instrument lorsque l’étape suivante est un tableau de données : taille de l’échantillon, direction du résultat et champs méthodologiques remplis avec des citations justificatives.
La limite honnête de Jenova est l’ergonomie des lots. Le filtrage par chat est rapide pour 50 articles soigneusement sélectionnés et maladroit pour 5 000 dossiers importés. Utilisez-le pour imposer des critères et extraire un codebook cohérent. Transférez ce même codebook dans Rayyan ou Elicit si le projet devient une revue formelle.
Ne laissez jamais le modèle « compléter » un PDF manquant. Si le texte intégral n’est pas disponible, la ligne demeure unsure, et non include. Cette seule règle évite la plupart des mises en scène de citations.
Comment transformer des articles filtrés en une carte des lacunes probantes validée ?
Vous transformez un ensemble filtré en carte des lacunes en codant chaque étude incluse selon deux dimensions ou plus, en désignant les cellules vides comme préliminaires, puis en vérifiant si ces cellules vides subsistent après une seconde recherche. Une cellule vide qui n’a pas été mise à l’épreuve est un résidu de codage, non une justification de recherche.
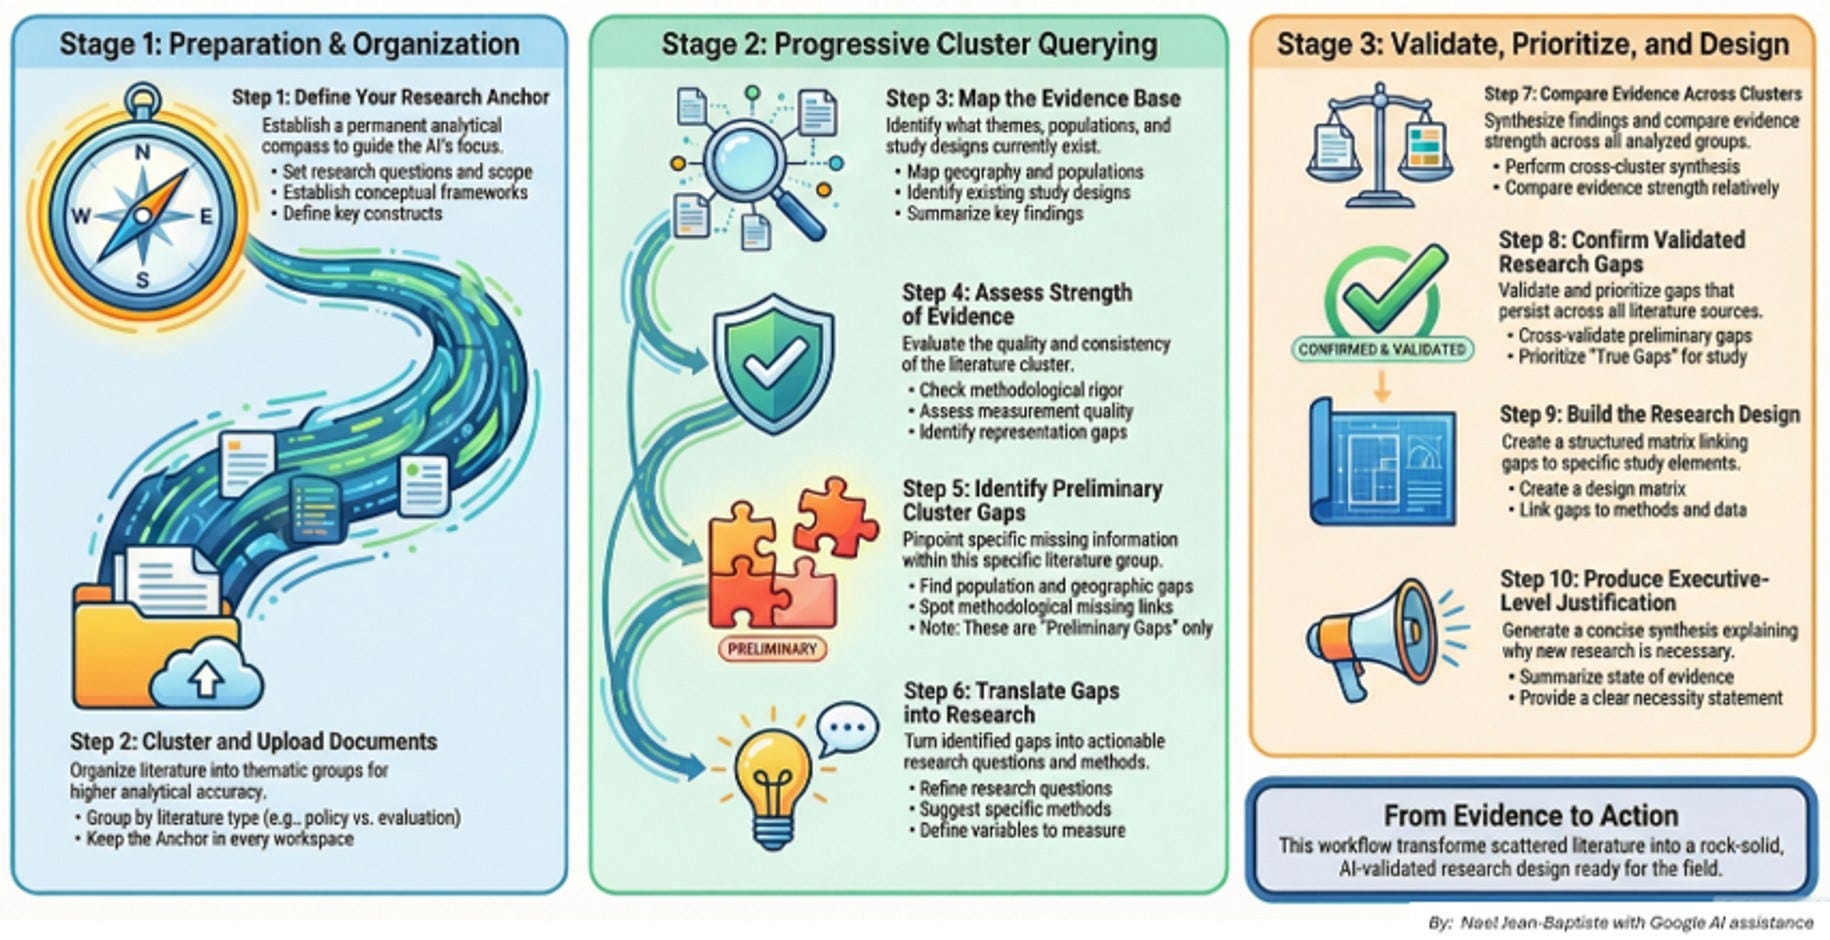
Le flux de travail de la figure ci-dessus respecte la bonne séquence : préparer un ancrage analytique, regrouper les documents, évaluer la force des données probantes, marquer les lacunes préliminaires, puis valider ces lacunes entre les regroupements avant de concevoir une étude. C’est ainsi que les cartes formelles sont censées fonctionner. Les cartes interactives des lacunes probantes sont des outils visuels structurés permettant d’afficher le volume et les caractéristiques des données probantes, et non des affiches de vos hypothèses privilégiées.
Une carte durable nécessite généralement au minimum :
- Lignes : interventions, expositions ou questions de recherche
- Colonnes : résultats, populations ou conceptions d’étude
- Filtres : année, géographie, qualité et statut de publication
- Contenu des cellules : nombre d’études, ainsi qu’une étiquette sommaire de force (revue, essai, étude observationnelle, protocole)
Demandez à l’assistant de construire la première matrice à partir des seules études incluses :
"En utilisant uniquement les études incluses, construis une matrice des lacunes avec lignes = [interventions ou questions] et colonnes = [résultats ou populations]. Dans chaque cellule, indique le nombre d’études, la conception dominante et la récence. Marque les cellules vides comme Preliminary. Propose ensuite trois recherches de suivi susceptibles de réfuter chaque cellule vide, y compris dans les registres d’essais et la littérature grise."
La validation est l’étape que la plupart des comptes rendus AI omettent. Les comparaisons méthodologiques soulignent que les cartes devraient inclure les études en cours provenant des registres, appliquer une évaluation critique et être mises à jour dans un délai d’environ trois ans. Une cellule qui paraît vide dans votre ensemble de 50 articles peut être bien remplie dans un serveur de prépublications ou un registre de protocoles.
Jenova est utile à cette étape parce qu’il peut conserver dans un même fil le codebook, la matrice et les articles rejetés, puis rédiger la note expliquant « pourquoi cette étude est nécessaire » uniquement à partir des lacunes validées. Il surinterprétera les cellules vides si vous le laissez faire. Exigez une recherche de réfutation pour chaque lacune que vous envisagez de financer ou de présenter dans un texte.
Si le sujet devient ensuite une revue de portée, adaptez la déclaration à PRISMA-ScR, qui spécifie 20 éléments essentiels et 2 éléments optionnels. Ne réaménagez pas a posteriori une carte informelle de 50 articles comme s’il s’agissait déjà d’une revue de portée.
Comment tirer le meilleur parti d’un flux de travail de recherche-filtrage-cartographie assisté par AI ?
Vous tirez le meilleur parti du flux de travail en fournissant à l’assistant un protocole figé, un corpus délimité et un budget de vérification — puis en refusant toute affirmation qui ne peut pas être ouverte dans le PDF original. La rapidité provient d’un codage cohérent, non de l’omission des vérifications en texte intégral.
Une séquence opérationnelle compacte :
- Rédigez l’ancrage. Un paragraphe énonçant l’affirmation qui nécessite un appui, la population et ce qui constituerait une donnée infirmant cette affirmation.
- Préparez et figez la recherche. Les bases de données, chaînes de recherche, dates et règles d’exclusion sont placées dans une note datée avant le début de la découverte.
- Constituez volontairement 50 articles. Mélangez des revues, des essais récents ou études primaires, et au moins quelques articles de domaines adjacents afin que la carte ne soit pas une illusion à regroupement unique.
- Filtrez dans un tableau. Inclusion, exclusion ou incertitude, avec un critère décisif et une phrase citée.
- Extrayez, puis évaluez. Les résultats, limites, conceptions et échantillons restent dans des champs distincts.
- Cartographiez, puis attaquez les vides. Chaque lacune préliminaire fait l’objet d’une seconde recherche conçue pour l’invalider.
- Rédigez à partir de la matrice. La phrase de nouveauté de l’article doit nommer la cellule vide validée, et non une impression.
Dans Jenova, conservez toute cette chaîne dans un même projet afin que l’assistant ne puisse pas modifier discrètement les règles d’inclusion entre les sessions. Un prompt de suivi qui empêche les dérives :
"Réapplique les critères d’inclusion originaux à ce nouvel article. Si tu dois modifier un critère pour l’inclure, arrête-toi et montre-moi la modification proposée au lieu d’évaluer l’article."
Pour Elicit, partez de la question de recherche, laissez le système suggérer des champs de filtrage et d’extraction, puis remplacez ces champs avant d’exécuter l’ensemble complet. Pour Rayyan, importez l’exportation de la base de données, définissez des étiquettes correspondant à votre codebook et conservez le classeur de pertinence AI comme ordre de tri plutôt que comme décision.
Prévoyez explicitement du temps de vérification. Un objectif réaliste pour un ensemble central de 50 articles est de deux à quatre minutes de contrôle humain par texte intégral inclus, en se concentrant sur la présence effective du résultat cité dans l’article et sur le codage correct de la conception. Cela reste bien moins coûteux qu’une extraction sans assistance, et c’est le seul moyen de respecter l’attente de PRISMA selon laquelle les valeurs extraites sont vérifiées.
Que disent les méthodologistes de la recherche et les créateurs d’outils sur la cartographie des données probantes assistée par AI ?
Les méthodologistes de la recherche considèrent les cartes de données probantes comme des graphiques de disponibilité guidés par un protocole, tandis que les créateurs d’outils constatent continuellement que la citation, et non la prose, est l’élément que l’AI traite mal. Les deux groupes convergent vers la même règle opérationnelle : l’AI peut structurer la recherche et le filtrage, mais le chercheur reste responsable de chaque cellule de la carte.
« Le mode de défaillance que nous observons le plus souvent consiste à traiter la cellule vide comme une découverte. Une cellule vide n’est qu’une hypothèse concernant l’absence de données probantes. Elle devient une lacune validée après avoir vérifié les regroupements adjacents, la littérature grise et les registres de protocoles, et après avoir confirmé que l’absence n’est pas un artefact de recherche. Si ces vérifications n’ont pas été effectuées, vous n’avez pas une carte des lacunes. Vous avez une visualisation de votre première requête. »
« Dans un filtrage de 50 articles, le gain de temps provient d’un codage cohérent, non de l’omission du texte intégral. La répartition utile du travail est simple : l’assistant prépare la décision d’inclusion/exclusion, la ligne d’extraction et la première matrice ; le chercheur consacre quelques minutes par article inclus à confirmer que la citation existe et que la conception n’a pas été rehaussée dans le récit. Cela permet tout de même de condenser des jours de notes désordonnées dans un seul codebook. »
« Nous ne soumettrions pas une revue systématique à une revue scientifique à partir de seuls journaux de chat. Les plateformes dédiées au filtrage restent supérieures pour la double évaluation, la résolution des conflits et les diagrammes PRISMA. Là où un assistant de recherche conversationnel mérite sa place, c’est plus tôt : pour verrouiller la question, révéler les limites biaisées de recherche, conserver les articles rejetés visibles et transformer une cellule vide validée en justification d’étude précise. »
— Équipe produit Jenova, flux de travail de recherche universitaire, 8 ans de développement d’outils de recherche AI traçables par source
Cette prudence est cohérente avec les travaux indépendants. Les revues des systèmes génératifs de synthèse de la littérature continuent de constater des capacités réelles associées à des limites de fiabilité qui rendent les revues non supervisées dangereuses. Les recommandations sur les cartes systématiques des données probantes soulignent également la catégorisation structurée des données scientifiques plutôt que la confiance narrative. La contrainte maintenant le chercheur aux commandes dans le flux de travail des sources en cinq étapes n’est pas un slogan. C’est l’étape de contrôle qualité dont dépend le reste de la méthode.
Références
- Saran et White — Cartes des données probantes et des lacunes : comparaison de différentes approches (PMC)
- Khalil et al. — Méthodologie des revues de cartographie, cartes de données probantes et cartes des lacunes (Research Synthesis Methods)
- Elicit — Présentation d’Elicit Systematic Review
- PRISMA Statement — Guide de déclaration PRISMA 2020
- Atlas Workspace — Meilleurs assistants de recherche AI (2026), comparaison vérifiée pour les hallucinations
- Fortune — Les hallucinations AI infiltrent le travail scientifique d’experts (mai 2026)
- LibGuide Grainger de l’Université de l’Illinois — Revues de portée, revues de cartographie, cartes de données probantes ou de lacunes
- Page et al. — La déclaration PRISMA 2020 (The BMJ)
- University of Kansas Medical Center — PRISMA et normes connexes pour les revues
- Elicit — Flux de travail de revue systématique conçu pour PRISMA 2020
- Rayyan — Plateforme de revue systématique propulsée par AI
- INRA.AI — Comparaison Covidence vs Rayyan vs Elicit
- Bibliothèques de l’Université de Toronto — Les revues de cartographie dans la famille de la synthèse des connaissances
- Kellermeyer, Harnke et Knight — Comparaison entre Covidence et Rayyan (PMC)
- EvalCommunity Academy — Outil interactif de cartographie des lacunes probantes
- PRISMA — Extension PRISMA pour les revues de portée
- Adel, Alateeq et Alshahrani — L’AI générative peut-elle synthétiser la littérature de manière fiable ? (AI & Society)
- Khalil et al. — Guide pour réaliser des cartes systématiques des données probantes (Science of the Total Environment)