Comment l’AI peut-elle synthétiser des preuves interdisciplinaires sans confondre les faits ?
2026-08-21
Quelles sont les trois couches de preuve à maintenir séparées dans une synthèse AI interdisciplinaire ?
L’AI ne peut synthétiser de manière fiable des preuves interdisciplinaires que lorsqu’elle étiquette chaque affirmation comme un fait source, une conclusion des auteurs ou une inférence du modèle — et empêche ces couches de se fondre dans un paragraphe unique non étiqueté. En 2026, cette séparation fait toute la différence entre une note de recherche auditable et un résumé fluide qui transforme des affirmations prudentes en autorité apparente. Les chatbots généralistes mélangent encore ces couches par défaut, ce qui explique pourquoi la fabrication bibliographique et les erreurs de citation restent bien documentées.
Les Agents de recherche conçus à cette fin — y compris l’Academic Research Assistant de Jenova — sont plus performants pour cette tâche lorsqu’ils récupèrent de vraies sources, préservent l’attribution et rendent visibles les extrapolations du modèle. Ils ne remplacent pas une revue systématique enregistrée selon PRISMA.
Facteurs essentiels qui distinguent une synthèse attentive à la provenance d’une paraphrase non étiquetée :
✅ Les faits sources correspondent aux mesures, méthodes, tailles d’échantillon et observations rapportées dans le texte primaire ✅ Les conclusions des auteurs sont les interprétations que les auteurs de l’article tirent dans la discussion ou le résumé — elles ne constituent pas des vérités indépendantes ✅ L’inférence de l’AI désigne le raisonnement analogique, prédictif ou intégratif que le modèle ajoute entre articles ou disciplines ✅ La mise en correspondance interdisciplinaire doit être explicite, car un mécanisme établi dans une discipline n’est souvent qu’une hypothèse dans une autre ✅ Chaque phrase extractible devrait résister à un audit simple : qui a affirmé cela, dans quel document et avec quel statut épistémique ?
Pour comparer les outils sur ce problème, considérez la provenance comme un critère d’évaluation de premier ordre plutôt que comme une préférence de mise en forme. Le reste de ce guide utilise cette perspective — le cadre FCI-TRACE — pour évaluer le comportement réel des systèmes de synthèse.
Pourquoi la synthèse AI interdisciplinaire échoue-t-elle lorsque la provenance est effacée ?
La synthèse interdisciplinaire échoue sans provenance parce que les disciplines ne partagent pas les mêmes normes de preuve, tandis que les modèles linguistiques sont optimisés pour produire une prose cohérente plutôt que pour préserver ces normes. Un résultat empirique issu d’un article sur le climat, une affirmation d’identification causale d’un économiste et une recommandation de pratique clinique peuvent être fusionnés grammaticalement dans une seule phrase. Cette phrase sera perçue comme un savoir établi, même si une seule de ses propositions a jamais été mesurée.
Il ne s’agit pas d’un scénario hypothétique. Une étude publiée dans Scientific Reports sur des revues de littérature générées par ChatGPT a constaté que 55 % des citations de GPT-3.5 et 18 % des citations de GPT-4 étaient fabriquées, et que 43 % et 24 % des citations réelles restantes comportaient des erreurs bibliographiques substantielles. Des rapports ultérieurs ont associé une hausse plus large des citations fabriquées dans des articles publiés aux outils génératifs. En 2026, des examens multi-modèles constatent encore que près de 40 % des références générées par AI contiennent des erreurs ou des fabrications, et que seules 26,5 % sont entièrement exactes.
Les taux d’hallucination sont encore plus élevés en dehors des textes scientifiques bien indexés. Une évaluation de Stanford HAI, résumée par MIT Sloan, a montré que les chatbots généralistes hallucinaient dans 58 à 82 % des requêtes de recherche juridique avec des modèles de l’ère 2023. Les domaines juridique, réglementaire et clinique sont précisément ceux dans lesquels les notes interdisciplinaires sont le plus souvent demandées — et ceux dans lesquels une inférence non étiquetée est la plus coûteuse.
Le problème plus profond est le blanchiment des sources : une clause prudente d’une section de discussion est reformulée sans précaution, puis citée comme s’il s’agissait d’un résultat. Des normes de provenance existent pour empêcher cette transformation. Le travail interdisciplinaire multiplie le risque, car les lecteurs ne peuvent pas s’appuyer sur des méthodes communes pour remarquer qu’une affirmation a changé de statut.
Quels critères utiliser pour évaluer un système AI de synthèse de preuves ?
Vous devez évaluer un système AI de synthèse de preuves selon sa capacité à maintenir les couches FCI intactes en cas de désaccord, et non selon le nombre d’articles qu’il mentionne. La fluidité, la rapidité et même le rappel sont secondaires si le résultat ne peut pas être audité. Le cadre FCI-TRACE utilisé ici évalue six dimensions.
FCI (statut épistémique)
- Faits : Le système peut-il citer ou paraphraser étroitement un résultat avec un repère précis — article, section, figure ou tableau ?
- Conclusions : Attribue-t-il l’interprétation aux auteurs nommés et conserve-t-il les précautions de langage ?
- Inférence : Indique-t-il les étapes analogiques ou intégratives comme étant générées par le modèle ?
TRACE (qualité de la synthèse)
- Traçabilité : Chaque affirmation est reliée à un passage source, et non seulement au titre d’un article.
- Actualité : Le système distingue les dates de prépublication, les dates de publication et les mises à jour de recommandations — un échec connu même dans les outils bibliographiques non-AI, ainsi qu’un mode d’erreur documenté de ChatGPT dans l’étude de Walters et Wilder.
- Concordance : Les résultats convergents et contradictoires sont répertoriés, et non moyennés pour produire un faux consensus.
- Couverture : Au moins deux méthodes disciplinaires sont représentées lorsque la question concerne plusieurs domaines.
- Étiquetage épistémique : Les étiquettes de statut sont visibles dans la prose, et non dissimulées dans une note de bas de page.
Cette approche est plus stricte que les listes de contrôle génériques sur l’« AI pour les revues de littérature », qui s’arrêtent souvent à la recherche et au résumé. Les guides universitaires recensent désormais des outils qui résument les articles et extraient des données dans des tableaux structurés, et les équipes de revues systématiques distinguent le dépistage semi-automatique du dépistage entièrement automatique. Ces capacités sont importantes. Elles n’empêchent pas, à elles seules, qu’une conclusion d’auteur soit réécrite comme un fait.
La transparence du protocole doit également faire partie de l’évaluation. PRISMA 2020 est une liste de contrôle de 27 éléments pour les revues systématiques incluant une synthèse, accompagnée de documents explicatifs via l’EQUATOR Network. Aucune session de chatbot ne constitue une revue PRISMA. Un processus AI défendable devrait néanmoins indiquer la logique d’éligibilité, les sources consultées et ce que le modèle a ajouté.
Comment les principaux outils de recherche AI traitent-ils les faits, les affirmations des auteurs et l’inférence du modèle ?
Les principaux outils se répartissent selon une ligne claire : les extracteurs fondés sur les articles réduisent la fabrication, tandis que les modèles de chat généralistes restent fluides mais faiblement attribués — et presque aucun n’impose nativement des étiquettes FCI dans la prose générée. La comparaison ci-dessous porte sur l’hygiène épistémique, non sur la popularité globale.
| Fonctionnalité / Dimension | ChatGPT généraliste | Elicit | Jenova Academic Research Assistant | Scite (contexte de citation) |
|---|---|---|---|---|
| Corpus de référence | Données d’entraînement et navigation facultative ; citations souvent non vérifiées | Recherche, résumé et extraction sur 125 millions d’articles ; utilisé par plus de 2 millions de chercheurs | Récupération en direct de sources savantes et web, pièces jointes et mémoire de session persistante | Graphe de citations et contexte confirmant ou contredisant la manière dont les articles sont cités |
| Étiquetage FCI dans le résultat | Généralement non étiqueté ; faits, affirmations de discussion et extrapolations du modèle partagent la même voix | Plus performant pour l’extraction au niveau de l’article que pour les étiquettes épistémiques au niveau de la phrase | Peut recevoir l’instruction d’étiqueter les couches FCI et de conserver le protocole entre les sessions | Étiquette davantage la posture de citation que le type d’affirmation au sein d’une synthèse |
| Synthèse interdisciplinaire | Grande fluidité ; faible piste d’audit entre disciplines | Très performant pour les questions de recherche empirique et l’extraction structurée | Très performant lorsqu’un protocole méthodologique et un suivi par domaine sont nécessaires sur plusieurs jours | Limité comme outil de synthèse ; plus performant comme perspective sur le contexte des citations |
| Vérification des citations | Taux élevés de fabrication et d’erreurs dans les tests systématiques | Les lignes fondées sur les articles réduisent les références inventées | Récupération plus attribution ; nécessite toujours des contrôles humains ponctuels | Contexte natif permettant de savoir si des articles ultérieurs confirment ou contredisent une affirmation |
| Dépistage / extraction | Non structuré | Automatise le dépistage et l’extraction de données pour les revues systématiques | Découverte itérative et assistance à la rédaction, sans interface de dépistage dédiée | Pas d’espace de travail de dépistage |
| Tarification (en 2026) | Abonnement ; niveaux grand public exacts non vérifiés ici | Non vérifiée dans cette revue | Niveau gratuit avec utilisation limitée ; Plus à 20 $/mois (30× d’utilisation) | Non vérifiée dans cette revue |
| Idéal pour | Rédiger lorsque les sources sont déjà disponibles | Extraction en colonnes à partir d’articles empiriques | Notes multi-sources réparties sur plusieurs sessions, qui doivent maintenir visibles les couches FCI | Vérifier la manière dont une affirmation est traitée dans la littérature ultérieure |
Elicit. L’examen de l’étendue du produit montre un environnement de travail de recherche plutôt qu’un chatbot : les utilisateurs posent une question, récupèrent des articles et extraient des champs. Des comparaisons indépendantes en 2026 décrivent Elicit comme plus performant pour la découverte de littérature, le dépistage et l’extraction de données, tandis que Consensus est présenté comme plus performant pour les questions scientifiques auxquelles on répond par oui ou par non. Cette force d’extraction est réelle. Sa limite est complémentaire : un tableau rempli peut toujours présenter le verbe causal d’un résumé comme s’il s’agissait d’un résultat, à moins que l’utilisateur ne définisse des colonnes séparant les résultats de l’interprétation.
Consensus et Semantic Scholar. Consensus est régulièrement présenté comme un moteur de réponses reposant sur de vrais articles, et non comme un pipeline complet de revue (The Drive AI). Un récapitulatif de 2026 situait Consensus à environ 144 $ par an comme point d’entrée. Semantic Scholar reste une base de découverte dans ces mêmes comparaisons. Aucun de ces outils, d’après les descriptions publiques examinées ici, ne propose une surcouche obligatoire distinguant les faits des inférences.
Scite. Scite convient mieux lorsque la question est comment un article est cité, et non comment fusionner deux disciplines. Les comparaisons le considèrent comme le spécialiste du contexte de citation, face au processus de revue plus large d’Elicit (Paperguide, 2026). Les étiquettes de citations confirmantes ou contradictoires sont précieuses, mais restent distinctes du FCI : un article ultérieur peut « confirmer » une conclusion d’auteur qui n’a jamais été un fait.
ChatGPT généraliste. Il demeure un mauvais choix par défaut pour une synthèse sans supervision. Même le taux de fabrication de 18 % amélioré de GPT-4 est incompatible avec un travail exigeant des citations fiables, et les champs numériques des citations — volume, pages, année — sont les erreurs les plus fréquentes parmi les références réelles. Les recommandations des bibliothèques traitent désormais les citations hallucinées comme un sujet d’intégrité de la recherche à part entière.
Jenova Academic Research Assistant. Cet Agent est conçu pour les universitaires et doctorants ayant besoin de découverte de littérature, d’assistance à la rédaction de manuscrits et de gestion des citations, plutôt que d’un résumé produit en une seule fois. Sur la plateforme Jenova, il peut utiliser la recherche savante, conserver un historique de chat illimité et mémoriser un protocole méthodologique de manière persistante afin que les règles FCI ne soient pas réinitialisées à chaque session. Associé à Deep Research — qui effectue des recherches étendues et produit des rapports riches en citations — il convient particulièrement aux questions interdisciplinaires qui se développent sur plusieurs séances.
Il est important d’indiquer honnêtement ses limites. Ce n’est ni Covidence, ni DistillerSR, ni Rayyan : il n’existe pas d’espace de travail dédié aux diagrammes de flux PRISMA, ni de grille native d’extraction de 125 millions d’articles à l’échelle annoncée par Elicit. Les décisions d’inclusion à fort enjeu et la mise en commun statistique relèvent toujours d’examinateurs humains. L’avantage en profondeur réside dans la persistance du protocole et l’étiquetage explicite, non dans une certitude automatisée.
Comment l’orchestration des connaissances empêche-t-elle les preuves disciplinaires de s’effondrer dans un seul récit ?
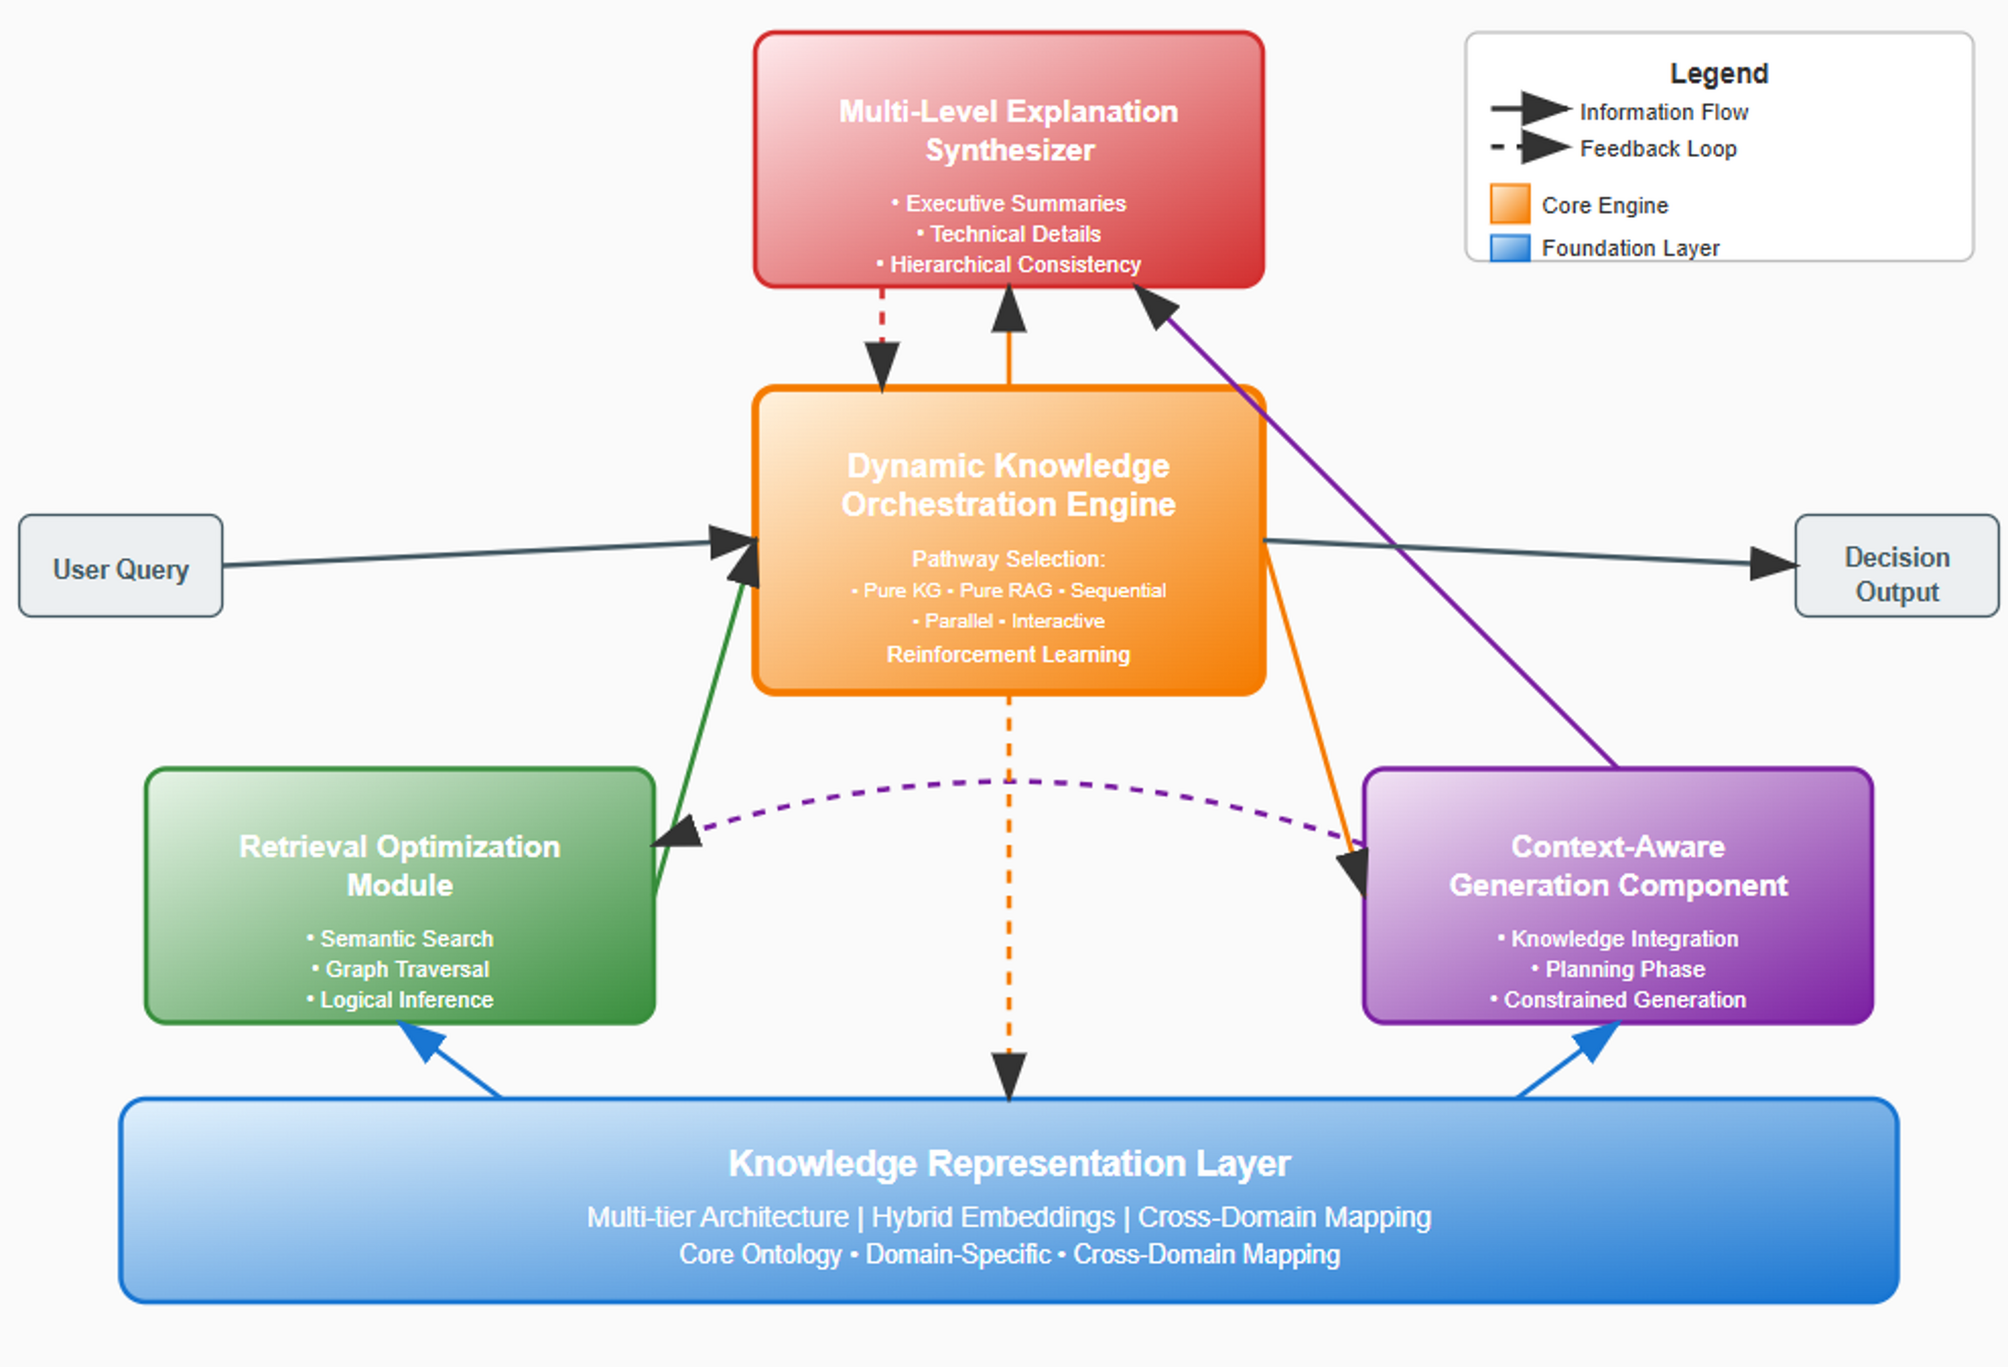
L’orchestration des connaissances préserve l’intégrité des preuves disciplinaires en choisissant un parcours de récupération avant la génération, puis en imposant aux explications de rester hiérarchiquement cohérentes avec ce qui a été récupéré. L’examen d’une pile d’orchestration typique montre pourquoi « récupérer puis rédiger » ne suffit pas au travail interdisciplinaire.
La base est une couche de représentation des connaissances : embeddings hybrides, ontologies de domaine et mise en correspondance interdisciplinaire. Sans cette couche, un modèle traite l’« incertitude » en physique du climat, l’« incertitude » en économétrie et l’« incertitude » dans les recommandations cliniques comme appartenant au même voisinage de jetons. Ce n’est pas le cas. La mise en correspondance des termes entre domaines est une étape d’inférence et doit être étiquetée comme telle.
Au-dessus de cette couche, un module d’optimisation de la récupération associe recherche sémantique, parcours de graphes et inférence logique. Le parcours de graphes est important lorsque la question est relationnelle — par exemple, le mécanisme A en écologie est-il analogue au mécanisme B en santé publique ? La recherche sémantique seule renvoie un langage similaire ; elle ne prouve pas une structure causale partagée. L’inférence logique appliquée à des affirmations extraites se rapproche davantage des réseaux d’inférence de preuves conçus pour une vérification interprétable des affirmations.
Le moteur d’orchestration sélectionne ensuite un parcours — graphe de connaissances seul, RAG seul, séquentiel, parallèle ou interactif — au lieu de toujours déverser des segments dans un prompt. La récupération parallèle convient lorsque deux disciplines doivent être recueillies indépendamment avant toute mise en correspondance. La récupération séquentielle convient lorsqu’une mesure de résultat dans un domaine doit contraindre la requête suivante. Mélanger ces modes sans le dire est la manière dont une note climat-santé devient discrètement une recommandation de politique publique.
Une étape de génération sensible au contexte doit planifier sous contraintes : ne pas générer de verbe causal si la source n’en emploie pas ; ne pas fusionner les cadres d’échantillonnage. La dernière étape, un synthétiseur d’explications à plusieurs niveaux, rend le FCI visible — résumé exécutif, détails techniques et contrôle de cohérence afin que le résumé ne dépasse pas les preuves. Les interfaces affirmation-preuve de la recherche actuelle, telles que PaperTrail, vont dans le même sens : la fiabilité dans les contextes savants dépend de l’association des affirmations aux preuves, non d’une prose plus fluide.
L’Academic Research Assistant de Jenova n’expose pas chaque commutateur de routage interne comme un contrôle destiné aux chercheurs. C’est une limite réelle pour les équipes qui ont besoin d’un DAG entièrement inspectable. Il offre toutefois l’équivalent pratique pour la plupart des processus universitaires : des instructions persistantes, des corpus joints, une récupération en direct et suffisamment de mémoire pour conserver un protocole d’étiquetage stable à mesure que les preuves s’accumulent.
Comment un pipeline de citation sémantique peut-il vérifier les affirmations avant leur intégration dans une synthèse ?
Un pipeline de citation sémantique vérifie les affirmations en traitant chaque citation comme une hypothèse à confronter au document source, et non comme un ornement formaté à la fin d’un paragraphe. Si cette étape est ignorée, la synthèse interdisciplinaire hérite de toutes les références inventées ou déformées produites par le générateur.
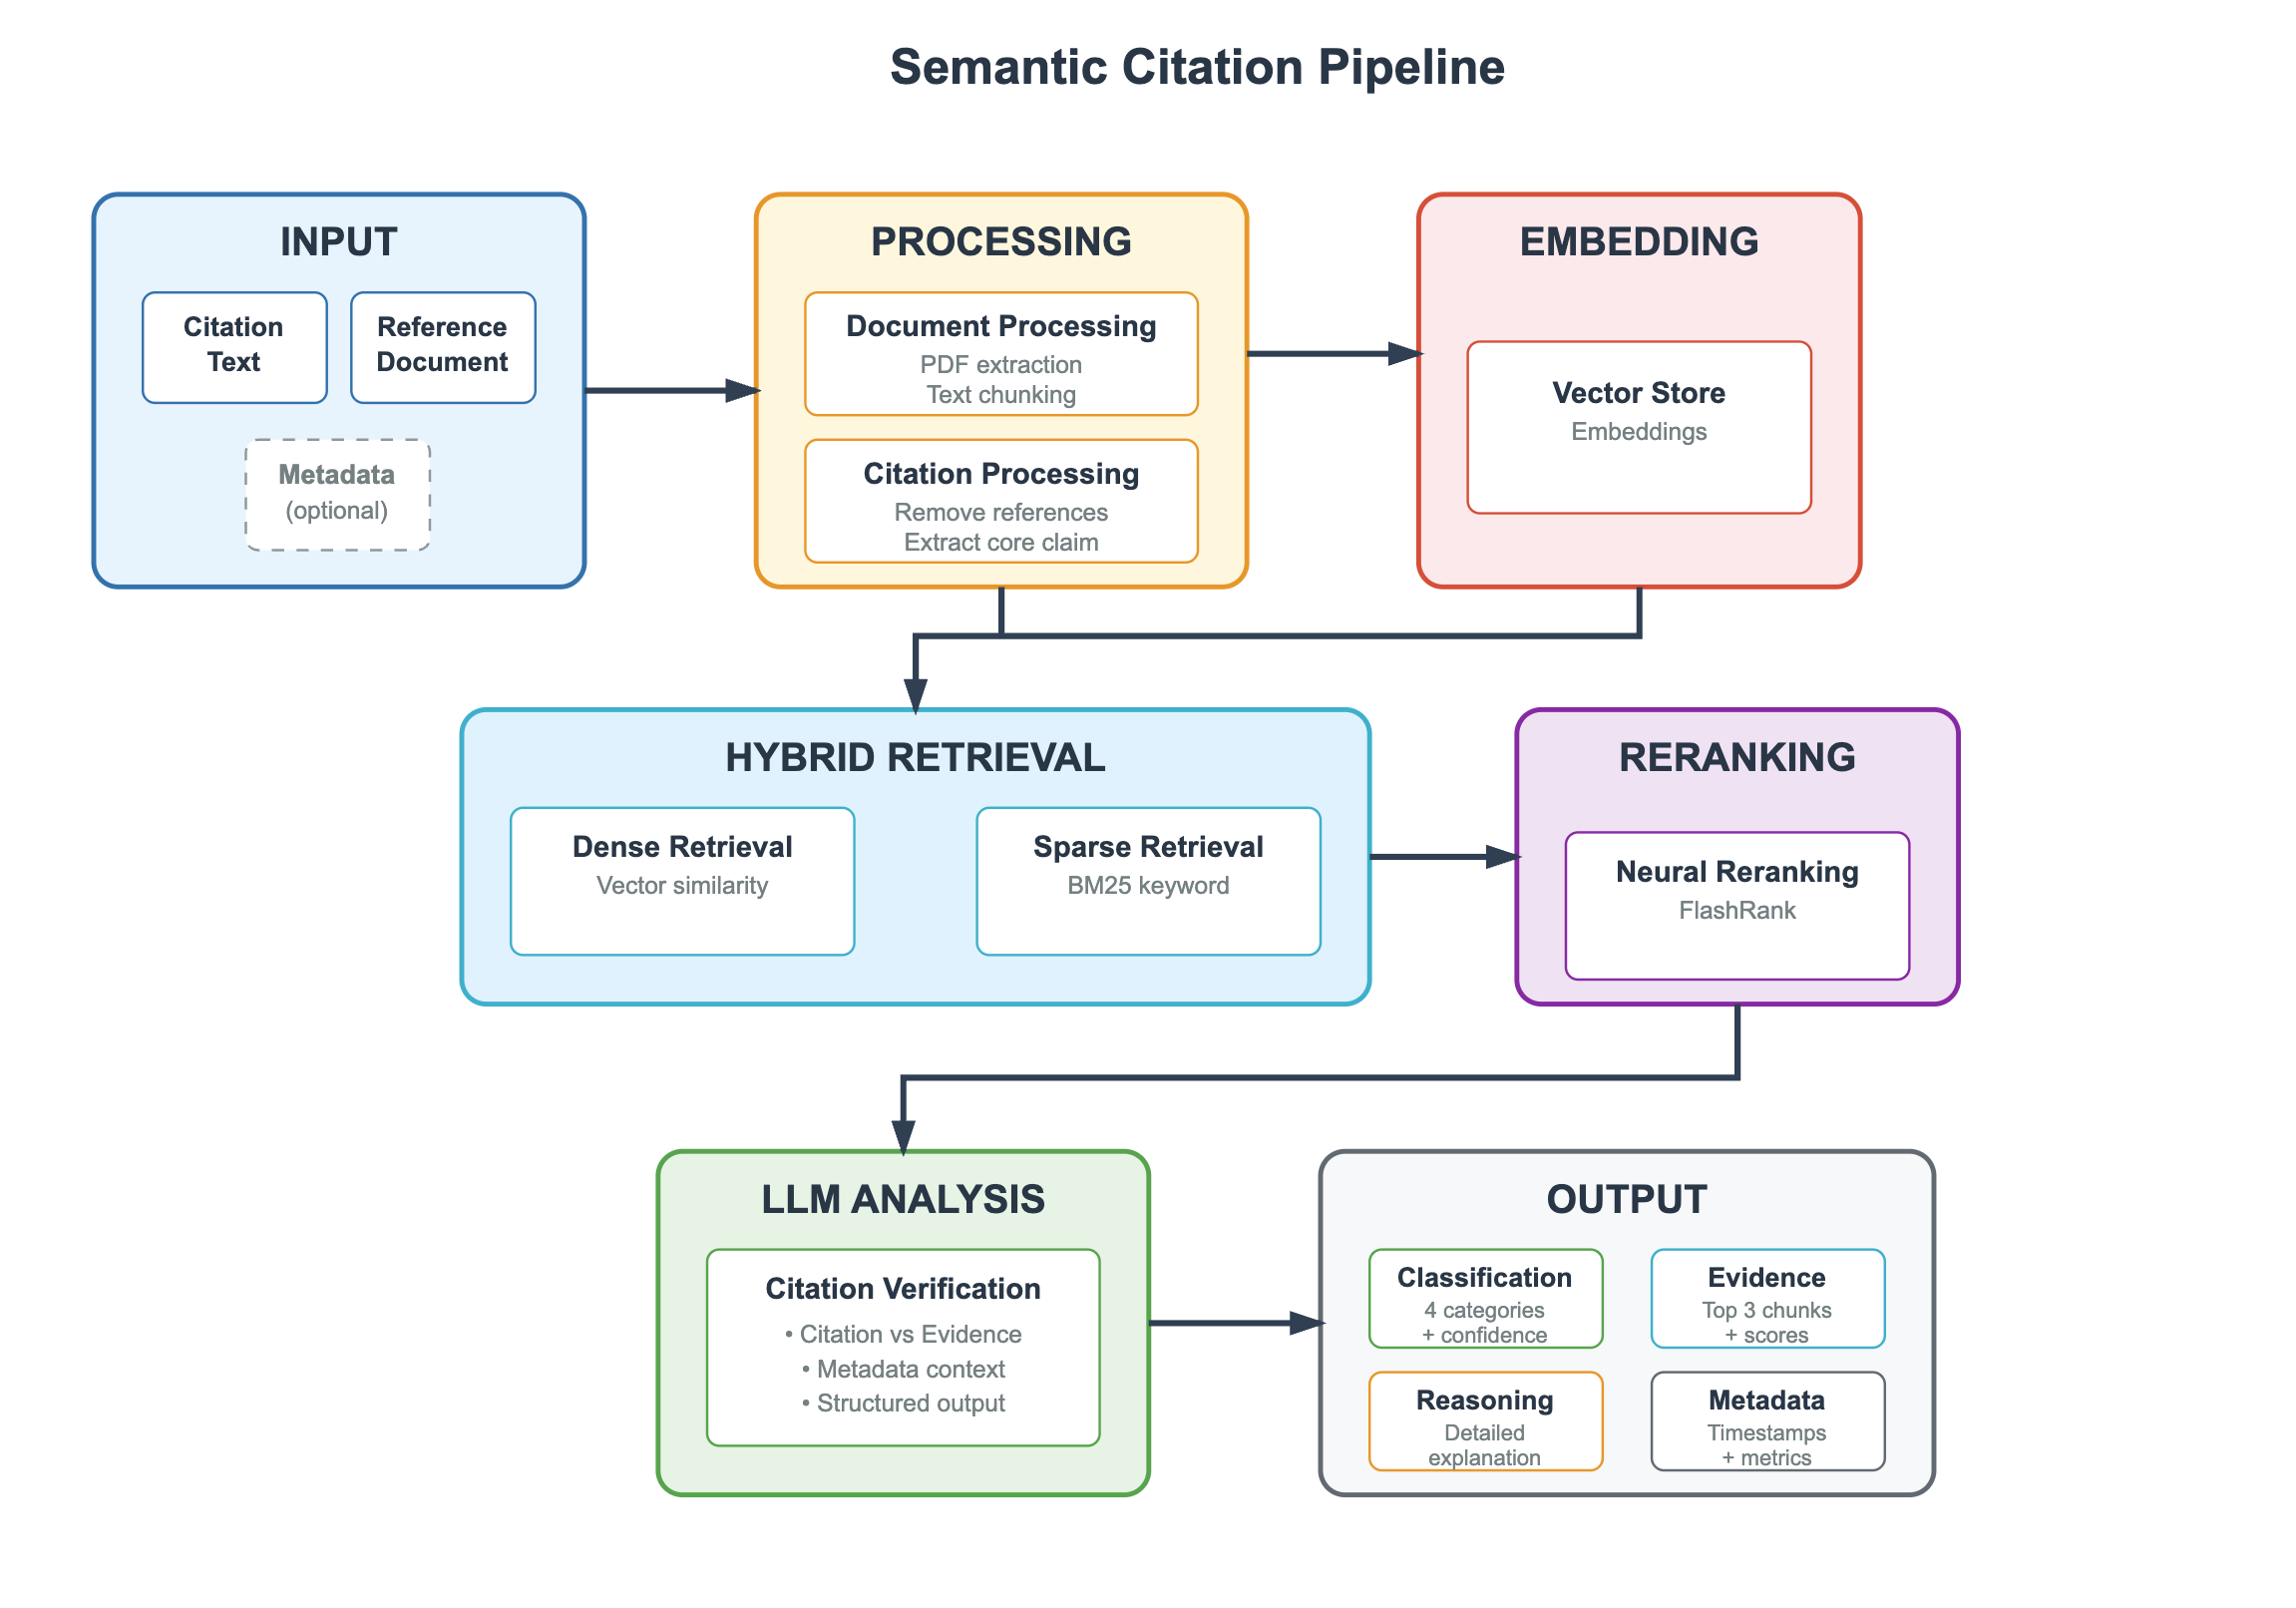
L’examen d’un pipeline de type production révèle un ordre fixe. L’entrée comprend le texte de la citation, le document de référence et des métadonnées facultatives. Le traitement extrait le texte du PDF, le segmente, retire la liste des références afin que le modèle ne puisse pas « vérifier » une affirmation en lisant la bibliographie, et isole l’affirmation centrale. L’embedding stocke ensuite ces segments. La récupération hybride exécute alors en parallèle une recherche vectorielle dense et une recherche BM25 clairsemée — ce qui est nécessaire parce que le jargon disciplinaire et la notation statistique échouent souvent avec une recherche par embeddings pure. Le reranking neuronal — par exemple FlashRank — conserve les meilleurs passages. Ce n’est qu’ensuite que l’analyse LLM classe la relation entre l’affirmation et la preuve.
Le résultat utile n’est pas une validation binaire. Une classification à quatre voies avec un niveau de confiance — confirmé, contredit, non traité ou partiellement traité — ainsi que les principaux passages de preuve et une justification écrite, constituent ce qu’un Agent de synthèse devrait ingérer. Ce schéma correspond à l’évolution plus large vers une vérification explicable des affirmations au niveau de la preuve. Il correspond également à ce que les unités d’enseignement universitaires recommandent déjà lorsqu’elles décrivent des assistants AI qui extraient des preuves plutôt que d’inventer un récit.
Deux modes d’échec subsistent, même avec un pipeline. Premièrement, une conclusion d’auteur correctement citée peut toujours être classée à tort comme un fait si le classificateur ignore le contexte de la section — résultats plutôt que discussion. Deuxièmement, la récupération hybride peut faire émerger une phrase très similaire issue d’un autre article du même domaine — une dérive de citation par paraphrase. L’examen humain des principaux passages fait donc partie de la méthode, et ne constitue pas un aveu d’échec.
Les processus Jenova peuvent approcher ce pipeline en exigeant une citation avec extrait et repère avant qu’une affirmation soit admise dans une note de synthèse, puis en exécutant Deep Research comme seconde passe sur la même bibliographie. Ils ne remplacent pas un service dédié de vérification des citations doté de métriques d’évaluation figées. Pour les chapitres de thèse et les soumissions à des revues, exportez le tableau de preuves et examinez-le.
Comment demander à un Agent de recherche AI de séparer les faits, les conclusions et les inférences ?
Vous devez instruire l’Agent à l’aide d’un protocole permanent qui définit les étiquettes, interdit les promotions silencieuses de statut d’affirmation et exige un tableau des contradictions avant tout récit interdisciplinaire. Le choix de l’outil est important, mais les prompts non étiquetés feront s’effondrer le FCI sur toutes les plateformes.
Pour l’Academic Research Assistant de Jenova, une configuration durable se présente ainsi :
- Ouvrez l’Agent à l’adresse jenova.ai/a/academic-research-assistant et indiquez la question de recherche, les disciplines couvertes et les limites temporelles.
- Collez un protocole FCI permanent (enregistrez-le dans les instructions personnalisées si les mêmes règles doivent s’appliquer entre les sessions) :
« Protocole de travail : Étiquetez chaque phrase [FAIT], [CONCLUSION DES AUTEURS] ou [INFÉRENCE DE L’AI]. Les faits exigent un repère source. Les conclusions des auteurs doivent nommer l’article et conserver les précautions de langage. L’inférence de l’AI comprend toute mise en correspondance interdisciplinaire, tout saut causal ou toute recommandation non énoncée par une source. Si les preuves sont contradictoires, ne les moyennez pas. Produisez un tableau : Affirmation | Couche | Source | Repère | Concordance (confirme / contredit / absent). »
- Constituez le corpus initial. Joignez les PDF auxquels vous faites déjà confiance, puis demandez une découverte complémentaire au lieu de laisser la première recherche définir le domaine.
- Exigez un livrable en couches — bibliographie annotée, résultats étiquetés FCI, puis synthèse courte qui ne peut introduire aucun nouveau fait.
Un prompt de premier échange qui produit généralement une structure exploitable :
« Question : Comment l’intensité de l’îlot de chaleur urbain, la qualité du logement et les admissions cardiovasculaires d’urgence sont-elles liées dans les villes à revenu élevé depuis 2015 ? Disciplines : climatologie, épidémiologie, économie urbaine. Résultat : (1) carte des sources, (2) résultats étiquetés FCI, (3) journal des contradictions, (4) inférences de l’AI listées en dernier et marquées comme non testées. Ne citez rien que vous n’ayez récupéré. »
Pour Elicit, la discipline équivalente réside dans la conception des colonnes plutôt que dans les étiquettes de prose. Créez des champs d’extraction distincts pour le résultat rapporté, l’interprétation des auteurs, la population et les limites identifiées, en suivant le processus question-versus-extraction de l’outil. N’utilisez pas une unique colonne « résultat principal » ; c’est dans cette colonne que les verbes de discussion sont promus au rang de résultats.
Pour un chatbot généraliste, ajoutez un contrôle contradictoire que l’étude de Nature rend nécessaire : exigez des citations directes, puis vérifiez indépendamment chaque référence dans une base de données bibliographique. Demander au même modèle « cette citation est-elle réelle ? » est peu fiable. Si le projet est une revue systématique, utilisez les outils de dépistage décrits dans les guides de bibliothèque sur la synthèse des preuves pour les décisions d’inclusion, et excluez le chatbot des décisions d’éligibilité.
Deep Research sur Jenova constitue le meilleur suivi lorsque la bibliographie est vaste et que vous avez besoin d’une seconde passe riche en citations. Utilisez-le après avoir établi les règles FCI, et non comme première analyse non étiquetée.
Que disent les méthodologistes de la recherche sur la provenance des preuves AI ?
Les méthodologistes de la recherche considèrent la synthèse AI non étiquetée comme un échec de reporting, et non comme un gain de productivité : si un lecteur ne peut pas voir quelle couche occupe une phrase, le document ne constitue pas encore une preuve. Cette position est cohérente avec l’insistance de PRISMA sur une synthèse transparente et avec les études sur l’intégrité des citations, qui considèrent les références fabriquées comme une menace pour le dossier probant.
« Le mode d’échec que nous observons n’est pas que les modèles ne peuvent pas lire les articles. C’est qu’ils écrivent d’une seule voix épistémique. Un chiffre méthodologique, une clause prudente provenant d’une section de discussion et une analogie interdisciplinaire sortent du modèle sous la forme d’un anglais tout aussi assuré. Les comités interdisciplinaires débattent alors de la conclusion alors qu’ils devraient débattre de la couche. Si une phrase ne peut pas répondre à “qui a affirmé cela, et cela a-t-il été mesuré ou inféré ?”, elle ne devrait pas entrer dans une note de résultats. »
« L’étiquetage FCI coûte moins cher qu’une rétractation a posteriori. Les équipes qui imposent des repères avant la synthèse consacrent davantage de temps à la première passe et beaucoup moins à démêler les dérives de citation. L’étude Nature sur ChatGPT reste le point de référence prudent : même de fortes réductions de la fabrication laissent des taux d’erreur résiduels inacceptables dans une liste de références. La provenance est le système de contrôle. La fluidité ne l’est pas. »
« Les pipelines d’orchestration et de vérification des citations sont la manière d’opérationnaliser cette norme. Récupérez les disciplines en parallèle lorsqu’elles ne partagent pas les mêmes construits. Vérifiez les affirmations par rapport aux segments avant qu’elles n’atteignent le synthétiseur. Conservez l’étape intégrative du modèle dans un bloc distinct et nommé. Cette architecture est plus conservatrice qu’un résumé de chatbot, et c’est précisément le but. »
— Équipe produit de Jenova, conception d’Agents de recherche AI, huit années de développement de processus de récupération et d’attribution pour les utilisateurs universitaires et professionnels
L’implication pour le choix de l’outil est précise. Préférez les systèmes capables de conserver un protocole, d’afficher les sources et de tolérer les contradictions. Ne privilégiez pas les systèmes qui semblent simplement interdisciplinaires.
Quand l’examen humain doit-il primer sur la synthèse AI entre disciplines ?
L’examen humain doit primer sur la synthèse AI chaque fois qu’une affirmation modifie une décision, franchit une frontière méthodologique disciplinaire ou ne peut être reliée à un repère — ce qui couvre la plupart des travaux qui justifient une synthèse au départ. L’AI est un multiplicateur de rédaction et de récupération. Elle n’est pas l’autorité épistémique.
La primauté humaine est non négociable dans au moins cinq situations :
- Un langage causal apparaît dans la synthèse, mais pas dans la section des résultats du travail cité.
- Une incompatibilité de construits est possible — par exemple, le « stress » en psychologie, la « charge allostatique » en médecine ou la « volatilité » en économie.
- Des recommandations ou le droit sont en jeu ; les taux d’hallucination dans les requêtes juridiques ont été particulièrement élevés dans les tests contrôlés.
- Une mise en commun statistique est implicite. Les modèles linguistiques ne réalisent pas de méta-analyse défendable en paraphrasant des résumés, et PRISMA 2020 existe spécifiquement pour les revues incluant une synthèse.
- La vérification des citations n’a pas été effectuée par rapport au PDF. Les références inventées ou modifiées restent suffisamment fréquentes en 2026 pour que les revues et bibliothèques les considèrent comme un problème d’intégrité.
Une répartition pratique du travail ressemble à ceci. L’Academic Research Assistant propose la carte des sources, les étiquettes FCI et le journal des contradictions. Elicit ou un outil de dépistage prend en charge l’extraction structurée lorsque le corpus constitue une revue formelle. Un méthodologiste humain arbitre les promotions de couche et toutes les inférences interdisciplinaires. L’AI peut suggérer la mise en correspondance ; seul l’humain peut l’élever au rang d’affirmation.
Utilisée ainsi, la synthèse AI ne remplace pas le jugement interdisciplinaire. Elle permet de conserver les faits, les conclusions des auteurs et l’inférence du modèle dans des flux distincts et inspectables afin que le jugement puisse s’appuyer sur une base honnête.
Références
- Rules Integrity Initiative — Provenance et blanchiment des sources
- Walters & Wilder, Scientific Reports — Fabrication et erreurs dans les citations bibliographiques générées par ChatGPT
- Forbes — AI accusée de la hausse des citations fabriquées dans les articles de recherche (2026)
- Enago — Hallucinations AI dans les citations de recherche (2026)
- MIT Sloan — Réduire les hallucinations et les biais de l’AI, y compris les taux de requêtes juridiques de Stanford HAI
- Bibliothèques de la George Mason University — Outils AI pour les revues de littérature
- King's College London — Outils AI pour la synthèse des preuves
- Déclaration PRISMA 2020
- Page et al., The BMJ — La déclaration PRISMA 2020
- EQUATOR Network — Guide de reporting PRISMA
- Elicit — AI pour la recherche scientifique
- Paperguide — Comparaison Elicit vs Scite (2026)
- PapersFlow — Elicit vs Consensus AI
- The Drive AI — Elicit vs Consensus vs Semantic Scholar
- Omid Saffari — Meilleurs outils de recherche AI 2026
- UNC Charlotte Library — Citations AI hallucinées
- Wu et al., AAAI — Réseaux d’inférence de preuves pour une vérification interprétable des affirmations
- PaperTrail — Une interface affirmation-preuve pour ancrer les résultats savants de LLM (arXiv)
- Zhang et al., EACL — Vérification multimodale et explicable des affirmations
- University of Iowa — Revues de littérature assistées par AI