Comment l’AI peut-elle repérer des preuves et rédiger des réponses aux évaluateurs ?
2026-08-22
Qu’est-ce qui distingue les outils de réponse fondés sur les preuves de la rédaction générique par AI ?
Les outils qui aident les auteurs à bien répondre aux évaluateurs en 2026 ne sont pas ceux qui produisent la prose la plus fluide. Ce sont ceux qui relient chaque commentaire d’évaluateur à des preuves citables, vérifient que ces preuves étayent réellement l’affirmation, puis rédigent une réponse dont la formulation n’est pas plus forte que les éléments disponibles. Jenova's Academic Research Assistant est conçu pour cette boucle centrée sur les preuves — découverte de la littérature, gestion des citations et rédaction ancrée dans le manuscrit — tandis que Scite, Elicit, SciSpace et Consensus couvrent chacun une partie de cette même tâche avec des atouts différents.
Voici ce qui distingue un processus de réponse par AI exploitable d’une rédaction fluide mais risquée :
✅ Recherche au niveau du commentaire, et non un seul lot de littérature pour toute la lettre ✅ Vérifications de citations qui ouvrent la phrase source, et pas seulement la référence bibliographique ✅ Étiquette de soutien pour chaque affirmation — pleinement étayée, partiellement étayée, contredite ou indéterminée ✅ Rédaction nuancée qui correspond à l’étiquette au lieu de transformer « suggère » en « démontre » ✅ Relecture humaine capable de rejeter, restreindre ou supprimer une phrase proposée par l’AI
Un rapport Nature de 2026 portant sur une enquête Frontiers menée auprès d’environ 1 600 universitaires dans 111 pays a révélé que plus de la moitié des chercheurs ont déjà utilisé l’AI lors de l’évaluation par les pairs. La même pression pèse désormais sur les auteurs qui rédigent des lettres de réponse. Pour comparer utilement les outils, il faut considérer la localisation des preuves, la vérification des citations et l’étalonnage des affirmations comme trois tâches distinctes plutôt que comme une unique tâche de rédaction.
Pourquoi les lettres de réponse aux évaluateurs échouent-elles lorsque les citations ne sont pas vérifiées ?
La plupart des révisions échouées ou retardées ne s’effondrent pas parce que l’auteur a été impoli. Elles échouent parce qu’une citation ne dit pas ce que la lettre affirme, qu’une analyse promise n’apparaît pas dans le manuscrit, ou que la réponse exagère une conclusion que l’article n’étaye que faiblement. Les rédacteurs et les évaluateurs peuvent vérifier ces incohérences en quelques minutes.
Les modèles généralistes facilitent ce type d’échec au lieu de le réduire. Les consignes universitaires sont sans détour : les systèmes d’AI inventent fréquemment des citations qui paraissent réelles mais n’existent pas, et soumettre une référence fabriquée est considéré comme une fraude académique. Les recommandations de l’Université de Stellenbosch sur l’usage responsable ajoutent que de nombreux outils ne peuvent pas vérifier les références dans des bases de données en direct et en temps réel. Une lettre de réponse est un endroit à haut risque pour apprendre cette leçon, car chaque nouvelle citation est une promesse implicite que la source existe et étaye exactement la phrase que vous venez d’écrire.
Il existe un deuxième échec, plus discret : de vrais articles, mais un usage erroné. Un article méthodologique cité comme preuve de résultat, une revue citée comme essai primaire, ou un résultat obtenu dans une autre population présenté comme une confirmation directe peuvent tous passer un contrôle de DOI tout en restant trompeurs. Les Smart Citations de Scite existent précisément pour indiquer si des travaux ultérieurs étayent, contestent ou ne font que mentionner une affirmation, ce qui constitue un problème différent de la vérification du bon format d’une référence.
Les vérificateurs de références fondés sur des règles sont réellement performants au niveau mécanique. PoolText indique que les vérificateurs de références par AI sont très précis pour les erreurs de style, les champs manquants, la ponctuation et le formatage des DOI. C’est nécessaire, mais insuffisant. Une affirmation non étayée et parfaitement mise en forme reste une exagération.
Que faut-il rechercher dans un processus de réponse aux évaluateurs assisté par AI ?
Vous devez évaluer les outils selon six dimensions : segmentation des commentaires, recherche de preuves, vérification des phrases sources, classification du soutien des affirmations, rédaction calibrée et mémoire des révisions. Un outil qui n’obtient un bon score que sur l’une de ces dimensions produira tout de même une lettre qui semble terminée alors qu’elle ne l’est pas.
Le cadre d’alignement commentaire-preuve utilisé dans cet article pondère les six dimensions comme suit :
- Segmentation des commentaires (15 %) — Le système peut-il isoler chaque demande de l’évaluateur, y compris les commentaires composés qui dissimulent deux exigences dans un même paragraphe ?
- Recherche de preuves (20 %) — Recherche-t-il séparément dans le manuscrit, les données de l’auteur et la littérature externe, puis indique-t-il de quel ensemble provient le soutien ?
- Vérification des phrases sources (20 %) — Une personne peut-elle ouvrir la phrase exacte censée étayer la réponse ?
- Classification du soutien des affirmations (20 %) — Chaque citation proposée est-elle étiquetée comme étayée, partiellement étayée, non étayée ou incertaine ?
- Rédaction calibrée (15 %) — La prose hérite-t-elle de l’étiquette, ou adopte-t-elle par défaut un anglais académique affirmatif ?
- Mémoire des révisions (10 %) — Le système peut-il se souvenir des cycles précédents, des analyses promises et des formulations rejetées ?
Cette pondération est délibérée. La rédaction est la partie la moins coûteuse de la tâche. La recherche et la classification sont les étapes où les lettres deviennent soit citables, soit un deuxième problème d’évaluation. Les recherches comparant les évaluations par les pairs générées par AI et par des humains n’ont pas établi de valeur ajoutée concluante de l’AI par rapport aux évaluateurs humains, ce qui constitue aussi un avertissement utile pour les auteurs : la fluidité n’est pas un signal de validité.
Des tests pratiques qui révèlent rapidement les faiblesses des outils :
- Donnez au modèle un commentaire d’évaluateur auquel votre article ne peut pas répondre complètement et observez s’il invente un résultat.
- Demandez-lui de citer la phrase étayante de chaque article référencé, et pas seulement la clé de citation.
- Imposez une étiquette de soutien à quatre niveaux avant de rédiger une seule phrase de réponse.
- Réexécutez le même commentaire une semaine plus tard et vérifiez si la lettre contredit une concession antérieure.
Si un produit ne peut pas échouer à ces tests de manière visible, il ne vous aide pas. Il dissimule l’incertitude que vous êtes censé gérer.
Comment les principaux outils de recherche par AI se comparent-ils pour la recherche de preuves et les contrôles de citations ?
Aucun produit unique ne domine actuellement les trois tâches — trouver des preuves pour chaque commentaire, vérifier la citation et rédiger une réponse qui ne surinterprète pas. La comparaison utile consiste à déterminer quelle tâche chaque outil est réellement conçu pour accomplir.
| Fonctionnalité / Dimension | Elicit | Jenova's Academic Research Assistant | Scite | SciSpace Response-to-Reviewers |
|---|---|---|---|---|
| Recherche de preuves | Recherche par AI et extraction de données dans plus de 125 millions d’articles | Découverte de littérature en temps réel et bases de connaissances associées au manuscrit | Texte intégral académique sous licence et contexte des citations dans un vaste corpus soutenu par des éditeurs | Processus d’Agent ancré dans les articles et orienté vers les commentaires d’évaluateurs |
| Vérification des citations | Solide pour l’extraction structurée ; 1 502 points de données corrects sur 1 511 (99,4 %) dans le test rapporté par Elicit | Récupère les sources candidates et les détails de citation ; une confirmation humaine de la phrase source reste nécessaire | Chaque affirmation de l’AI renvoie à la phrase précise dans l’article précis | Utile pour constituer un dossier de réponse ; la profondeur de vérification dépend des sources sous-jacentes |
| Rédaction de lettres de réponse | Indirecte — mieux adapté aux tableaux et aux réponses issues de la littérature qu’à une lettre complète | Solide pour les brouillons point par point lorsque les commentaires et le manuscrit sont dans la session | Indirecte — conçu pour tester si les résultats tiennent, pas pour rédiger la lettre | Processus de rédaction de réponses aux évaluateurs conçu à cet effet |
| Signaux de soutien des affirmations | Précision d’extraction, et non système de soutien à quatre étiquettes | Classification imposée par l’utilisateur au sein de la boucle de rédaction | Contexte de citations favorables, contradictoires et mentionnant l’affirmation | Structure alignée sur l’évaluateur davantage qu’une taxonomie formelle du soutien |
| Tarification (en 2026) | Non vérifiée dans cette analyse | Niveau gratuit avec usage limité ; forfaits payants à partir de 20 $/mois | Non vérifiée dans cette analyse | Non vérifiée dans cette analyse |
| Idéal pour | Extraction systématique et tableaux de preuves | Cycles de révision de bout en bout restant associés à un même manuscrit | Vérifier si la littérature étaye réellement une phrase | Auteurs souhaitant un Agent dédié à la rédaction de réfutations |
Elicit est le plus performant lorsqu’un évaluateur demande une comparaison manquante, une cartographie plus claire des travaux connexes ou l’extraction de chiffres depuis un ensemble d’études. Le résumé d’un guide de recherche de l’Université George Mason le décrit comme un outil qui résume les articles et extrait les données dans des vues structurées de preuves. Sa limite pour les réfutations tient à sa portée : un excellent tableau de preuves n’est pas encore une lettre au ton calibré, et il ne vous empêchera pas automatiquement de transformer une constatation extraite en affirmation causale.
Scite est le plus performant lorsque le risque consiste à mal interpréter la littérature. Il recherche dans plus de 300 millions d’articles scientifiques et, surtout, montre comment des publications ultérieures ont traité une affirmation donnée. C’est l’outil adéquat lorsqu’un évaluateur affirme que « cette citation n’étaye pas votre conclusion » ou lorsque vous êtes tenté de citer un article majeur comme si le domaine y adhérait toujours. Il est moins performant en tant que secrétaire de révision complet : il ne maintiendra pas à lui seul une lettre de réponse de 14 commentaires, ne suivra pas les numéros de ligne du manuscrit et ne se souviendra pas de ce que vous avez concédé au premier tour.
SciSpace est l’un des rares produits qui traite la « réponse aux évaluateurs » comme un processus de premier plan plutôt que comme une invite de chat. Cette focalisation constitue un véritable avantage lorsque vous avez besoin de structure. La limite correspondante est la même que pour tout Agent de rédaction : une production structurée peut encore exagérer un résultat si la couche de preuves sous-jacente est mince.
Consensus est un moteur de recherche de littérature évaluée par les pairs conçu pour trouver, organiser et analyser rapidement des affirmations scientifiques. Il est utile pour le volet « que dit actuellement le domaine ? » d’une réfutation. Ce n’est ni un auditeur de citations ni un outil de mise en forme de lettres.
Jenova's Academic Research Assistant se situe entre ces outils spécialisés. Il peut conserver le manuscrit, le PDF des évaluateurs et la correspondance antérieure dans un espace de travail persistant, effectuer des recherches dans la littérature et rédiger des réponses commentaire par commentaire. Il ne fournit pas nativement de décomptes de citations favorables ou contradictoires de type Scite, et il n’est pas un exportateur de dossier de révision prêt pour Word au sens où le propose le processus de réponse aux évaluateurs de PeerReply. Ce sont des limites réelles. Sa force compensatrice est la continuité : une révision qui dure six semaines a davantage besoin de mémoire que d’un générateur de lettre ponctuel.
Paper Digest mérite d’être ajouté comme spécialiste ciblé. Son orientation vers la vérification des affirmations est plus proche de Scite que d’un chatbot de rédaction, ce qui en fait un meilleur vérificateur de second passage qu’un rédacteur de premier passage.
Comment un moteur de questions-réponses multi-aspects localise-t-il les preuves à l’appui de chaque commentaire ?
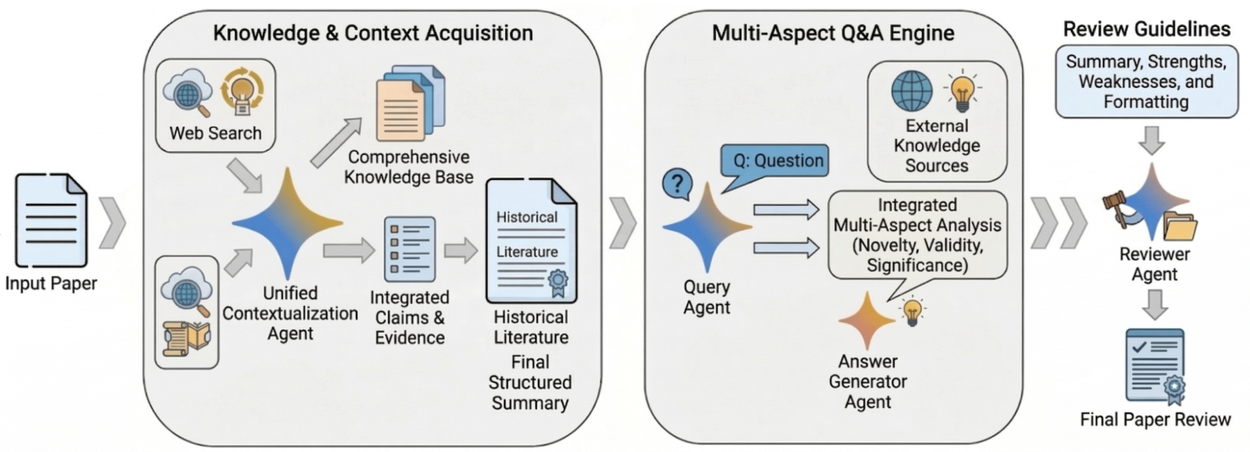
Un système fiable ne se contente pas de « lire les évaluations et rédiger une lettre ». Il transforme chaque commentaire d’évaluateur en requête, effectue des recherches dans trois ensembles de connaissances distincts, puis décide seulement alors si une réponse peut être écrite. C’est précisément ce que montre le diagramme de pipeline ci-dessus : acquisition des connaissances d’abord, questions-réponses multi-aspects ensuite, synthèse en dernier.
Les trois ensembles doivent rester distincts :
- L’ensemble du manuscrit — figures, tableaux, méthodes, limites et toute analyse que vous avez déjà effectuée.
- L’ensemble de l’auteur — notes de laboratoire, contrôles de robustesse supplémentaires, dictionnaires de données et lettres de réponse antérieures.
- L’ensemble de la littérature — articles qui répondent réellement à l’objection de l’évaluateur, récupérés par une recherche de type Scholar plutôt que par la mémoire du modèle.
Mélanger ces ensembles est la manière dont commence la surinterprétation. Une phrase vraie dans la littérature n’est pas un résultat de votre article. Un contrôle de sensibilité dans un carnet n’est pas un tableau publié. Un Agent de requête efficace pose trois questions différentes pour un même commentaire : Cela figure-t-il déjà dans le manuscrit ? Sinon, les auteurs disposent-ils d’éléments non publiés ? Sinon, la littérature justifie-t-elle une affirmation limitée, une révision ou une concession ?
En pratique, l’étape de recherche se présente ainsi avec Jenova's Academic Research Assistant :
- Joignez le manuscrit, la lettre de décision et tout supplément.
- Demandez un inventaire numéroté des demandes des évaluateurs, y compris les demandes implicites.
- Pour chaque demande, imposez une recherche dans les trois ensembles avant toute rédaction :
« L’évaluateur 2, commentaire 3, demande si l’effet persiste après exclusion du sous-échantillon de 2019. Recherchez d’abord uniquement dans le manuscrit joint. Citez le tableau, la section ou la phrase qui y répond. Si rien n’est trouvé, indiquez “absent du manuscrit” et listez l’analyse qui serait nécessaire. Ne citez pas d’articles externes comme s’il s’agissait de nos résultats. »
- Ce n’est qu’après une absence dans le manuscrit que l’Agent doit rechercher dans la littérature ou proposer une nouvelle analyse.
Les produits dédiés à la réfutation suivent une séparation similaire. Manusights soutient que les modèles de langage généralistes restent les outils les plus pratiques pour rédiger la lettre elle-même, ce qui est vrai sur le plan de la prose. Le moteur de preuves doit toutefois se situer avant ce modèle de rédaction. Sinon, la lettre devient une reformulation assurée de ce que le chatbot a trouvé de plus proche, et non de ce que contient le dossier.
La nouveauté, la validité et l’importance — les trois axes d’analyse d’un moteur d’évaluation multi-aspects — sont aussi les trois axes qu’occupent réellement la plupart des commentaires d’évaluateurs. Un commentaire sur des bases de comparaison manquantes relève de la validité. Un commentaire sur une contribution incrémentale relève de la nouveauté. Un commentaire sur la question de savoir si le sujet intéresse quelqu’un relève de l’importance. Étiqueter les commentaires de cette manière évite de répondre à une objection de validité par un paragraphe sur l’importance.
Comment l’AI doit-elle classifier le soutien d’une citation avant de citer une source ?
Chaque citation dans une lettre de réponse doit recevoir l’une de quatre étiquettes avant d’être autorisée dans le brouillon : étayée, partiellement étayée, non étayée ou incertaine. Si le système ne peut pas attribuer d’étiquette, il ne doit pas attribuer de note de bas de page.
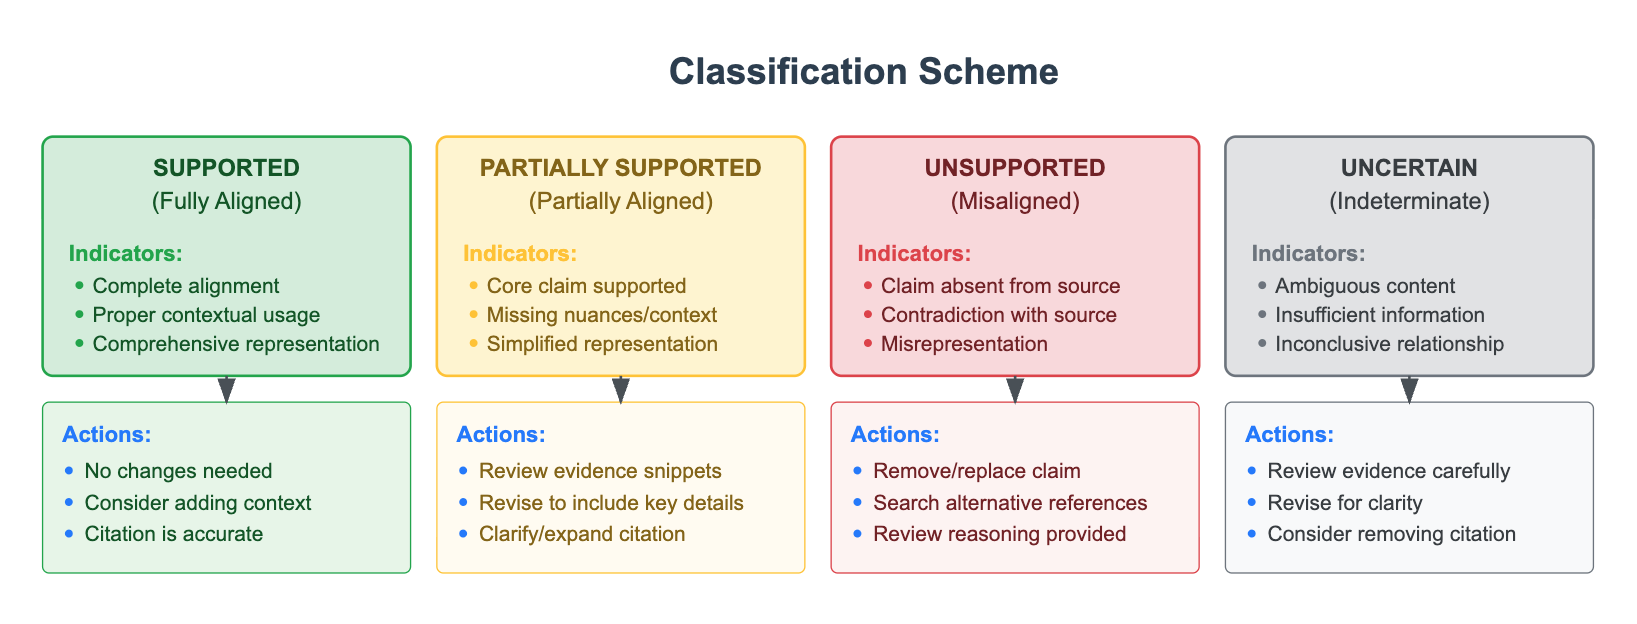
Cette classification constitue la différence entre un vérificateur de citations et un vérificateur d’affirmations.
Étayée signifie que la source formule l’affirmation avec la même portée, la même population et le même degré de causalité que celui que vous vous apprêtez à employer. Action : conservez la citation. Envisagez d’ajouter une brève proposition de contexte afin que l’évaluateur voie l’alignement.
Partiellement étayée signifie que le fait central figure dans la source, mais que votre phrase a omis une réserve, une restriction d’échantillon ou un résultat secondaire contradictoire. Action : réécrivez la phrase pour inclure la nuance manquante, ou remplacez la citation par une meilleure source primaire. C’est l’étiquette honnête la plus fréquente dans les réfutations réelles, et celle que les chatbots génériques réduisent à « étayée ».
Non étayée signifie que l’affirmation est absente, contredite ou utilisée d’une manière que la source n’autorise pas. Action : supprimez ou remplacez. Ne conservez pas la citation parce que la liste des auteurs est prestigieuse ou que le DOI se résout.
Incertaine signifie que le PDF est payant, que la section pertinente est ambiguë ou que la relation entre l’affirmation et la source ne peut pas être déterminée à partir du texte disponible. Action : ouvrez l’article ou supprimez la citation. L’incertitude n’est pas une forme atténuée de soutien.
Scite met en œuvre un cousin proche de ce système à l’échelle de la littérature en indiquant si des articles ultérieurs étayent, contestent ou discutent un résultat. C’est inestimable pour les citations externes. En revanche, l’outil ne classe pas vos propres nouvelles phrases par rapport à vos propres figures. Pour les affirmations internes au manuscrit, le système à quatre étiquettes doit être appliqué par le processus de rédaction lui-même.
Une invite qui impose ce système :
« Pour chaque phrase que vous proposez dans la réponse à l’évaluateur 1, produisez : (1) la phrase, (2) la citation, (3) une citation textuelle de la source ou du manuscrit, (4) une étiquette — Étayée / Partiellement étayée / Non étayée / Incertaine, et (5) la réécriture imposée par cette étiquette. N’incluez aucune phrase étiquetée Non étayée. Réécrivez chaque phrase Partiellement étayée avant de me la présenter. »
La comparaison des moteurs de recherche par AI du Columbia Journalism Review a révélé des échecs systématiques de citation, même lorsque les sources nommées étaient des marques reconnues. Les outils académiques sont plus performants que les moteurs de réponse pour le web ouvert sur cette dimension, mais le mode d’échec est identique : le nom d’une source de confiance sert de substitut à une phrase vérifiée. Le filtre à quatre étiquettes existe pour empêcher cette substitution.
Comment rédiger une réponse point par point sans exagérer les conclusions ?
Vous rédigez après l’existence des étiquettes, et vous laissez l’étiquette choisir le verbe. « Montre », « démontre » et « prouve » sont réservés aux affirmations étayées dont la portée correspond. Les affirmations partiellement étayées reçoivent « est cohérent avec », « répond partiellement à » ou « se vérifie sous [restriction indiquée] ». Les affirmations incertaines ne reçoivent pas de verbes. Elles reçoivent un plan ou une suppression.
Une structure claire de lettre de réponse ressemble à ceci :
- Reformulez le point de l’évaluateur dans un langage neutre.
- Indiquez ce que vous avez fait : déjà présent dans l’article, nouvellement analysé ou concédé.
- Renvoyez à un emplacement : page, ligne, tableau, figure ou supplément.
- Citez des travaux externes uniquement si le commentaire porte sur la littérature, et seulement avec une étiquette de soutien.
- Concluez par la modification exacte apportée au manuscrit, ou par une raison limitée expliquant pourquoi vous n’en avez pas fait.
Jenova's Academic Research Assistant peut conserver cette structure tout au long d’une longue lettre si vous lui donnez la contrainte dès le départ :
« Rédigez la réponse à l’évaluateur 2 en utilisant uniquement les éléments Étayés et les éléments Partiellement étayés réécrits du tableau de preuves. Utilisez la liste de verbes que j’ai fournie. Chaque paragraphe doit comporter un repère dans le manuscrit ou une concession explicite. Ne présentez pas des expériences futures comme si elles étaient terminées. Ne décrivez pas la section Discussion d’un article cité comme s’il s’agissait de notre résultat. »
Pour SciSpace ou un modèle généraliste utilisé comme rédacteur de lettres, cette même contrainte doit être collée dans l’invite, car les produits de rédaction optimisent l’exhaustivité et la politesse. C’est par souci d’exhaustivité que des analyses fantômes apparaissent. C’est par politesse qu’un désaccord est transformé en « nous sommes d’accord et avons désormais démontré ».
La prudence de formulation n’est pas décorative. C’est une caractéristique de fidélité. Les formulations nuancées utiles sont précises :
- Nuances de portée : « dans cet échantillon », « sous la spécification linéaire », « parmi les participants disposant d’un suivi complet »
- Nuances épistémiques : « cohérent avec », « n’exclut pas », « fournit un soutien préliminaire »
- Nuances de processus : « nous rapportons désormais », « nous avons ajouté », « nous ne pouvons pas tester avec le plan actuel »
Les transformations interdites dans un brouillon de réfutation comprennent le fait de transformer une corrélation en effet, un contrôle de robustesse en réplication, un résultat non significatif en « aucune différence », et une seule citation favorable en « c’est bien établi ». Les recommandations sur la rédaction académique assistée par AI soulignent que les auteurs restent responsables de vérifier que le texte généré correspond aux affirmations réelles du manuscrit. Les journaux diffèrent quant à la divulgation, mais le résumé des règles des éditeurs par The Conversation indique qu’une aide mécanique courante peut ne pas exiger de citation, tandis qu’un contenu substantiel généré par AI l’exige souvent. Une lettre de réponse qui contient des interprétations de la littérature rédigées par un modèle relève généralement du second cas.
Le guide pratique de ProofreaderPro sur les lettres de réponse a raison au sujet de la structure et du ton. La structure et le ton ne sont pas la partie difficile. La difficulté consiste à refuser de répondre à un commentaire avec plus de force que ne le permet votre tableau. Si l’évaluateur a demandé une stratégie d’identification causale dont vous ne disposez pas, le brouillon honnête est un paragraphe sur les limites et, si cela est faisable, une analyse plus faible mais identifiée — et non une reformulation plus assurée de la régression initiale.
Une invite de second passage qui détecte les exagérations :
« Comparez chaque paragraphe de réponse au tableau de preuves. Signalez toute phrase dont le verbe est plus fort que son étiquette de soutien. Signalez toute citation qui n’est pas accompagnée d’une citation textuelle. Signalez toute promesse qui ne correspond pas à une modification suivie du manuscrit. »
Que disent les spécialistes de l’intégrité de la recherche à propos des réfutations assistées par AI ?
Les chercheurs qui travaillent sur l’intégrité de l’évaluation par les pairs reviennent sans cesse au même point : l’AI peut accélérer la recherche et la mise en forme, mais l’auteur reste responsable de la valeur de vérité de chaque phrase renvoyée au rédacteur.
« L’échec que nous observons est rarement une virgule manquante dans la liste de références. C’est une phrase qui est un degré épistémique trop forte pour l’article qu’elle cite. Un modèle récompensé pour son utilité comblera cet écart à votre place, sauf si vous le lui interdisez. Le contrôle le moins coûteux est architectural : récupérer, étiqueter, puis rédiger. Si vous inversez cet ordre, la lettre contiendra des affirmations que vous tenterez seulement de justifier plus tard. »
« Les outils de citations intelligentes ont modifié le coût de vérification du maintien du consensus autour d’un article. Ils n’ont pas modifié le coût de vérification du fait que votre propre tableau 3 étaye le verbe du paragraphe 6 de la réponse. Ce second contrôle reste la lecture humaine d’un nombre à côté d’une phrase. Les auteurs qui le sautent ne gagnent pas du temps. Ils l’empruntent au cycle d’évaluation suivant. »
« Nous conseillons également aux équipes de conserver un journal des refus. Chaque fois que le modèle veut dire “nous montrons” alors que l’étiquette n’est que partielle, notez la phrase rejetée. Après deux ou trois articles, vous verrez les exagérations par défaut de votre laboratoire — généralement des verbes causaux, des généralisations au-delà de l’échantillon et des revues citées comme s’il s’agissait d’essais. Les instructions personnalisées ne sont qu’une manière d’encoder ce journal. »
— Équipe produit Jenova, conception de processus académiques, huit années de soutien aux systèmes de manuscrits et de citations
Ce conseil est cohérent avec la littérature de recherche sur l’AI dans l’évaluation elle-même. Une revue PMC sur l’AI dans l’évaluation par les pairs souligne que les évaluateurs doivent toujours évaluer de manière critique le contenu généré par AI avant toute décision. La même obligation s’applique lorsque l’AI se trouve du côté de l’auteur dans la lettre de décision. Les auteurs utilisant des modèles de type ChatGPT dans leur correspondance relative à l’évaluation par les pairs sont expressément invités à contrôler les suggestions au regard des affirmations centrales du manuscrit et de l’intégrité de la recherche.
Le test pratique d’Editage sur l’AI appliquée aux réponses d’évaluation par les pairs est utile moins pour établir un classement avec un unique gagnant que pour le schéma qu’il révèle : les modèles peuvent juger qu’une réponse semble complète tout en restant faibles sur la question de savoir si elle est vraie. Le fait de paraître complet est ce qui conduit à soumettre les lettres trop tôt.
Quand faut-il remplacer une réponse aux évaluateurs rédigée par AI ?
Vous devez remplacer le brouillon chaque fois que l’étiquette de soutien est plus faible que la phrase, que le commentaire demande un jugement que le modèle ne peut pas étayer, ou qu’acquiescer vous engagerait sur une affirmation que vous ne pourrez pas défendre au cycle suivant. Remplacer le brouillon est le chemin normal, et non un chemin d’exception.
Remplacez-le immédiatement dans les cas suivants :
- L’Agent cite un article que vous n’avez pas ouvert.
- L’Agent répond à une critique méthodologique par un texte d’introduction supplémentaire et aucun nouveau test.
- L’Agent traite l’incompréhension d’un évaluateur comme une demande de citations supplémentaires au lieu de réécrire votre explication.
- L’Agent « trouve » une analyse qui ne figure pas dans le dépôt.
- L’Agent accepte les demandes de deux évaluateurs qui sont incompatibles, sans signaler le conflit.
- L’Agent utilise un article de revue pour étayer une affirmation empirique primaire.
Certains commentaires ne doivent jamais être entièrement délégués. Les demandes portant sur l’éthique de la recherche, l’accès aux données, les conflits d’intérêts et la signification clinique ou politique d’un résultat exigent une décision humaine sur ce que vous êtes prêt à défendre. L’AI peut rassembler les documents. Elle ne peut pas en accepter la responsabilité.
Un problème inverse se développe également : les auteurs rencontrent désormais des commentaires d’évaluateurs qui paraissent eux-mêmes générés par AI. La réponse correcte reste centrée sur les preuves. Reformulez la demande scientifique exploitable contenue dans le commentaire, ignorez le remplissage générique et répondez à la demande que vous pouvez documenter. Répondre à une évaluation qui sonne comme de l’AI par une lettre qui sonne comme de l’AI ne fait que doubler le texte non étayé dans le dossier.
Une clôture humain-dans-la-boucle praticable pour chaque commentaire :
- Lisez la phrase de l’évaluateur et rédigez vous-même un résumé de six mots.
- Acceptez ou rejetez la ligne de preuves de l’Agent avant de lire le paragraphe rédigé.
- Si vous rejetez la ligne, ne modifiez pas le paragraphe. Renvoyez l’Agent à la recherche.
- Si vous acceptez une ligne Partiellement étayée, modifiez vous-même le verbe.
- Insérez seulement ensuite le paragraphe dans la lettre.
Utilisés de cette façon, Jenova's Academic Research Assistant, Scite, Elicit et un Agent de rédaction dédié comme SciSpace sont complémentaires plutôt qu’interchangeables. Les outils de recherche réduisent le risque de manquer un article. La classification réduit le risque d’en faire mauvais usage. Les outils de rédaction réduisent le risque que la lettre soit désorganisée. Aucun d’entre eux ne réduit le risque de surinterprétation à moins que vous refusiez de rédiger à partir d’affirmations sans étiquette.
La norme qui mérite d’être affichée au-dessus de la fenêtre d’invite est assez simple : si vous ne pouvez pas désigner une phrase, un tableau ou une concession qui justifie le verbe, la phrase n’a pas sa place dans la réponse.
Références
- Nature — Plus de la moitié des chercheurs utilisent désormais l’AI pour l’évaluation par les pairs
- Bibliothèque de l’Université de Pretoria — Gestion des citations et risques d’hallucinations de l’AI
- Université de Stellenbosch — Recommandations pour un usage responsable de l’AI dans la rédaction académique
- Scite — Smart Citations et vérification des affirmations au niveau de la phrase
- PoolText — Ce que l’AI peut et ne peut pas faire dans l’évaluation par les pairs, y compris la vérification des références
- ScienceDirect — Comparaison des évaluations par les pairs générées par AI et par des humains
- Elicit — Recherche de littérature par AI et précision d’extraction rapportée
- Bibliothèques de l’Université George Mason — Outils d’AI pour les revues de littérature
- SciSpace — Processus de l’Agent Response to Reviewers
- Consensus — Recherche par AI dans la littérature évaluée par les pairs
- PeerReply — Processus de réponse point par point et de dossier de révision
- Paper Digest — Vérification des affirmations par rapport aux preuves académiques
- Manusights — Meilleurs outils d’AI pour répondre aux évaluateurs
- Columbia Journalism Review — Moteurs de recherche par AI et échecs de citation
- PMC — Rédaction académique assistée par intelligence artificielle
- The Conversation — Recommandations des éditeurs sur l’AI dans les articles de revues
- ProofreaderPro — Comment rédiger une lettre de réponse aux évaluateurs avec l’aide de l’AI
- PMC — Intelligence artificielle dans l’évaluation par les pairs
- PMC — Naviguer dans l’évaluation par les pairs avec ChatGPT 4
- Editage — Tests de l’AI sur les réponses à l’évaluation par les pairs
- ResearchGate — Discussion sur les commentaires d’évaluateurs générés par AI