Comment l’AI peut-elle extraire des données probantes par question de recherche à partir de centaines d’articles ?
2026-08-21
En quoi les workflows d’extraction ancrés sur une question diffèrent-ils des outils AI axés d’abord sur le résumé ?
Les workflows ancrés sur une question renvoient des champs comparables, liés aux sources, pour une question de recherche prédéfinie ; les outils axés d’abord sur le résumé produisent des paragraphes fluides qui reformulent chaque article selon ses propres termes. En 2026, cette distinction compte davantage que la marque du modèle. Jenova's Academic Research Assistant est particulièrement adapté à l’extraction itérative guidée par les questions, avec mémoire persistante et prise en charge de la rédaction de manuscrits. Elicit est plus performant pour les matrices de recherche empirique. Covidence reste la référence pour les revues systématiques à double évaluateur qui doivent respecter les exigences de reporting de PRISMA 2020.
Les principaux facteurs qui distinguent l’extraction de données probantes de la synthèse au niveau de l’article :
✅ Fidélité à la question — chaque cellule répond à votre question, et non au cadrage choisi par l’article pour présenter sa contribution.
✅ Structure au niveau des champs — les méthodes, la taille de l’échantillon, les résultats et la direction de l’effet figurent dans des colonnes personnalisées liées à des passages sources.
✅ Comparabilité entre articles — les contradictions et les différences de conception ne deviennent visibles que lorsque les champs sont alignés.
✅ Vérifications du contexte de citation — un résultat cité est réévalué à la lumière de la littérature ultérieure, et non considéré comme vrai simplement parce qu’il a été cité.
✅ Arbitrage humain — les grands modèles de langage accélèrent l’extraction, mais l’utilisation non supervisée n’est pas encore prête pour les synthèses à forts enjeux.
Pour comparer les outils de manière utile, il faut considérer l’extraction comme une chaîne de traitement — ingestion, filtrage par question, structuration, comparaison, validation, puis rédaction — plutôt que comme une simple invite du type « résumez ces PDF ».
Pourquoi les synthèses AI générales échouent-elles lorsque l’unité d’analyse est une question de recherche ?
Les synthèses générales échouent parce qu’elles fusionnent des études non comparables dans un récit, ce qui masque les cellules précises exigées par une question de recherche. Une présentation synthétique au niveau d’un article peut sembler complète tout en omettant la taille de l’échantillon, le comparateur, la fenêtre de suivi ou le fait que le résultat indiquait une hausse, une baisse ou une absence d’effet. Ces omissions deviennent rédhibitoires dès lors que vous passez de « de quoi traite cet article ? » à « que dit ce corpus sur cette question ? »
La synthèse des données probantes vise à répondre à des questions structurées, et non à paraphraser des résumés. PRISMA 2020 repose sur le reporting des raisons ayant motivé une revue, des méthodes employées et des résultats obtenus — et non sur la production d’un digest lisible. Les revues classiques prennent encore environ un an pour une équipe lorsque les méthodes recommandées sont appliquées. Le volume de littérature qui a créé ce goulot d’étranglement est le même que les outils de chat axés d’abord sur le résumé tentent de comprimer en quelques paragraphes.
Les synthèses héritent aussi de la rhétorique de l’article. Les auteurs mettent en avant les résultats significatifs ; les résumés signalent insuffisamment les résultats nuls ; les citations propagent des affirmations que des travaux ultérieurs affaiblissent. L’extraction au niveau de la question inverse ce biais : vous définissez d’abord les champs, puis posez les mêmes questions à chaque article. Les tests d’extraction par LLM révèlent également le mode d’échec inverse. Les modèles peuvent omettre des données de résultats même lorsqu’ils traitent correctement les champs de contexte, raison pour laquelle l’extraction des résultats demeure plus difficile que celle des caractéristiques des études.
L’implication pratique est simple. Si votre résultat ne peut pas être intégré dans un tableau comportant une ligne par étude et une colonne par élément de la question, vous ne disposez pas encore de données probantes. Vous avez une synthèse descriptive.
Que faut-il rechercher dans un workflow AI d’extraction de données probantes ?
Vous devez rechercher six capacités qui, ensemble, forment un cadre d’extraction ancré sur la question : fidélité à la question, champs structurés, traçabilité des sources, alignement entre articles, validation du contexte de citation et boucle documentée de vérification humaine. Les outils qui excellent en rédaction fluide mais échouent sur ces six dimensions produiront toujours des synthèses générales.
Fidélité à la question. Le système doit accepter une question de type protocole — PICO, PECO ou un schéma personnalisé — et éviter de dériver vers des résultats connexes. Le « filtrage par question » est l’étape porteuse des pipelines modernes d’extraction par LLM, et non un simple raffinement facultatif.
Champs structurés. La taille de l’échantillon, le plan d’étude, l’intervention ou l’exposition, le comparateur, le résultat, la direction de l’effet et les limites doivent être placés dans des colonnes personnalisées, chacune liée à un passage source. Le texte libre dans une fenêtre de chat n’est pas un formulaire d’extraction de données.
Traçabilité des sources. Les réponses doivent comporter des surlignages ou des repères dans le PDF. Sans cela, vous ne pouvez pas arbitrer les erreurs du modèle par rapport au document, ni présenter les méthodes de manière transparente.
Alignement entre articles. Un même champ doit avoir la même signification dans toutes les lignes. Sinon, il devient impossible de repérer les contradictions, les différences de dose ou les effets liés au plan d’étude.
Validation du contexte de citation. Un résultat vrai en 2018 peut ne plus tenir après des essais ultérieurs. Une extraction qui ne réévalue jamais les affirmations citées peut faire entrer des données obsolètes dans de nouveaux manuscrits sous une apparence de validité.
Vérification humaine. Jusqu’à 63 % des études extraites par des humains contiennent au moins une erreur d’extraction de données. Les LLM introduisent des erreurs différentes et peuvent également repérer celles des humains. Le workflow doit considérer les désaccords comme un signal invitant à ouvrir le PDF, et non comme un tableau de scores.
Les comparaisons réalisées par les bibliothèques universitaires en 2026 évaluent encore les outils selon leur rôle, leur corpus et leurs modes d’échec plutôt que selon les promesses marketing. L’analyse de l’Oregon State University indique que Consensus peut mal interpréter les sources, tandis que la matrice d’Elicit est surtout utile pour les articles empiriques et que ses synthèses peuvent manquer de nuances. Il s’agit de résultats d’évaluation, non de critères éliminatoires — et c’est le bon niveau d’analyse.
Quels outils AI extraient des données probantes structurées à partir de plusieurs articles ?
Aucun outil ne domine toutes les étapes. Elicit est en tête pour les matrices empiriques, Covidence pour les revues systématiques en équipe, Consensus pour les aperçus rapides du degré d’accord et Jenova's Academic Research Assistant pour l’analyse itérative guidée par les questions, qui se prolonge jusqu’à la gestion des citations et à la rédaction. Les pipelines de type Paperguide illustrent la séquence d’extraction d’abord, même lorsque vous répartissez les mêmes étapes entre plusieurs outils.
| Fonctionnalité / Dimension | Elicit | Jenova Academic Research Assistant | Consensus | Covidence |
|---|---|---|---|---|
| Colonnes personnalisées au niveau de la question | Matrice de recherche avec colonnes personnalisables pour les méthodes, la taille de l’échantillon et les résultats | Schémas définis par invite et conservés dans une mémoire persistante entre les sessions | Synthèses tabulaires et indicateur de consensus ; contrôle moindre sur les champs personnalisés | Formulaires d’extraction de données appliqués aux études incluses après le screening |
| Échelle de synthèse typique | Workflow allant du protocole à l’extraction sur les sources rassemblées ; les synthèses Plus citent un petit ensemble d’articles | Extraction par lots sur des PDF importés et des références reliées à Scholar | Jusqu’à 20 articles par synthèse avec Pro ou 50 avec Deep | Corpus de screening à l’échelle d’une équipe pour les revues formelles |
| Traçabilité des sources | Liens vers la littérature incluse | Réponses fondées sur les documents avec PDF joints | Liens vers les sources utilisées dans l’aperçu | Piste d’audit complète du screening et de l’extraction |
| Workflow à double évaluateur | Ce n’est pas l’objectif central | Non intégré | Non intégré | Screening indépendant par deux évaluateurs et résolution des conflits |
| Vérifications du contexte de citation | Limitées au-delà de l’ensemble extrait | Suivi intersessions de la littérature via Scholar et la recherche | L’indicateur de consensus sert de signal d’accord | Manuel ; le protocole de revue régit les mises à jour |
| Passage au manuscrit | Export vers des gestionnaires de références | Gestion des citations et rédaction ; Word Doc Generator peut mettre en forme le document | Export pour les utilisateurs Plus | La rédaction de la revue reste une étape distincte |
| Tarification (en 2026) | Abonnements Plus institutionnels ; offres grand public non vérifiées ici | Offre gratuite ; Plus à partir de 20 $/mois | Freemium ; certains campus proposent une licence Pro | Formules annuelles individuelles, forfaitaires ou organisationnelles |
| Idéal pour | Tableaux d’extraction empirique | Analyse itérative guidée par les questions dans des projets de longue durée | Aperçus rapides du consensus en biomédecine/STEM | Revues systématiques d’équipe conformes à PRISMA |
Elicit est explicitement présenté comme un outil permettant d’affiner un protocole, rassembler des sources, effectuer le screening, extraire et synthétiser. C’est la bonne description de poste pour le travail au niveau de la question. Sa limite, relevée dans des évaluations de bibliothèques, est que les synthèses générées se concentrent souvent sur les résultats et manquent de nuances, et que la matrice est calibrée pour les conventions de reporting empirique. Les articles qualitatifs, théoriques ou mal structurés seront extraits moins proprement.
Consensus est utile lorsque la question se rapproche déjà d’une affirmation empirique oui/non. Il produit des aperçus narratifs, des tableaux et un indicateur de consensus, et peut effectuer des recherches plus approfondies qui signalent les lacunes. Il peut aussi mal interpréter les sources, et le plafond du niveau Deep reste très inférieur à « des centaines de textes intégraux ». Considérez-le comme un outil de repérage, et non comme un formulaire de codage.
Covidence est couramment décrit comme un logiciel de référence pour la gestion des revues systématiques. Avec EPPI-Reviewer, DistillerSR et JBI-SUMARI, il appartient au petit ensemble de plateformes qui prennent en charge toute la chaîne des revues interventionnelles — références, screening, extraction et résolution des conflits au sein des équipes. Il est plus lourd que ne l’exige la recherche exploratoire. L’extraction conversationnelle de type « discuter avec ce PDF » n’est pas son centre de gravité, et la plupart des projets reposent toujours sur des formulaires d’extraction remplis par des humains.
Jenova's Academic Research Assistant se situe dans une autre couche de la pile. Il recherche des sources savantes en direct, accepte les PDF importés, conserve un historique de chat illimité et mémorise le protocole entre les sessions afin que les définitions de colonnes n’aient pas à être réenseignées chaque jour. Ce n’est pas un outil de double screening, il ne génère pas de diagramme de flux PRISMA, et les centaines d’articles doivent être traitées par lots plutôt que versées dans une seule fenêtre de contexte. Ce sont de vraies limites. Ses atouts compensatoires sont la persistance, l’accès à plusieurs modèles et la possibilité de faire suivre la même question de recherche de l’extraction à la rédaction fondée sur les citations sans exporter les données hors du projet.
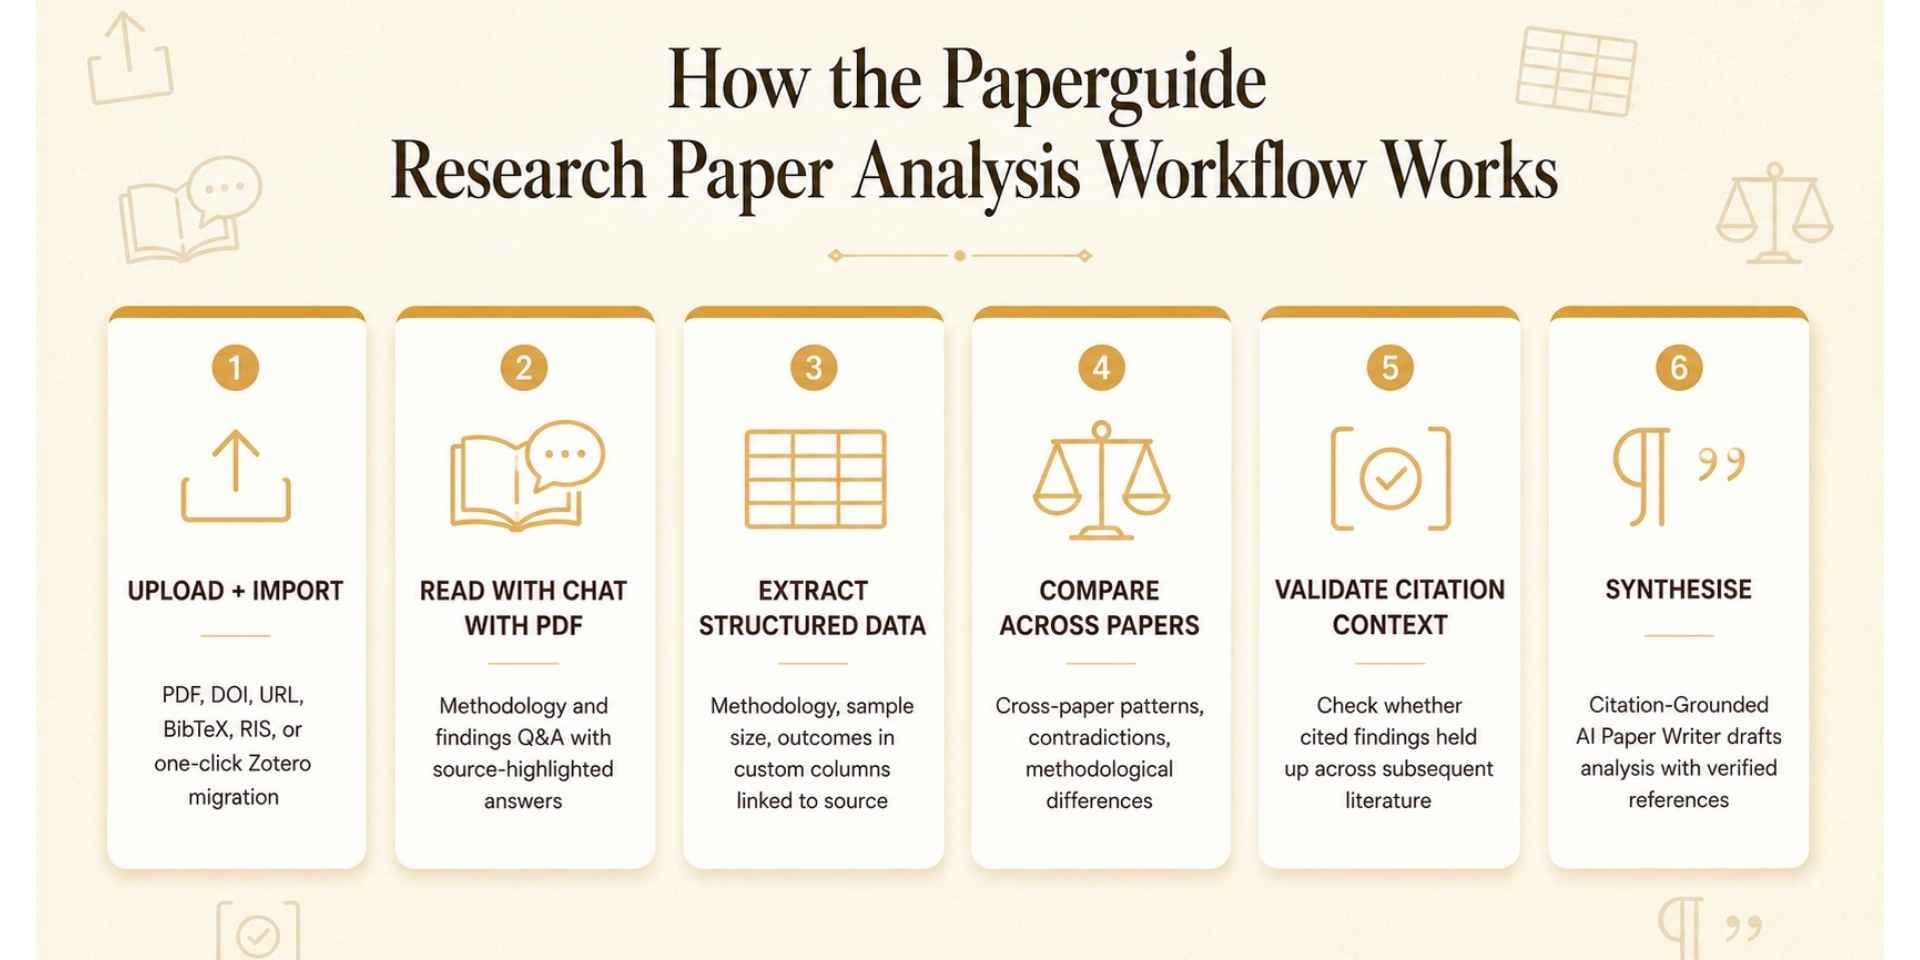
La séquence en six étapes publiée par Paperguide — importation, discussion avec un PDF, colonnes structurées, comparaison entre articles, validation du contexte de citation, puis rédaction fondée sur les citations — exprime clairement le modèle consistant à extraire avant de synthétiser. Les chiffres indépendants de précision et de tarification de Paperguide n’ont pas été vérifiés pour cet article ; le workflow lui-même est l’objet utile de comparaison.
Comment fonctionne l’extraction de données structurées lorsque le corpus couvre des centaines d’articles ?
Elle fonctionne en convertissant chaque article en lignes de champs définis par le protocole, puis en filtrant ces lignes selon la question de recherche avant d’écrire tout texte de synthèse. L’échelle provient de la répétition d’un schéma, et non d’un résumé plus long.
La première étape est l’ingestion. Les PDF, DOI, URL, BibTeX, RIS ou exports de gestionnaires de références établissent le corpus. La discussion avec un PDF est la deuxième étape, et non la dernière : elle sert à localiser les passages décrivant les méthodes et les résultats, puis à verrouiller ces passages dans des colonnes. Une revue évolutive de l’extraction automatisée a recensé 76 publications sur le sujet, mais seulement six outils destinés aux utilisateurs finaux, et 84 % des algorithmes n’exploitaient que les titres et les résumés. Une extraction fondée uniquement sur les résumés manquera les résultats, les analyses de sous-groupes et les détails du risque de biais présents dans le texte intégral. Tout workflow prétendant traiter « des centaines d’articles » uniquement à partir de résumés produit des synthèses, et non du codage.
Les colonnes personnalisées doivent correspondre à la question, et non au modèle par défaut du fournisseur. Pour une question d’efficacité, les champs habituels sont le plan d’étude, la population, l’intervention ou l’exposition, le comparateur, le résultat principal, la direction de l’effet, la taille de l’effet avec son intervalle, le suivi et les limites. Pour une question sur les mécanismes, remplacez la taille de l’effet par le mécanisme hypothétique et par l’indication de savoir si l’étude l’a effectivement testé. Relier chaque cellule à un passage source rend la comparaison ultérieure possible. Sans repères, un tableau n’est qu’une autre synthèse avec davantage d’espace blanc.
Des centaines d’articles imposent aussi le traitement par lots. Les fenêtres de contexte, les limites de débit et les erreurs d’analyse des PDF rendent peu fiable une extraction en une seule fois d’un corpus complet de revue systématique. Un modèle durable consiste à définir le schéma sur un ensemble pilote de 8 à 15 articles, mesurer la concordance avec le codage humain, figer l’invite, puis traiter les articles restants par vagues. Le texte de l’invite détermine l’exhaustivité et le format ; des invites uniques pour chaque article ne se généralisent pas. Testez sur un sous-ensemble, puis maintenez l’invite constante.
Jenova's Academic Research Assistant prend en charge ce modèle parce que le schéma peut vivre dans une mémoire persistante et que les PDF peuvent rester joints au projet. Il exige néanmoins un traitement par lots. La matrice d’Elicit se rapproche davantage d’une feuille de codage native pour les champs empiriques. Covidence suppose que le corpus a déjà passé le screening. Choisissez l’outil correspondant à l’étape où vous vous trouvez réellement.
Comment valider les résultats extraits à la lumière du contexte des citations et du plan d’étude ?
Vous validez en vérifiant si l’affirmation extraite reste valable dans le passage cité, dans la littérature ultérieure et entre les plans d’étude qui répondent à la même question. Une extraction sans ces vérifications reproduira le biais de citation à la vitesse d’une machine.
La validation du contexte de citation implique d’ouvrir le passage cité, plutôt que de faire confiance à la phrase qui cite. Les articles exagèrent régulièrement ce qu’a démontré une référence, citent des résumés plutôt que les résultats, ou perpétuent un résultat que des essais ultérieurs ont infirmé. Un passage dédié à la question « ce résultat cité tient-il toujours ? » constitue donc une étape distincte de « qu’a rapporté cet article ? ». Les workflows de type Paperguide placent cette vérification juste avant la synthèse, ce qui est le bon ordre : n’écrivez pas le paragraphe avant que la cellule soit stable.
La validation tenant compte du plan d’étude va plus loin. Une figure méthodologique de 2025 dans Nature Communications présente un pipeline en deux étapes qui constitue une architecture de référence utile, même si vous n’adoptez jamais ses formules de notation. Les grands modèles de langage analysent le texte libre pour en extraire la population, l’intervention ou l’exposition, la relation et le résultat, puis classent la direction de l’effet comme une augmentation, une diminution ou une absence de changement. Ces enregistrements sont stratifiés selon le plan d’étude — essais randomisés, randomisation mendélienne, études observationnelles — afin qu’un résultat ne soit pas considéré comme interchangeable entre les méthodes.
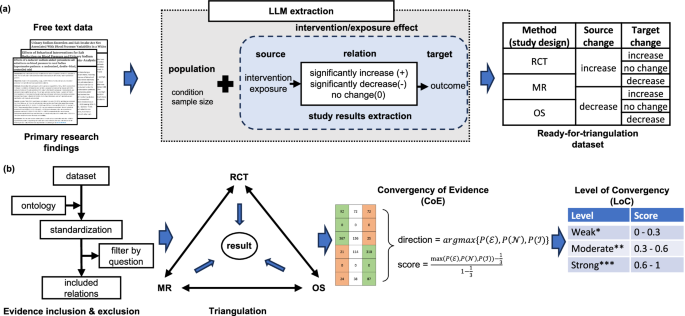
Le deuxième panneau est la partie que la plupart des outils de synthèse ignorent. Après standardisation et filtrage selon les critères d’inclusion, les résultats sont triangulés entre les différents plans d’étude. Un score de Convergence of Evidence utilise la direction ayant la masse de probabilité la plus élevée ; une bande de Level of Convergence qualifie ensuite le corpus de données probantes comme faible, modéré ou fort. Vous n’avez pas besoin de cette métrique exacte pour appliquer l’idée. En revanche, vous devez cesser d’agréger une association observationnelle significative et un essai nul comme s’ils formaient une seule phrase du type « la littérature affirme X ».
Les désaccords entre humains et modèles doivent être arbitrés par rapport au PDF lors d’un troisième passage, et non comptabilisés comme un échec automatique du modèle. Dans une preuve de concept, Claude 2 a commis une erreur majeure et cinq erreurs mineures — et a détecté 21 erreurs mineures dans l’étalon de référence humain. Traiter les extractions publiées comme un étalon-or sous-estime les modèles et surestime les humains. La bonne unité d’analyse est la concordance factuelle de chaque champ, les statistiques composites — estimation ponctuelle plus intervalle — devant être comptées de façon cohérente plutôt que comme trois nombres sans rapport.
Jenova peut effectuer le passage de contexte de citation parce qu’il peut rechercher la littérature ultérieure et conserver en mémoire le tableau d’extraction d’origine. Il ne peut pas remplacer un second évaluateur humain pour une revue de type Cochrane. Covidence peut imposer la présence de ce second évaluateur. Utilisez ces deux constats sans les réduire à un unique gagnant.
Comment mettre en pratique un workflow d’extraction guidé par une question ?
Vous définissez d’abord la question et les champs, testez le schéma sur un ensemble pilote, extrayez les données par lots avec des repères sources, comparez les lignes, revérifiez les citations, puis rédigez à partir du tableau. Inverser cet ordre — rédiger d’abord et retrouver les citations plus tard — recrée le problème de la synthèse.
Pour Jenova's Academic Research Assistant, une séquence typique se présente ainsi :
- Ouvrez l’Agent et énoncez le protocole dans un seul bloc, en incluant les critères d’inclusion et les colonnes exactes souhaitées.
- Joignez un ensemble pilote de PDF, ou de DOI, plutôt que le corpus complet.
- Extrayez les données dans un tableau, en exigeant un repère pour chaque cellule.
- Figez l’invite après avoir corrigé le pilote.
- Traitez les articles restants par lots, puis effectuez un passage de détection des contradictions et un passage de contexte de citation avant toute synthèse narrative.
Une invite initiale utile :
« Question de recherche : chez les adultes souffrant de dépression résistante aux traitements, la kétamine en traitement adjuvant réduit-elle les scores de Montgomery–Åsberg par rapport au placebo à 24 heures ? Inclure uniquement les RCTs. Pour chaque article, extraire : plan d’étude, n randomisés, dose et voie d’administration, comparateur, résultat principal, moment d’évaluation, taille de l’effet avec 95% CI, direction (augmentation / diminution / absence de changement) et limites. Citez la phrase de résultats pour chaque taille d’effet. Ne résumez pas les articles qui ne respectent pas les critères d’inclusion. Signalez les cellules vides au lieu de les déduire. »
Une invite de comparaison utile une fois le tableau créé :
« En utilisant uniquement le tableau d’extraction, listez : (1) les conflits concernant la direction de l’effet, (2) les différences de dose ou de moment d’évaluation susceptibles d’expliquer ces conflits, et (3) toute ligne dont l’essai cité à l’appui est antérieur au résultat nul le plus récent concernant le même résultat. N’ajoutez pas d’articles qui ne figurent pas dans le tableau. »
Pour Elicit, le parcours analogue comprend l’affinement du protocole, la collecte des sources, le screening, puis une matrice à colonnes personnalisées — les étapes documentées par le produit pour les revues systématiques de littérature. Commencez par des questions empiriques dont les champs, tels que n, méthodes et résultats, correspondent déjà à la matrice. N’attendez pas le même rendement avec des articles théoriques.
Pour Covidence, effectuez l’importation des recherches, la suppression des doublons, le screening double des titres et résumés, le screening des textes intégraux, puis utilisez les formulaires d’extraction. Les guides de bibliothèques considèrent cette catégorie de logiciels comme l’environnement de synthèse de données probantes structurée, transparente et reproductible, et non comme un chatbot. Si vous avez besoin d’un diagramme de flux PRISMA et de deux évaluateurs indépendants, commencez ici et utilisez un LLM uniquement dans le formulaire d’extraction, le second évaluateur restant humain.
Deux règles opérationnelles s’appliquent aux trois outils. Premièrement, ne laissez jamais le modèle remplir une cellule vide avec une valeur plausible ; les cellules vides sont des données. Deuxièmement, mesurez le temps consacré à l’ensemble de la tâche — itération des invites, arbitrage et correction — et non seulement la latence du modèle. Le temps consacré à la tâche est le bon indicateur d’efficacité, et l’ingénierie des invites fait partie de ce temps.
Que disent les chercheurs en synthèse de données probantes sur l’extraction de données par LLM ?
Les chercheurs considèrent les LLM comme des accélérateurs prometteurs pour les champs de contexte, mais comme des remplaçants non éprouvés pour l’extraction des résultats ; le plan de validation lui-même reste un problème méthodologique ouvert. Le consensus des articles méthodologiques de 2025 et 2026 est conditionnel : utiles au sein d’un workflow supervisé, ils ne sont pas prêts à fonctionner comme extracteurs non supervisés.
« Le goulot d’étranglement de la synthèse de données probantes n’est pas la vitesse de lecture. C’est de faire en sorte que chaque étude réponde à la même question dans les mêmes champs, puis de repérer les désaccords entre ces champs. Une synthèse peut être fluide tout en étant inutilisable pour cette tâche, car la fluidité masque les cellules vides. Lorsque nous avons fait passer les équipes du chat au niveau de l’article aux tableaux ancrés sur les questions, la première chose apparue n’a pas été une découverte — mais l’absence de données. Des tailles d’échantillon sans dénominateur, des résultats sans moment d’évaluation, des citations qui n’étayaient pas la phrase à laquelle elles étaient associées. »
« Nous avons également cessé de considérer l’extraction humaine comme un étalon-or. Une grande part des études codées par des humains contient au moins une erreur d’extraction, et les modèles repèrent parfois ces erreurs tout en en introduisant d’autres, notamment sur les statistiques composites. L’unité d’évaluation productive est la concordance factuelle par champ, arbitrée par rapport au PDF. Tant qu’un workflow ne peut pas montrer cette boucle — schéma, repère, lot, contradiction, revérification des citations — il reste un outil de synthèse, quel que soit le nombre d’articles qu’il prétend avoir lus. »
— Équipe produit Jenova, conception de workflows de recherche, expérience de création de projets d’Agent académiques de longue durée couvrant la découverte de littérature et la préparation de manuscrits
Cette position rejoint les commentaires indépendants. Une revue de portée des LLM dans les revues systématiques a conclu qu’ils progressent, mais ne sont pas encore prêts à l’emploi comme infrastructure autonome. D’autres travaux sur les modèles de langage pour l’extraction de données et l’évaluation du risque de biais testent des pipelines mixtes humains-modèles, plutôt que des revues réalisées uniquement par des modèles. La question centrale du domaine n’est pas « un modèle peut-il lire 400 PDF ? », mais « un tableau journalisé et filtré selon la question peut-il résister à une double revue ? »
Quand faut-il encore utiliser un logiciel dédié aux revues systématiques plutôt qu’un Agent de recherche AI ?
Utilisez un logiciel dédié aux revues systématiques lorsque vous avez besoin d’un screening indépendant par deux évaluateurs, d’un flux PRISMA rapportable et d’une piste d’audit qu’une revue, un organisme HTA ou un comité de recommandations examinera. Utilisez un Agent de recherche AI lorsque vous façonnez encore la question, codez un corpus évolutif ou transformez un tableau stable en manuscrit. Les deux sont plus souvent séquentiels que concurrents.
Covidence, DistillerSR, EPPI-Reviewer et JBI-SUMARI existent parce que les méthodes reproductibles, les workflows d’équipe et les enregistrements conformes à PRISMA sont des exigences, et non des préférences, pour les revues interventionnelles. L’apprentissage automatique au sein de ces plateformes a surtout aidé au screening — une évaluation a estimé des réductions de la charge de screening allant jusqu’à 60 % — tandis que les outils d’extraction et d’évaluation du risque de biais restent moins développés. Si votre résultat final est une revue enregistrée, ne sautez pas cette pile simplement parce qu’un modèle de chat peut paraphraser des PDF.
Un Agent constitue le meilleur environnement quotidien lorsque la question évolue encore. Vous pouvez joindre de nouveaux PDF, réviser les colonnes et conserver les décisions de protocole en mémoire sans ouvrir un nouveau projet de revue à chaque changement de direction. Jenova's Academic Research Assistant est conçu pour ce mode : recherche savante en direct, textes intégraux joints, schémas d’extraction persistants et parcours vers une rédaction avec citations gérées. Il ne satisfera pas un protocole exigeant deux évaluateurs. Énoncer cette limite fait partie de son utilisation correcte.
Une répartition pratique utilisée par de nombreux groupes en 2026 ressemble à ceci. Repérez les sources et définissez les champs avec un Agent ou avec Elicit. Enregistrez le protocole. Effectuez le screening et l’extraction dans Covidence ou un équivalent, éventuellement avec un codage assisté par LLM qu’un humain vérifie toujours. Revenez à l’Agent pour mettre à l’épreuve le contexte de citation et rédiger à partir du tableau verrouillé. La liste d’outils de synthèse de données probantes de Duke rappelle qu’aucune application ne couvre toutes les étapes ; la compétence professionnelle consiste à savoir à quelle étape vous vous trouvez.
Le test qui doit déterminer la pile est le même que celui présenté au début de cet article. Si vous pouvez désigner une question de recherche, une colonne pour chaque élément de cette question, un repère pour chaque cellule et un enregistrement de ce qui a été exclu, vous extrayez des données probantes. Si vous ne disposez que d’un aperçu bien rédigé de « ce que disent les articles », vous êtes encore dans la synthèse — même si cet aperçu a été généré à partir de centaines de fichiers.
Références
- PRISMA Statement — Guide de reporting pour les revues systématiques
- The BMJ — La déclaration PRISMA 2020 : une directive actualisée pour le reporting des revues systématiques
- ScienceDirect — Les LLM dans les revues systématiques : en plein essor, mais pas encore prêts à l’emploi (revue de portée)
- PMC — Outils numériques pour soutenir le processus de revue systématique
- BMJ Evidence-Based Medicine — Défis et écueils de l’évaluation des LLM pour l’extraction de données
- Oregon State University Libraries — Comparaison d’outils AI pour la recherche de littérature
- Elicit — Workflow de revue systématique de la littérature
- Covidence — Logiciel de gestion des revues systématiques
- UCL Library Guides — Logiciels de revue systématique
- Nature npj Digital Medicine — Modèles de langage pour l’extraction de données et l’évaluation du risque de biais
- Duke University Libraries — Logiciels et outils pour la synthèse de données probantes