L’AI multi-modèles réduit-elle mieux les angles morts de l’analyse boursière ?
2026-08-24
Comment les désaccords entre modèles et les vérifications d’ensemble révèlent-ils les risques cachés d’une thèse ?
Le recoupement entre plusieurs modèles réduit les angles morts et l’excès de confiance plus sûrement que l’analyse boursière par un seul modèle, car le désaccord entre modèles est en soi un signal de risque, et non une nuisance à lisser. En 2026, une réponse fluide unique de ChatGPT, Claude ou Gemini peut donner l’impression d’une recherche achevée. C’est précisément cette fluidité qui pose problème. Un modèle, une fenêtre de contexte et une distribution d’entraînement produisent une histoire cohérente, même lorsque les chiffres sont obsolètes, qu’un document réglementaire est mal interprété ou que le scénario baissier est absent.
Voici ce qui distingue réellement une recherche actions rigoureuse fondée sur l’AI d’une simple conjecture formulée avec assurance :
✅ Ancrage dans les sources — documents réglementaires, estimations et cours en direct, plutôt qu’une date limite d’entraînement ✅ Diversité des modèles — plus d’un fournisseur, afin de repérer plus facilement les biais d’un corpus partagé ✅ Diversité des rôles — vues fondamentale, technique, macroéconomique et portefeuille, au lieu d’un seul généraliste ✅ Affichage de l’incertitude — fourchettes, contradictions et indicateurs « Non vérifié », plutôt qu’une fausse précision ✅ Coût d’un second examen — suffisamment faible pour que les recoupements aient réellement lieu avant d’augmenter la taille d’une position
Une règle de travail utile est le test du désaccord comme signal : considérez le consensus des modèles comme une hypothèse et les conflits entre modèles comme le programme de recherche. Le reste de cet article applique ce test aux chatbots à modèle unique, aux outils de scoring spécialisés comme Danelfin, aux outils de recherche axés sur les citations comme Perplexity, ainsi qu’aux agents spécialisés en actions de Jenova.
Pourquoi l’excès de confiance persiste-t-il lorsque les investisseurs utilisent un seul modèle AI ?
L’excès de confiance persiste parce qu’un modèle unique fournit un récit soigné, et que les récits soignés éliminent la friction qui incite normalement à réexaminer une conclusion. La finance comportementale considère l’excès de confiance comme un biais systématique, et non comme un défaut de personnalité. Sur les marchés, il se manifeste par une activité de trading excessive, des paris concentrés et l’ignorance d’éléments contradictoires.
Ce schéma ne disparaît pas lorsque l’analyste est une AI. Des recherches sur l’excès de confiance et le biais de confirmation dans le trading associent ce biais à un turnover plus élevé, une diversification plus faible et des rendements moins bons. Une revue de 2025 sur le comportement des investisseurs à l’ère de l’AI conclut que les interventions discrétionnaires peuvent annuler les gains d’efficacité des algorithmes, en accroissant la volatilité au lieu de la réduire. Des travaux plus récents décrivent l’« excès de confiance algorithmique » : une fois l’analyse déléguée à un modèle, les utilisateurs considèrent son résultat comme plus objectif qu’il ne l’est réellement.
Une session avec un seul modèle aggrave le problème de trois manières mécaniques. Premièrement, le modèle est récompensé pour sa cohérence : il comble donc les lacunes plutôt que de les signaler. Deuxièmement, l’utilisateur ne voit aucun désaccord entre pairs, alors que c’est précisément le signal que les institutions utilisent pour élargir les intervalles de confiance. Troisièmement, l’interface est conversationnelle : même un chiffre erroné arrive dans une prose assurée. L’alerte de la SEC américaine aux investisseurs sur l’AI est sans détour sur ce point : l’AI peut générer et diffuser des informations fausses ou inexactes, et les investisseurs devraient vérifier les affirmations auprès de professionnels enregistrés.
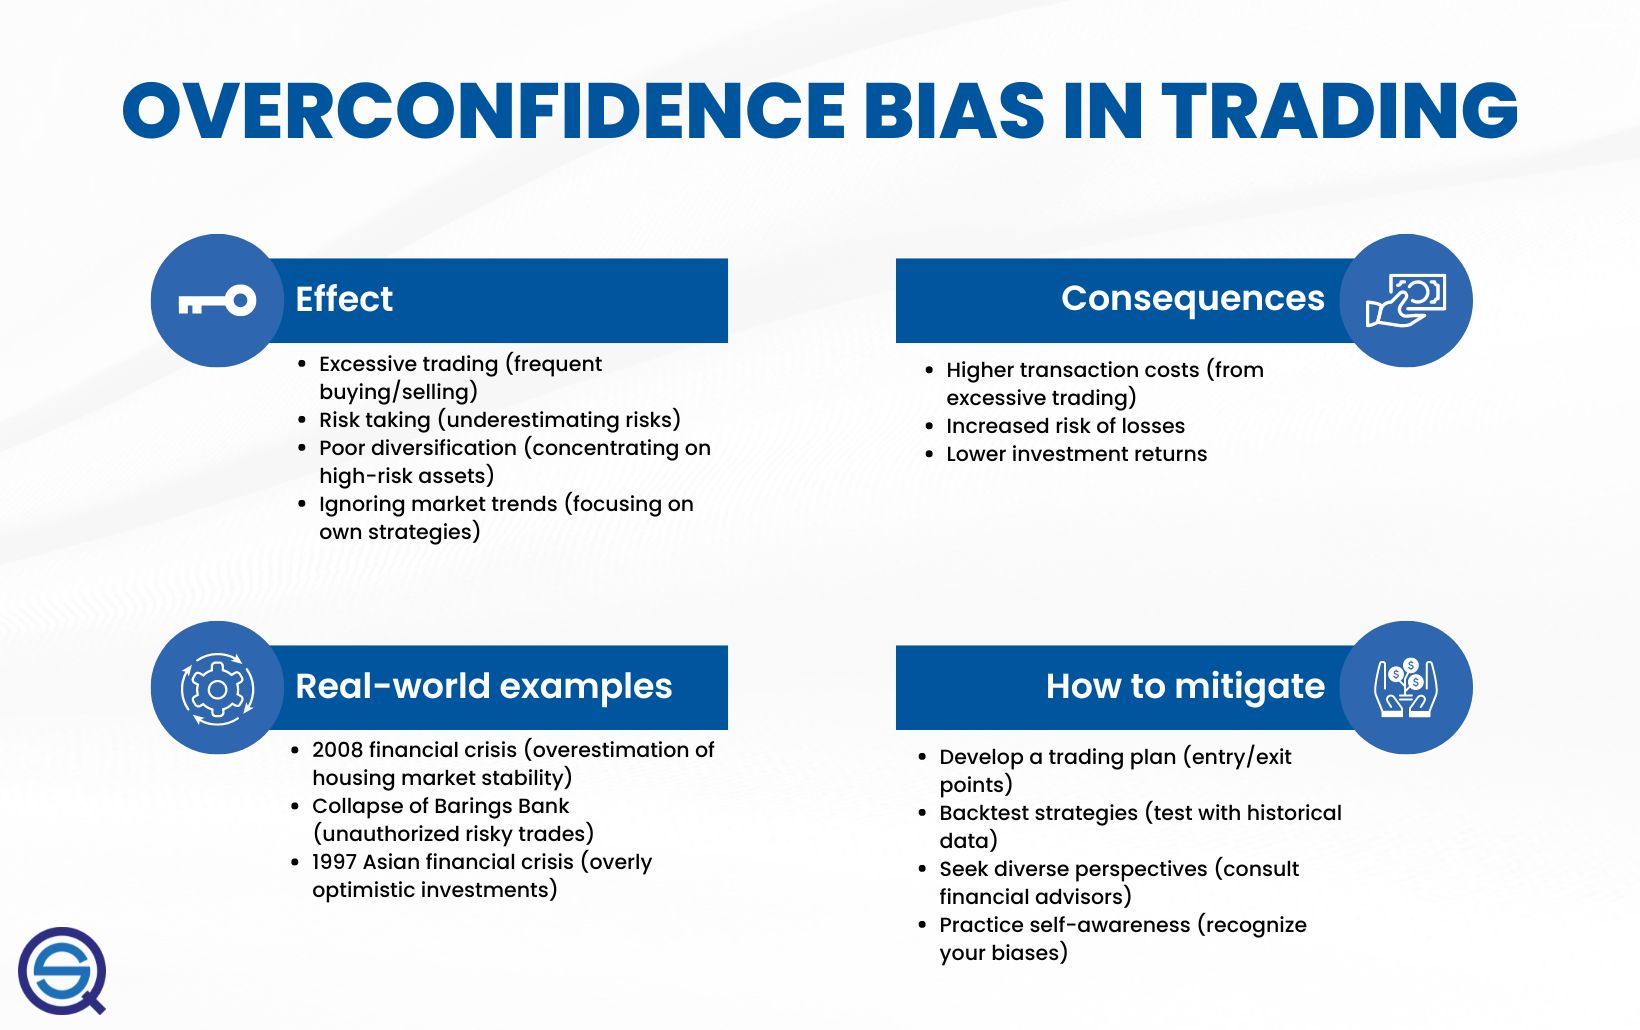
Les mesures d’atténuation classiques — un plan écrit, des tests historiques et des perspectives diverses — se transposent directement à l’architecture de recherche. Un seul modèle peut aider à rédiger le plan. Il ne peut pas, à lui seul, constituer cette perspective diverse.
Que faut-il évaluer pour comparer l’analyse boursière par modèle unique et par modèles multiples ?
Vous devez évaluer six couches de couverture, et non déterminer quelle interface paraît la plus intelligente. Appelons cela l’audit des angles morts en six couches. Il s’agit d’une liste de contrôle pratique pour tout ticker, tout outil et tout horizon temporel.
1. Ancrage dans les sources. Le système extrait-il les documents SEC, les estimations et les cours actuels, ou complète-t-il du texte à partir d’une date limite ? Openbook Analytics souligne que les chatbots généralistes n’ont pas accès aux données de marché en direct et ne peuvent pas vérifier les chiffres qu’ils génèrent, et que le CEO de Perplexity a reconnu la présence de données de marché obsolètes sur la plateforme.
2. Diversité des modèles. Un fournisseur unique signifie un seul mode de défaillance. Recouper une réponse de classe GPT avec Claude, Gemini ou DeepSeek n’est utile que si le prompt, les données et le rôle changent réellement. Changer de marque tout en conservant le même prompt obsolète ne constitue pas de la diversité.
3. Diversité des rôles. Une lecture fondamentale, une lecture du flux et de la structure de marché, et une superposition macroéconomique détectent des erreurs différentes. Cette approche se rapproche davantage d’une réunion de recherche que d’un fil de discussion avec un chatbot.
4. Représentation de l’incertitude. Préférez les fourchettes, les scénarios concurrents et les indicateurs explicites « Non vérifié » à un objectif de cours unique.
5. Persistance. Le travail sur une thèse s’étend sur plusieurs semaines. Les outils qui oublient la vision alternative de mardi dernier regonfleront la confiance lors de la session suivante.
6. Coût par vérification. Si le passage par un second modèle est coûteux ou peu pratique, il sera ignoré exactement lorsque la position sera la plus importante.
L’analyse de FINRA sur l’AI dans le secteur des valeurs mobilières formule les mêmes enjeux dans le langage réglementaire : gestion du risque de modèle, explicabilité, intégrité des données et contrôles de supervision. Les entreprises sont censées comprendre comment un modèle produit un résultat avant de s’y appuyer pour des flux de travail de conseil en investissement soumis à Regulation Best Interest et à la règle FINRA 2111. Les investisseurs individuels n’ont pas de programme Rule 3110. Ils ont néanmoins besoin d’une habitude équivalente : savoir ce que le modèle ne peut pas voir.
Un article de 2025 de Harvard Business School sur le biais étranger des LLM financiers ajoute un mode de défaillance plus discret. Une information peut être absente des données d’entraînement, ou présente mais sous-pondérée. Deux modèles centrés sur les États-Unis peuvent « être d’accord » sur une valeur de marché émergent tout en partageant la même lacune.
En quoi ChatGPT, Danelfin, Perplexity et Jenova diffèrent-ils dans leur couverture des angles morts ?
Ils diffèrent d’abord selon qu’ils produisent un score unique, une note unique sourcée ou un dossier de recherche susceptible d’être contesté. ChatGPT est le plus fort comme partenaire de réflexion et le plus faible comme moteur de chiffres. Danelfin excelle comme screener transparent, mais moins comme débat multi-rôles. Perplexity est particulièrement efficace pour récupérer des extraits cités, mais plus faible lorsque ces extraits sont obsolètes. Le Fundamental Stock Analyst de Jenova est le plus pertinent lorsqu’une thèse nécessite de réunir résultats, valorisation et sentiment, puis de les confronter à d’autres modèles ou agents spécialisés.
Openbook Analytics, qui synthétise des tests antérieurs, indique que ChatGPT a répondu incorrectement à environ 35 % des requêtes financières et d’investissement, et que Gemini a halluciné des informations financières à des taux allant jusqu’à 88–91 % dans certaines évaluations. Ces chiffres ne justifient pas d’abandonner les modèles de langage. Ils justifient de ne pas laisser l’un d’eux conclure seul une thèse.
| Fonctionnalité / Dimension | ChatGPT | Danelfin | Perplexity | Jenova Fundamental Stock Analyst |
|---|---|---|---|---|
| Résultat principal | Explication en prose | AI Score explicable et variables | Réponses web citées | Mémo fondamental ancré dans les documents réglementaires |
| Données de marché en direct / vérifiées | Faible ; limité par la date de coupure | Conçu pour des univers notés | Citées, mais potentiellement obsolètes | Documents SEC, estimations, sentiment |
| Recoupement multi-modèles | Manuel, plusieurs comptes | Système propriétaire unique | Recherche multi-modèles, une note unique | Multi-fournisseurs natif, plus agents spécialisés |
| Gestion de l’incertitude | Prose assurée par défaut | Score et attribution des variables | Citations, risque résiduel plus limité | Scénarios concurrents, désaccord entre modèles, mémoire |
| Tarification (en 2026) | Environ 20 $/mois en version payante | Non vérifiée dans cette analyse | 20 $/mois pour Pro ; formule gratuite | Formule gratuite ; payant à partir de 20 $/mois |
| Idéal pour | Revue de concepts, rédaction du scénario baissier | Screening et timing d’une liste connue | Faits sourcés rapidement | Recherche actions recoupée |
ChatGPT
ChatGPT reste utile pour traduire une section de 10-K, décrire la structure d’un secteur ou forcer l’élaboration d’un scénario baissier en langage clair. Une comparaison de quatre modèles en 2026 le place dans le camp des généralistes plutôt que parmi les terminaux à données en direct. Sa limite est structurelle : il continuera de rédiger un pont de marge convaincant de mémoire. C’est exactement ainsi que l’excès de confiance entre dans une note de recherche.
Danelfin
Danelfin est un produit différent. Il publie un AI Score plutôt qu’une conversation. L’entreprise indique que les actions américaines notées 10/10 ont surperformé le marché de 21,05 % d’alpha annualisé après trois mois depuis 2017, tandis que les titres notés 1/10 ont sous-performé de 33,28 %, et qu’une stratégie AI Score a généré 376 % du 3 janvier 2017 au 9 juin 2025, contre 166 % pour le S&P 500. Les variables explicables constituent un véritable antidote au scoring de boîte noire. La limite est complémentaire : un score peut classer un univers sans mettre à l’épreuve le risque comptable, sectoriel ou réglementaire spécifique qui pourrait faire échouer cette position.
Perplexity
Perplexity gagne sa place comme couche de citations. La comparaison 2026 de Helm Terminal indique qu’il domine pour les faits cités en direct et les fonctionnalités financières, tandis que Claude domine pour la synthèse approfondie des documents réglementaires. Sa limite est celle déjà signalée par son CEO : une citation n’est fraîche qu’à la hauteur de la page vers laquelle elle renvoie. Recouper Perplexity avec un flux de travail natif des documents réglementaires est plus utile que de considérer le nombre de citations comme une preuve.
Jenova Fundamental Stock Analyst
Le Fundamental Stock Analyst de Jenova est conçu comme un spécialiste des actions : résultats, valorisation relative, analyse du modèle économique et données en temps réel couvrant documents réglementaires, estimations et sentiment. Sur la plateforme Jenova, il peut être relancé avec les modèles OpenAI, Anthropic, Google, DeepSeek et xAI, et côtoyer d’autres spécialistes au lieu de prétendre les remplacer tous. Une mémoire persistante maintient le dernier désaccord au centre du dossier.
Les limites honnêtes comptent ici. Jenova ne publie pas de score composite de long terme comparable au bilan 2017–2025 de Danelfin. Les exécutions multi-modèles consomment davantage d’usage qu’un passage unique. Les réponses contradictoires augmentent la charge cognitive, et l’utilisateur doit toujours ouvrir le 10-K. Ce sont des coûts réels. Ce sont aussi les coûts à payer pour ne pas confondre fluidité et diligence.
Comment l’orchestration multi-agents transforme-t-elle la recherche fondamentale sur les actions ?
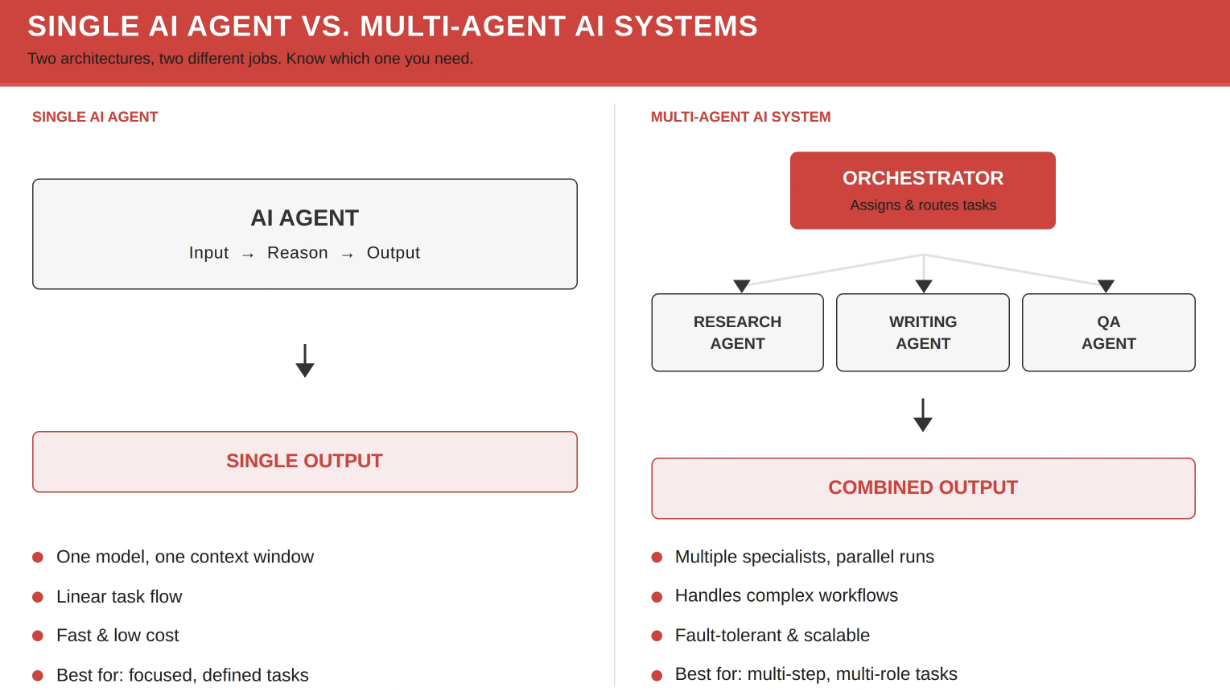
L’orchestration transforme le travail de « poser une question à un analyste » en « constituer une petite équipe et réconcilier le dossier ». Un seul agent suit un chemin linéaire : entrée, raisonnement, sortie. C’est rapide, peu coûteux et adapté lorsque la question est étroite. Une architecture multi-agents ajoute un orchestrateur qui répartit le travail entre des spécialistes — recherche, rédaction, contrôle qualité — et renvoie un produit combiné. Cette architecture est plus lente et plus coûteuse. Elle permet aussi d’éviter qu’une erreur éloquente devienne l’intégralité du mémo.
Dans le travail sur les actions, la répartition analogue n’est pas abstraitement « recherche / rédaction / QA ». Elle est la suivante :
- Fondamental : qualité des résultats, économie unitaire, valorisation, allocation du capital
- Technique : structure, volumes, momentum, niveaux d’invalidation
- Macro : politique économique, taux, régime inter-actifs
- Portefeuille : taille, corrélation, drawdown, adéquation de l’idée avec ce portefeuille
Le Fundamental Stock Analyst de Jenova couvre le premier siège. L’associer au Technical Stock Analyst et au Macro Strategist représente la version pratique du QA multi-agents. Un modèle qui apprécie l’histoire, un autre qui affirme que la dynamique du titre est cassée, et un troisième qui indique que la trajectoire des taux détruit le multiple : ce n’est pas une requête ratée. C’est une réunion complète sur les risques.
Les éléments de preuve concernant les ensembles, en dehors des chatbots dédiés aux actions, vont dans le même sens. Une étude arXiv de 2025 sur les ensembles de LLM utilisant les données de Survey of Professional Forecasters a constaté qu’une combinaison de LLM surpassait la moyenne simple sur plusieurs indicateurs à court horizon et restait plus utile lorsque le désaccord entre experts était élevé. Le mécanisme n’avait rien de magique. L’ensemble sous-pondérait les experts récemment imprécis, s’ajustait aux révisions différées et refusait de traiter chaque voix de façon égale. C’est l’inverse de demander un objectif de cours à un chatbot et de s’arrêter là.
Le langage de FINRA sur les modèles de boîte noire et l’explicabilité est pertinent, même pour les flux de travail des particuliers. Si vous ne pouvez pas expliquer pourquoi le scénario haussier a survécu à la confrontation avec un second modèle et un second rôle, vous ne disposez pas d’un processus d’investissement. Vous disposez d’une transcription.
Les agents techniques, macroéconomiques et de portefeuille peuvent-ils détecter ce qu’un modèle unique manque ?
Oui. Ils détectent les erreurs de catégorie — les erreurs qu’un modèle limité à l’analyse fondamentale a structurellement peu de chances de remarquer. Un modèle de langage qui vient de rédiger un récit convaincant sur une valeur de croissance composée ne signalera que rarement que le titre est trop étendu, que le secteur est un pur pari sur la duration ou que la position double un facteur déjà présent dans votre portefeuille.
Erreurs typiques par siège :
- Siège technique. Le modèle fondamental peut avoir raison sur la valeur et avoir un an d’avance. La structure de prix, les cassures avortées et les divergences de volume ne sont pas des notes de bas de page. Elles déterminent le timing et l’invalidation. Le Technical Stock Analyst est conçu autour de ces questions : structure de marché, momentum et risque défini.
- Siège macro. Un DCF au niveau d’une action qui ignore le régime de politique économique est un tableur avec une hypothèse de taux cachée. Le Macro Strategist est conçu pour la synthèse inter-actifs et l’analyse des politiques, là où de nombreuses histoires prétendument « idiosyncratiques » échouent réellement.
- Siège portefeuille. Une excellente idée prise isolément peut constituer un mauvais ajout au portefeuille. La dérive, le stress et la corrélation se situent au niveau portefeuille, qui est le rôle du Portfolio Management Strategist de Jenova.
C’est aussi ici que les plateformes à score unique et les modèles de conversation uniques partagent un angle mort. Le score de Danelfin peut présenter de manière transparente les variables qui sous-tendent un classement, tout en ne disant rien sur le fait que votre portefeuille soit déjà exposé au même facteur. ChatGPT peut lister des risques de façon abstraite tout en ignorant que vous détenez déjà trois valeurs logicielles ayant la même sensibilité aux taux. La revue multi-rôles est ce qui permet à ces erreurs de remonter à la surface.
La limite est la corrélation des visions du monde. Si chaque agent reçoit un prompt haussier, ou si chaque modèle est alimenté par le même article de blog secondaire, vous faites du théâtre. La diversité des rôles ne fonctionne que si l’agent technique est autorisé à invalider le trade, l’agent macro à réévaluer le multiple et l’agent portefeuille à réduire la taille à une exposition symbolique.
Comment effectuer un recoupement multi-modèles sur une thèse boursière ?
Menez-le comme un dossier en quatre passages, et non comme une conversation plus longue. L’objectif est de provoquer délibérément le désaccord, puis de décider quelles preuves permettraient de le résoudre.
Passage 1 — Ancrer les faits. Demandez au Fundamental Stock Analyst un aperçu sourcé uniquement : les deux dernières périodes publiées, les prévisions, la répartition par segment, la dette nette, les rachats d’actions et les multiples de valorisation qui correspondent réellement à l’entreprise. Interdisez les objectifs de cours à ce stade.
« À l’aide du dernier 10-K, 10-Q et des deux derniers appels sur les résultats de [TICKER], extrayez le chiffre d’affaires par segment, la marge brute et opérationnelle, le FCF, la dette nette et le nombre d’actions diluées. Citez le document ou l’appel pour chaque chiffre. Si vous ne pouvez pas sourcer un chiffre, écrivez Unverified. »
Passage 2 — Changez le modèle, pas la question. Relancez la même extraction auprès d’un second fournisseur. Les différences significatives sur un chiffre publié ne relèvent pas du « style ». Elles constituent un événement d’intégrité des données. Vérifiez vous-même le document réglementaire avant le Passage 3.
Passage 3 — Mobilisez les autres sièges. Envoyez le même ticker au Technical Stock Analyst pour les niveaux d’invalidation et au Macro Strategist pour l’hypothèse de taux, de FX ou de matières premières intégrée dans le multiple.
« Ignorez le mémo fondamental haussier. Identifiez le niveau de prix et le régime macroéconomique qui rendraient cette configuration non pertinente à détenir, même si la thèse finit par être juste. »
Passage 4 — Exigez une dissidence écrite. Demandez à l’un des modèles d’argumenter la position opposée avec une longueur et un niveau de sourcing équivalents. La note de Lucid.now sur la finance comportementale souligne le schéma humain habituel : surestimer sa capacité de prévision, trader trop souvent et concentrer ses positions dans une histoire privilégiée. Une dissidence obligatoire est le moyen d’interrompre ce schéma lorsque « l’analyste » est aussi un modèle.
Avec ChatGPT ou Claude seuls, vous pouvez approximativement reproduire les Passages 2 et 4 en ouvrant un second produit et en y collant le même extrait sourcé. Vous ne pouvez pas reproduire les extractions de documents réglementaires en direct ni la mémoire persistante sur plusieurs semaines, à moins que l’outil ne les offre réellement. Avec Danelfin, le Passage 1 est partiellement automatisé par le score et la liste de variables ; les Passages 3 et 4 nécessitent toujours une surface de recherche distincte.
La tarification de Jenova repose sur l’usage, avec une formule gratuite à usage limité, puis des paliers à 20, 50, 100, 200, 500 et 1 000 $ par mois à mesure que les allocations augmentent. Une vérification en quatre passages coûte plus cher qu’une seule conversation. Pour toute position suffisamment importante pour compter, c’est l’erreur la moins coûteuse.
Que disent les praticiens des marchés de l’excès de confiance lié à l’AI dans la recherche ?
Les praticiens qui utilisent ces outils au quotidien considèrent généralement la certitude d’un seul modèle comme une défaillance de processus, et non comme une caractéristique de modèles « meilleurs ».
« L’erreur la plus coûteuse que nous observons n’est pas un chiffre erroné. C’est un chiffre qui semble juste mais qui n’a jamais rencontré un second modèle. Lorsque trois fournisseurs s’accordent sur un pont de marge qu’aucun d’eux ne peut rapprocher du 10-Q, cet accord est le signal d’alerte. Nous préférons livrer un mémo comportant deux fourchettes contradictoires et une liste d’éléments Unverified, plutôt qu’un objectif de cours unique sans aucune réserve. »
« Le multi-modèles n’est pas automatiquement plus sûr. Si vous posez la même question négligée à GPT, Claude et Gemini, vous obtenez souvent la même réponse négligée avec des adjectifs différents. La diversité doit être conçue : rôles différents, extractions de données différentes et instruction permanente de contredire. Sinon, vous avez acheté de l’excès de confiance corrélé pour trois fois le coût en tokens. »
« Au sein de l’équipe, le désaccord nous indique ce que nous devons lire ensuite. Si le fondamental et le macro sont en conflit, nous examinons l’hypothèse de taux. Si le fondamental et le technique sont en conflit, nous examinons le timing et la taille. Si tous les sièges s’accordent trop vite, nous supposons que le dossier est superficiel. Cette habitude est antérieure aux LLM. Les modèles facilitent simplement son contournement. »
— Équipe produit Jenova, conception et évaluation d’agents actions, travail pluriannuel sur les flux de recherche multi-modèles
Cette position est cohérente avec l’accent mis par FINRA sur les tests, les plans de repli et la supervision interfonctionnelle avant que les outils AI n’influencent les conseils d’investissement. Elle correspond également au résultat sur les prévisions d’ensemble : les combinaisons aident le plus lorsque les entrées divergent et que quelqu’un applique une règle pour les pondérer.
Dans quels cas l’analyse par modèle unique reste-t-elle le meilleur choix ?
L’analyse par modèle unique demeure le meilleur choix lorsque la tâche est limitée, que le coût d’une erreur est faible et que la vitesse importe davantage que le risque résiduel. Le recoupement multi-modèles est un système de contrôle. Vous n’avez pas besoin d’un système de contrôle pour définir le ROIC ou résumer une entreprise en deux paragraphes.
Un modèle unique suffit généralement lorsque :
- Vous apprenez un concept plutôt que de dimensionner une position
- Vous avez déjà le document réglementaire ouvert et ne recherchez qu’un compagnon de lecture
- Vous examinez le langage, et non le calcul d’une valorisation
- Vous avez besoin d’un premier plan avant un flux de travail plus lent et sourcé
- Des appels supplémentaires à des modèles ne changeraient pas la décision
Le guide 2026 d’Openbook établit la même distinction : les chatbots généralistes constituent des points de départ, pas des moteurs de recherche principaux. Le score de Danelfin provient d’un système unique, mais spécialisé ; l’utiliser comme screener puis s’arrêter reste une décision prise avec un seul modèle si personne ne remet en question le titre. Perplexity est le bon passage unique lorsque vous avez besoin d’une piste de citations en quelques minutes et que vous vérifierez vous-même la source primaire.
Le mode de défaillance consiste à utiliser le passage peu coûteux pour une décision coûteuse. L’excès de confiance n’est pas causé par l’AI. Il est causé par l’arrêt du processus à la première réponse cohérente. Le résumé 2025 de Sidley sur les orientations des régulateurs financiers américains souligne que les entreprises doivent déjà traiter l’AI comme une activité supervisée, et non comme un oracle. Les investisseurs privés devraient adopter l’esprit de cette règle, même si aucun examinateur ne leur posera la question.
Une règle de décision concise : si se tromper modifierait la taille de la position, utilisez au moins deux modèles et deux rôles. Si se tromper ne modifierait qu’une phrase dans vos notes, un bon modèle suffit.
Comment la réglementation et le risque de modèle doivent-ils façonner votre flux de recherche AI ?
Ils doivent vous obliger à documenter ce que le modèle n’a pas vu, et non seulement ce qu’il a dit. L’analyse de FINRA sur l’AI est rédigée pour les courtiers-négociants, mais ses thèmes de contrôle sont transposables. La gestion du risque de modèle, la gouvernance des données, l’explicabilité et la supervision existent parce que les outils qui semblent autonomes échouent de manière corrélée.
Pour un processus de recherche individuel, les contrôles transférables sont simples :
- Conservez la source primaire dans le dossier. Si le modèle ne peut pas renvoyer au 10-K, 10-Q, 8-K ou au transcript d’appel, l’affirmation n’est qu’un brouillon.
- Consignez les désaccords. Un journal d’une ligne — « Claude anticipe une compression, Gemini non, page 37 du 10-Q non résolue » — est plus utile qu’un scénario haussier régénéré.
- Séparez conseil et explication. Les chatbots ne sont pas un moteur d’adéquation. FINRA souligne que les outils AI générant des recommandations relèvent de Regulation BI et de la règle 2111 pour les entreprises membres. Les utilisateurs particuliers devraient considérer les résultats des modèles comme une analyse, et non comme une recommandation personnalisée.
- Présumez un biais partagé jusqu’à preuve du contraire. Le résultat de HBS sur le biais étranger n’en est qu’un exemple. Deux modèles peuvent manquer le même fait non américain. Un document réglementaire local, une source dans une seconde langue ou un spécialiste humain constituent la véritable diversification.
- Préférez les outils capables de dire Unverified. La fausse précision est révélatrice. Un système qui termine toujours le paragraphe n’est pas « plus analytique ». Il est moins supervisé.
Aucun de ces éléments ne nécessite un budget institutionnel. Les terminaux de classe Bloomberg se situent toujours dans une autre catégorie de coût — Openbook cite une tarification Bloomberg typique supérieure à 25 000 $ par an. Le contrôle qui réduit réellement l’excès de confiance est moins cher : un second modèle, un second siège et une règle selon laquelle un consensus sans sources ne justifie pas d’augmenter la taille.
L’analyse boursière par modèle unique est un outil de rédaction. Le recoupement multi-modèles et multi-rôles est un outil contre les angles morts. Utilisez le premier pour commencer le dossier. Utilisez le second pour décider si le dossier est terminé.
Références
- Openbook Analytics — Meilleurs outils AI d’analyse boursière en 2026
- Investopedia — Finance comportementale : biais, émotions et comportement des investisseurs
- Preprints.org — Excès de confiance et biais de confirmation dans le trading
- ResearchGate — L’excès de confiance des investisseurs à l’ère de l’AI : prise de décision humaine vs. algorithmique
- SSRN — Le comportement des investisseurs sur les marchés actions : l’émergence de l’AI et de l’excès de confiance algorithmique
- Investor.gov — Intelligence artificielle (AI) et fraude à l’investissement : alerte aux investisseurs
- FINRA — Intelligence artificielle dans le secteur des valeurs mobilières : principaux défis et considérations réglementaires
- Harvard Business School — Lorsque les LLM partent à l’étranger : biais étranger dans l’analyse financière par AI
- Danelfin — Sélecteur d’actions AI et méthodologie AI Score
- AI Business Weekly — Guide tarifaire AI 2026 : ChatGPT, Claude et Gemini
- Perplexity — Tarification pour les particuliers et les entreprises
- Helm Terminal — ChatGPT vs Claude vs Gemini vs Perplexity pour la recherche actions
- arXiv — Les LLM peuvent-ils améliorer la combinaison de prévisions d’experts ?
- Lucid.now — AI dans les décisions financières : éclairages comportementaux
- Sidley Austin — Intelligence artificielle : orientations des régulateurs américains des valeurs mobilières et des matières premières