Les assistants de recherche AI spécialisés sont-ils plus fiables que les chatbots ?
2026-08-22
Comment la traçabilité et l’ancrage distinguent-ils l’AI de recherche des chatbots ?
Les assistants spécialisés de recherche académique sont plus fiables que les chatbots AI généralistes pour la traçabilité des citations et l’extraction des preuves, car ils récupèrent des informations dans des index scientifiques, rattachent les affirmations à des passages identifiables et exposent le contexte qui les étaye ou les contredit. Les chatbots généralistes produisent un langage bibliographique fluide à partir de modèles appris, raison pour laquelle ils inventent encore des auteurs, des titres, des DOI et des résultats impossibles à rattacher à une source.
L’écart de fiabilité ne concerne pas la qualité rédactionnelle. Il porte sur la possibilité d’auditer une affirmation.
Facteurs clés qui distinguent une assistance de recherche citable de la prose d’un chatbot :
✅ Récupération avant génération — les réponses sont assemblées à partir d’articles indexés plutôt que de la seule probabilité du jeton suivant
✅ Attribution au niveau du passage — chaque résultat extrait renvoie à une phrase, un tableau ou une section, et pas seulement au titre d’un article
✅ Visibilité des contradictions — les travaux ultérieurs qui étayent, contestent ou ne font que mentionner une affirmation sont affichés au lieu d’être aplatis dans un résumé unique
✅ Extraction structurée — les méthodes, échantillons, résultats et limites sont extraits dans des champs comparables plutôt que paraphrasés dans des paragraphes
✅ Provenance vérifiable par un humain — chaque résumé, citation et résultat extrait peut être consulté dans la source originale
Pour comparer utilement ces outils en 2026, il faut considérer la fiabilité des citations comme une propriété d’ingénierie, et non comme une promesse de marque. La suite de cet article évalue les chatbots et les assistants de recherche selon cette propriété.
Pourquoi la fiabilité des citations est-elle devenue un problème d’intégrité de la recherche ?
La fiabilité des citations est devenue un problème d’intégrité de la recherche, car l’AI générative est désormais utilisée à l’échelle des publications, tandis que les modèles généralistes fabriquent encore des références suffisamment réalistes pour passer un examen superficiel. L’adoption par les étudiants et les chercheurs a fortement augmenté en 2025, et les citations fabriquées ne sont plus une erreur anecdotique. Elles s’introduisent dans les actes de conférences, les manuscrits et les graphes de citations.
L’enquête étudiante 2025 du Higher Education Policy Institute a révélé que l’utilisation d’outils d’AI générative pour les évaluations est passée de 53 % à 88 % en un an. Une analyse liée à la même enquête indiquait que 92 % des étudiants utilisent désormais l’AI sous une forme ou une autre, contre 66 % en 2024. Ce volume compte, car une fausse référence plausible est plus difficile à détecter qu’une référence absente.
Une analyse de 2026 dans Energy Research & Social Science a indiqué que ChatGPT avait produit 178 références pour des propositions de recherche, dont 69 sans DOI valide. Le même article citait une analyse de GPTZero portant sur 4 841 articles NeurIPS 2025, qui a confirmé au moins 100 citations hallucinées dans 53 articles acceptés. L’évaluation par les pairs, menée par plusieurs experts, ne les a pas détectées.
Le mécanisme est désormais bien décrit. Une hallucination d’AI est une production fluide mais fausse ou non ancrée dans des sources. Les recommandations de bibliothèques universitaires soulignent que les chatbots peuvent inventer une citation entière — auteur, titre et revue. Science a expliqué que les modèles sont entraînés à fournir une réponse même lorsqu’ils n’en connaissent pas. Lorsque l’invite demande de « citer des sources », le modèle reproduit des styles bibliographiques. Pour les sujets spécialisés ou récents, cette reproduction stylistique devient une invention.
Que faut-il évaluer lors du choix d’un assistant de recherche AI ?
Vous devez évaluer un assistant de recherche AI selon sa capacité à rendre chaque affirmation traçable, ancrée, attribuée, confrontée aux contradictions et extractible — et non selon l’élégance de sa prose. Un raccourci utile est le cadre TRACE : traçabilité, ancrage par récupération, granularité d’attribution, prise en compte des contradictions et extractibilité.
La traçabilité consiste à vérifier qu’un lecteur peut passer d’une phrase du brouillon au passage exact qui l’étaye. Si l’outil ne produit qu’une référence mise en forme, il fournit un pointeur, pas une preuve.
L’ancrage par récupération vérifie si le système a interrogé un corpus scientifique ou s’il a échantillonné ses propres poids de modèle. L’extraction ancrée dans les citations est conçue pour empêcher à la fois l’invention sans source et la paraphrase non attribuée en exigeant une attribution explicite de la source pour chaque affirmation extraite.
La granularité d’attribution distingue les citations au niveau de l’article des citations au niveau de la phrase ou du champ. Un article peut être réel alors que le résultat cité est erroné, obsolète ou tiré du résumé plutôt que des résultats.
La prise en compte des contradictions vérifie si l’outil affiche les études ultérieures qui étayent, contestent ou ne font que mentionner l’affirmation. Un seul résumé confirmatif ne constitue pas une revue de littérature.
L’extractibilité vérifie si les méthodes, échantillons, résultats et limites peuvent être comparés dans des champs structurés. Les résumés en prose dissimulent les données manquantes. Les tableaux rendent les lacunes visibles.
Les recommandations de King’s College London sur la synthèse des preuves sont explicites quant à l’implication pratique : les outils AI peuvent soutenir certaines étapes d’une revue, mais ils ne peuvent pas remplacer des méthodes de recherche validées, et les systèmes génératifs créent toujours de fausses références. Une revue de 2025 citée dans ce guide a conclu que les données actuelles ne permettent pas d’utiliser l’AI générative dans la synthèse des preuves sans intervention humaine. La bonne question d’évaluation n’est donc pas « Cet outil sait-il écrire ? », mais « Cet outil peut-il être audité ? »
Comment les assistants de recherche spécialisés se comparent-ils aux chatbots généralistes ?
Les assistants de recherche spécialisés surpassent les chatbots généralistes en matière de traçabilité des citations, car ils relient leurs réponses à des articles récupérés, tandis que les chatbots restent plus performants pour la rédaction, l’explication et le brainstorming. La comparaison honnête est fondée sur les rôles. Les chatbots sont des moteurs de rédaction flexibles. Les assistants de recherche sont des systèmes de récupération plus ciblés et inspectables.
Elicit interroge des millions d’articles académiques et renvoie des rapports structurés avec citations. Il est particulièrement performant lorsqu’un chercheur doit aligner les méthodes, les échantillons et les résultats d’un ensemble d’études. Une comparaison de 2026 liée à Cochrane et citée par King’s College London a montré qu’Elicit ne présentait pas une sensibilité suffisante pour remplacer une recherche bibliographique traditionnelle, même si sa précision le rend utile comme outil complémentaire. Il s’agit d’une limite réelle, pas d’une simple note de bas de page.
Scite est conçu autour de la vérification plutôt que de la rédaction. Il indique couvrir plus de 300 millions d’articles scientifiques et disposer d’un accès sous licence grâce à des accords avec plus de 40 éditeurs. Ses Smart Citations déterminent si des articles ultérieurs étayent, contredisent ou se contentent de mentionner une affirmation. Chaque affirmation produite par son assistant est reliée à la phrase précise de l’article précis. Le compromis concerne l’étendue : Scite est plus fort en intelligence des citations qu’en flux de travail complet pour manuscrits.
ResearchRabbit est particulièrement performant pour la cartographie. Il aide les chercheurs à trouver des articles connexes, à créer des cartes de citations et à observer l’expansion d’un domaine à partir d’un article initial. Il est moins utile comme moteur d’extraction des preuves ou de validation des citations. Ce n’est pas un défaut lorsque la tâche est la découverte.
Les chatbots généralistes tels que ChatGPT restent très utilisés parce qu’ils rédigent rapidement et traitent des questions complexes couvrant plusieurs domaines. Leur faiblesse documentée est l’invention bibliographique. Des analyses récentes, résumées dans l’étude de 2026 sur l’intégrité scientifique, estimaient les hallucinations de citations factuelles pour des modèles avancés tels que GPT-4o et Claude 3.7 entre 15 et 20 %, avec une hausse de 35 à 55 % sur des sujets spécialisés ou récents. Des benchmarks auditant les références scientifiques produites par des grands modèles de langage ont signalé des taux d’erreur supérieurs à 30 % dans certains contextes.
L’Academic Research Assistant de Jenova occupe une position différente. C’est un agent de domaine pour la découverte bibliographique, la préparation de manuscrits et la gestion des citations, avec une mémoire persistante et une recherche en direct dans des bases de données académiques. Il est plus performant qu’un chatbot pour conserver la cohérence d’un projet de recherche entre les sessions. Il est moins performant que Scite pour la classification de citations en texte intégral sous licence, et moins spécialisé qu’Elicit en tant que produit dédié aux tableaux d’extraction. Ces écarts expliquent pourquoi une combinaison d’outils reste plus performante que n’importe quel assistant isolé.
| Fonctionnalité / Dimension | Chatbots généralistes (p. ex. ChatGPT) | Jenova Academic Research Assistant | Elicit | Scite | ResearchRabbit |
|---|---|---|---|---|---|
| Ancrage par récupération | Principalement mémoire du modèle ; la navigation varie selon le produit | Récupération académique et Web en direct au sein d’un agent de recherche persistant | Recherche dans un corpus d’articles avec rapports structurés | Texte intégral scientifique sous licence, plus corpus ouvert | Découverte par graphe de citations à partir d’articles de départ |
| Traçabilité des citations | Souvent invérifiable ou fabriquée | Sources intégrées avec vérification complémentaire dans les originaux | Citations rattachées aux champs extraits | Liens au niveau de la phrase, plus étiquettes d’étayage ou de contradiction | Liens de réseau entre articles, pas de preuves au niveau de l’affirmation |
| Extraction des preuves | Résumés libres | Notes, comparaisons et synthèses prêtes pour un manuscrit | Tableaux structurés très performants | Plus performant pour le contexte de citation que pour l’extraction par champ | Limitée ; privilégie la cartographie |
| Prise en compte des contradictions | Généralement aplatie dans une seule réponse | Peut comparer des résultats contradictoires sur demande | Dépend de l’ensemble récupéré | Fonctionnalité centrale via Smart Citations | Indirecte, via des grappes de travaux connexes |
| Tarification (en 2026) | Non vérifiée selon les forfaits | Offre gratuite ; forfaits payants à partir de $20/mois | Non vérifiée | Non vérifiée | Non vérifiée |
| Idéal pour | Rédaction, explication, cadrage initial | Projets académiques continus nécessitant découverte et mémoire rédactionnelle | Trier des articles dans des tableaux de preuves comparables | Vérifier si une affirmation est étayée ou contestée | Cartographie visuelle de la littérature et découverte d’auteurs ou de grappes |
Un panorama de 2026 des outils d’AI pour la recherche académique est arrivé à une répartition similaire des rôles : Elicit dominait l’extraction structurée, Consensus était le plus rapide pour les vérifications rapides de preuves, et Semantic Scholar restait le meilleur index gratuit de découverte. Aucune colonne de ce paysage ne remplace les autres.
En quoi l’extraction des preuves diffère-t-elle selon les outils académiques d’AI ?
L’extraction des preuves diffère selon que l’outil renvoie des champs comparables ou une simple paraphrase narrative. L’extraction au niveau des champs est plus fiable pour les méthodes, tailles d’échantillon, résultats et limites, car les valeurs manquantes restent visibles. L’extraction narrative est plus rapide et plus lisible, mais elle masque la différence entre un résultat, une interprétation et un détail halluciné.
Elicit est l’exemple le plus clair de l’approche structurée. Il est conçu pour transformer une question de recherche en rapport dont les lignes sont des articles et les colonnes des caractéristiques d’étude. Ce format explique pourquoi les évaluateurs le préfèrent souvent pour le tri préliminaire. Il exige toujours qu’un humain vérifie la logique d’inclusion, car une haute précision n’équivaut pas à un rappel élevé.
Scite extrait un objet différent : le contexte de citation. Au lieu de demander « Qu’a découvert cet article ? », il demande « Qu’ont fait les articles ultérieurs de ce résultat ? ». Cette approche se rapproche davantage de l’évaluation des preuves que de l’extraction de données. Elle est particulièrement utile après l’identification d’un article candidat.
Les chatbots généralistes extraient sous forme de prose. Demandez une comparaison de quatre essais randomisés et ils produiront un paragraphe assuré. Ce paragraphe peut être utile comme première ébauche. Il constitue un mauvais artefact d’audit, car aucun champ ne peut être marqué « non indiqué ».
L’Academic Research Assistant de Jenova et son agent compagnon Deep Research se situent entre ces deux pôles. Deep Research effectue des recherches étendues et renvoie un rapport de synthèse avec des citations intégrées. L’Academic Research Assistant maintient l’état du projet : décisions d’inclusion antérieures, articles rejetés, exigences stylistiques et sections inachevées du manuscrit restent disponibles dans les sessions ultérieures. L’essai de ce flux de travail montre un avantage pratique pour les revues de littérature menées sur plusieurs semaines. Sa limite est tout aussi pratique. Aucun des deux agents n’est un outil dédié au tri des revues systématiques, à la manière d’outils spécialisés comme Rayyan ou DistillerSR, que les bibliothécaires spécialisés dans la synthèse des preuves considèrent toujours comme des options mieux évaluées pour le tri des titres et résumés.
Une invite d’extraction fiable explicite les champs souhaités :
« Extrayez de ces articles : le plan d’étude, la taille de l’échantillon, la population, le critère de jugement principal, le sens de l’effet, les limites déclarées et la phrase exacte qui étaye chaque champ. Si un champ manque, écrivez “non indiqué” au lieu de l’inférer. »
La même invite dans un chatbot reste limitée à la qualité du texte récupéré. Si le modèle n’a jamais ouvert l’article, il remplira le tableau à partir de sa mémoire stylistique.
Que requiert réellement un pipeline de vérification des citations ?
Un pipeline de vérification des citations requiert le document source, et non seulement la chaîne de référence. Le processus minimal consiste à ingérer le texte cité, à le segmenter, à récupérer les passages les plus pertinents pour l’affirmation, à les réordonner et à classifier la relation entre l’affirmation et la preuve. Tout processus moins complet se limite à la mise en forme d’une bibliographie.
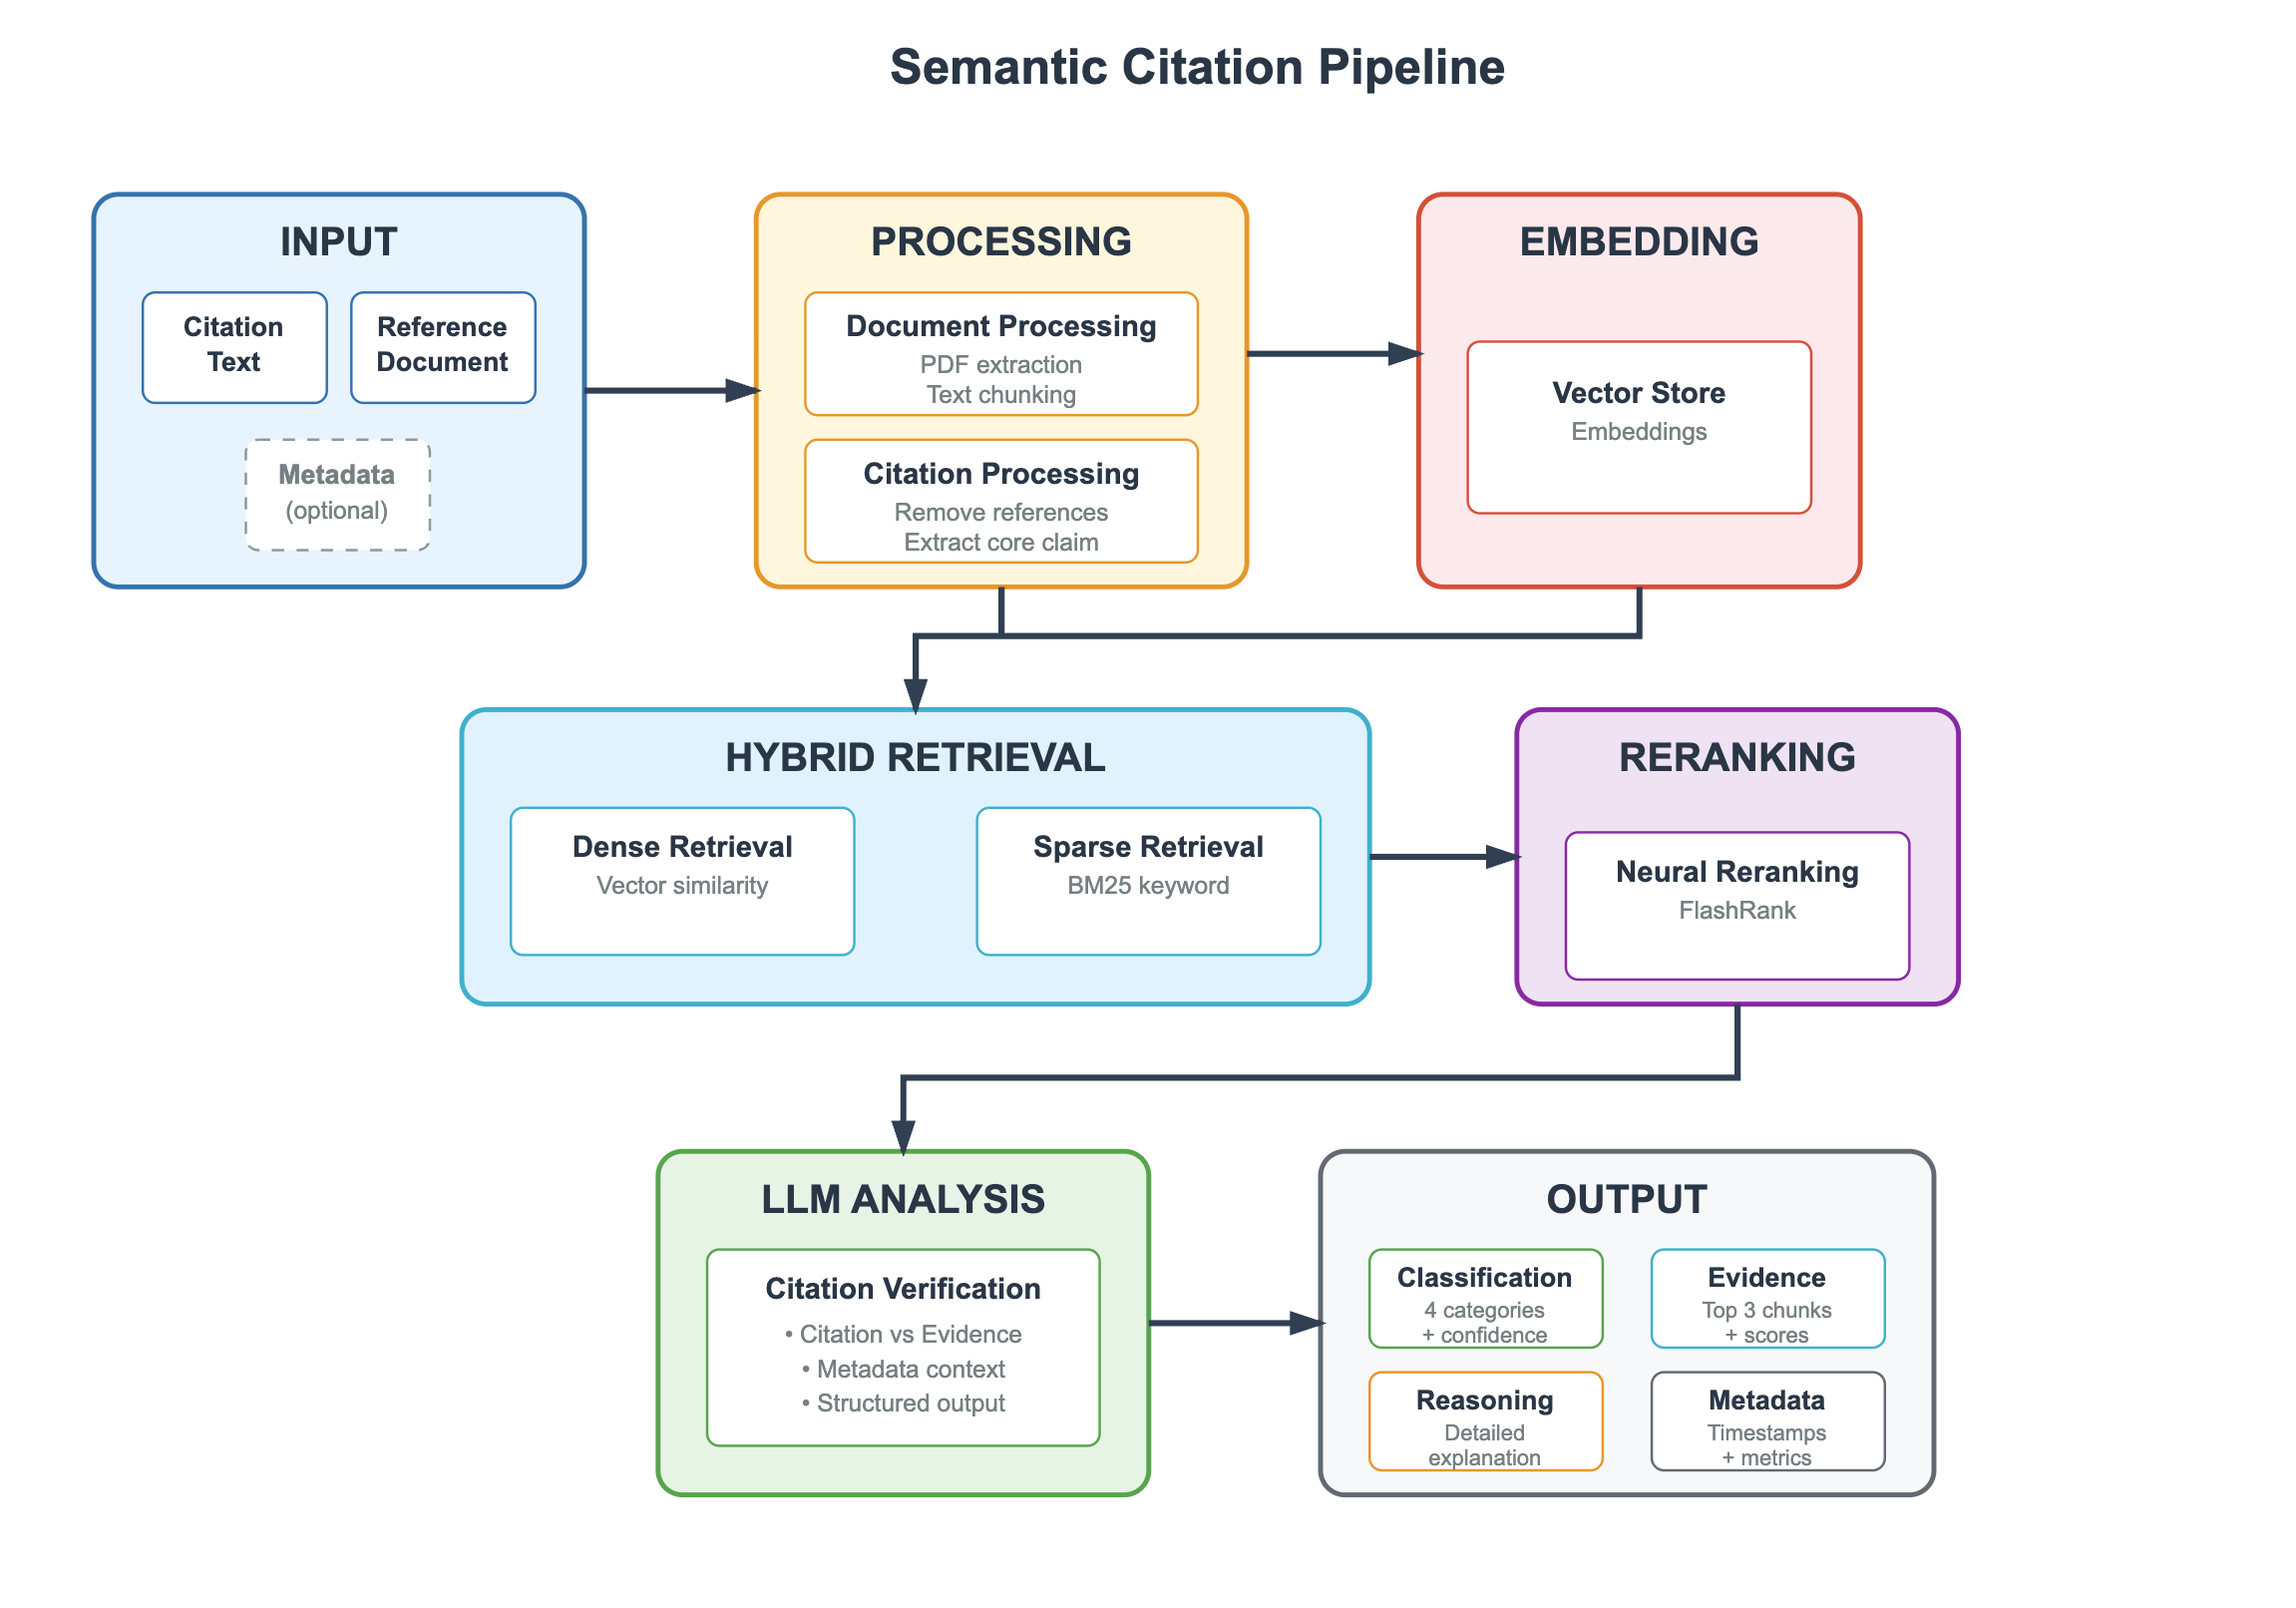
L’architecture ci-dessus fait la différence entre « cette citation semble réelle » et « cette citation est étayée ». L’entrée est l’affirmation, accompagnée du document de référence. Le traitement supprime la bibliographie, extrait l’affirmation centrale et segmente le PDF. La récupération hybride recherche ensuite à la fois la similarité vectorielle et le recouvrement de mots-clés, ce qui est important car les noms de méthodes et les mesures de résultats échouent souvent avec une recherche purement sémantique. Le reranking neuronal conserve les meilleurs passages. Ce n’est qu’ensuite qu’un LLM classe la relation et renvoie des preuves, un niveau de confiance et un raisonnement.
Des systèmes tels que SemanticCite sont développés spécifiquement pour vérifier l’exactitude des citations par l’analyse des sources en texte intégral. Ce choix de conception existe parce que la correspondance de métadonnées ne suffit pas. Un DOI peut être valide alors que la phrase citée provient d’un autre article, d’un résumé de prépublication ou d’un résultat que les auteurs ont ensuite nuancé.
L’infrastructure des éditeurs ne résout pas ce problème automatiquement. Les grandes revues créent déjà des hyperliens vers les références, pourtant les estimations analysées dans l’étude d’intégrité de 2026 évaluent les échecs de DOI, ou la dégradation des liens, jusqu’à 37 % dans des contenus scientifiques échantillonnés. Un lien vert n’est pas une affirmation vérifiée.
C’est également à ce stade que les chatbots généralistes échouent de la manière la plus prévisible. Ils optimisent une réponse complète. Un pipeline de vérification optimise une relation classifiée : étayée, non étayée, contredite ou preuves insuffisantes. Ces quatre étiquettes sont plus utiles scientifiquement qu’un paragraphe soigné, car elles indiquent au chercheur quel type de contrôle reste nécessaire.
Les agents Jenova peuvent exécuter une version légère de cette boucle en récupérant l’article candidat, en citant le passage qui l’étaye et en signalant les affirmations introuvables. Ils ne remplacent pas encore un classificateur de citations en texte intégral sous licence, doté d’une couverture à l’échelle des éditeurs. Les chercheurs qui ont besoin des étiquettes Smart Citations associent toujours un agent de rédaction à Scite plutôt que de demander à un seul système d’assurer les deux fonctions.
Comment construire un flux de travail de littérature assisté par AI plus sûr ?
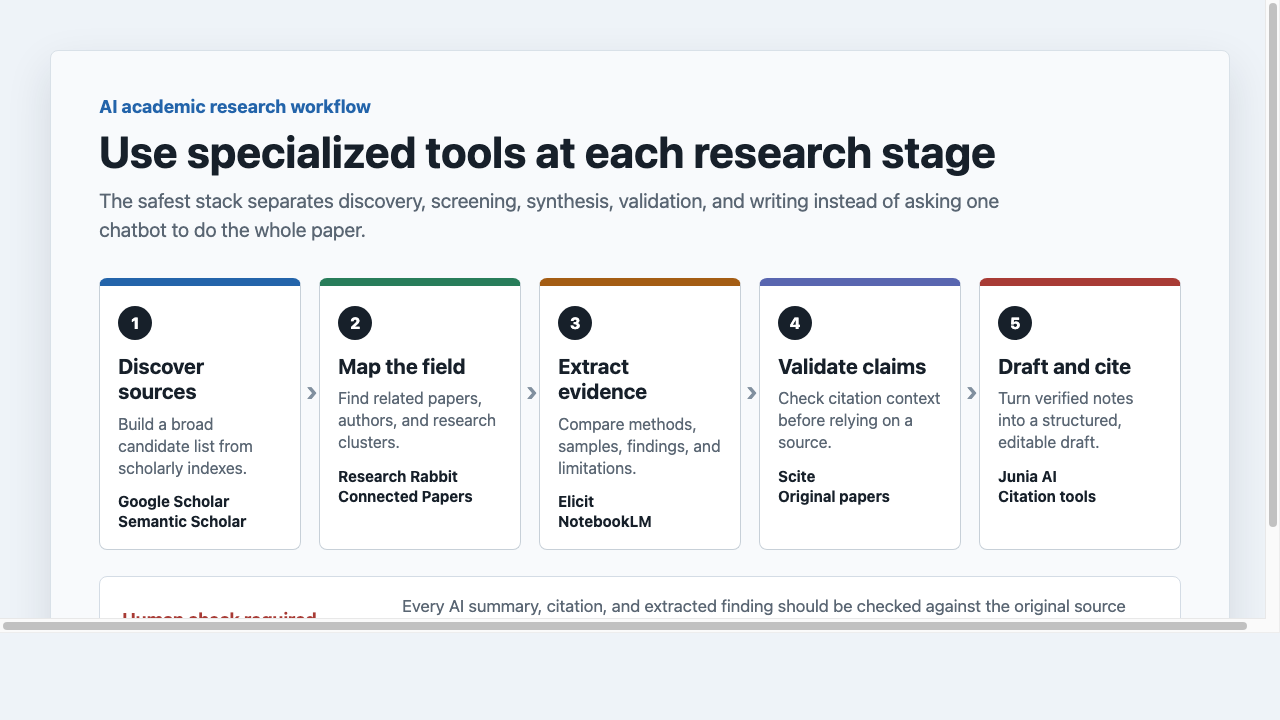
Vous construisez un flux de travail de littérature assisté par AI plus sûr en attribuant chaque étape à un outil vérifiable, puis en contrôlant chaque résultat extrait dans l’article original. Le schéma dangereux consiste à demander à un seul chatbot de découvrir, trier, extraire, valider et rédiger.
Un flux de travail par étapes ressemble à ceci :
- Découvrez les sources dans des index scientifiques tels que Google Scholar ou Semantic Scholar, et non dans une fenêtre de chat.
- Cartographiez le domaine avec ResearchRabbit ou Connected Papers afin de rendre visibles les auteurs et grappes connexes.
- Extrayez les preuves avec Elicit, NotebookLM ou un agent de recherche dans des notes structurées.
- Validez les affirmations dans Scite et dans les PDF originaux avant de considérer une phrase comme citable.
- Rédigez et citez uniquement à partir de l’ensemble de notes vérifiées.
Pour l’Academic Research Assistant de Jenova, la configuration commence par un brief de recherche plutôt que par une visite des fonctionnalités :
- Ouvrez l’agent sur jenova.ai/a/academic-research-assistant.
- Indiquez la question, la discipline et le résultat attendu :
« Je rédige une section méthodologique sur les taux d’erreur de citation des LLM. Privilégiez les études évaluées par les pairs et les analyses d’éditeurs de 2023 à 2026. Pour chaque source, extrayez l’échantillon, la définition de l’erreur, le taux d’hallucination et si des humains ont vérifié les références. »
- Demandez d’abord une liste d’articles candidats, puis des tableaux d’extraction, puis de la prose. Ne passez pas directement au brouillon.
- Conservez les articles rejetés dans le même fil afin que l’agent ne les réintroduise pas ultérieurement.
Pour Elicit, l’équivalent est une question précise accompagnée d’une liste de colonnes : population, intervention, résultat, type d’étude. Pour Scite, partez d’un article ou d’une affirmation connue et examinez les citations qui l’étayent et celles qui la contredisent avant d’écrire. Pour un chatbot généraliste, l’usage le plus sûr est la structuration et la révision linguistique après que les sources existent déjà.
Deux règles opérationnelles évitent la plupart des échecs. Premièrement, n’acceptez jamais une citation qui ne peut pas être ouverte. Deuxièmement, ne laissez jamais le modèle de rédaction devenir le seul registre de ce qu’un article affirme. La note vérifiée est la source de référence. Le brouillon n’est qu’une réorganisation de cette note.
Quand un chatbot généraliste reste-t-il le meilleur outil académique ?
Un chatbot généraliste reste le meilleur outil académique lorsque la tâche concerne la langue, la structure ou l’explication plutôt que les preuves. La fiabilité dépend de la tâche. La traçabilité des citations est un mauvais test pour un modèle de rédaction, tout comme la fluidité de la prose est un mauvais test pour un index de récupération.
Les chatbots restent utiles pour :
- Transformer un plan vérifié en prose académique plus claire
- Expliquer une méthode que le chercheur a déjà lue
- Générer des chaînes de recherche, des contre-arguments ou des listes de contrôle de révision
- Traduire des passages denses dans un langage plus simple pour des notes, mais pas pour les citer
Ils constituent un mauvais moteur principal de recherche bibliographique. Les travaux de classification liés à Nature considèrent les déclarations non étayées des chatbots comme un type distinct d’hallucination, et les recommandations des bibliothèques répètent le même avertissement : les citations fabriquées peuvent contenir un ensemble complet auteur-titre-revue. Ce mode de défaillance est coûteux dans les thèses, les propositions de subvention et les soumissions à des revues, où une seule référence inventée peut discréditer un raisonnement par ailleurs soigneux.
Il existe aussi une raison liée au flux de travail de conserver les chatbots dans la combinaison d’outils. Les outils spécialisés sont plus étroits. Elicit ne travaillera pas le rythme d’un paragraphe. Scite ne mènera pas une conversation d’accompagnement sur un chapitre de thèse pendant tout un semestre. ResearchRabbit ne mettra pas les références au format d’une revue. Un chatbot, ou un agent généraliste de rédaction, comble ces lacunes une fois que les preuves sont verrouillées.
La règle pratique est l’ordre des opérations. Utilisez d’abord la récupération et la vérification spécialisées. Utilisez ensuite un modèle généraliste, uniquement sur un texte dont les sources existent déjà dans une bibliothèque que vous pouvez ouvrir. Si un chatbot introduit une nouvelle citation au cours de la révision, considérez cette citation comme non fiable jusqu’à ce qu’elle passe les mêmes contrôles TRACE que le reste du manuscrit.
Que disent les spécialistes de l’intégrité de la recherche au sujet des citations AI ?
Les spécialistes de l’intégrité de la recherche considèrent les chatbots généralistes comme des aides à la rédaction et les systèmes spécialisés, liés à des sources, comme la seule couche acceptable pour les affirmations qui seront citées. Le consensus n’est pas « évitez l’AI ». Il est : « ne laissez pas un générateur non ancré devenir le registre de ce que dit la littérature ».
« Le problème que nous observons sans cesse n’est pas que les modèles écrivent mal. C’est qu’ils produisent des bibliographies complètes pour des articles qui n’existent pas, ou pour des articles réels qui ne contiennent pas le résultat allégué. Une fois ces chaînes introduites dans un brouillon, elles se comportent comme des preuves. Les évaluateurs, coauteurs et outils de citation ultérieurs peuvent les propager avant que quiconque n’ouvre la source. »
« Un assistant de recherche spécialisé change l’unité de travail. Au lieu de demander un paragraphe avec des citations, vous demandez une affirmation, un passage et une classification : étayée, non étayée, contredite ou preuves insuffisantes. Cette sortie est plus lente et moins élégante. C’est aussi la seule qu’une section méthodologique puisse défendre. »
« La mémoire persistante du projet compte davantage que les gens ne l’imaginent. Les hallucinations réapparaissent souvent dans un article lors des révisions, lorsqu’un chatbot généraliste reçoit la consigne d’“ajouter des sources” à une section déjà propre. Un assistant qui se souvient des articles exclus, et de leurs motifs d’exclusion, accomplit un travail d’intégrité, pas seulement de commodité. Même dans ce cas, le PDF original reste l’autorité. »
— Équipe produit Jenova, flux de travail de recherche académique, travaux pluriannuels sur la conception d’agents ancrés dans les citations
Cette position correspond aux recommandations des bibliothécaires et de la synthèse des preuves. King’s College London conseille d’utiliser l’AI comme outil complémentaire, de vérifier le droit d’auteur avant de téléverser des textes intégraux et de supposer que les outils génératifs peuvent toujours inventer des références et des vedettes-matière. Les analyses au niveau des éditeurs considèrent désormais les références hallucinées comme un problème de corpus, et non comme un phénomène anecdotique. Un commentaire de 2026, s’appuyant sur un examen de Nature portant sur environ 4 000 publications, a indiqué que 65 des 100 articles les plus suspects contenaient au moins une référence invalide, une tendance qui pourrait impliquer plus de 110 000 articles touchés parmi environ 7 millions de publications en 2025.
L’implication pour les experts est opérationnelle. Choisissez des outils qui rendent la vérification peu coûteuse. Rejetez ceux qui donnent l’impression qu’elle est inutile.
Références
- Higher Education Policy Institute — Enquête 2025 sur l’AI générative chez les étudiants
- ERIC / Département de l’Éducation des États-Unis — Enquête 2025 sur l’AI générative chez les étudiants, note de politique HEPI 61
- Boretti, Energy Research & Social Science — Hallucinations dans l’AI générative et intégrité scientifique
- Wikipedia — Hallucination (intelligence artificielle)
- McGoogan Library de l’University of Nebraska Medical Center — Hallucinations d’AI avec citations
- Science / AAAS — Pourquoi les modèles AI hallucinent au lieu d’admettre leur incertitude
- LlamaIndex — Extraction ancrée dans les citations
- Guide de la bibliothèque de King’s College London — Outils AI dans la synthèse des preuves
- Elicit — AI pour la recherche scientifique
- Scite — Recherche fondée sur les citations et Smart Citations
- ResearchRabbit — Cartographie de la littérature et réseaux de citations
- newline — Benchmarks de vérification des références scientifiques produites par les LLM
- Paperguide — Comparaison 2026 des outils AI pour la recherche académique
- arXiv — SemanticCite : vérification des citations par analyse en texte intégral
- Nature Humanities and Social Sciences Communications — Classification des hallucinations d’AI