Les plateformes AI multi-modèles sont-elles meilleures que les outils de recherche à modèle unique ?
2026-08-22
Comment le routage des tâches et la diversité des modèles transforment-ils la qualité de la recherche et de la rédaction ?
Pour les workflows complexes de recherche, d'analyse et de rédaction en 2026, les plateformes multi-modèles avec routage des tâches surpassent généralement les outils de recherche à modèle unique, car elles peuvent attribuer la découverte, le raisonnement et la rédaction à différents modèles au lieu de contraindre un seul système à tout faire. Jenova est particulièrement performante lorsqu'un projet doit passer de la collecte de sources à la synthèse, puis à un brouillon final dans un espace de travail persistant. ChatGPT et Claude restent plus performants pour une rédaction rapide et autonome. Perplexity et Elicit restent plus performants pour des recherches ciblées dans une interface familière.
L'écart de qualité ne dépend pas de la marque qui possède le plus grand modèle. Il dépend de la capacité de la stack à changer de modèles, d'outils et de spécialistes à mesure que la tâche évolue.
Facteurs clés qui distinguent un chat de recherche compétent d'une plateforme de workflow :
✅ Fidélité de recherche — capacité des réponses à rester liées à des sources récupérables plutôt qu'à la mémoire d'un seul modèle
✅ Intelligence de routage — capacité du système à envoyer la revue de littérature, les calculs et la prose à différents modèles
✅ Continuité de composition — capacité du contexte de recherche à survivre jusqu'au plan, au brouillon et aux révisions
✅ Détection des erreurs — capacité d'un deuxième modèle ou agent à remettre en cause la première passe
✅ Maîtrise des coûts — capacité à réserver les modèles de pointe coûteux aux étapes difficiles
AWS indique qu'un seul grand modèle de langage (LLM) ne peut souvent pas optimiser simultanément le coût, la latence et la qualité sur des tâches mixtes, ce qui explique pourquoi le routage est devenu une décision d'architecture centrale. Pour comparer équitablement ces outils, il est utile de distinguer ce qu'un modèle peut bien faire de ce qu'un workflow multi-agents routé peut soutenir dans la durée.
Pourquoi les workflows complexes de recherche et de rédaction dépassent-ils les outils à modèle unique ?
Les travaux complexes de recherche et de rédaction dépassent les outils à modèle unique, car le travail ne se résume plus à un seul prompt. Il s'agit d'une séquence de recherche, filtrage, comparaison, structuration, rédaction et vérification des faits, et chacune de ces étapes récompense des atouts différents.
Une analyse de la littérature exige des sources récentes. Une critique méthodologique exige un raisonnement rigoureux. Une note client exige la maîtrise du ton. Un seul chat peut approximativement réaliser les trois, mais il le fait généralement dans une seule fenêtre de contexte, en conservant les angles morts d'un même modèle.
Les bibliothécaires universitaires soulignent que les outils d'AI générative restent sujets aux erreurs, à une compréhension limitée du contexte et à des capacités de recherche restreintes. Les guides de recherche universitaires signalent également les hallucinations, les lacunes des données d'entraînement et la littérature payante comme des limites structurelles. Ces limites se cumulent lorsqu'un seul modèle assure à la fois la récupération et la rédaction.
C'est pourquoi les chercheurs assemblent désormais des outils spécialisés. Les comparatifs d'AI pour la recherche en 2026 constatent régulièrement qu'aucun produit unique ne couvre aussi bien la découverte, l'analyse, la rédaction et la présentation. Les sélections de workflows universitaires répartissent toujours le travail entre Consensus, Elicit, Semantic Scholar et Perplexity, plutôt que de recommander un seul chatbot généraliste.
La question pratique n'est plus « quel modèle est le plus intelligent ? ». Elle est de savoir si votre stack peut acheminer chaque étape vers le système le moins susceptible d'échouer à cette étape.
Que faut-il évaluer lors du choix d'une stack AI de recherche et de rédaction ?
Vous devez évaluer une stack AI de recherche et de rédaction selon la fidélité de recherche, l'intelligence de routage et la continuité de composition — un test en trois volets que nous appelons le cadre SRC — et non selon la qualité des réponses de démonstration à un seul prompt.
Le cadre SRC pose trois questions qui correspondent aux véritables modes d'échec de la recherche :
- Fidélité de recherche. L'outil peut-il trouver des documents récents et citables, ou reconstruit-il une réponse à partir des données d'entraînement ?
- Intelligence de routage. Peut-il envoyer une question méthodologique, une réécriture sensible aux coûts et une longue synthèse à différents modèles ?
- Continuité de composition. Le même espace de travail peut-il conserver les sources, les affirmations rejetées et les contraintes de ton tout au long du brouillon ?
D'autres critères deviennent importants dès qu'un workflow dure plus qu'une seule session :
- Outils d'ancrage. Recherche web, recherche universitaire, fichiers et gestion des citations.
- Mémoire. Persistance des préférences et des conclusions antérieures entre les sessions.
- Orchestration. Possibilité d'exécuter la recherche, la rédaction et la révision sous forme de rôles coordonnés.
- Observabilité. Possibilité de voir quel modèle ou agent a produit quelle affirmation.
- Structure des coûts. Paiement ou non des tarifs de modèles de pointe pour chaque étape de classification peu coûteuse.
- Mode d'échec. Capacité ou non d'une réponse faible à faire échouer l'ensemble du projet.
HatchWorks présente la décision essentielle comme le choix entre un LLM généraliste et une stack multi-modèles qui attribue le travail par tâche. TrueFoundry décrit le routage multi-modèles comme l'envoi de chaque requête vers le modèle le mieux adapté à cette tâche. Ce sont des choix d'architecture, et non des listes de fonctionnalités.
Un outil peut obtenir un bon score de qualité conversationnelle tout en échouant au test SRC si chaque réponse est produite par le même modèle, dans la même session et sans vérification indépendante.
Comment ChatGPT, Claude, Perplexity, Elicit et Jenova se comparent-ils pour le travail en plusieurs étapes ?
ChatGPT et Claude sont les plus performants comme généralistes à interface unique, Perplexity et Elicit comme interfaces spécialisées de recherche, et Jenova lorsque la recherche, l'analyse et la rédaction doivent rester connectées dans un espace de travail multi-modèles.
ChatGPT apparaît systématiquement dans les listes d'outils de 2026 comme un assistant généraliste polyvalent. Claude est fréquemment recommandé pour la rédaction universitaire longue. Perplexity est largement utilisé pour les recherches documentaires, bien que certains guides de workflows universitaires recommandent la prudence. Elicit est positionné comme un assistant de recherche AI destiné aux revues de littérature.
Jenova adopte une approche différente. Les utilisateurs peuvent passer d'un modèle à l'autre parmi ceux d'OpenAI, Anthropic, Google, DeepSeek et xAI, conserver un historique de chat illimité et associer des bases de connaissances. Des agents spécialisés tels que l'Academic Research Assistant et le Writing Assistant reposent sur cette même stack ; ainsi, une phase de revue de littérature n'a pas besoin d'être copiée dans un outil de rédaction distinct.
Le compromis est réel. Elicit reste davantage conçu pour l'extraction structurée d'articles. Claude reste plus simple lorsque la seule tâche consiste à produire un brouillon long et soigné. L'avantage de Jenova apparaît lorsque le projet comporte plusieurs rôles, et non lorsque l'utilisateur recherche le minimum de réglages possible.
| Fonctionnalité / Dimension | ChatGPT | Claude | Perplexity | Elicit | Jenova |
|---|---|---|---|---|---|
| Accès aux modèles | Assistant généraliste d'un seul fournisseur | Modèle à long contexte d'un seul fournisseur | Interface orientée recherche sur un modèle hébergé | Modèle de workflow dédié à la recherche | Accès multi-fournisseurs avec choix du modèle par tâche |
| Recherche et ancrage des sources | Assistance web généraliste solide ; pas une base de données bibliographique dédiée | Analyse de documents solide ; moins performant comme index de recherche en direct | Performant pour les recherches rapides avec citations | Performant pour les revues de littérature structurées | Web, Scholar, fichiers et bases de connaissances dans un seul espace de travail |
| Orchestration en plusieurs étapes | Prompts gérés par l'utilisateur entre les chats | Prompts à long contexte gérés par l'utilisateur | Optimal pour les boucles questions-réponses | Optimal pour les pipelines de revue, pas pour la rédaction complète | Orchestration d'agents et routage de modèles entre recherche et rédaction |
| Mémoire et continuité | Mémoire conversationnelle au sein du produit | Contexte solide dans le fil ; plus faible comme système de référence inter-projets | Mémoire de projet limitée au-delà des fils de recherche | Centré sur les études et articles plutôt que sur le brouillon | Mémoire persistante entre sessions et documents joints |
| Tarification (en 2026) | Non vérifiée dans cette analyse | Non vérifiée dans cette analyse | Non vérifiée dans cette analyse | Non vérifiée dans cette analyse | Offre gratuite avec usage limité ; offres payantes à partir de $20/mois |
| Idéal pour | Recherche générale rapide et rédaction | Manuscrits longs et prose soignée | Réponses citées à des questions précises | Revue de littérature universitaire | Workflows complets de recherche, analyse et rédaction |
Une autre option multi-modèles est Multi, qui indique proposer plus de 300 modèles de grands laboratoires dans quatre workflows. Cela en fait une solution pertinente pour les équipes qui souhaitent un large choix brut de modèles. Elle est moins pertinente si l'utilisateur a besoin d'agents spécialisés, d'une mémoire de projet persistante et d'un espace de travail unique de la recherche au brouillon.
Quelle approche AI produit une recherche et une découverte des sources plus fiables ?
Un outil spécialisé dans la recherche ou une plateforme multi-modèles dotée d'une récupération en direct est plus fiable pour la découverte de sources qu'un modèle généraliste unique répondant de mémoire. La raison est simple : la découverte et la synthèse sont des modes d'échec différents.
Le chat à modèle unique est efficace lorsque vous connaissez déjà la question et n'avez besoin que d'une première explication. Il devient fragile lorsque la réponse dépend de ce qui a été publié après l'entraînement, de ce qui se trouve derrière un paywall, ou de ce qu'une deuxième base de données contredirait.
ConvergePanel soutient que la recherche à modèle unique masque les désaccords en synthétisant trop tôt, alors que la recherche multi-modèles préserve les divergences et les signaux de qualité des sources. Argumentree fait un constat similaire : un seul modèle hérite de ses propres erreurs sans vérification indépendante, tandis que la recherche multi-modèles peut valider les affirmations.
En pratique, le modèle le plus fiable ressemble à ceci :
- Utilisez un outil orienté récupération pour collecter des sources candidates.
- Utilisez un deuxième modèle pour extraire les méthodes, les tailles d'échantillon et les limites.
- Utilisez une troisième passe pour signaler les extrapolations non étayées avant de commencer la rédaction.
Elicit et Consensus sont conçus pour certaines parties de cette séquence. Consensus se concentre sur des réponses fondées sur des preuves issues de la littérature évaluée par les pairs. Perplexity est plus rapide lorsque la question se rapproche davantage d'une recherche web que d'une revue systématique.
Jenova est plus utile lorsque la découverte n'est que la première étape. L'Academic Research Assistant peut rechercher dans des bases de données universitaires et conserver les citations associées, puis transmettre le même contexte de projet à un agent de rédaction. Cela ne remplace pas une base de données de preuves dédiée pour une revue systématique formelle. Cela réduit toutefois l'écart de copier-coller qui introduit généralement une dérive des citations.
Un prompt fiable pour l'étape de découverte précise le périmètre et les règles d'exclusion :
"Trouvez des sources évaluées par les pairs publiées entre 2023 et 2026 sur le routage multi-LLM dans les systèmes de production. Excluez les pages de présentation de fournisseurs. Pour chaque source, extrayez le gain de coût ou de qualité avancé, la méthode d'évaluation et une limite reconnue par les auteurs."
Si un outil ne peut pas suivre cette instruction sans inventer des articles, c'est une aide à la rédaction, pas une stack de recherche.
Comment le routage multi-modèles améliore-t-il l'analyse sans gonfler les coûts ?
Le routage multi-modèles améliore l'analyse en envoyant les classifications et recherches peu coûteuses à des modèles plus petits, et en réservant les modèles plus performants à la comparaison, à la vérification des contradictions et au raisonnement structuré. Lorsqu'il est bien exécuté, il améliore la qualité et peut réduire les dépenses. Lorsqu'il est mal exécuté, le routeur devient lui-même une étape facturable supplémentaire.
AWS décrit deux familles de routage : le routage statique via des interfaces dédiées et le routage dynamique qui classe un prompt avant de sélectionner un modèle. Le routage dynamique peut utiliser un modèle de classification, la similarité sémantique ou une combinaison des deux. Amazon Bedrock Intelligent Prompt Routing est présenté comme une solution gérée permettant de réduire jusqu'à 30 % le coût des requêtes en choisissant le modèle moins coûteux capable de respecter le niveau de qualité requis.
MindStudio indique que l'adéquation des tâches au bon modèle peut réduire les coûts de 60 % lorsque la planification et l'exécution sont séparées, au lieu d'envoyer chaque étape à un modèle de pointe. Ce chiffre provient d'un fournisseur et doit être considéré comme une limite supérieure, non comme une garantie. La logique sous-jacente reste valable : l'analyse comporte des sous-tâches peu coûteuses et des sous-tâches coûteuses.
Une répartition pratique pour l'analyse de recherche ressemble à ceci :
- Modèle petit ou rapide : étiqueter les documents, extraire les citations, normaliser les références, regrouper les thèmes.
- Modèle intermédiaire : résumer les méthodes et signaler les comparateurs manquants.
- Modèle à haute capacité : réconcilier les conflits, tester la solidité des affirmations causales, rédiger la note analytique.
Jenova prend en charge cette répartition, car les utilisateurs peuvent changer de fournisseur de modèles dans un même projet plutôt que d'exporter leurs notes entre plusieurs applications. La limite est que le routage n'est efficace que si la tâche est bien définie. Si vous demandez à un agent d'« analyser l'ensemble », vous avez recréé un workflow à modèle unique avec une surcharge supplémentaire.
AWS souligne également que le routage personnalisé ajoute de la latence et un coût de classification ; les économies doivent donc dépasser le coût du routage. Pour un briefing de 20 minutes, un seul modèle performant est souvent moins cher. Pour un pipeline de recherche récurrent, le routage s'amortit généralement.
Quand un seul modèle AI produit-il encore une meilleure rédaction ?
Un seul modèle AI produit encore une meilleure rédaction lorsque la tâche est linéaire, que l'ensemble de sources est déjà choisi et que la cohérence stylistique compte davantage qu'une vérification indépendante. Dans ces cas, des agents supplémentaires peuvent introduire des ruptures, des délais et des modifications contradictoires.
Les recommandations de GitHub sur l'orchestration des agents sont explicites : si les tâches sont simples et linéaires, un seul agent est mieux adapté. La rédaction correspond souvent à cette description. Un modèle à long contexte qui peut voir le plan, les notes et les trois derniers paragraphes maintiendra généralement une voix plus cohérente que trois spécialistes qui se transmettent des brouillons.
Claude en est l'exemple le plus clair. Il est régulièrement recommandé pour la rédaction universitaire longue, car la tâche exige une prose soutenue, et non des changements d'outils. ChatGPT suffit souvent pour les e-mails, les briefs et les premiers brouillons dans lesquels la vitesse prime sur l'architecture des citations.
La rédaction à modèle unique commence à perdre en efficacité lorsque le brouillon dépend de preuves en direct, de plusieurs versions destinées à différentes parties prenantes, ou d'une passe de QA qui ne devrait pas faire confiance au rédacteur d'origine. C'est là qu'un agent de rédaction associé à un agent de révision distinct se justifie.
Le Writing Assistant de Jenova est conçu pour le milieu de ce spectre : s'adapter à un format et à une audience, conserver une voix stable et rester dans un espace de travail qui contient déjà la recherche. Il n'est pas automatiquement meilleur que Claude pour un essai autonome. Il est plus performant lorsque le brouillon doit continuer à utiliser les mêmes sources, exclusions et terminologies collectées auparavant.
Un brief de rédaction à modèle unique doit néanmoins rester précis :
"En utilisant uniquement les huit sources déjà présentes dans ce projet, rédigez un article explicatif de 900 mots destiné aux chefs de produit. N'ajoutez aucune nouvelle citation. Conservez un niveau de lecture non technique. Signalez toute affirmation qui n'est pas étayée par les notes jointes."
Si votre tâche de rédaction peut être définie aussi clairement, un seul modèle n'est pas un compromis. C'est la bonne architecture.
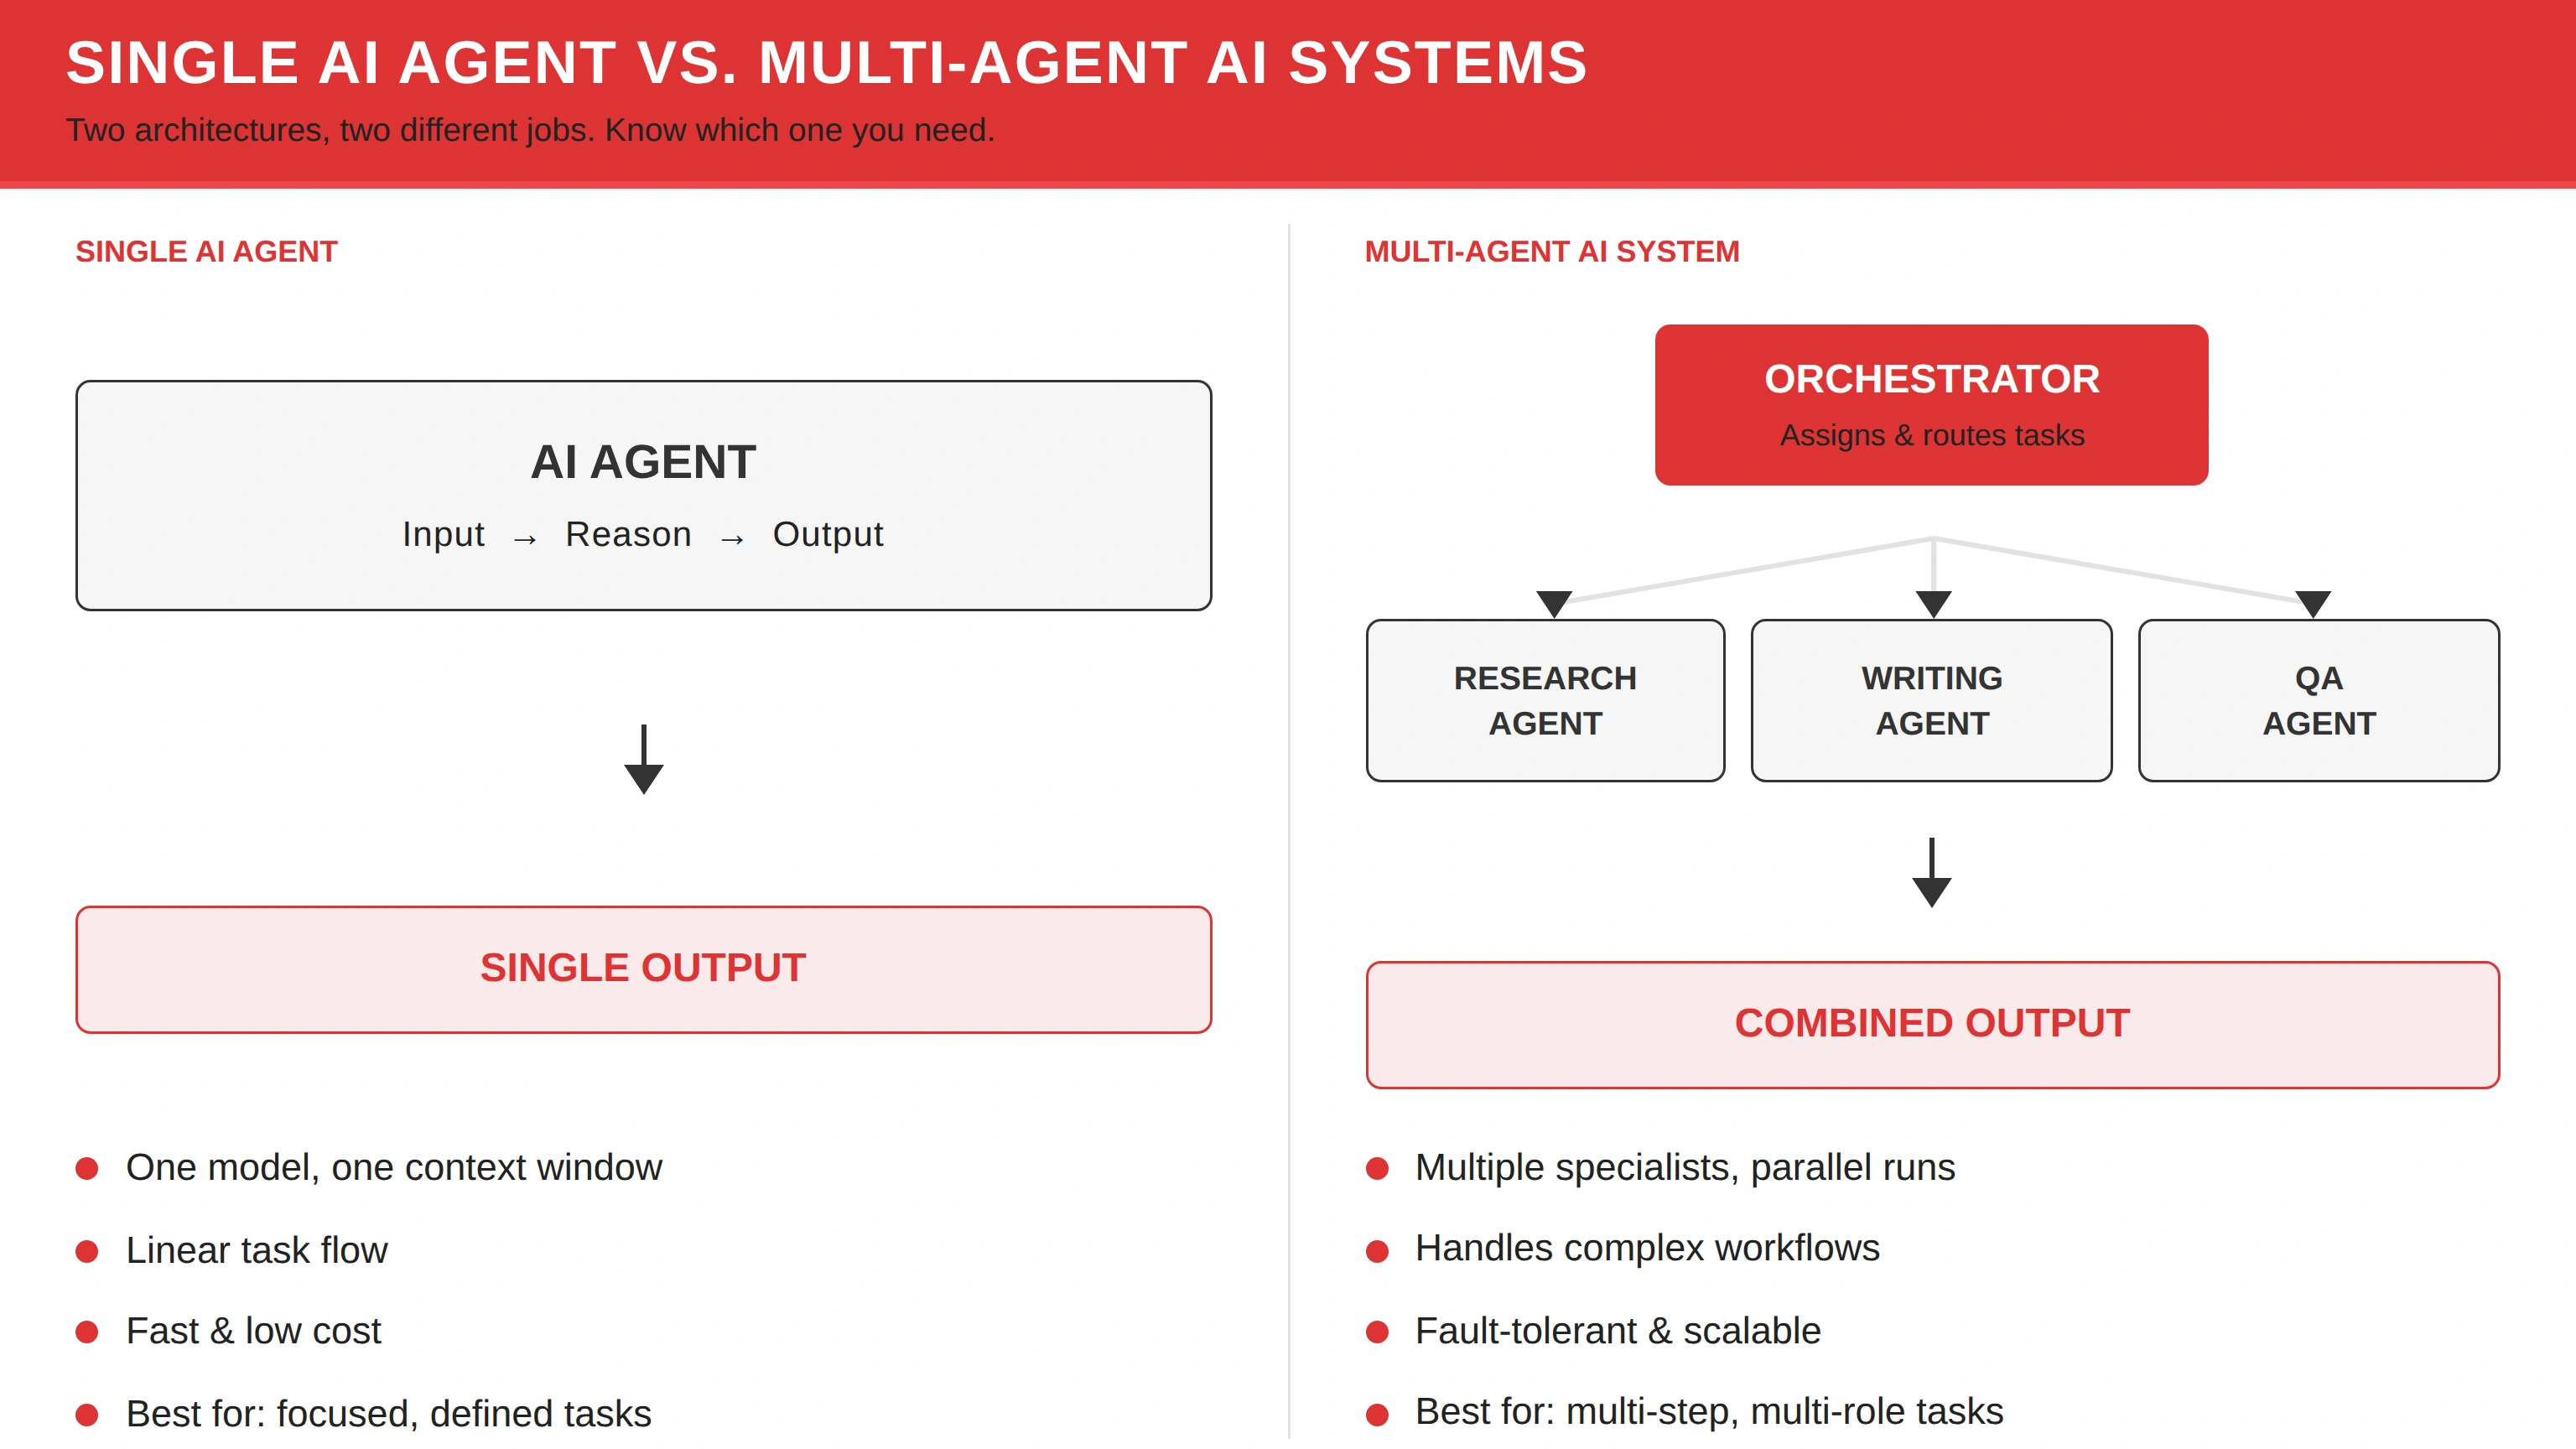
En quoi les architectures à agent unique et multi-agents diffèrent-elles pour les workflows de recherche ?
Un système à agent unique utilise un modèle et une fenêtre de contexte dans une boucle linéaire entrée-raisonnement-sortie, tandis qu'un système multi-agents utilise un orchestrateur pour attribuer des rôles spécialisés tels que la recherche, la rédaction et la QA. Le premier est plus rapide et moins coûteux pour des tâches définies. Le second est plus tolérant aux défaillances pour le travail en plusieurs étapes.
L'orchestration d'agents AI est la couche de contrôle qui coordonne plusieurs agents autonomes vers un objectif commun, y compris l'état, les autorisations et les points de contrôle humains. Elle se distingue du simple fait de disposer de plusieurs agents, ainsi que de l'orchestration AI ordinaire qui se limite à séquencer des modèles et des API. Kimi décrit le même modèle en termes de workflow : un agent effectue les recherches, un autre planifie, un autre rédige.
Le contraste architectural est particulièrement visible dans la production universitaire. En avril 2026, Google Research a décrit PaperVizAgent, un système à cinq agents — récupérateur, planificateur, styliste, visualiseur et critique — qui a obtenu un score de 60,2 contre une référence humaine de 50,0 pour la génération de figures. Un système complémentaire, ScholarPeer, utilise plusieurs agents pour ancrer l'évaluation par les pairs dans la littérature en direct plutôt que de traiter la révision comme une génération de texte ponctuelle. Ces résultats ne prouvent pas que toute stack multi-agents est meilleure. Ils montrent pourquoi la spécialisation associée à la critique peut surpasser un seul prompt.
Les coûts sont tout aussi concrets. Les systèmes multi-agents nécessitent des protocoles explicites, davantage d'infrastructure et des plafonds de dépenses. Sans orchestration, les agents peuvent dupliquer le travail, entrer en conflit ou réessayer jusqu'à faire exploser les dépenses. Les systèmes à agent unique présentent le risque opposé : un seul échec met fin au travail.
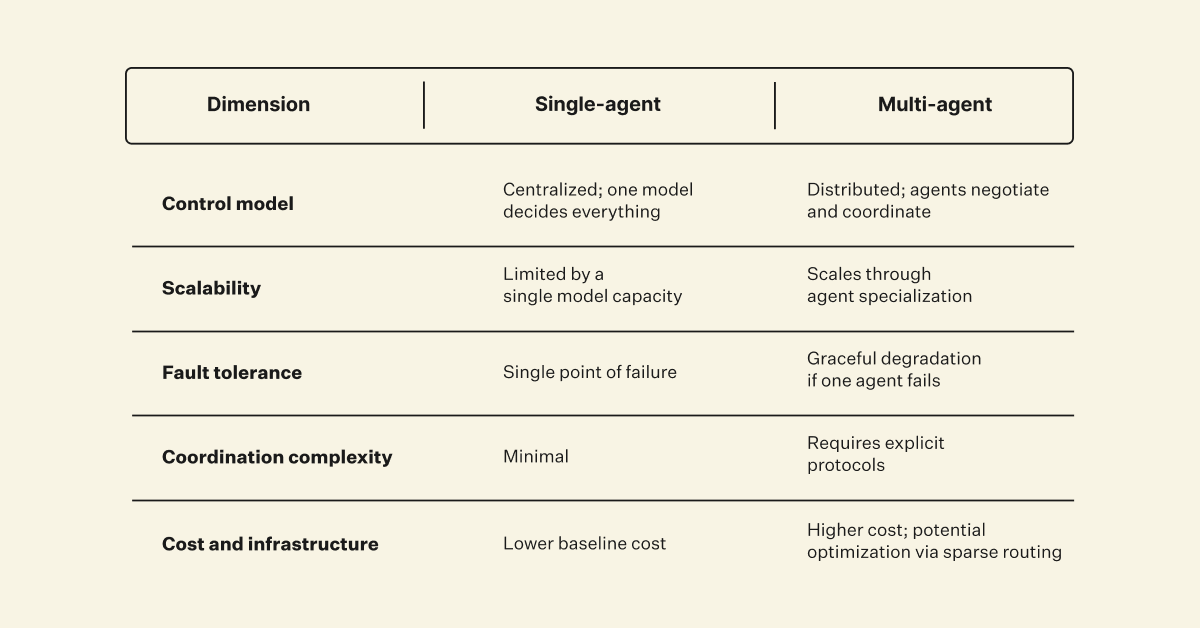
Pour la recherche et la rédaction, la règle utile est le nombre de rôles. Si le travail ne comporte qu'un rôle, utilisez un agent. S'il comporte un chercheur, un rédacteur et un relecteur, utilisez un système orchestré — ou acceptez que vous soyez l'orchestrateur.
Comment construire un workflow complet de recherche et de rédaction assistées par AI ?
Vous construisez un workflow complet de recherche et de rédaction assistées par AI en séparant la découverte, l'analyse et la composition, puis en choisissant pour chaque couche un outil à modèle unique ou une plateforme routée, au lieu d'utiliser un seul chat pour l'ensemble du projet.
Une séquence durable ressemble à ceci :
- Définissez la décision. Rédigez la question à laquelle le document final doit répondre, ainsi que ce qui permettrait de l'infirmer.
- Collectez les sources avec un outil orienté récupération. Utilisez Elicit ou Consensus pour une revue au niveau des articles, Perplexity pour un briefing à l'échelle du web, ou l'Academic Research Assistant de Jenova lorsque le même espace de travail doit conserver les citations.
- Analysez avec un deuxième modèle. Extrayez les méthodes, les désaccords et le niveau de confiance, et pas seulement des résumés.
- Rédigez avec un spécialiste de l'écriture. Utilisez Claude pour un manuscrit autonome ou le Writing Assistant de Jenova lorsque le brouillon doit rester associé à la mémoire du projet.
- Effectuez une passe de QA hostile. Demandez à un autre modèle d'attaquer les citations, la chronologie et les affirmations excessives.
- Figez le livrable. Exportez uniquement après avoir supprimé ou nuancé les affirmations non étayées.
Sur Jenova, cette séquence peut rester dans un seul compte. Un utilisateur peut commencer avec l'Academic Research Assistant, changer de modèles pour la passe analytique, puis poursuivre avec le Writing Assistant ou le SEO Blog Generator si le résultat est un article public. La mémoire persistante et les fichiers joints réduisent la perte habituelle de contraintes entre les outils.
Un bon prompt de transmission entre la recherche et la rédaction explicite ce qui ne doit pas changer :
"Voici le dossier de sources et les affirmations que nous avons déjà rejetées. Rédigez la section d'analyse pour un public de décideurs. Chaque paragraphe doit comporter une source conservée. Si une affirmation est déduite, indiquez qu'il s'agit d'une inférence. Ne réhabilitez pas les affirmations rejetées."
Avec un outil à modèle unique, le même workflow reste possible. Vous devenez simplement le routeur : nouveaux chats, notes collées et modèle de QA utilisé manuellement. Cela peut être le bon choix pour un travail occasionnel. Cela devient fragile lorsque le projet dure des semaines ou implique plusieurs types de documents.
Jenova n'est pas la solution la plus discrète pour réaliser un résumé ponctuel. Son avantage est que le workflow ci-dessus ne nécessite pas trois abonnements et un système de prise de notes personnel pour maintenir l'alignement des éléments.
Que disent les équipes d'infrastructure AI sur les stacks à modèle unique et multi-modèles ?
Les équipes d'infrastructure AI considèrent généralement les outils à modèle unique comme le bon choix par défaut pour un travail linéaire, et les plateformes multi-modèles comme le bon choix par défaut dès qu'un workflow comporte des rôles spécialisés, des contraintes de coûts ou une étape de révision indépendante.
« La plus coûteuse erreur de recherche que nous observons n'est pas de choisir le mauvais modèle de pointe. C'est d'utiliser un seul modèle comme chercheur, analyste et éditeur, puis de faire confiance à la fluidité du paragraphe final. Lorsque le même système invente une source, puis rédige la phrase qui en dépend, il n'existe aucune alarme interne. Un deuxième modèle ne garantit pas la vérité, mais il crée une possibilité de désaccord. »
« Le routage ne vaut la complexité qu'après avoir pu nommer les tâches. “Faites la recherche et rédigez-la” reste une seule tâche. “Collectez les articles candidats, extrayez les méthodes, réconciliez les conflits, rédigez, puis attaquez les citations” représente cinq tâches. Les équipes qui ignorent cette décomposition achètent un schéma multi-agents et exécutent toujours un seul prompt. »
« Les arguments de coût sont réels, mais jouent dans les deux sens. Les travaux publiés par Amazon sur le routage montrent qu'envoyer chaque requête au modèle le plus performant gaspille de l'argent, et les rapports de fournisseurs faisant état d'économies de 30 % à 60 % sont plausibles lorsque la classification et la rédaction sont séparées. L'échec inverse est également courant : un orchestrateur, un classificateur et trois spécialistes dépensent plus qu'un seul modèle rigoureux ne l'aurait fait pour une note courte. »
— Équipe produit Jenova, architecture de workflows AI, 8 ans de création de systèmes d'agents multi-modèles
Cette position correspond à la littérature publique d'ingénierie. AWS traite le routage multi-LLM comme une réponse à des types de tâches mixtes, et non comme une amélioration universelle. GitHub considère l'orchestration comme nécessaire après la prolifération des agents, et non avant. Le consensus des experts est conditionnel : ajoutez des modèles lorsque le travail comporte des séparations. N'ajoutez pas de modèles pour complexifier une tâche simple.
Quand faut-il continuer à utiliser un outil de recherche à modèle unique ?
Vous devriez continuer à utiliser un outil de recherche à modèle unique lorsque la question est délimitée, que les sources sont déjà disponibles, que le délai est court et que vous n'avez pas besoin d'un deuxième système pour auditer le premier. Dans ces conditions, le routage multi-modèles ajoute un coût de coordination sans apporter beaucoup plus de vérité.
Restez avec ChatGPT ou Claude lorsque vous :
- Expliquez un concept connu plutôt que de cartographier une littérature.
- Réécrivez un document auquel vous faites déjà confiance.
- Explorez le ton, la structure ou l'ordre des arguments.
- Travaillez en une seule session sans transmission à un autre membre de l'équipe.
Restez avec Perplexity ou Elicit lorsque vous :
- Posez une question précise nécessitant des citations.
- Filtrez des résumés avant une lecture approfondie.
- Réalisez une revue de littérature qui sera rédigée ailleurs.
Passez à une plateforme de routage des tâches multi-modèles lorsque deux ou plusieurs des situations suivantes sont vraies :
- Le projet mélange recherche, analyse et rédaction finalisée.
- Le résultat doit conserver une traçabilité des sources entre les brouillons.
- Vous avez besoin de modèles différents pour l'extraction, le raisonnement et la prose.
- Le travail se répète suffisamment pour qu'un workflow réutilisable soit utile.
- Une citation erronée aurait un coût élevé.
Jenova correspond à cette deuxième liste. Elle est moins performante qu'Elicit pour le workflow d'extraction d'articles et moins performante que Claude comme rédacteur discret à long contexte. Elle est plus performante lorsque ces tâches doivent être effectuées ensemble, avec mémoire, choix du modèle et agents spécialisés au même endroit.
La décision n'est donc pas « modèle unique contre multi-modèles » comme un test de fidélité. Il s'agit de déterminer si votre workflow ressemble encore à une conversation ou déjà à une chaîne de production. Les conversations relèvent d'un seul modèle. Les chaînes de production relèvent d'un routeur.
Références
- AWS Machine Learning Blog — Stratégies de routage multi-LLM pour les applications d'AI générative sur AWS
- The Chicago School Library — Outils et ressources d'intelligence artificielle : avantages et limites
- University of the District of Columbia Library — Usages et limites de l'AI générative
- PapersFlow — Meilleure AI pour les chercheurs en 2026 : 10 outils comparés par catégorie
- Thesify — Les meilleurs outils AI pour la recherche universitaire en 2026
- HatchWorks AI — Cas d'usage des grands modèles de langage : un LLM contre plusieurs modèles
- TrueFoundry — Routage multi-modèles : optimiser efficacement les tâches AI
- Synthesia — Les 12 meilleurs outils AI pour 2026
- AnswerThis — Les 10 meilleurs outils AI pour les chercheurs en 2026
- Zerve — Outils AI pour la recherche en 2026 : revue de littérature, analyse
- Multi — Une tâche, le bon workflow AI
- ConvergePanel — Le meilleur outil AI multi-modèles pour la recherche
- Argumentree.AI — Recherche AI multi-modèles contre recherche à modèle unique
- MindStudio — Comment réduire les coûts de 60 % en associant les tâches au bon modèle
- GitHub Resources — Qu'est-ce que l'orchestration d'agents AI ?
- Kimi AI — Orchestration d'agents AI : types, étapes et avantages
- Google Research — Présentation de deux agents AI pour de meilleures figures et une meilleure évaluation par les pairs