Les espaces de travail de recherche AI sont-ils meilleurs pour la cartographie systématique des preuves ?
2026-08-22
En quoi l’état persistant d’un projet et la récupération de fragments à la demande diffèrent-ils ?
Pour la cartographie systématique des preuves, un espace de travail de recherche qui recharge les décisions, l’état d’avancement et les artefacts au début de chaque session constitue un meilleur environnement principal qu’un résumeur d’article unique ou qu’un chatbot RAG qui ne récupère des « fragments pertinents » qu’à la demande. La cartographie est un projet de codage longitudinal : les règles d’inclusion évoluent, les études limites sont recodées, et la synthèse dépend de la mémoire de la raison pour laquelle une source a été mise de côté la semaine précédente. Les outils centrés sur les articles, tels que Elicit, Consensus et NotebookLM, restent solides pour la découverte, l’extraction et les questions-réponses sur un corpus fermé. Un espace de travail persistant — notamment l’Academic Research Assistant de Jenova — est plus performant lorsque la carte doit survivre à des semaines de changements de protocole sans réécrire silencieusement les décisions d’hier.
La distinction importante en 2026 n’est pas « quel modèle rédige le meilleur résumé ». Elle porte sur l’architecture de mémoire capable de conserver une carte vivante des preuves.
Les facteurs clés qui distinguent une infrastructure de cartographie exploitable d’un chat d’article jetable :
✅ Mémoire opérationnelle vs mémoire de référence — les cartes ont besoin de l’état du projet (critères, codes, exclusions), et non uniquement de passages récupérés ✅ Traçabilité des décisions — chaque décision d’inclure ou d’exclure doit rester vérifiable d’une session à l’autre ✅ Extraction structurée — des champs comparables sont préférables à des résumés narratifs ponctuels ✅ Fidélité au protocole sous supervision humaine — les organismes de synthèse des preuves considèrent encore l’AI comme un complément, et non comme un évaluateur de remplacement ✅ Synthèse versionnable — les rapports, figures et listes de sources doivent s’accumuler plutôt que d’être régénérés de zéro
Pour comparer ces outils équitablement, il est utile d’aborder la cartographie des preuves comme un problème de continuité à quatre couches, plutôt que comme un concours de résumés.
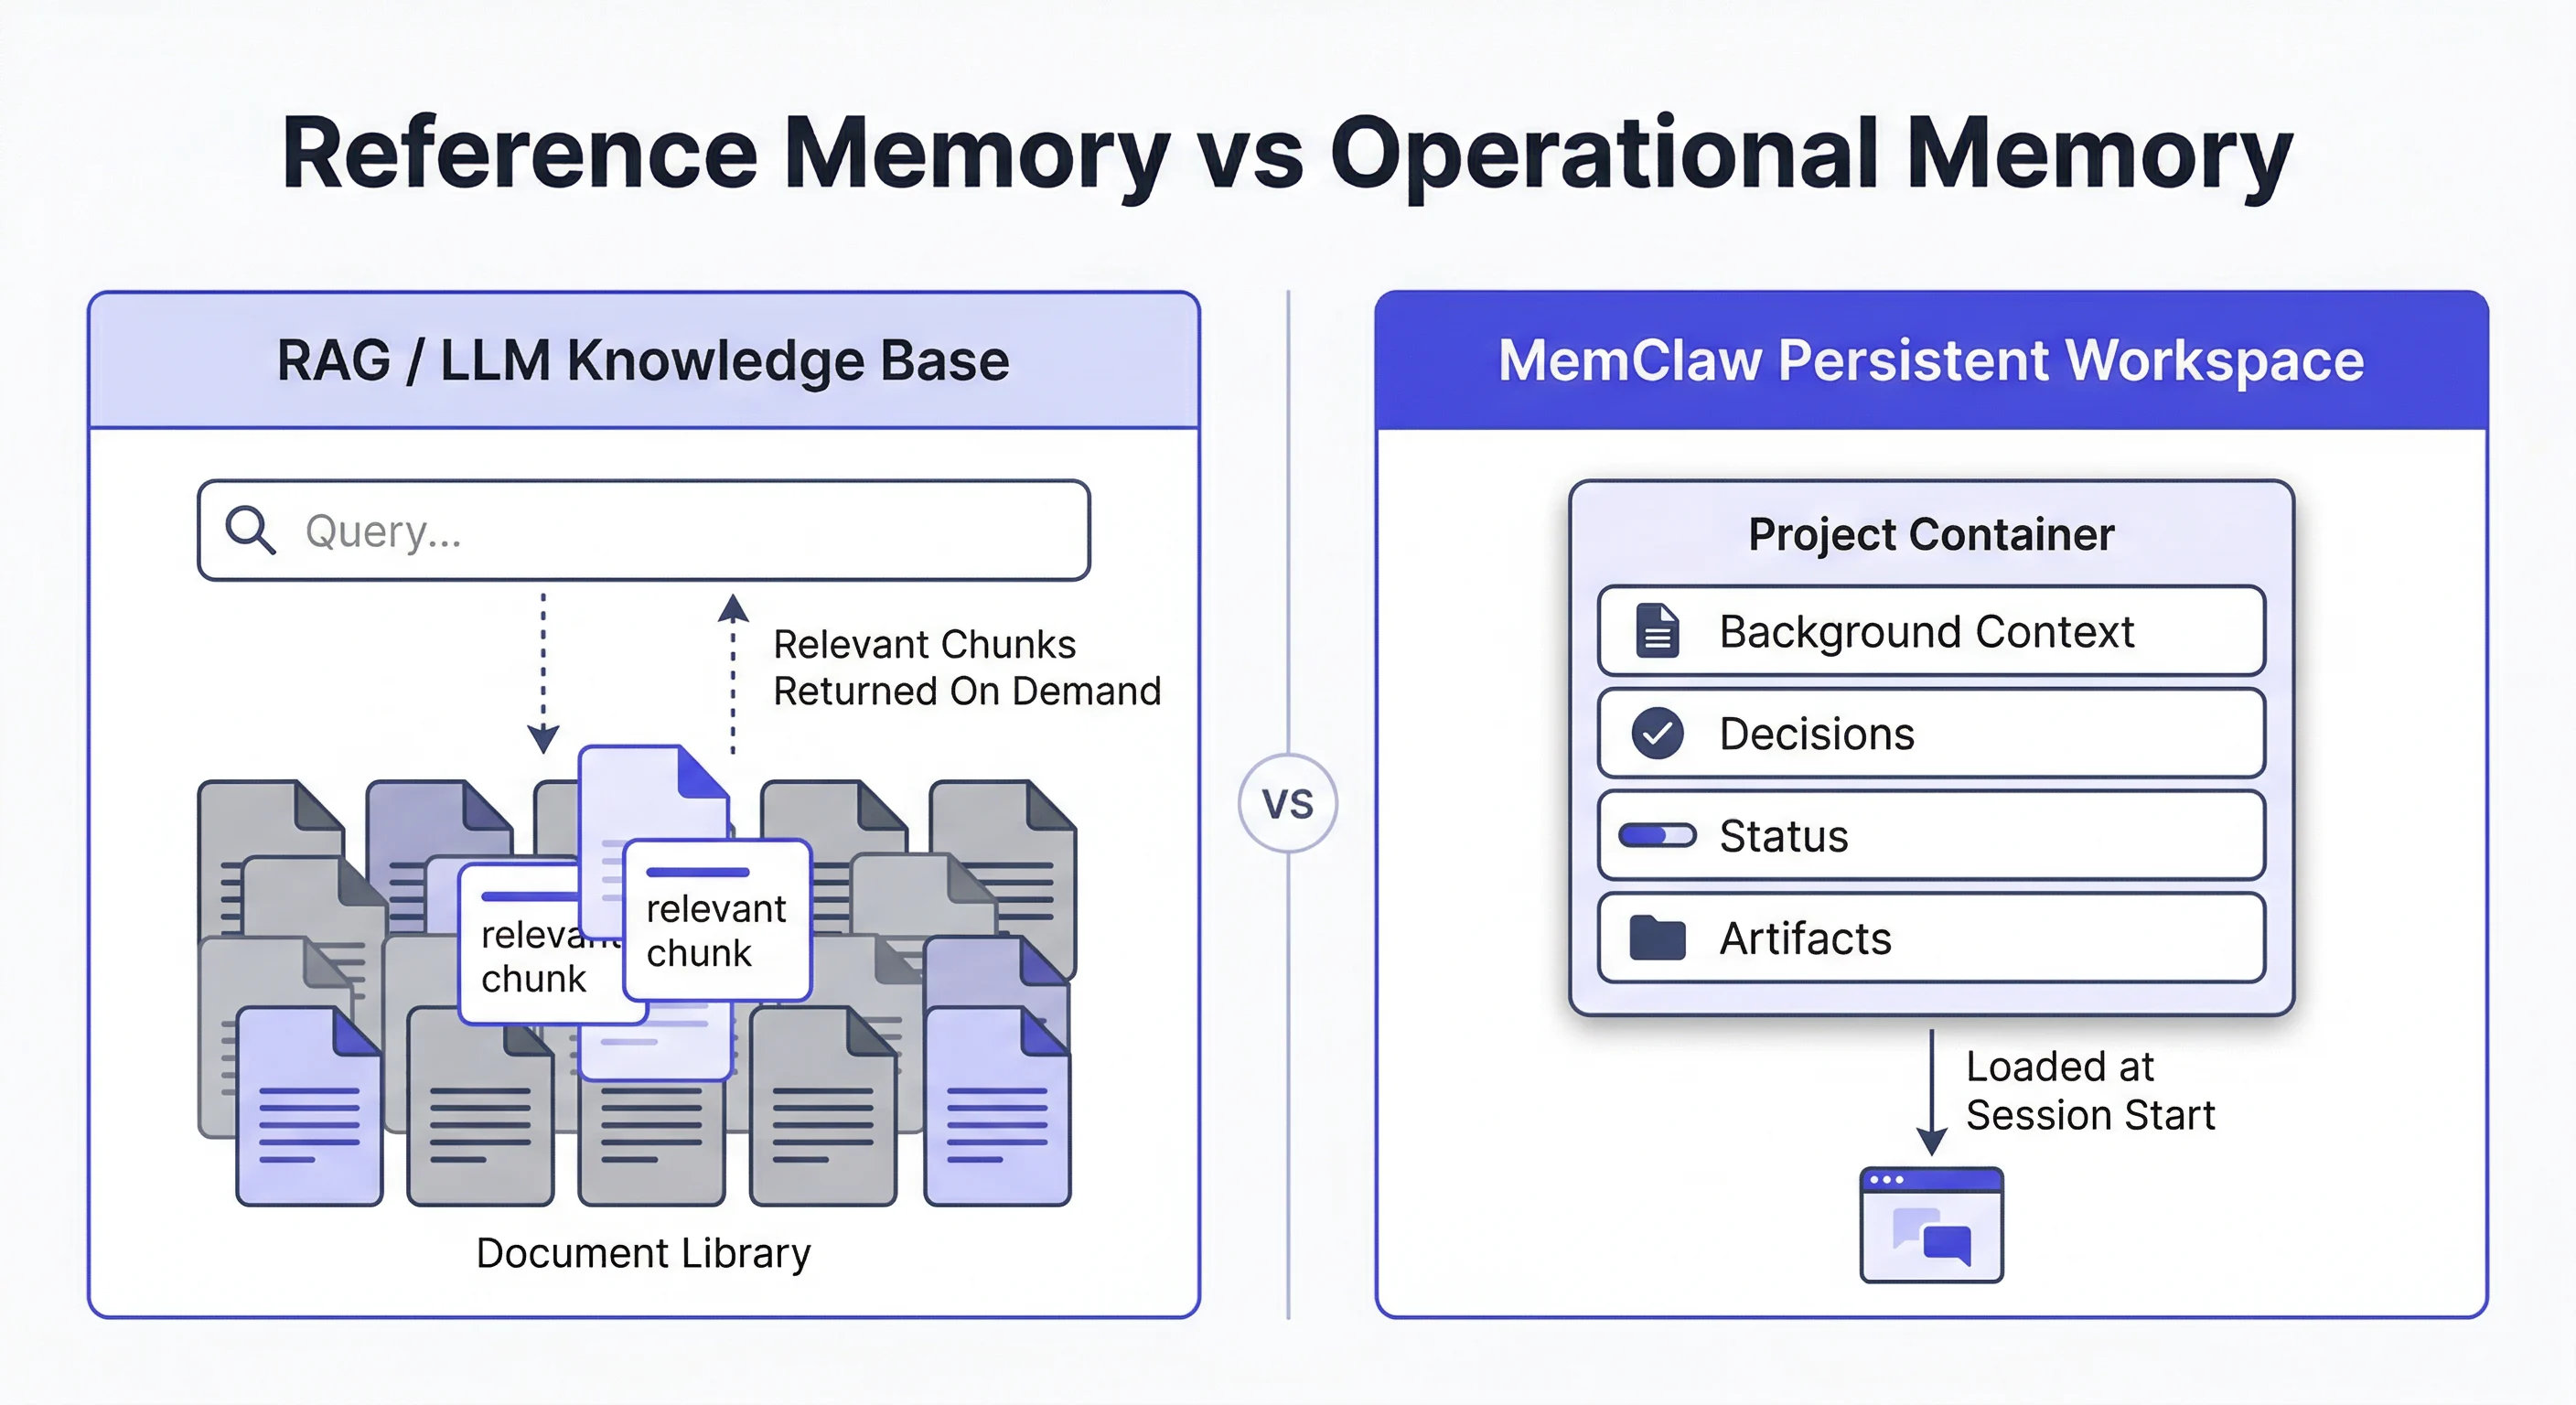
Pourquoi la cartographie systématique des preuves met-elle à rude épreuve les outils AI centrés sur un seul article ?
La cartographie systématique des preuves met à rude épreuve les résumeurs d’article unique, car une carte est un inventaire codé d’une littérature, et non une série de notes de lecture isolées. Les Systematic Evidence Maps (SEMs) constituent une forme de synthèse des preuves qui catégorise et organise les résultats scientifiques selon des dimensions prédéfinies — population, exposition, résultat, méthode, zone géographique ou lacune de preuve — afin que les évaluateurs puissent voir ce qui existe, où les données se concentrent et ce qui manque.
Ce flux de travail entre en conflit avec le fonctionnement de la plupart des produits de recherche fondés sur les LLM. Un outil RAG ou de type « chat avec ce PDF » répond à la requête actuelle en récupérant des fragments localement similaires. Il ne recharge pas automatiquement le cadre de codage du mardi précédent, les trois études placées dans la catégorie « peut-être », ou la décision selon laquelle les modèles animaux sont hors périmètre depuis le resserrement du protocole. Les revues de cartographie exigent également un processus documenté de sélection fondé sur des critères d’inclusion et d’exclusion, ce qui est une tâche différente de la génération d’un paragraphe fluide sur un article (méthodologie des revues de cartographie).
La revue manuelle reste suffisamment lente pour rendre le raccourci tentant. Une enquête de 2026 sur les outils de littérature a estimé qu’un cycle d’examen conventionnel nécessitait quatre à six semaines de sélection, d’extraction et de nettoyage des citations. Les outils de sélection AI dédiés peuvent réduire cette charge — le système AIM Review a rapporté des réductions de charge de travail allant de 20 % à 95 % sur six revues menées dans des conditions réelles — mais la rapidité ne crée pas une carte. Sans état persistant du projet, une sélection plus rapide ne produit qu’un amas plus important de résumés déconnectés.
Les organismes spécialisés dans les bibliothèques et les méthodes explicitent clairement l’écart restant. Les recommandations de King’s College London en matière de synthèse des preuves indiquent que les outils AI ne peuvent pas remplacer les méthodes traditionnelles de recherche, de sélection et d’extraction et qu’ils ne doivent être utilisés qu’avec une compréhension claire des biais, des limites liées au droit d’auteur et du risque d’hallucination. Une revue systématique de 2025 sur l’AI générative dans la synthèse des preuves est parvenue à la même conclusion opérationnelle : les preuves actuelles ne soutiennent pas l’utilisation de GenAI sans implication ni supervision humaine.
Que devez-vous rechercher dans un flux de travail AI de cartographie des preuves ?
Vous devez évaluer les outils AI de cartographie au moyen d’un test de continuité, et non d’un test de qualité rédactionnelle. Nous utilisons une pile à quatre couches — appelée pile CODE — car chaque couche échoue d’une manière distincte et prévisible lorsque les équipes tentent de transformer un chat d’article en carte systématique.
C — Couverture. L’outil peut-il chercher dans un véritable corpus scientifique, ou seulement dans les fichiers que vous avez déjà téléversés ? Elicit interroge plus de 138 millions d’articles et 545 000 essais cliniques. NotebookLM, par conception, répond à partir des sources présentes dans le notebook. Les erreurs de couverture à cette couche deviennent des lignes manquantes dans la carte, et pas seulement des paragraphes superficiels.
O — Opérationnalisation. Les critères d’inclusion, les dimensions de codage et les champs d’extraction peuvent-ils être définis une fois puis réappliqués ? Un résumeur qui réinterprète la « pertinence » à chaque prompt codera différemment le même essai limite au troisième jour. Les recommandations de cartographie considèrent les critères prédéfinis comme non facultatifs (méthodes de revue de cartographie).
D — Traçabilité des décisions. Pouvez-vous retrouver pourquoi une étude a été incluse, exclue, mise en attente ou filtrée ? Les groupes alignés sur Cochrane, dont l’initiative Responsible AI in Evidence Synthesis (RAISE) menée avec Cochrane, Campbell et JBI, considèrent la transparence comme une exigence de qualité, et non comme un simple confort.
E — Extractibilité. Les résultats peuvent-ils être placés dans des cellules comparables — échantillon, conception, direction de l’effet, limite — plutôt que dans une prose impossible à réconcilier ? La conception du produit Elicit repose sur des tableaux interactifs et une extraction en plusieurs étapes. Consensus est plus rapide pour évaluer la direction des preuves au niveau d’une hypothèse, mais n’est pas conçu pour la rédaction structurée de revues.
Pondérez les couches selon votre objectif. Une exploration préliminaire peut tolérer une traçabilité plus faible. Une carte vivante des preuves, qui sera citée, actualisée ou transmise à un coauteur, ne le peut pas. Les outils excellant en Couverture et en Extractibilité échouent tout de même à produire des cartes si l’Opérationnalisation et la Traçabilité des décisions sont réinitialisées à chaque session.
Comment Elicit, Consensus, NotebookLM et les espaces de travail de recherche se comparent-ils ?
Elicit et Consensus forment la meilleure couche de découverte et d’extraction d’articles de cette catégorie, NotebookLM est le meilleur notebook à corpus fermé, et un espace de travail de recherche persistant est le meilleur environnement pour préserver la cohérence d’une carte sur plusieurs semaines. Aucun produit ne remporte toutes les couches CODE, ce qui explique pourquoi les équipes de cartographie sérieuses associent généralement un outil de corpus à un environnement doté d’une mémoire de projet, au lieu d’attendre d’un seul chatbot qu’il prenne en charge l’ensemble de la revue.
En 2026, les synthèses publiées des fonctionnalités et des tarifs se présentent ainsi :
| Fonctionnalité / Dimension | Elicit | NotebookLM | Consensus | Espace de travail de recherche Jenova |
|---|---|---|---|---|
| Modèle de mémoire | Bibliothèque de sources enregistrées et personnalisation par rapport ; pas un conteneur complet d’état de projet | Ensemble de sources limité au notebook ; les réponses restent dans les documents téléversés | Mémoire de questions/listes autour des requêtes d’hypothèses | Mémoire persistante entre les sessions ; le contexte du projet peut être rechargé plutôt que récupéré à nouveau |
| Couverture | 138 M+ d’articles, 545 k essais | Corpus téléversé uniquement ; 50 sources gratuitement, 300 avec Plus | 200 M+ d’articles, étiquettes de direction des preuves | Recherche Web et scientifique en direct, plus bases de connaissances associées ; pas d’index fixe d’éditeur |
| Extraction structurée | Tableaux, sélection, points de données à grande échelle (jusqu’à 1 000 articles / 20 000 points de données) | Questions-réponses et plans liés aux sources, sans grilles d’extraction SR | Consensus Meter et réponses brèves fondées sur les preuves | Rapports de synthèse et briefs étayés par des citations via Deep Research ; moins adapté comme outil dédié à la sélection en double évaluation |
| Persistance des décisions | Les sources peuvent être stockées dans une bibliothèque ; l’état du protocole n’est pas une fonction de premier plan | Conserve les fichiers du notebook, mais pas la logique codée d’inclusion/exclusion | Signets et listes dans les offres payantes | L’historique des conversations, la mémoire et les fichiers de projet associés survivent d’une session à l’autre |
| Tarification (en 2026) | Plus à partir d’environ $12/mois | Gratuit ; Plus via Google AI Pro à environ $19.99/mois | Premium à environ $10/mois | Offre gratuite avec utilisation limitée ; Plus à $20/mois pour une utilisation 30× supérieure |
| Idéal pour | Sélection à grand volume et tableaux d’extraction | Ensembles pédagogiques et PDFs déjà collectés | Vérifications rapides du type « la littérature soutient-elle X ? » | Cartes vivantes, codage sur plusieurs sessions et intégration aux manuscrits |
Elicit est le spécialiste transparent de la sélection de type systématique. Il peut automatiser la sélection et l’extraction et annonce jusqu’à 80 % de gain de temps pour ces étapes. Une comparaison méthodologique de Cochrane a toutefois conclu que la sensibilité de recherche d’Elicit n’était pas suffisante pour remplacer une recherche documentaire traditionnelle ; il fonctionne donc mieux comme complément de haute précision. Il tend aussi à s’arrêter aux rapports et aux tableaux ; le travail d’écriture, de versionnage et de manuscrit vivant est généralement déplacé ailleurs.
NotebookLM est le spécialiste transparent de la lecture étayée d’un ensemble fixe. Chaque réponse peut être vérifiée par rapport à un passage cité, et Google a ajouté Deep Research ainsi que des types de fichiers plus variés. Il ne peut pas découvrir les articles que vous n’avez pas collectés et n’encode pas de journal de décision de type PRISMA.
Consensus est le spécialiste transparent de la direction d’une hypothèse. Son indicateur et son balisage soutien/contraste sont plus rapides que la création d’une grille d’extraction lorsque vous voulez simplement savoir dans quel sens penche la littérature (comparaison d’outils). C’est le mauvais système principal pour une carte codée.
L’Academic Research Assistant de Jenova est le plus fort lorsque l’unité de travail est le projet, et non le PDF. Il peut rechercher des sources scientifiques, conserver le contexte du manuscrit et des citations et — parce que la plateforme sous-jacente stocke un historique de chat illimité ainsi qu’une mémoire intersessions — poursuivre un cadre de codage sans avoir à recoller le protocole. Ce n’est pas une plateforme validée de sélection à double évaluateur au sens de Covidence ou Rayyan, et elle ne publie pas de chiffres d’exactitude d’extraction comparables à ceux d’Elicit. Les équipes qui ont besoin de pistes d’audit de niveau réglementaire doivent conserver un outil de sélection dédié dans leur pile.
SciSpace et Scite remplissent des fonctions adjacentes plus étroites. SciSpace est fréquemment décrit comme le meilleur environnement d’analyse approfondie article par article, avec un très vaste corpus mais un flux de travail de revue moins unifié. Les 1,6 milliard de Smart Citations de Scite, classées selon qu’elles soutiennent, contredisent ou mentionnent une affirmation, sont inégalées pour l’audit du contexte des citations, mais presque inutiles à elles seules comme base de données de découverte ou de cartographie.
Comment la mémoire opérationnelle transforme-t-elle la synthèse documentaire sur plusieurs sessions ?
La mémoire opérationnelle transforme la synthèse parce qu’elle traite le conteneur de projet — contexte, décisions, état, artefacts — comme l’objet chargé au début de la session, au lieu de traiter la littérature comme une botte de foin à interroger à nouveau. La mémoire de référence demande : « Quels fragments ressemblent à cette question ? » La mémoire opérationnelle demande : « Qu’est-ce qui est déjà établi pour ce projet, et qu’est-ce qui nécessite encore des preuves ? »
Cette différence apparaît dans trois modes d’échec que les résumeurs masquent efficacement :
- Dérive des critères. Si « RCTs humains chez l’adulte uniquement » vit dans le prompt plutôt que dans l’état du projet, une session ultérieure posant une question légèrement plus large réinclura discrètement les études pédiatriques déjà rejetées.
- Cas incertains orphelins. Les articles limites mis en attente en vue d’une discussion avec un coauteur disparaissent, sauf si leur statut constitue un champ de premier plan.
- Synthèse régénérée. Une réponse RAG peut être localement fidèle aux fragments récupérés aujourd’hui tout en contredisant le tableau de lacunes de la semaine dernière, car rien n’oblige la nouvelle réponse à hériter de l’ancien codage.
Les espaces de travail persistants inversent l’ordre de chargement. Le contexte, les décisions, l’état et les artefacts sont chargés avant la requête suivante. La mise en œuvre de ce schéma par la plateforme Jenova associe mémoire intersessions et bases de connaissances associables : l’assistant peut mémoriser les dimensions de cartographie, la définition de travail d’une lacune de preuve et les affirmations qui disposent déjà d’un soutien suffisant. Les tests par rapport aux outils de type notebook révèlent un compromis net. Le corpus fermé de NotebookLM est plus sûr contre les inventions hors source (réponses liées aux sources). Un espace de travail ouvert persistant est plus utile lorsque le corpus continue de croître et que le cadre de codage est l’actif rare.
L’implication pratique pour les SEMs est simple. Si votre livrable est un briefing ponctuel sur 15 PDFs, la mémoire opérationnelle est facultative. Si votre livrable est une carte des lacunes qui sera actualisée après le prochain cycle de conférences, la mémoire opérationnelle est le produit.
À quoi ressemble réellement un pipeline agentique de preuves de bout en bout ?
Un pipeline de cartographie de bout en bout ressemble à un sprint de recherche par étapes avec des portes de contrôle, et non à un simple prompt « résumez ces articles ». L’illustration ci-dessous présente une architecture de référence utile : formulation de la question, triage de la littérature, identification des candidats, formalisation de l’hypothèse, validation multi-source, rapport versionné et package suivi par git.
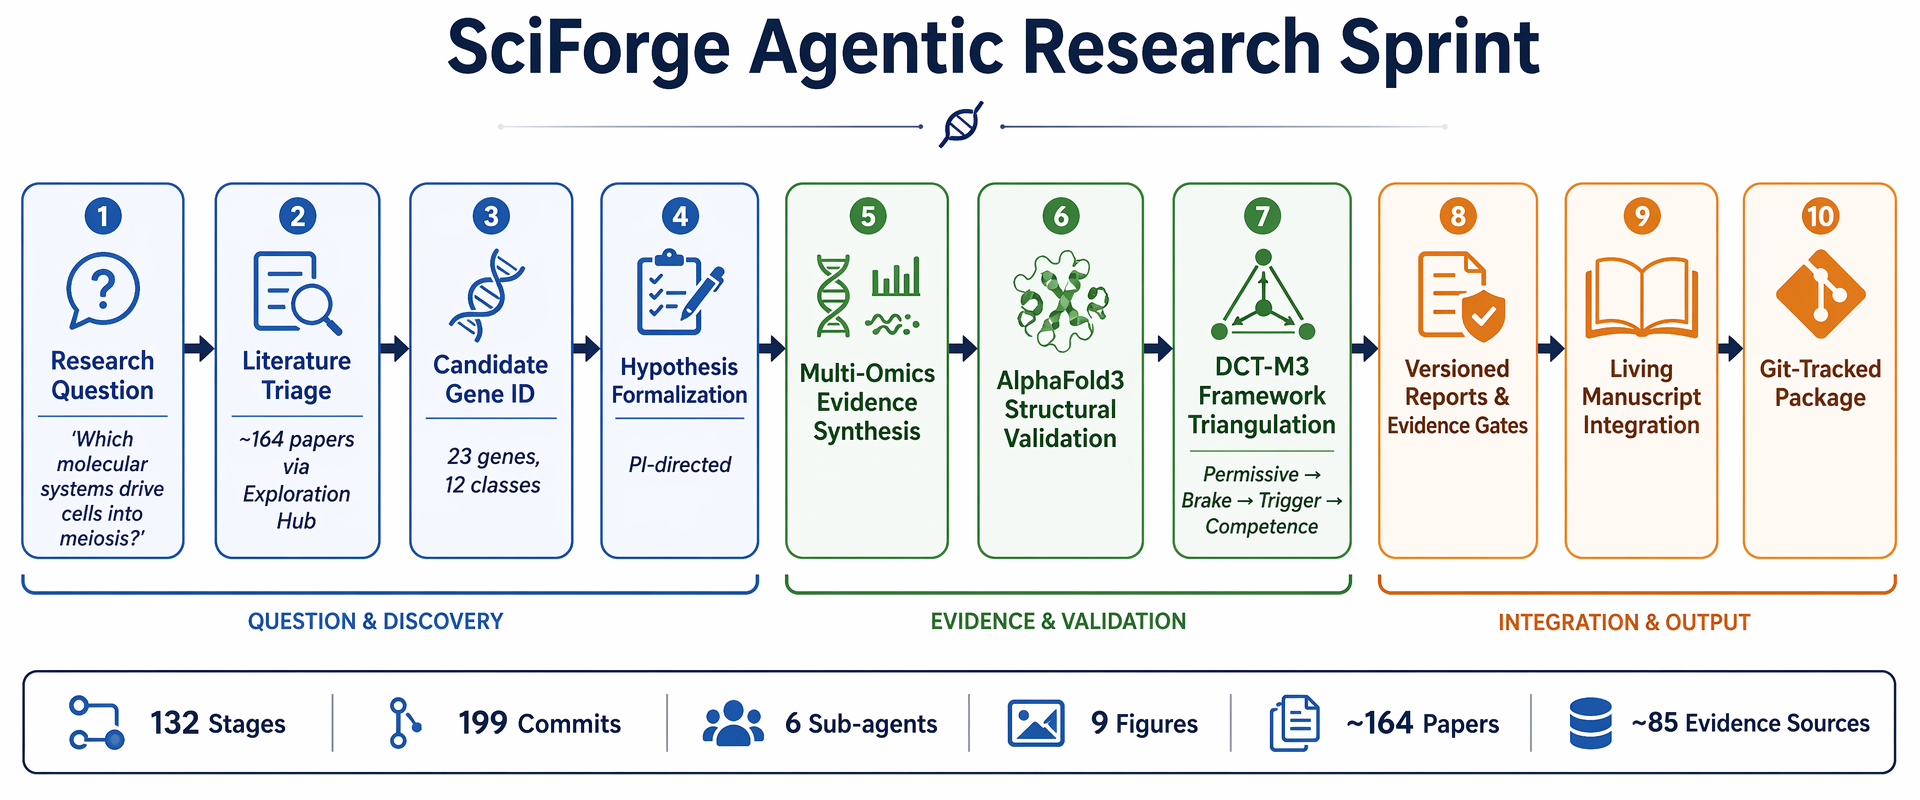
L’exemple de sprint est volontairement vaste — de l’ordre de 164 articles triés, 132 étapes, 199 commits, six sous-agents et environ 85 sources de preuves — car c’est à cette échelle que le chat d’article s’effondre. Un résumeur peut décrire l’article 17. Il ne peut pas maintenir la cohérence d’une chaîne en 10 étapes lorsque l’étape 4 modifie la règle d’inclusion déjà appliquée à l’étape 2.
Trois choix de conception de ce pipeline comptent davantage que les détails du domaine :
- La découverte est une phase, pas le produit. Le triage de la littérature alimente les identifiants des candidats et une hypothèse formalisée. S’arrêter aux résumés laisse la carte inachevée.
- La validation est multimodale. La synthèse des preuves, les vérifications structurelles ou quantitatives et une logique explicite « permissif → frein → déclencheur » font passer les affirmations par des portes de contrôle plutôt que de les moyenner dans un paragraphe.
- La sortie est versionnée. L’intégration à un manuscrit vivant et un package suivi par git font de la carte un artefact doté d’un historique. C’est l’opposé d’une transcription de chat impossible à rejouer.
Jenova peut reproduire approximativement ce schéma en répartissant les rôles entre plusieurs agents, plutôt qu’en forçant un seul chat à être bibliothécaire, codeur et rédacteur. Academic Research Assistant gère la découverte scientifique et le contexte du manuscrit. Deep Research produit une synthèse étayée par des citations à partir de nombreuses sources. Real-Time Search est utile lorsque la carte doit aussi inclure des prépublications, des dépôts ou de la littérature grise non publiée dans des revues. La limite réside dans la discipline d’orchestration : l’humain reste responsable du protocole, des portes de contrôle et de la décision de promouvoir une affirmation dans le manuscrit vivant. Les groupes méthodologiques continuent de considérer ce rôle humain comme non négociable (recommandations KCL / RAISE).
Les plateformes de revue tout-en-un de type Paperguide tentent de condenser planification–recherche–sélection–extraction–génération dans un seul flux de travail fournisseur, avec notamment des modes Extended qui sélectionnent 200 candidats et rédigent à partir des 50 premiers. C’est plus proche d’un espace de travail qu’Elicit-plus-Word, mais un journal de décision externe reste nécessaire si vous vous souciez de la traçabilité après l’exportation de la revue générée.
Comment tirer le meilleur parti d’une carte de preuves AI ?
Vous tirerez le meilleur parti d’une carte de preuves AI en inscrivant le protocole dans l’espace de travail avant de demander de la prose, puis en imposant à chaque session ultérieure d’hériter de ce protocole. La configuration est similaire d’un outil à l’autre ; la différence est de savoir si l’outil peut s’en souvenir.
Pour une carte centrée sur Jenova, une séquence efficace est la suivante :
- Ouvrez Academic Research Assistant et indiquez le nom du projet, la population et les dimensions de cartographie dans le premier message.
- Épinglez le protocole dans un langage réutilisable par l’assistant :
« Construisez une carte systématique des preuves portant sur les études humaines chez l’adulte sur X. Incluez uniquement les RCTs et les cohortes prospectives. Codez chaque étude selon sa conception, son échantillon, son intervention, son résultat principal, la direction de l’effet et ses limites. Placez les articles animaux et in-vitro dans un journal d’exclusion avec une raison en une ligne. Ne régénérez pas les codes déjà décidés. »
- Exécutez Deep Research pour le premier passage sur le corpus, puis collez ou associez le tableau de travail dans le même fil de projet afin que l’extraction et le récit partagent une seule mémoire.
- Après chaque session, demandez trois artefacts, et non un seul essai : un tableau d’études actualisé, un journal d’exclusion et une liste de lacunes. Ces trois fichiers constituent la carte.
Pour Elicit, commencez par la question de recherche, générez un tableau de sélection et considérez la bibliothèque comme la source de vérité (flux de travail de revue systématique Elicit). Ne sautez pas l’étape d’une recherche conventionnelle dans les bases de données. Les études de cas Cochrane ont jugé Elicit utile pour la recherche préliminaire de haute précision et l’identification d’études supplémentaires uniques, mais pas comme moteur de recherche unique.
Pour NotebookLM, collectez d’abord les PDFs, restez dans un seul notebook et posez des questions dimension par dimension (« Listez chaque étude qui rapporte le résultat Y avec la taille d’échantillon et le suivi ») afin que le corpus fermé ne puisse pas dériver. Les limites de téléversement — 50 sources dans l’offre gratuite, 300 avec Plus — font de cet outil un mauvais choix pour une carte de 400 dossiers, sauf si vous effectuez une présélection ailleurs.
Deux règles de processus s’appliquent à toutes les piles. Premièrement, ne téléversez pas de PDFs en texte intégral dans un modèle grand public si les conditions de droit d’auteur l’interdisent ; les titulaires de droits interdisent généralement cet usage. Deuxièmement, maintenez un humain au poste de décision pour l’inclusion et l’exclusion. L’assistance à la sélection est la tâche AI qui dispose du plus grand nombre de preuves de soutien ; la synthèse non supervisée est celle qui en dispose du moins (revue des revues sur la préparation à l’AI).
Que disent les spécialistes de la synthèse des preuves sur la cartographie assistée par AI ?
Les spécialistes acceptent de plus en plus l’AI pour la sélection et l’extraction supervisées, mais continuent de rejeter l’AI comme cartographe non supervisé d’un domaine. Le consensus d’experts utile en 2026 est plus restreint que les arguments marketing des fournisseurs : automatisez la couche répétitive, préservez la couche décisionnelle et maintenez la responsabilité humaine concernant la carte.
« Le mode d’échec que nous observons n’est pas que les modèles ne puissent pas résumer un article. C’est que les équipes de cartographie traitent un bon résumé comme s’il s’agissait d’un dossier codé. Une carte systématique des preuves est un ensemble de décisions réversibles — inclus, exclu, en attente, filtré — associées à des champs stables. Si ces décisions ne vivent que dans le prompt de la semaine dernière, la carte est déjà corrompue, même lorsque chaque paragraphe conserve un ton prudent. »
« La récupération de références et la mémoire opérationnelle résolvent des problèmes différents. La récupération permet de trouver les preuves candidates. La mémoire opérationnelle évite de coder trois fois la même étude. Les outils excellents dans la première tâche sont régulièrement déployés comme s’ils réalisaient la seconde. C’est ainsi que l’on obtient une analyse fluide des lacunes, incapable d’expliquer pourquoi 12 essais limites ont disparu. »
« Notre règle de travail est simple. Utilisez un moteur de corpus pour renseigner les lignes. Utilisez un espace de travail persistant pour maintenir le livre de codes, le journal d’exclusion et le tableau des lacunes. Faites intervenir un évaluateur humain à chaque porte de contrôle qui modifie le sens de la carte. Tout produit vendu comme une carte systématique en un clic vous demande d’ignorer la seule couche que les groupes méthodologiques considèrent encore comme non négociable. »
— Équipe Produit Jenova, conception de flux de travail de recherche, 8 ans de développement de systèmes de connaissances pour le travail analytique sur plusieurs sessions
Cette position s’aligne sur les recommandations officielles. NICE, les recommandations RAISE liées à Cochrane et les services de bibliothèque universitaires décrivent tous l’AI comme un complément intégré aux méthodes validées existantes. Un guide vivant sur l’AI dans la recherche et la sélection bibliographiques présente le même argument d’efficacité — la sélection est coûteuse ; l’automatisation aide — sans prétendre que la génération puisse remplacer un protocole.
Quand les résumeurs d’article unique restent-ils le bon choix ?
Les résumeurs d’article unique restent le bon choix lorsque le corpus est petit, déjà collecté et n’est pas codé dans une carte réutilisable. Si vous avez 12 PDFs, une réunion de journal club demain et aucun besoin d’actualiser l’inventaire dans trois mois, un chat d’article de type NotebookLM ou SciSpace terminera le travail avec moins de formalités qu’un conteneur de projet.
Ils conviennent aussi mieux à trois autres tâches souvent étiquetées à tort comme de la cartographie :
- Explication de mécanisme. « Expliquez-moi la Figure 3 » est une tâche de lecture. Un notebook à corpus fermé avec citations cliquables est plus sûr qu’un espace de travail ouvert susceptible de mélanger les articles.
- Vérifications du contexte des citations. Si la question est de savoir si des travaux ultérieurs soutiennent ou contredisent une affirmation, les citations classées de Scite constituent la couche conçue à cette fin (1,6 Md+ Smart Citations).
- Vérifications ponctuelles d’hypothèses. Consensus reste le moyen le plus rapide de voir si une proposition présente une séparation visible entre soutien et contradiction avant d’investir dans une carte (aperçu Elicit vs Consensus).
L’erreur consiste à employer ces forces comme substitut à une infrastructure de SEM. Un résumeur peut être excellent localement tout en restant le mauvais système d’enregistrement. Inversement, un espace de travail persistant peut maintenir en vie un livre de codes désordonné tout en étant le mauvais outil pour une sélection en double évaluation de 5 000 dossiers si vous avez besoin d’un logiciel SR dédié. Les guides institutionnels continuent d’orienter les équipes vers des plateformes de sélection telles que Rayyan, Covidence et DistillerSR pour cette étape (guide CASRAI sur l’AI pour les SR ; guide de revue systématique de Stony Brook).
La règle de décision qui résiste à la réalité des revues est donc architecturale, et non fondée sur une marque. Si le produit du travail est un ensemble de décisions de codage comparables, actualisables et explicables, choisissez un espace de travail de recherche avec mémoire de projet et conservez un moteur de corpus à ses côtés. Si le produit du travail consiste à comprendre les articles déjà sur votre bureau, un résumeur d’article unique n’est pas un compromis. C’est l’outil correctement dimensionné.
Références
- ScienceDirect — Guide pour mener des cartes systématiques des preuves
- PubMed Central — Méthodologie des revues de cartographie, cartes de preuves et cartes de lacunes
- Paperguide — Les 7 meilleurs outils AI de revue de littérature en 2026
- King’s College London — Outils AI dans la synthèse des preuves
- Elicit — AI pour la recherche scientifique
- NotebookLM — Outil de recherche AI et partenaire de réflexion
- Google Blog — NotebookLM ajoute Deep Research, DOCX, Sheets et plus encore
- The Drive AI — Elicit vs Consensus vs Semantic Scholar
- Omid Saffari — Meilleurs outils de recherche AI 2026 : Elicit vs Consensus
- Guide d’utilisation de l’AI dans la recherche et la sélection bibliographiques
- CASRAI — Outils AI pour les revues systématiques de littérature
- Bibliothèques de l’Université Stony Brook — Guide de revue systématique : intelligence artificielle