Les assistants de recherche IA sont-ils meilleurs que la recherche par mots-clés pour trouver des articles connexes ?
2026-08-22
Quand la correspondance sémantique surpasse-t-elle le classement par mots-clés pour les articles conceptuellement liés ?
Les assistants de recherche IA sémantiques surpassent la recherche traditionnelle par mots-clés lorsque les articles dont vous avez besoin décrivent la même idée avec une terminologie différente. Les moteurs fondés sur les mots-clés restent toutefois plus performants lorsque vous connaissez déjà les expressions exactes, les auteurs ou le réseau de citations à cibler. En 2026, la réponse pratique n’est pas d’abandonner Google Scholar, mais d’associer le classement lexical à la recherche fondée sur le sens, avec des outils tels que Elicit, SciSpace, Undermind et Jenova's Academic Research Assistant.
Les principaux facteurs qui distinguent une découverte conceptuelle efficace d’une correspondance par mots-clés sont les suivants :
✅ Flexibilité du vocabulaire — la capacité du système à faire émerger un article sur l’« infarctus du myocarde » lorsque la requête mentionne une « crise cardiaque » ✅ Signaux de classement — scores lexicaux pondérés par les citations, similarité des embeddings ou LLM évaluant la pertinence ✅ Profondeur de l’index — métadonnées de titre et de résumé ou correspondance en texte intégral sur des centaines de millions de travaux ✅ Contrôles de précision — imbrication booléenne, restrictions par champ, filtres de qualité des revues et limites d’exportation ✅ Temps nécessaire pour obtenir un ensemble utile — listes exploratoires instantanées ou recherches itératives de plusieurs minutes
Pour comparer honnêtement ces méthodes, il est utile de considérer séparément l’écart de vocabulaire, le biais de classement et le contrôle de recherche, plutôt que de demander quel outil est universellement meilleur.
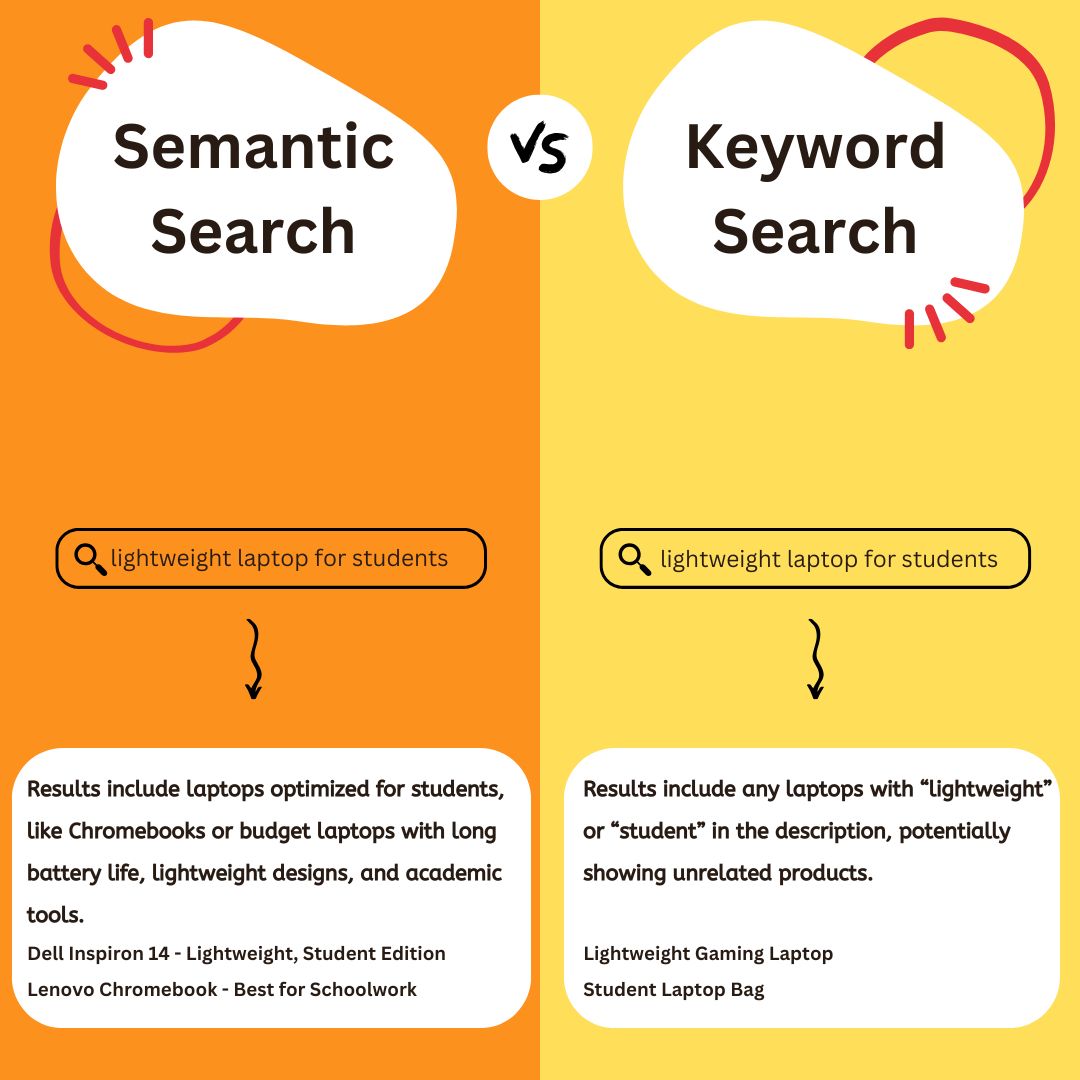
Pourquoi l’écart de vocabulaire perturbe-t-il encore la recherche universitaire traditionnelle en 2026 ?
L’écart de vocabulaire perturbe encore la recherche universitaire traditionnelle parce que les auteurs, les disciplines et les périodes désignent un même phénomène de façons différentes, et que les moteurs lexicaux ne récupèrent que les documents partageant suffisamment de termes de surface avec la requête. Un article de santé publique peut parler d’« activité physique », un article de cardiologie de « capacité d’exercice », et un article de sociologie de « mouvements durant les loisirs ». Si vous ne recherchez qu’une seule expression, les deux autres groupes peuvent disparaître des premières pages de résultats.
Google Scholar reste le point de départ par défaut pour la plupart des chercheurs et demeure la plus vaste interface unique de recherche universitaire disponible, incluant des textes intégraux provenant d’éditeurs et de dépôts. Aaron Tay, bibliothécaire universitaire à la Singapore Management University, l’a décrit comme le couteau suisse de la recherche savante — l’outil qu’il conserverait s’il ne pouvait en garder qu’un. Son classement demeure toutefois lexical. Après les correspondances de titre, il accorde un poids important aux articles très cités, ce qui est excellent pour trouver des travaux fondateurs, mais moins efficace pour trouver des articles conceptuellement liés qui emploient une formulation différente ou qui n’ont pas encore accumulé de citations.
Le problème est plus grave lorsqu’un terme de requête est courant. Comme Google Scholar effectue des correspondances dans le texte intégral, une recherche sur un outil ou un concept portant un nom courant peut générer des milliers de résultats accessoires. Tay note que rechercher « Elicit » dans Google Scholar est presque inutile sans ajouter une solution de contournement liée au domaine, car le mot apparaît constamment dans les sections méthodologiques. Les systèmes sémantiques réduisent ce mode d’échec en évaluant le sens plutôt que le chevauchement de chaînes de caractères, ce qui explique pourquoi ils sont devenus une couche complémentaire plutôt qu’une simple nouveauté.
Que faut-il évaluer pour comparer la recherche par mots-clés et les assistants IA sémantiques ?
Vous devriez évaluer la recherche par mots-clés et les assistants IA sémantiques selon six dimensions que cet article appelle le cadre de récupération des écarts de vocabulaire : flexibilité du vocabulaire, transparence du classement, couverture de l’index, contrôle de la précision, signaux d’autorité et temps nécessaire pour obtenir un ensemble utile. Un outil qui gagne sur une dimension perd souvent sur une autre, ce qui explique pourquoi un classement désignant un unique « gagnant » induit davantage en erreur qu’il n’aide.
La flexibilité du vocabulaire détermine si le moteur peut récupérer un article dont le résumé ne répète jamais les termes de votre requête. Les embeddings denses et les méthodes hybrides comme SPLADE, qu’Elicit utilise comme approche d’embeddings clairsemés appris, sont conçus pour cela. La transparence du classement demande si vous pouvez expliquer pourquoi un article est apparu. Les systèmes Boolean-plus-BM25 sont plus faciles à auditer ; la recherche de voisins les plus proches par embeddings et les réorganiseurs LLM sont plus difficiles à reproduire.
La couverture de l’index n’est pas identique au « nombre d’articles annoncé ». OpenAlex indique compter 517 millions de fiches de travaux et 66 millions de PDF en texte intégral, tandis qu’Elicit affirme qu’il recherche, résume et extrait des données de plus de 125 millions d’articles. Google Scholar ne publie pas de chiffre officiel comparable, mais il est largement considéré comme le plus grand index universitaire de recherche en texte intégral. Le contrôle de la précision couvre l’imbrication booléenne, les restrictions par champ, les opérateurs de proximité et les vocabulaires contrôlés — des fonctionnalités pour lesquelles The Lens et OpenAlex surpassent Google Scholar.
Les signaux d’autorité comprennent les nombres de citations, le niveau de la revue et les indicateurs de rétractation. Google Scholar et, dans une moindre mesure, Undermind privilégient les travaux très cités. Elicit et SciSpace classent généralement les résultats selon la similarité sémantique et ne pondèrent pas les citations, de sorte que des articles plus récents ou moins cités remontent dans les résultats. Le temps nécessaire pour obtenir un ensemble utile distingue la recherche instantanée par mots-clés des exécutions itératives de type Undermind qui prennent au moins trois minutes. Évaluez chaque dimension par rapport à votre tâche réelle — découverte riche en synonymes, rappel systématique ou orientation en cinq minutes — avant de choisir un moteur principal.
Comment Google Scholar, Elicit, SciSpace, Undermind et Jenova se comparent-ils pour la découverte conceptuelle ?
Google Scholar est le plus performant pour l’exploration large pondérée par les citations ; Elicit et SciSpace sont les plus efficaces lorsque les mots-clés sont incertains ; Undermind est le meilleur pour des recherches étroites et de haute précision ; et Jenova's Academic Research Assistant est le plus adapté lorsque découverte, synthèse et travail de citation doivent rester dans une même conversation persistante. Aucun de ces outils ne domine toutes les dimensions du cadre de récupération des écarts de vocabulaire.
| Fonctionnalité / Dimension | Google Scholar | Elicit / SciSpace | Undermind | Jenova Academic Research Assistant | Lens.org / OpenAlex |
|---|---|---|---|---|---|
| Méthode de correspondance | Lexicale / par mots-clés, pondérée par les citations | Sémantique ou hybride (Elicit utilise SPLADE) | Recherche hybride, évaluation de la pertinence par LLM et recherche itérative | Agent de recherche en langage naturel sur des sources savantes en direct, dont Google Scholar | Recherche structurée de métadonnées savantes avec opérateurs avancés |
| Récupération avec une formulation différente | Faible, sauf si vous ajoutez des synonymes ou utilisez Related articles | Forte pour les requêtes fondées sur le sens | Forte pour des consignes précises en langage naturel | Forte grâce à la reformulation conversationnelle entre les sessions | Faible à modérée ; dépend de la construction de la requête |
| Biais d’autorité | Favorise les articles très cités après les correspondances de titre | Faible pondération des citations ; les articles récents remontent | Biais partiel vers les travaux fondateurs grâce à la recherche de citations | Suit les sources connectées et les consignes que vous fournissez | Piloté par les métadonnées ; conçu davantage pour l’analyse que pour le classement sémantique |
| Fonctions de précision | Pas d’imbrication booléenne, limite de 256 caractères, recherche par champ limitée | Post-filtres de qualité des revues, par exemple les niveaux Scimago dans SciSpace | Spécificité en langage naturel plutôt que Boolean | Affinage conversationnel ; pas un moteur de syntaxe booléenne | Boolean imbriqué, proximité, recherche par champ, vocabulaire contrôlé |
| Temps de requête habituel | Instantané | Suffisamment rapide pour l’exploration | Au moins ~3 minutes par recherche | Interactif ; les tours de suivi sont immédiats | Instantané à cadencé par API |
| Tarification (en 2026) | Gratuit | Elicit Pro à environ 49 $/mois ; niveaux payants de SciSpace signalés entre 12 et 160 $/mois | Niveau exploratoire gratuit ; forfaits universitaires payants | Niveau gratuit avec utilisation limitée ; Plus à partir de 20 $/mois | Recherche web gratuite ; l’API OpenAlex propose un niveau gratuit |
| Idéal pour | Travaux fondateurs, chaînage via Cited by, recherche en texte intégral | Mots-clés incertains et requêtes sous forme de questions | Trouver une catégorie d’étude spécifique avec un rappel élevé | Travail de littérature de bout en bout, avec mémoire et prise en charge des manuscrits | Recherches systématiques, reproductibles et très contrôlées |
Google Scholar
Google Scholar demeure l’outil généraliste. Les pages d’aide officielles confirment que les résultats sont normalement triés par pertinence, et non par date, et que les chercheurs peuvent naviguer via Related articles et Cited by une fois qu’ils disposent d’un article de départ. Ces deux fonctionnalités sont ce qui se rapproche le plus de la découverte conceptuelle dans la recherche par mots-clés, mais elles nécessitent une bonne référence de départ. Ses faiblesses sont bien documentées : pas d’imbrication booléenne, pas de recherche limitée aux résumés, plafond de requête de 256 caractères, limite de 1 000 résultats et aucune exportation en masse. Cette combinaison explique pourquoi les bibliothécaires l’excluent régulièrement en tant que base de données principale pour les revues systématiques.
Elicit et SciSpace
Elicit se présente comme une IA permettant de rechercher, résumer, extraire des données et converser avec plus de 125 millions d’articles, utilisée par plus de 2 millions de chercheurs. Elicit et SciSpace acceptent tous deux des questions en langage naturel et classent les résultats selon la similarité sémantique, ce qui explique qu’ils récupèrent des articles dont la formulation diverge de celle de la requête. Le compromis est un biais de classement dans la direction opposée à celle de Google Scholar : ils peuvent promouvoir des articles sémantiquement proches mais de faible qualité ou peu cités. SciSpace est généralement plus rapide et plus adapté à l’obtention rapide d’informations qu’à une synthèse itérative approfondie. Les résultats peuvent aussi être non déterministes ; ainsi, une même requête peut ne pas renvoyer deux fois le même ensemble.
Undermind
Undermind est l’outil spécialiste. Il combine récupération par mots-clés et récupération sémantique, puis utilise un modèle de pointe pour déterminer si le titre, le résumé et les métadonnées disponibles répondent réellement à la consigne, avant d’itérer avec une recherche de citations. Dans un test comparé à l’ensemble inclus d’une revue systématique, il a récupéré 8 des 11 articles de référence parmi les 10 premiers résultats (recall@10 de 72,7 %) et 9 sur 11 avant le rang 50 (recall@50 de 81,8 %). Cette qualité prend du temps et fonctionne mal sur des sujets vagues. Il voit principalement le titre et le résumé, ainsi qu’une partie des textes intégraux en accès libre ; des affirmations enfouies uniquement dans les méthodes ou les résultats peuvent donc lui échapper.
Jenova's Academic Research Assistant
Jenova's Academic Research Assistant est un partenaire de recherche conscient des disciplines, plutôt qu’un index d’articles autonome. Il effectue une découverte de littérature en direct sur des sources savantes, puis accompagne le projet durant la synthèse, la préparation du manuscrit et la gestion des citations. Sa mémoire persistante lui permet de se souvenir que votre terme de travail est « fatigue cognitive », alors que la littérature utilise aussi « épuisement de l’ego » et « besoin de récupération », et de conserver ces groupes de synonymes rattachés au même projet entre les sessions.
La limite honnête est architecturale. Il ne propose pas d’index sémantique propriétaire de 125 millions d’articles avec des tableaux d’extraction intégrés au sens d’Elicit, et ce n’est pas un outil de recherche itérative de plusieurs minutes à la manière d’Undermind, avec un benchmark recall@10 publié. Sa force réside dans l’orchestration : consignes en langage naturel, recherche savante en direct, questions de suivi et aide à la rédaction dans un même fil. Les chercheurs ayant besoin d’une piste d’audit booléenne reproductible devraient toujours utiliser The Lens ou OpenAlex en parallèle.
Comment la recherche sémantique récupère-t-elle des articles qui emploient des formulations différentes pour la même idée ?
La recherche sémantique récupère des articles formulés différemment en encodant la requête et la collection de documents dans un espace de sens partagé, puis en récupérant les voisins les plus proches au lieu d’exiger des tokens communs. Si la requête est « comment les infirmières de nuit retrouvent-elles leur attention après des gardes consécutives ? », un moteur lexical recherche ces mots. Un moteur sémantique peut récupérer des études intitulées autour de la « perturbation circadienne », du « sommeil de récupération » ou de la « fatigue professionnelle », même lorsque « infirmières » ou « attention » n’apparaissent jamais dans le titre.
Semantic Scholar, le moteur de littérature de l’Allen Institute for AI, a été une première démonstration publique de cette idée : classer des articles scientifiques selon le sens compris plutôt que selon la correspondance de chaînes de caractères. Elicit et SciSpace appliquent un principe similaire à l’échelle des applications web. Tay décrit un test particulièrement clair : collez un paragraphe de journal qui décrit les résultats d’une étude, et un moteur sémantique peut faire émerger l’article scientifique sous-jacent, car l’embedding du texte journalistique est proche de celui de l’article. La recherche par mots-clés survit presque jamais à cette paraphrase.
Il existe un second mécanisme, plus discret : l’expansion de requête au sein de l’assistant. Un Agent conversationnel peut générer des ensembles de synonymes, des concepts apparentés de type MeSH, des antonymes et des variantes disciplinaires, puis rechercher explicitement ces variantes. Il ne s’agit pas d’une recherche vectorielle pure. C’est une compréhension sémantique utilisée pour construire un meilleur filet lexical. En pratique, les flux de travail au meilleur rappel font les deux : ils utilisent les embeddings pour récupérer des formulations inconnues, puis vérifient avec des expressions exactes, des noms d’auteurs et des liens de citation afin de maintenir un ensemble auditable.
Tester cela sur une consigne en direct révèle généralement vite l’écart. Demandez à un moteur de mots-clés « la perception des enseignants » et vous obtiendrez surtout des articles employant ce terme exact de recherche en éducation. Demandez à un assistant sémantique « comment les enseignants détectent et interprètent en temps réel une réflexion inattendue d’un élève ? », et vous trouverez également des travaux classés sous « vision professionnelle », « évaluation formative » ou « prise de décision en situation ». Le second ensemble est celui que l’écart de vocabulaire aurait dissimulé.
Quand faut-il encore utiliser la recherche par mots-clés plutôt qu’un assistant IA sémantique ?
Vous devriez toujours utiliser la recherche par mots-clés lorsque vous devez retrouver un élément connu, suivre les citations depuis un article de départ, rechercher une expression en texte intégral ou mettre en place une stratégie booléenne reproductible pour une revue systématique. Le classement sémantique est le mauvais instrument lorsque la tâche consiste à « trouver ce titre », « trouver tous les articles qui citent cet essai » ou « documenter une chaîne de recherche qu’un évaluateur peut relancer ».
Google Scholar constitue la bonne première étape pour trois tâches courantes. Premièrement, la recherche d’un élément connu : placez le titre entre guillemets, comme le recommandent l’aide de Google et la plupart des guides de bibliothèque. Deuxièmement, la cartographie de l’autorité : ouvrez un article marquant et parcourez Cited by pour voir ce que le domaine a fait ensuite, ou Related articles pour étendre la recherche depuis un article de départ. Troisièmement, la recherche d’expressions dans le texte intégral : si le concept est le nom distinctif d’une méthode, d’un jeu de données ou d’une échelle, la recherche lexicale en texte intégral repérera des mentions que les index sémantiques de titres et résumés manquent.
Pour les recherches systématiques ou très précises, n’utilisez ni Google Scholar ni la plupart des applications sémantiques comme système de référence. The Lens et OpenAlex prennent en charge l’imbrication booléenne, les opérateurs de proximité, la recherche par champ et les vocabulaires contrôlés. OpenAlex est un catalogue ouvert comptant 517 millions de travaux, 5,8 milliards de relations dans son graphe et un jeu de données du domaine public sous licence CC0. Une note de bibliothèque publiée en 2026 estimait sa couverture à environ 474 millions de publications, avec un accent sur l’accès libre et la transparence. Google Scholar ne peut pas rivaliser avec cette auditabilité : il limite l’affichage à 1 000 résultats et ne propose pas d’accès en masse.
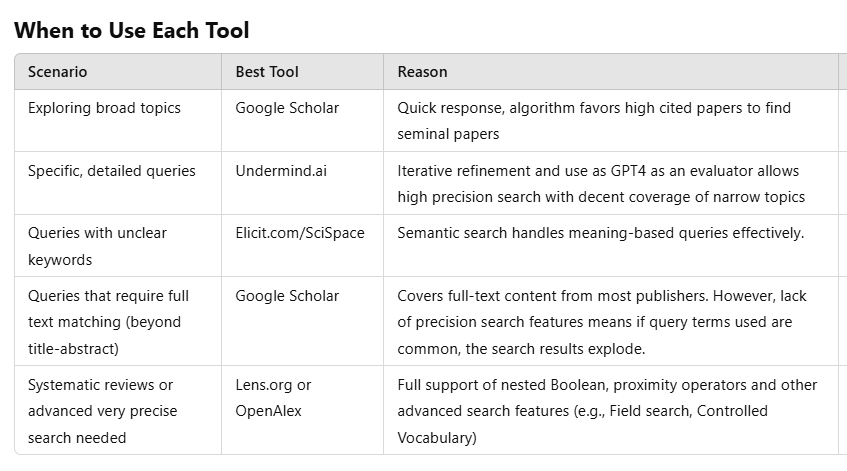
Utilisez le tableau ci-dessus comme règle d’orientation, non comme test de fidélité. L’orientation générale et l’identification des articles fondateurs restent du ressort de Google Scholar. Les formulations incertaines vont vers Elicit ou SciSpace. Une question d’existence très précise — « existe-t-il des RCT utilisant un LLM comme outil de sélection sur titre et résumé, et rapportant précision et rappel ? » — est une consigne pour Undermind. Les recherches reproductibles, riches en opérateurs, appartiennent à The Lens ou OpenAlex.
Comment mener une recherche bibliographique combinant les deux approches ?
Vous menez une recherche combinée en commençant par une consigne conceptuelle, en récupérant sémantiquement des articles candidats aux synonymes divers, puis en consolidant l’ensemble avec des opérateurs lexicaux, du chaînage de citations et une base de données très contrôlable. La séquence compte. Si vous commencez dans Google Scholar avec une seule expression, vous héritez des angles morts de cette expression. Si vous ne quittez jamais une liste classée sémantiquement, vous héritez de ses problèmes de qualité et de reproductibilité.
Une séquence pratique se présente ainsi :
- Rédigez le besoin d’information comme vous l’expliqueriez à un collègue, en incluant les populations, les résultats recherchés et les formulations dont vous savez déjà qu’elles sont instables.
- Exécutez cette consigne dans un assistant sémantique afin de recueillir des articles candidats et le vocabulaire qu’ils emploient réellement.
- Construisez un tableau de synonymes à partir de ces titres et résumés.
- Réutilisez les termes élargis dans Google Scholar avec des guillemets,
author:, des limites de date et Cited by / Related articles. - Pour tout ce qui doit être exhaustif ou auditable, reconstruisez la stratégie dans The Lens ou OpenAlex avec Boolean imbriqué et des restrictions par champ.
- Tenez un journal d’inclusion continu afin que les relances sémantiques non déterministes ne modifient pas silencieusement la base de preuves.
Dans Jenova's Academic Research Assistant, le premier tour peut être une consigne conceptuelle plutôt qu’une chaîne de mots-clés :
« Je cherche des articles empiriques sur la manière dont les travailleurs du savoir à distance récupèrent de la fatigue cognitive. Incluez les études pouvant employer les termes épuisement professionnel, épuisement de l’ego, besoin de récupération, rumination hors travail ou détachement psychologique au lieu du mot fatigue. Privilégiez les revues de psychologie du travail et d’IHC à partir de 2018, et indiquez le synonyme effectivement employé par chaque article. »
Une question de suivi transforme ensuite le tableau de synonymes de l’assistant en stratégie lexicale que vous pouvez coller dans Google Scholar ou The Lens :
« Transformez les groupes de synonymes en trois requêtes Google Scholar et une chaîne Boolean imbriquée adaptée à OpenAlex ou The Lens. Séparez les requêtes limitées aux titres des requêtes en texte intégral. »
Dans Elicit ou SciSpace, posez la question en langage naturel plutôt qu’avec des mots-clés — Tay note que les requêtes en langage naturel ont tendance à moins bien fonctionner dans Google Scholar et mieux dans ces outils sémantiques. Dans Undermind, ajoutez des contraintes jusqu’à ce que la consigne ne puisse correspondre qu’à un type d’étude précis. Une fois l’ensemble d’articles candidats constitué, l’agent Deep Research de Jenova est le meilleur outil pour lire plusieurs sources et produire une synthèse citée, tandis que l’Academic Research Assistant reste l’outil le plus adapté pour rester dans le flux de travail savant de découverte, de citation et d’aide au manuscrit.
Une précaution s’applique à chaque étape assistée par IA. Considérez les listes classées et les résumés générés comme des aides à la récupération, et non comme un processus de sélection terminé. Les dix premiers résultats sémantiques manquent des articles. Les évaluations de pertinence par LLM concordent souvent avec les humains, mais pas toujours. Les affirmations fondées sur le texte intégral nécessitent toujours le PDF.
Que disent les bibliothécaires de recherche et les évaluateurs d’outils sur la découverte sémantique par IA ?
Les bibliothécaires de recherche et les évaluateurs indépendants considèrent généralement les assistants IA sémantiques comme des compléments à Google Scholar, et non comme des remplacements ; ils évaluent les outils selon la qualité de recherche pour un cas d’usage donné plutôt que selon les catégories marketing. La comparaison publiée la plus utile dans ce domaine provient de revues fondées sur la pratique, et non de benchmarks de fournisseurs.
« Si je ne connaissais pas à l’avance mon cas d’usage et ne pouvais choisir qu’un seul outil de recherche universitaire, choisir Google Scholar serait une évidence. Ce n’est pas un argument contre la recherche par IA. C’est un argument contre l’idée qu’une seule fonction de classement suffit. Scholar reste l’outil généraliste. Les nouveaux outils gagnent leur place lorsque la requête est sémantiquement maladroite ou extrêmement spécifique. »
« L’échec que j’observe le plus souvent est une inadéquation entre le type de requête et le moteur. Les gens saisissent un sujet large dans un Agent itératif et attendent plusieurs minutes un ensemble plus étroit que nécessaire. Ou ils saisissent un paragraphe en langage naturel dans un moteur lexical et concluent que la littérature n’existe pas. L’écart de vocabulaire est généralement une erreur de flux de travail avant d’être une lacune de base de données. »
« Le classement sémantique modifie aussi le sens de “pertinent”. Si vous ne pondérez pas les citations, vous verrez plus tôt des articles plus récents et parfois plus faibles. Si vous pondérez les citations, vous redécouvrirez sans cesse le même canon. Les chercheurs qui veulent des travaux conceptuellement liés, mais formulés différemment, ont besoin du premier comportement. Ceux qui veulent les articles que tout le monde s’attendra à les voir citer ont besoin du second. Un processus compétent utilise les deux et explique pourquoi. »
— Équipe produit de Jenova, systèmes de découverte de littérature, 8 ans de conception de flux de travail de recherche universitaire
Cette approche correspond aux données publiques. Les guides universitaires recensent désormais les outils de recherche IA utilisés dans les revues de littérature, et les revues de produits distinguent le passage itératif plus lent d’Undermind de l’analyse sémantique plus rapide de SciSpace. Le consensus des experts est méthodologique, non tribal : choisissez le modèle de récupération correspondant à l’écart que vous cherchez à combler.
Quel outil convient aux revues systématiques par rapport à la cartographie exploratoire de la littérature ?
Les revues systématiques ont besoin d’une infrastructure lexicale très contrôlable ; la cartographie exploratoire de la littérature requiert un rappel sémantique et une itération rapide ; la plupart des travaux de thèse et de demande de subvention nécessitent une approche hybride, avec un protocole écrit pour chaque étape. Confondre ces tâches conduit les équipes soit à manquer des études conceptuellement liées, soit à produire un ensemble de preuves impossible à reproduire.
Pour la cartographie exploratoire — « qu’a-t-on écrit sur cette idée, sous n’importe quel nom ? » — commencez par une recherche sémantique. Elicit, SciSpace et un assistant de recherche conversationnel sont conçus pour cette question. Google Scholar peut contribuer une fois que vous avez des articles de départ, via Related articles et Cited by, et il reste inégalé pour localiser rapidement des PDF et des liens de bibliothèque. Jenova's Academic Research Assistant convient à cette étape lorsque vous avez aussi besoin que la carte persiste : décisions de synonymie enregistrées, pistes écartées et formatage des citations pour la rédaction finale.
Pour les revues systématiques ou de portée, ne laissez pas une liste classée sémantiquement devenir la recherche officielle. Utilisez The Lens ou OpenAlex comme socle reproductible, documentez chaque opérateur et considérez Elicit, Undermind ou Jenova comme des aides complémentaires à la découverte de citations et à la sélection. OpenAlex offre en outre une API, un langage de requête destiné aux revues systématiques et un instantané complet sous licence CC0, ce qui constitue l’opposé d’un tri de pertinence fermé. Le plafond de 1 000 résultats et l’absence d’accès en masse de Google Scholar l’excluent comme recherche principale documentée, même s’il reste utile pour vérifier si une étude connue a été indexée.
Pour les questions d’existence étroites — « existe-t-il un article de ce type ? » — Undermind est l’outil spécialiste, à condition de pouvoir attendre et que les preuves fondées sur le titre et le résumé suffisent. Pour la production de manuscrit une fois l’ensemble constitué, la combinaison de découverte de littérature et de gestion des citations de Jenova est plus pertinente qu’une autre interface de découverte uniquement, avec la réserve qu’une méta-analyse exigeant beaucoup d’extraction reste du ressort d’un outil d’extraction dédié tel qu’Elicit.
La règle de décision est suffisamment simple pour être réutilisée. Si la formulation varie et que vous ne connaissez pas encore le jargon du domaine, utilisez d’abord un assistant de recherche IA sémantique. Si vous devez défendre la chaîne de recherche, utilisez une infrastructure par mots-clés avec des opérateurs avancés. Si vous devez faire les deux — ce qui est la situation normale pour trouver des articles conceptuellement liés avec une formulation différente — utilisez le rappel sémantique pour découvrir le langage, puis le contrôle lexical pour le capturer et le documenter.
Références
- Aaron Tay — Google Scholar face aux autres outils de recherche IA (Undermind, Elicit, SciSpace)
- Google Scholar — Aide officielle sur la recherche
- Elicit — IA pour la recherche scientifique
- OpenAlex — Catalogue ouvert du système mondial de recherche
- Paperguide — Comparaison des tarifs et fonctionnalités d’Elicit et SciSpace (2026)
- Undermind — Cochercheur IA pour la littérature
- University of Alberta / JCHLA — Évaluation du produit Undermind.ai
- Paperpile — Comment utiliser Google Scholar
- TUHH — OpenAlex comme alternative ouverte pour la recherche universitaire
- Semantic Scholar — Outil de recherche propulsé par IA
- UBC Wiki — Outils de recherche IA utilisés dans les revues de littérature et les recherches exhaustives
- SciSpace — Comparaison entre Elicit et SciSpace
- The Lens — Version 8.5 et intégration d’OpenAlex
- PMC / NIH — Fonctionnalités d’OpenAlex et potentiel pour la synthèse des preuves