Backend d’Agent AI : une API unique ou un développement à partir de zéro (juillet 2026)
2026-07-24
Chaque équipe d’ingénierie qui déploie des fonctionnalités AI en 2026 rencontre le même dilemme : construire le backend d’Agent à partir de zéro ou en intégrer un. Construire implique d’assembler des API de modèles, des frameworks d’orchestration, des bases de données vectorielles, des stockages de mémoire et des serveurs d’outils — une stack qui mobilise des trimestres de travail d’ingénierie avant votre première interaction utilisateur. L’API Jenova Agent est l’alternative : un backend d’Agent entièrement géré, où l’orchestration, la mémoire, le stockage, le RAG et les outils s’exécutent derrière une intégration unique.
- ✅ Remplacez toute la stack d’Agent DIY — routage des modèles, orchestration, mémoire, RAG et outils — par une seule API
- ✅ Créez et lancez des Agents personnalisés, de niveau production, définis par vos instructions, modèles, bases de connaissances et outils
- ✅ Accédez aux modèles d’OpenAI, Anthropic, Google, xAI, Qwen et plus encore avec un seul identifiant
- ✅ Exécutez vos Agents sur une infrastructure éprouvée en production auprès de plus de 30 000 utilisateurs dans plus de 70 pays
Pour prendre honnêtement la décision entre construire et intégrer, vous avez besoin des vrais chiffres : ce que coûte réellement la création, l’exploitation et la maintenance d’un backend d’Agent conçu à partir de zéro en 2026.
Réponse rapide : qu’est-ce qu’un backend d’Agent AI ?
Un backend d’Agent AI est la couche d’infrastructure qui permet à un Agent de fonctionner en production : orchestration entre modèles et outils, mémoire et contexte persistants, recherche dans des données privées, ainsi que les systèmes sous-jacents de calcul, de mise à l’échelle et de fiabilité. Le construire à partir de zéro signifie gérer cinq systèmes distincts ou davantage ; une API d’Agent gérée les fournit tous via une seule intégration.
Principales capacités d’un backend d’Agent géré :
- Orchestration d’Agent coordonnant modèles, outils, mémoire et récupération dans des flux de travail en plusieurs étapes
- Routage multi-modèles entre fournisseurs — sans verrouillage fournisseur ni gestion de clés par fournisseur
- Mémoire conversationnelle et contexte illimités intégrés à chaque session
- Stockage relationnel et vectoriel entièrement géré avec RAG intégré
- Intégration d’outils via des outils natifs à la plateforme et tout serveur MCP distant
Le problème : ce que coûte réellement une création à partir de zéro
La pression du marché pour livrer des Agents est intense. Les logiciels d’entreprise sont en passe d’intégrer l’AI agentique dans 33 % des applications — contre moins de 1 % en 2024 (Datagrid) — et 67 % des dirigeants s’attendent à ce que des Agents AI opèrent de manière indépendante au sein de leurs organisations d’ici 2027 (VAST Data).
Mais créer le backend nécessaire pour en prendre en charge un est extrêmement coûteux et lent :
- Une logique d’orchestration qui devient une seconde discipline d’ingénierie
- Des API de modèles sans état et sans mémoire entre les appels
- Des pipelines RAG aux modes de défaillance documentés et récurrents
- Toute la plomberie d’intégration d’outils pour chaque capacité externe
- Une infrastructure de production qui doit monter en charge, rester fiable et passer les examens de sécurité
- Un coût total de première année qui éclipse toutes les estimations de prototype
Le budget réel : les appels de modèles ne représentent que 2 % de l’histoire
La démo d’un « Agent à 100 $/mois » masque la véritable structure des coûts. Une analyse d’ingénierie détaillée estime le coût réaliste de première année d’un Agent de production petit à moyen à **270 000–690 000 $** — les appels d’API de modèles ne représentant qu’environ 2 % du total (Particle41).
Le reste va dans des postes qu’aucune vidéo de démo ne montre :
**30 000–80 000 $** — pour l’ingénierie initiale des prompts et leur amélioration à elle seule, soit 200 à 400 heures d’ingénierie facturées à 150–200 $/heure (Particle41)
**1 000–5 000 $/mois** — pour l’hébergement de la base de données vectorielle, auxquels s’ajoutent 1 000–2 000 $/mois pour la génération d’embeddings (Particle41)
30 000–60 000 $ — pour l’ingénierie d’intégration des données afin de connecter l’Agent à seulement 4 ou 5 systèmes existants (Particle41)
6 000–10 000 $/mois par ETP — pour la supervision humaine des défaillances, car même un Agent précis à 95 % qui gère 10 000 interactions mensuelles génère 500 cas nécessitant un examen manuel (Particle41)
Et cela ne s’arrête pas au lancement : la deuxième année coûte encore 150 000–300 000 $par an pour l’exploitation et l’amélioration ([Particle41](https://particle41.com/insights/real-cost-of-building-ai-agent/)). Même des estimations plus restreintes, limitées au développement, vont de 20 000 à 60 000$ pour des Agents de tâches simples (Biz4Group) et de 10 000 à plus de 400 000 $ pour les systèmes multi-Agents (Azilen).
L’orchestration devient un produit à part entière
Un Agent de production ne répond pas une seule fois : il planifie, appelle des outils, récupère du contexte, évalue des résultats intermédiaires et se remet d’erreurs au fil d’exécutions en plusieurs étapes. Construire cette boucle de coordination nécessite des machines à états, une logique de nouvelle tentative, une gestion des délais d’expiration et des garde-fous de coûts qui n’ont rien à voir avec votre véritable produit.
Les praticiens décrivent sans détour cet écart : construire un Agent prend quelques jours ; le mettre en production en prend six mois, avec des boucles non protégées qui font exploser les factures d’API et une perte d’état qui détruit les tâches de longue durée (
). Des frameworks tels que LangGraph et CrewAI fournissent des abstractions pour cette couche (Speakeasy), mais les abstractions ne s’exécutent pas seules : vous devez toujours héberger, mettre à l’échelle, sécuriser et maintenir tout ce qui se trouve en dessous.Les pipelines RAG sont une obligation permanente, pas un projet
Ancrer un Agent dans vos données privées signifie gérer l’ingestion, la segmentation, la génération d’embeddings, l’indexation, le reranking et la synthèse — et les praticiens avertissent régulièrement qu’un pipeline RAG « est non seulement plus difficile qu’il n’y paraît, mais exige également une expertise continue en LLM, en recherche d’information et en MLOps spécialisés » (Vectara).
Une étude de cas documentée décrit un projet RAG interne « simple » qui, commencé en janvier, avait mobilisé en mars un ingénieur à temps plein déboguant les hallucinations, un ingénieur data à temps plein luttant contre les problèmes d’ingestion et un ingénieur DevOps combattant l’infrastructure — tandis que le budget avait triplé (Towards AI). Le même témoignage documente le cycle typique de huit semaines : problèmes de latence, cas limites, réécriture complète, nouveaux problèmes d’hallucinations, migration de base de données vectorielle et nouvelle réécriture.
Les infrastructures héritées n’ont pas été conçues pour les Agents
Les charges de travail des Agents exigent un accès continu et en temps réel aux données — et les infrastructures de données héritées, conçues pour des charges transactionnelles, « ne peuvent pas prendre en charge le raisonnement continu et le passage à l’action requis par les Agents AI autonomes » (VAST Data). Une infrastructure d’Agent de niveau entreprise nécessite une fondation de données unifiée, un stockage haute performance, une vectorisation en temps réel, une orchestration intelligente et une gouvernance zéro confiance — cinq couches de capacités distinctes avant même d’écrire la logique produit.
40 % — des projets d’AI agentique échouent en raison de fondations d’infrastructure inadéquates (Landbase)
C’est précisément le problème que l’API Jenova Agent a été conçue pour éliminer.
La solution : l’API Jenova Agent
L’API Jenova Agent est un service d’infrastructure d’Agent entièrement géré : une intégration qui remplace la stack DIY composée d’API de modèles, de frameworks d’orchestration, de bases de données vectorielles, de stockages de mémoire et de serveurs d’outils. Vous définissez les instructions de votre Agent, sélectionnez un modèle, importez une base de connaissances et configurez des outils — l’API gère l’orchestration, la mémoire, le stockage et la mise à l’échelle, afin que vous déployiez des Agents personnalisés de niveau production en quelques jours plutôt qu’en trimestres.
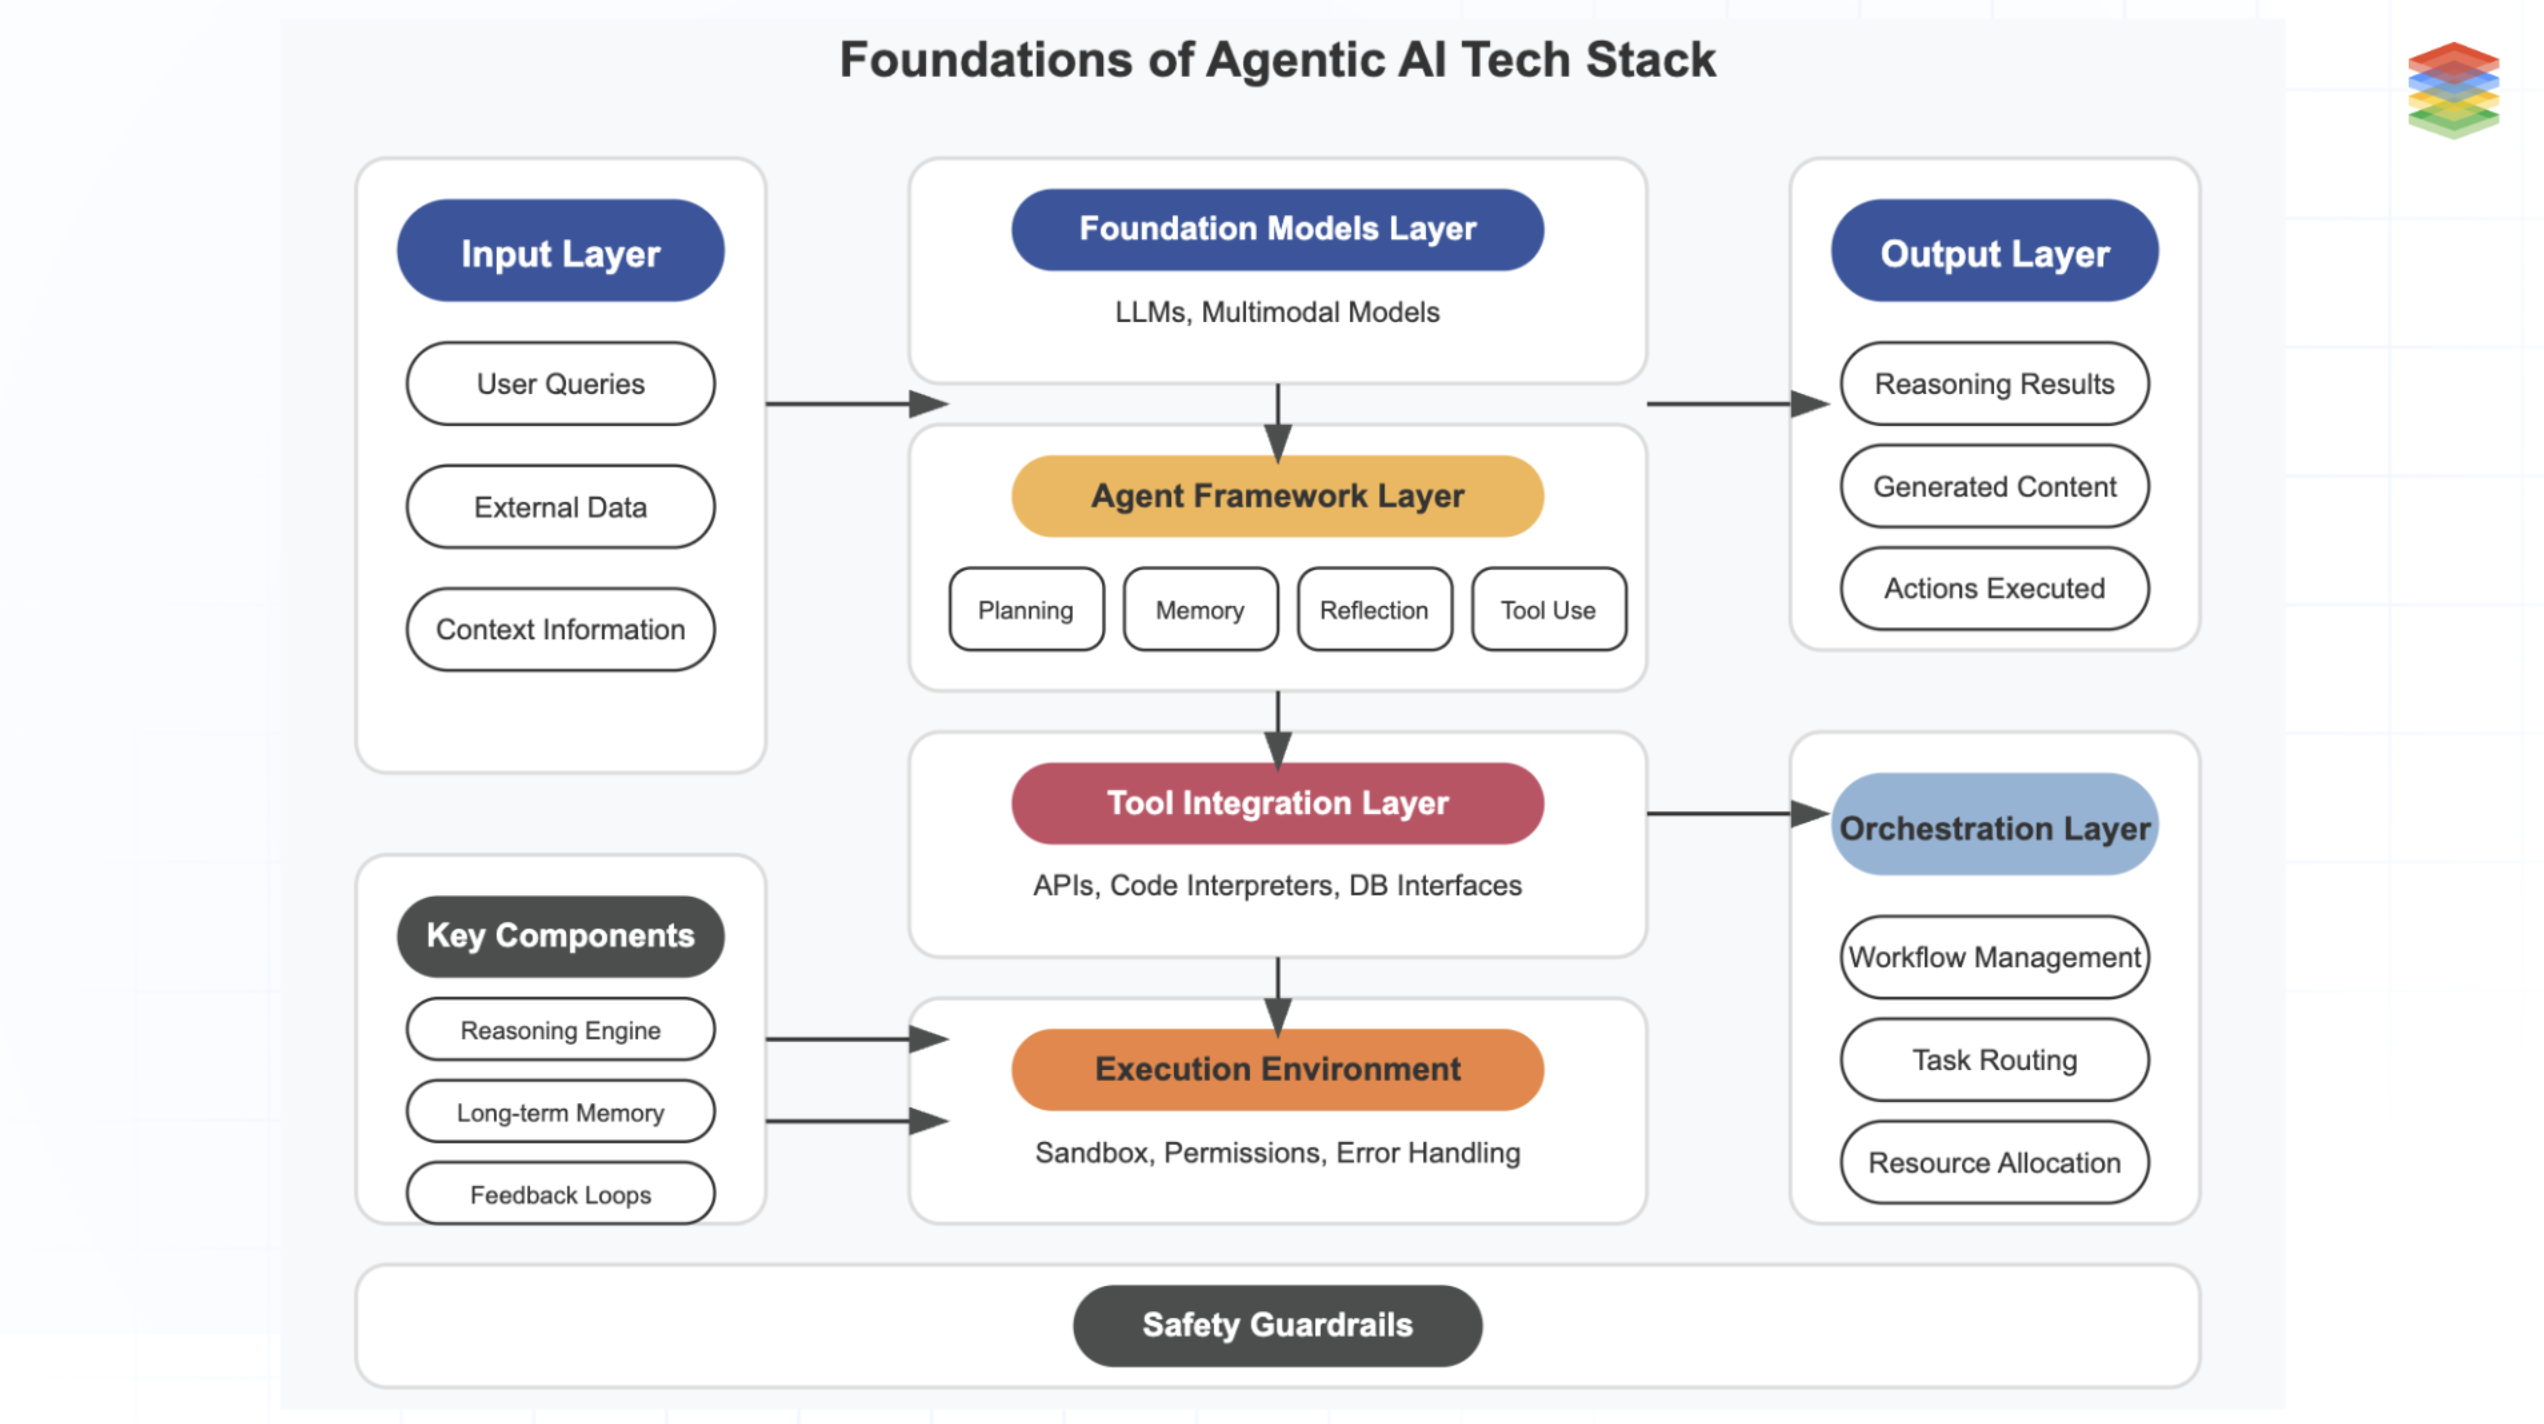
Chaque couche du diagramme ci-dessus — la planification, la mémoire, la réflexion et l’utilisation d’outils du framework d’Agent ; les API et interfaces de bases de données de la couche d’intégration d’outils ; le sandboxing et la gestion des erreurs de l’environnement d’exécution ; la gestion des flux de travail et le routage des tâches de la couche d’orchestration — est une infrastructure que le parcours DIY vous impose de créer. L’API Jenova Agent exécute l’ensemble.
| Backend d’Agent DIY | API Jenova Agent |
|---|---|
| Graphes d’orchestration personnalisés, logique de nouvelle tentative, schémas d’état | Orchestration éprouvée en production coordonnant modèles, outils, mémoire et récupération |
| SDK, clés et limites de débit distincts par fournisseur de modèles | Tout modèle majeur via une seule intégration — sans verrouillage fournisseur |
| État de session dans Redis/Postgres avec sérialisation personnalisée | Mémoire et contexte illimités intégrés à chaque session |
| Base de données vectorielle provisionnée, pipelines de segmentation et d’embeddings (1 000–5 000 $/mois) | Stockage relationnel et vectoriel entièrement géré avec RAG intégré |
| Connecteurs d’outils écrits à la main, flux d’authentification, code récurrent de gestion des erreurs | Outils natifs à la plateforme et tout serveur MCP distant, prêts à l’emploi |
| Serveurs, conteneurs, règles de mise à l’échelle, surveillance de disponibilité | Infrastructure gérée de niveau production avec API stables |
Orchestration d’Agent
Le raisonnement en plusieurs étapes, l’appel d’outils, la récupération et la synthèse des réponses s’exécutent au sein de la plateforme — aucun graphe, schéma d’état ou DAG de flux de travail à créer et maintenir. Vous définissez ce que l’Agent doit accomplir ; l’infrastructure détermine comment, avec l’exécution contrôlable et bornée qu’exige la fiabilité en production.
Utilisez n’importe quel modèle
Alimentez vos Agents avec des modèles d’OpenAI, Anthropic, Google, xAI, Qwen et plus encore via un seul identifiant. Exécutez un modèle de pointe pour les raisonnements complexes et un modèle économique pour les sessions à fort volume — changez librement de modèle par Agent, sans gestion de clés par fournisseur ni travail de migration lors de la sortie de nouvelles générations de modèles. Vos couches de mémoire et de connaissances survivent à chaque changement.
Mémoire et contexte
La mémoire conversationnelle et le contexte illimités sont intégrés à chaque session. Transmettez un identifiant de session cohérent, et votre Agent mémorise l’historique, les préférences et les projets de longue durée de chaque utilisateur — sans stockage d’état externe, code de sérialisation ni ingénierie de fenêtre contextuelle. La couche la plus sujette aux défaillances de la stack DIY n’existe tout simplement plus de votre côté.
Stockage entièrement géré
Des bases de données relationnelles et vectorielles gérées avec RAG intégré. Importez des documents et des bases de connaissances ; la plateforme gère la segmentation, la génération d’embeddings, l’indexation et la récupération. Aucune base de données vectorielle n’est à provisionner, régler ou mettre à l’échelle — le poste de dépenses de 1 000–5 000 $/mois, ainsi que l’ingénieur qui le maintient, disparaissent.
Outils et MCP
Des intégrations d’outils illimitées avec des outils natifs à la plateforme et tout serveur MCP distant, prêtes à l’emploi — recherche, e-mail, calendriers, documents et vos propres API internes. Aucun code de connecteur, aucune plomberie de flux d’authentification, aucun code récurrent à maintenir au fil de l’évolution des API tierces.
Niveau production
Une infrastructure entièrement gérée avec des API stables, conçue pour le trafic de production — sans serveurs, conteneurs ou règles de mise à l’échelle de votre côté. La plateforme est éprouvée en production auprès de plus de 30 000 utilisateurs dans plus de 70 pays ; vos Agents héritent donc d’une fiabilité que votre équipe n’a jamais besoin de construire.
Un seul appel exécute l’Agent complet :
bashcurl -X POST https://api.jenova.ai/v1/chat \
  -H "Authorization: Bearer YOUR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "agent_id": "your-support-agent",
    "message": "Summarize this customer'\''s open issues and draft a reply.",
    "session_id": "user-4821-session"
  }'
L’orchestration, la mémoire, la récupération et les appels d’outils s’exécutent tous dans cette requête. Votre App affiche la réponse ; la plateforme gère tout ce qui se trouve derrière.
Ce que vous pouvez créer
L’API est conçue pour les développeurs qui déploient des Agents personnalisés avec état en tant que fonctionnalités de leurs propres produits. Chacun des cas suivants est une App que vous pouvez créer et lancer : définissez les instructions et la base de connaissances de l’Agent, et l’API gère l’orchestration, la mémoire et la mise à l’échelle.
Un Agent de support formé sur votre produit
Créez un Agent de support ancré dans votre centre d’aide, votre journal des modifications et votre historique de tickets. La mémoire de session suit l’intégralité du parcours de support de chaque client au fil des interactions — fini les « pouvez-vous répéter votre numéro de compte ? »
- Indexation et récupération des documents gérées de bout en bout
- Systèmes de ticketing et CRM connectés via MCP
- Déployez en quelques jours au lieu de consacrer un trimestre à la gestion d’état
Un analyste financier intégré
Lancez un conseiller de portefeuille dans votre tableau de bord fintech qui mémorise les positions, la tolérance au risque et les objectifs de chaque client tout au long de mois de conversations.
- Contexte de conseil longitudinal maintenu automatiquement
- Données de marché et systèmes de comptes connectés via MCP
- Changement de modèle selon la complexité de la requête pour optimiser les coûts
Un tuteur personnalisé pour votre plateforme d’apprentissage
Déployez un tuteur adaptatif qui suit les progrès, les points faibles et les préférences de chaque étudiant d’une session à l’autre, ancré dans votre programme pédagogique.
- Mémoire par étudiant sans lignes de base de données par utilisateur à gérer
- Les mises à jour du programme sont déployées à l’import, sans réingénierie de la récupération
- Montez à l’échelle jusqu’à des milliers d’apprenants simultanés sur une infrastructure gérée
Un assistant commerce qui connaît votre catalogue
Intégrez un assistant d’achat conversationnel qui connaît votre catalogue, mémorise les préférences et l’historique d’achat de chaque client, et guide la découverte par le dialogue plutôt que par des filtres.
- Catalogue ancré via RAG géré — les mises à jour sont déployées instantanément
- Mémoire des préférences de chaque client sans stockage d’état externe
- Concurrence de niveau production pour les pics de trafic
Un Agent opérationnel interne pour votre équipe
Créez un Agent opérationnel connecté à votre documentation interne, à vos systèmes de tickets et de données — il répond aux questions des employés et exécute des flux de travail de routine avec un contexte organisationnel complet.
- Base de connaissances privée indexée automatiquement
- API internes connectées par des serveurs MCP distants
- Les nouvelles capacités sont déployées par configuration, non par code
Obtenez votre clé API et déployez votre premier Agent en quelques minutes.
Comment ça marche : de la clé API à l’Agent de production en quatre étapes
Étape 1 : obtenez votre clé API
Créez un compte et générez votre clé API depuis le tableau de bord de la plateforme. Un seul identifiant couvre chaque fournisseur de modèles et chaque Agent que vous créez — sans gestion de clés par fournisseur entre le développement, la préproduction et la production.
Étape 2 : créez ou choisissez votre Agent
Définissez un Agent personnalisé avec vos propres instructions, votre modèle préféré, votre base de connaissances et votre configuration d’outils — ou partez d’un Agent préconstruit et adaptez-le. La création de l’Agent relève de la configuration, pas du code : vous décrivez le comportement, et la plateforme fournit l’orchestration, la mémoire et la récupération nécessaires.
Étape 3 : ajoutez des crédits
Rechargez le solde de crédits de votre compte. Chaque appel débite votre solde — sans factures d’infrastructure distinctes, factures de bases de données vectorielles ou coûts de stockage de mémoire cachés en arrière-plan.
Étape 4 : effectuez l’appel
Depuis votre backend, transmettez le message de l’utilisateur avec l’ID de votre Agent et un identifiant de session. Réutilisez l’ID de session, et l’Agent reprend exactement là où il s’était arrêté avec cet utilisateur :
bashcurl -X POST https://api.jenova.ai/v1/chat \
  -H "Authorization: Bearer YOUR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "agent_id": "your-commerce-assistant",
    "message": "Show me trail running shoes like the pair I bought last spring.",
    "session_id": "shopper-9317"
  }'
json{
  "response": "Based on your purchase last spring — the ridge-trail model in size 10 — here are three current options with similar cushioning and grip...",
  "session_id": "shopper-9317"
}
Aucun stockage de mémoire à configurer, aucun pipeline de récupération à maintenir, aucun graphe d’orchestration à déboguer. Les spécifications complètes des points de terminaison, les schémas de requêtes et de réponses, ainsi que les détails d’intégration sont disponibles dans la documentation de l’API.
Résultats et cas d’usage
💼 Start-up SaaS : un sprint au lieu de 270 000–690 000 $
Scénario : Une entreprise SaaS B2B comptant 3 000 clients souhaite un Agent de support dans son App, connaissant sa documentation et mémorisant l’historique de chaque compte — avec une équipe d’ingénierie de trois personnes.
Approche traditionnelle : Le parcours DIY est estimé à 270 000–690 000 $ pour la première année (Particle41) : sélection d’un framework d’orchestration, provisionnement d’une base de données vectorielle, mémoire par client dans Redis ou Postgres, connecteurs d’outils pour le système de tickets, puis hébergement, mise à l’échelle et surveillance — avant la première réponse destinée à un client.
API Jenova Agent : Définissez les instructions de support et les règles d’escalade, importez le centre d’aide et connectez le système de tickets via MCP. La mémoire de session persistante fournit à chaque compte un historique de support continu dès le premier jour.
- ✅ Quelques jours jusqu’à la production au lieu de plusieurs mois
- ✅ Budget d’infrastructure à six chiffres redirigé vers l’ingénierie produit
- ✅ Aucun système de mémoire ou base de données vectorielle à provisionner ou maintenir
📊 Fintech : une fonctionnalité de conseil sans équipe backend
Scénario : Une fintech souhaite proposer un analyste de portefeuille AI comme fonctionnalité premium de son tableau de bord. Ses deux ingénieurs backend n’ont jamais créé d’infrastructure d’Agent.
Approche traditionnelle : Apprendre un framework d’orchestration, créer des flux de conseil avec état, mettre en œuvre la persistance de mémoire pour les relations continues avec les clients, provisionner du RAG pour les documents financiers — soit le même écart de quatre à six mois entre le prototype et le lancement que décrivent les praticiens (
).API Jenova Agent : Configurez un Agent d’analyste financier avec des instructions métier, connectez des données de marché via MCP et laissez la mémoire intégrée maintenir le contexte de portefeuille au fil de chaque conversation de conseil.
- ✅ Aucun framework à apprendre, héberger ou maintenir
- ✅ Mémoire client longitudinale prête à l’emploi
- ✅ Changement de modèle pour optimiser les coûts, sans aucune modification de code
📱 EdTech mobile : du tutorat pour 30 000 étudiants simultanés
Scénario : Une App mobile d’éducation servant 30 000 étudiants a besoin de tuteurs personnalisés dans quatre matières, chacun disposant des connaissances du programme et d’un suivi des progrès par étudiant.
Approche traditionnelle : Configurations d’Agent par matière, persistance de mémoire par étudiant dans des bases de données externes, stockage vectoriel pour le programme — ainsi qu’une infrastructure capable de gérer des dizaines de milliers de sessions simultanées avec état sans perdre le contexte. C’est précisément la charge de travail pour laquelle les infrastructures héritées échouent (VAST Data).
API Jenova Agent : Créez un Agent tuteur par matière avec des instructions et des contenus propres au programme. La mémoire de session conserve automatiquement les progrès de chaque étudiant ; le RAG indexe le programme à l’import.
- ✅ Contexte d’apprentissage persistant et personnalisé, sans stockage d’état externe
- ✅ Mises à jour du programme déployées sans réingénierie de la récupération
- ✅ Concurrence de niveau production dès le premier jour
🎯 Agence produit : quatre clients, une intégration
Scénario : Une agence de développement crée des fonctionnalités AI pour quatre clients — accueil de patients, examen de documents juridiques, découverte de produits de commerce et recherche d’entreprise. Le parcours DIY implique de dupliquer les stockages de mémoire, les pipelines RAG et l’hébergement pour chaque client.
Approche traditionnelle : Quatre stacks d’Agent distinctes — quatre pipelines de récupération, quatre configurations de mise à l’échelle, quatre obligations de maintenance. Étant donné que 40 % des projets agentiques échouent en raison de fondations insuffisantes (Landbase), répliquer quatre fois la couche la plus risquée constitue un pari à l’échelle du portefeuille.
API Jenova Agent : Une seule intégration et une seule clé API pour les quatre clients. Des Agents personnalisés pour chaque mission — instructions métier, modèles, bases de connaissances et outils — s’exécutent tous sur le même backend géré.
- ✅ Une intégration unique qui monte à l’échelle sur un nombre illimité de projets clients
- ✅ Sélection de modèles par client sans gestion de fournisseurs par client
- ✅ Temps d’ingénierie investi dans la logique produit, non dans la réplication de l’infrastructure
FAQ
Combien coûte la création d’un backend d’Agent AI à partir de zéro ?
Les analyses d’ingénierie estiment le coût réaliste de première année d’un Agent de production à 270 000–690 000 $lorsque vous incluez l’infrastructure, l’ingénierie des prompts, les tests, l’intégration des données, les bases de données vectorielles et la supervision humaine — les appels d’API de modèles ne représentant qu’environ 2 % du total ([Particle41](https://particle41.com/insights/real-cost-of-building-ai-agent/)). L’exploitation continue coûte ensuite 150 000–300 000$ par an.
Comment fonctionnent la tarification et les crédits de l’API Jenova Agent ?
L’utilisation est basée sur des crédits : vous ajoutez des crédits à votre compte, et chaque appel API débite votre solde. Il n’y a aucun coût distinct pour l’infrastructure, la base de données ou le stockage de mémoire — la stack gérée est incluse dans l’utilisation, ce qui regroupe en une seule facture ce qui serait autrement cinq ou six factures fournisseurs. Consultez les tarifs actuels sur la page de la plateforme.
Quels modèles puis-je utiliser via l’API ?
Les Agents peuvent être alimentés par des modèles d’OpenAI, Anthropic, Google, xAI, Qwen et plus encore via une seule intégration. Vous sélectionnez le modèle par Agent et pouvez en changer librement — il n’existe aucun verrouillage fournisseur ni travail de migration lors de la sortie de nouvelles générations de modèles. La mémoire et les connaissances persistent malgré les changements de modèle.
L’intégration est-elle difficile comparée à une création avec LangChain ou des API de modèles brutes ?
L’intégration suit un flux en quatre étapes : obtenez une clé API, créez ou choisissez un Agent, ajoutez des crédits et effectuez votre premier appel. Une seule requête POST exécute l’Agent complet — orchestration, mémoire, RAG et outils inclus. Les API de modèles brutes ne fournissent que l’inférence, tandis que des frameworks comme LangChain fournissent des abstractions que vous devez toujours héberger, mettre à l’échelle et maintenir ; l’API Jenova Agent est le backend géré lui-même. Les schémas complets sont disponibles dans la documentation de l’API.
Puis-je créer des Agents personnalisés avec mes propres données et outils ?
Oui. Vous définissez des instructions personnalisées, importez une base de connaissances privée — indexée automatiquement par le RAG géré — sélectionnez votre modèle et configurez des outils, y compris tout serveur MCP distant, ce qui couvre la plupart des API internes. L’Agent se comporte comme une fonctionnalité propriétaire de votre produit, et non comme un assistant générique.
Une API d’Agent gérée est-elle prête pour du trafic réel en production ?
Oui. L’infrastructure est entièrement gérée avec des API stables conçues pour le trafic de production — sans serveurs ni règles de mise à l’échelle de votre côté. La plateforme est éprouvée en production auprès de plus de 30 000 utilisateurs dans plus de 70 pays, et l’utilisation monte en charge avec votre solde de crédits plutôt qu’avec une infrastructure que vous devez provisionner.
Conclusion
Le parcours de création à partir de zéro d’un backend d’Agent AI est bien documenté en 2026 : 270 000–690 000 $ de coûts lors de la première année, des mois d’ingénierie d’orchestration et de RAG, une base de données vectorielle et une couche de mémoire à maintenir indéfiniment, ainsi qu’un écart vers la production qui tue 40 % des projets avant leur lancement. L’appel de modèle n’a jamais été la partie difficile — tout ce qui l’entoure l’est.
L’API Jenova Agent remplace toute cette stack par une seule intégration : des Agents personnalisés définis par vos instructions, modèles, bases de connaissances et outils, exécutés sur une infrastructure entièrement gérée de niveau production avec orchestration, mémoire, stockage et outillage MCP intégrés. Définissez votre Agent, effectuez l’appel et déployez en quelques jours ce que le parcours DIY planifie en trimestres. Commencez à créer avec la documentation de l’API, obtenez votre clé API sur la plateforme API Jenova Agent et découvrez la plateforme étendue sur Jenova.