¿Por qué el mismo personaje de AI cambia de rostro, ropa o peinado entre viñetas de cómic?
2026-08-13
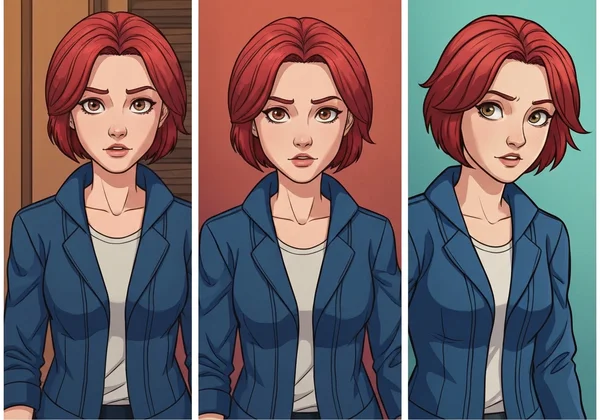
¿Qué causa realmente la deriva de identidad entre viñetas: la redacción del prompt o la arquitectura del modelo?
La deriva de personajes en los cómics con AI es una limitación arquitectónica, no un error de prompting: los modelos de texto a imagen generan cada viñeta como un evento de muestreo independiente, sin memoria de resultados previos. Por ello, una descripción como «detective pelirrojo con gabardina» se resuelve cada vez en una persona estadísticamente plausible, pero no en la misma persona. Las soluciones más fiables canalizan la identidad mediante imágenes de referencia y sistemas de activos, en lugar de texto: herramientas como ComicInk, LTX Studio, Figma Weave y Comic Creator de Jenova convergen en este principio desde enfoques distintos.
Lo que distingue los flujos de trabajo resistentes a la deriva de los propensos a ella:
✅ Generación anclada a referencias: la identidad se transporta mediante un activo de imagen, no se vuelve a describir en prosa en cada viñeta
✅ Desacoplamiento de atributos: el rostro, el cabello, el vestuario y el fondo se bloquean de forma independiente para que un cambio de escena no reorganice al personaje
✅ Separación entre primer plano y fondo: las investigaciones muestran que los detalles del fondo se desvían incluso cuando el rostro se mantiene (CharaConsist, ICCV 2025)
✅ Disciplina de vocabulario: «gabardina marrón» debe seguir siendo «gabardina marrón», nunca «abrigo» o «chaqueta»
✅ Tolerancia al movimiento: los métodos de consistencia se degradan drásticamente cuando un personaje cambia de pose o acción
Para evaluar con honestidad cualquier herramienta o flujo de trabajo, primero conviene comprender los cuatro mecanismos de fallo distintos que se esconden tras el único síntoma de «mi personaje se ve diferente».
¿Cuáles son las cuatro causas técnicas de la deriva de personajes?
La deriva tiene cuatro causas separables, y cada una requiere una solución diferente. Tratarlas como un único problema es la razón por la que la mayoría de creadores pasan de un ajuste de prompt a otro sin lograr resolverlo por completo.
1. No hay mecanismo de memoria. Cada generación es un evento independiente. El desglose técnico de LTX Studio lo expresa claramente: el modelo «no puede “recordar” rasgos de personajes generados previamente», por lo que cada renderizado vuelve a empezar desde la descripción textual. Un prompt es una distribución de probabilidades, no una especificación: «ojos verdes, unos 35 años» describe millones de rostros válidos.
2. Entrelazamiento entre estilo e identidad. Los modelos tienen dificultades para separar quién es el personaje de cómo se ve la imagen. Cambia la dirección artística entre viñetas —iluminación dramática, un plano más abierto— y la geometría facial cambia con ella, porque el modelo nunca aprendió que son variables independientes.
3. Brechas de perspectiva y razonamiento 3D. Renderizar a la misma persona desde un ángulo nuevo exige una comprensión implícita en 3D que el modelo no posee. Por eso las vistas laterales y traseras son las que más se desvían, y por eso LTX recomienda específicamente referencias frontales para disponer de flexibilidad posterior.
4. Dispersión de atención. El modelo distribuye una atención finita entre el personaje, el vestuario, el fondo y el estilo de forma simultánea. Añade complejidad narrativa y el detalle del personaje pierde la competencia.
🎯 Por qué la ropa se desvía más que los rostros
El vestuario es el modo de fallo menos comentado. El artículo CharaConsist de ICCV 2025 descubrió que los métodos de referencia de identidad, incluidos IP-Adapter y PhotoMaker, «se centran únicamente en preservar la identidad facial y no pueden garantizar la consistencia de otros atributos como la ropa o las escenas». Las herramientas que bloquean el rostro pueden mantener una cara estable mientras la chaqueta cambia de color, el cuello se rediseña y los accesorios desaparecen, porque esos sistemas nunca fueron entrenados para conservarlos.
¿Cuánta consistencia pueden lograr realmente los métodos actuales?
La consistencia medida es real, pero parcial: ningún método alcanza un bloqueo total de identidad, y las cifras muestran exactamente dónde falla cada enfoque. El equipo de CharaConsist comparó cuatro métodos líderes mediante la similitud de imagen CLIP, dividida en componentes de primer plano (CLIP-I-fg) y fondo (CLIP-I-bg), además de la similitud de incrustaciones faciales (ID Sim).
Sus resultados publicados sitúan a CharaConsist en 0.883 de CLIP-I-fg y 0.916 de CLIP-I-bg en tareas que mantienen el fondo, frente a 0.876 y 0.895 para ConsiStory. La diferencia aumenta específicamente en la consistencia del fondo, la dimensión que la mayoría de los métodos ignora por completo.
En un estudio de preferencia humana citado en el mismo artículo, los evaluadores eligieron CharaConsist frente a las líneas base el 64 % de las veces en consistencia de vestuario y el 98 % de las veces en consistencia de fondo, mientras que la preferencia de alineación textual fue de solo el 57 %: una compensación medible entre bloquear la identidad y seguir el prompt.
Esa compensación es la tensión central de toda esta categoría. Cada mecanismo de consistencia restringe el generador, y la restricción reduce la capacidad de respuesta al prompt. El propio estudio de ablación del artículo muestra que FLUX.1 con CharaConsist aplicado obtiene una puntuación inferior en CLIP-T, la alineación de texto, que el modelo base sin modificar.
📊 El problema del movimiento
Los métodos de consistencia se degradan con el movimiento. Los autores de CharaConsist lo señalan directamente: «cuando el personaje en primer plano experimenta grandes variaciones de movimiento, las inconsistencias en la identidad y los detalles de la ropa se hacen evidentes». Para los cómics, un medio construido sobre personajes que corren, luchan, gesticulan y reaccionan, esta es la limitación más difícil. Una viñeta de personajes hablando se mantiene mucho mejor que una viñeta de acción, y cualquier comparación de herramientas que solo evalúe retratos estáticos exagera el rendimiento en condiciones reales.
¿Qué enfoques existen y cómo se comparan?
Existen cuatro enfoques arquitectónicos distintos, y todos intercambian los mismos tres factores: coste de configuración, fuerza de consistencia y flexibilidad creativa.
| Dimensión | Generadores generales (Midjourney, DALL·E) | ComfyUI + IP-Adapter/ControlNet | Plataformas de activos de referencia (LTX, Figma Weave, ComicInk) | Jenova Comic Creator |
|---|---|---|---|---|
| Mecanismo de consistencia | Reutilización de seed + repetición de prompt | Adaptadores entrenados, LoRA, incrustaciones faciales | Activos de personajes guardados y reutilizados en cada generación | Memoria conversacional persistente + definiciones de personajes guardadas |
| Consistencia facial | Débil; los usuarios la identifican como el fallo principal | Fuerte; IP-Adapter FaceID está optimizado para identidad | Fuerte; anclada a activos | Fuerte para personajes definidos; varía según el modelo seleccionado |
| Consistencia de vestuario | Débil | Débil; brecha documentada en métodos de referencia de identidad | Gestionada mediante variantes de atuendo (duplicar y modificar en LTX) | Se mantiene mediante fichas de personaje explícitas en la memoria de sesión |
| Coste de configuración | Mínimo | Alto; creación de flujos, pesos de modelos y GPU | Moderado; primero hay que crear la biblioteca de personajes | Bajo; configuración conversacional, sin ajustes técnicos |
| Flexibilidad de pose/acción | Alta, pero inconsistente | Moderada; ControlNet aporta control de pose | Moderada; el sesgo hacia referencias frontales limita los ángulos | Moderada; la deriva aumenta con acciones extremas |
| Hardware local | Ninguno | 3–37 GB de VRAM según el modo de descarga | Ninguno | Ninguno |
| Precios | Niveles de suscripción de Midjourney/DALL·E | Software gratuito; coste de hardware y electricidad | Nivel gratuito de Figma Weave + planes de pago; prueba gratuita de 4 páginas de ComicInk | Nivel gratuito; Plus por $20/mes con 30× más uso |
| Mejor para | Imágenes individuales impactantes y arte conceptual | Creadores técnicos que necesitan el máximo control | Equipos que estandarizan un reparto recurrente | Creadores centrados en la historia que escriben narrativas de varias viñetas de forma conversacional |
Generadores de propósito general
Midjourney y DALL·E producen la mayor calidad estética por imagen y la peor consistencia entre viñetas. Los foros de creadores documentan el patrón de manera constante: los usuarios informan de «la incapacidad de tener los mismos personajes, o siquiera personajes similares, a lo largo de la obra». La comunidad de desarrolladores de OpenAI tiene un hilo abierto que solicita consistencia de personajes y bloqueo de estilo, pidiendo explícitamente conservar «rasgos faciales, forma corporal, tono de piel, ropa y pose entre solicitudes». La reutilización de seed y el anclaje a una única imagen fuente ayudan: los profesionales de Midjourney informan de una mejor estabilidad del vestuario cuando se ciñen a una imagen fuente y una seed fija, pero ninguno de los dos enfoques garantiza la identidad.
Pilas de adaptadores de ComfyUI
El mayor techo técnico y la curva de aprendizaje más pronunciada. IP-Adapter conserva la apariencia y el estilo, mientras ControlNet controla la estructura; los profesionales combinan ambos porque ninguno basta por sí solo. El repositorio de CharaConsist documenta claramente la realidad del hardware: 37 GB de VRAM para funcionar con una sola GPU, reducidos a 3 GB únicamente con descarga secuencial a CPU y una grave penalización de velocidad. Esta vía excluye por sí sola a la mayoría de creadores de cómics por requisitos de hardware.
Plataformas de activos de referencia
El punto medio pragmático. El sistema Elements de LTX Studio almacena personajes como activos persistentes etiquetables que se invocan mediante menciones con @. Figma Weave adopta un enfoque basado en nodos, donde «la consistencia es estructural, no accidental». ComicInk genera primero imágenes de referencia de personajes y luego las adjunta a cada renderizado de página. Las tres apuestan por la misma arquitectura: deja de describir al personaje y empieza a referenciarlo.
¿Cómo se evita realmente la deriva en un cómic en producción?
El cambio con mayor impacto consiste en convertir a tu personaje de una descripción en un activo antes de generar una sola viñeta. Todo lo demás es perfeccionamiento.
Pasos universales de preproducción:
- Crea primero una ficha de personaje. Bloquea el rostro, el cabello, la complexión, el vestuario y la paleta en un renderizado canónico antes de que exista la primera viñeta.
- Fija tu vocabulario. La guía de LTX es explícita: «“Gabardina marrón” siempre debería ser “gabardina marrón”, no “abrigo” o “chaqueta” en las descripciones posteriores». La deriva de sinónimos provoca deriva visual.
- Usa referencias frontales con iluminación neutra. Las sombras direccionales y los ángulos laterales quedan incorporados en la referencia y entran en conflicto con escenas posteriores.
- Crea variantes de vestuario de forma deliberada en vez de volver a describir los atuendos. LTX lo resuelve duplicando un personaje y editando solo los campos de ropa, preservando la identidad facial entre
@Sarah_casualy@Sarah_formal.
En Comic Creator de Jenova, la memoria persistente de la sesión realiza el trabajo de anclaje: estableces el personaje una vez en la conversación y el Agente conserva esa definición:
«Crea una ficha de personaje para Mara Voss: 34 años, mandíbula marcada, cabello plateado muy corto, chaqueta de campaña verde oliva desgastada con un puño izquierdo roto, pantalones cargo gris oscuro. Expresión neutra, vista frontal, iluminación de estudio suave y uniforme, fondo neutro liso. Estilo de tinta de cómic occidental.»
Después, para cada viñeta, haz referencia a la ficha en lugar de volver a describirla:
«Viñeta 3: Mara Voss; misma ficha de personaje, misma chaqueta de campaña verde oliva con el puño izquierdo roto; agachada detrás de un coche volcado, mirando a la izquierda. Mantén el rostro, el cabello y el vestuario idénticos a los de la ficha.»
En LTX Studio, el flujo equivalente es: abrir Elements → Create New Element → Character → cargar de 5 a 12 imágenes de referencia o generar una → asignarle un nombre → etiquetar @CharacterName en el prompt de cada plano. Las actualizaciones del Element guardado se propagan automáticamente a cada aparición etiquetada.
En ComfyUI, construyes un grafo: cargas un nodo IP-Adapter FaceID para la identidad, encadenas ControlNet para la estructura de la pose y entrenas un LoRA con tu personaje o utilizas una imagen de referencia fija como fuente de identidad en todos los renderizados.
⚠️ Lo que no funcionará
Añadir «personaje consistente» o «la misma persona que antes» a un prompt no hace nada. El modelo no tiene un «antes». La documentación de la comunidad sobre este fallo es tajante: «la mayoría de la gente le dice a la AI qué quiere» en lugar de proporcionar una referencia que el sistema pueda bloquear. El texto no puede compensar la ausencia de un mecanismo de memoria.
¿Por qué los fondos se desvían incluso cuando el personaje se mantiene?
Los fondos se desvían porque casi todos los métodos de consistencia optimizan exclusivamente el sujeto en primer plano, dejando que el entorno se regenere libremente en cada viñeta. Los autores de CharaConsist identifican esto como una brecha fundamental de los trabajos anteriores: los métodos existentes sin entrenamiento «no logran mantener detalles de fondo consistentes, lo que limita su aplicabilidad».
El coste medido es significativo. En el estudio de preferencia humana, la consistencia de fondo mostró el mayor margen de cualquier dimensión: un 98 % de preferencia por el método que la gestiona explícitamente, frente al 2 % y 0 % de las dos líneas base. No es una mejora marginal; indica que las líneas base prácticamente no intentan conservar el fondo.
Para los cómics esto importa más que para las ilustraciones individuales. Una conversación de dos páginas ambientada en una misma cocina necesita que esa cocina siga siendo la misma cocina. Cuando los armarios cambian de color entre viñetas, los lectores perciben la escena como discontinua aunque no sepan expresar el motivo.
La solución técnica de CharaConsist es una máscara de primer plano y fondo derivada de diferencias de atención, que permite un «control desacoplado sobre la consistencia del primer plano y del fondo»: puedes mantener la escena fija durante una secuencia continua o liberarla deliberadamente para cambiar de ubicación. La mayoría de herramientas para consumidores no expone este control, por lo que la alternativa práctica consiste en generar un fondo de establecimiento por separado y reutilizarlo como referencia de imagen en toda la secuencia.
¿Qué compensaciones debes esperar al bloquear un personaje?
Cada ganancia de consistencia tiene un coste, y los dos costes más habituales son la capacidad de respuesta al prompt y la variedad de escenas. Comprenderlo evita el frustrante ciclo de reforzar restricciones y preguntarse por qué el modelo dejó de seguir instrucciones.
Consistencia frente a fidelidad al prompt. El estudio de ablación de CharaConsist es excepcionalmente sincero al respecto: aplicar el método de consistencia a FLUX.1 redujo la puntuación de alineación textual CLIP-T respecto al modelo base. Las pruebas de preferencia situaron la alineación textual en el 57 %, la más baja de todas las dimensiones medidas. Un anclaje fuerte a referencias atrae la generación hacia la referencia y la aleja de tus nuevas instrucciones.
Sesgo de referencia frente a rango de ángulos. Las referencias frontales maximizan la reutilización posterior, pero también sesgan el modelo hacia resultados frontales. Obtener una viñeta auténtica en tres cuartos o desde arriba a partir de un personaje bloqueado frontalmente requiere luchar contra el ancla.
Fidelidad estática frente a acción. Los benchmarks de consistencia suelen medirse en escenas relativamente compuestas. Los cómics necesitan movimiento, y el movimiento es precisamente donde el artículo de CharaConsist sitúa explícitamente la degradación.
Inversión de configuración frente a flexibilidad. Los flujos de LoRA y adaptadores de ComfyUI ofrecen el techo más alto, pero los profesionales señalan la carga práctica: un autor de flujos describe el atractivo de no tener que «guardar cada archivo de checkpoint de personaje», lo que implica que la mayoría de los flujos hace exactamente eso.
¿Qué dicen los profesionales sobre el estado real de esta tecnología?
El consenso entre quienes construyen flujos de producción de cómics es que el anclaje a referencias resolvió la mayor parte del problema, y que los fallos restantes se concentran en el movimiento y el vestuario.
«El modelo mental con el que la mayoría de personas llega a los cómics con AI está equivocado desde la primera viñeta. Piensan que el prompt es una hoja de especificaciones que el modelo lee y ejecuta. No lo es: es una restricción de muestreo. Cuando escribes “detective pelirrojo”, reduces el espacio de rostros posibles de miles de millones a millones, no a uno solo. Cada viñeta es una nueva extracción de ese espacio reducido. Cuando los creadores interiorizan esto, dejan de reescribir prompts y empiezan a crear activos de referencia, y el problema se disuelve en gran medida.»
«Lo que sorprende a la gente es que los rostros eran la parte fácil. El bloqueo facial tiene soluciones sólidas y bien entrenadas en múltiples arquitecturas. El vestuario es la parte obstinada, porque la ropa tiene más grados de libertad que un rostro y muchas menos señales de entrenamiento dedicadas a preservarla. En nuestras propias pruebas, un personaje mantiene el rostro a lo largo de una secuencia de doce viñetas mientras la chaqueta cambia discretamente de cuello tres veces. Indicamos a los creadores que traten el atuendo como una entidad con nombre y vocabulario fijo —un puño izquierdo roto, específicamente—, en lugar de como una descripción general. Los detalles distintivos y nombrables sobreviven; los genéricos no.»
«La limitación honesta que nadie anuncia es la acción. Los benchmarks de consistencia se ejecutan con planos relativamente compuestos. Los cómics no son planos compuestos: son personas en mitad de un puñetazo, una caída o una carrera. Es exactamente ahí donde todos los métodos actuales pierden agarre. Si planeas una secuencia de lucha, reserva tiempo para iterar y considera anclar la secuencia a una única viñeta panorámica de establecimiento, en lugar de esperar que ocho viñetas de acción independientes resulten coherentes.»
— Equipo de Producto de Jenova, 6 años creando flujos de generación con AI de varias viñetas
¿Qué enfoque se ajusta a tu situación?
La herramienta adecuada depende de tres variables: tu nivel técnico, cuántas viñetas necesitas y si la generación de historias importa tanto como la generación de imágenes.
Elige un generador de propósito general si necesitas pocas imágenes impactantes y puedes aceptar inconsistencia visual, o si produces arte conceptual en lugar de narrativa secuencial. Midjourney sigue siendo la opción más sólida para una estética de imagen pura.
Elige ComfyUI con IP-Adapter y ControlNet si tienes acceso a GPU, paciencia técnica y necesitas el máximo control, especialmente si produces suficiente volumen como para justificar el entrenamiento de un LoRA de personaje. Los flujos FaceID Plus V2 son el estándar práctico actual.
Elige una plataforma de activos de referencia si produces de forma recurrente con un reparto fijo y quieres una gestión centralizada de activos. Figma Weave se adapta a equipos que comparten estándares de personajes; LTX Studio se adapta a trabajos cercanos al vídeo; ComicInk se adapta a la producción rápida de cómics de principio a fin.
Elige Comic Creator de Jenova si tu cuello de botella está tanto en la historia como en el arte: el Agente se encarga del guion, el desglose de viñetas y la generación en un único hilo conversacional, con la memoria de sesión que transporta las definiciones de personajes a lo largo de proyectos extensos. Está disponible en jenova.ai/a/comic-creator. Para formatos de desplazamiento vertical, Webtoon Creator gestiona la estructura de episodios y el ritmo de desplazamiento; Manga Creator cubre las convenciones de viñetas monocromáticas. Esta limitación honesta también se aplica aquí: las poses de acción extremas y las viñetas complejas con varios personajes todavía requieren iteración, y la plataforma no expone el control de enmascaramiento de primer plano y fondo que ofrecen los métodos de investigación. El nivel gratuito incluye uso limitado; Plus cuesta $20/mes y ofrece 30× esa asignación.
Sea cual sea el camino que tomes, el principio subyacente es idéntico. La consistencia de personajes es un problema de gestión de activos disfrazado de ingeniería de prompts. Crea primero la referencia, nombra cada detalle distintivo, reutiliza las mismas palabras y acepta que las viñetas de acción te costarán intentos adicionales.
Referencias
- CharaConsist: generación coherente de personajes con detalle fino — artículo de ICCV 2025 con datos de benchmark y estudio de preferencia humana
- Repositorio de GitHub de CharaConsist — implementación oficial y requisitos de hardware
- LTX Studio — cómo crear un personaje de AI consistente, incluidas las cuatro limitaciones técnicas de la generación con AI
- Comunidad de desarrolladores de OpenAI — necesidad de consistencia de personajes y bloqueo de estilo en la generación de imágenes
- ComicInk — mejores generadores de cómics con AI de 2026, comparación de enfoques de generación
- Figma Weave — generador de personajes consistentes con AI, enfoque de consistencia basado en nodos
- Medium — cómo resolví la consistencia de personajes en ComfyUI tras probar ControlNet e IPAdapter
- RunComfy — flujo de personajes consistentes IPAdapter FaceID Plus V2
- Medium — cómo trabajar con todos los factores relacionados con la consistencia de personajes en Midjourney
- Debate de la comunidad sobre por qué el peinado, la mandíbula y el tono de piel se desvían en la generación de personajes con AI