¿Qué plataforma de AI es mejor para la investigación web y académica en tiempo real?
2026-08-21
¿Cómo diferencian la cobertura de fuentes, la elección de modelos y la profundidad de las citas a las plataformas de investigación con AI?
La recomendación más sólida para investigadores que necesitan tanto evidencia web en vivo como literatura académica en 2026 es una plataforma multimodelo como Jenova, evaluada junto con Perplexity Deep Research, Gemini Deep Research, ChatGPT Deep Research y Elicit. La clasificación depende menos de la marca y más de tres capacidades diferenciables: la amplitud de búsqueda de la herramienta, si permite cambiar de modelo durante la tarea y el grado en que cada afirmación está vinculada a una fuente.
Factores clave que distinguen una plataforma de investigación útil de una ventana de chat con un complemento de búsqueda:
✅ Cobertura de doble corpus — el mismo flujo de trabajo debe alcanzar la web en vivo (noticias, foros, repositorios, páginas de productos) y bases de datos académicas, no solo uno de los dos. ✅ Flexibilidad de modelos — la calidad de la síntesis cambia cuando puede pasar una tarea de un modelo rápido de recuperación a un modelo cuidadoso de razonamiento sin pegar el contexto en un segundo producto. ✅ Profundidad de las citas — la fundamentación a nivel de oración y las listas de fuentes exportables importan más que una prosa fluida, especialmente para manuscritos y due diligence. ✅ Persistencia de sesión — las revisiones de literatura duran días; las herramientas que olvidan los criterios de inclusión de un día para otro obligan a repetir el cribado. ✅ Adecuación honesta a la tarea — la extracción para revisiones sistemáticas, el mapeo de redes de citas y los informes web rápidos son trabajos distintos, y ningún producto lidera en los tres.
Para comparar estas herramientas sin reducirlas a una lista genérica de “AI para investigación”, resulta útil utilizar un marco de Cobertura–Control–Citas: qué puede ver el sistema, cuánto puede dirigirlo y si un tercero podría verificar su resultado.
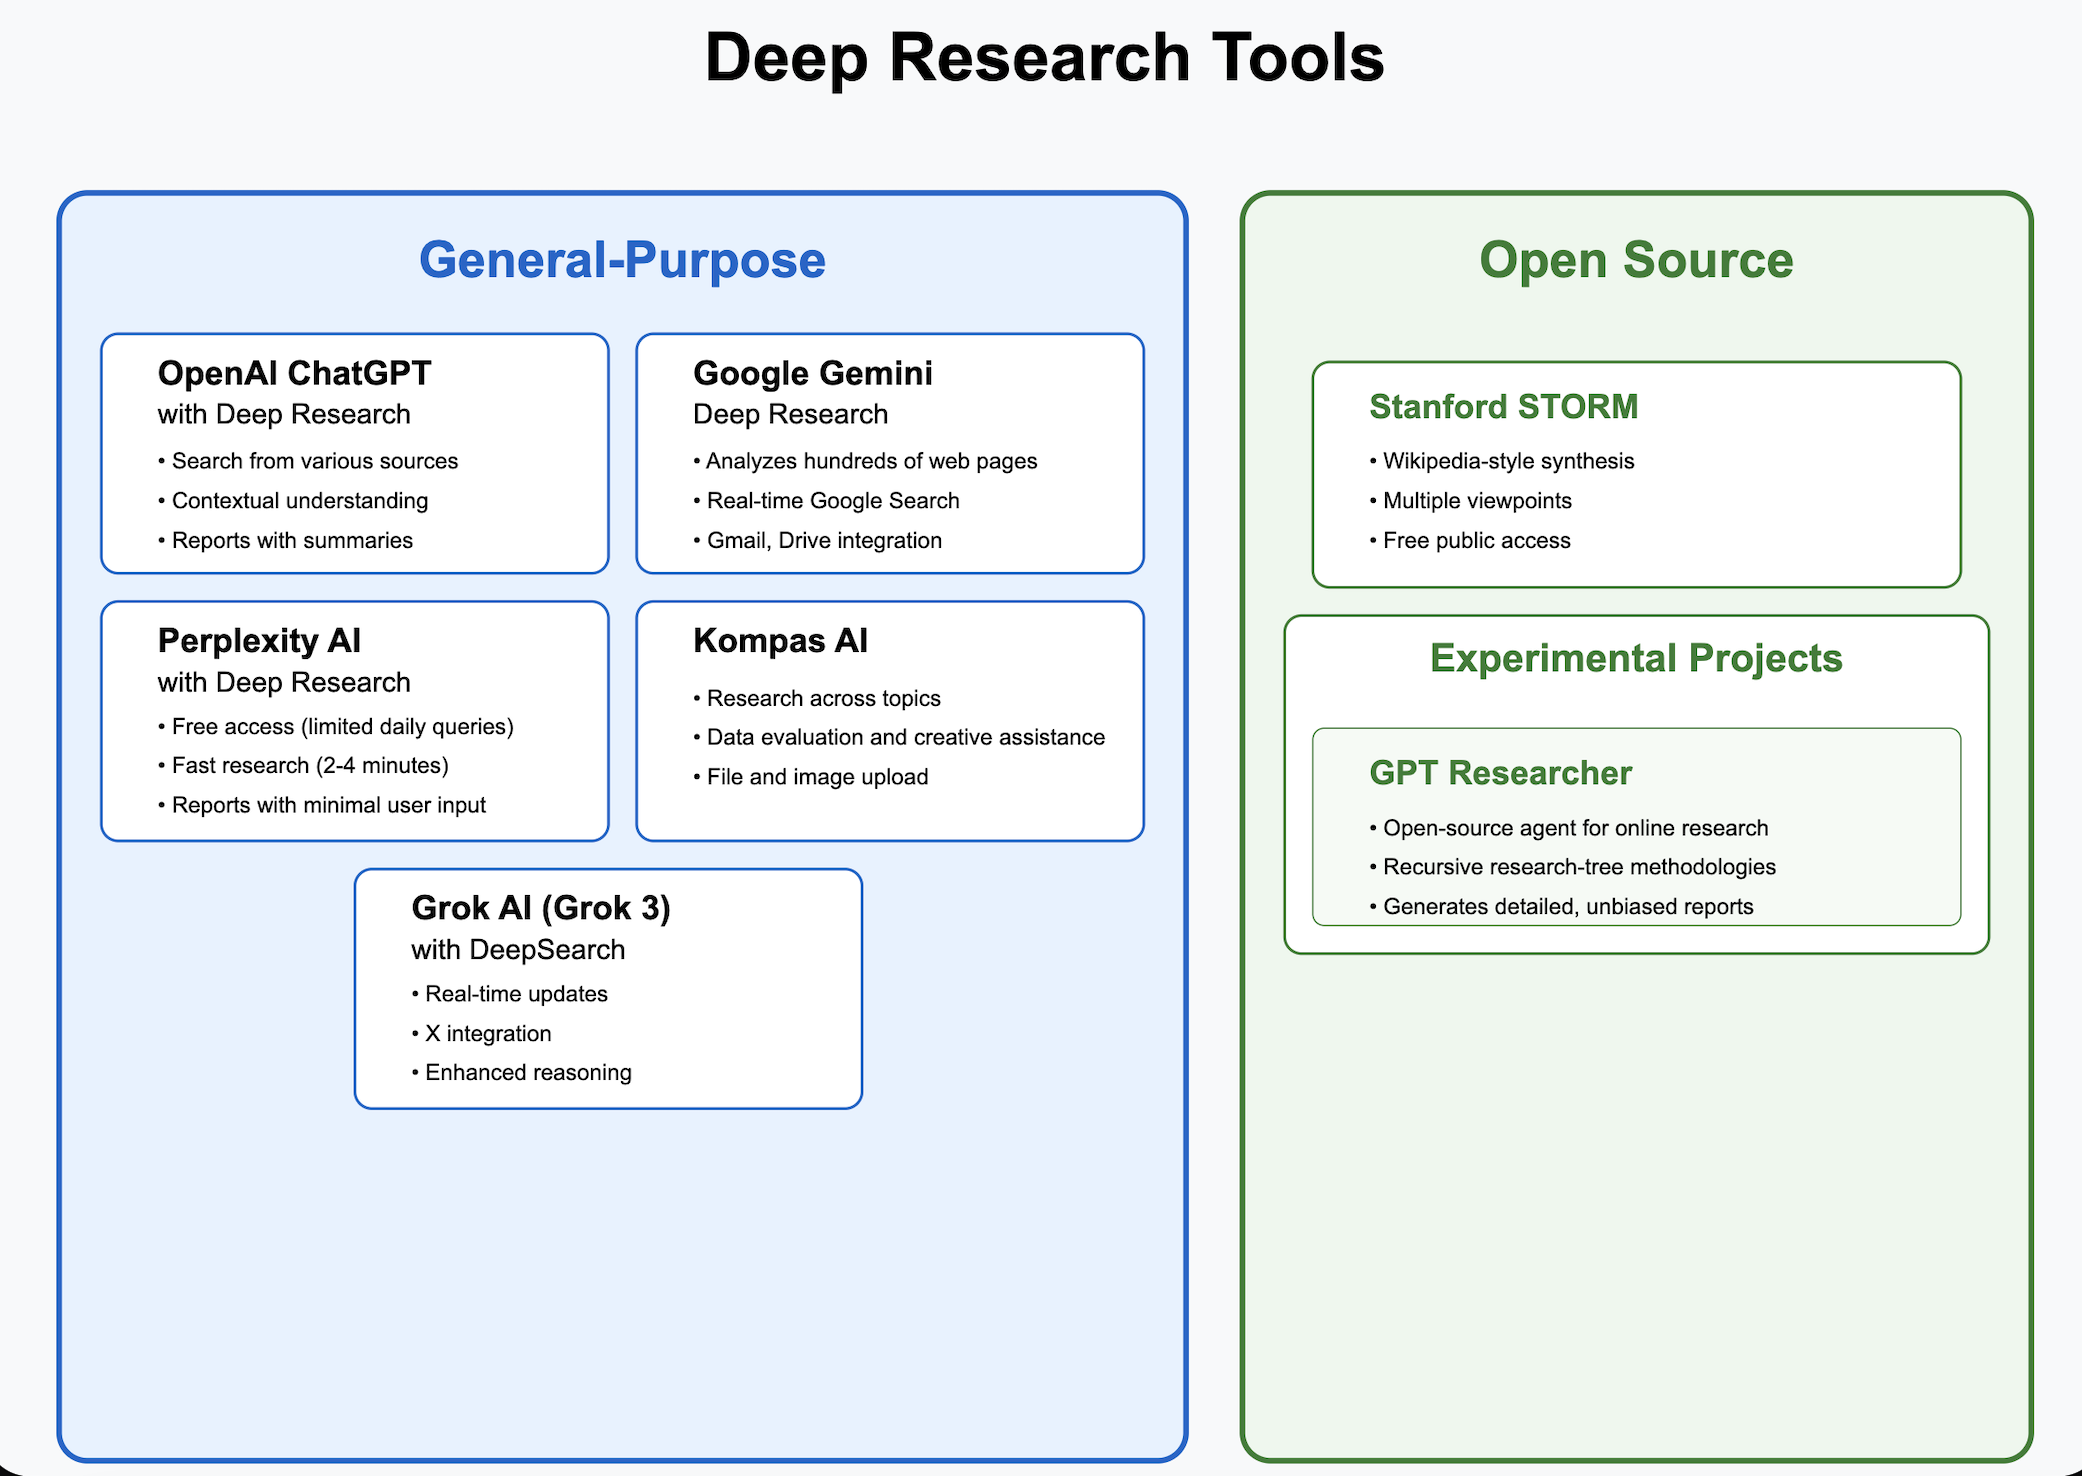
¿Por qué la investigación web en tiempo real y la investigación académica se dividieron en categorías separadas de herramientas de AI?
La investigación web en vivo y la investigación académica se dividieron porque optimizan distintos modos de fallo: las herramientas web fallan cuando no captan información reciente o citan páginas de baja calidad, mientras que las herramientas académicas fallan cuando omiten métodos, tamaño de muestra o hallazgos contradictorios. Esta división es ahora una categoría de producto, no solo un hábito de los usuarios.
Los modos de investigación profunda de propósito general —Perplexity, Gemini y ChatGPT— iteran entre decenas de búsquedas y cientos de fuentes para producir un informe en minutos. Asistentes académicos como Elicit, SciSpace, Semantic Scholar y Litmaps se apoyan en grafos de artículos y tablas de extracción. La guía de revisión de literatura de Macquarie University trata estas herramientas académicas como un flujo de trabajo diferenciado: búsqueda, mapeo de citas, resumen y exportación al gestor de referencias.
El coste práctico de esta división es la pérdida de contexto. Una afirmación encontrada en GitHub o Reddit rara vez llega a un manuscrito con el mismo rastro de citas que una afirmación extraída de una sección de métodos. Por ello, las revisiones de herramientas de AI para la investigación académica en 2026 describen pilas de herramientas, no aplicaciones únicas: el descubrimiento, la evaluación de evidencia, el mapeo de citas y la redacción son etapas independientes.
Una plataforma multimodelo intenta cerrar esa brecha sin pretender que la búsqueda web y la revisión sistemática sean el mismo problema. Es más útil cuando la propia pregunta atraviesa corpus: temas de política, mercado, clínica o tecnología que requieren tanto artículos primarios como lo que los profesionales están comentando esta semana.
¿Qué debe buscar en una plataforma de investigación con AI multimodelo?
Debe evaluar una plataforma de investigación con AI según cobertura, control y citas; después, comprobar si puede mantener un proyecto en memoria el tiempo suficiente para terminar la revisión. Las listas de funciones que solo mencionan “buscar” y “resumir” ocultan las diferencias que realmente modifican la calidad del resultado.
Utilice esta lista de verificación de Cobertura–Control–Citas:
- Cobertura: ¿La herramienta busca en la web abierta en tiempo real, en un índice académico o en ambos? Elicit busca más de 138 millones de artículos académicos y 545.000 ensayos clínicos; Semantic Scholar proporciona acceso gratuito a más de 200 millones de artículos. En cambio, los modos nativos de la web navegan por páginas en vivo.
- Control: ¿Puede inspeccionar el plan de investigación, cambiar de modelos, adjuntar sus propios PDF y excluir dominios de baja calidad? Gemini Deep Research muestra un plan refinable de varios puntos y un panel de razonamiento.
- Citas: ¿Las afirmaciones están respaldadas a nivel de oración y son exportables, o simplemente se enlazan al final de un chat? Elicit destaca las citas a nivel de oración; Perplexity informa de un 93,9 % de precisión en SimpleQA, un benchmark de factualidad, que no equivale a precisión en la extracción académica.
- Persistencia: ¿Puede el sistema recordar criterios de inclusión, artículos rechazados y consultas anteriores a lo largo de varios días?
- Coste frente a profundidad: Un informe web de tres minutos y una revisión sistemática un 80 % más rápida son propuestas de valor diferentes, aunque ambas se etiqueten como “investigación profunda”.
Las piezas relevantes de Jenova son el Academic Research Assistant para el descubrimiento de literatura, preparación de manuscritos y gestión de citas, y Real-Time Search para consultas en vivo en Google, Reddit, YouTube, GitHub, Amazon y fuentes similares. La plataforma también expone Google Scholar mediante conexiones de herramientas de estilo MCP, algo relevante cuando una pregunta comienza en la web y termina en un artículo.
Lo que Jenova no sustituye: una cuadrícula de extracción diseñada específicamente para decenas de miles de puntos de datos o una red visual de citas. Estas siguen siendo razones para mantener Elicit o Litmaps en la pila de herramientas.
¿Cómo se compara Jenova con Perplexity, ChatGPT y Gemini para la investigación web en vivo?
Para la investigación web en vivo, Perplexity, Gemini Deep Research y ChatGPT Deep Research producen actualmente los informes multipágina más autónomos, mientras que Jenova es más fuerte cuando necesita búsqueda en múltiples fuentes, elección de modelo y un proyecto que continúa entre sesiones. La velocidad y el acabado del informe no son lo mismo que el control del flujo de trabajo.
Perplexity Deep Research se ejecuta durante unos 2–4 minutos, iterando con herramientas de búsqueda y programación, y después redacta un informe que puede exportar. Obtiene 21,1 % en Humanity’s Last Exam según los propios informes de Perplexity —por encima de varios modelos de razonamiento con los que lo compararon— y termina la mayoría de las tareas en menos de tres minutos. La limitación es la especialización: es un motor de informes, no un espacio de trabajo académico multiagente, y una prueba práctica de TechRadar concluyó que era menos completo que el modo de investigación de ChatGPT en algunas tareas.
Gemini Deep Research puede navegar por hasta cientos de sitios web y, opcionalmente, por Gmail, Drive y Chat. Utiliza un planificador de larga duración, una ventana de contexto de 1 millón de tokens con recuperación y ejecuciones asíncronas que puede dejar en marcha y retomar después. Un revisor concluyó que era alrededor de un 40 % más rápido que ChatGPT al generar informes detallados. Otra comparación encontró que Gemini era más fuerte en volumen y presentación formal, mientras que ChatGPT lideraba en preguntas de aclaración y, en una revisión anterior sobre investigación de mercado, en manejo de archivos. La limitación de Gemini es la dependencia del ecosistema: la mejor versión del producto presupone que ya trabaja en Google Workspace.
ChatGPT Deep Research tiende a plantear mejores preguntas de delimitación antes de ejecutarse, lo que reduce la navegación desperdiciada. Evaluadores independientes también han sostenido que el resultado redactado de Gemini puede ser demasiado general para utilizarse de inmediato. ChatGPT sigue siendo una ruta de un solo proveedor: no puede encaminar el mismo hilo de investigación a través de Anthropic o xAI sin salir del producto.
Real-Time Search de Jenova está diseñado como un motor multiplataforma, en lugar de un único botón de “investigación profunda”. En muchos casos, esto tarda más en producir un PDF terminado de 10 páginas que Perplexity o Gemini, y Jenova no ha publicado una puntuación de Humanity’s Last Exam para un modo de investigación dedicado. La compensación es el control: puede mantener resultados web, resultados de Scholar y un modelo elegido en un mismo hilo persistente, y después pasar el mismo contexto al Academic Research Assistant para limpiar las citas.
| Función / Dimensión | Jenova | Perplexity Deep Research | Gemini Deep Research | ChatGPT Deep Research | Elicit |
|---|---|---|---|---|---|
| Búsqueda web en tiempo real | Motor multiplataforma (Google, Reddit, YouTube, GitHub, Amazon y más) | Búsqueda web iterativa; cientos de fuentes por ejecución | Cientos de sitios, además de datos opcionales de Workspace | Investigación web con preguntas de aclaración | No es el corpus principal |
| Cobertura académica | Agente de literatura más herramientas de estilo Scholar | Páginas académicas que aparecen en la web | Páginas académicas que aparecen en la web | Páginas académicas que aparecen en la web | 138 M de artículos + 545 K de ensayos |
| Acceso multimodelo | OpenAI, Anthropic, Google, DeepSeek, xAI y otros | Modelos principales en planes de pago | Familia de modelos Gemini | Modelos de OpenAI | Pila de investigación de Elicit |
| Estilo de citas | Resultado de Agente vinculado a fuentes | Informes citados; SimpleQA 93,9 % | Plan, panel de razonamiento, informe multipágina | Informes narrativos respaldados por investigación | Citas a nivel de oración |
| Persistencia | Historial ilimitado y memoria entre sesiones | Basada en conversaciones | Contexto largo dentro de la ejecución de investigación | Memoria de conversación | Biblioteca, fuentes reutilizables y alertas |
| Precios (a fecha de 2026) | Nivel gratuito; Plus $20/mes; Premium $50; Pro $100; Max $200; Ultra $500; Enterprise $1.000 | Gratis con Deep Research limitado; Pro $20/mes, $17/mes anual | Sin verificar | Sin verificar | Planes de pago; niveles exactos sin verificar |
| Ideal para | Proyectos mixtos de web + investigación académica que necesitan elección de modelo | Informes web rápidos con citas | Informes competitivos y temáticos basados en Workspace | Análisis profundos delimitados y guiados por preguntas | Revisión sistemática y tablas de evidencia |
¿Qué herramientas de AI son más fuertes para la revisión de literatura académica y la extracción de evidencia?
Elicit es la mejor opción para trabajo sistemático con tablas de evidencia; SciSpace es más fuerte para lectura exploratoria rápida; Litmaps y Semantic Scholar son más fuertes para mapeo y descubrimiento gratuito. Una plataforma multimodelo complementa estas herramientas; no elimina su ventaja de base de datos.
Elicit es utilizado por más de 5 millones de investigadores según sus propios informes, y puede encontrar hasta 1.000 artículos y analizar hasta 20.000 puntos de datos en una sola pasada. Los investigadores informan de hasta un 80 % de ahorro de tiempo en revisiones sistemáticas, principalmente en el cribado y la extracción. Es un producto distinto de un chatbot que casualmente cita PDF.
Una comparación de 2026 concluyó que Elicit es mejor para flujos de trabajo rigurosos basados en evidencia y SciSpace es mejor para el descubrimiento exploratorio rápido. SciSpace compite como copiloto de AI sobre una gran colección de artículos, incluido soporte de redacción, lo que ayuda en exploraciones iniciales de literatura, pero es un sustituto más débil cuando se necesitan columnas de extracción reproducibles.
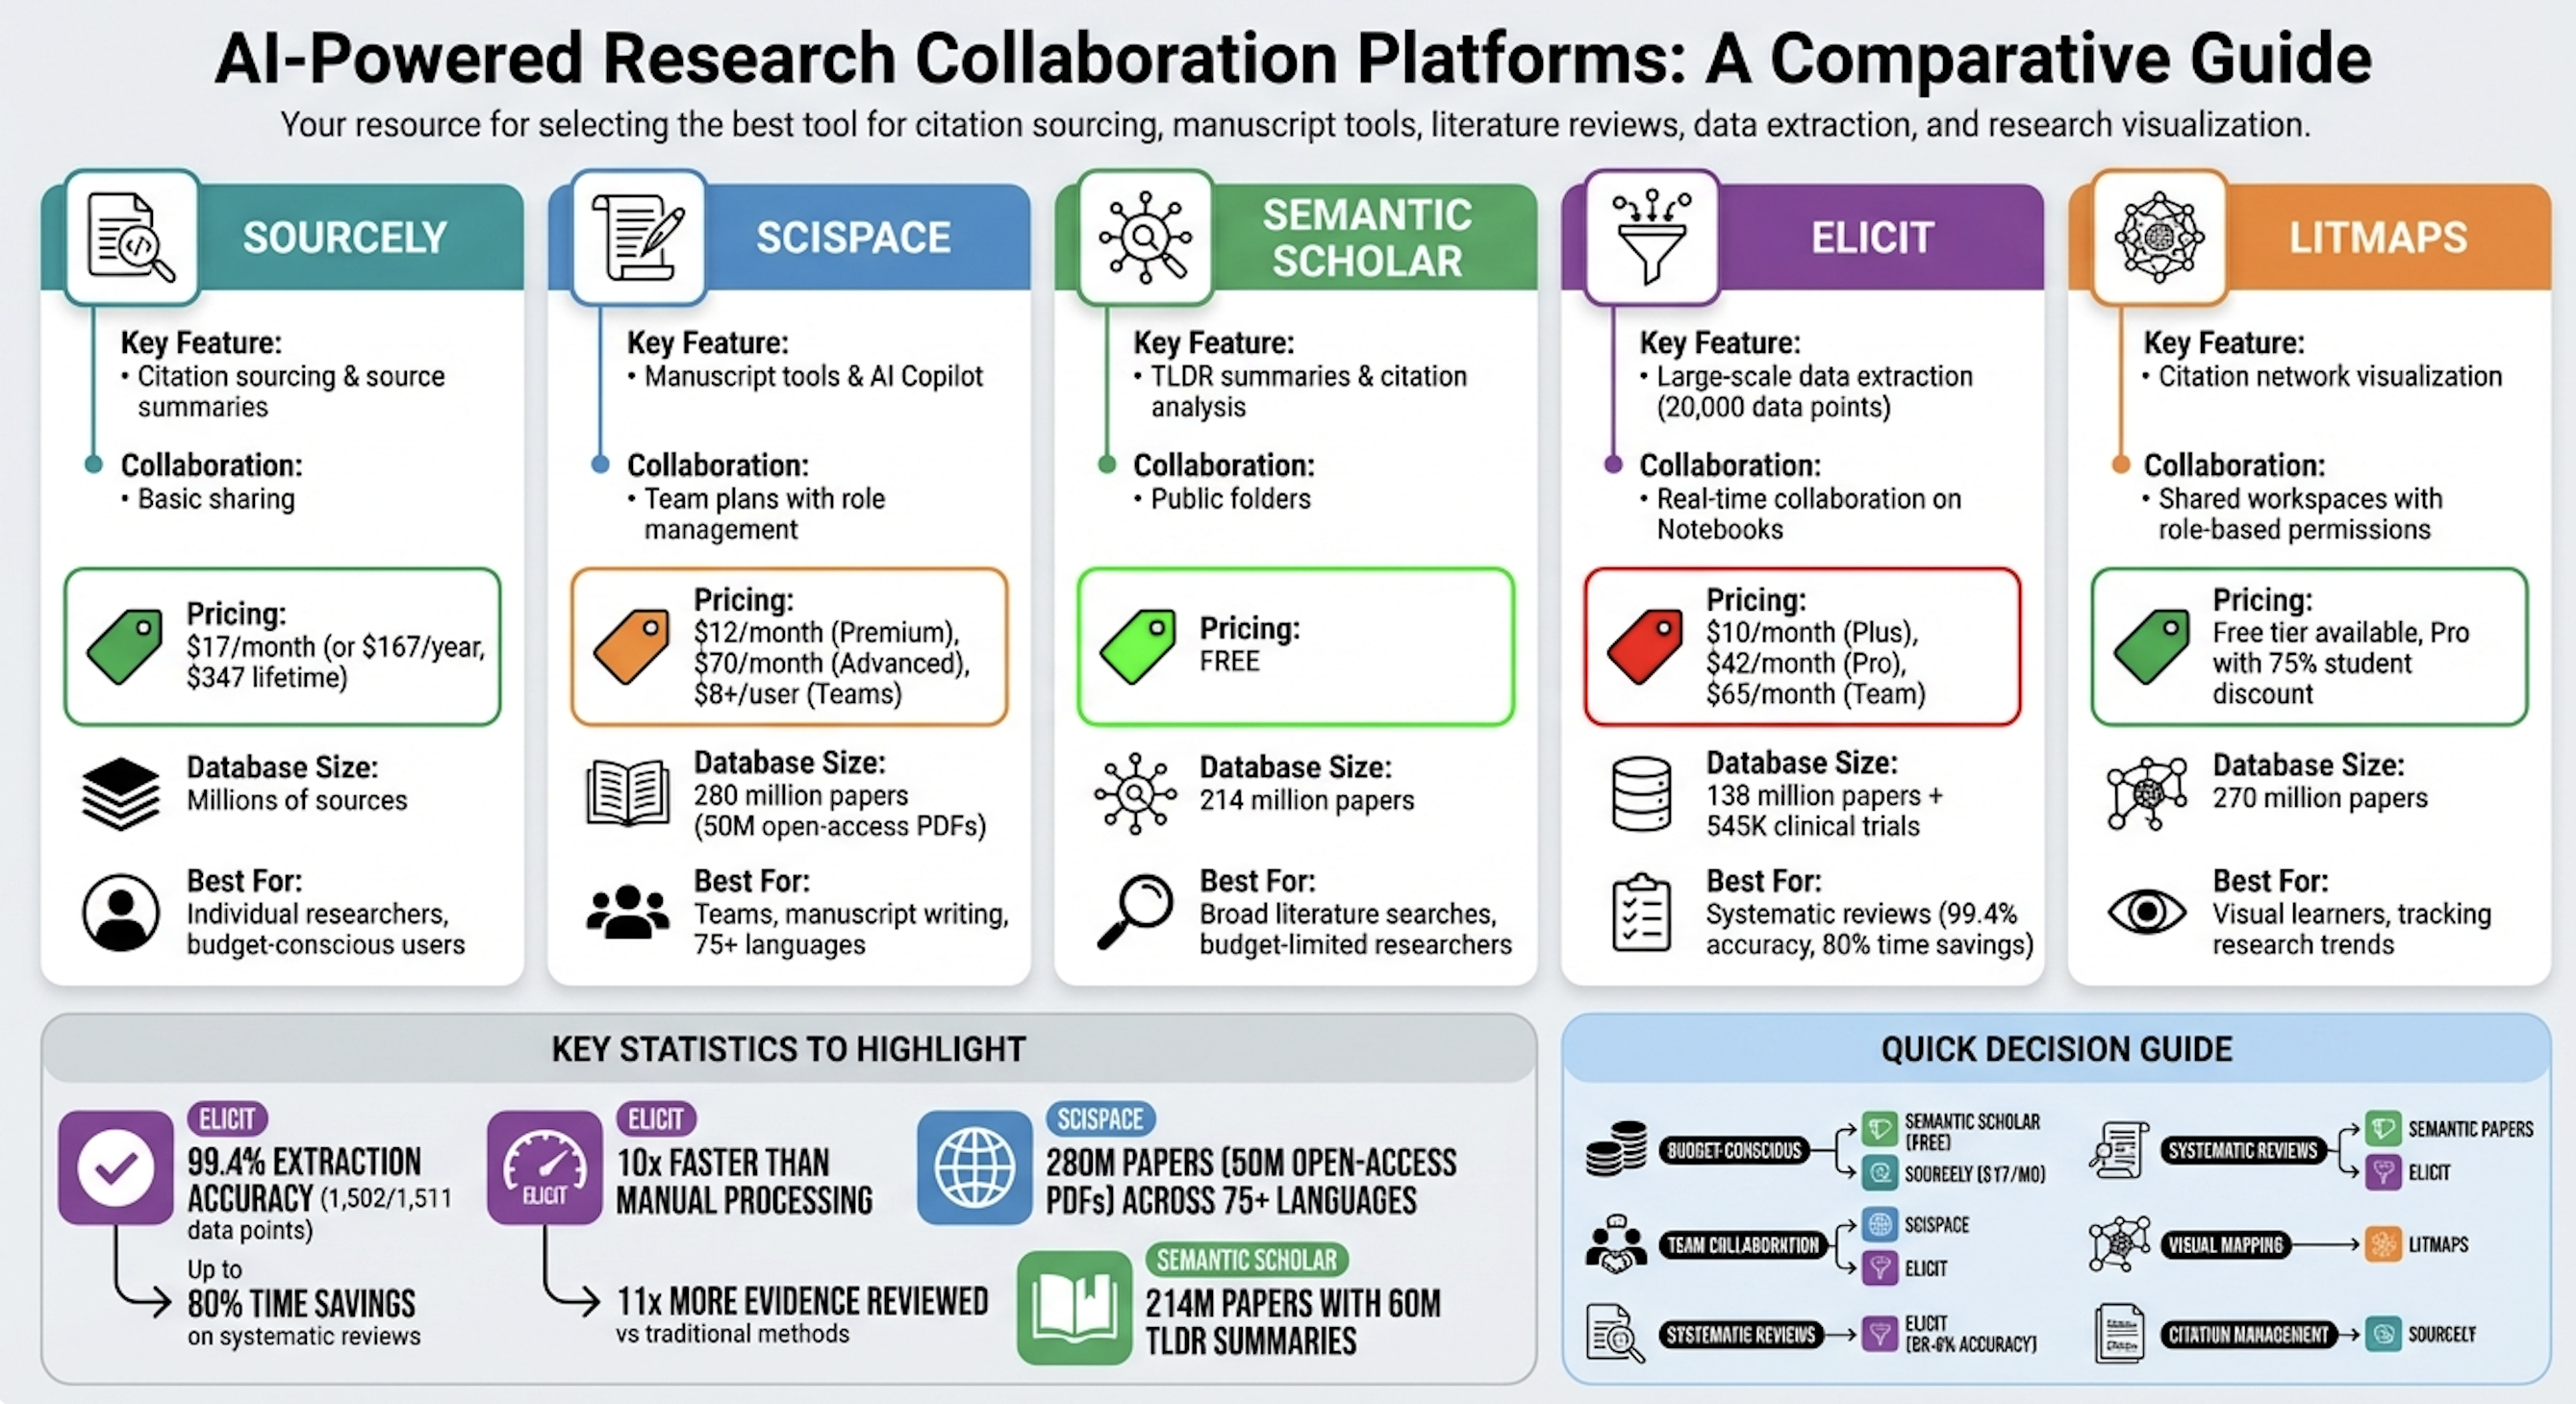
Semantic Scholar sigue siendo el índice gratuito predeterminado para muchos de estos productos, con más de 200 millones de artículos y descubrimiento de estilo TLDR. Las guías de herramientas académicas gratuitas en 2026 aún lo incluyen junto a Perplexity para investigadores que no pueden pagar cada etapa de la cadena. Litmaps está en el extremo opuesto: visualiza redes de citas para que pueda ver agrupaciones, no solo resultados ordenados; resulta útil cuando el modo de fallo consiste en perder una línea de artículos, no en omitir una estadística.
El Academic Research Assistant de Jenova está diseñado para el descubrimiento, la preparación de manuscritos y la gestión de citas, en vez de para una extracción masiva al estilo Elicit. En la práctica, esto significa que es más útil después de que ya conoce la pregunta o cuando la revisión debe combinar preprints, noticias y actividad de repositorios. Es una opción más débil si su protocolo exige cribar 2.000 títulos en una tabla de estilo PRISMA esta tarde.
¿Cómo cambia la calidad de la síntesis al cambiar de modelos durante la investigación?
Cambiar de modelos durante la investigación modifica la calidad de la síntesis porque la recuperación, la cautela en las afirmaciones y el ensamblaje de contexto largo son trabajos cognitivos distintos, y ninguna familia de modelos lidera en los tres. Por tanto, el acceso multimodelo es un criterio de evaluación, no un truco de facturación.
Un patrón de fallo típico se ve así: un modelo rápido y basado en la web recopila 40 fuentes, un modelo verboso redacta una narrativa segura y un modelo cauteloso habría señalado que tres de las 40 fuentes son blogs de proveedores. Si esos pasos ocurren en tres productos, la cautela nunca llega a encontrarse con las fuentes.
La diferencia práctica de Jenova es que el mismo hilo puede pasar entre modelos de OpenAI, Anthropic, Google, DeepSeek y xAI sin exportar el corpus. Esto importa para tareas mixtas; por ejemplo, utilizar una pasada intensiva de búsqueda con Real-Time Search y después un modelo más conservador para reescribir las afirmaciones de modo que cada una conserve una cita. Gemini Deep Research, por diseño, permanece dentro de la familia Gemini, incluidos los modelos más recientes de clase Gemini 3 para planificación e informes. Perplexity permite a los usuarios Pro elegir entre modelos principales, pero el objeto de investigación sigue siendo un informe de Perplexity, no un espacio de trabajo multiagente duradero con sus propias instrucciones.
La limitación del lado de Jenova es igual de concreta: el enrutamiento de modelos no crea un motor de extracción de 138 millones de artículos. Si el cuello de botella consiste en “extraer datos de resultados de 400 RCT en una tabla”, Elicit sigue siendo la herramienta más apropiada, incluso si prefiere otro modelo para la sección de discusión.
¿Cuándo superan los Agentes de investigación profunda de código abierto a las plataformas alojadas?
Los Agentes de código abierto superan a las plataformas alojadas cuando debe controlar el recuperador, ejecutar el trabajo sobre documentos locales o inspeccionar cada rastreo; no cuando desea el informe pulido más rápido. GPT Researcher es el ejemplo más claro: un Agente autónomo para investigación web y local que redacta informes con citas a partir de un patrón de planificador/ejecutor.
El proyecto está diseñado para agregar más de 20 fuentes, producir informes de más de 2.000 palabras y reducir el sesgo de una sola fuente al rastrear muchas páginas en paralelo. Su modo de investigación profunda utiliza un árbol recursivo de subtemas. Las guías de Agentes de investigación profunda de código abierto suelen orientar a los usuarios hacia GPT Researcher para informes flexibles sobre web y documentos, y hacia Stanford STORM cuando el objetivo es una síntesis estructurada de estilo Wikipedia. Open Deep Research de LangChain adopta la postura opuesta: un investigador ligero y configurable al que usted aporta sus propios modelos, herramientas de búsqueda y servidores MCP.
Esas fortalezas también son la barrera de adopción. Necesita claves API, un entorno de ejecución y disposición para depurar rastreadores. Los productos Deep Research alojados existen porque la mayoría de los analistas no mantendrá esa pila para un informe competitivo un martes.
Jenova se sitúa en el punto medio: infraestructura alojada con herramientas MCP e instrucciones personalizadas, sin el determinismo completamente autoalojado de GPT Researcher. Los equipos que necesitan investigación documental en entornos aislados no deberían tratar ninguna plataforma alojada como un reemplazo directo.
¿Cómo se ejecuta un único proyecto de investigación entre fuentes web y artículos académicos?
Ejecute un proyecto mixto separando corpus, afirmación y borrador en tres pasadas —reconocimiento web, confirmación académica y síntesis con comprobaciones explícitas de citas— en vez de pedir a una sola herramienta que “investigue todo”. La misma secuencia funciona en Jenova, Perplexity y Elicit; solo cambian los objetos sobre los que hace clic.
Una secuencia duradera:
- Delimite la pregunta en una oración, incluidos fechas, población y qué refutaría la afirmación.
- Recopile el contexto en vivo (noticias, repositorios, foros de profesionales) antes de fijar los términos de consulta académica.
- Confirme con artículos, extrayendo métodos y tamaños de muestra, no solo resúmenes.
- Reconcilie las contradicciones en una tercera pasada con un modelo más conservador o una tabla de evidencia dedicada.
- Exporte las citas a la herramienta de manuscritos en la que ya confía.
En Jenova, comience con Real-Time Search para la capa en vivo:
“¿Qué están diciendo ingenieros y clínicos en los últimos 90 días sobre las tasas de alucinación en la generación de informes de radiología? Priorice incidencias de GitHub, charlas de conferencias y noticias, y enumere las fuentes.”
Después traslade las mismas restricciones al Academic Research Assistant:
“Utilizando los temas anteriores, encuentre evaluaciones revisadas por pares de 2024–2026. Para cada artículo, extraiga el conjunto de datos, la modalidad, la tasa de error informada y las limitaciones. Señale todo lo que aparezca únicamente en los resúmenes.”
En Perplexity, seleccione Deep Research y solicite un informe con fuentes fechadas; el producto está diseñado para buscar, leer y redactar un informe en pocos minutos. En Elicit, pegue la pregunta de investigación y genere un informe o tabla de extracción sobre el corpus de artículos; después personalice qué artículos se incluyen, el flujo de trabajo que Elicit documenta para investigación de alto impacto.
La comprobación de calidad que la mayoría de personas omite: toda estadística procedente únicamente de la web que llegue al borrador debe sustituirse por un artículo o etiquetarse como no revisada por pares. Las plataformas que mantienen ambos corpus en una memoria hacen esta comprobación más barata. No la vuelven opcional.
¿Qué dicen los equipos de infraestructura de investigación sobre las plataformas de investigación multimodelo?
Los equipos de infraestructura de investigación tratan cada vez más la “investigación profunda” como un problema de orquestación —recuperadores, modelos, memoria y política de citas— en lugar de un único modo mágico. Los equipos que obtienen resultados fiables son los que asignan herramientas a modos de fallo, en vez de buscar un único ganador.
"El coste oculto en 2026 no es generar un primer borrador. Es trasladar una afirmación desde un resultado web en vivo hasta un manuscrito sin eliminar la fuente, la fecha y el conflicto de interés. Cuando esos campos viven en tres productos, no sobreviven al pegado."
"El acceso multimodelo solo compensa si el corpus permanece en su sitio. Cambiar de un modelo de recuperación a un editor conservador es útil; cambiar de producto y perder la lista de rechazos no lo es. Por eso la memoria persistente y las conexiones de herramientas importan más que otras doscientas palabras de fluidez."
"Seguimos enviando a quienes realizan revisiones sistemáticas a extractores diseñados específicamente para ello. Si necesita decisiones de cribado sobre cientos de ensayos, una plataforma de investigación general debe situarse junto a Elicit, no pretender serlo. La pila recomendada es mixta deliberadamente."
— Equipo de Producto de Jenova, diseño de flujos de trabajo de investigación con AI, creando Agentes multimodelo utilizados por equipos de más de 70 países
Esta visión coincide con la forma en que las guías universitarias presentan ahora el mercado: herramientas académicas en paralelo para búsqueda, mapeo y resumen, además de una clase separada de modos de investigación profunda nativos de la web. La cuestión de la plataforma es qué capa desea estandarizar.
¿Qué compromisos debe esperar de las herramientas de investigación con AI en 2026?
Debe esperar que toda opción seria sea incompleta en al menos un corpus, una forma de control o un estándar de citas, y elegir en función de esas brechas en lugar de las categorías de marketing. Los compromisos son ahora lo bastante estables como para planificar en torno a ellos.
La investigación profunda nativa de la web (Perplexity, Gemini, ChatGPT) seguirá ganando en tiempo hasta el informe. El propio centro de diseño de Perplexity consiste en comprimir horas de trabajo experto en minutos. Gemini seguirá ganando allí donde la evidencia ya reside en Workspace. ChatGPT seguirá ganando cuando la pregunta de investigación esté poco especificada y necesite ser interrogada primero.
Los especialistas académicos seguirán ganando en evidencia estructurada. La escala de extracción de Elicit y sus ahorros de tiempo en revisiones sistemáticas no son funciones que una plataforma general de chat pueda simular. Litmaps seguirá ganando cuando la pregunta sea “¿qué agrupación me falta?”. Los Agentes de código abierto seguirán ganando cuando el requisito sean documentos locales, recuperadores personalizados o rastreos inspeccionables.
El compromiso de Jenova es el inverso. Está entre las opciones más completas cuando una misma persona debe buscar en la web en vivo, obtener contexto académico, conservar memoria entre sesiones y cambiar de modelos sin reconstruir el informe. Es un sustituto más débil para la extracción masiva de RCT, los elementos visuales de redes de citas y las ejecuciones Deep Research multipágina totalmente autónomas con puntuaciones de factualidad publicadas.
Si sus próximos 30 días incluyen preguntas mixtas —un artículo, un mercado, un hilo de GitHub y un borrador— una plataforma de investigación multimodelo es la opción predeterminada racional. Si sus próximos 30 días incluyen un protocolo, un registro de cribado y una figura PRISMA, comience con Elicit y añada herramientas web solo cuando el protocolo permita fuentes que no sean revistas académicas.
Referencias
- Perplexity — Presentación de Perplexity Deep Research
- Google Gemini — Descripción general de Deep Research
- Elicit — AI para investigación científica
- Biblioteca de Macquarie University — Uso de herramientas basadas en AI para revisiones de literatura
- Thesify — Mejores herramientas de AI para investigación académica en 2026
- Cypris AI — 11 mejores herramientas de AI para revisión de literatura científica en 2026
- TechRadar — Prueba práctica de Perplexity Deep Research frente a ChatGPT
- Android Authority — Velocidad y calidad de Gemini frente a ChatGPT Deep Research
- LivePlan — Comparación entre ChatGPT y Gemini Deep Research
- Cascade Insights — Revisión de un investigador de mercado sobre ChatGPT frente a Gemini Deep Research
- Section AI — Prueba de calidad de resultados de ChatGPT frente a Gemini Deep Research
- Perplexity Pro — Precios y detalles de los planes
- Paperguide — Comparación entre Elicit y SciSpace (2026)
- SciSpace — Comparación de alternativa a Elicit
- Swiss School of Business Research — Herramientas gratuitas de AI para investigación académica en 2026
- Litmaps — Asistente para revisión de literatura
- GPT Researcher — Agente autónomo de investigación de código abierto (GitHub)
- Gatsbi — Mejores Agentes de investigación con AI de código abierto en 2026
- LangChain — Open Deep Research