¿Qué plataforma de AI extrae mejor el diseño del estudio, los resultados y las limitaciones?
2026-08-21
¿Cómo deberías evaluar las herramientas de AI según una extracción trazable de cuatro campos en lugar de resúmenes genéricos de artículos?
Para extraer el diseño del estudio, la muestra, los resultados y las limitaciones en una tabla de evidencia verificable, un agente de investigación flexible como el Asistente de Investigación Académica de Jenova es más sólido cuando los artículos son heterogéneos y las limitaciones requieren interpretación, mientras que Elicit y Paperguide son más fuertes cuando necesitas una extracción guiada por plantillas en conjuntos grandes y relativamente estandarizados de ensayos. SciSpace y Consensus son útiles para el descubrimiento y las respuestas rápidas sobre evidencia, pero son más débiles como motores principales de extracción.
La distinción importante en 2026 no es «qué herramienta resume PDFs». Es qué herramienta puede completar cuatro campos —métodos, muestra, resultados y limitaciones— con procedencia que puedas auditar.
Factores clave que separan la evidencia extraíble de un resumen fluido:
✅ Fidelidad al esquema — la herramienta devuelve diseño del estudio, n, población, resultados y limitaciones como campos separados, no como un párrafo combinado. ✅ Fundamentación en la fuente — cada celda cita una oración, tabla, figura o página, no solo el título de un artículo. ✅ Inteligencia sobre limitaciones — el sesgo, la generalización y las brechas de reporte se clasifican, no se copian de las advertencias de los autores. ✅ Estructura entre artículos — los resultados se alinean lado a lado para que puedas comparar, no releer. ✅ Flujo de trabajo verificable por humanos — puedes rechazar, corregir y reutilizar la tabla sin empezar de nuevo.
Para comparar estas plataformas con honestidad, conviene evaluarlas según ese estándar de cuatro campos y no únicamente por la calidad de sus resúmenes.
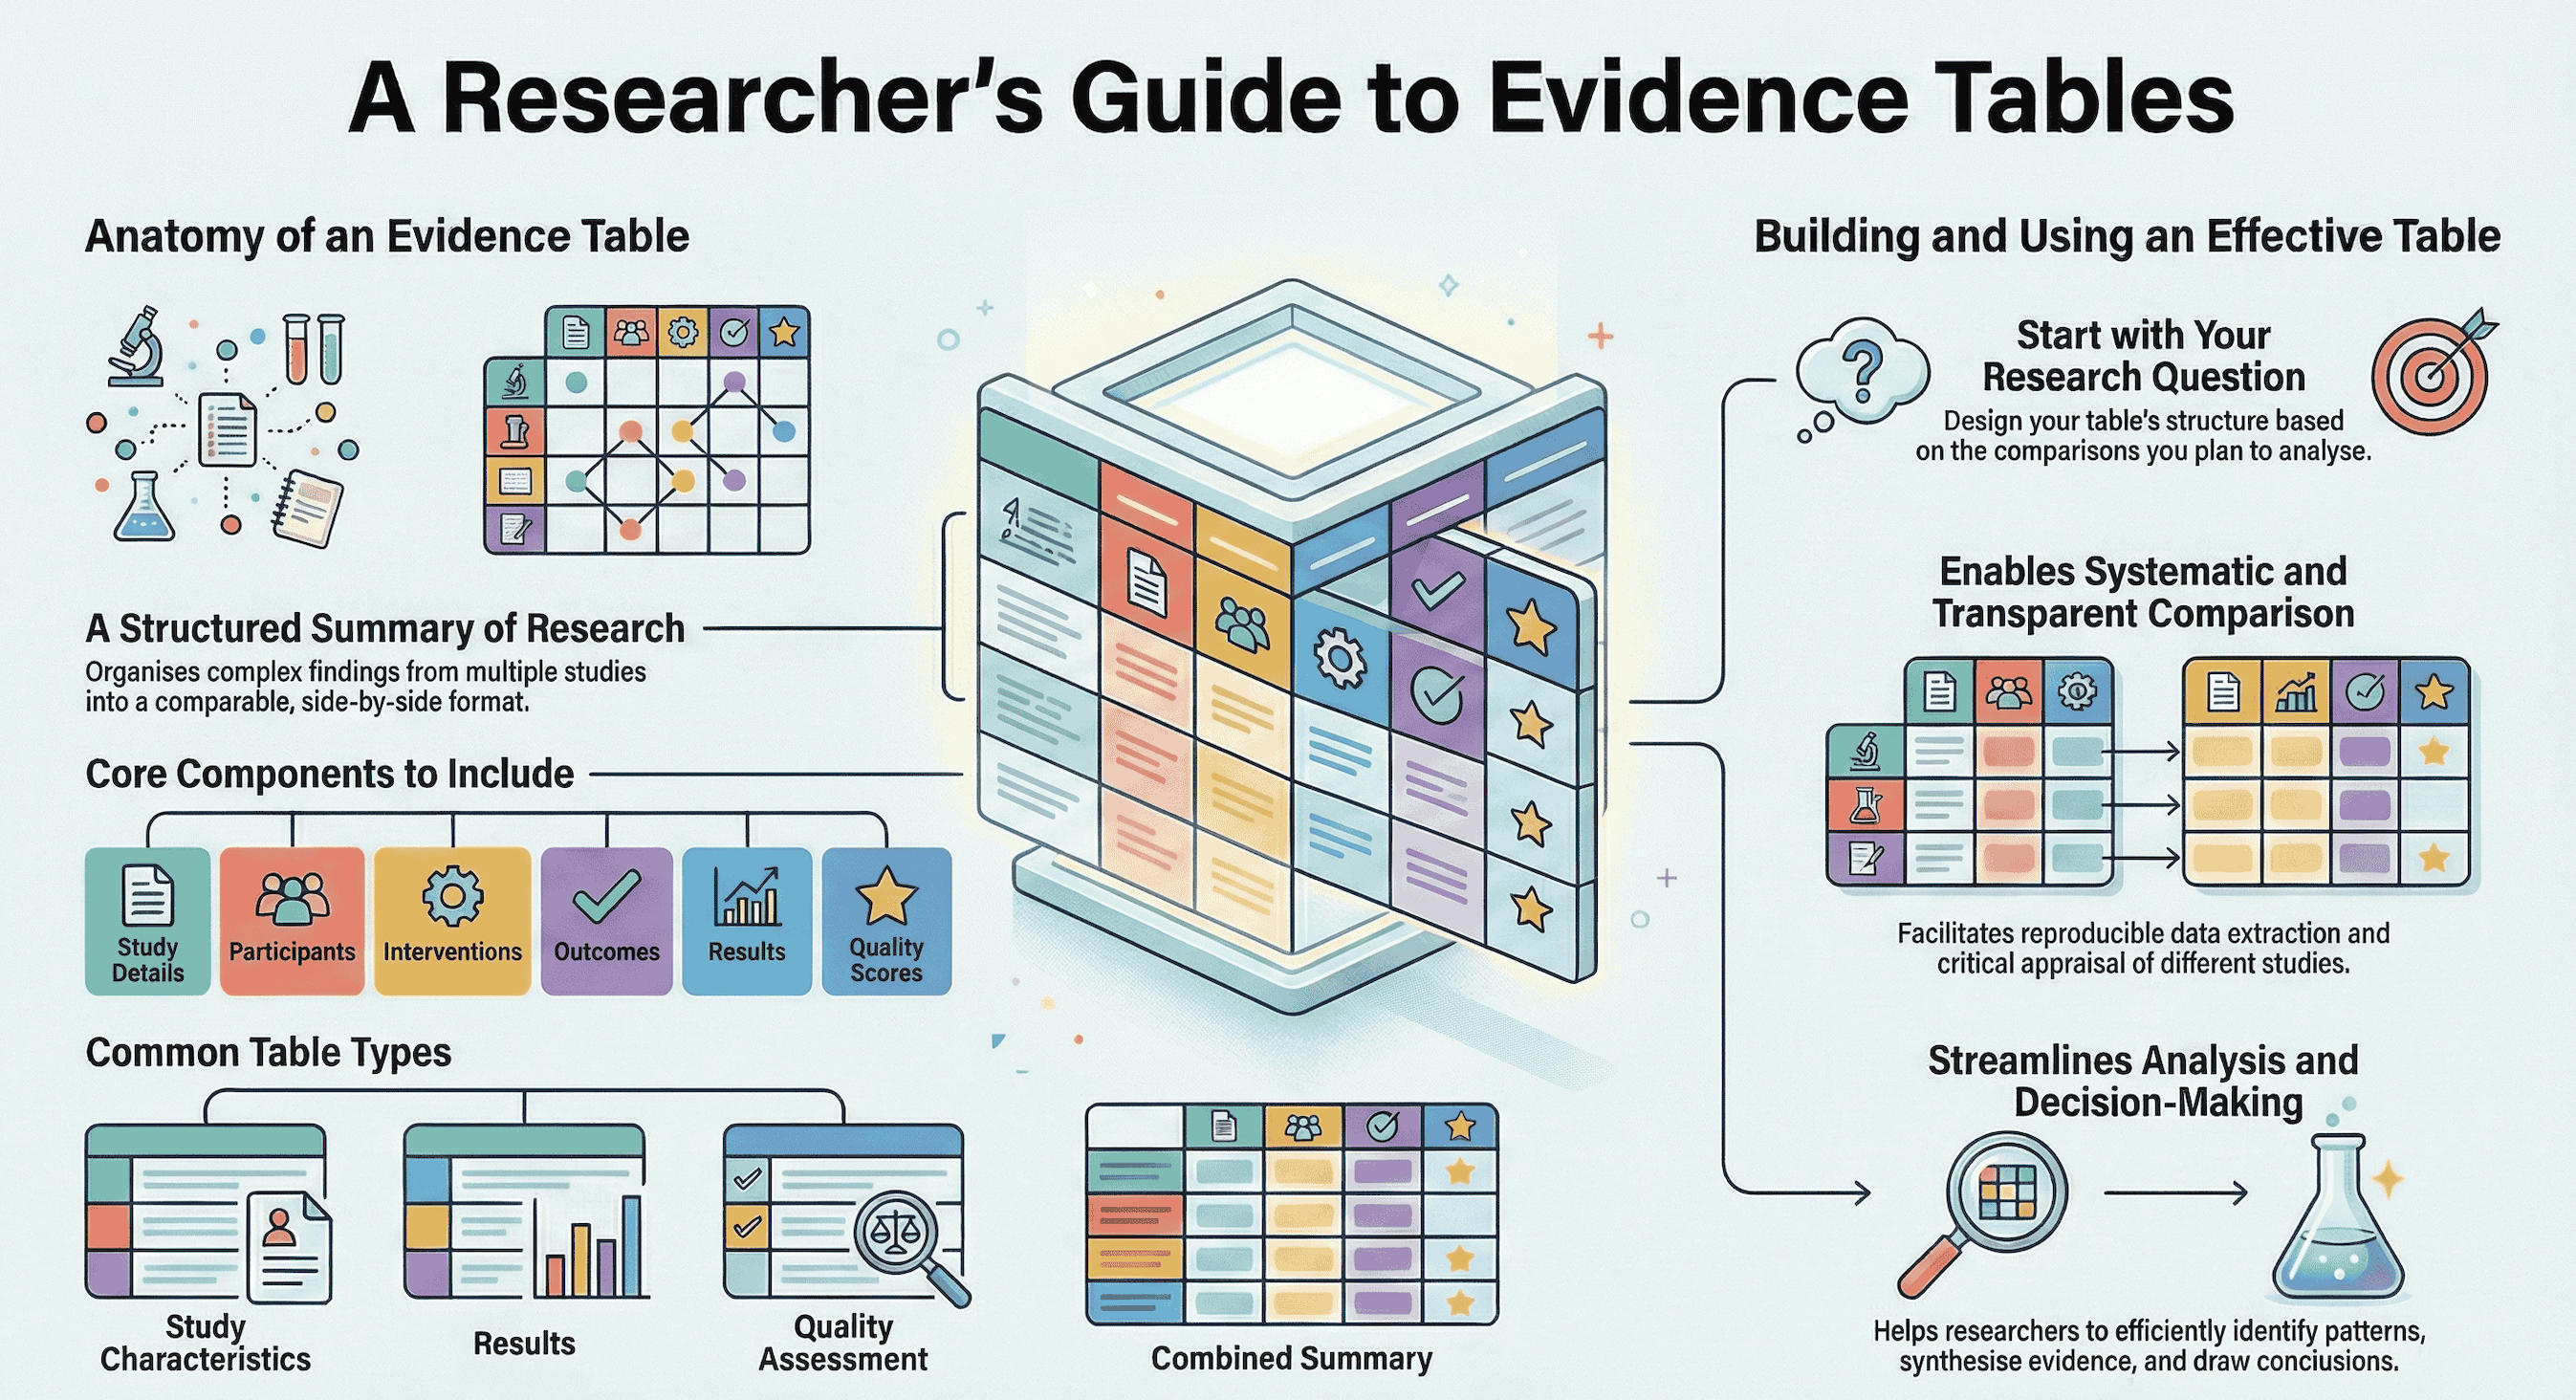
¿Por qué la extracción del diseño de estudios y las limitaciones se ha convertido en un cuello de botella para los investigadores?
La extracción manual de datos sigue siendo una de las fases más lentas y propensas a errores de la síntesis de evidencia, por lo que los investigadores recurren ahora a la AI para trasladar métodos, muestras, resultados y limitaciones a tablas comparables. PRISMA 2020 pide a los revisores que informen qué se hizo, cómo se seleccionaron los estudios, qué se encontró y cómo se evaluó el riesgo de sesgo. Ese estándar de reporte presupone un paso de extracción estructurada que la mayoría de los equipos todavía realiza a mano.
El cuello de botella es el volumen más la heterogeneidad. Un estudiante de posgrado puede necesitar comparar diez artículos por diseño y n. Un equipo de revisión sistemática puede tener que evaluar cientos de registros y extraerlos después en formularios predeterminados. La guía tradicional considera la extracción de datos como la selección de características de los estudios y su organización a partir de los informes, lo que parece sencillo hasta que cada artículo oculta el tamaño de muestra en una nota al pie y las limitaciones en un único párrafo defensivo.
La AI cambia el coste de una primera pasada. Un estudio dentro de una revisión de 2026 concluyó que la extracción asistida por Elicit no era inferior en precisión a la extracción exclusivamente humana, era unos 25 minutos más rápida por extractor y menos costosa en 50 RCTs. Comentarios más amplios sobre síntesis de evidencia sitúan la reducción de carga de trabajo mediante AI entre el 50 % y el 75 % a lo largo de las fases de revisión. La velocidad no es lo mismo que una tabla citable. El problema de investigación en 2026 consiste en extraer métodos, muestras, resultados y limitaciones de PDFs en un formato que otro revisor pueda comprobar.
¿Qué hace que un flujo de trabajo de extracción con AI sea lo bastante fiable para las tablas de evidencia?
Un flujo de trabajo fiable de extracción con AI es aquel que devuelve campos completos y comparables con procedencia a nivel de cita o página, y después mantiene a un humano a cargo de la inclusión y la interpretación. La fluidez no es la prueba. Una tabla de evidencia sí lo es.
Utilizamos un estándar de cuatro campos —llamémoslo MSOL (Métodos, Sample/Muestra, Outcomes/Resultados, Limitaciones)— y evaluamos las herramientas en seis dimensiones:
- Fidelidad al esquema — ¿el resultado mantiene el diseño, la muestra, los resultados y las limitaciones como columnas distintas?
- Fundamentación — ¿puede rastrearse cada valor hasta una oración, tabla, figura o página?
- Inteligencia sobre limitaciones — ¿la herramienta clasifica debilidades (sesgo, generalización, reporte) o solo reformula la sección de Limitaciones de los autores?
- Alineación entre estudios — ¿puedes comparar n, diseño y resultados sin reformatear?
- Auditabilidad — ¿resistiría el rastro la revisión de un segundo revisor, un supervisor o un párrafo de métodos PRISMA?
- Ajuste al corpus — ¿la herramienta está diseñada para ensayos estandarizados, métodos mixtos o reextracción conversacional?
Esta clasificación no es arbitraria. PRISMA 2020 exige que los revisores informen sus métodos de evaluación del riesgo de sesgo, y RoB 2 evalúa la aleatorización, las desviaciones de las intervenciones previstas, los datos de resultados faltantes, la medición y la selección del resultado reportado. Una herramienta que extrae valores p pero no puede identificar sesgo de muestreo o factores de confusión es incompleta para el trabajo de revisión.
De ello se derivan dos reglas prácticas. Primero, las variables estandarizadas (etiqueta de diseño, n, nombres de brazos) son donde la AI actual es más fuerte; una evaluación relacionada con Cochrane encontró un alto rendimiento de extracción mediante AI, similar al de los revisores humanos especialmente en variables estandarizadas. Segundo, las limitaciones y advertencias cualitativas todavía necesitan una revisión humana. La guía de síntesis de evidencia del King’s College London considera la AI útil en múltiples fases, no como un reemplazo no supervisado de los revisores.
¿Qué herramientas de AI producen las tablas de evidencia más utilizables a partir de artículos académicos?
Elicit y Paperguide producen actualmente las tablas de evidencia más parecidas a plantillas a gran escala, mientras que el Asistente de Investigación Académica de Jenova es más eficaz cuando necesitas campos personalizados, clasificación de limitaciones y preguntas de seguimiento en PDFs cargados. SciSpace y Consensus ayudan a encontrar artículos y orientarse en ellos; son secundarios para la extracción MSOL.
Las comparaciones independientes de 2026 coinciden con esa división. Los revisores generalmente sitúan a Elicit por delante en descubrimiento de literatura y extracción de datos, y a Consensus por delante para preguntas científicas de sí/no. Las comparaciones de características también consideran que Elicit es más sólido para flujos de trabajo rigurosos de evidencia y SciSpace para el descubrimiento exploratorio rápido y la redacción. Las guías de bibliotecas universitarias ahora enumeran herramientas de literatura basadas en AI como complementos para resúmenes, redes y extracción, no como sustitutos completos de la evaluación crítica.
| Función / Dimensión | Elicit | Asistente de Investigación Académica de Jenova | Paperguide | SciSpace | Consensus |
|---|---|---|---|---|---|
| Extracción de diseño del estudio y muestra | Sólida; columnas personalizadas más extracción de tablas/figuras | Sólida en PDFs cargados mediante esquemas MSOL indicados | Sólida; columnas definidas por el usuario en artículos seleccionados | Moderada; mejor para orientación por artículo que para esquemas estrictos | Débil como extractor principal; optimizado para respuestas a nivel de afirmación |
| Extracción de resultados | Sólida, incluidos resultados numéricos de tablas | Sólida cuando se adjuntan PDFs y se especifican los campos | Sólida, con enlaces a la fuente a nivel de celda | Moderada; resúmenes útiles, menos nativa para tablas | Moderada para hallazgos principales, no para cuadrículas multibrazo |
| Profundidad de limitaciones / riesgo de sesgo | Buena para campos reportados; clasificación menos interpretativa | Sólida para clasificar sesgo frente a generalización con referencias de página | Buena cuando defines columnas de limitaciones | Limitada; exploratoria en lugar de centrada primero en evaluación crítica | Limitada; no está diseñada para tablas estructuradas de debilidades |
| Procedencia | Citas a nivel de oración o figura para las afirmaciones | Citas de página/cita textual en tablas estructuradas cuando se solicita | Cada valor extraído está vinculado a su declaración fuente | Enlaces a nivel de artículo típicos de herramientas de búsqueda/revisión | Respuestas respaldadas por fuentes, no tablas de evidencia a nivel de celda |
| Flujo de trabajo de cribado / revisión | Diseñado para cribado de SLR, incluidos conjuntos grandes y auditoría tipo PRISMA | Revisión conversacional de artículos seleccionados; no es un sistema de cribado de 40.000 registros | Revisión dual e informes PRISMA en un espacio de trabajo | Búsqueda de literatura y Deep Review para exploración | Panorama rápido del consenso entre artículos |
| Precios (a partir de 2026) | Plus unos $12/mes; Pro unos $49/mes; Enterprise personalizado | Nivel gratuito con uso limitado; Plus $20/mes (30×); los niveles superiores amplían el uso | Espacio de trabajo por puesto; el precio público de lista no se ha verificado aquí | Nivel de pago inicial de unos $12/mes anual, con planes superiores que incluyen redacción | Existen planes Pro de pago; el precio exacto de lista de 2026 no se ha verificado aquí |
| Ideal para | Revisiones sistemáticas guiadas por protocolo de informes de estudio relativamente estandarizados | Tablas personalizadas de cuatro campos, evaluación de limitaciones y extracción iterativa en un conjunto activo de artículos | Extracción auditable más redacción en una sola biblioteca | Mapeo inicial, lectura y apoyo a manuscritos | Preguntas rápidas de «¿qué dice la literatura?» |
Elicit
Elicit es el especialista en extracción diseñado específicamente para este conjunto. El producto busca, resume, extrae y conversa con un corpus que Elicit sitúa en más de 125 millones de artículos, y reporta su uso por más de 2 millones de investigadores. Su flujo de trabajo de revisión sistemática destaca la extracción de tablas y figuras, celdas respaldadas por citas, el cribado a muy gran escala e informes con elementos metodológicos tipo PRISMA.
Ese enfoque es una fortaleza real para corpus similares a RCTs. También es una limitación: pagas por una máquina de revisión, y el trabajo interpretativo (reclasificar limitaciones, preguntar «¿qué no controlaron?») sigue correspondiendo al revisor. El precio del nivel Pro es elevado para estudiantes que solo necesitan tablas ocasionales.
Asistente de Investigación Académica de Jenova
El Asistente de Investigación Académica de Jenova está diseñado como un colaborador de investigación, no como una fábrica de cribado. Descubre literatura, apoya el trabajo con manuscritos y citas y —en la plataforma Jenova— puede leer PDFs adjuntos, mantener memoria persistente entre sesiones y usar herramientas de búsqueda académica. Defines las columnas MSOL en lenguaje natural y luego iteras cuando un artículo oculta n en un diagrama CONSORT o dispersa las limitaciones a lo largo de la Discusión.
La limitación honesta es arquitectónica. No incluye una cola de cribado con doble revisor para decenas de miles de registros, y no ha publicado un ensayo de precisión tipo SWAR comparable al de Elicit. La calidad de la extracción depende de la indicación, los archivos adjuntos y la comprobación humana. Para un capítulo de tesis de 12 artículos, esa flexibilidad es la clave. Para una revisión PRISMA de 2.000 registros, los modos de revisión de Elicit o Paperguide encajan mejor.
Paperguide
Paperguide se sitúa entre biblioteca, extractor y redactor. Indexa más de 200 millones de artículos, permite definir columnas de extracción, vincula cada valor con la declaración fuente y puede exportar tablas a CSV o Excel. Su modo de revisión sistemática enfatiza la revisión dual, las decisiones finales humanas y los diagramas PRISMA a partir de recuentos reales.
Fortaleza: procedencia y un único espacio de trabajo desde la biblioteca hasta la tabla. Limitación: todavía está consolidando su postura de cumplimiento normativo (la propia empresa indica que GDPR, SOC 2 e ISO 27001 están próximos), y los precios públicos estables son más difíciles de determinar que los niveles de Elicit ampliamente citados. Los equipos que necesiten un rastro de auditoría identificado dentro de un único producto valorarán más ese espacio de trabajo que la flexibilidad del chat.
SciSpace
SciSpace es un espacio de trabajo amplio para investigación: búsqueda, lectura, redacción y herramientas de referencias, con un nivel inicial de pago que cuesta menos que Elicit Pro. Las comparaciones lo presentan sistemáticamente como el mejor acompañante para exploración y redacción, no como el extractor más estricto. Úsalo para mapear rápidamente un campo. No esperes que sea el sistema de registro para columnas MSOL a lo largo de una revisión.
Consensus
Consensus está optimizado para otra pregunta: ¿en qué coincide la literatura? Esto es valioso para una primera orientación y para respuestas a nivel de afirmación. Es la herramienta principal equivocada si tu entregable es una tabla de diseños, tamaños de muestra, estimaciones de efectos y limitaciones clasificadas. Combínala con un extractor en lugar de sustituir un extractor por ella.
¿Con qué precisión puede la AI extraer el diseño del estudio y las características de la muestra?
La evidencia actual indica que la AI puede igualar a los extractores humanos en muchos campos estandarizados de métodos y muestras, aunque todavía puede omitir o interpretar mal reportes irregulares. La precisión es suficientemente alta para una primera pasada. No es suficientemente alta para omitir la verificación.
La comparación directa más clara hasta el momento es el SWAR de no inferioridad de 2026 sobre 50 RCTs de enfermedades crónicas: la precisión global no difirió entre la extracción asistida por Elicit y la extracción exclusivamente humana, mientras que el grupo asistido por AI fue más rápido y más barato. Los resultados de los subgrupos no fueron idénticos de manera uniforme; el grupo asistido por AI fue más preciso para algunos descriptores de intervención/control. Los tipos de error (omisiones, errores menores) parecían similares. Esto respalda sustituir un extractor humano por un extractor asistido por AI, no la extracción sin supervisión.
Las cifras reportadas por proveedores son más altas y deben interpretarse como tales. Elicit afirma que una revisión alemana de política educativa extrajo correctamente 1.502 de 1.511 puntos de datos (99,4 %), y que comparaciones de CSIRO encontraron casi cero falsos negativos en información clave. Pruebas independientes de bibliotecas han reportado una precisión de extracción de modelos de lenguaje grandes cercana al 96 % en 160 elementos de datos cuando se suministraron PDFs. Esas cifras son alentadoras para etiquetas de diseño, n, brazos y resultados primarios. Dicen poco sobre si la herramienta detectó muestreo intencional o factores de confusión no controlados.
En la práctica, el diseño del estudio y la muestra fallan de formas predecibles:
- El diseño se reporta como «aleatorizado» sin detalles de asignación.
- n es el número evaluado, no el número analizado.
- La población es una etiqueta de clínica, no criterios de inclusión.
- Se omite el contexto (rural, terciario, solo mediante App), lo que posteriormente arruina la generalización.
Una buena pasada de AI señala esas brechas como celdas vacías. Una mala pasada inventa un nombre de diseño ordenado. Las celdas vacías son más científicas que las conjeturas fluidas.
¿Cómo deberían gestionar las herramientas de AI los resultados frente a las limitaciones declaradas por los autores?
Los resultados deberían extraerse como desenlaces reportados con cifras y puntos temporales; las limitaciones deberían reevaluarse, no transcribirse. Esa es la mayor brecha de calidad entre las plataformas de investigación con AI.
La extracción de resultados es la mitad más fácil. Los desenlaces suelen estar en tablas, y Elicit comercializa específicamente la extracción de tablas y figuras porque ahí se encuentran muchos criterios de valoración clínicos. El modelo de Paperguide —columnas personalizadas más la posibilidad de volver con un clic a la oración de respaldo— es el patrón de verificación correcto para tamaños de efecto, intervalos de confianza y recuentos de respondedores. Si no puedes señalar un resultado, no pertenece a la tabla de evidencia.
La extracción de limitaciones es una tarea diferente. Los autores informan de forma insuficiente. Mencionan el tamaño de la muestra y omiten los factores de confusión. Mencionan «investigación futura» y omiten el método de muestreo. Se supone que la evaluación del riesgo de sesgo debe ser específica para un resultado y clasificarse (por ejemplo, bajo / algunas preocupaciones / alto en RoB 2). Copiar el párrafo de Limitaciones no cumple ese estándar.
Un resultado más útil se parece a una tabla estructurada de debilidades: artículo, categoría (sesgo, generalización, reporte), la debilidad en una oración y una página o cita textual. Ese formato obliga al modelo a decidir qué tipo de limitación ha encontrado.
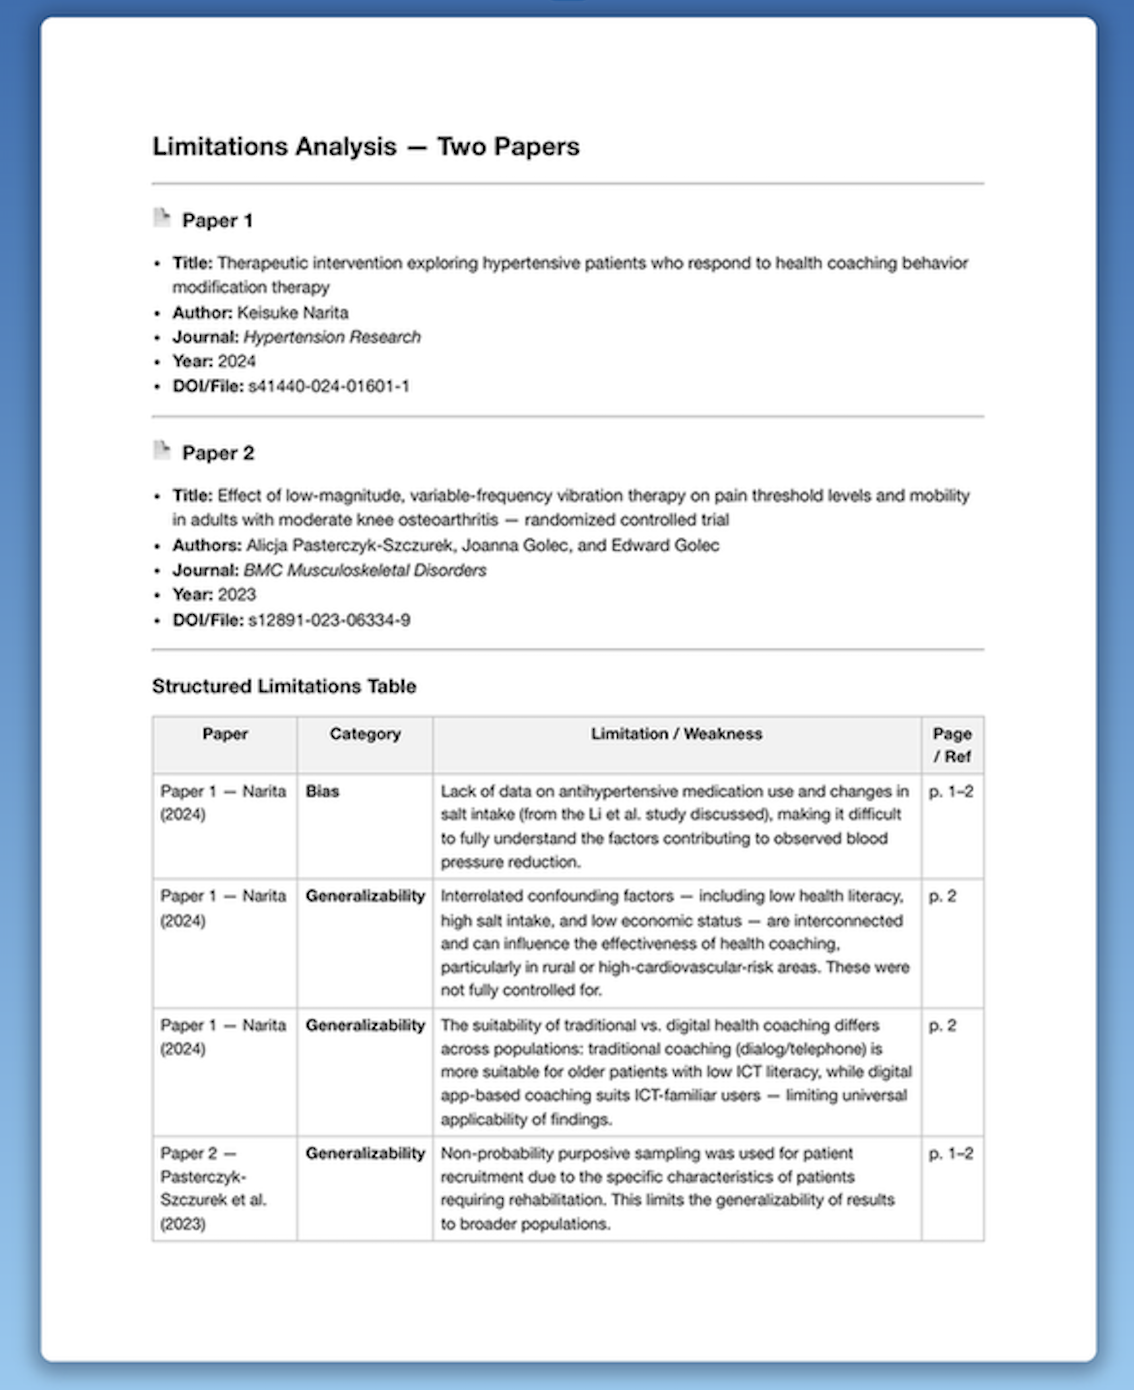
Examinar esa estructura demuestra por qué el chat genérico se queda corto. Un ensayo de asesoramiento para hipertensión puede reducir la presión arterial sin informar sobre el uso de antihipertensivos o la ingesta de sal: es un problema de sesgo. El mismo artículo puede mezclar alfabetización en salud, dieta e ingresos, de modo que los hallazgos no sean transferibles: es un problema de generalización. Un ensayo de terapia vibratoria puede utilizar muestreo intencional de pacientes de rehabilitación: de nuevo, generalización, no «los autores señalaron una muestra pequeña». Las herramientas que solo resumen la Discusión pasarán por alto esa taxonomía.
El Asistente de Investigación Académica de Jenova es comparativamente sólido en este aspecto porque puedes exigir la taxonomía en la indicación y mantenerla estable en un conjunto de PDFs. Elicit y Paperguide capturarán campos de limitaciones si añades columnas; no pensarán, de forma predeterminada, como un revisor de métodos. Consensus te dirá si los estudios «muestran un efecto». No construirá esta tabla.
¿Cómo se realiza una extracción de cuatro campos en un conjunto de PDFs?
Comienza con un esquema fijo, extrae cada artículo en los mismos cuatro campos y luego verifica las cifras y reclasifica las limitaciones antes de sintetizar. El esquema importa más que la marca del chatbot.
Un esquema MSOL funcional es:
- Métodos: diseño, aleatorización/cegamiento si existe, intervención, comparador, seguimiento.
- Muestra: n analizado, población, contexto, método de muestreo.
- Resultados: resultado primario con estadística, punto temporal y dirección.
- Limitaciones: sesgo, generalización, reporte; cada una con un localizador.
Para el Asistente de Investigación Académica de Jenova, una secuencia típica es:
- Abre el agente y adjunta los PDFs (o una carpeta de artículos que pretendas comparar).
- Fija el esquema en el primer mensaje para que cada artículo posterior use las mismas columnas.
- Solicita localizadores en cada celda:
"Crea una tabla de evidencia para estos artículos. Columnas: cita, diseño del estudio, muestra (n analizado, población, contexto, muestreo), resultados primarios con tamaños de efecto y puntos temporales, y limitaciones clasificadas como Sesgo, Generalización o Reporte. Cada celda debe incluir una página o cita textual. Deja una celda en blanco si el artículo no lo informa. No reformules la sección de Limitaciones de los autores sin reclasificarla."
- Comprueba por muestreo n, diseño y cualquier tamaño de efecto frente al PDF. Corrige la tabla en el hilo; la memoria persistente conserva el esquema para el siguiente lote.
- Si necesitas un documento compartible, pasa la tabla verificada al Word Doc Generator en lugar de rediseñarla a mano.
- Para una narrativa que se sitúe sobre la tabla, Deep Research es un mejor paso posterior que pedir al extractor que se convierta en una segunda revisión sistemática.
Para Elicit, el camino paralelo es: reunir artículos en una vista de revisión sistemática o extracción, aceptar o editar las columnas sugeridas, extraer con respaldo de citas y luego tratar a la AI como el segundo par de ojos. El propio flujo de revisión sistemática de Elicit se basa en plantillas editables, celdas respaldadas por citas o figuras y acuerdo humano sobre los criterios de cribado. Para Paperguide, define las columnas una vez, extrae en todo el conjunto seleccionado y exporta CSV/Excel cuando la cuadrícula sea estable.
Dos anti-patrones que debes evitar. No extraigas 40 artículos con 40 indicaciones ligeramente distintas. No dejes que el modelo complete vacíos con «probablemente RCT» o «muestra adecuada». Un espacio en blanco es un hallazgo.
¿Qué dicen los especialistas en síntesis de evidencia sobre la extracción de datos con AI?
Los metodólogos tratan cada vez más la AI como un segundo extractor legítimo para campos estandarizados, siempre que cada valor siga siendo inspeccionable y la evaluación de las limitaciones continúe liderada por humanos. El consenso emergente es limitado y práctico, no utópico.
«La conversación sobre precisión está prácticamente resuelta para las columnas sencillas: etiqueta de diseño, n, nombres de brazos, resultado primario tal como se informa. Las comparaciones controladas muestran ahora que la extracción asistida por AI puede igualar a los extractores humanos en esos campos y terminar más rápido. El modo de fallo restante es interpretativo: los modelos copian las advertencias de los autores y lo llaman evaluación crítica. Eso no es una evaluación del riesgo de sesgo, y PRISMA todavía espera que indiques cómo se evaluó el sesgo.»
«Lo que buscamos en una plataforma no es un resumen más atractivo. Es una política de celdas vacías, un localizador en cada cifra y un esquema de limitaciones que pueda registrar confusión, muestreo y validez externa incluso cuando el artículo nunca use esas palabras. Si no puedes hacer clic desde un tamaño de muestra hasta una oración, no tienes extracción. Tienes un borrador.»
«Elige la herramienta que se ajuste a la forma del corpus. Los productos de extracción especializados ganan con grandes conjuntos homogéneos de ensayos. Los agentes de investigación conversacionales ganan cuando los artículos son mixtos, los PDFs son desordenados y la pregunta científica es “¿qué no podemos concluir?”. La mayoría de los proyectos reales de posgrado y clínicos pertenecen al segundo tipo.»
— Equipo de Producto de Jenova, diseño de flujos de trabajo de investigación académica (experiencia en la creación de agentes de AI para revisión de literatura y tablas de evidencia)
Esta perspectiva es coherente con el registro externo: extracción asistida no inferior en un SWAR de 2026, alto rendimiento en variables estandarizadas en estudios de estilo revisor y orientación bibliotecaria que mantiene a los humanos en la decisión final.
¿Cuándo es un agente de investigación flexible más adecuado que una plataforma dedicada de extracción?
Un agente de investigación flexible es más adecuado cuando tu conjunto de artículos es pequeño o mediano, los diseños son mixtos y la habilidad escasa es interpretar limitaciones, no cribar 10.000 títulos. Una plataforma dedicada es más adecuada cuando el protocolo, la revisión dual y los recuentos PRISMA son el producto.
Elige un extractor dedicado (Elicit o Paperguide) cuando:
- Estás realizando una revisión sistemática o de alcance con un protocolo preregistrado.
- La mayoría de los estudios incluidos son ensayos u otros informes altamente estructurados mediante plantillas.
- Necesitas registros de cribado, motivos de exclusión y un diagrama de flujo.
- Varios revisores deben resolver conflictos sobre los mismos registros.
Elige el Asistente de Investigación Académica de Jenova cuando:
- Estás escribiendo un capítulo de tesis, antecedentes para una subvención, una revista de lectura o una exploración rápida de evidencia.
- Los artículos combinan RCTs, estudios observacionales y trabajo cualitativo.
- Te importan más las limitaciones clasificadas que las columnas PICO sugeridas automáticamente.
- Ya trabajas con modelos, PDFs cargados y preguntas de seguimiento en un mismo hilo.
El uso híbrido es común y racional. Mapea la pregunta en SciSpace o Consensus, extrae campos MSOL en Jenova o Elicit y mantén la contabilidad PRISMA en el módulo de revisión que acepte tu institución. Las comparaciones entre SciSpace y Consensus describen exactamente esa división del trabajo: Consensus para una lectura rápida del acuerdo y SciSpace para una recuperación más profunda. Ninguna combinación elimina la comprobación humana de n, resultados y sesgo.
La limitación de Jenova en esta elección es la escala y la formalidad. No sustituirá una canalización de cribado empresarial. La limitación de Elicit es la inversa: cuadrículas excelentes, menos soporte nativo para el trabajo complejo y argumentativo de explicar por qué un hallazgo no debería ser transferible. Si tu entregable es una tabla de evidencia que un supervisor pueda auditar, evalúa primero las herramientas según la completitud MSOL y la procedencia, y solo después según la marca o el precio mensual.
Referencias
- Declaración PRISMA — guía de reporte para revisiones sistemáticas
- DistillerSR — herramientas y técnicas de extracción de datos para revisiones sistemáticas
- medRxiv — precisión y eficiencia de la extracción de datos asistida por AI con Elicit (SWAR 2026)
- Paperguide — herramientas de AI para revisión sistemática y reducción de carga de trabajo reportada
- The BMJ — declaración PRISMA 2020
- PubMed Central — explicación y elaboración de PRISMA 2020, incluidos los dominios de RoB 2
- Wiley / Cochrane Evidence Synthesis and Methods — herramientas de AI como segundos revisores para extracción de datos
- King’s College London — herramientas de AI en síntesis de evidencia
- PapersFlow — comparación de AI entre Elicit y Consensus
- Paperguide — comparación de características y precios de Elicit frente a SciSpace (2026)
- George Mason University — herramientas de AI para revisiones de literatura
- Elicit — AI para investigación científica, cifras de corpus y uso
- Elicit — flujo de trabajo de revisión sistemática de literatura, afirmaciones de precisión de extracción y cribado
- SciSpace — comparación SciSpace frente a Elicit, incluidos los niveles de precios de 2026
- Paperguide — documentación de plataforma para columnas de extracción personalizadas y valores vinculados a la fuente
- Biblioteca de Ciencias de la Salud Himmelfarb — calidad de reporte y riesgo de sesgo
- Birmingham City University — notas sobre precisión de extracción de datos mediante AI
- Paperguide — comparación SciSpace frente a Consensus