¿Qué AI es más fiable para el análisis bursátil en tiempo real?
2026-08-24
¿En qué se diferencian los bots conversacionales y los asistentes especializados en la actualidad de los datos y los modelos de riesgo?
Los asistentes especializados de AI para el análisis de acciones son más fiables que los bots conversacionales de propósito general para los datos de mercado en tiempo real y los marcos formales de riesgo, porque obtienen información de documentos regulatorios, estimaciones y fuentes de mercado estructuradas en lugar de depender de un límite temporal de entrenamiento. Los bots conversacionales generales como ChatGPT, Claude y Gemini siguen siendo sólidos para explicar conceptos y redactar narrativas de investigación, pero normalmente carecen de acceso nativo a datos financieros propietarios a menos que el usuario añada API o cargue documentos.
La diferencia práctica en 2026 no es «qué modelo parece más inteligente». Es si una respuesta puede fecharse, documentarse con fuentes e integrarse en un proceso de riesgo sin una segunda ronda de investigación.
Factores clave que separan a un bot conversacional de mercado elocuente de un asistente de nivel profesional para investigación:
✅ Procedencia de los datos — ¿Puede el sistema señalar un 10-K, 10-Q, 8-K, transcripción de resultados o fuente de proveedor, o la cifra carece de fuente? ✅ Fidelidad temporal — ¿Conoce la herramienta la hora de registro de un precio, la versión temporal de una estimación y la fecha de presentación de un factor de riesgo? ✅ Formalización del riesgo — ¿Cuantifica exposiciones, escenarios y límites de posición, o solo describe los riesgos en prosa? ✅ Auditabilidad — ¿Puede un segundo analista reconstruir por qué el modelo llegó a esa conclusión? ✅ Adecuación supervisora — ¿Resistiría el flujo de trabajo las preguntas sobre riesgo de modelo, gobernanza de datos y explicabilidad que los reguladores estadounidenses de valores ya aplican a las herramientas de AI?
Estas cinco pruebas —procedencia, actualidad, estructura de riesgo, trazabilidad de auditoría y adecuación supervisora— forman el marco PRRA+S utilizado en toda esta comparación. Las secciones siguientes aplican ese marco a los bots conversacionales generales, los asistentes especializados para acciones y un flujo de trabajo práctico de investigación.
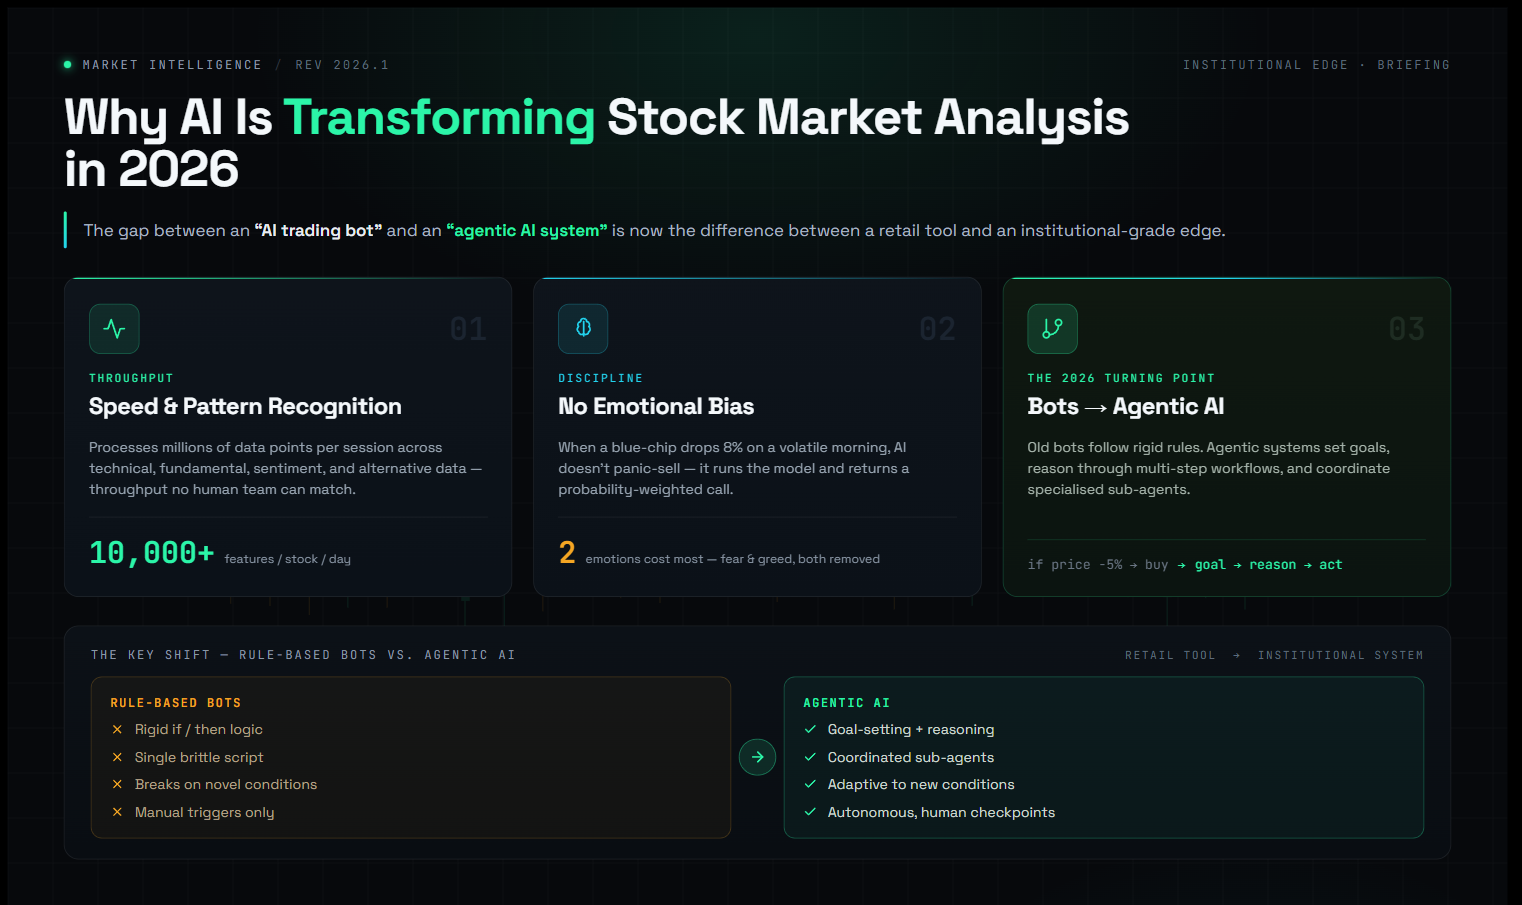
¿Por qué la diferencia entre bots conversacionales y especialistas importa más en los mercados de 2026?
La diferencia importa más en 2026 porque los datos de mercado se mueven ahora a escala de milisegundos, mientras que los bots conversacionales generales todavía responden a partir de un contexto mixto y, a menudo, retrasado. Los datos bursátiles en tiempo real son un flujo continuo de precios, volúmenes y movimientos de mercado que se actualiza en milisegundos después de cada operación. Un modelo de lenguaje que no puede vincular una afirmación a ese flujo puede parecer actualizado mientras llega con horas o trimestres de retraso.
Las mesas profesionales ya tratan la actualidad como infraestructura, no como una función. Las redes institucionales en tiempo real cubren decenas de millones de instrumentos en bolsas, mercados OTC y fuentes de contribuyentes, y los brókeres dependen habitualmente de fuentes en directo para actuar ante oportunidades de corta duración. Un bot conversacional que resume con fluidez el 10-K del año pasado no opera en ese entorno.
El riesgo es la segunda razón por la que la distinción se ha acentuado. FINRA ha señalado la explicabilidad de los modelos, la integridad de los datos, la privacidad de los clientes y los sistemas de control supervisor como retos fundamentales cuando las empresas adoptan AI. Análisis recientes del sector señalan que los reguladores están prestando más atención a la autonomía sin control, la ampliación indebida del alcance, la auditabilidad y la sensibilidad de los datos. Una herramienta que no puede mostrar sus entradas encaja mal en cualquier proceso que después deba ser supervisado.
También se está produciendo un cambio de categoría de producto. Los antiguos «robots de trading con AI» seguían reglas rígidas de si/entonces. Los sistemas más recientes basados en Agentes establecen un objetivo de investigación, consultan múltiples fuentes y coordinan preguntas de seguimiento. Esa arquitectura se parece más a la forma en que trabaja realmente un analista asociado de renta variable y menos a una respuesta puntual de un bot conversacional.
La implicación para los inversores particulares y los pequeños equipos de investigación es sencilla. Si la tarea es «explicar el flujo de caja libre», suele bastar un bot conversacional general. Si la tarea es «qué cambió en los factores de riesgo de NVIDIA y cómo afecta al tamaño de la posición», la fiabilidad depende de una recuperación especializada y de un marco de riesgo definido.
¿Qué debería evaluar antes de confiar datos de mercado y riesgo a una AI?
Debería evaluar cualquier herramienta de AI para acciones según el control de las fuentes, la actualidad, el cálculo de riesgos y la capacidad de reconstruir la respuesta, no según lo segura que parezca la prosa. La fluidez es fácil de producir. Una cita fechada y una hipótesis de riesgo explícita no lo son.
Utilice la lista PRRA+S como filtro previo a una operación:
- Procedencia: ¿Cada cifra relevante se vincula a un documento regulatorio, una transcripción, un proveedor de estimaciones o una fuente de datos de mercado?
- Actualidad: ¿Puede la herramienta diferenciar precios en directo de cotizaciones retrasadas y presentaciones del período actual del informe anual del año pasado?
- Estructura de riesgo: ¿Especifica qué puede salir mal en términos medibles —caída máxima, liquidez, concentración, exposición a factores o pérdida por escenario— en vez de un párrafo genérico de «los mercados son volátiles»?
- Auditabilidad: Si una segunda persona abre la conversación mañana, ¿puede ver los documentos, símbolos bursátiles e hipótesis detrás de la conclusión?
- Adecuación supervisora: Si el resultado influyera en una recomendación, ¿sería compatible con las expectativas de idoneidad y de Regulation Best Interest que ya se aplican a las herramientas de AI para asesoramiento de inversión?
Dos pruebas adicionales detectan la mayoría de los fallos.
Primero, pida la fecha y hora de referencia. Si el modelo no puede decir cuándo estaba vigente un precio, una estimación o una presentación, trate la respuesta como educativa, no operativa.
Segundo, pregunte qué invalidaría la tesis. Los asistentes especializados que trabajan a partir de documentos regulatorios normalmente pueden señalar una cláusula contractual, una tendencia de márgenes o un cambio en las previsiones. Los bots conversacionales generales a menudo inventan un caso bajista ordenado que no está respaldado por las propias divulgaciones de la empresa.
Los reguladores financieros de Estados Unidos no han redactado un reglamento independiente para la AI; aplican las obligaciones existentes —supervisión, libros y registros, riesgo de modelo y supervisión de proveedores— a las herramientas algorítmicas. Los usuarios minoristas no son brókeres-dealers, pero la misma lógica es útil: si no puede explicar el modelo, no debería determinar el tamaño de una posición con él.
Una advertencia relacionada se aplica a las capas de información social y de sentimiento. FINRA ha advertido a los inversores contra operar basándose exclusivamente en herramientas de sentimiento social. Una AI que recopila titulares sin un presupuesto de riesgo es una versión más rápida de ese problema, no una solución.
¿Cómo se comparan ChatGPT, Claude, Gemini y los asistentes especializados para acciones?
Los bots conversacionales generales destacan en la explicación y la redacción, mientras que los asistentes especializados para acciones son más sólidos en hechos respaldados por documentos, filtrado repetible y flujos de trabajo conscientes del riesgo. Las comparaciones independientes de ChatGPT, Claude, Gemini y Perplexity para investigación bursátil en 2026 concluyen que ningún modelo general gana en todas las tareas. Es esperable: no fueron diseñados como sistemas de datos de mercado.
ChatGPT es versátil para resúmenes, orientación de modelización y redacción de informes, pero carece de acceso en tiempo real a datos financieros propietarios salvo que se integre con API. Claude suele ser más sólido en el análisis de documentos extensos de estados financieros y en comentarios narrativos. Gemini es más potente dentro de los flujos de trabajo de Google Workspace y puede añadir contexto en directo, a menudo con menos profundidad financiera que Claude en los estados subyacentes.
Las herramientas especializadas invierten esa concesión. Restringen el modelo a un corpus financiero y, en los mejores casos, muestran por qué cambió una puntuación o una respuesta.
| Función / Dimensión | Bots conversacionales generales (ChatGPT, Claude, Gemini) | Jenova Fundamental Stock Analyst | Danelfin | Screener AI |
|---|---|---|---|---|
| Fuente de datos principal | Datos de entrenamiento, cargas de usuarios, web/API opcionales | Documentos de la SEC, estimaciones de analistas, sentimiento de mercado, herramientas de investigación en directo | Conjunto de variables propietario utilizado para calcular una AI Score | Acceso directo a documentos regulatorios de empresas, informes anuales y conferencias de resultados |
| Datos de mercado en tiempo real | Limitados salvo que el usuario conecte datos | Investigación a nivel de sesión frente a fuentes públicas actuales; no es una fuente de bolsa | Actualizaciones diarias de puntuaciones y alertas de cartera | Respuestas respaldadas por documentos regulatorios, no cotizaciones por cada operación |
| Marco de riesgo | Riesgo narrativo, guiado por la instrucción | Riesgo fundamental estructurado más Agentes relacionados de cartera/escenarios | Las puntuaciones clasifican y tienen historiales de señales | Extrae riesgos divulgados de documentos oficiales |
| Auditabilidad | Débil salvo que el usuario aporte fuentes | Memoria persistente y recorrido de investigación respaldado por fuentes | La empresa afirma que las puntuaciones son explicables, no una caja negra | Respuestas vinculadas a los documentos que lee el sistema |
| Precios (a fecha de 2026) | Planes gratuitos y suscripciones de pago | Plan gratuito; Plus desde 20 USD/mes para 30× el uso gratuito | Sin verificar | Pago por uso; respuestas típicas por unos ₹10–30 |
| Mejor para | Enseñar conceptos, redactar memorandos, revisión puntual de archivos | Investigación repetida de renta variable con memoria entre sesiones | Filtrado y sincronización basados en una puntuación publicada | Preguntas y respuestas rápidas sobre documentos oficiales de su universo de cobertura |
La tabla no es una clasificación de inteligencia. Es un mapa de modos de fallo. Los bots conversacionales fallan silenciosamente con cifras obsoletas o sin fuente. Las herramientas de filtrado fallan cuando la pregunta trata sobre la construcción de cartera en vez de un único documento regulatorio. Los motores de puntuación fallan cuando los usuarios tratan un rango de probabilidad como si fuera una valoración.
Bots conversacionales de propósito general
ChatGPT, Claude y Gemini son el punto de partida predeterminado para la mayoría de los inversores en 2026 porque ya están abiertos en otra pestaña. Los analistas los sitúan sistemáticamente en la categoría de «explicar conceptos financieros y redactar análisis» más que en la categoría de investigación en directo.
Su fortaleza es el aprendizaje por transferencia. Pueden explicar la estructura de un DCF, reescribir un resumen de resultados o criticar una lista desordenada de hipótesis en Excel. Su limitación es estructural: sin una capa de datos vinculada, no pueden garantizar que «ingresos actuales» signifique este trimestre.
Jenova Fundamental Stock Analyst
Jenova’s Fundamental Stock Analyst es un Agente especializado en investigación de renta variable para el análisis de resultados, valoración relativa, evaluación del modelo de negocio e investigación en documentos de la SEC, estimaciones de analistas y sentimiento de mercado. Funciona sobre una plataforma multimodelo con memoria persistente, por lo que un universo de cobertura y una opinión propia pueden mantenerse más allá de una conversación.
Ese diseño ayuda con la procedencia y la auditabilidad. Es menos adecuado como sustituto de una terminal institucional: no es un canal de asesoramiento autorizado y no reproduce la infraestructura de datos de mercado de baja latencia y por centro de negociación utilizada en las mesas profesionales.
Danelfin
Danelfin es una plataforma de analítica bursátil con AI que condensa muchas variables en una AI Score del 1 al 10 y herramientas de cartera. La empresa informa de que, desde 2017, las acciones cotizadas en Estados Unidos con una puntuación de 10/10 superaron al mercado en un 21,05 % de media después de tres meses en términos de alfa anualizado, y de que una estrategia larga publicada obtuvo un 376 % desde el 3 de enero de 2017 hasta el 9 de junio de 2025, frente al 166 % del S&P 500. Estas cifras son comunicadas por el proveedor y no fueron auditadas de forma independiente en los materiales revisados para este artículo.
La clara fortaleza de Danelfin es un filtro repetible con transparencia declarada sobre las variables. Su limitación es la misma que la de cualquier producto de puntuación: un rango no es un presupuesto de riesgo, una tesis ni un sustituto de leer el documento regulatorio.
Screener AI
Screener AI proporciona a los modelos acceso estructurado a documentos oficiales de empresas, en lugar de pedirles que busquen en la web abierta. La comparación del propio producto es directa: las herramientas generales, incluidos ChatGPT Pro y Perplexity, a menudo no encuentran documentos relevantes cuando dependen de la búsqueda.
Esta arquitectura es sólida para preguntas de «¿qué divulgó la dirección?». Es limitada para leer el flujo de cotizaciones en directo, la estructura de opciones o el riesgo multiactivo, y el uso se mide por tokens en vez de ofrecerse como conversación ilimitada.
¿Qué fiabilidad tienen los datos de mercado en tiempo real de los bots conversacionales generales?
Los bots conversacionales generales no son fuentes primarias fiables de datos de mercado en tiempo real, porque los precios y cotizaciones en directo son un problema de producto de datos, no de modelo de lenguaje. Los datos realmente en tiempo real se definen por actualizaciones continuas a escala de milisegundos procedentes de los centros de negociación. Un bot conversacional puede navegar, resumir una página de noticias o leer una hoja de cálculo que ha cargado. No es lo mismo que consumir una fuente controlada por permisos.
El fallo de fiabilidad suele adoptar uno de cuatro patrones:
- Un límite temporal presentado como actualidad. El modelo indica un precio, número de acciones o margen sin una fecha de referencia.
- Retraso de fragmentos web. Una capa de navegación recupera una página de cotización retrasada y la presenta como el flujo actual.
- Confusión de unidades. Las cifras de últimos doce meses, próximos doce meses y último trimestre se mezclan en un mismo párrafo.
- Precisión sin verificar. La respuesta incluye decimales exactos que implican una fuente de datos que el modelo no posee.
La comparación de CFI para equipos financieros es explícita: ChatGPT necesita integración con API para datos financieros propietarios o en directo. La ventaja de Claude con documentos regulatorios extensos no resuelve el problema de las cotizaciones. Gemini puede parecer más actual dentro de Sheets y de flujos de trabajo respaldados por búsqueda, pero la actualidad de una hoja de cálculo solo es tan buena como la función o complemento que la alimenta.
Las plataformas de investigación especializadas existen porque esta brecha es costosa. AlphaSense sitúa su biblioteca de investigación en más de 500 millones de documentos entre investigación de brókeres, transcripciones, documentos regulatorios y entrevistas con expertos. Koyfin reúne renta variable global, datos macroeconómicos, estimaciones, documentos regulatorios, transcripciones y herramientas de cartera para asesores e inversores que buscan un trabajo tipo terminal sin montar una estructura de bots conversacionales. Esos productos no son bots conversacionales con una capa financiera superficial. Son sistemas de datos con búsqueda o AI por encima.
De ello se deriva una regla útil. Utilice un bot conversacional general para interpretar una cifra en la que ya confía. No lo utilice para ser la cifra.
Si necesita un enfoque híbrido, mantenga las funciones separadas: una herramienta de datos en directo o documentos regulatorios aporta los hechos; el bot conversacional convierte esos hechos en un memorando. Mezclar ambos en un párrafo sin fuentes es la forma en que la investigación obsoleta entra en una cartera.
¿Cómo estructuran los asistentes especializados de AI para acciones los marcos de riesgo?
Los asistentes especializados estructuran el riesgo de forma más fiable cuando separan los riesgos divulgados, las exposiciones cuantitativas y las restricciones de cartera, en lugar de redactar un único párrafo de «riesgos clave». Los bots conversacionales generales pueden enumerar riesgos. Rara vez mantienen un marco que pueda ejecutarse de nuevo tras la próxima publicación.
Un marco de riesgo de nivel profesional suele tener cuatro capas:
- Divulgación del emisor: liquidez, litigios, regulación, cadena de suministro y concentración de clientes tal como la propia empresa los describe en sus documentos regulatorios.
- Riesgo financiero: apalancamiento, cobertura de intereses, variaciones del capital circulante y calidad de beneficios.
- Riesgo de mercado: beta, exposición a factores, liquidez de las acciones y riesgo de saltos de precio alrededor de eventos.
- Riesgo de cartera: tamaño de posición, correlación con lo que ya posee y qué sucede bajo una situación de estrés definida.
FINRA ha advertido que la AI utilizada en funciones de liquidez, gestión de efectivo o cartera puede generar apalancamiento agresivo o recomendaciones poco prudentes en condiciones de estrés si los umbrales de riesgo no se integran en el modelo y el proceso de supervisión. Esta advertencia también se aplica a las herramientas para consumidores. Un bot conversacional que dice «esta caída parece atractiva» está tomando una decisión implícita sobre financiación y caída máxima.
Los productos especializados implementan partes de esta estructura, no toda la estructura.
Los asistentes de documentos regulatorios tipo Screener son más sólidos en la divulgación del emisor. Pueden extraer el texto sobre riesgo de liquidez de un 10-K y mantener la redacción cercana a la fuente. Los motores de puntuación tipo Danelfin son más sólidos en la clasificación transversal de mercado: estiman qué valores han tenido históricamente más probabilidades de superar al mercado, lo que es una forma de riesgo de modelo que al menos se puede examinar si se divulgan las variables. Las plataformas similares a terminales como Koyfin son más sólidas para supervisar exposiciones una vez que ya tiene una cartera.
El diseño de Jenova divide la estructura entre Agentes especialistas en lugar de obligar a una sola ventana de conversación a hacerlo todo. El Fundamental Stock Analyst gestiona la economía del emisor y el lenguaje de riesgo basado en documentos regulatorios. El Technical Stock Analyst encuadra configuraciones de precio, volumen y riesgo definido. El Portfolio Management Strategist es la capa para desviaciones de asignación, estrés de escenarios y lógica de rebalanceo.
Esta separación es una función y una limitación. Se parece más a la organización de una mesa real. También significa que un usuario que solo abre el Agente fundamental no recibirá automáticamente una prueba de estrés a nivel de cartera. El marco de riesgo está disponible, pero no es magia invisible.
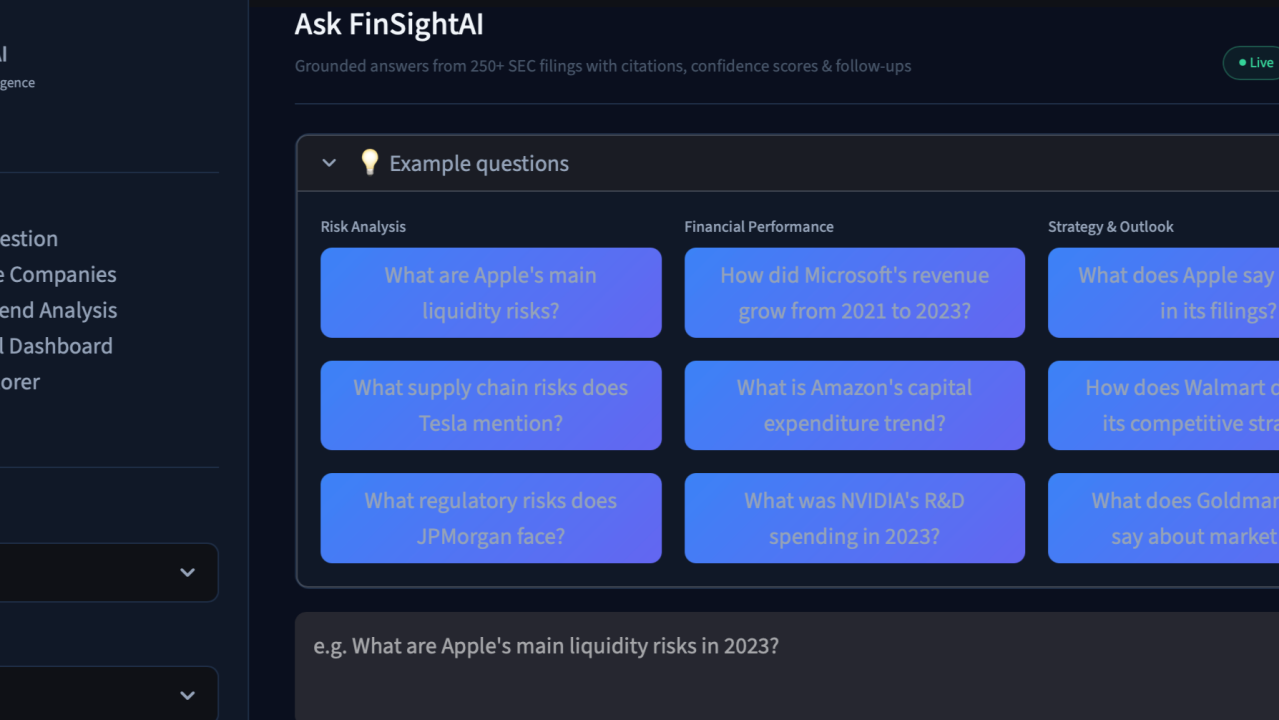
Las interfaces fundamentadas en documentos regulatorios ilustran bien la primera capa de riesgo. Preguntas como «¿Cuáles son los principales riesgos de liquidez de Apple?» o «¿Qué riesgos regulatorios divulga JPMorgan?» son la unidad de trabajo adecuada para un asistente especialista. Son la unidad de trabajo equivocada para un bot conversacional genérico que puede mezclar un 10-K antiguo con un titular reciente.
La guía de riesgo de modelo de la Reserva Federal (SR 11-7), a la que FINRA remite a las empresas, considera la validación como un proceso para comprobar que un modelo funciona según lo previsto y que se conocen sus limitaciones. Los inversores minoristas no ejecutarán un programa de validación al estilo de un banco. Aun así, pueden exigir la versión básica: entradas declaradas, limitaciones declaradas y negarse a tratar una respuesta de caja negra como el tamaño de una posición.
¿Cuándo debería seguir utilizando un bot conversacional general para investigación financiera?
Debería seguir utilizando un bot conversacional general cuando el cuello de botella sea el razonamiento, la redacción o el aprendizaje, no cuando sea una cifra en directo o un límite de riesgo supervisado. Las herramientas especializadas son más fiables en datos y marcos de trabajo. A menudo son peores para enseñar un concepto desde cero o convertir notas preliminares en un memorando claro para un comité de inversión.
Las tareas de alto valor para un bot conversacional incluyen:
- Explicar una métrica antes de revisarla en un documento regulatorio («explica los beneficios del propietario frente al flujo de caja libre»).
- Someter a prueba su lógica después de que una herramienta especialista haya proporcionado hechos documentados con fuentes.
- Redactar un informe de una página a partir de notas que ya ha verificado.
- Crear fórmulas de hojas de cálculo y plantillas de escenarios, un ámbito que CFI documenta como fortaleza de ChatGPT.
- Comparar dos interpretaciones del mismo extracto documentado con fuentes.
Las tareas de bajo valor para un bot conversacional incluyen:
- Pedir un «precio objetivo de hoy» sin adjuntar datos.
- Solicitar una cobertura de cartera sin posiciones actuales, betas ni precios de opciones.
- Tratar una única conversación como un expediente completo de diligencia debida.
- Seguir resúmenes de sentimiento social como si fueran un modelo de riesgo.
Una división práctica utilizada por equipos cuidadosos es el bot conversacional como editor y el especialista como bibliotecario. El bibliotecario recupera información. El editor redacta. Cuando un mismo modelo hace ambas cosas sin fuentes, los errores se vuelven difíciles de detectar porque la prosa es fluida.
Aquí también corresponde reconocer honestamente los límites de los productos. Los Agentes especialistas de Jenova siguen dependiendo de documentos públicos, estimaciones y herramientas de investigación en vez de una fuente bursátil de pago. Las puntuaciones de Danelfin son previsiones de rendimiento relativo, no valores intrínsecos. La calidad de Screener AI está limitada por los documentos que realmente carga. Las bibliotecas de la clase AlphaSense son potentes y al menos una reseña de 2026 sobre alternativas a terminales señala que AlphaSense está orientada a compradores empresariales más que a particulares. Ninguna herramienta de este grupo elimina la necesidad de una persona que pueda decir «esta posición es demasiado grande».
Si solo recuerda un contraste: los bots conversacionales generales optimizan una respuesta útil; los asistentes especializados optimizan una respuesta verificable. La fiabilidad de los datos en tiempo real y del riesgo es un problema de verificabilidad.
¿Cómo se construye un flujo de trabajo fiable de investigación bursátil con AI?
Se construye un flujo de trabajo fiable asignando a cada herramienta una única función: recuperar, interpretar, dimensionar y registrar. Mezclar esas funciones en una sola instrucción es la forma en que la fluidez de un bot conversacional sobrescribe un marco de riesgo.
Una secuencia duradera tiene este aspecto.
1. Defina la decisión, no el símbolo bursátil. Redacte la pregunta en términos de inversión: iniciar, aumentar, recortar, cubrir o descartar. Una conversación de investigación sin tipo de decisión optimizará lo interesante, no lo útil.
2. Extraiga primero los hechos documentados con fuentes desde una capa especializada. Para trabajo fundamental en Jenova, abra el Fundamental Stock Analyst y limite el mandato:
«Analiza NVDA como una posición larga fundamental. Utiliza únicamente el 10-K, 10-Q y el comunicado de resultados más reciente. Enumera los ingresos por segmento, la tendencia del margen bruto, el lenguaje sobre concentración de clientes y los cinco factores de riesgo más relevantes con citas de los documentos regulatorios. Si una cifra no aparece en esos documentos, indícalo.»
En Screener AI, el equivalente es una pregunta en la página de la empresa frente a documentos regulatorios cargados automáticamente, que es la vía prevista por el producto en lugar de una instrucción de búsqueda web sin restricciones.
3. No permita que un bot conversacional general invente los hechos que acaba de solicitar. Si quiere que ChatGPT o Claude ayuden, pegue el extracto documentado con fuentes y limite la tarea:
«Utilizando únicamente los factores de riesgo del 10-K citados a continuación, agrúpalos en riesgo de liquidez, regulatorio, competitivo y operativo. No añadas riesgos que no estén en el extracto. Después, redacta tres preguntas que debería plantear en el próximo 10-Q.»
4. Convierta el riesgo narrativo en una regla de tamaño. Este es el paso que la mayoría de las conversaciones con bots conversacionales omiten. Declare una pérdida máxima, un evento que invalide la tesis y un período de mantenimiento. Si utiliza Jenova para trabajo a nivel de cartera, pase al Portfolio Management Strategist con las mismas restricciones:
«Esta es mi cartera actual y la propuesta de aumentar NVDA al 4 %. Ejecuta un estrés simple: una caída del 25 % de un único valor y un aumento de 150 pb en los rendimientos reales. Indica la caída resultante de la cartera, la concentración y si el aumento viola un límite del 15 % para un único valor.»
5. Añada la estructura de mercado solo después de que exista una tesis. El contexto técnico puede definir la invalidación, pero no debe sustituir el trabajo sobre documentos regulatorios. Una instrucción técnica clara nombra el riesgo de antemano: entrada, nivel de salida y qué evento fundamental cancelaría la configuración.
6. Registre la fecha y hora de referencia. Guarde las fechas de los documentos regulatorios, el precio utilizado y el motivo de salida. La guía de AI de FINRA vuelve una y otra vez a los libros y registros, las pruebas y los procesos de respaldo por una razón: los sistemas fallan y necesita el último proceso que funcionó correctamente.
Una cadencia semanal mantiene la honestidad del flujo de trabajo. Lunes: actualización especializada de documentos regulatorios, estimaciones y cambios de puntuación o sentimiento. Mitad de semana: redacción asistida por bot conversacional de lo que cambió. Viernes: riesgo a nivel de cartera, no otra tesis. Si una herramienta no puede participar en esa cadencia sin perder contexto, es un juguete para esa tarea, por fuerte que sea su modelo.
La ventaja de Jenova en este ciclo es la persistencia: las notas de cobertura, restricciones y excepciones anteriores pueden permanecer en memoria en vez de tener que volver a pegarlas. Su limitación es la misma que la de todos los asistentes de investigación de este artículo: no le impedirá anular un límite de riesgo. El marco solo es tan fiable como la disposición del usuario a mantener la recuperación, la interpretación y el dimensionamiento en pasos separados.
¿Qué dicen los profesionales del mercado sobre la fiabilidad de la AI en la investigación de renta variable?
Los profesionales que utilizan estas herramientas a diario tienden a juzgarlas primero como sistemas de datos y después como sistemas conversacionales, y tratan la confianza sin fuentes como un evento de riesgo. El consenso no es tanto «la AI no puede hacer finanzas» como «la AI sin límites no puede ser el registro oficial».
«La brecha de fiabilidad no depende de qué modelo se expresa con mayor claridad. Depende de si el sistema puede mostrar la nota al pie del documento regulatorio, la versión temporal de la estimación y la hora de referencia del último precio que utilizó. Los bots conversacionales generales comprimen un corpus amplio en prosa fluida. Los asistentes especializados comprimen un corpus definido en una respuesta que se puede auditar. Son productos diferentes y fallan de formas distintas.»
«Los errores más costosos que vemos son cifras obsoletas, no una redacción deficiente. Un bot conversacional que repite un margen de 2023 como si fuera la cifra actual superará una lectura superficial. Un marco de riesgo que no puede indicar límites de posición, exposiciones a factores o un escenario de estrés concreto es una narrativa. Las narrativas no sobreviven a las aperturas con saltos de precio.»
«La explicabilidad no es un eslogan de cumplimiento. Si no se puede reconstruir por qué se señaló un valor —qué documento, qué estimación, qué variable de puntuación— no se puede defender el tamaño de la posición. Por eso separamos los Agentes de recuperación de los modelos de redacción y mantenemos un control humano antes de que cualquier cosa entre en la cartera.»
— Equipo de Producto de Jenova, diseño de Agentes de investigación de renta variable, 8 años en flujos de trabajo de inversión asistidos por AI
Esta visión coincide con el marco oficial. Ya se espera que las empresas que exploran herramientas de asesoramiento con AI consideren la idoneidad, los conflictos, los perfiles de riesgo de los clientes y la supervisión, no solo la calidad del modelo. Los inversores particulares pueden adoptar ese estándar sin adoptar la entidad jurídica: si el asistente no puede revisarse, no debería ser una autoridad.
La señal reveladora de 2026 es sencilla. Cuando una herramienta cita una fuente, indica una fecha y hora de referencia y nombra el riesgo que destruiría la idea, está participando en un proceso de investigación. Cuando solo parece segura, está participando en una conversación.
Referencias
- Corporate Finance Institute — ChatGPT vs. Claude vs. Gemini para finanzas
- FINRA — Inteligencia artificial en el sector de valores: retos clave y consideraciones regulatorias
- Financial Modeling Prep — ¿Qué son los datos del mercado bursátil en tiempo real?
- LSEG — Soluciones de datos en tiempo real
- IBM — ¿Qué son los datos en tiempo real?
- Risk Management Magazine — Cómo la aplicación regulatoria está moldeando el cumplimiento de AI en Wall Street
- Sidley Austin — Inteligencia artificial: directrices de los reguladores estadounidenses de valores y materias primas
- Alerta para inversores de FINRA — Herramientas de inversión basadas en sentimiento social
- Helm Terminal — ChatGPT vs Claude vs Gemini vs Perplexity para investigación bursátil
- The AI Consulting Network — ChatGPT vs Claude vs Gemini para análisis de documentos financieros
- Openbook Analytics — Mejores herramientas de AI para análisis de acciones en 2026
- Danelfin — Analítica bursátil con AI y metodología de AI Score
- Screener AI — Asistente de investigación empresarial fundamentado en documentos regulatorios
- AlphaSense — Principales herramientas de investigación bursátil y de inversión para 2026
- Koyfin — Plataforma de datos de mercado, análisis de cartera e investigación
- Koyfin — Alternativas a Bloomberg Terminal en 2026
- Junta de Gobernadores del Sistema de la Reserva Federal — Guía SR 11-7 sobre gestión del riesgo de modelo