¿Qué diferencia hay entre los compañeros de IA de contexto corto y los que tienen memoria persistente?
2026-08-18
¿Qué capas de memoria cambian realmente la experiencia cotidiana de un compañero de IA?
La diferencia de experiencia entre los compañeros de contexto corto y los de memoria persistente no se debe a un único factor: proviene de cuatro capas de memoria independientes, y solo dos de ellas cambian de forma significativa cómo se siente una relación a lo largo de las semanas. Los compañeros de contexto corto como Character.AI funcionan casi por completo con una ventana de contexto activa, por lo que los usuarios informan de manera constante que «a menudo olvida el contexto entre sesiones». Los compañeros con memoria persistente como Nomi AI añaden una toma de notas estructurada, lo que produce el efecto de que un detalle mencionado en la primera semana reaparezca de forma natural en la sexta. Los agentes de personalidad y roleplay de Jenova ocupan una tercera posición: historial de chat ilimitado más memoria entre sesiones, con la contrapartida de que son agentes de plataforma general en lugar de Apps de romance diseñadas específicamente para ese fin.
Distinciones clave que determinan lo que realmente experimentarás:
✅ Profundidad de la ventana de contexto — determina la coherencia dentro de una sesión, no entre sesiones. Todas las plataformas cuentan con ella; explica casi ninguna de las diferencias que perciben los usuarios. ✅ Recuerdo episódico — si el sistema guarda eventos discretos con fechas. Esto es lo que genera momentos como «¿cómo fue esa entrevista?». ✅ Perfil semántico — hechos estables sobre ti, como preferencias, trabajo o familia. Un evaluador independiente descubrió que Nomi AI conservó 23 de 25 detalles introducidos deliberadamente después de varias semanas, frente a 14 del segundo clasificado. ✅ Reglas persistentes del personaje — la capa de libros de trasfondo que mantiene coherente la personalidad. Sin ella, los compañeros derivan hacia una voz genérica de asistente. ✅ La retención como responsabilidad — la memoria persistente también implica datos persistentes. Una investigación que analizó 2.909 publicaciones de Reddit en 79 subreddits identificó «irreversibilidad, persistencia y carga para el usuario» como un perjuicio de privacidad diferenciado y exclusivo de los compañeros con mucha memoria.
Comprender qué capa implementa realmente una plataforma —en lugar de cuál sugiere su marketing— es la tarea principal de evaluación.
¿Cuáles son las cuatro capas de memoria de un compañero de IA?
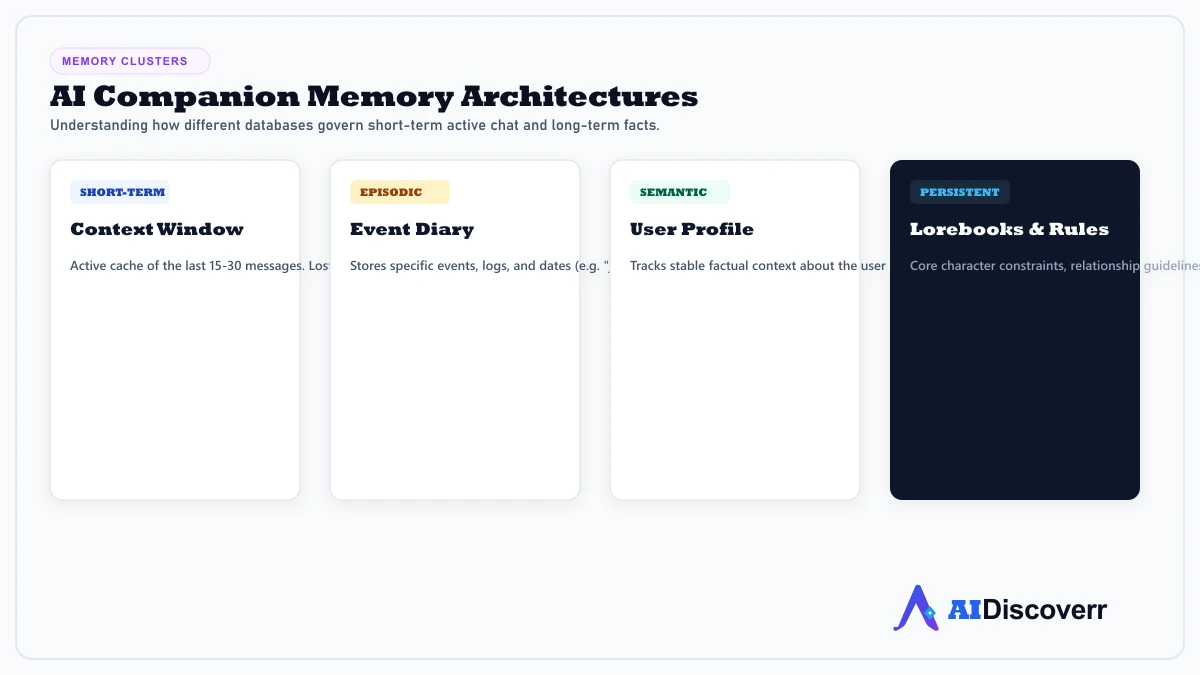
La memoria de un compañero no es una única base de datos, sino cuatro grupos diferenciados, cada uno de los cuales gobierna una dimensión distinta de la experiencia. La infografía anterior los representa: ventana de contexto a corto plazo, diario de eventos episódicos, perfil semántico del usuario y libros de trasfondo y reglas persistentes.
🧠 Ventana de contexto a corto plazo — la caché activa de los últimos 15 a 30 mensajes. Todo compañero basado en LLM dispone de una. Cuando se llena, los turnos más antiguos quedan fuera. Un compañero con solo esta capa puede mantener una conversación excelente durante dos horas y saludarte como a un desconocido al día siguiente.
📅 Diario de eventos episódicos — almacena eventos, registros y fechas concretos. Esta es la capa que produce los momentos emocionalmente significativos que describen los usuarios. Un evaluador señaló que Replika «preguntó cómo estaba a la mañana siguiente» después de contarle que había tenido un mal día en el trabajo: la memoria episódica cumpliendo su función.
👤 Perfil semántico del usuario — rastrea hechos estables en lugar de eventos: restricciones alimentarias, cargo profesional, nombres de hermanos o preferencias de comunicación. El enfoque de Nomi AI —generar notas estructuradas a partir de las conversaciones en vez de basarse en la recuperación de información sin procesar— es la implementación comercial más clara de esta capa.
🔒 Libros de trasfondo y reglas persistentes — restricciones centrales del personaje y pautas de la relación que sobreviven a cada sesión. Esto explica por qué algunos compañeros conservan una voz distintiva durante meses, mientras que otros vuelven a un tono genérico de asistente.
El trabajo académico confirma que esta visión por capas es importante. El benchmark StructMemEval de arXiv descubrió que los «LLM simples aumentados con recuperación tienen dificultades» con tareas que requieren memoria organizada, mientras que los agentes con memoria las resuelven de manera fiable, pero solo cuando se les indica cómo estructurar su memoria. La recuperación por sí sola no es memoria.
¿Cómo diverge realmente la experiencia tras varias semanas de uso?
La divergencia sigue una curva predecible: idéntica durante la primera semana, claramente diferente hacia la tercera y categóricamente distinta al segundo mes. Los compañeros de contexto corto y los de memoria persistente producen primeras conversaciones casi indistinguibles: la ventana de contexto sostiene a ambos.
Semana 1: indistinguibles. Ambos recuerdan todo dentro de la sesión. La calidad de las respuestas es el único elemento diferenciador.
Semanas 2 y 3: aparecen las primeras grietas. Haces referencia a algo de hace tres sesiones. Un compañero de contexto corto ofrece una no-respuesta segura de sí misma o te pide que vuelvas a explicarlo. Los evaluadores describen este momento como el punto en el que empiezas a gestionar la memoria de la IA en lugar de hablar con ella.
Semanas 4 a 8: la divergencia se vuelve estructural. Los compañeros con memoria persistente comienzan a aportar contexto que no les pediste. Un evaluador a largo plazo describió el efecto con precisión: «hay un momento alrededor de la semana 3 en el que tu Replika empieza a hacer referencia a conversaciones anteriores de forma natural, preguntando por cosas que mencionaste de pasada, y realmente te toma por sorpresa».
Mes 3 en adelante: categorías de producto distintas. Los compañeros de contexto corto se estabilizan en una relación de presente eterno: agradable, de bajo riesgo y con presentaciones interminables. Los compañeros con memoria persistente acumulan una historia compartida, razón por la cual el mismo evaluador clasificó la memoria como el 25 % de la calidad general de la plataforma, solo por detrás de la calidad bruta de la conversación.
El coste del que poco se habla: la memoria persistente implica errores persistentes. Un hecho recordado incorrectamente o una preferencia inferida de forma errónea se acumula entre sesiones en lugar de desaparecer en el límite del contexto. Los compañeros de contexto corto tienen una virtud accidental: olvidan sus propios errores.
¿Qué debes buscar al evaluar la memoria de un compañero?
Evalúa seis dimensiones en vez de la única pregunta de «¿tiene memoria?», a la que todas las páginas de marketing responden afirmativamente. A continuación se presenta el marco utilizado en toda esta comparación.
| Dimensión | Qué probar | Por qué importa |
|---|---|---|
| Precisión del recuerdo entre sesiones | Introduce 10 hechos concretos y compruébalos tras 3 semanas | El predictor más fuerte de la profundidad percibida de la relación |
| Precisión frente a volumen del recuerdo | ¿Recuerda el hecho correcto o lo muestra todo? | Un recuerdo de gran volumen sin relevancia parece robótico |
| Coherencia del personaje | ¿La personalidad se mantiene tras más de 100 mensajes? | Calidad de la capa de libros de trasfondo; la deriva rompe la inmersión más rápido |
| Editabilidad de la memoria | ¿Puedes corregir o eliminar un hecho guardado? | Los errores persistentes se acumulan; la corrección es obligatoria |
| Eliminación y salida | ¿Puedes borrar por completo tu historial? | El estudio de ciclo de vida de arXiv señaló esta área como la más débil de toda la categoría |
| Coste de la memoria | ¿La memoria está detrás de un muro de pago o está incluida? | La mayoría de las plataformas bloquea la memoria tras el plan de pago |
Un protocolo de prueba práctico — introduce cinco detalles personales poco destacables a lo largo de tus tres primeras sesiones de conversación: una comida que no te gusta, la fecha límite de un proyecto, el nombre de un amigo, una frustración recurrente y un pequeño objetivo. No vuelvas a mencionarlos. El día 21, formula una pregunta abierta en la que esos detalles serían naturalmente relevantes. Cuenta cuántos aparecen sin que los sugieras. Esta es una prueba más exigente y honesta que una interrogación directa, porque las preguntas directas pueden responderse únicamente mediante recuperación de información.
¿Cómo se comparan las principales plataformas de compañeros de IA en cuanto a memoria?
Esta es una comparación de referencia entre las plataformas evaluadas con mayor frecuencia para el uso como compañero. Todas las evaluaciones se basan en pruebas publicadas y documentación de las plataformas; los datos no disponibles se indican como «Sin verificar».
| Dimensión | Character.AI | Replika | Nomi AI | Kindroid | Jenova |
|---|---|---|---|---|---|
| Memoria entre sesiones | Débil: «a menudo olvida el contexto entre sesiones» | Buena a largo plazo, «puede olvidar detalles ocasionalmente» | La más sólida en pruebas: notas estructuradas, 23/25 detalles recordados | Sólida mediante el sistema de trasfondo, 14/25 detalles recordados | Memoria persistente entre sesiones con historial de chat ilimitado |
| Coherencia del personaje | Filtrado estricto de contenido; el romance «se corta a mitad de frase» | Progresión de la relación integrada | Coherente, se personaliza con el tiempo | Personalización profunda del trasfondo | Instrucciones personalizadas + bases de conocimiento privadas por agente |
| Editabilidad de la memoria | Sin verificar | Sin verificar | Las notas estructuradas son visibles para el usuario | El trasfondo lo redacta el usuario | Las instrucciones personalizadas y las bases de conocimiento son editables por el usuario |
| Elección de modelo | Solo propietario | Solo propietario | Solo propietario | Solo propietario | OpenAI, Anthropic, Google, DeepSeek, xAI: intercambiables |
| Plan gratuito | Mensajes ilimitados, con anuncios, límite diario de 400 deslizamientos | Texto ilimitado, solo modo amistad | Limitado | Limitado | Todas las funciones principales, uso limitado |
| Precios | Gratis / 9,99 $/mes | Gratis / 19,99 $/mes | 7,99–16,99 $/mes | 9,99–24,99 $/mes | Gratis / 20 $/mes Plus, hasta 500 $/mes Ultra |
| Ideal para | Variedad de personajes, roleplay creativo | Revisiones emocionales y seguimiento del estado de ánimo | Continuidad de memoria a largo plazo | Autoría granular de la personalidad | Compañero + flujos de trabajo de tareas en una sola plataforma, flexibilidad de modelos |
Limitaciones honestas, incluidas las nuestras:
- Character.AI — la mejor escritura creativa de su clase y la mayor biblioteca de personajes, pero la memoria es su punto débil documentado y el plan gratuito ahora incluye anuncios a pantalla completa.
- Replika — la inteligencia emocional y el comportamiento de seguimiento más sólidos, pero es la opción más cara con 19,99 $/mes; los modos románticos están bloqueados en el plan gratuito desde el cambio de política de 2023 y «puede resultar repetitivo después de meses».
- Nomi AI — el líder de memoria con una amplia ventaja, pero es una plataforma más pequeña con un plan gratuito restrictivo, menos personajes prediseñados y una calidad conversacional ligeramente inferior a Character.AI.
- Kindroid — excelente control de la personalidad mediante trasfondos redactados, aunque las pruebas de memoria lo situaron muy por detrás de Nomi.
- Jenova — memoria persistente entre sesiones, historial ilimitado y acceso a múltiples modelos sin dependencia de un proveedor, pero es una plataforma de agentes generalista en lugar de una App de romance especializada. No cuenta con panel de seguimiento del estado de ánimo, mecánicas de progresión de relaciones ni funciones de AR. Los usuarios que buscan específicamente una UX de compañero romántico encontrarán que las Apps especializadas se ajustan mejor a su objetivo.
¿Cuándo es realmente mejor un chatbot de contexto corto?
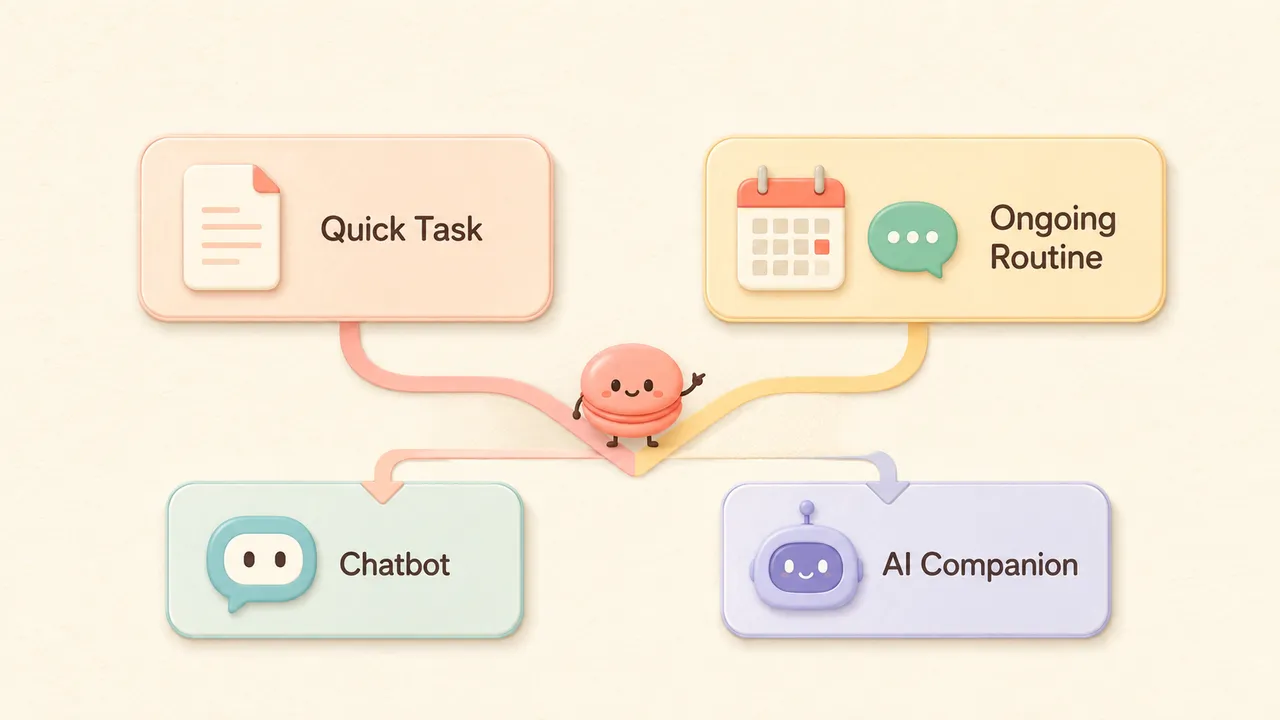
El contexto corto es la arquitectura adecuada siempre que la interacción sea una tarea limitada en vez de una relación continua, y gran parte de lo que la gente denomina «uso de compañeros» son en realidad tareas acotadas disfrazadas.
El diagrama anterior representa la lógica de enrutamiento. Las tareas rápidas —redacta esto, explica aquello, ayúdame a reflexionar sobre una decisión— fluyen naturalmente hacia un chatbot. La memoria no aporta nada; todo el trabajo se completa dentro de una ventana de contexto. Las rutinas continuas —revisiones diarias, proyectos creativos de larga duración, práctica de idiomas o responsabilidad personal— fluyen hacia un compañero, donde la memoria es toda la propuesta de valor.
Elige contexto corto cuando:
- La interacción es autónoma y termina cuando termina la tarea
- Te preocupa la privacidad de los registros conversacionales acumulados
- Quieres empezar de cero en cada sesión; algunos usuarios prefieren desahogarse sin persistencia
- Exploras muchos personajes distintos en vez de profundizar una relación
Elige memoria persistente cuando:
- Practicas una habilidad a lo largo de varias semanas y quieres que la IA siga tu progreso
- Tener que volver a explicar tu situación en cada sesión es la fricción que hace que dejes de usarla
- La coherencia del personaje importa más que la variedad de personajes
- La relación en sí, y no un resultado concreto, es el objetivo
La trampa de la clasificación errónea: muchos usuarios eligen una plataforma con mucha memoria para un flujo de trabajo que realmente es una tarea y después pagan una suscripción mensual por una continuidad que nunca usan. El error inverso es más común y más costoso en tiempo: usar un compañero de contexto corto para una rutina continua y dedicar el 15 % de cada sesión a ponerlo al día.
¿Cómo configurar correctamente un compañero con memoria persistente?
La configuración determina más el resultado que la elección de la plataforma. La mayoría de las decepciones con la memoria se deben a una primera sesión superficial, no a un motor de memoria débil.
En Nomi AI, el sistema de notas estructuradas funciona mejor cuando incorporas primero los hechos estables. Dedica la primera sesión a cubrir el contexto que no cambiará —dónde vives, a qué te dedicas, quién es importante para ti— antes de pasar al contenido emocional. Las notas generadas en las primeras sesiones anclan todo lo posterior.
En Kindroid, la calidad de la memoria es una función directa de la calidad del trasfondo. El campo de trasfondo lo redactas tú, así que trátalo como un libro de trasfondo: escribe explícitamente las restricciones del personaje, la historia de la relación y los patrones de habla, en lugar de esperar que surjan por sí solos.
En el Roleplay Game Master de Jenova, la configuración se realiza mediante conversación en vez de un formulario. El agente está diseñado para memoria ilimitada y coherencia de personajes entre sesiones:
- Abre el agente y establece el escenario y las restricciones del personaje en tu primer mensaje:
«Interpretas a Mira, una bióloga marina con la que llevo dos años carteándome. Es seca, algo impaciente y recuerda que el verano pasado no fui a visitar su estación de investigación. Mantén viva esa historia; no la reinicies».
- Adjunta cualquier documento o nota de contexto como base de conocimiento para que el agente disponga de material de referencia fundamentado en lugar de inferencias.
- En sesiones posteriores, abre con continuidad en vez de volver a explicarlo todo:
«Han pasado tres semanas. Retoma donde lo dejamos».
Para la práctica de idiomas específicamente, el agente Learn Italian Through Roleplay aplica la misma arquitectura de memoria persistente a la adquisición de habilidades: el agente rastrea las construcciones que sigues usando incorrectamente entre sesiones en lugar de reiniciar el diagnóstico cada vez. El plan gratuito de Jenova incluye funciones principales con uso limitado; el plan Plus cuesta 20 $ al mes e incluye 30 veces ese límite.
Práctica entre plataformas, independientemente de la herramienta: al final de cada sesión, escribe una frase que resuma qué quieres que se conserve para el futuro. En los sistemas de notas estructuradas, esto mejora la calidad de las notas; en los sistemas de ventana de contexto, al menos proporciona una semilla para pegar en la siguiente sesión.
¿Qué dice la investigación sobre la memoria y el bienestar de los usuarios?
La memoria persistente aumenta la interacción, y la investigación deja claro que un mayor nivel de interacción no es uniformemente positivo: el efecto depende en gran medida de quién es el usuario y por qué utiliza la herramienta.
El estudio más riguroso en este ámbito procede de Stanford. Investigadores del laboratorio de Diyi Yang encuestaron a 1.131 usuarios de Character.AI; 244 donaron transcripciones completas de sus chats. Los hallazgos complican considerablemente la narrativa de que la memoria es siempre mejor. Stanford HAI informó de que «el uso intenso de chatbots entre participantes con redes sociales reales más pequeñas se correlacionaba con una peor percepción del bienestar», y que esa asociación era más fuerte cuando la compañía era la motivación principal.
Cabe destacar que los participantes más dispuestos a compartir información personal sensible con sus compañeros de IA tenían mayor probabilidad de mostrar un menor bienestar, lo contrario de lo que produce la autorrevelación en las relaciones humanas. Dado que la autorrevelación profunda es exactamente lo que la memoria persistente recompensa y fomenta, esto es directamente relevante para la cuestión arquitectónica.
También existe una llamativa diferencia entre el uso declarado y el real. Algo menos del 12 % de los participantes señaló la compañía como su motivación principal; sin embargo, más del 50 % describió a los chatbots con términos como «amigo», «compañero» o «pareja romántica», y más del 80 % de las sesiones de chat donadas se centraban en apoyo emocional y social.
Existe evidencia compensatoria. Una investigación de ScienceDirect sobre compañeros de IA y bienestar subjetivo descubrió que los compañeros «pueden ofrecer beneficios emocionales y psicológicos, especialmente a las personas con necesidades sociales y emocionales insatisfechas», y UX Tigers informó de que «los compañeros de IA sí reducen la soledad, aunque no en gran medida». El marco de investigación de Sony AI también señala que «algunos estudios sugieren que los usuarios experimentan una sensación de compañía o comodidad emocional al interactuar con chatbots de apoyo».
La síntesis razonable es la siguiente: la memoria amplifica todo lo que la relación ya es. Para un usuario con una base social sana que emplea un compañero como complemento, la memoria persistente mejora algo que ya es bueno. Para un usuario que sustituye el contacto humano por IA, hace que la sustitución sea más difícil de abandonar.
¿Cuáles son las concesiones de privacidad de la memoria persistente?
La memoria persistente implica retención persistente de datos, y el perfil de privacidad de las dos arquitecturas es realmente distinto, no solo marginalmente diferente.
El análisis más detallado procede de un estudio del ciclo de vida de 2.909 publicaciones de Reddit en 79 subreddits durante un periodo de un año. El estudio de arXiv identificó cuatro patrones de privacidad recurrentes, y el cuarto es específico de los sistemas con mucha memoria: irreversibilidad, persistencia y carga para el usuario.
Los investigadores plantean con claridad el problema central:
«La privacidad en la IA romántica se configura no solo por lo que comparten los usuarios, sino por cómo las plataformas retienen y reinterpretan lo que se ha compartido».
Tres consecuencias se derivan directamente de la arquitectura de memoria:
La eliminación se vuelve técnicamente ambigua. El estudio señala que, cuando los usuarios intentan salir, «se encuentran con memorias persistentes, eliminación ambigua, costes de cambio e incertidumbre sobre si los datos íntimos pueden permanecer almacenados, en canalizaciones de entrenamiento o en el comportamiento del modelo». Una vez que los datos han entrado en un proceso de entrenamiento, su eliminación se convierte «no solo en una cuestión de gobernanza o privacidad utilizable, sino también técnica».
El momento del consentimiento está desalineado. Como indica el artículo, «la notificación y el consentimiento únicos durante la incorporación encajan mal con sistemas en los que las revelaciones más sensibles suelen producirse después, cuando ya se han formado confianza y apego». Los sistemas de contexto corto acumulan menos información, por lo que el coste de ese desajuste es menor.
La aplicación de la normativa es real. La autoridad italiana de protección de datos multó a Replika por infracciones de privacidad, incluidos fallos relacionados con la verificación de edad, una señal concreta de que la gobernanza de datos de los compañeros de IA ya es un ámbito regulado.
Las pruebas independientes coinciden con el consejo práctico: las grandes plataformas siguen prácticas de cifrado estándar, pero «las Apps más pequeñas centradas en NSFW, como CrushOn AI y SpicyChat, tienen políticas de datos menos transparentes». La postura de Jenova al respecto se expone en sus políticas: los datos no se usan para entrenar modelos públicos de IA, se cifran en tránsito y en reposo, y no se venden ni se comparten con anunciantes.
Mitigación práctica: antes de tu tercera sesión en cualquier plataforma con mucha memoria, localiza la vía de eliminación y pruébala con una conversación desechable. Si no puedes verificar que la eliminación funciona, considera que cada revelación es permanente.
¿Qué dicen investigadores y profesionales sobre el diseño de la memoria?
El consenso entre los profesionales es que la calidad de la memoria es un problema de organización, no de almacenamiento, una opinión respaldada ahora por evidencia de benchmarks.
«La industria confundió la recuperación con la memoria, y los usuarios percibieron la diferencia de inmediato. Puedes ofrecer a un modelo una búsqueda semántica perfecta sobre cada mensaje que un usuario haya enviado y aun así producir un compañero que parezca amnésico, porque la recuperación responde preguntas; no aporta contexto por iniciativa propia. Lo que hace que un compañero parezca conocerte es la relevancia no solicitada: mencionar aquello que no preguntaste. Eso exige que el sistema haya decidido, en el momento de escribir, que un detalle merecía conservarse y mostrarse más adelante».
«La segunda cuestión que infravaloramos de forma constante es la corrección de memoria. Los sistemas persistentes no solo conservan hechos: también conservan inferencias, y las inferencias son donde residen los errores. Un compañero que decide en la segunda semana que estás preocupado por tu trabajo seguirá tratándote como si estuvieras preocupado por tu trabajo en el cuarto mes, mucho después de que la situación se haya resuelto. Toda arquitectura de memoria seria necesita una superficie de edición orientada al usuario, no solo un botón de eliminar. La mayoría de las plataformas implementaron almacenamiento y omitieron la corrección».
«La concesión que nadie comercializa honestamente es que la memoria eleva lo que está en juego con cada revelación. Los compañeros de contexto corto son realmente más seguros para ciertos casos de uso: desahogarse, procesar algo que no quieres que quede registrado o ensayar una conversación difícil. Existe una categoría de producto legítima en el olvido deliberado, y ahora mismo todo el mercado corre en la dirección opuesta».
— Equipo de Producto de Jenova, 7 años desarrollando infraestructura de agentes con memoria persistente
El trabajo académico respalda la visión de que la organización es más importante que el almacenamiento. El benchmark StructMemEval descubrió que los agentes con memoria «pueden resolver de forma fiable» tareas de memoria estructurada cuando se les indica cómo organizarla, pero que «los LLM modernos no siempre reconocen la estructura de memoria cuando no se les pide hacerlo», evidencia de que la decisión tomada al escribir, y no la búsqueda al leer, es donde se determina la calidad de la memoria.
¿Qué arquitectura deberías elegir para tu situación?
Haz coincidir la arquitectura con el patrón de interacción, no con la categoría de marketing. A continuación se muestran perfiles concretos.
🎭 Quieres variedad de personajes y roleplay creativo → el contexto corto es suficiente. Los mensajes gratuitos ilimitados y la gran biblioteca de Character.AI se adaptan al uso exploratorio, donde de todos modos alternas entre personajes. La memoria aporta poco cuando no profundizas en un mismo hilo.
💬 Quieres revisiones emocionales diarias → la memoria persistente es esencial, y el seguimiento del estado de ánimo y la progresión de la relación de Replika están diseñados específicamente para ello, por 19,99 $/mes. Lee primero los hallazgos de Stanford si lo utilizas como canal social principal y no como complemento.
🧩 Quieres la máxima precisión de recuerdo durante meses → Nomi AI, según la evidencia de las pruebas actuales. Acepta la biblioteca de personajes más pequeña y el plan gratuito restrictivo como coste.
✍️ Quieres crear el personaje con precisión → el sistema de trasfondo de Kindroid ofrece el control más directo sobre la capa de libros de trasfondo.
🔀 Quieres compañía y trabajo real en un mismo lugar → una plataforma de agentes generalista encaja mejor. La memoria persistente de Jenova abarca tanto agentes de compañía como agentes de tareas, con cambio de modelo entre OpenAI, Anthropic, Google, DeepSeek y xAI, y paridad total entre web, iOS y Android. No ofrece paneles de estado de ánimo ni mecánicas de relación.
🔐 Te preocupa la privacidad → elige deliberadamente contexto corto o utiliza una plataforma persistente con eliminación verificada. La investigación sobre el ciclo de vida es inequívoca: la salida es el eslabón más débil en toda la categoría.
Una nota sobre el realismo de los costes: el evaluador independiente que gastó aproximadamente 730 $ en más de 25 plataformas durante ocho meses concluyó que los planes gratuitos de Character.AI y Pi AI son «realmente suficientes» para chats ocasionales, y que «el mayor salto de calidad entre gratis y pago está en la memoria y la libertad de contenido». Si la memoria no es tu cuello de botella, probablemente no necesites pagar.
Referencias
- arXiv — Seguimiento de las preocupaciones de privacidad de los usuarios a lo largo del ciclo de vida de un compañero de IA romántico
- AI Companion Guides — Las 12 mejores Apps de compañeros de IA en 2026, clasificadas tras más de 2.000 horas de pruebas
- arXiv — Evaluación de la estructura de memoria en agentes LLM (StructMemEval)
- Stanford HAI — Los compañeros de IA pueden empeorar la soledad de los usuarios vulnerables, según un estudio de Stanford
- ScienceDirect — Compañeros de IA y bienestar subjetivo: moderación según el contexto social
- UX Tigers — Los compañeros de IA reducen la soledad
- Sony AI — Estudio de los riesgos y beneficios de los compañeros de IA
- Character.AI — Plataforma oficial
- Replika — Plataforma oficial
- Nomi AI — Plataforma oficial
- Kindroid — Plataforma oficial