Chat de AI con memoria vectorial: recuerdo semántico persistente para agentes
2026-09-15
Jenova te ofrece chat de AI con memoria vectorial: conversaciones que recuerdan el significado, no solo los últimos mensajes. En septiembre de 2026, la mayoría de los asistentes todavía olvidan preferencias, pierden el contexto de los proyectos y te obligan a explicar de nuevo los mismos archivos. Esta plataforma almacena diálogos, documentos y preferencias para que los agentes especializados recuperen el contexto adecuado cuando lo necesitas.
✅ Memoria persistente entre sesiones, no una ventana deslizante que se borra sola
✅ Recuperación semántica, no por palabras clave: encuentra lo que querías decir, no lo que escribiste
✅ Bases de conocimiento que adjuntas una vez y reutilizas en investigación, código y redacción
✅ El mismo modelo de memoria en web, iOS y Android
El chat sin estado es barato de ejecutar y caro de usar. Para entender por qué la memoria vectorial está ahora en el centro del chat de AI útil, conviene observar cómo fallan realmente los embeddings, la recuperación y el contexto a largo plazo en el trabajo diario.
Respuesta rápida: ¿qué es el chat de AI con memoria vectorial?
El chat de AI con memoria vectorial es un sistema de recuperación que almacena el significado de las conversaciones como embeddings para que una AI pueda recordar contexto relevante, documentos y preferencias entre sesiones. Es la diferencia entre un chatbot que reinicia cada hilo y un agente que continúa el trabajo.
Capacidades clave:
- Convertir mensajes, archivos y datos en vectores para búsquedas por similitud
- Incorporar únicamente los recuerdos más relevantes a la ventana de contexto del modelo
- Mantener un historial de chat ilimitado y preferencias entre sesiones en una sola plataforma
- Fundamentar las respuestas en bases de conocimiento adjuntas en lugar de suposiciones paramétricas
- Llevar la misma memoria de una sesión de escritorio al teléfono sin tener que volver a poner al día al agente
Por qué la mayoría de los chats de AI aún olvidan
Los modelos de lenguaje grandes son buenos razonadores y malos archivistas. Sus pesos contienen conocimiento general; no contienen tu lista de tareas pendientes, tu esquema ni tu última decisión. La generación aumentada por recuperación existe precisamente porque la memoria paramétrica es inconsistente y difícil de actualizar para un dominio privado, un aspecto sintetizado en una encuesta de 2025 sobre arquitecturas RAG.
La demanda del sector por esa capa de recuperación ya no es experimental:
USD 2,652.1 millones → USD 8,945.7 millones — Mercado mundial proyectado de bases de datos vectoriales entre 2025 y 2030, con una CAGR del 27.5%
Ese gasto es un síntoma. Los equipos están comprando infraestructura vectorial porque el chat sin memoria sigue fallando de las mismas formas:
- Las ventanas de contexto se desbordan, por lo que las decisiones anteriores desaparecen a mitad del proyecto
- La búsqueda por palabras clave no detecta paráfrasis, sinónimos ni intención implícita
- Las pilas RAG hechas por cuenta propia —segmentación, índices, evaluación y autenticación— se estancan antes de llegar a producción
- La personalización queda atrapada en el historial de chat de un único proveedor
- Las respuestas se desvían cuando el modelo no puede fundamentarse en tus archivos
Pero incorporar memoria duradera, privada y semánticamente consultable al chat diario sigue siendo frustrantemente difícil:
Las ventanas de contexto no son memoria
Una ventana de contexto es un búfer, no un archivo. El historial de la conversación, una pregunta del usuario y unos pocos «datos guardados» se concatenan en un prompt; todo lo que no cabe se descarta. Por eso un agente de programación olvida el error que pegaste ayer y un tutor vuelve a preguntarte tu puntuación objetivo. La memoria vectorial está fuera de la ventana: recupera una pequeña porción relevante durante la inferencia, en vez de esperar que la transcripción completa siga cabiendo.
La búsqueda por palabras clave no puede representar el significado
La búsqueda clásica premia los tokens exactos. La búsqueda vectorial compara embeddings —representaciones numéricas de alta dimensionalidad del significado— mediante métricas como la similitud coseno o la distancia euclídea. Los embeddings junto con un índice vectorial son la capa de recuperación que hace posibles las aplicaciones LLM modernas. Sin esa capa, «plan de contratación del T3» no recuperará la nota titulada «plantilla para el otoño».
Un RAG casero es un proyecto de infraestructura
Una canalización de recuperación para producción necesita una estrategia de segmentación, selección de embeddings, un índice ANN, filtros de metadatos, evaluación y tareas de actualización. Los benchmarks publicados de ANN muestran por qué los equipos se preocupan por ello: los motores se comparan simultáneamente en latencia, rendimiento y precisión, porque la velocidad sin capacidad de recuperación es otro producto. La mayoría de las personas que solo quieren un chat que recuerde no deberían tener que operar esa pila.
La personalización sin memoria portátil es frágil
El Digital Economy Lab de Stanford sostiene que la ventaja duradera en AI provendrá de un contexto personal persistente y gobernado por el usuario, no de otro chatbot aislado. Hoy, la memoria suele ser una función del proveedor: no viaja contigo y puede moldear silenciosamente la información que recibes. Un reportaje de Columbia Journalism Review sobre la memoria de los chatbots señala que recordar al usuario puede cambiar la información que recibe.
Para eso se creó Jenova.
La solución de Jenova
Jenova trata el chat de AI con memoria vectorial como una función predeterminada, no como un complemento que configuras más tarde. El historial de chat ilimitado, la memoria persistente entre sesiones y las bases de conocimiento adjuntables sustentan cada agente especializado. Hablas en lenguaje natural; la plataforma recupera los embeddings, herramientas y archivos adecuados antes de que el modelo responda.
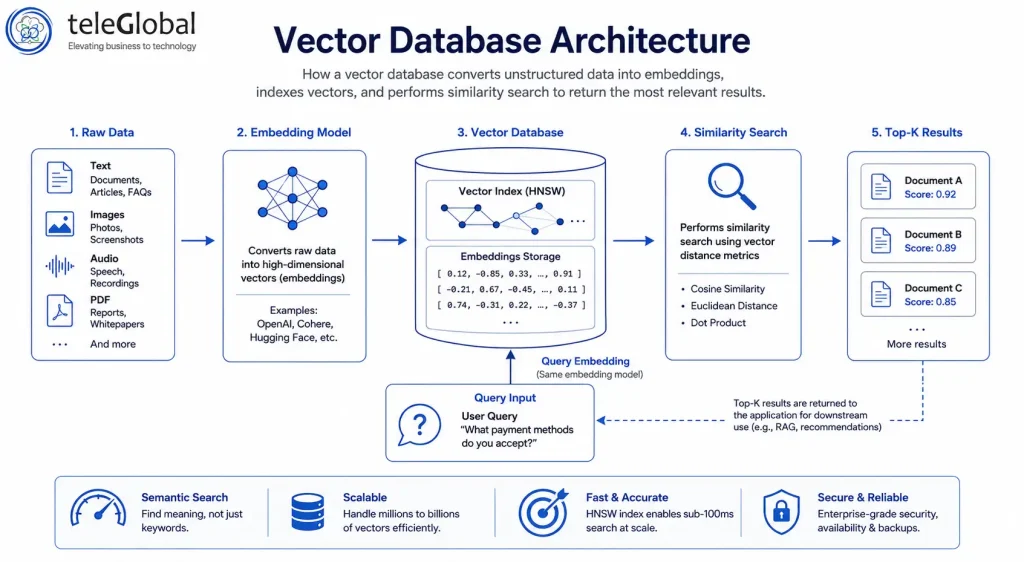
El diagrama anterior muestra la mecánica detrás de esa experiencia: texto, imágenes y documentos no estructurados se convierten en embeddings, entran en un índice vectorial y regresan como coincidencias top-k para una consulta. Nunca configuras parámetros HNSW ni eliges una métrica de distancia. Solo inicias un hilo.
| Enfoque tradicional | Jenova |
|---|---|
| Pegar las mismas instrucciones en cada chat nuevo | Memoria persistente entre sesiones y agentes |
| Búsqueda por palabras clave en notas y PDFs | Recuperación semántica mediante embeddings |
| Alojar por cuenta propia una base de datos vectorial, un generador de embeddings y una evaluación RAG | Almacenamiento y recuperación totalmente gestionados |
| Un proveedor de modelos, un silo de memoria | Acceso a múltiples modelos con contexto compartido |
| Historial solo de escritorio que desaparece en móvil | Paridad total en web, iOS y Android |
Investigación que se acumula en lugar de reiniciarse
Las revisiones bibliográficas y los análisis de mercado fallan cuando el asistente no puede recordar los artículos que ya descartaste. Real-Time Search obtiene resultados en vivo de Google, Reddit, YouTube, GitHub y más, mientras que la memoria vectorial mantiene activos tus criterios de inclusión, citas anteriores y reglas de «no usar esta fuente». No empiezas una nueva consulta booleana cada mañana; continúas una investigación respaldada por recuperación.
Bases de código que el agente realmente conoce
Python Coding Assistant resulta útil el primer día para un script. Se vuelve duradero el día doce, cuando todavía conoce la estructura de tu empaquetado, la prueba inestable que decidiste omitir y el contrato de API que congelaste la semana pasada. Adjunta las notas del repositorio o un documento de diseño una vez. Las solicitudes posteriores recuperan ese contexto en lugar de inventar una arquitectura paralela.
Redacción que conserva tu voz y tus datos
Los borradores fracasan en el chat sin estado porque el tono, las frases prohibidas y los URLs de referencia se salen de la ventana. Un agente enfocado en redacción en la plataforma puede almacenar tus muestras de estilo y decisiones de esquema como memoria, y recuperarlas cuando dices «la misma voz que la publicación de lanzamiento». Combinado con documentos adjuntos, eso es memoria vectorial que ofrece continuidad editorial, no un prompt más largo.
Vida y aprendizaje que no deberían reiniciarse
El acompañamiento y la práctica de idiomas solo funcionan si el agente recuerda las restricciones: lesiones, fechas de exámenes y vocabulario que ya dominas. La memoria persistente convierte un tutor genérico en uno que deja de repetir los ejercicios de la primera semana. El mismo almacén que recupera una traza de Python puede recuperar el hecho de que aprendes mejor con juegos de rol que con tablas de gramática.
Prueba la plataforma gratis; no requiere tarjeta de crédito.
Agentes de AI especializados para chat de AI con memoria vectorial
La memoria solo es útil en función del flujo de trabajo al que sirve. Estos agentes están diseñados para tareas en las que olvidar resulta caro: arcos de investigación extensos, logística recurrente, práctica inmersiva y juego coherente con los personajes.
Deep Research
La investigación de varias horas es el caso de uso clásico del chat de AI con memoria vectorial. Este agente busca en cientos de fuentes, sintetiza hallazgos con citas integradas y entrega informes que puedes continuar mañana sin volver a delimitar la pregunta.
- Almacena la pregunta de investigación, las fuentes excluidas y la tesis de trabajo
- Recupera hallazgos anteriores para que las secciones posteriores no contradigan las anteriores
- Fundamenta las afirmaciones en material citado en lugar de depender solo de la memoria del modelo
Academic Research Assistant
Los flujos de trabajo de doctorado y profesorado abarcan meses de bibliografía, estilos de cita y versiones de manuscritos. El asistente descubre artículos en las principales bases de datos y ayuda con la preparación de manuscritos, mientras la memoria mantiene intactos tu revista objetivo, metodología y conjunto de lecturas ya revisadas.
- Descubrimiento bibliográfico en tiempo real en repositorios académicos
- Asistencia con citas y manuscritos vinculada a tu borrador en curso
- Continuidad entre artículos relacionados, no respuestas de chat aisladas
Personal Secretary
La logística es un problema de memoria: proveedores recurrentes, preferencias de viaje y quién recibe la actualización del viernes. Este agente coordina calendario, correo electrónico y operaciones diarias con un contexto personal profundo para que no tengas que volver a enseñar tu rutina cada lunes.
- Recuerda preferencias establecidas y las personas con las que trabajas
- Conecta la planificación con las herramientas que ya utilizas
- Lleva el contexto de una sesión informativa matinal al seguimiento de la tarde
Roleplay Game Master
La consistencia narrativa es imposible sin memoria a largo plazo. Este agente está diseñado para juegos de rol inmersivos con memoria ilimitada y personajes estables: las promesas argumentales, los nombres de facciones y el tono no se reinician cuando la ventana de contexto se habría desbordado.
- Memoria ilimitada para el estado de la historia y la voz de los personajes
- Recuperación de escenas anteriores cuando un capítulo posterior las necesita
- Amplitud creativa sin perder continuidad
Learn Russian Through Roleplay
La adquisición de idiomas depende de un contexto personal y espaciado: palabras que no recordaste, nivel de formalidad e historias que ya viviste. Este mentor utiliza escenarios ilimitados y memoria ilimitada para que la práctica se acumule en lugar de repetir guiones para principiantes.
- Recuerda tus lagunas de vocabulario y tus tipos de escenario preferidos
- Mantiene coherentes los personajes y el entorno entre sesiones
- Convierte cada conversación en una práctica respaldada por recuperación
Cómo funciona el chat de AI con memoria vectorial
No tienes que desplegar una base de datos vectorial. Inicias una conversación; la plataforma se encarga de los embeddings, la recuperación y la ventana de contexto.
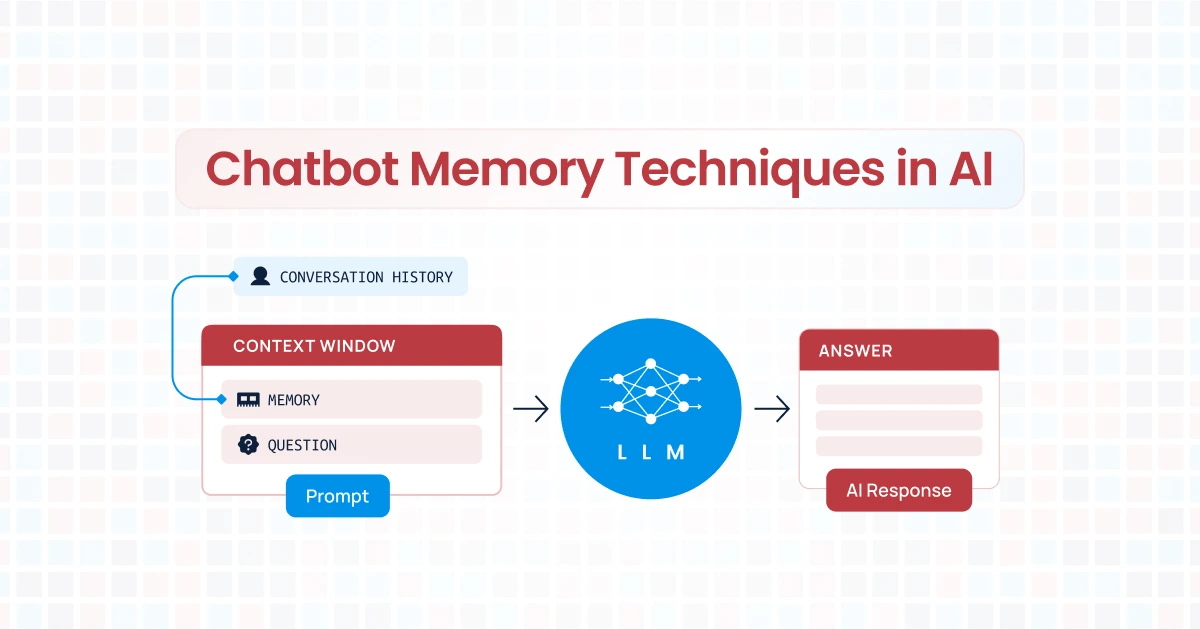
Ese segundo diagrama muestra el ciclo visible para el usuario. El historial, la memoria almacenada y la nueva pregunta se integran en un prompt; el modelo responde. La recuperación vectorial decide qué recuerdos pertenecen a ese prompt para que la ventana se mantenga enfocada.
Paso 1: Abre un Agente y define el resultado Elige el especialista para el trabajo —investigación, código, viajes o tutoría— y explica cómo es el resultado terminado. El primer mensaje se convierte en un embedding como todos los que vienen después.
«Estoy escribiendo una revisión sistemática sobre generación aumentada por recuperación. Prefiero encuestas de 2024 en adelante, excluye blogs de proveedores y mantén el estilo de citas IEEE.»
Paso 2: Adjunta el conocimiento en el que debe confiar el modelo Sube instrucciones, PDFs, notas o especificaciones. Esos documentos se indexan para búsqueda semántica, de modo que las preguntas posteriores recuperan pasajes por significado. Es el mismo patrón que las empresas financian actualmente como infraestructura RAG, sin que tú tengas que operar el índice.
«Usa la matriz bibliográfica adjunta. Si un artículo está marcado como rechazado, no lo cites de nuevo.»
Paso 3: Sigue trabajando entre sesiones Cierra el portátil. Al día siguiente, haz una pregunta de seguimiento. La memoria persistente y el historial ilimitado permiten que el agente recupere el alcance de la revisión, la lista de rechazos y el último encabezado del esquema, en lugar de saludarte como a un desconocido.
«Continúa desde la sección de limitaciones y recupera los tres artículos que marcamos para la discusión.»
Paso 4: Cambia de dispositivo sin volver a explicarlo todo Abre el mismo hilo en iOS o Android. La configuración y el historial se sincronizan. Una solicitud durante el trayecto puede recuperar los mismos vectores que la sesión de escritorio, que es precisamente para lo que sirve el chat de AI con memoria vectorial: continuidad, no un nuevo silo de chat por dispositivo.
«Voy de camino al campus: hazme preguntas sobre los tres modos de fallo de RAG que enumeramos ayer.»
Resultados y casos de uso
La memoria vectorial se manifiesta como horas que no hay que repetir, no como un gráfico de benchmarks. Estos escenarios son típicos de lo que cambia cuando el chat recupera significado.
📊 Síntesis bibliográfica de varias semanas
Escenario: Un estudiante de posgrado necesita un panorama con citas de artículos sobre la robustez de RAG, actualizado cada pocos días a medida que aparecen nuevas prepublicaciones.
Enfoque tradicional: Una carpeta de PDFs, una hoja de cálculo con notas y un chatbot que olvida la lista de exclusión. Volver a pegar las instrucciones en cada sesión. Es fácil citar dos veces una fuente o pasar por alto una contradicción.
Deep Research: La pregunta, las exclusiones y el esquema de trabajo persisten. Las nuevas ejecuciones recuperan la síntesis anterior, de modo que el informe crece en lugar de bifurcarse.
- Las citas se mantienen alineadas con las secciones anteriores
- Las fuentes rechazadas siguen rechazadas
- Los seguimientos cuestan menos que la búsqueda inicial
💼 Un servicio Python que abarca varios sprints
Escenario: Estás creando un servicio FastAPI con una especificación OpenAPI congelada, una prueba inestable conocida y una restricción de despliegue en Python 3.11.
Enfoque tradicional: Cada chat nuevo inventa una estructura de carpetas distinta. Pasas los primeros diez minutos explicando de nuevo decisiones que el modelo no puede ver.
Python Coding Assistant: Las notas de arquitectura y la especificación viven en la memoria y los adjuntos. Un informe de error del jueves recupera la lista de restricciones del miércoles.
- Menos refactorizaciones contradictorias
- La depuración parte de la pila real
- Incorporar a tu yo futuro —o a un compañero que lea el hilo— es más rápido
🎭 Una campaña que no debe contradecirse
Escenario: Una partida semanal con NPCs con nombre, un secreto que el grupo aún no ha descubierto y un tono que ya definiste en la primera sesión.
Enfoque tradicional: Notas de sesión en otra App; el chatbot introduce a la fuerza un nuevo villano porque no puede recuperar la promesa anterior.
Roleplay Game Master: El estado de la historia es memoria. Cuando un jugador menciona un detalle casual de hace tres sesiones, la recuperación puede traerlo de vuelta a la escena.
- La voz de los personajes se mantiene estable
- Las promesas argumentales siguen siendo consultables
- Los arcos largos se mantienen coherentes
📱 Planificación de viaje desde la fila del aeropuerto
Escenario: Planificaste un viaje de tres ciudades desde el escritorio: límite de presupuesto, días centrados en caminar y sin vuelos nocturnos. En la puerta de embarque necesitas una reformulación de mañana únicamente, adaptada al clima.
Enfoque tradicional: Haces una captura de tus propias notas. Esperas que el chatbot móvil deduzca restricciones que nunca ha visto.
Travel Planning Advisor: Las preferencias y el itinerario ya están en la memoria. Una solicitud desde el teléfono los recupera y modifica un día sin reconstruir el viaje.
- Las restricciones sobreviven al cambio de dispositivo
- Los seguimientos locales se mantienen dentro del presupuesto
- No vuelves a escribir las instrucciones en la pasarela de embarque
Al examinar el uso real aparece el mismo patrón por el que los compradores empresariales de bases de datos vectoriales están pagando: recuperación semántica de baja latencia ante preguntas en vivo, no una caja de chat más grande.
Preguntas frecuentes
¿Qué es el chat de AI con memoria vectorial?
El chat de AI con memoria vectorial almacena mensajes, archivos y datos como embeddings y después recupera las coincidencias más próximas cuando haces una pregunta. Esas coincidencias se insertan en la ventana de contexto del modelo para que la respuesta pueda utilizar tu historial y documentos. En Jenova, esa recuperación está integrada en agentes especializados, en lugar de ofrecerse como una base de datos independiente que debas mantener.
¿Jenova es gratis para usar chat de AI con memoria vectorial?
Sí. Un nivel gratuito incluye funciones principales con uso mensual limitado. Los niveles de pago aumentan el margen de uso y añaden opciones como la selección de modelos personalizados. El uso se restablece en la fecha de facturación, con la asignación completa disponible desde el primer día en lugar de una pequeña cuota diaria.
¿En qué se diferencia de un chatbot que «guarda recuerdos»?
Muchos productos almacenan una lista corta de datos o una transcripción continua. La memoria vectorial recupera por similitud semántica en un historial ilimitado y conocimiento adjunto, lo que se parece más a RAG que a una nota adhesiva. El trabajo independiente sobre memoria a largo plazo para agentes en producción trata la memoria escalable como un problema de sistemas propio, no como un interruptor de configuración. OpenAI también ha ampliado la capacidad de ChatGPT para hacer referencia al contexto de chats anteriores; la cuestión arquitectónica es si la memoria es un silo del proveedor o infraestructura bajo cada flujo de trabajo que ejecutas.
¿Puedo fundamentar el chat en mis propios documentos?
Sí. Adjunta los archivos que deben prevalecer sobre los conocimientos previos del modelo: especificaciones, programas de estudio, transcripciones y guías de marca. La recuperación prioriza ese corpus cuando haces preguntas relacionadas, que es la forma de reducir las alucinaciones sobre material privado. Un Writing Assistant puede seguir usando esas muestras para el tono; un agente de investigación puede seguir utilizándolas para las afirmaciones.
¿El chat de AI con memoria vectorial funciona en móvil?
Sí. La web, iOS y Android comparten historial, configuración y memoria. El dictado por voz está disponible cuando no puedes escribir. El escenario de viaje anterior es el diseño previsto: recuperar desde un teléfono los mismos vectores que creaste en un escritorio.
¿Un agente con memoria es lo bastante preciso para temas delicados?
La memoria mejora la consistencia; no hace infalible a un modelo. Las encuestas sobre RAG aún señalan la calidad de la recuperación, el contexto ruidoso y la fidelidad como problemas abiertos (Sharma, 2025). Para decisiones de salud, legales o financieras, considera al agente como apoyo y verifica las fuentes primarias. Un Personal Therapist puede recordar los temas que le pediste que mantuviera presentes, algo útil para la continuidad, pero no sustituye la atención profesional acreditada.
La memoria vectorial es la interfaz de chat que por fin acumula valor
El chat de AI sin estado desperdicia el único recurso escaso que tienes: el tiempo dedicado a explicarte. El chat de AI con memoria vectorial almacena significado como embeddings, lo recupera bajo demanda y permite que los agentes especializados continúen el trabajo. El mercado de esa capa de recuperación está creciendo porque el problema es universal: desde la búsqueda semántica en sistemas de producción hasta el contexto personal que debería pertenecer al usuario.
Jenova integra esa memoria en investigación, código, narrativa y planificación sin pedirte que operes una base de datos vectorial. Continúa un informe de Deep Research, un servicio de Python o una campaña de juego de rol como si el agente hubiera estado en la sala todo el tiempo.
Explora la biblioteca completa de agentes en Jenova.
Para desarrolladores: Todos los agentes de este artículo están disponibles programáticamente mediante la Jenova API: integra memoria vectorial, recuperación y agentes multimodelo en tu aplicación con una sola integración. Documentación completa →