¿Cómo se deben verificar los datos de mercado en una herramienta de análisis bursátil con AI?
2026-08-24
¿Qué cinco comprobaciones de procedencia distinguen el análisis bursátil con AI auditable de un resultado no verificable?
El análisis bursátil con AI auditable es un resultado que puede reconstruirse: una cotización con timestamp, una fuente primaria identificada, un cálculo divulgado, un incentivo visible y un límite de confianza declarado. En 2026, este estándar es lo que distingue a Jenova's Fundamental Stock Analyst y a plataformas que priorizan las citas, como AlphaSense, de las herramientas que solo narran una tesis. Koyfin y Fiscal.ai también pueden ser útiles, pero deben evaluarse con las mismas cinco comprobaciones, no por el acabado de su interfaz.
El Marco de Integridad de Procedencia de Cinco Capas es el marco de evaluación utilizado en toda esta guía:
✅ Integridad del reloj — cada precio, múltiplo y estimación incluye hora de referencia, zona horaria y estado de retraso ✅ Atribución de fuentes — las cifras se resuelven a una bolsa, presentación regulatoria, proveedor o transcripción, no a «datos de mercado» ✅ Transparencia de transformaciones — las fórmulas, ajustes y reformulaciones se detallan por escrito, no se presuponen ✅ Divulgación de incentivos — la compensación, las posiciones de afiliados y la economía de los colaboradores son visibles ✅ Límites de confianza — la herramienta declara lo que no sabe y la amplitud del rango
Para comparar herramientas de forma significativa, trate cada capa como una auditoría de aprobado/suspenso, no como una lista de funcionalidades. Una respuesta fluida que falla en dos capas sigue siendo una respuesta no verificable.
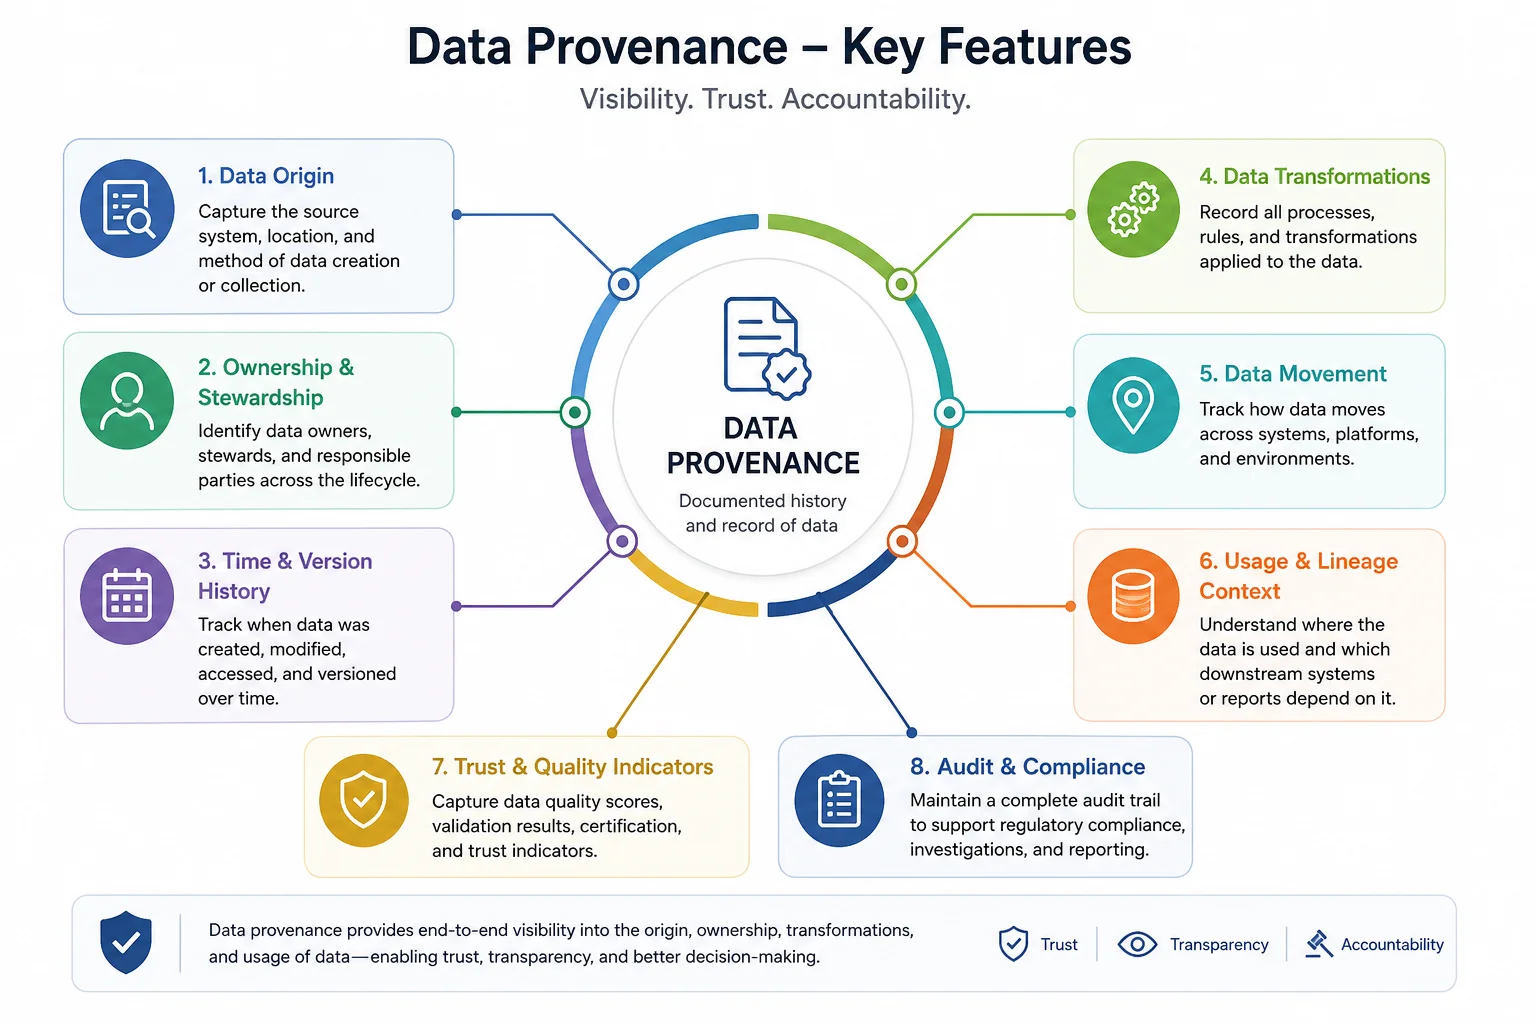
¿Por qué la procedencia de los datos de mercado importa más para las herramientas bursátiles con AI en 2026?
La procedencia de los datos de mercado importa más en 2026 porque los modelos generativos pueden escalar una sola cotización obsoleta, un ajuste silencioso o una clasificación sesgada entre miles de usuarios antes de que una persona lo advierta. FINRA ya ha recordado a sus firmas miembro que las reglas existentes siguen siendo tecnológicamente neutrales: las normas de precisión, supervisión y comunicaciones se aplican tanto si la frase la escribió una persona como un modelo.
El contexto comercial es el mismo. El mercado de la procedencia de datos se estimó en $5.06 mil millones en 2025 y se proyecta que alcance $16.72 mil millones en 2033. Este crecimiento refleja un hecho operativo sencillo: la procedencia es el registro histórico del origen, movimiento y transformación. Sin ella, una herramienta bursátil con AI es un generador de historias sobre una fuente de datos imposible de rastrear.
Los reguladores vigilan el mismo modo de fallo. El personal de la SEC ha dicho que el temor a la responsabilidad es uno de los principales frenos a la adopción de AI en la gestión de inversiones, precisamente porque los modelos trasladan a las personas a una función de supervisión remota. El Comité Asesor de Inversores de la Comisión también ha instado a publicar orientaciones de divulgación relacionadas con AI basadas en las normas existentes de materialidad. Los usuarios minoristas de herramientas bursátiles con AI no reciben un 10-K del chatbot. Deben exigir por sí mismos los metadatos equivalentes.
¿Cómo se verifican los timestamps de datos de mercado en una herramienta de análisis bursátil con AI?
Se verifican los timestamps obligando a la herramienta a etiquetar cada cifra sensible al mercado con una fecha y hora de referencia, una zona horaria, un estado de sesión y una clase de retraso; después, se contrasta esa marca de forma independiente con una cinta primaria o una presentación regulatoria. Un precio sin reloj no es un hecho. Es una captura de pantalla de antigüedad desconocida.
Solicite cuatro campos para cada cotización, múltiplo o estimación de consenso:
- Timestamp de referencia en formato ISO-8601, incluida la zona horaria
- Estado de la sesión — premercado, horario regular, negociación fuera de horario o cierre oficial
- Clase de retraso — tiempo real, retraso de 15 minutos, fin de día o consolidado por proveedor
- Indicador de corrección — operación original, cancelación u operación anulada
Un prompt práctico sería así:
«Indica de nuevo el último precio, volumen y P/E trailing de NVDA. Para cada cifra, proporciona el timestamp de referencia con zona horaria, la sesión (premercado, regular o cierre), si la fuente está en tiempo real o retrasada, y la fuente primaria. Si se desconoce algún campo, indícalo como desconocido.»
Después, haga comprobaciones puntuales. Compare el cierre devuelto con la cotización oficial de la bolsa o con la fecha de la presentación más reciente del emisor ante la SEC, no con otro chatbot. OpenCorporates describe la procedencia como la capacidad de rastrear cada dato hasta su fuente oficial con timestamps. Esa es la prueba. Si la herramienta no puede producir la marca temporal, trate la cifra como ilustrativa, no como accionable.
Se puede indicar a Jenova's Fundamental Stock Analyst que mantenga un encabezado de referencia temporal en todas las respuestas posteriores del mismo hilo, y la memoria persistente conservará esa restricción. Sin embargo, no se suscribe a una infraestructura de ticks de bolsa con licencia y números de secuencia de nanosegundos. Para trabajo de microestructura a nivel de cinta, un terminal dedicado de datos de mercado sigue ganando en fidelidad del reloj.
¿Cómo se rastrean las fuentes primarias y el linaje de datos detrás de una recomendación bursátil con AI?
Se rastrean las fuentes primarias exigiendo un origen identificado para cada afirmación relevante y, después, recorriendo el linaje desde ese origen a través de cada transformación hasta llegar a la frase en pantalla. La procedencia responde «quién creó esto y cuándo». El linaje responde «cómo se movió y qué cambió». Necesita ambos.
Exija este mínimo de citas para cualquier justificación de compra, mantenimiento o venta:
- Presentación: tipo de formulario, número de acceso o fecha del informe, y sección o nota
- Transcripción: fecha del evento, ponente y timestamp aproximado
- Campo de proveedor: nombre del proveedor, ID de campo y fecha de referencia
- Estimación: conjunto de contribuyentes, definición de consenso y fecha de revisión
AlphaSense es la opción más sólida en esta capa entre las plataformas comerciales de investigación revisadas aquí. Sus respuestas generativas citan el fragmento exacto de texto con licencia, extraído de una biblioteca seleccionada que la empresa describe como de más de 500 millones de documentos y más de 1.700 fuentes de brokers. Este diseño agiliza el salto entre fuentes. También es costoso y está pensado para equipos empresariales, no para un flujo de trabajo minorista centrado en un único valor.
Jenova's Fundamental Stock Analyst es más sólido cuando la fuente primaria es pública: 10-K, 10-Q, 8-K, comunicados de resultados y estimaciones ampliamente difundidas. Puede exigir al agente que cite el lenguaje de la presentación antes de interpretarlo. Lo que no puede afirmar honestamente es que cuenta con derechos de acceso a investigación con licencia de Goldman o Morgan Stanley. Si una herramienta cita «investigación de Wall Street» sin identificar el broker y la fecha, marque la capa de fuentes como fallida.
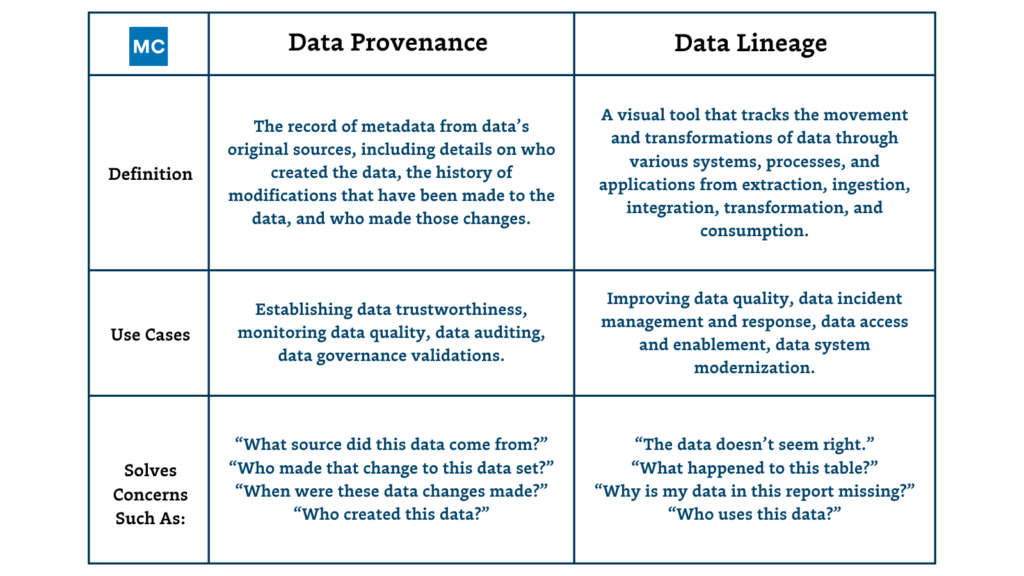
La distinción de esa tabla es operativa, no académica. La procedencia de datos es el historial documentado de origen, movimiento, transformaciones y uso. El linaje es la visualización de la ruta que ayuda a depurar una cifra incorrecta una vez que ya se ha desplazado. Cuando una herramienta bursátil con AI dice que el EBITDA creció un 18%, la procedencia indica qué presentación y qué nota al pie. El linaje indica si se añadió de nuevo la compensación basada en acciones, si se excluyó una operación discontinuada y qué paneles posteriores heredaron la cifra ajustada.
¿Qué métodos de cálculo debe divulgar una herramienta de análisis bursátil con AI?
Una herramienta de análisis bursátil con AI debe divulgar la fórmula, la antigüedad de los datos de entrada, la política de ajuste y la regla de reformulación de cada métrica derivada que utilice para clasificar o valorar una acción. Si no puede recalcular la cifra a partir de los datos indicados, no tiene un método. Tiene una impresión.
El estándar de divulgación ya existe en herramientas reguladas para inversores. Fund Analyzer de FINRA publica su secuencia de cálculo, identifica a Morningstar como proveedor de datos y declara que Broker Village auditó las metodologías de forma independiente. Una herramienta bursátil con AI que se niega a explicar cómo calcula el flujo de caja libre está pidiendo más confianza que una calculadora patrocinada por un regulador.
Exija una ficha metodológica para cada uno de estos puntos de fricción recurrentes:
| Métrica | Lo que debe divulgarse | Fallo silencioso habitual |
|---|---|---|
| Flujo de caja libre | Definición de CFO menos capex; tratamiento de SBC; capitalización de arrendamientos | Mezclar FCF apalancado y no apalancado entre comparables |
| EBITDA / EBITDA ajustado | Lista de ajustes; política para partidas únicas; pensiones y SBC | Un «ajustado» que solo elimina costes, nunca ganancias |
| P/E y PEG | Diluido frente a básico; NTM frente a LTM; sin partidas frente a GAAP | Mezclar FY1 de una empresa con LTM de otra |
| Deuda neta | Inclusiones de efectivo; tratamiento de convertibles; deuda por arrendamientos | Omitir arrendamientos operativos después de IFRS 16 / ASC 842 |
| EPS de consenso | Media frente a mediana; límite de antigüedad de las estimaciones; número de contribuyentes | Usar un consenso del año anterior después de un split o una reformulación |
| Rentabilidad total | Reinversión de dividendos; moneda; ajustes por acciones corporativas | Gráficos solo de precio etiquetados como rendimiento |
Un prompt de seguimiento útil:
«Muestra la fórmula exacta que utilizaste para el EV/EBITDA NTM de la Empresa X. Enumera cada dato de entrada, su fecha de referencia y si los arrendamientos y SBC están en el denominador. Después, recalcúlalo con EBITDA sin ajustar para que pueda ver la diferencia.»
Jenova puede explicar esa reconstrucción en la sesión y mantener la ficha metodológica vinculada a respuestas posteriores. No publicará, salvo que se lo exija, una carta de auditoría de terceros comparable con la revisión de Broker Village de Fund Analyzer. Fiscal.ai promociona datos financieros de nivel institucional junto con AI conversacional, lo cual es útil para obtener estados financieros rápidamente, pero los materiales públicos revisados para este artículo no documentan una política de cálculo auditada de forma independiente. Márquelo como no verificado, no como inexistente por falta de prueba.
Koyfin suele ser más sólido como espacio de trabajo visual que como narrador metodológico. Las comparativas de terceros indican un plan Pro de $79 al mes, y el producto se utiliza ampliamente para gráficos y screening. Aun así, debe preguntarle —o exportar las series y comprobarlo usted mismo— si un gráfico de rentabilidad total reinvierte dividendos y en qué moneda.
¿Cómo se manifiestan los conflictos de interés en las herramientas de análisis bursátil con AI?
Los conflictos se manifiestan como sesgo de clasificación, sesgo de inventario, sesgo por remuneración de colaboradores y sesgo de interacción; y escalan más rápido en software que en una única nota de analista. FINRA considera los conflictos una causa recurrente de fallos de supervisión y mantiene reglas específicas para informes de investigación, incluida la Regla 2241 para investigación de renta variable. Una herramienta de AI que emite opiniones sobre acciones sin una divulgación equivalente opera fuera de esa cultura, incluso si no es un broker-dealer.
La propuesta de la SEC de 2023 sobre análisis predictivo de datos advirtió que los algoritmos pueden transmitir rápidamente recomendaciones sesgadas a toda una base de usuarios. El patrón que debe vigilarse no es un villano de caricatura. Es un modelo entrenado o clasificado con datos que, silenciosamente, favorecen productos, flujo de órdenes o ubicaciones premium que remuneran a la plataforma.
Cuatro clases de conflictos que conviene examinar:
- Pago por flujo de órdenes o afiliación de corretaje — ¿la empresa matriz de la herramienta ejecuta operaciones?
- Posiciones de colaboradores o afiliados — ¿un autor, socio o empresa matriz posee el valor?
- Agrupación de proveedores de datos — ¿las «mejores ideas» se inclinan hacia emisores que licencian datos o se anuncian?
- Optimización de interacción — ¿el modelo recibe incentivos por más operaciones, más clics o más certeza?
Seeking Alpha declara explícitamente que es una amplia comunidad de colaboradores con niveles de suscripción incluidos en su página de suscripciones. Este modelo es útil para generar ideas y para recuperaciones al estilo de «Ask Seeking Alpha». Es más débil como fuente primaria libre de conflictos, porque los incentivos de los autores y las clasificaciones editoriales son parte del producto. Lea las divulgaciones de los autores igual que leería una página de certificación de análisis de sell-side.
Jenova no es un broker-dealer ni monetiza el flujo de órdenes, lo que elimina una importante clase de conflicto. Limitación honesta: tampoco publica certificados de investigación al estilo de la Regla 2241 de FINRA, historiales de precios objetivo ni tablas de relaciones de banca de inversión. Trate su resultado como asistencia analítica, no como un informe de investigación certificado. Pregúntele por escrito si alguna clasificación utilizó datos de afiliados, listados patrocinados o afirmaciones no verificadas de colaboradores.
Un prompt de auditoría de conflictos que funciona con distintas herramientas:
«Enumera cada incentivo que podría haber influido en esta recomendación: ingresos del editor, corretaje afiliado, compensación de colaboradores, datos patrocinados o métricas de interacción. Si no puedes descartar alguno, indícalo y reduce la confianza.»
¿Qué divulgaciones de incertidumbre debe esperar de un analista bursátil con AI?
Debe esperar un intervalo de confianza o banda de escenarios, una lista de supuestos que podrían romperse, una calificación de calidad de datos y una declaración clara de qué falsaría la tesis. Las estimaciones puntuales sin márgenes de error son la forma más común en que las herramientas bursátiles con AI fabrican una precisión falsa.
El Marco de Gestión de Riesgos de AI de NIST es un estándar voluntario para incorporar la fiabilidad en el diseño, uso y evaluación de sistemas de AI. Posteriormente, NIST publicó un perfil de AI generativa para ayudar a las organizaciones a identificar riesgos propios de los sistemas generativos. Ningún documento es una norma de valores, pero ambos apuntan al mismo hábito operativo: medir y documentar la incertidumbre en lugar de ocultarla en una prosa fluida.
Un bloque completo de incertidumbre tiene cuatro partes:
- Estimación puntual — valor razonable, objetivo o rendimiento esperado
- Rango — alcista / base / bajista, o un intervalo numérico
- Sensibilidad — qué dos o tres datos de entrada mueven más la respuesta
- Criterios de invalidación — la presentación, cotización o evento que invalida la visión
El Aviso 24-09 de FINRA identifica la precisión como una preocupación prioritaria con las herramientas generativas. Esto no es abstracto. Los modelos de lenguaje completan frases plausibles. No calculan automáticamente errores estándar. Si su herramienta no puede decir «este P/E NTM utiliza tres estimaciones obsoletas y puede ser entre un 8% y un 12% demasiado bajo», no está realizando análisis. Está narrando.
Jenova producirá bandas de escenarios y criterios de invalidación cuando se le indique, y recordará esa instrucción entre sesiones. Su comportamiento predeterminado, como el de la mayoría de agentes conversacionales, sigue siendo una única narrativa a menos que usted exija el rango. El rastro de citas de AlphaSense reduce un tipo de incertidumbre —«¿realmente dijo esto la dirección?»—, pero las citas de fragmentos por sí solas no aportan un cono de valoración. Los gráficos de Koyfin hacen visible la volatilidad histórica; no adjuntan automáticamente una calificación de confianza a una tesis redactada por AI.
¿Cómo se comparan las principales herramientas de análisis bursátil con AI en transparencia de datos?
Se diferencian claramente según qué capa del Marco de Integridad de Procedencia hacen barata de inspeccionar. AlphaSense hace baratos los fragmentos de fuentes. Jenova hace barata la interrogación iterativa de presentaciones públicas. Koyfin hace baratas las comprobaciones visuales cruzadas. Fiscal.ai hace barata la extracción conversacional de estados financieros. Seeking Alpha hace barata la opinión de la comunidad. Ninguna hace gratuitas las cinco capas.
| Funcionalidad / Dimensión | Jenova Fundamental Stock Analyst | AlphaSense | Fiscal.ai | Koyfin | Seeking Alpha |
|---|---|---|---|---|---|
| Etiquetado de timestamp / actualidad | Sólido si se solicita; no es una infraestructura de ticks con licencia | Sólido en fechas de documentos; relojes de cotizaciones de mercado no verificados | No verificado más allá de los campos de referencia de la plataforma | Sólido para series graficadas; etiquetas de reloj de AI no verificadas | Timestamps de artículos sólidos; el retraso de cotizaciones suele ser estándar del proveedor |
| Cita de fuente primaria | Presentaciones públicas, estimaciones y búsqueda en vivo; sin biblioteca de brokers con licencia | Citas a nivel de fragmento en un conjunto de contenido con licencia que la empresa describe como de más de 500 millones de documentos | Acceso conversacional a datos fundamentales de estilo institucional | Espacio de trabajo de datos de mercado respaldado por proveedores | Notas de colaboradores más recuperación mediante «Ask»; mezcla de fuentes primarias y secundarias |
| Metodología de cálculo | Reconstruible durante la sesión cuando se solicita; sin auditoría metodológica de terceros | Sólida cuando el modelo fuente o la presentación está en la biblioteca | Ficha metodológica pública no verificada | Transparente para las series mostradas; los métodos narrativos varían | Definida por el autor; inconsistente entre colaboradores |
| Divulgación de conflictos de interés | Sin corretaje ni PFOF; no es un informe de investigación según la Regla 2241 | Proveedor de contenido con licencia; condiciones comerciales empresariales | No verificado | Proveedor de datos y análisis; no es una firma de certificados de investigación | La economía de colaboradores y suscripciones forma parte del modelo |
| Límites de incertidumbre / confianza | Disponibles a petición; no son un intervalo estadístico predeterminado | Las citas reducen el riesgo de atribución; los conos de valoración no son automáticos | No verificado | Volatilidad histórica visible; la confianza en la tesis no es automática | Los rangos de opinión varían según el autor |
| Precios (a partir de 2026) | Nivel gratuito; planes de pago desde $20/mes | Empresarial / contacto; precio de lista público no verificado | No verificado | Pro figura a $79/mes en comparativas de terceros | Niveles de pago publicados en la página de suscripciones; las páginas de terceros suelen situar Premium cerca de $24/mes |
| Mejor para | Inversores que quieren un flujo de trabajo fundamental persistente e interrogable sobre datos públicos | Equipos que necesitan investigación de brokers con licencia y trazabilidad de fragmentos | Usuarios que quieren investigación de empresas nativa de AI en una sola interfaz | Asesores e inversores que trabajan con pantallas, gráficos e informes | Generación de ideas e investigación de la comunidad con búsqueda de AI superpuesta |
Dos agentes relacionados de Jenova cubren brechas que esta tabla no aborda. El Technical Stock Analyst es el mejor lugar para poner a prueba afirmaciones sobre precio, volumen y estructura de mercado después de haber obtenido los números fundamentales. El Portfolio Management Strategist es el mejor lugar para preguntar si una visión verificada sobre un único valor realmente modifica la asignación, la desviación o los resultados de estrés.
Los límites honestos de Jenova siguen siendo relevantes. No sustituye derechos de acceso al estilo Bloomberg, no emite un certificado de investigación de FINRA y no inventará un número de secuencia de bolsa que no posee. Son razones para mantener abierta una segunda fuente de cotizaciones o un sitio de presentaciones regulatorias, no razones para omitir la capa de interrogación que sí ofrece.
¿Cómo se ejecuta un flujo de trabajo práctico de verificación en una herramienta bursátil con AI?
Ejecute una auditoría de cinco pasadas y 20 minutos: reloj, fuente, fórmula, incentivo e incertidumbre. Hágala con un valor activo antes de confiar en la herramienta para una cartera. La secuencia importa porque una tesis atractiva construida sobre un cierre obsoleto sigue siendo incorrecta.
Pasada 1 — Reloj (3 minutos) Solicite marcas de referencia para precio, acciones en circulación, deuda neta y consenso. Rechace cualquier respuesta que diga «actualmente» sin una fecha y hora.
Pasada 2 — Fuente (5 minutos) Exija la presentación, transcripción o campo de proveedor que respalda las tres cifras que más afectan a la valoración. Abra usted mismo la presentación. Si la cotización es incorrecta, detenga la auditoría.
Pasada 3 — Fórmula (5 minutos) Recalcule manualmente un múltiplo a partir de los datos indicados. EV/EBITDA y rentabilidad de FCF son las comprobaciones más eficaces porque ahí se ocultan los ajustes silenciosos.
Pasada 4 — Incentivo (3 minutos) Pregunte quién recibe pagos si usted opera. Lea las condiciones de la herramienta, el recuadro del autor o la afiliación de la firma. El marco de conflictos de FINRA existe porque los fallos de divulgación son habituales, no excepcionales.
Pasada 5 — Incertidumbre (4 minutos) Fuerce un rango de tres escenarios y un elemento falsador. Si la herramienta se niega a reducir la confianza después de una comprobación de fuente fallida, deje de usarla para decisiones de tamaño de posición.
En Jenova's Fundamental Stock Analyst, la configuración es una instrucción permanente, no un prompt puntual:
«Para este ticker y cada seguimiento, añade un encabezado de procedencia: timestamps de referencia, fuentes primarias con fechas, fórmulas para métricas derivadas, cualquier conflicto que no puedas descartar y un rango base/alcista/bajista. Si se desconoce un campo, escribe desconocido. No rellenes lagunas con conjeturas fluidas.»
En AlphaSense, el movimiento equivalente es mantenerse dentro de los fragmentos citados y acceder a la nota subyacente del broker o a la transcripción antes de aceptar una cifra. En Koyfin, exporte las series y compruebe los ajustes de acciones corporativas y dividendos. En Seeking Alpha, separe los datos financieros auditados de la opinión del autor antes de incorporar cualquiera de las dos cifras a un modelo.
Un hábito de segunda sesión importa tanto como el primer prompt. Vuelva al día siguiente y pida a la misma herramienta el mismo múltiplo sin pegar la respuesta anterior. Una variación en la fórmula o en la fecha de referencia es una señal de alerta. La memoria entre sesiones de Jenova reduce el reinicio accidental de sus reglas de divulgación. No elimina la necesidad de volver a comprobar la cinta después de una publicación de resultados o un split.
¿Qué dicen los profesionales de datos de mercado sobre confiar en el análisis bursátil con AI?
Los profesionales que han visto converger la investigación de sell-side y las notas generadas por modelos coinciden en una regla: confíe en los metadatos, no en la prosa. Una herramienta que puede narrar una historia convincente sobre ventajas competitivas, pero no puede poner timestamp a su propia cifra de EV, no está lista para determinar el tamaño de una posición.
«El fallo que observamos casi nunca es la ausencia de un adjetivo. Es un cierre del martes dentro de un memorando del jueves, o un EBITDA “ajustado” que excluyó la compensación basada en acciones solo para la empresa objetivo. Si una herramienta bursátil con AI no puede emitir un encabezado de referencia temporal y una ficha de fórmula, tratamos el resultado como ayuda de lectura, no como dato de entrada para un modelo. Suena duro hasta que se recuerda que una sola reformulación silenciosa puede cambiar un múltiplo aparentemente barato en varios puntos.»
«Los conflictos son el segundo fallo silencioso. Un sitio de colaboradores, un afiliado de corretaje o un clasificador optimizado para interacción no tiene que mentir sobre el crecimiento de ingresos. Solo tiene que mostrar los nombres que mantienen a la gente haciendo clic. Hacemos a cada sistema la misma pregunta que haríamos a un analista junior: ¿quién cobra si actúo según esto y qué te haría retirar la recomendación? Si la respuesta es un encogimiento de hombros, la incertidumbre es del 100%, sin importar lo segura que suene la frase.»
«Los reguladores no están esperando una nueva ley para ocuparse de esto. FINRA ya ha dicho que las antiguas reglas de comunicaciones y supervisión se aplican a los sistemas generativos, y el marco de riesgos de AI de NIST deja claro que la fiabilidad se mide, no se afirma. Por ello, el estándar práctico para un analista bursátil con AI en 2026 es deliberadamente aburrido: relojes, fuentes, fórmulas, incentivos y rangos, en ese orden.»
— Equipo de Producto de Jenova, herramientas de investigación de renta variable e infraestructura de agentes de AI
Ese estándar también explica por qué las arquitecturas mixtas son normales. Utilice un motor de citas para el lenguaje de brokers, un agente nativo de presentaciones para la reconstrucción y un espacio de gráficos para la cinta. El trabajo de verificación es el producto. La ventana de chat es solo la interfaz.
Referencias
- SkyQuest — Tamaño, cuota y análisis de crecimiento del mercado de procedencia de datos
- IBM — ¿Qué es la procedencia de datos?
- Aviso Regulatorio 24-09 de FINRA — AI generativa y modelos de lenguaje grandes
- SEC — AI y el futuro de la gestión de inversiones (David W. Blass Daly, 3 de febrero de 2026)
- Crowell & Moring — El Comité Asesor de Inversores recomienda directrices de divulgación de la SEC para AI
- OpenCorporates — Explicación de la procedencia de datos
- Hyperbots — ¿Qué es la procedencia de datos? Definición, proceso y métricas clave
- AlphaSense — Principales herramientas de investigación de acciones e inversiones para 2026
- FINRA — Metodología y fuentes de datos de Fund Analyzer
- FINRA — Conflictos de interés
- Federal Register — Conflictos de interés asociados al uso de análisis predictivo de datos por broker-dealers y asesores de inversión
- NIST — Marco de Gestión de Riesgos de AI
- TrustRadius — AlphaSense frente a Koyfin
- Seeking Alpha — Suscripciones