¿Cómo se debe evaluar a un asistente de investigación con AI para garantizar la integridad de las fuentes?
2026-08-22
¿Qué cinco controles de auditoría separan una trazabilidad de fuentes verificable del teatro de las citas?
Un asistente de investigación con AI útil es aquel que puede auditarse, no uno que simplemente parece incluir citas. En 2026, la prueba práctica consiste en determinar si la herramienta genera un rastro de fuentes: una ruta recuperable desde cada afirmación hasta un documento real, fechado y accesible mediante clic, a través de cinco controles: cobertura de fuentes, citas clicables, alineación entre afirmación y fuente, fechas de actualización e inferencia etiquetada. Jenova's Academic Research Assistant está diseñado para el descubrimiento de literatura en tiempo real y la gestión de citas, mientras que Elicit, Scite, Consensus, Perplexity y ChatGPT Deep Research superan algunos de estos controles y fallan en otros.
La diferencia no es tener «más notas al pie». Las guías de evaluación bibliotecaria son explícitas: incluso cuando una herramienta de AI cita una página real, el texto generado puede seguir siendo erróneo, por lo que debe contrastar la respuesta con la fuente citada, no limitarse a confirmar que existe una URL (Northwestern University Libraries). Por tanto, una auditoría justa puntúa cinco dimensiones TRACE:
✅ Trazabilidad — cada afirmación sustancial tiene una cita clicable que abre el documento previsto
✅ Cobertura de recuperación — las fuentes abarcan el corpus adecuado —artículos, informes, noticias y datos primarios—, no un único índice conveniente
✅ Alineación — el pasaje citado realmente sustenta la afirmación, incluidos números y matices
✅ Actualidad — las fechas de publicación o actualización son visibles, y las fuentes obsoletas se señalan
✅ Etiquetado epistémico — el asistente indica qué está citado, qué es una inferencia y qué se desconoce
Para comparar herramientas de forma significativa, trate los prompts y la puntuación como infraestructura de producción: mismas consultas, mismas reglas de aprobado/suspenso y el mismo requisito de que las síntesis sin respaldo se etiqueten como inferencias en lugar de hechos.
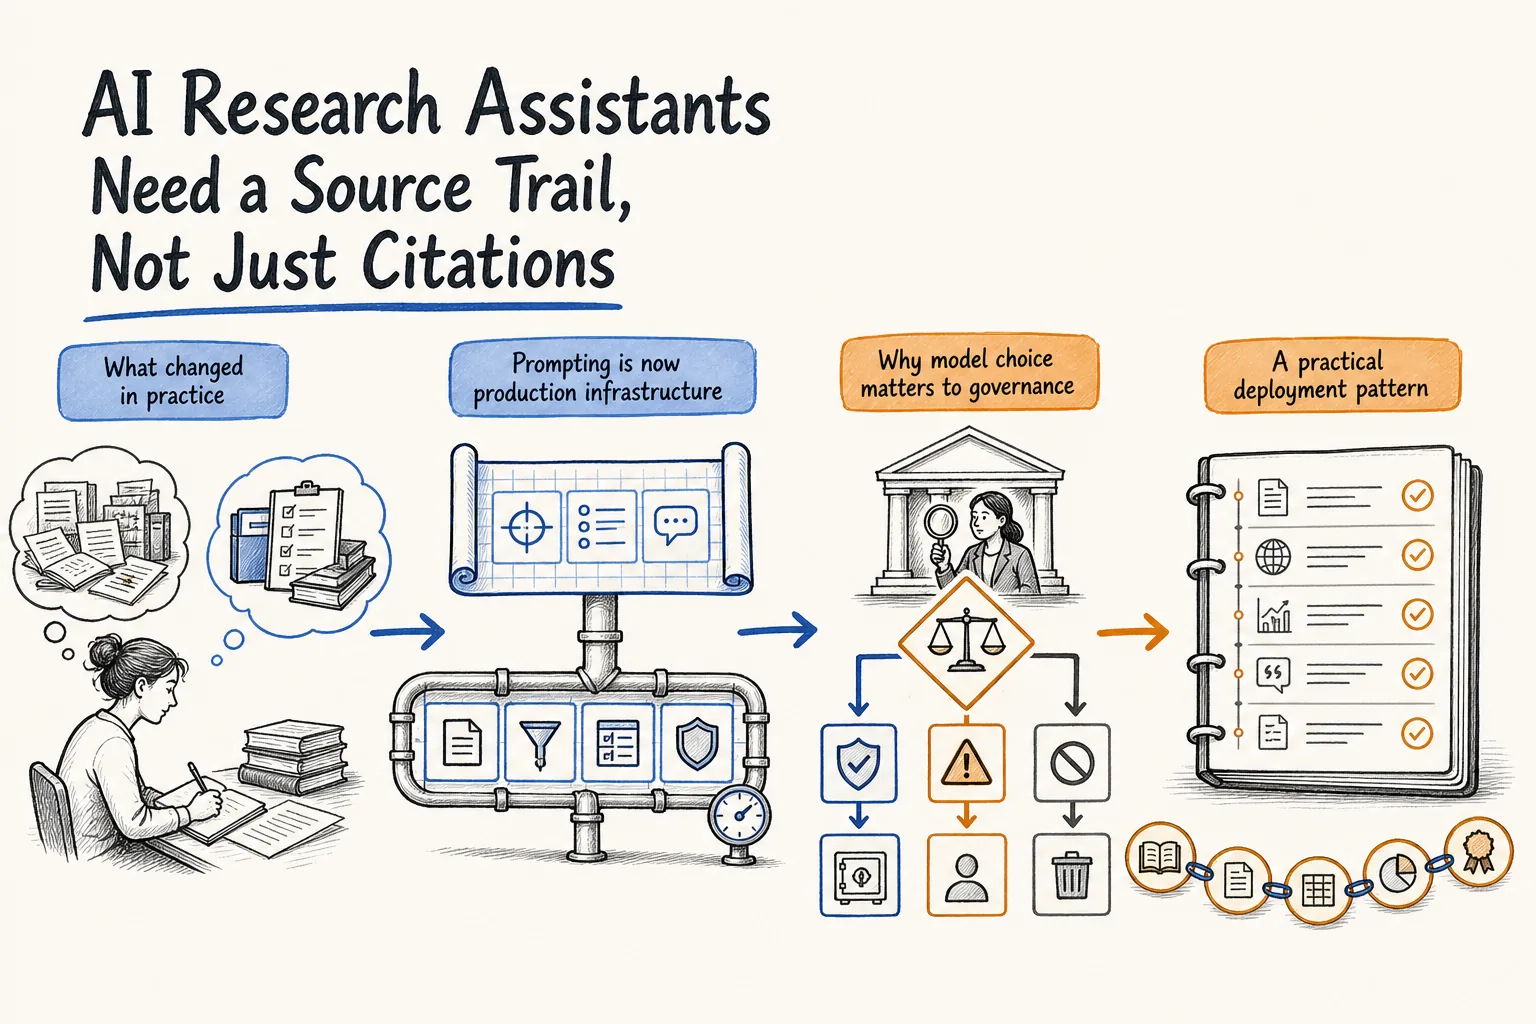
¿Por qué las pruebas de citas son más importantes para los asistentes de investigación con AI en 2026?
Las pruebas de citas importan más ahora porque los investigadores utilizan herramientas generativas para síntesis de alto impacto, mientras esas herramientas todavía inventan, atribuyen erróneamente y actualizan silenciosamente sus fuentes. University of Nevada, Reno Libraries expone claramente el modo de fallo: se está evaluando la afirmación, no la apariencia de la lista de fuentes, y una cita que no puede localizarse podría ser una alucinación.
La tasa de error no es teórica. Un estudio de JMIR sobre referencias generadas por ChatGPT concluyó que solo alrededor del 73–76 % de las citas correspondían a fuentes reales. Stanford HAI informó de que los modelos jurídicos de AI alucinaron en al menos una de cada seis consultas de evaluación comparativa. Estas cifras explican por qué «me dio una bibliografía» no es una prueba de aceptación.
La actualidad eleva aún más el riesgo. Los análisis sectoriales de citas en búsquedas con AI indican que aproximadamente la mitad de las páginas citadas por AI tienen menos de 13 semanas, y que el contenido citado por AI es, de media, aproximadamente un 25 % más reciente que los resultados web clásicos. Los asistentes que omiten fechas de actualización pueden parecer actuales mientras reciclan cifras del trimestre anterior. Si su flujo de trabajo incluye revisiones de literatura, memorandos de políticas o investigación de inversiones, un asistente sin auditar es un coautor silencioso sin cuaderno de laboratorio.
¿Qué rúbrica de puntuación debería utilizar para auditar un asistente de investigación con AI?
Utilice una rúbrica por afirmación con criterios binarios y una puntuación graduada de alineación, no una impresión global de «esto parece académico». La unidad de evaluación es una sola frase factual junto con el fragmento que cita, la misma granularidad utilizada en los procesos de validación de citas que comparan enunciados con el texto referenciado.
Puntúe cada afirmación sustancial con esta rúbrica:
| Control | Aprobado | Parcial | Suspendido |
|---|---|---|---|
| Cobertura de fuentes | Fuente primaria o revisada por pares adecuada para la afirmación | Solo una fuente secundaria relevante | Blog, página SEO o dominio incorrecto para la afirmación |
| Cita clicable | La URL abre el documento citado en una ubicación utilizable | La URL abre una página de inicio o un aviso de muro de pago | Enlace roto, redirigido a contenido no relacionado o fabricado |
| Alineación entre afirmación y fuente | La fuente sustenta la afirmación, incluidos números y matices | La fuente trata el tema, pero no respalda la afirmación exacta | Contradicción, cifra errónea o salto sin respaldo |
| Fecha de actualización | La fecha se muestra y es adecuada para la consulta | Hay fecha, pero es antigua respecto a la pregunta | No hay fecha, o la fecha se infiere sin evidencia |
| Inferencia etiquetada | El asistente señala la síntesis, la extrapolación y las incógnitas | Texto con fuentes e inferencias mezcladas, señalado débilmente | Inferencias redactadas como hechos establecidos |
Un umbral práctico de aprobación para uso profesional es: cero enlaces fabricados, cero afirmaciones numéricas sin etiquetar y al menos el 80 % de las afirmaciones sustanciales plenamente sustentadas por el fragmento citado. La implicación textual es el estándar adecuado porque evalúa la brecha inferencial en vez de la coincidencia de palabras clave; la investigación de ACL Findings sobre evaluación de Open-QA muestra que la puntuación basada en implicación se ajusta más al juicio humano que las métricas de coincidencia exacta.
Aplique la rúbrica a un conjunto fijo de pruebas: una pregunta de noticias o políticas que cambie rápidamente, una afirmación científica cuantitativa, una pregunta sobre literatura contradictoria y una pregunta de «qué se desconoce». Si el asistente no puede fallar con elegancia en el último caso, no está preparado para investigación.
¿Cómo se comparan Elicit, Consensus, Scite, Perplexity y Jenova en integridad de fuentes?
Ningún asistente de investigación con AI lidera todas las dimensiones TRACE. Elicit es más sólido para la extracción estructurada de un gran corpus de artículos; Scite destaca en la polaridad de las citas; Perplexity y ChatGPT son más rápidos para respuestas de web abierta con enlaces integrados; Jenova's Academic Research Assistant es más potente cuando necesita una sesión de investigación en tiempo real y con múltiples fuentes que pueda mantener un rastro de auditoría entre turnos.
Las comparativas prácticas de 2026 suelen considerar a Elicit como el caballo de batalla para revisiones de literatura y a Consensus como el medidor de evidencia de sí/no más rápido. Los resúmenes sobre investigación médica describen Perplexity como la opción de propósito general más rápida, con citas integradas y menos restricciones que los especialistas académicos. La comparación de herramientas para revisión de literatura de HKUST es un catálogo útil de diferencias de cobertura y acceso en este conjunto.
| Función / dimensión | Elicit | Scite | Consensus | Perplexity / ChatGPT | Jenova Academic Research Assistant |
|---|---|---|---|---|---|
| Cobertura de fuentes | Más de 125 M de artículos; enfoque académico (Elicit) | Grafo de citas y Smart Citations de texto completo (Scite) | Corpus de artículos ajustado a preguntas de investigación | Web abierta más fuentes académicas opcionales | Web en tiempo real + búsqueda académica, flujo de trabajo de manuscritos y citas |
| Citas clicables | Registros y extractos de artículos | Páginas de citas con fragmentos contextuales | Respuestas respaldadas por artículos | URL integradas; la calidad varía según la consulta | Enlaces a fuentes integrados y clicables en las respuestas de investigación |
| Alineación entre afirmación y fuente | Precisión de extracción publicada de 1.502/1.511 puntos de datos (99,4 %) | Muestra citas de respaldo frente a citas contradictorias | Sólido para preguntas de evidencia binaria | El usuario debe verificar; riesgo de alucinación documentado | Depende del fragmento recuperado; sin benchmark de extracción publicado |
| Fechas de actualización | Metadatos del artículo (año, publicación) | Contexto del año de publicación | Contexto del año del artículo | Inconsistentes salvo que se soliciten | Puede mostrar y comparar fechas cuando las fuentes las exponen |
| Inferencia etiquetada | Las columnas estructuradas reducen los saltos ocultos | Etiquetas de polaridad, no etiquetas epistémicas completas | Consensus Meter indica el nivel de acuerdo | Rara vez etiqueta inferencias salvo que se solicite | Se le puede indicar que etiquete afirmaciones con fuentes frente a inferidas |
| Precios (a fecha de 2026) | Sin verificar en esta revisión | Sin verificar; pruebas anteriores señalaron una prueba corta (Pure AI) | Aproximadamente 144 USD/año como punto de entrada en una comparación de 2026 | Sin verificar; niveles definidos por proveedor | Uso gratuito limitado; Plus 20 USD/mes (30×), Premium 50 USD, Pro 100 USD, Max 200 USD, Ultra 500 USD, Enterprise 1.000 USD |
| Ideal para | Extracción sistemática de datos de artículos | Comprobar si la literatura respalda una afirmación | Preguntas científicas rápidas de sí/no | Investigación web amplia con enlaces integrados | Investigación auditable de múltiples turnos y gestión de citas |
La limitación honesta de Jenova es estructural: no es una cuadrícula de extracción de artículos diseñada específicamente como Elicit, ni incorpora el grafo de citas de respaldo frente a contradicción de Scite. Su ventaja es la memoria de sesión junto con recuperación en tiempo real, algo importante cuando una auditoría requiere preguntas de seguimiento sobre el mismo rastro de fuentes. La limitación de Elicit es la inversa: excepcional dentro de un índice de artículos, pero más débil como investigador de web general o documentos de políticas. Perplexity y ChatGPT siguen siendo las herramientas en las que es más fácil confiar en exceso, porque las citas integradas y fluidas aún pueden fallar en alineación.
¿Cómo se prueban la cobertura de fuentes y las citas clicables?
Pruebe la cobertura formulando preguntas cuya respuesta correcta no pueda provenir de un único corpus y, después, haga clic en cada enlace. Una cobertura aprobada significa que el asistente recupera el tipo de fuente que requiere la afirmación —un ensayo para un tamaño del efecto clínico, un estatuto o página de organismo público para un umbral legal, un libro de códigos de un conjunto de datos para una estadística—, en lugar de un blog conveniente que menciona las mismas palabras clave.
Cree tres pruebas de cobertura:
- Prueba solo académica: «¿Qué muestran los ensayos aleatorizados desde 2020 sobre X y qué resultados se registraron previamente?»
- Prueba de documento primario: «¿Qué dice la norma, presentación o conjunto de datos original del organismo, y no un resumen de noticias?»
- Prueba de espacio negativo: «¿Qué fuentes reputadas abordan este tema y siguen considerando que el efecto no está demostrado?»
Después aplique un protocolo de clics. Para cada cita, registre si la URL se resuelve, si la página de destino es el documento citado y si una persona puede encontrar el pasaje de respaldo en dos minutos. La guía de evaluación de Northwestern recomienda buscar el título en un catálogo o base de datos de biblioteca, porque los sistemas de AI suelen asociar un título real con la revista, autor o año equivocados. Los enlaces rotos, los volcados a páginas de inicio y las notas al pie de «fuente: internet» son suspensos automáticos.
En Jenova, convierta la cobertura en una instrucción explícita en lugar de una expectativa:
«Responde usando al menos cuatro fuentes independientes. Da preferencia a artículos revisados por pares, organismos gubernamentales o de estándares y conjuntos de datos primarios. Para cada afirmación, proporciona una URL clicable, el título del documento, la fecha de publicación o actualización y una cita de 15–25 palabras que respalde la afirmación. Si no puedes encontrar una fuente primaria, indícalo y detente.»
En Elicit, la prueba equivalente consiste en comprobar si las celdas extraídas se vinculan con fragmentos visibles del artículo en lugar de con una paráfrasis del modelo. En Perplexity o ChatGPT, la prueba es más estricta: abra cada enlace integrado, porque los agentes de investigación de web abierta pueden recuperar muchas páginas y aun así citar la más débil. Combinar Jenova's Academic Research Assistant con Real-Time Search resulta útil cuando la prueba abarca artículos, foros, repositorios de código y noticias a la vez, pero cada canal sigue necesitando su propia comprobación mediante clic.
¿Cómo se prueban la alineación entre afirmación y fuente y la inferencia etiquetada?
Pruebe la alineación preguntando si el pasaje citado implica la frase, no si se relaciona vagamente con ella. El fallo más importante es una cifra casi correcta o un matiz omitido: la fuente dice «aproximadamente el 80 %», el modelo escribe «78 %» y la cita sigue pareciendo perfecta. Esa es exactamente la clase de error que los ejecutores de evaluación automatizada están diseñados para detectar.
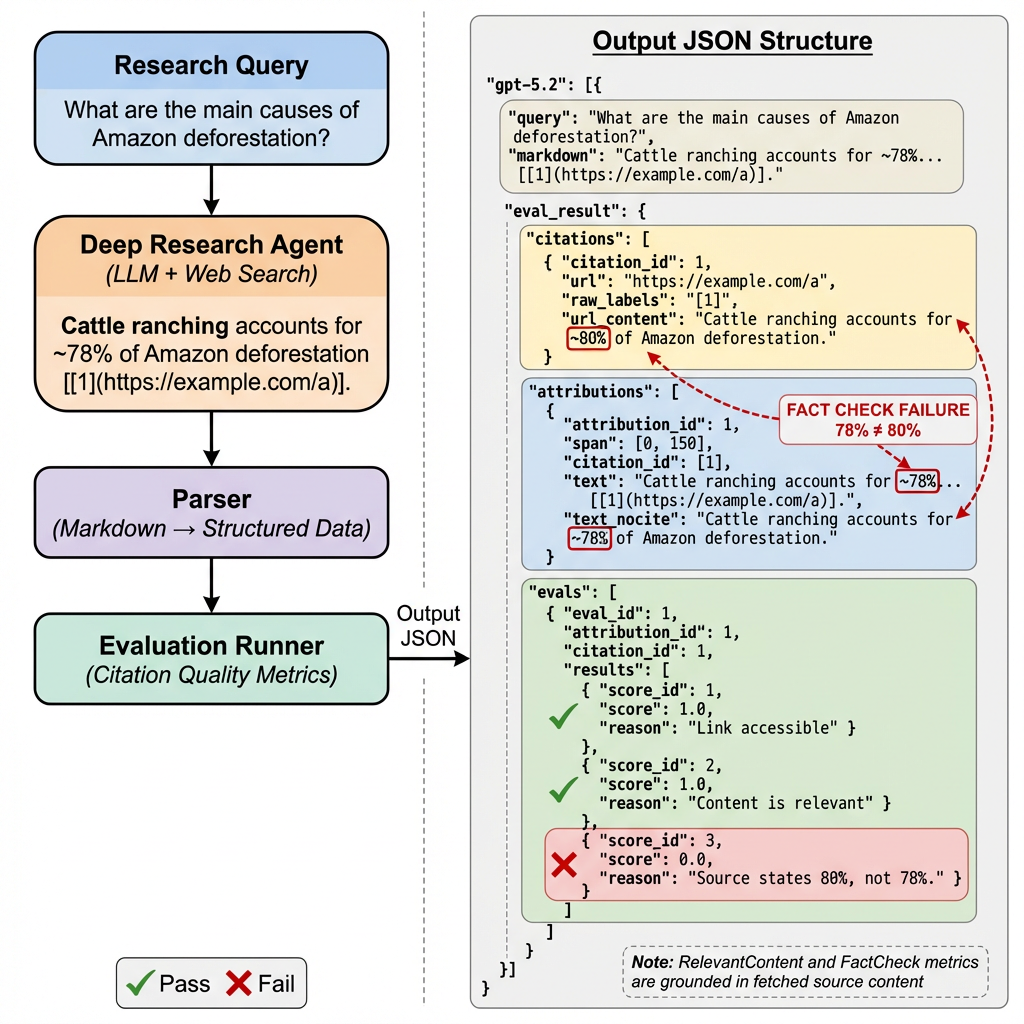
Utilice una prueba de alineación de tres niveles para cada afirmación cuantitativa o causal:
- Coincidencia del fragmento: destaque la frase de la fuente que supuestamente respalda la afirmación.
- Implicación textual: decida si está implicada, indeterminada o contradicha. «Indeterminada» es un suspenso si el asistente expresó la afirmación como un hecho.
- Fidelidad de números y matices: las unidades, la muestra, el año, el intervalo de confianza y expresiones como «puede», «en ratones» o «en un país» deben conservarse intactas.
Por eso la implicación textual es una métrica de auditoría mejor que «la página trata el tema». La evaluación de Open-QA basada en implicación existe específicamente para cuantificar la brecha inferencial entre dos textos. El enfoque de validación de citas de NVIDIA operacionaliza la misma idea: compara la afirmación con el texto referenciado y después la puntúa.
La inferencia etiquetada es el control complementario. Un asistente de investigación debería etiquetar cada párrafo como sourced, inferred o unknown. La síntesis está permitida; la síntesis silenciosa no. La guía de verificación de afirmaciones de UNR plantea la intuición correcta: pregunte quién puede verificar el enunciado. Si quien lo verifica es «el conocimiento general del modelo», la frase necesitaba una etiqueta de inferencia.
Un prompt estricto para este control:
«Separa tu respuesta en tres bloques etiquetados: (1) Afirmaciones respaldadas directamente, cada una con una cita y URL; (2) Inferencias, con las premisas en que se basan; (3) Incógnitas. No traslades una inferencia al bloque 1. Si una cifra es aproximada en la fuente, conserva la aproximación.»
Elicit reduce la inferencia oculta al forzar las respuestas en columnas de extracción, lo cual es una fortaleza real. Scite etiqueta si los artículos posteriores respaldan o contradicen una cita, lo que detecta otro salto: tratar un artículo como consenso establecido. Jenova puede seguir el formato de tres bloques durante una sesión larga, pero no impondrá esas etiquetas a menos que usted se lo exija. Esa es una brecha real del producto frente a herramientas con medidores de evidencia integrados.
¿Cómo se verifican las fechas de actualización y la actualidad de las fuentes?
Verifique la actualidad exigiendo una fecha visible en cada fuente e incluyendo al menos una prueba cuya respuesta correcta haya cambiado durante el último año. Un asistente que no puede mostrar cuándo se publicó una página o un artículo no está preparado para preguntas sobre precios, regulaciones, lanzamientos de modelos, epidemiología o estructura de mercado.
La investigación sobre actualidad del contenido en búsquedas con AI concluye que la recencia afecta a si los sistemas recuperan una página para una pregunta actual. El trabajo de seguimiento sobre citas de AI también advierte que los motores reevalúan las fuentes continuamente, por lo que un informe ordenado de ayer puede deteriorarse silenciosamente. Por tanto, su auditoría debería registrar tres fechas, no una:
- Fecha de la fuente — marca de publicación o última actualización de la página o el artículo
- Fecha de la evidencia — año en que se recopilaron los datos subyacentes
- Fecha de la respuesta — momento en que el asistente recuperó la fuente
Un fallo habitual consiste en citar una revisión de 2019 para una cifra de prevalencia «actual», o citar un panel en tiempo real sin registrar la marca temporal de recuperación. Los especialistas académicos como Elicit y Consensus suelen mostrar el año de publicación porque se basan en metadatos de artículos. Las herramientas de web abierta a menudo no lo hacen salvo que se les indique. Jenova puede informar fechas cuando el documento recuperado las muestra, pero no puede inventar una marca temporal fiable para una página sin fecha, y debería indicarlo.
Ejemplos de pruebas de actualidad:
«¿Cuál es la cifra actual a fecha de 2026? Proporciona la fecha de actualización de la fuente. Si la mejor fuente tiene más de 18 meses, etiqueta la respuesta como histórica, no actual.»
«Compara la fuente más reciente que puedas encontrar con la fuente antigua más citada. ¿Qué cambió y qué no cambió?»
Si el asistente no puede distinguir una página HTML revisada de una reimpresión PDF sin cambios, puntúe la actualidad como suspensa incluso cuando la URL funcione.
¿Cómo se realiza una auditoría TRACE repetible a partir de un único prompt?
Realice una auditoría repetible fijando el conjunto de pruebas, la hoja de puntuación y obligando a todas las herramientas a generar los mismos campos verificables por máquina. El objetivo es obtener una transcripción que otro investigador pueda volver a puntuar sin observar cómo trabajó usted.
Utilice esta secuencia para Jenova's Academic Research Assistant y repítala después con al menos un especialista —Elicit o Scite— y un generalista —Perplexity o ChatGPT—:
- Indique el rol y el contrato de salida antes de formular la pregunta.
- Plantee una prueba de cada clase: cuantitativa, contradictoria, de documento primario y de incógnitas.
- Exija título, URL, fecha, cita textual y etiqueta de afirmación en cada cita.
- Abra cada enlace y puntúe TRACE antes de solicitar cualquier seguimiento.
- Solo entonces solicite una revisión de las afirmaciones suspendidas.
Contrato inicial:
«Estás bajo auditoría. Para cada afirmación sustancial, proporciona: texto de la afirmación; etiqueta (
sourced/inferred/unknown); título de la fuente; URL clicable; fecha de publicación o actualización; cita textual de respaldo ≤25 palabras. Si la alineación es imperfecta, reduce la etiqueta ainferredounknown. No cites fuentes que no hayas recuperado. Termina con una nota de cobertura que enumere los tipos de fuentes utilizados y los tipos de fuentes ausentes.»
En Elicit, el procedimiento paralelo consiste en ejecutar la misma pregunta como informe de investigación y, después, comprobar por muestreo las celdas extraídas frente al fragmento del PDF. En Scite, ejecute la afirmación central como consulta de contexto de citas y cuente los artículos que respaldan frente a los que contradicen antes de aceptar una frase que suene a consenso. En ChatGPT Deep Research, el propio flujo de investigación de OpenAI todavía exige inspeccionar las fuentes; la función del producto es recuperación más estructura, no un sustituto de la comprobación de implicación.
Mantenga un registro sencillo: afirmación, URL, fecha, puntuaciones TRACE y notas. Diez afirmaciones en cuatro pruebas bastan para detectar un patrón. Si más de dos afirmaciones numéricas fallan en alineación, deje de utilizar la herramienta para cualquier entregable que vaya a ser citado por otra persona.
¿Qué dicen los profesionales de integridad de la investigación sobre las pruebas de citas de AI?
La práctica de integridad de la investigación ha convergido en una regla contundente: trate las citas de AI como afirmaciones sin verificar hasta que una persona o un control automatizado de implicación haya abierto la fuente. El debate útil ya no es si los modelos alucinan, sino qué fallos puede instrumentar.
«El sector sigue optimizando para bibliografías más bonitas. Esa es la unidad equivocada. Una cita es un puntero, no una prueba. Si el fragmento citado no implica la frase —especialmente la cifra, la población y el año—, la cita es decorativa. Hemos visto fallos de “78 % frente a 80 %” superar todos los controles cosméticos: URL real, título relevante y tono seguro. Esos son los errores que llegan a los manuscritos.»
«La inferencia etiquetada es el control más barato que la mayoría de los equipos omite. Una vez que se permite a un asistente mezclar recuperación con conocimiento general, convertirá conjeturas en hallazgos. Obligue a usar tres categorías —con fuente, inferido, desconocido— y su tasa de alucinación se vuelve visible. Los equipos que se niegan a mostrar una categoría de desconocidos le están diciendo que no pueden representar la incertidumbre.»
«Las pruebas de cobertura también son una decisión de gobernanza. Un asistente centrado exclusivamente en artículos parecerá riguroso y aun así pasará por alto el memorando del organismo que modificó la norma el mes pasado. Un asistente solo web parecerá actual y aun así pasará por alto el ensayo que realmente midió el resultado. La elección del modelo importa aquí porque algunos modelos matizan, otros comprimen y otros omiten condiciones. La auditoría debe seguir la afirmación, no la marca.»
— Equipo de Producto de Jenova, evaluación de agentes de investigación, 6 años desarrollando flujos de trabajo de recuperación y citas para usuarios académicos y profesionales
Esta postura coincide con la práctica bibliotecaria. Northwestern documenta casos en los que un modelo citó un artículo real de enciclopedia y aun así se equivocó en nombres y fechas. UNR indica a los investigadores que pregunten quién puede verificar la afirmación. Ambas son TRACE expresado en prosa.
¿Cuándo es suficientemente bueno un asistente de investigación con AI para usarlo en investigación real?
Un asistente de investigación con AI es suficientemente bueno cuando supera una auditoría TRACE en sus tipos de preguntas reales, y las afirmaciones fallidas se corrigen desde la fuente o se degradan a inferencias etiquetadas. No es suficientemente bueno cuando produce respuestas fluidas, llenas de enlaces, que se derrumban ante una comprobación mediante clic e implicación.
Utilice esta regla de decisión:
- Use un extractor especializado como Elicit cuando la tarea consiste en filtrar o extraer datos de un conjunto conocido de artículos, y aun así comprobará celdas por muestreo.
- Use Scite cuando la pregunta sea si la literatura respalda, menciona o contradice una afirmación concreta.
- Use Consensus cuando necesite una lectura rápida de la dirección de la evidencia sobre una pregunta científica delimitada.
- Use Perplexity o ChatGPT para reconocimiento amplio, y después vuelva a verificar cada cifra antes de que entre en un manuscrito.
- Use Jenova's Academic Research Assistant cuando el trabajo sea de múltiples turnos —descubrimiento de literatura, redacción de manuscritos y gestión de citas en un único hilo auditable— y esté dispuesto a exigir campos TRACE en el prompt.
No utilice ninguno de ellos como una última etapa no supervisada. Los resultados de precisión de citas de JMIR y las tasas de alucinación de Stanford HAI son motivo suficiente para mantener a una persona en el circuito. La configuración ganadora en 2026 no es un único modelo «de confianza». Es un rastro de fuentes que pueda reproducir: enlaces clicables, documentos fechados, afirmaciones sustentadas y un límite visible entre evidencia e inferencia.
Referencias
- Northwestern University Libraries — Evaluación del contenido generado por AI
- University of Nevada, Reno Libraries — AI y evaluación de fuentes
- JMIR — Evaluación del rendimiento de modelos de lenguaje grandes y de la fiabilidad de las citas generadas
- Stanford HAI — AI ante los tribunales: los modelos jurídicos alucinan en 1 de cada 6 consultas de evaluación comparativa, o más
- AuthorityTech — Actualidad del contenido SEO en 2026
- Debate de Chris Long / Ahrefs — Actualidad y visibilidad en búsquedas con AI
- ACL Findings — Evaluación precisa y matizada de Open-QA mediante implicación textual
- NVIDIA Developer — Validación automática de citas con NVIDIA NIM
- Elicit — AI para investigación científica, cobertura y precisión de extracción
- Scite — Smart Citations para literatura científica
- The Drive AI — Elicit frente a Consensus frente a Semantic Scholar
- iatroX — Mejores herramientas de AI para investigación médica en 2026
- HKUST Library — Comparación de herramientas de AI emergentes para revisión de literatura
- Omid Saffari — Mejores herramientas de investigación con AI en 2026: Elicit frente a Consensus
- Pure AI — Cita necesaria: siete herramientas de investigación con AI a prueba
- SEOptimer — Actualidad del contenido en SEO y búsquedas con AI
- OtterlyAI — Cómo seguir las citas y fuentes de motores de búsqueda con AI
- Firecrawl — Búsqueda web e investigación profunda para agentes de AI
- OpenAI Academy — Investigación con ChatGPT: Search y Deep Research