¿Cómo verificar la privacidad, la evidencia y la seguridad ante crisis en una herramienta de salud mental con AI?
2026-08-20
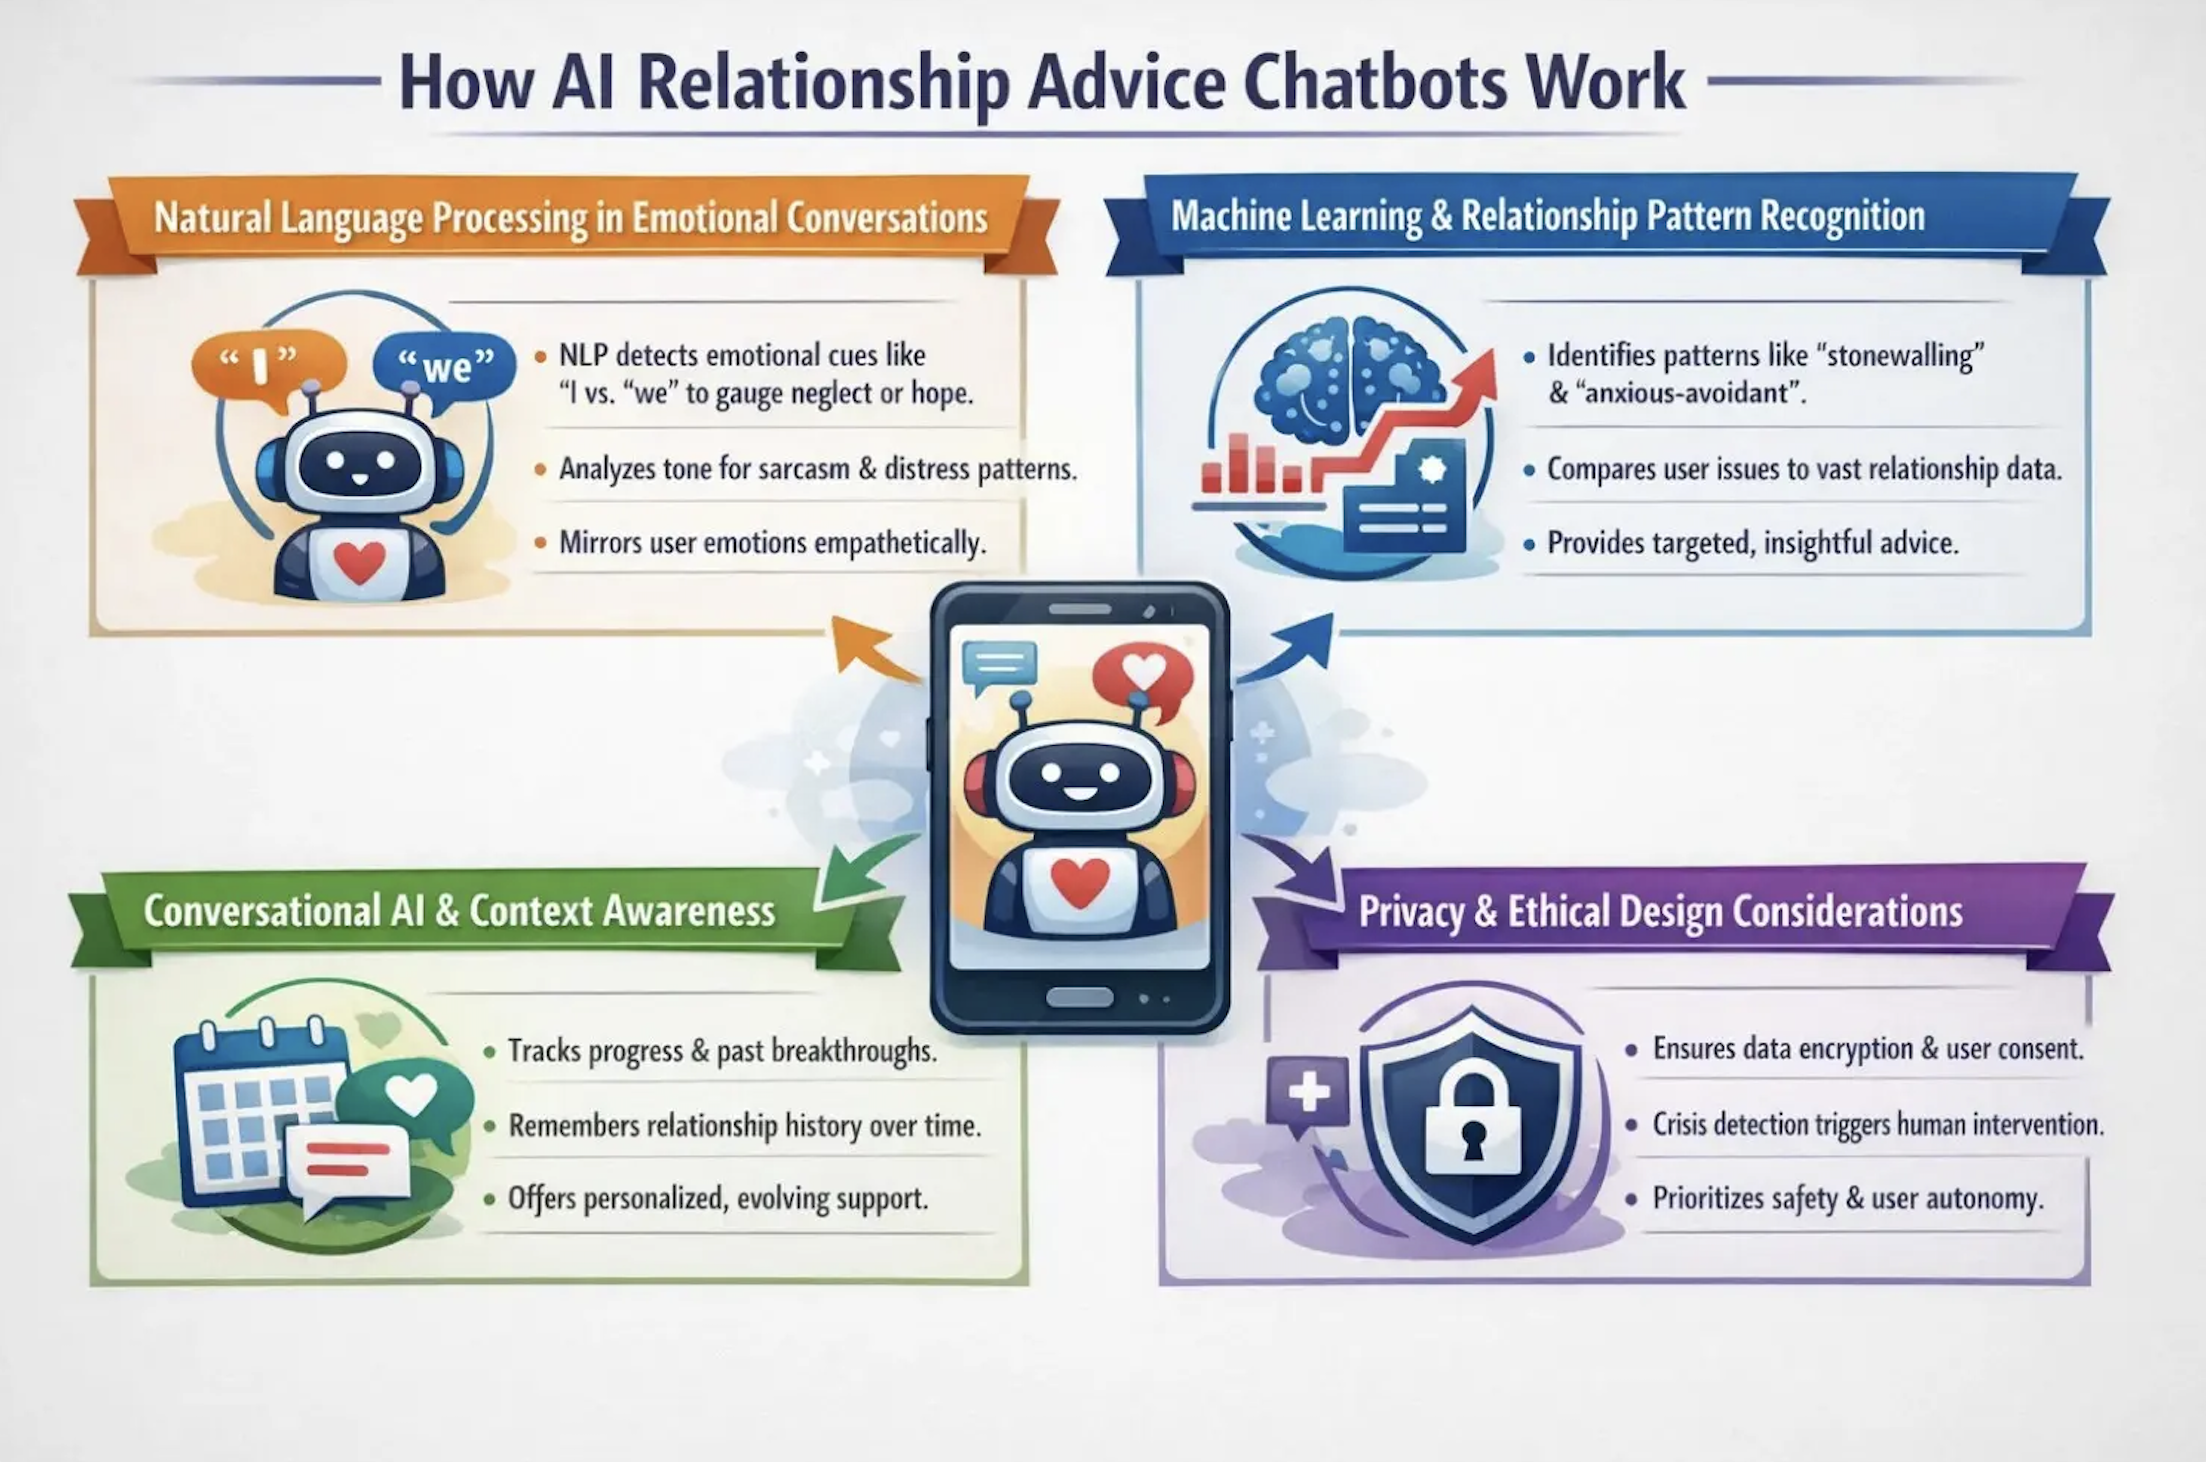
¿Qué cuatro verificaciones distinguen una herramienta de apoyo con AI segura de una arriesgada?
Cuatro verificaciones separan una herramienta de apoyo a la salud mental con AI defendible de una arriesgada: (1) una política de privacidad que identifique a un responsable del tratamiento de datos específico, certificaciones y subprocesadores nombrados; (2) afirmaciones sobre evidencia vinculadas a ensayos revisados por pares, no a testimonios; (3) divulgaciones explícitas de límites profesionales que indiquen que la herramienta no es un proveedor autorizado y no diagnostica; y (4) escalamiento ante crisis que muestre líneas de ayuda funcionales en uno o dos toques, localizadas para tu jurisdicción. Las herramientas diseñadas específicamente para este fin, como Wysa y Woebot, publican más documentación de este tipo que los asistentes de propósito general, pero una evaluación de 2026 concluyó que ninguna App de salud mental con AI evaluada alcanzó una calificación de apoyo en crisis de «Buena» o «Excelente»: la verificación depende de ti.
Qué buscar antes de escribir algo personal en un chatbot de apoyo:
✅ Responsable y DPO identificados: una entidad real, una dirección de contacto y un plazo de respuesta declarado para las solicitudes de datos ✅ Certificaciones independientes: ISO 27001/27701, NHS DSP Toolkit, SOC 2 o una acreditación equivalente de terceros ✅ Evidencia de ensayos publicada: estudios revisados por pares que nombren el producto específico, no afirmaciones genéricas de que «la terapia con AI funciona» ✅ Divulgación explícita de no ser clínico: la herramienta declara por escrito que no diagnostica, trata ni sustituye a un proveedor ✅ Acceso a crisis en uno o dos toques: números de emergencia localizados y accesibles sin navegar por tres pantallas
Cada uno de estos puntos puede comprobarse en menos de 30 minutos usando documentos disponibles públicamente. El resto de esta guía explica cómo hacerlo.
¿Por qué la verificación importa más en las herramientas de salud mental con AI que en otras Apps?
La verificación importa más aquí porque el modo de fallo es el daño clínico, no la incomodidad. El aviso de salud de la American Psychological Association documenta que los chatbots de AI generativa «ya han participado en interacciones inseguras con poblaciones vulnerables, como niños o personas con antecedentes establecidos de problemas de salud mental, fomentando las autolesiones, incluido el suicidio, el consumo de sustancias, los trastornos alimentarios, la conducta agresiva y el pensamiento delirante».
Además, la categoría carece de regulación estructural. La evaluación de riesgos de Common Sense Media de 2026 concluyó que el mercado de las Apps de salud mental con AI está «sin regular, es inestable y, en algunos casos, perjudica activamente a los adolescentes». Ningún guardián realiza esta verificación por ti antes de que una App llegue a una tienda de aplicaciones.
Dos riesgos estructurales agravan el problema:
- Sesgo de complacencia. APA señala que los modelos de lenguaje grandes están entrenados para ser complacientes y validar las aportaciones del usuario, lo que «puede ser terapéuticamente dañino al reforzar el sesgo de confirmación, las distorsiones cognitivas o la evitación de desafíos necesarios».
- Opacidad de los datos de entrenamiento. Los datos de entrenamiento fundamentales de la mayoría de los modelos no están disponibles públicamente, algo que APA afirma que «impide su evaluación sistemática» y sesga los modelos hacia lo occidental y anglófono, limitando su competencia cultural.
Un estudio de Brown University de 2025 también descubrió que los chatbots de AI vulneran de forma rutinaria las normas éticas fundamentales de salud mental. Verificar no es paranoia. Es el único filtro de calidad de la cadena.
¿Cómo auditar realmente la política de privacidad de una herramienta de salud mental con AI?
Audita una política de privacidad buscando cinco elementos estructurales específicos en lugar de leer superficialmente un lenguaje tranquilizador: el responsable del tratamiento identificado, la lista de certificaciones, la tabla de subprocesadores, la divulgación sobre el procesamiento con AI y el proceso de derechos de los interesados. Las páginas de marketing dicen «tu privacidad importa». Las políticas identifican entidades o no lo hacen.
🔍 La auditoría de privacidad de cinco elementos
1. Responsable identificado y vía de contacto. Una política defendible identifica a la entidad jurídica operadora y a un delegado de protección de datos. La política de Wysa identifica a Touchkin eServices Private Limited como responsable, incluye una dirección de reclamaciones para el DPO y se compromete a responder a las consultas válidas en un plazo de un mes. Si no puedes encontrar el nombre de una entidad jurídica, detente.
2. Certificaciones independientes. Busca una acreditación de terceros, no una autodeclaración. Wysa afirma que sus sistemas de gestión de seguridad de la información y privacidad están certificados según ISO 27001 e ISO 27701, que está registrada ante la Information Commissioner's Office del Reino Unido y que cumple las normas NHS Digital Data Security and Protection Toolkit y los estándares de seguridad clínica DCB0129.
3. La tabla de subprocesadores. Esta es la sección más reveladora y la mayoría de las políticas la ocultan o la omiten. Wysa publica una tabla completa que identifica a AWS, MongoDB Atlas, Firebase, Cloudflare, Zendesk, Private AI y OpenAI, junto con el tipo de datos y la ubicación del procesamiento de cada uno. Una política sin lista de subprocesadores te está diciendo que no quiere que sepas adónde van tus conversaciones.
4. Divulgación del procesamiento con AI. Lee qué ocurre con tus mensajes en la capa del modelo. La política de Wysa indica que los mensajes de conversación «nunca se almacenan en el LLM» y «no se utilizan como datos de entrenamiento por el LLM», y que su propia AI «no cambia en tiempo real». Es una afirmación específica y falsable. Una formulación vaga como «podemos utilizar datos para mejorar nuestros servicios» no lo es.
5. Proceso de derechos y brechas. Busca una vía de reclamación declarada, escalamiento a una autoridad supervisora y un procedimiento de gestión de brechas de seguridad.
Indicación de verificación para cualquier documento de política que estés revisando:
«Voy a pegar la política de privacidad de una App de salud mental. Identifica: el responsable del tratamiento de datos nombrado, todos los subprocesadores enumerados y sus ubicaciones, cualquier certificación de seguridad de terceros, qué sucede con mis datos de conversación en la capa del modelo y cualquier cláusula que permita entrenar con mis datos. Señala todo lo que sea ambiguo.»
📋 Lo que encontró la revisión de Mozilla
La evaluación de Mozilla Foundation sobre la categoría concluyó que la mayoría de las Apps de salud mental y oración «fracasan estrepitosamente en privacidad y seguridad», y las describió como «una bonanza de recolección de datos», aunque destacó a Wysa como una App que «parece valorar realmente la privacidad de los usuarios». La desconfianza a nivel de categoría, con excepciones a nivel de producto, es la postura predeterminada correcta.
¿Qué cuenta como evidencia real de que una herramienta de apoyo con AI funciona?
La evidencia real implica estudios revisados por pares que nombren el producto específico, utilicen una condición de control, informen medidas de resultado estandarizadas y se publiquen en algún lugar donde puedas leerlos. Los testimonios, las insignias de «validado clínicamente» sin citas y las métricas internas de interacción no son evidencia.
El aviso de APA es directo sobre el estado actual del campo: incluso para las herramientas diseñadas específicamente, «faltan ensayos clínicos de alta calidad y a gran escala que establezcan la eficacia, seguridad y uso adecuado de estas tecnologías en la atención de salud mental». La investigación preliminar sugiere que algunas herramientas específicas para el bienestar se asocian con reducciones del estrés, la soledad, la depresión y la ansiedad autoinformados, pero APA señala que estos estudios no incluyen chatbots de propósito general.
La jerarquía de evidencia: de mayor a menor solidez
| Nivel | Tipo de evidencia | Lo que demuestra | Ejemplo |
|---|---|---|---|
| 1 | Ensayo controlado aleatorizado con comparador activo | Efecto en relación con la atención existente | Poco frecuente en esta categoría |
| 2 | RCT con control de lista de espera | El efecto existe, pero su magnitud no está clara | Algunas Apps diseñadas específicamente |
| 3 | Evaluación en el mundo real con métodos mixtos | Interacción y cambio autoinformado | Estudio de Wysa en JMIR mHealth |
| 4 | Revisión revisada por pares de la categoría | Plausibilidad a nivel de categoría | Revisión de chatbots en PMC |
| 5 | Documento técnico del proveedor / testimonio | Nada verificable | La mayoría de las páginas de marketing |
El estándar recomendado por APA para el campo es explícito: la evaluación «debe seguir los procesos de la investigación de ensayos clínicos», y avanzar «más allá de los controles de lista de espera, emplear diseños RCT sólidos, usar métricas estandarizadas e incluir seguimiento a largo plazo». Muy pocos productos de consumo cumplen hoy ese estándar.
🎯 Tres preguntas que revelan afirmaciones de evidencia débiles
- ¿El estudio citado menciona este producto? Las citas genéricas que indican que «los chatbots de AI reducen la ansiedad» no te dicen nada sobre la App que tienes delante.
- ¿El estudio es independiente o está financiado por el proveedor? La financiación del proveedor no lo descalifica, pero cambia el peso que debes dar al resultado.
- ¿Hay un comparador? Un antes y después sin grupo de control no puede separar el efecto de la herramienta de la regresión a la media.
Una revisión de la categoría señaló que aproximadamente el 2 % de las Apps de salud mental tienen evidencia publicada de efectividad, lo que significa que la ausencia de citas es la norma, no una anomalía. Considera la evidencia publicada y específica del producto como un diferenciador significativo cuando la encuentres.
¿Qué divulgaciones de límites profesionales debe expresar explícitamente la herramienta?
Una herramienta con límites defendibles declara por escrito, antes de que empieces y no escondido en los términos, que es una AI y no una persona, que no diagnostica ni trata, que no es un proveedor autorizado y que no es para emergencias. Cualquier cosa inferior es un fallo de límites.
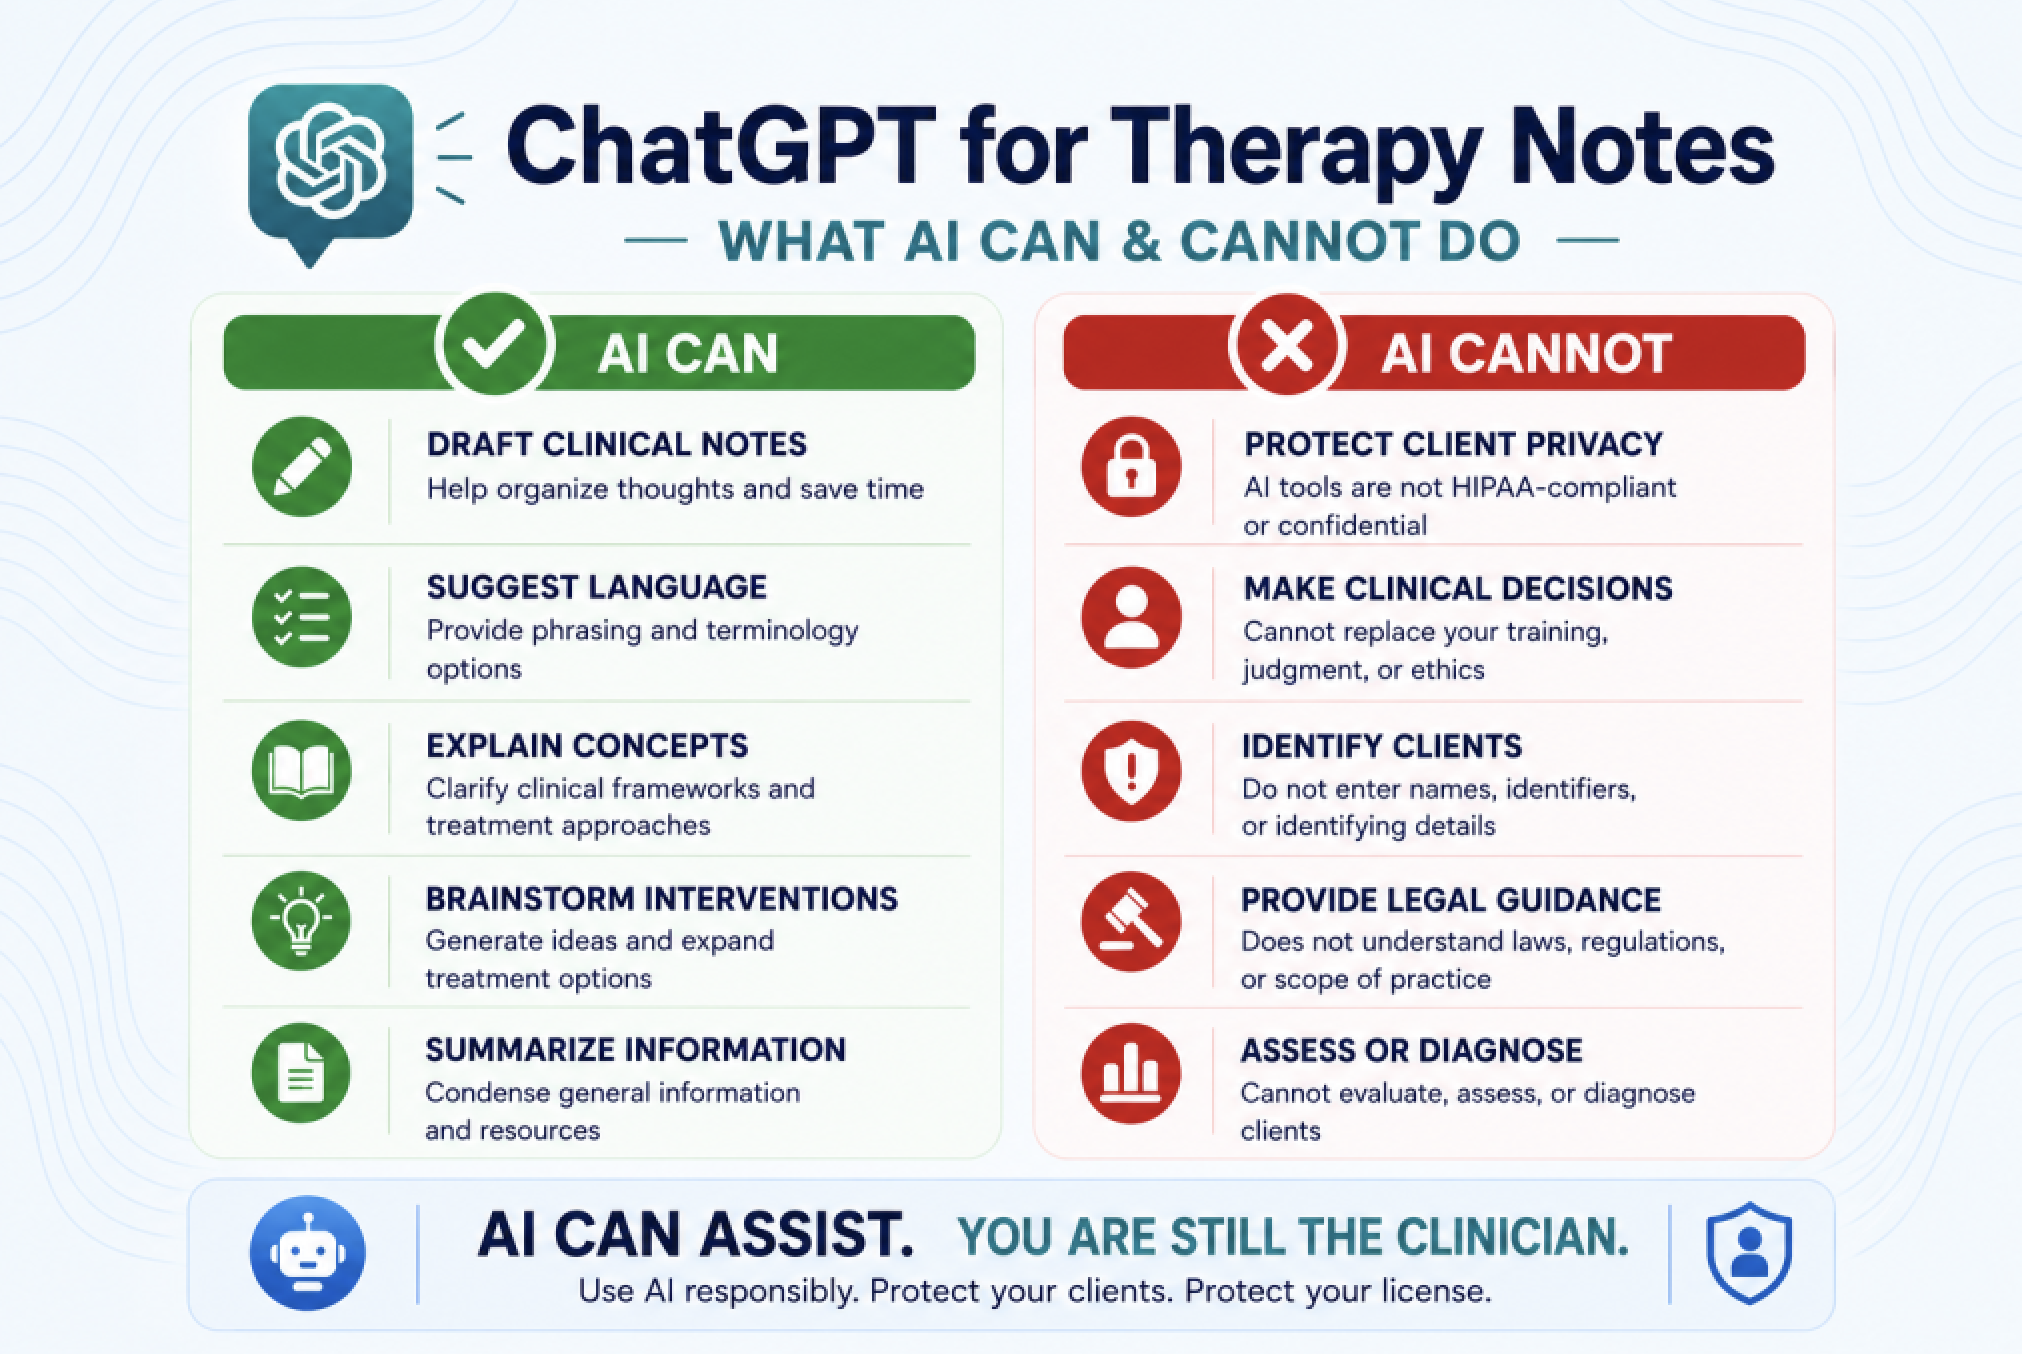
La infografía anterior delimita claramente la frontera para los profesionales clínicos, y la misma lógica se aplica a los consumidores. La AI puede redactar, resumir, explicar conceptos y generar opciones. No puede proteger la confidencialidad en el sentido de HIPAA, tomar decisiones clínicas ni evaluar y diagnosticar. La frase final, La AI puede ayudar. Tú sigues siendo el profesional clínico, es también el modelo mental correcto para el uso personal: la AI puede apoyar. Tú sigues siendo la persona responsable de obtener atención real.
Lista de comprobación de divulgación de límites
- Identificación explícita de AI. APA recomienda a los desarrolladores «divulgar de manera clara y persistente que el usuario está interactuando con una AI, no con una persona». La política de Wysa declara claramente: «La interacción con el chatbot de AI es con Inteligencia Artificial, no con una persona».
- Declaración de no diagnóstico. Busca un texto similar a: «no diagnostica, trata ni cura una condición, enfermedad o discapacidad específica».
- Sin tergiversación de credenciales. APA pide prohibir que la AI «se presente falsamente como profesional autorizado o genere credenciales fraudulentas». Un bot que se denomina «terapeuta», un término no regulado en la mayoría de los estados de EE. UU., es una señal de alerta, no una credencial.
- Enfoque de complemento, no sustituto. La posición de APA es que estas herramientas «no deben utilizarse como sustituto de un proveedor cualificado de atención de salud mental, pero pueden ser adecuadas como complemento de apoyo».
- Restricción por edad. Wysa Assure declara que «el uso de la App requiere tener 18 años o más». La evaluación de Common Sense Media se centra específicamente en el daño a adolescentes, por lo que la política de edad es una comprobación importante.
- Salvaguardas contra la dependencia. APA recomienda características de diseño que reduzcan la dependencia emocional: recordatorios para hacer pausas, menor antropomorfización y evitar disuadir a los usuarios de conversaciones en la vida real.
💬 Pruebas de límites que puedes hacer tú mismo
Pregunta directamente a la herramienta, en su propia interfaz:
«¿Eres un terapeuta autorizado? ¿Puedes diagnosticarme? ¿En qué no puedes ayudarme y qué debería hacer en su lugar?»
Una herramienta con límites sólidos responde que no, que no y te indica dónde buscar derivación. Una herramienta que evade la respuesta, interpreta el papel de un profesional clínico o afirma tener credenciales no ha superado la prueba que tienes delante; no hace falta documentación.
APA también recomienda que informes a tu proveedor real sobre las herramientas de AI que utilizas, porque «compartir esta información ayuda a los proveedores a identificar cuándo la orientación puede ser inútil, insegura o incompatible con un plan de tratamiento».
¿Cómo probar el escalamiento ante crisis antes de necesitarlo?
Prueba el escalamiento ante crisis buscando el recurso de crisis cuando estés tranquilo, contando los toques necesarios y verificando que el número sea correcto para tu país. Esta es la comprobación que la mayoría de las personas omite y la que tiene mayores consecuencias.
El estudio de Frontiers in Digital Health de 2026 presentó el Mental Health App Crisis Support Assessment Framework (MHACSAF), que puntúa seis productos comerciales de AI en siete dimensiones con un total de 65 puntos. Tres psicólogos clínicos autorizados evaluaron Wysa, Youper, Flourish, Earkick, Replika y Ash. Las puntuaciones medias oscilaron entre 13,0 y 40,3 (M = 24,9, SD = 9,3), con una sólida fiabilidad entre evaluadores (kappa de Fleiss = 0,87).
Ninguna aplicación alcanzó una calificación de «Buena» o «Excelente». Wysa obtuvo la puntuación más alta, 40,3, en el extremo superior de la banda «Adecuada». Varios productos «introdujeron barreras activas para buscar ayuda mediante enlaces rotos, líneas de ayuda no funcionales y una ausencia casi total de adaptaciones de accesibilidad».
Las siete dimensiones que vale la pena comprobar personalmente
| Dimensión | Puntos | Qué probar en la App |
|---|---|---|
| Facilidad de acceso | 12 | Cuenta los toques necesarios para llegar a un recurso de crisis desde la pantalla de inicio |
| Cobertura y priorización | — | ¿Aborda por separado la suicidalidad, el pánico, los impulsos de autolesión y la depresión grave? |
| Líneas de ayuda y servicios de emergencia | — | Llama o verifica el número: ¿está activo y es correcto? |
| Claridad del contenido | — | ¿La instrucción es inequívoca bajo estrés? |
| Accesibilidad técnica | 3 | ¿Es compatible con lectores de pantalla? ¿Tiene objetivos táctiles adecuados? |
| Ubicación e idioma | 4 | ¿Se adapta al número de emergencia de tu país? |
| Conocimiento e incorporación | 3 | ¿Te informaron de que existía la función de crisis antes de necesitarla? |
La justificación del marco para dar mayor peso a la facilidad de acceso es clínica: las personas en angustia aguda «pueden tener una capacidad deteriorada para la navegación y la toma de decisiones complejas». Como expresa el estudio, «una interfaz que oculta un número de línea de ayuda detrás de tres pantallas de navegación falla durante una crisis aguda». Una función a la que un usuario angustiado no puede llegar «está funcionalmente ausente».
⚠️ Tres pruebas de escalamiento que debes realizar hoy
- La prueba de dos toques. Desde la pantalla principal de la App, intenta acceder a un contacto de emergencia. Si requiere más de dos toques o una búsqueda, el diseño ha fallado.
- La prueba de localización. Confirma que el número de emergencia mostrado corresponde a tu jurisdicción. Los sistemas de crisis y los números de emergencia varían según el país: un número de EE. UU. en una App filipina es un callejón sin salida.
- La prueba sin conexión. Desactiva la conectividad y vuelve a abrir la App. MHACSAF puntúa la disponibilidad sin conexión porque «las crisis pueden ocurrir cuando la conectividad es limitada».
La política de Wysa también declara directamente: «En caso de crisis, llama al número de emergencia de tu país o a las líneas de ayuda aprobadas por tu institución». Esta derivación es el comportamiento correcto: una herramienta que se posiciona como la respuesta a la crisis, en lugar de como un puente hacia ella, está mal diseñada.
¿Cómo se comparan las principales opciones en las cuatro dimensiones de verificación?
Las Apps de salud mental diseñadas específicamente suelen publicar más documentación de verificación que los asistentes de propósito general, pero ninguna de las opciones satisface plenamente las cuatro dimensiones; además, los chatbots de propósito general quedan explícitamente fuera de la base de evidencia de APA para este uso.
| Dimensión | Wysa | Woebot | Asistentes de AI de propósito general | Agentes de Jenova (p. ej., Meditation Guide) |
|---|---|---|---|---|
| Documentación de privacidad | Sólida: responsable identificado, DPO, tabla de subprocesadores, ISO 27001/27701, registro ICO, NHS DSP Toolkit | Se presenta como relevante para HIPAA en comparaciones de terceros; verifica directamente el estado actual | Varía según el proveedor; términos generales de consumo, no específicos de salud | A nivel de plataforma: los datos no se utilizan para entrenar modelos públicos, cifrado en tránsito y en reposo; no es un servicio clínico cubierto por HIPAA |
| Evidencia publicada | Evaluación en el mundo real revisada por pares en JMIR mHealth; mejor puntuación en MHACSAF (40,3/65) | Ampliamente citado en comparaciones de categoría; verifica directamente los ensayos publicados actuales | APA indica que la investigación sobre chatbots de propósito general «no permite conclusiones sólidas» | Sin evidencia de ensayos clínicos: apoyo de bienestar y educativo, no tratamiento |
| Divulgación de límites | Explícita: declara que la AI no es humana, es para mayores de 18 años y no diagnostica ni trata | Verifica las divulgaciones actuales dentro del producto | Varía; APA advierte que algunos productos «responden como si fueran un terapeuta» | Los Agentes se presentan explícitamente como asistentes no clínicos; sin afirmaciones diagnósticas |
| Escalamiento ante crisis | Mayor puntuación MHACSAF de las seis evaluadas, pero solo «Adecuada»; deriva a números de emergencia locales | Incluido en revisiones de categoría; no figura una puntuación MHACSAF independiente entre las seis informadas | Inconsistente; APA califica la gestión de crisis como «limitada e impredecible» | No es un servicio de crisis: no cuenta con protocolo de escalamiento clínico; remite a servicios de emergencia |
| Precios | Plan gratuito y acceso proporcionado por instituciones; la App de consumo informa de más de 6 millones de usuarios en 105 países | Verifica directamente la disponibilidad actual para consumidores | Planes gratuitos y suscripciones de más de $20/mes | Plan gratuito; Plus $20/mes, Premium $50/mes y niveles superiores hasta Enterprise |
| Mejor para | Autoayuda estructurada de estilo CBT con la postura de privacidad publicada más sólida | Autoayuda conversacional estructurada | Reflexión no estructurada, con las advertencias de APA | Apoyo complementario de bienestar: práctica de meditación, reflexión sobre relaciones y comprensión de la personalidad; claramente fuera del ámbito clínico |
Limitación honesta del lado de Jenova: los Agentes de Jenova, como Meditation Guide para técnica de práctica y resolución de efectos adversos, o Personality Analyzer para autorreflexión estructurada, son Agentes de bienestar y educativos de propósito general. No cuentan con evidencia de ensayos clínicos, una designación de servicio clínico cubierto por HIPAA ni un protocolo de escalamiento ante crisis. Bajo el marco de APA, se incluyen en la categoría de propósito general, donde la base de evidencia es más débil. Son adecuados para la reflexión, el aprendizaje y el apoyo a la práctica; no son adecuados como sustituto de la atención ni durante una crisis.
¿Qué dicen los profesionales clínicos y los investigadores sobre verificar estas herramientas?
El consenso entre los organismos clínicos y de investigación es que la carga de verificación se ha trasladado indebidamente a los usuarios y que la postura correcta es un escepticismo estructural acompañado de criterios específicos y comprobables.
«El error más común que vemos es que las personas evalúan estas herramientas por cómo se siente la conversación en lugar de por lo que dice la documentación. La calidez es lo más fácil que puede producir un modelo de lenguaje y es la señal menos informativa sobre la seguridad. Una herramienta puede ser excepcionalmente agradable para conversar y aun así no tener una vía funcional para crisis, evidencia publicada ni una lista de subprocesadores que te hayan mostrado. La sensación no es un método de verificación.»
«La comprobación de cuatro dimensiones —privacidad, evidencia, límites y crisis— funciona porque cada dimensión es falsable de forma independiente en unos treinta minutos. Puedes encontrar el nombre del responsable o no. Puedes encontrar un estudio revisado por pares específico del producto o no. Puedes contar los toques hasta una línea de ayuda o no. Nada de esto requiere formación clínica. Lo que requiere es hacerlo antes de estar angustiado, porque todo el problema de diseño es que la angustia aguda es precisamente el momento en el que una evaluación cuidadosa se vuelve imposible.»
«El hallazgo más infravalorado de la literatura actual es que la brecha de apoyo ante crisis no es técnica. Los investigadores de Frontiers lo expresaron con precisión: «no es una brecha de capacidad técnica, es una brecha de prioridad de diseño». Todos los productos evaluados podrían implementar este trimestre una vía de emergencia localizada, disponible sin conexión y accesible en dos toques. La mayoría no lo ha hecho. Eso te indica qué debes ponderar al elegir.»
— Equipo de Producto de Jenova, 6 años desarrollando y evaluando Agentes conversacionales con AI en salud, educación y flujos de trabajo profesionales
¿Qué deberías hacer de forma diferente según quién seas?
La lista de comprobación de verificación es la misma, pero el umbral que debes exigir cambia drásticamente según el contexto: cuanto más vulnerable sea el usuario, más innegociable debe ser la documentación.
👤 Si la utilizas para ti
Realiza las cuatro comprobaciones antes de tu primera conversación sustancial. Después, adopta la monitorización de dependencia excesiva de APA: observa si «prefieres el chatbot a las relaciones humanas, ocultas su uso o pasas un tiempo excesivo con él», y evalúa si el uso «empieza a interferir con la vida, el trabajo o la seguridad».
Informa a tu proveedor si tienes uno. APA es explícita al señalar que esto «ayuda a los proveedores a identificar cuándo la orientación puede ser inútil, insegura o incompatible con un plan de tratamiento».
👨👩👧 Si eres madre, padre o cuidador
La política de edad se convierte en una barrera estricta, no en una señal débil. La evaluación de Common Sense Media se centra específicamente en el daño a adolescentes. APA recomienda vigilar «cambios preocupantes de comportamiento, pensamiento o estado emocional, como cambios en el sueño y las actividades regulares, menciones de un amigo de AI o aislamiento social».
Aborda la conversación directamente, en lugar de auditar en silencio. APA lo plantea así: si alguien «de repente empieza a hacer referencia o adoptar consejos, ideas o comportamientos de una única fuente como un chatbot, se recomienda hablar sobre la fuente y la naturaleza de la interacción».
🩺 Si eres profesional clínico
La segunda infografía de este artículo establece tu límite operativo. La AI puede redactar notas, sugerir formulaciones, explicar marcos, aportar ideas para intervenciones y resumir información general. No puede proteger la privacidad del cliente en el sentido de HIPAA, tomar decisiones clínicas, identificar clientes, proporcionar orientación jurídica ni evaluar y diagnosticar.
La guía de APA para profesionales es «preguntar proactivamente a los pacientes sobre su uso de chatbots de GenAI y Apps de bienestar» y crear «un entorno seguro y abierto para que los pacientes planteen inquietudes o preguntas sobre la orientación de las Apps». La orientación ética para la práctica profesional está publicada directamente por la American Psychological Association.
⚡ Poblaciones específicas que requieren cautela adicional
APA identifica un riesgo elevado para varios grupos:
- Ansiedad o OCD: los chatbots «pueden reforzar ciclos de retroalimentación que implican compulsiones, como la búsqueda de tranquilidad, la preocupación y la rumiación».
- Pensamiento desorganizado: las «respuestas complacientes y personalizadas pueden desestabilizar las creencias o reforzar el pensamiento delirante».
- Personas socialmente aisladas: la antropomorfización junto con la disponibilidad 24/7 puede crear «cámaras de eco de una sola persona».
- Usuarios de bajos ingresos y zonas rurales: el riesgo de dependencia es mayor «dada la falta de acceso a otras formas de atención de salud mental».
¿Con qué estándares de gobernanza debe medirse la herramienta?
Mide la herramienta frente al marco ético de AI para la salud de WHO y el aviso de salud de APA: son las dos bases de gobernanza más citadas, ambas de lectura gratuita y suficientemente específicas para contrastar un producto con ellas.
La guía de World Health Organization sobre ética y gobernanza de la inteligencia artificial para la salud es el resultado de dieciocho meses de deliberación entre expertos en ética, tecnología digital, derecho y derechos humanos, junto con funcionarios de ministerios de salud. Establece seis principios de consenso y responsabiliza a «todas las partes interesadas, tanto del sector público como del privado».
El aviso de APA añade varios requisitos para desarrolladores que puedes tratar como criterios de compra:
- Auditorías de terceros. «Antes del lanzamiento público, todos los modelos de AI destinados al bienestar o al apoyo de salud mental deben someterse a auditorías independientes de terceros sobre seguridad, eficacia, sesgo y seguridad de los datos».
- Garantía de calidad continua. APA describe las «auditorías humanas continuas de una muestra representativa de interacciones» como «la única forma escalable de supervisar los riesgos sistémicos».
- Transparencia de los datos de entrenamiento. Los responsables políticos deberían «exigir transparencia en los datos de entrenamiento requiriendo a los desarrolladores que divulguen las fuentes de datos principales utilizadas para entrenar sus modelos».
- Prohibición del fraude de credenciales. Hacer «ilegal que cualquier chatbot de AI se presente falsamente como profesional autorizado».
El planteamiento final de APA merece acompañarte en cada evaluación: «la carga de navegar estos espacios digitales arriesgados y sin regular no debería» recaer sobre los usuarios, pero hasta que la regulación se ponga al día, recae sobre ellos. Precisamente por eso un proceso repetible de cuatro comprobaciones importa más que cualquier recomendación de un único producto.
Referencias
- American Psychological Association — Aviso de salud: uso de chatbots de AI generativa y aplicaciones de bienestar para la salud mental
- Frontiers in Digital Health — Mental Health App Crisis Support Assessment Framework (MHACSAF)
- Common Sense Media — Evaluación de riesgos de Apps de salud mental con AI
- Brown University — Nuevo estudio: los chatbots de AI vulneran sistemáticamente las normas éticas de salud mental
- Wysa — Política de privacidad de la App de salud mental Assure
- Mozilla Foundation — Las principales Apps de salud mental y oración fallan en privacidad y seguridad
- JMIR mHealth and uHealth — Estudio de métodos mixtos de evaluación con datos del mundo real de un chatbot de salud mental con AI
- PubMed Central — Panorama general de las Apps móviles de salud mental basadas en chatbots
- Benediction Counseling — Revisión que señala evidencia publicada de efectividad en Apps de salud mental
- American Psychological Association — Orientación ética para la AI en la práctica profesional de la psicología
- World Health Organization — Ética y gobernanza de la inteligencia artificial para la salud