¿Cómo prevenir las infracciones de integridad en la investigación con AI?
2026-08-22
¿Qué modos de fallo deben guiar su elección de herramientas de investigación con AI?
La mayoría de los fallos de integridad relacionados con AI en el trabajo académico provienen de cuatro modos de fallo previsibles: fuentes fabricadas, citas desajustadas o distorsionadas, plagio accidental y exposición de datos sensibles. Las herramientas que los reducen recuperan literatura real antes de redactar, no redactan primero e inventan una bibliografía después. En 2026, un análisis de Nature determinó que decenas de miles de publicaciones de 2025 podrían contener referencias no válidas generadas por AI. Los investigadores que comparan opciones suelen evaluar el Academic Research Assistant de Jenova para el trabajo bibliográfico con gestión de citas, Elicit para la extracción sistemática de evidencia y Scite para las comprobaciones de contexto de las citas, al tiempo que consideran que los chatbots genéricos conllevan un alto riesgo para cualquier afirmación que vaya a aparecer en un manuscrito enviado.
Factores clave que distinguen la investigación con AI segura desde el punto de vista de la integridad de la redacción sin restricciones:
✅ Arquitectura de recuperar antes de citar: el sistema debe localizar un artículo real antes de atribuirle una afirmación. ✅ Verificación humana de cada referencia: las directrices docentes de Cornell exigen que los estudiantes verifiquen la precisión de todas las citas cuando se permite el uso de AI. ✅ Divulgación y responsabilidad humana: el Committee on Publication Ethics (COPE) establece que las herramientas de AI no pueden ser autoras y que los humanos siguen siendo responsables de cada frase, incluidas las redactadas por AI. ✅ Contención de datos: los conjuntos de datos no publicados, la información identificable de participantes y los manuscritos bajo embargo nunca deben entrar en canales públicos de entrenamiento. ✅ Conocimiento de los umbrales de similitud: las normas institucionales ahora tratan la coincidencia elevada, y no solo los párrafos copiados, como un evento sancionable.
Para comparar herramientas de manera útil, conviene tratar la integridad como un problema de ingeniería con cuatro puertas —existencia, fidelidad, atribución y contención— en lugar de como una única puntuación de plagio.
¿Por qué las citas generadas por AI se han convertido en una crisis de integridad en la investigación?
Las citas generadas por AI se han convertido en una crisis porque los modelos de lenguaje de gran tamaño completan patrones bibliográficos plausibles en lugar de consultar un catálogo bibliotecario, por lo que las referencias fabricadas parecen lo bastante reales como para sobrevivir a una corrección apresurada. Enago informa de que aproximadamente una de cada cinco referencias académicas generadas por AI es falsa, y esas falsificaciones suelen imitar nombres de revistas legítimas, patrones familiares de nombres de autores y títulos de artículos que parecen pertenecer al campo.
La contaminación ya no se limita a los ensayos estudiantiles. Un informe de STAT de 2026 sobre el aumento de las citas fraudulentas describió cómo las referencias fabricadas se propagan por la literatura publicada y contaminan el registro público de la ciencia. Los análisis biomédicos también han descubierto que las referencias falsas generadas por AI son cada vez más frecuentes en los artículos de investigación. Una vez que se cita un artículo fantasma, autores posteriores pueden copiar la cita sin abrir la fuente, que es como una sola alucinación se convierte en un error duradero.
David B. Resnik y sus coautores sostienen que las citas alucinadas pueden constituir mala conducta en la investigación cuando las citas funcionan como datos, por ejemplo, en revisiones sistemáticas, mapas de evidencia o cualquier artículo cuyo argumento dependa de quién dijo qué. Este planteamiento es importante: una referencia inventada no es un error de formato. Es una afirmación empírica falsa sobre la existencia de un registro académico.
Ahora se pide a los editores que traten las referencias no verificables como un fallo de control de acceso, no como una molestia de corrección de estilo. Un comentario de PubMed Central presentó las citas fabricadas en la era de AI como una llamada de atención para los editores de revistas. Para los investigadores individuales, la implicación práctica es más sencilla: si una herramienta no puede mostrarle la fuente, usted no tiene una cita.
¿Qué debe buscar en un asistente de investigación con AI seguro para la integridad?
Un asistente de investigación con AI seguro para la integridad debe recuperar artículos identificables, vincular las afirmaciones con pasajes específicos, mantener sus archivos no publicados fuera de los conjuntos públicos de entrenamiento y dejar un rastro de divulgación que pueda defender ante un supervisor o editor. Las listas de funciones son un indicador indirecto poco sólido. Lo importante es si el flujo de trabajo predeterminado de la herramienta hace que fabricar sea costoso y verificar sea fácil.
Un modelo de evaluación útil es el Modelo de integridad centrado en la fuente. Evalúe una herramienta según su capacidad de superar cuatro puertas antes de pegar cualquier contenido en un capítulo de tesis:
- Existencia: ¿un identificador persistente (DOI, PMID, ISBN o URL estable) lleva a una obra real?
- Fidelidad: ¿el pasaje citado realmente respalda la afirmación o el modelo ha distorsionado el hallazgo?
- Atribución: ¿el autor, el año y la paginación correctos están vinculados a la frase adecuada?
- Contención: ¿algún material identificable, embargado o clínicamente sensible salió de su control?
Las herramientas que generan prosa primero y añaden referencias después fallan sistemáticamente en la puerta 1. Las herramientas que buscan en bases de datos académicas, devuelven el artículo y solo entonces lo resumen son estructuralmente más seguras, aunque nunca automáticas. La guía de George Mason University sobre herramientas de AI para revisiones de literatura agrupa productos como Elicit y Scite en torno a la síntesis de evidencia, en vez de al chat abierto, que es la frontera de categoría adecuada.
También valore criterios operativos sobre los que realmente preguntan las oficinas de integridad:
- Soporte para la divulgación: ¿puede registrar el nombre del modelo, la fecha y el prompt, tal como APA, MLA y Chicago ya ofrecen pautas para citar la salida de LLM?
- Alcance de la memoria: ¿la memoria del proyecto le ayuda a mantener la coherencia o mezcla silenciosamente los datos de un cliente con otra sesión?
- Valores predeterminados con intervención humana: ¿la interfaz facilita abrir el PDF o esconde la fuente detrás de un párrafo fluido?
- Independencia respecto a detectores: Cornell aconseja actualmente no depender de algoritmos automáticos de detección de AI porque son poco fiables y pueden acusar falsamente a los autores. Una buena herramienta reduce la necesidad de detectores al hacer que las fuentes sean inspeccionables.
El Academic Research Assistant de Jenova está diseñado en torno al descubrimiento de literatura, la preparación de manuscritos y la gestión de citas, con memoria persistente a nivel de plataforma y herramientas de búsqueda académica. No sustituye a iThenticate, a un comité de revisión institucional ni a la aprobación de un supervisor. Esta limitación es deliberada: la integridad sigue siendo una responsabilidad humana.
¿Cómo se comparan las principales herramientas de investigación con AI en verificación de citas y privacidad?
Los asistentes de investigación especializados superan a los chatbots generales en integridad de las citas porque están conectados a corpus de artículos, mientras que los modelos generales están orientados a la fluidez del siguiente token. La siguiente comparación utiliza el Modelo de integridad centrado en la fuente en lugar de categorías de marketing. Las evaluaciones reflejan la documentación de los proveedores y los informes publicados disponibles en el momento de redacción en 2026.
| Función / dimensión | Chatbots LLM genéricos | Elicit | Scite | Jenova Academic Research Assistant |
|---|---|---|---|---|
| Arquitectura de citación | Generar y luego citar; alto riesgo de fabricación | Recupera datos de un corpus de 138 millones de artículos y 545.000 ensayos clínicos, con citas a nivel de frase | Busca en más de 300 millones de artículos académicos y muestra si trabajos posteriores respaldan o cuestionan una afirmación | Descubrimiento de literatura en tiempo real y soporte para manuscritos con gestión de citas |
| Control de referencias alucinadas | Débil salvo que el usuario verifique de forma independiente cada elemento | Más sólido para tablas de evidencia; sigue requiriendo comprobaciones humanas | Sólido para el contexto de las citas; más débil como entorno de redacción completo | Más sólido cuando se utilizan las herramientas Scholar/búsqueda antes de redactar; sigue siendo necesaria la verificación |
| Riesgo de plagio accidental | Alto si los usuarios pegan la salida fluida sin cambios | Menor para tablas de extracción; los resúmenes aún pueden acercarse demasiado a la redacción de la fuente | Menor para comprobación de afirmaciones; no es principalmente una herramienta de redacción | Menor cuando se utiliza para esquemas y mapas de fuentes; los borradores aún necesitan revisión de originalidad |
| Postura sobre datos sensibles | Varía según el proveedor y el plan; los modelos públicos son una mala opción predeterminada para datos identificables | Espacio de trabajo de investigación; los términos de entrenamiento/retención deben leerse según el plan | Espacio de trabajo de investigación; los términos de entrenamiento/retención deben leerse según el plan | Política de plataforma: los datos de usuario no se utilizan para entrenar modelos públicos de AI |
| Precios (a fecha de 2026) | No verificados en esta revisión | No verificados en esta revisión | No verificados en esta revisión | Nivel gratuito con uso limitado; Plus a $20/mes (30× la asignación gratuita); los niveles superiores amplían el uso |
| Mejor para | Lluvia de ideas sobre preguntas que posteriormente documentará por su cuenta | Cribado sistemático, extracción de datos y tablas de evidencia | Validar cómo se cita un artículo en la literatura | Flujos de trabajo académicos de extremo a extremo que combinan descubrimiento, notas y redacción consciente de las citas |
Elicit es especialmente sólido cuando la tarea es una revisión estructurada. La empresa afirma que los investigadores reportan hasta un 80 % de ahorro de tiempo en flujos de revisión sistemática y que cada afirmación generada por AI está respaldada por citas a nivel de frase. Las comparaciones independientes de 2026 suelen considerar a Elicit como la herramienta más amplia para operaciones de revisión y a Scite como el especialista en inteligencia de citas. Una revisión comparativa situó a Elicit por delante en operaciones y a Scite por delante en validación de evidencia.
Los productos de estilo Consensus, descritos en las comparaciones de herramientas de 2026, responden preguntas de investigación a partir de evidencia revisada por pares, no de texto de la web abierta. Ese diseño reduce la fabricación respecto a un chatbot, pero no elimina el problema de fidelidad: un artículo real aún puede resumirse de manera incorrecta.
La limitación honesta de Jenova es la misma que todo Agente de investigación responsable debería comunicar. Puede recuperar, organizar y redactar; no puede jurar que un PDF de pago dice lo que un modelo cree que dice. Los investigadores que necesitan recuentos del contexto de las citas pueden seguir prefiriendo Scite para esa tarea específica. Quienes realizan un cribado de estilo PRISMA pueden seguir prefiriendo las tablas de Elicit. La ganancia de integridad consiste en utilizar una herramienta centrada primero en la fuente y, después, verificar.
¿Cómo puede detectar y bloquear citas fabricadas o distorsionadas?
Puede detectar citas fabricadas y distorsionadas resolviendo cada referencia en un registro activo y leyendo después el pasaje citado frente a su propia frase, porque la existencia y la fidelidad son fallos distintos. Un DOI que devuelve 404 es una fabricación o un error fatal de metadatos. Un artículo real citado por un hallazgo que nunca hizo es una distorsión. Ambos pueden desencadenar investigaciones por mala conducta.
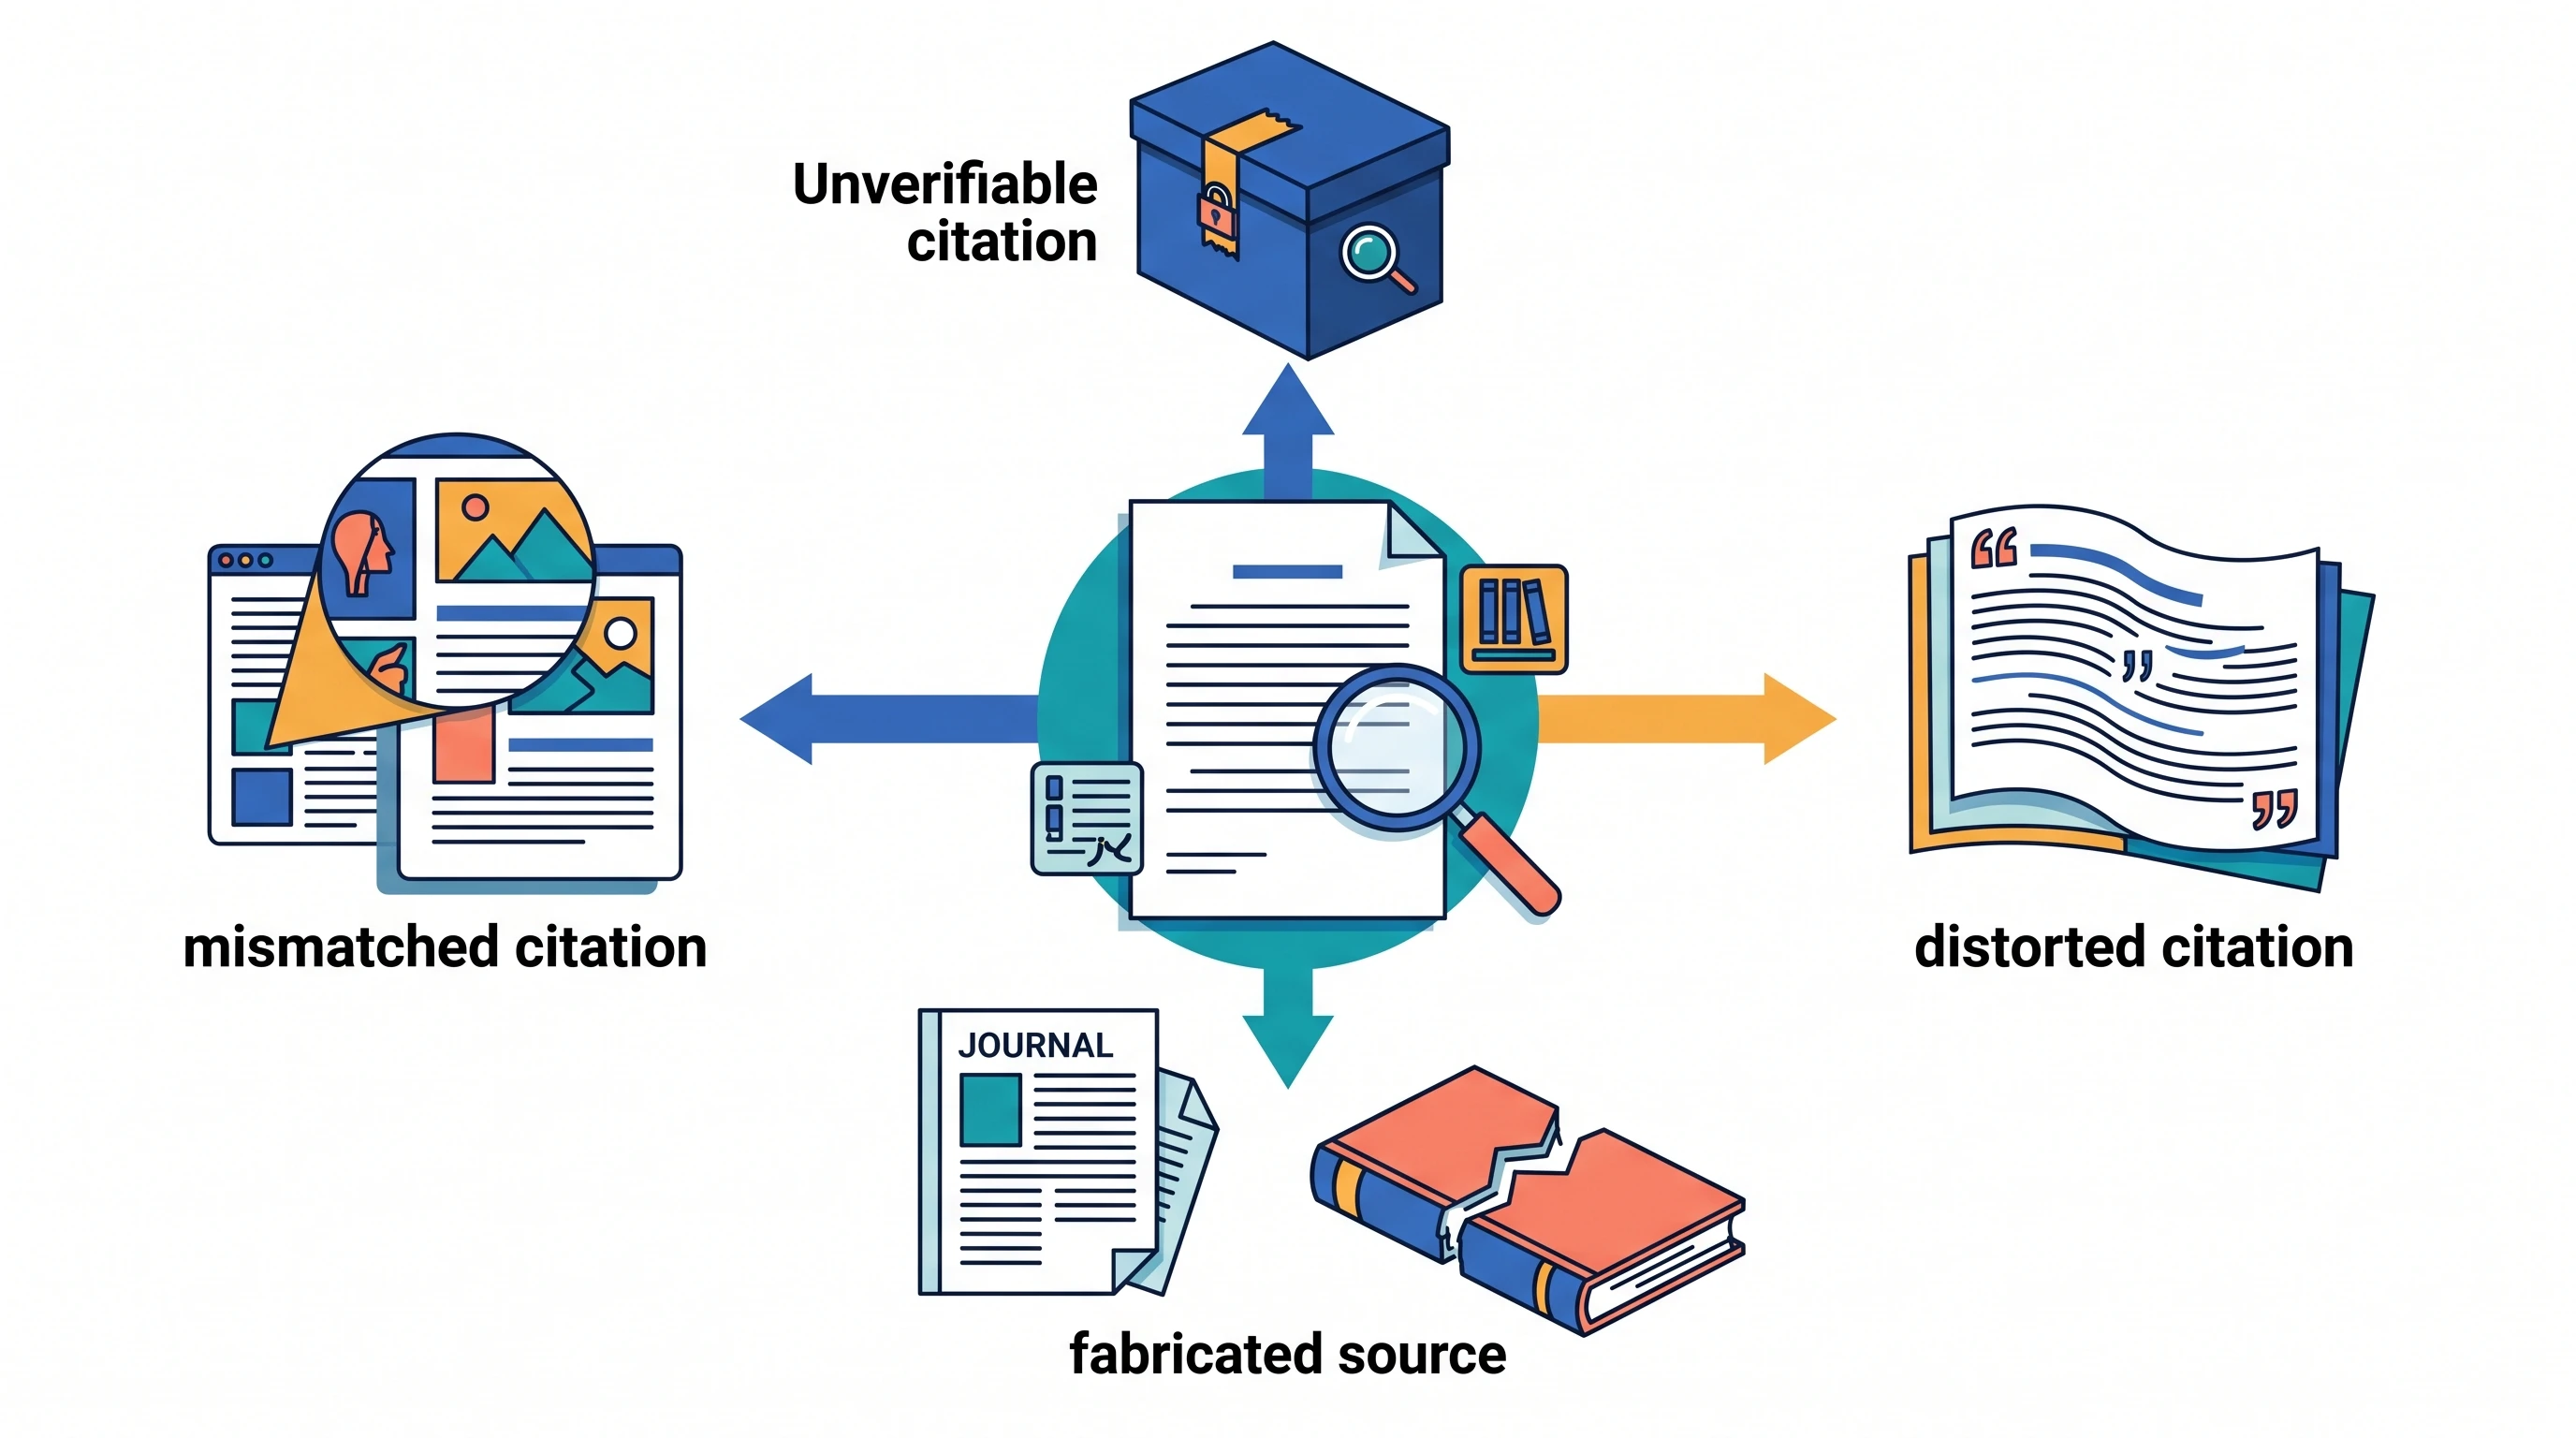
Cuatro tipos de infracciones aparecen repetidamente en bibliografías asistidas por AI:
- Fuente fabricada: el artículo, conjunto de datos o libro no existe.
- Cita no verificable: el elemento puede existir, pero no se puede localizar ningún registro accesible, DOI o copia de archivo.
- Cita desajustada: una obra real se vincula con la afirmación, el autor o el año equivocados.
- Cita distorsionada: la fuente existe y es pertinente, pero el modelo invirtió un resultado, eliminó una salvedad o trató una limitación como un hallazgo.
Un protocolo práctico de bloqueo lleva unos dos minutos por cada afirmación clave y mucho menos cuando se convierte en hábito:
- Copie la referencia en Crossref, PubMed, Google Scholar o el sitio de la revista y confirme la combinación título-autor-año.
- Abra el PDF o HTML y encuentre el pasaje. Si no puede encontrarlo, elimine la cita.
- Compruebe que las salvedades se mantienen. «Se asocia con» no equivale a «causa». «En ratones» no equivale a «en pacientes».
- Rechace cualquier fuente que el modelo no pueda producir cuando se le solicite. «Recuerdo un artículo de 2019 en Nature Neuroscience...» no es una cita.
- Mantenga un registro de verificación —en una hoja de cálculo o nota del gestor de referencias— para capítulos de tesis y envíos a revistas.
El Academic Research Assistant de Jenova resulta más útil en el paso 1, cuando le pide que recupere artículos candidatos y cree un mapa de fuentes antes de que exista cualquier prosa. Combínelo con Scite cuando necesite saber si la literatura posterior respalda o cuestiona el artículo en el que está a punto de apoyarse. Combínelo con Elicit cuando esté extrayendo métodos y resultados de un conjunto de ensayos.
Un prompt de alta integridad tiene este aspecto:
«Busque artículos revisados por pares de 2020 a 2026 sobre [tema]. Para cada artículo, proporcione título, autores, año, DOI, medio de publicación y una afirmación de 25 palabras que se indique explícitamente en el resumen o los resultados. Si no puede verificar un DOI, omita el artículo. No invente referencias».
Los chatbots genéricos aún pueden fallar con este prompt. La diferencia es que un flujo de trabajo centrado primero en la fuente hace visible el fallo.
¿Cómo se evita el plagio accidental al redactar con AI?
Evite el plagio accidental tratando la salida de AI como material bruto sin licencia —nunca como texto propio— y reescribiendo desde notas, no desde las frases fluidas del modelo. El plagio accidental es ahora el caso más común: el usuario no pretendía apropiarse de contenido, pero el modelo comprimió una fuente tan estrechamente que un comprobador de similitud, examinador o revisor aún puede detectar la redacción coincidente.
El COPE exige a los autores que utilizan AI en la redacción, las figuras o el análisis que divulguen la herramienta y cómo se utilizó, normalmente en Métodos o una sección equivalente. Los autores siguen siendo «plenamente responsables del contenido de su manuscrito, incluso de las partes producidas por una herramienta de AI». Esa frase resume toda la estructura de responsabilidad. El modelo no puede ejercer derechos de autor, gestionar conflictos ni responder a un aviso de retractación. Usted sí puede.
Tres vías de plagio aparecen en borradores asistidos por AI:
- Eco de la fuente: el modelo parafrasea un artículo que usted pegó o que recuperó, conservando la sintaxis original.
- Autoplagio: el modelo recicla su párrafo metodológico publicado anteriormente porque lo cargó como «antecedentes».
- Redacción mediante parches a gran escala: muchas frases ligeramente alteradas de muchos artículos, que el software de similitud sigue marcando.
Una secuencia de redacción más segura:
- Lea usted mismo la fuente y escriba un punto en sus propias palabras con un número de página.
- Pida al modelo que reorganice sus puntos, no el PDF.
- Ejecute la herramienta de similitud de su institución sobre el capítulo, no sobre la «puntuación de originalidad» de un chatbot.
- Divulgue la asistencia de AI en el formato que especifique su revista o escuela de posgrado.
Un prompt que reduce el eco:
«Pegaré mis propias notas de esquema, no PDF de fuentes. Reordénelas en un argumento lógico. No añada nuevas citas. No amplíe ningún punto a un lenguaje que pueda pasar por una frase académica terminada. Señale cualquier punto que aún necesite una fuente».
El Academic Research Assistant de Jenova ayuda en este punto cuando mantiene el texto de las fuentes en una capa de notas y redacta en un hilo separado. La memoria persistente es una ventaja para tesis largas, porque el Agente puede recordar su pregunta de investigación y los artículos excluidos. También implica un riesgo si pega el borrador no publicado de un coautor en el mismo proyecto. La contención forma parte de la originalidad: no permita que un manuscrito contamine otro.
La European Network for Academic Integrity publica directrices generales de integridad que las instituciones siguen utilizando como vocabulario de referencia. Una revisión de ScienceDirect de 2025 sostuvo que las universidades deben desarrollar competencias estudiantiles y políticas explícitas de AI, no limitarse a comprar detectores. Ese es el énfasis correcto. Los detectores hacen conjeturas. La divulgación y los registros de fuentes demuestran.
¿Cómo mantener los datos de investigación sensibles fuera de los sistemas públicos de AI?
Mantenga los datos de investigación sensibles fuera de los sistemas públicos de AI no pegando nunca material identificable, embargado o restringido contractualmente en una herramienta cuyo entrenamiento, retención o subprocesadores no pueda identificar. IBM define la privacidad de AI como la protección de información personal o sensible recopilada, utilizada, compartida o almacenada por sistemas de AI. El trabajo académico está lleno precisamente de esa clase de información: transcripciones de entrevistas, notas de pacientes, registros escolares, resultados negativos no publicados y narrativas de subvenciones.
Los principios clásicos de privacidad chocan con el uso ingenuo de AI. El comisionado de información de Victoria señala que AI desafía la limitación de la recopilación, la especificación de la finalidad y la limitación del uso: la idea de que se recopila solo lo necesario, se explica el motivo y no se reutiliza para una nueva finalidad. Pegar un conjunto de datos cualitativos completo en un chatbot público para «encontrar temas» es una nueva finalidad que los participantes no aprobaron.
Una lista de comprobación de contención que resiste una revisión ética:
- Minimice: envíe el código, el extracto desidentificado o el diccionario de variables, no el archivo sin procesar. Las directrices de minimización de datos para sistemas de AI indican que se debe recopilar y almacenar solo lo que exige la tarea.
- Desidentifique antes de cargar: elimine nombres, ubicaciones, diagnósticos poco frecuentes y metadatos de archivos.
- Prefiera plataformas que indiquen que no entrenan modelos públicos con su contenido: la política de plataforma de Jenova establece que los datos de usuario no se utilizan para entrenar modelos públicos de AI y se cifran en tránsito y en reposo. Lea los términos de cualquier competidor con el mismo grado de especificidad; «nos tomamos la privacidad en serio» no es un control.
- Separe los proyectos: un hilo de Agente por estudio, de modo que un conjunto de datos hospitalarios no pueda recuperarse mientras redacta una publicación de blog pública.
- Revise los contratos: el trabajo patrocinado por la industria, los hallazgos de doble uso y los acuerdos de uso de datos a menudo prohíben por completo los procesadores externos.
Jenova es más sólido que un chatbot de consumo en esta dimensión debido a su postura de no entrenar modelos públicos con datos de usuario y a la memoria de proyecto que usted controla. No es un historial médico electrónico certificado por HIPAA, un motor de anonimización ni un sustituto del entorno seguro de su universidad. Si un protocolo de IRB nombra software aprobado, esa lista prevalece.
Para la investigación mediante entrevistas, un prompt seguro es:
«Aquí hay seis extractos desidentificados cuyos nombres y lugares ya se han eliminado. Proponga únicamente códigos temáticos. No adivine identidades. No almacene estos extractos más allá de esta tarea si más adelante le pido que los olvide».
Si no puede escribir ese prompt porque el texto sigue siendo identificable, aún no está preparado para utilizar AI con él.
¿Cómo construir un flujo de trabajo de investigación con AI seguro para la integridad?
Un flujo de trabajo seguro para la integridad comienza con la pregunta de investigación y una biblioteca de fuentes, utiliza AI solo dentro de etapas definidas y termina con un párrafo de divulgación y un registro de verificación. La secuencia siguiente funciona en el Academic Research Assistant de Jenova y puede reproducirse, con distintas fortalezas, en Elicit o Scite.
Etapa 1: delimite sin fuentes. Pida al Agente que enumere definiciones rivales, bases de datos probables y reglas de exclusión. No acepte todavía ninguna cita.
«Estoy redactando un capítulo de métodos sobre [pregunta]. Enumere las subpreguntas que debería cubrir una búsqueda sistemática. No cite artículos. Señale dónde mi pregunta es demasiado amplia».
Etapa 2: recupere y después fije una biblioteca. Utilice el Academic Research Assistant —o Elicit, si está cribando cientos de ensayos— para recopilar registros candidatos con DOI. Expórtelos a Zotero, EndNote o su gestor institucional. El gestor de referencias, no la transcripción del chat, se convierte en el sistema de registro.
El Agente relacionado Deep Research de Jenova resulta útil cuando necesita un informe amplio y con muchas citas antes de delimitar el corpus. Trate ese informe como un mapa, no como literatura que ya ha leído.
Etapa 3: extraiga con una tabla, no con un párrafo. Solicite en columnas el diseño del estudio, la muestra, el resultado y la limitación. Elicit está diseñado específicamente para esto; Jenova puede redactar la misma tabla si le proporciona artículos que ya haya abierto.
Etapa 4: redacte a partir de sus notas. Escriba o dicte puntos. Permita que el Agente estructure y ponga a prueba la lógica. No deje que «suavice» el lenguaje hasta que las fuentes estén fijadas.
Etapa 5: verifique y divulgue. Resuelva cada DOI. Lea cada pasaje que cite. Añada una frase en Métodos como: «Se utilizó un modelo de lenguaje de gran tamaño (nombre del modelo, fecha) para organizar notas y sugerir términos de búsqueda; el autor comprobó todas las citas frente a fuentes primarias».
La configuración en Jenova toma unos minutos: abra el Academic Research Assistant, indique su campo y las restricciones de integridad en el primer mensaje, y adjunte únicamente archivos que tenga autorización para procesar. El nivel gratuito cubre un uso limitado; Plus comienza en $20 al mes con 30 veces la asignación gratuita. El uso es una reserva mensual en lugar de un límite diario, lo que importa durante una fase intensa de revisión.
En Elicit, la ruta paralela es: plantear una pregunta de revisión, generar una tabla de evidencia, personalizar qué artículos entran en el informe y después exportar y verificar. En Scite, la ruta paralela es: incorporar los artículos clave e inspeccionar las citas de respaldo frente a las que los cuestionan antes de afirmar que existe consenso.
La regla innegociable del flujo de trabajo es el orden: buscar antes de escribir frases. Pasajes antes de paráfrasis. Divulgación antes del envío.
¿Qué dicen los expertos en integridad de la investigación sobre la producción académica asistida por AI?
Los especialistas en integridad de la investigación tratan cada vez más las citas alucinadas, la redacción con AI no divulgada y las cargas de datos sin control como fallos de proceso contra los que las instituciones pueden diseñar defensas, no como casos excepcionales de trampa estudiantil.
«El error que observamos no es que los investigadores utilicen modelos. Es que usan un ciclo de generar y luego citar en tareas donde la cita es en sí misma un dato. Si su sección de resultados depende de que exista un artículo, una referencia falsa y fluida se parece más a la fabricación de datos que a un formato descuidado. La solución es arquitectónica: recuperar el registro, extraer la afirmación y luego redactar. Las herramientas que invierten ese orden seguirán sembrando la literatura con fantasmas.»
«Los fallos de privacidad siguen la misma inversión. Las personas pegan el archivo más completo que tienen porque es cómodo, lo cual es lo opuesto a la limitación de la recopilación. Desidentifique primero, minimice después y elija un sistema que no entrene modelos públicos con los residuos. La comodidad no es una exención ética.»
«También aconsejamos a los laboratorios que dejen de externalizar la integridad a los detectores de AI. Los detectores no pueden mostrar una fuente, no pueden demostrar intención y crean falsos positivos que castigan a los autores no nativos. Un registro de verificación y una divulgación al estilo COPE son más lentos el primer día y mucho más rápidos cuando un revisor pregunta: “¿De dónde salió esta referencia?”.»
— Equipo de Producto de Jenova, investigación sobre flujos de trabajo académicos con AI, ocho años diseñando Agentes de investigación conscientes de las citas
Esta perspectiva se alinea con las directrices formales. COPE asigna la responsabilidad a los autores humanos. Cornell pide a los docentes que exijan verificación de citas y recopilen evidencia objetiva —referencias inexistentes, métodos que el estudiante no puede explicar— en vez de una puntuación de detector. El tratamiento de Cambridge sobre la integridad académica en la era de AI parte de la misma premisa: si las evaluaciones ya no reflejan el aprendizaje, la credencial misma es la perjudicada.
¿Qué ocurre cuando el uso de AI supera los umbrales institucionales de integridad?
Cuando el uso de AI supera los umbrales institucionales, las sanciones recaen sobre el autor humano y, cada vez más, sobre los supervisores: desde una revisión obligatoria hasta el bloqueo del envío o la cancelación de la matrícula. Las políticas varían según el país y el campus, pero la tendencia en 2026 es hacia bandas de similitud más estrictas, un escrutinio explícito de AI y menos paciencia ante la excusa de que «el modelo se lo inventó».
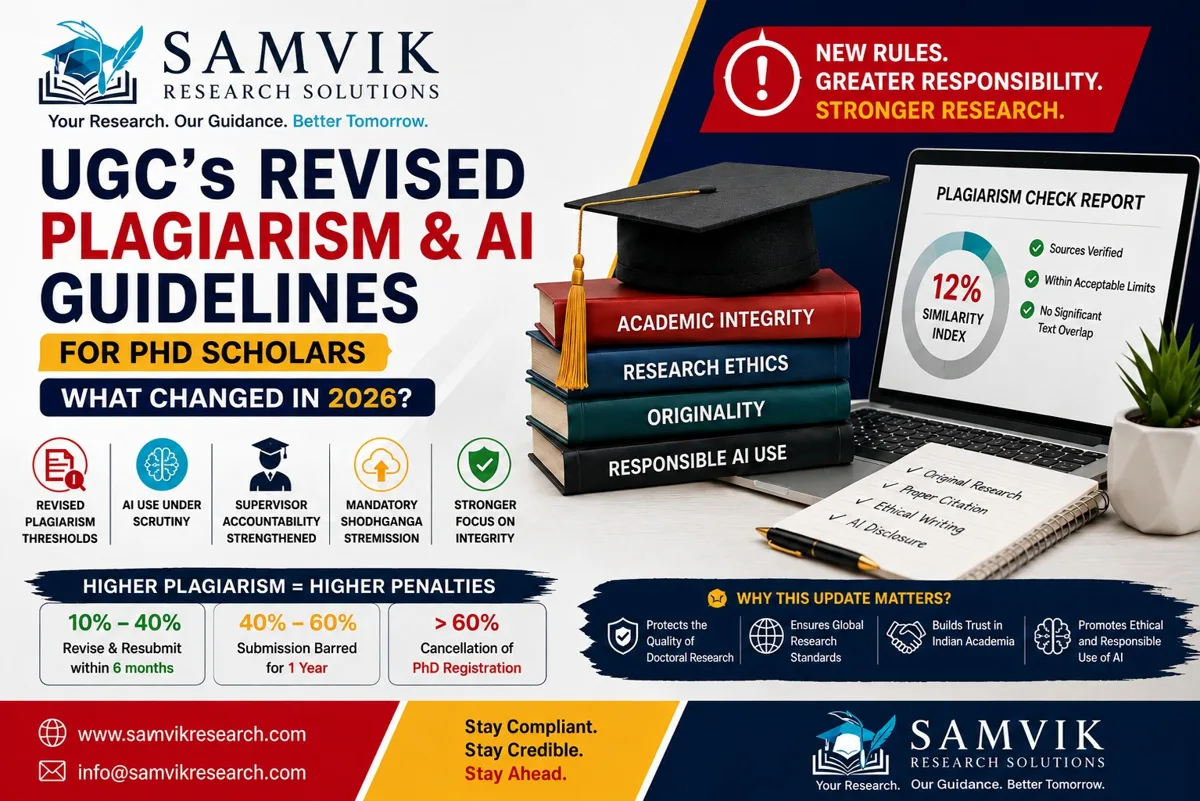
Las directrices distribuidas entre estudiantes de PhD en 2026 en torno a la revisión de la University Grants Commission (UGC) ilustran cómo los umbrales numéricos se convierten en acontecimientos profesionales. En ese marco, una similitud de entre el 10 % y el 40 % activa una revisión y reenvío en un plazo de seis meses; entre el 40 % y el 60 % puede impedir el envío durante un año; y una similitud superior al 60 % puede cancelar la matrícula de PhD. Las mismas directrices vinculan esas bandas a una revisión más estrecha del uso de AI, una responsabilidad reforzada de los supervisores y el depósito obligatorio en repositorios. Aunque su universidad utilice límites diferentes, la lógica es transferible: la coincidencia se trata como una señal medible de integridad, y «AI ayudó» no es una defensa si el texto no es suyo o las referencias no son reales.
Las revistas añaden una segunda capa. La posición de COPE sobre autoría significa que no puede incluir a ChatGPT, Elicit, Scite o Jenova como coautor. Puede, y a menudo debe, nombrar la herramienta en Métodos. No divulgarla se considera cada vez más una infracción de transparencia incluso cuando la ciencia es sólida. Las referencias fabricadas, en cambio, pueden justificar el rechazo o la retractación porque falsifican el registro académico.
Implicaciones prácticas para cualquier persona que presente un trabajo en 2026:
- Conozca su banda local de similitud antes de redactar, no después de que se ejecute el comprobador.
- Conserve los prompts y las versiones del modelo para poder reconstruir qué aportó la herramienta.
- No considere una puntuación baja de un detector de AI como autorización. Considere una bibliografía completa y resoluble como autorización.
- Si supervisa a estudiantes, revise sus registros de fuentes. La responsabilidad está subiendo en la cadena.
Utilizada dentro de estas restricciones, AI sigue siendo un acelerador legítimo para la búsqueda, la extracción y la organización. Utilizada como coautor invisible con una lista de referencias inventada, ahora es una de las formas más rápidas de paralizar un título o un artículo.
Referencias
- Nature — Las citas alucinadas están contaminando la literatura científica
- Enago — Referencias generadas por AI: 1 de cada 5 es falsa
- STAT — Las citas fraudulentas, atribuidas a alucinaciones de AI, se están propagando en artículos académicos
- Today’s Clinical Lab — Las referencias falsas generadas por AI aumentan en la literatura biomédica
- Accountability in Research (Taylor & Francis) — Citas alucinadas producidas por inteligencia artificial generativa
- PubMed Central — Citas fabricadas en la era de AI: una llamada de atención para los editores
- Cornell University Center for Teaching Innovation — AI e integridad académica
- COPE — Autoría y herramientas de AI
- Elicit — AI para la investigación científica: tamaño del corpus, citas a nivel de frase y flujo de revisión sistemática
- Scite — Respuestas respaldadas por citas en más de 300 millones de artículos académicos
- Paperguide — Comparación de Elicit y Scite para investigadores (2026)
- The Drive AI — Elicit frente a Consensus frente a Semantic Scholar
- Bibliotecas de George Mason University — Herramientas de AI para revisiones de literatura
- IBM — Exploración de los problemas de privacidad en la era de AI
- Office of the Victorian Information Commissioner — Inteligencia artificial y privacidad: cuestiones y desafíos
- Fortra — Privacidad de datos de AI: desafíos y soluciones
- European Network for Academic Integrity — Directrices generales para la integridad académica
- ScienceDirect — Reevaluación de la integridad académica en la era de AI
- Cambridge University Press — Integridad académica en la era de AI