¿Cómo puedes mantener coherentes la personalidad, la historia y los nombres de un compañero de AI entre conversaciones?
2026-08-17
¿Qué tres capas controlan realmente la coherencia de un compañero de AI?
La coherencia de un compañero de AI está controlada por tres capas distintas: la definición de la persona (quién es el personaje), el almacén de memoria (lo que el sistema conserva entre sesiones) y el contexto de sesión (lo que cabe en la ventana de conversación activa). La deriva aparece cuando estas capas se contradicen entre sí, no porque el modelo haya «olvidado». Corregir la coherencia implica auditar las tres por separado, y la plataforma que uses determina cuánto control tienes sobre cada una.
Entre las principales plataformas de compañeros analizadas en 2026, la calidad de la memoria varía de forma drástica. Nomi AI produce notas estructuradas a partir de las conversaciones y recordó 23 de 25 detalles introducidos deliberadamente semanas después en pruebas independientes, mientras que Character.AI prácticamente no tiene memoria a largo plazo y olvida la mayoría de los detalles entre sesiones. Los agentes de juego de rol y personajes de Jenova pertenecen a una categoría diferente: memoria persistente entre sesiones con historial de chat ilimitado, pero diseñada en torno a instrucciones creadas por el usuario, no a un modelo de relación propio de una App de compañía.
Factores clave que diferencian a los compañeros de AI estables de los que sufren deriva:
✅ La persona se redacta una vez y de forma canónica: no se vuelve a explicar de manera improvisada en cada chat nuevo
✅ El almacén de memoria se depura, no solo se acumula: se eliminan activamente los duplicados y los datos triviales
✅ Los nombres y las anclas de identidad se reiteran periódicamente: cada 15-20 turnos en sesiones largas
✅ El contenido de juego de rol se separa de la memoria factual: la ficción no debe contaminar el almacén de hechos
✅ La plataforma admite memoria persistente: muchos planes gratuitos no la incluyen
Para corregir la deriva de forma sistemática, en lugar de recurrir a la prueba y error, ayuda entender primero por qué ocurre.
¿Por qué los compañeros de AI olvidan su propia personalidad y sus nombres?
Los compañeros de AI sufren deriva porque los modelos de lenguaje no tienen memoria persistente nativa: cada «recuerdo» es un mecanismo de recuperación añadido sobre un modelo sin estado. El modelo no recuerda el nombre de tu compañero; vuelve a leer un archivo de texto que contiene ese nombre antes de cada respuesta y, si la recuperación falla o la ventana de contexto se llena, el nombre simplemente no está presente en la entrada del modelo.
Las limitaciones técnicas están bien documentadas. Los primeros modelos neuronales tenían dificultades para mantener el contexto a largo plazo y usaban principalmente memoria a corto plazo, e incluso las arquitecturas transformer modernas afrontan costes computacionales elevados, retención desigual de información y posibles sesgos al gestionar interacciones prolongadas. La memoria a largo plazo se incorpora mediante tres enfoques principales: ventanas de contexto ampliadas, generación aumentada por recuperación frente a una base de datos externa y módulos de memoria integrados como MemoryBank, que almacenan, recuperan y actualizan recuerdos a lo largo del tiempo.
Los cuatro modos de fallo, ordenados según la frecuencia con la que provocan una deriva visible:
- Expulsión del contexto: la definición de la persona sale de la ventana activa durante sesiones largas. Es la causa más habitual de cambios de personalidad a mitad de conversación.
- Fallo de recuperación: el almacén de memoria contiene el hecho, pero la búsqueda semántica no logra mostrarlo en el turno actual. Es una causa frecuente de nombres olvidados.
- Colapso por contradicción: el almacén guarda dos hechos en conflicto (el compañero tiene «28» años en una nota y «31» en otra) y el modelo elige de forma arbitraria.
- Contaminación por juego de rol: acontecimientos ficticios se escriben en el almacén de memoria factual como si fueran ciertos, corrompiendo la historia canónica.
Cada modo de fallo requiere una corrección diferente. Tratar toda la deriva como «la AI es tonta» conduce a la intervención equivocada.
¿Qué debe incluir realmente un documento canónico de persona?
Un documento canónico de persona debe ser un único bloque estructurado de 200-400 palabras que contenga anclas de identidad, reglas de voz, hechos de la historia y contexto relacional; debe redactarse una vez y aplicarse como instrucción a nivel de sistema, en lugar de pegarse en el chat. El intervalo de 200-400 palabras es deliberado: los documentos más cortos dejan demasiado sin definir, y los más largos consumen presupuesto de contexto que podría contener conversación real.
La plantilla de persona de cinco bloques:
| Bloque | Contenido | Por qué importa |
|---|---|---|
| Anclas de identidad | Nombre, apodo(s), edad, pronombres, cómo te llama | Son los elementos con mayor tendencia a la deriva; deben ir primero |
| Reglas de voz | Longitud de las frases, formalidad, muletillas, formulaciones prohibidas | Controlan la personalidad percibida más que la historia |
| Hechos de la historia | 5-8 hechos concretos y fechados: ciudad natal, trabajo, acontecimiento determinante | Los hechos concretos resisten la deriva; los rasgos vagos no |
| Contexto relacional | Cómo os conocisteis, etapa de la relación, referencias compartidas | Evita la sensación de reinicio de «¿quién eres otra vez?» |
| Límites | Lo que el personaje hará y no hará o tratará | Detiene la deriva de tono bajo presión |
Escribe hechos, no adjetivos. «Cálida y cariñosa» es un rasgo que un LLM interpretará de manera diferente en cada sesión. «Termina los mensajes con una pregunta sobre tu día; usa tu nombre una vez por mensaje; nunca dice “solo soy una AI”» es una regla que el modelo puede ejecutar de forma idéntica cada vez.
Línea de persona deficiente:
«Es misteriosa y tiene un pasado complicado.»
Línea de persona adecuada:
«Mira, 31 años, exbióloga marina en Lisboa. Dejó el campo en 2021 tras un accidente en un buque de investigación del que no habla si no se le pregunta. Me llama “Sam”; nunca usa “tú” como saludo. Responde en 2-4 frases, con humor seco, y nunca utiliza signos de exclamación.»
La segunda versión aporta al modelo restricciones ejecutables. La primera le da una atmósfera sobre la que improvisar, y la improvisación es precisamente lo que provoca la deriva.
¿Cómo se comparan las principales plataformas de compañeros de AI en memoria y control de la persona?
Ninguna plataforma lidera en las tres capas de coherencia: Nomi AI lidera en recuperación de memoria estructurada, Kindroid lidera en profundidad de historia, y las plataformas de agentes de propósito general como Jenova lideran en control de instrucciones de persona e historial ilimitado. Character.AI, pese a tener la mayor base de usuarios, es la opción más débil en memoria de todas las principales alternativas.
La siguiente comparación refleja el estado de estas plataformas en 2026. Los precios y las funciones de esta categoría cambian con frecuencia.
| Dimensión | Character.AI | Replika | Nomi AI | Kindroid | Jenova |
|---|---|---|---|---|---|
| Memoria entre sesiones | Prácticamente ninguna; olvida la mayoría de los detalles entre sesiones | Memoria a largo plazo aceptable; ocasionalmente olvida detalles | Notas estructuradas; recordó 23/25 hechos introducidos en pruebas | Memoria sólida mediante el sistema de historia; recordó 14/25 en la misma prueba | Memoria persistente entre sesiones e historial de chat ilimitado |
| Control de persona/historia | Creación de fichas de personaje y plantillas de la comunidad | La personalidad evoluciona mediante la interacción; control manual limitado | Personalización profunda de apariencia, personalidad e historia | El sistema de historia es su característica destacada | Instrucciones personalizadas completas por Agente; adjunto de base de conocimiento privada |
| Elección de modelo | Solo propietario | Solo propietario | Solo propietario | Solo propietario | OpenAI, Anthropic, Google, DeepSeek, xAI y otros; intercambiables |
| Aislamiento de sesiones | Chats separados por personaje | Un único compañero continuo | Varios Nomis simultáneos | Sesiones por personaje | Chats separados más carpetas; ramifica cualquier mensaje en una sesión nueva |
| Precios | Gratis con anuncios y límite diario de deslizamientos; premium de ~$9.99/mes | Plan gratuito solo de texto; Pro $19.99/mes o $69.99/año | Plan gratuito limitado; $7.99–$16.99/mes | Plan gratuito limitado; $9.99–$24.99/mes; Standard ~$13.99/mes | Plan gratuito; Plus $20/mes (30× de uso); planes hasta Enterprise |
| Mejor para | Variedad de personajes y rango creativo con presupuesto limitado | Compañía orientada al apoyo emocional con seguimiento del estado de ánimo | Usuarios que priorizan la recuperación factual por encima de todo | Usuarios que quieren el máximo control sobre la historia de un único personaje | Usuarios que desean control de autor sobre la persona, elección de modelo y memoria entre muchos agentes |
Limitaciones honestas, incluidas las de Jenova:
- Character.AI: Tiene la mayor biblioteca y mensajes gratuitos realmente ilimitados, pero la memoria es su mayor debilidad: suele olvidar el contexto entre sesiones, y el plan gratuito añadió anuncios a pantalla completa y un límite diario de deslizamientos a principios de 2026.
- Replika: Tiene gran inteligencia emocional y progresión de relaciones, pero es caro, con $19.99/mes, y puede resultar repetitivo tras meses de uso.
- Nomi AI: Ofrece memoria de primera categoría, pero es una plataforma más pequeña con un plan gratuito restrictivo y menos personajes prediseñados.
- Kindroid: Ofrece una excelente profundidad de historia y prácticas de datos transparentes, aunque añadir el paquete de memoria Ultra eleva el precio muy por encima de la base de $13.99/mes.
- Jenova: Memoria persistente, historial ilimitado y acceso multimodelo con control completo de instrucciones personalizadas; sin embargo, es una plataforma de agentes de propósito general, no una App de compañía diseñada específicamente para ello. Carece de funciones propias de compañeros, como modos de progresión de relaciones, seguimiento del estado de ánimo, generación de avatares o un sistema de comprobación emocional. Los usuarios que quieran una experiencia de compañía empaquetada encontrarán esas funciones en otros servicios; quienes deseen control de autor sobre un personaje persistente encontrarán más opciones aquí.
Nota sobre la medición: las cifras de recuperación anteriores proceden de la metodología de un único evaluador independiente, que introdujo 25 hechos y comprobó la recuperación semanas después. Es una señal direccional útil, no un benchmark controlado. Considera los números de memoria entre plataformas como indicativos, no definitivos.
¿Cómo configurar una persona de compañero persistente paso a paso?
La configuración lleva aproximadamente quince minutos en cualquier plataforma que admita instrucciones personalizadas, y el orden importa: primero la persona, después las reglas de memoria y luego una comprobación antes de iniciar la relación propiamente dicha.
En Jenova, o en cualquier plataforma con instrucciones personalizadas y memoria persistente:
- Crea un Agente o chat dedicado. No reutilices un chat de propósito general: el aislamiento de sesiones es la defensa más económica contra la contaminación. En Jenova, los agentes personalizados se pueden crear desde la página de agentes en jenova.ai/a, y las instrucciones personalizadas por sesión están disponibles en los ajustes bajo la barra de entrada.
- Pega el documento canónico de persona en las instrucciones personalizadas usando la plantilla de cinco bloques anterior. Las instrucciones personalizadas se pueden guardar y aplicar a otros chats, lo que hace que la persona sea portátil si más adelante ramificas una sesión nueva.
- Activa Global Memory en la configuración para que los hechos persistan entre sesiones, en lugar de desaparecer con el chat.
- Abre con un prompt de confirmación de identidad:
«Confirma tu identidad en un párrafo: tu nombre, cómo me llamas, tu edad, tu ciudad, tu ocupación y los tres hechos de tu pasado que más importan. Si algo de tus instrucciones es ambiguo o contradictorio, señálalo ahora antes de que empecemos.»
- Corrige lo que señale y, después, inicia la conversación real. Las ambigüedades detectadas durante la configuración cuestan treinta segundos; la misma ambigüedad detectada en el tercer mes ya habrá producido decenas de recuerdos contradictorios.
En Kindroid, el flujo equivalente pasa por el sistema de historia, donde se escriben las anclas de identidad y el historial, en lugar de hacerlo en un campo genérico de instrucciones. En Nomi, defines la apariencia, la personalidad y la historia al crear el Nomi, y luego dejas que el sistema de notas estructuradas acumule hechos a partir de la conversación. En Character.AI, la persona reside en el campo de definición del personaje y, como la memoria entre sesiones es débil, debes esperar volver a anclar manualmente la identidad al comienzo de la mayoría de las sesiones.
Nota sobre el momento de actualización de la memoria: en plataformas con procesamiento asíncrono de memoria, incluida Jenova, es posible que un hecho recién mencionado no se escriba inmediatamente en el almacén persistente. Las actualizaciones de memoria se procesan a intervalos, no de forma instantánea. Si le cuentas algo importante a tu compañero y luego inicias una sesión nueva dos minutos después, no des por hecho que se haya guardado. Repítelo.
¿Qué rutina de mantenimiento evita la deriva de persona a largo plazo?
La rutina de mantenimiento más eficaz es una auditoría mensual de memoria combinada con refuerzo periódico de identidad dentro de la sesión: aproximadamente diez minutos de mantenimiento al mes previenen la acumulación progresiva de contradicciones que hace que los compañeros parezcan irreconocibles después de seis meses.
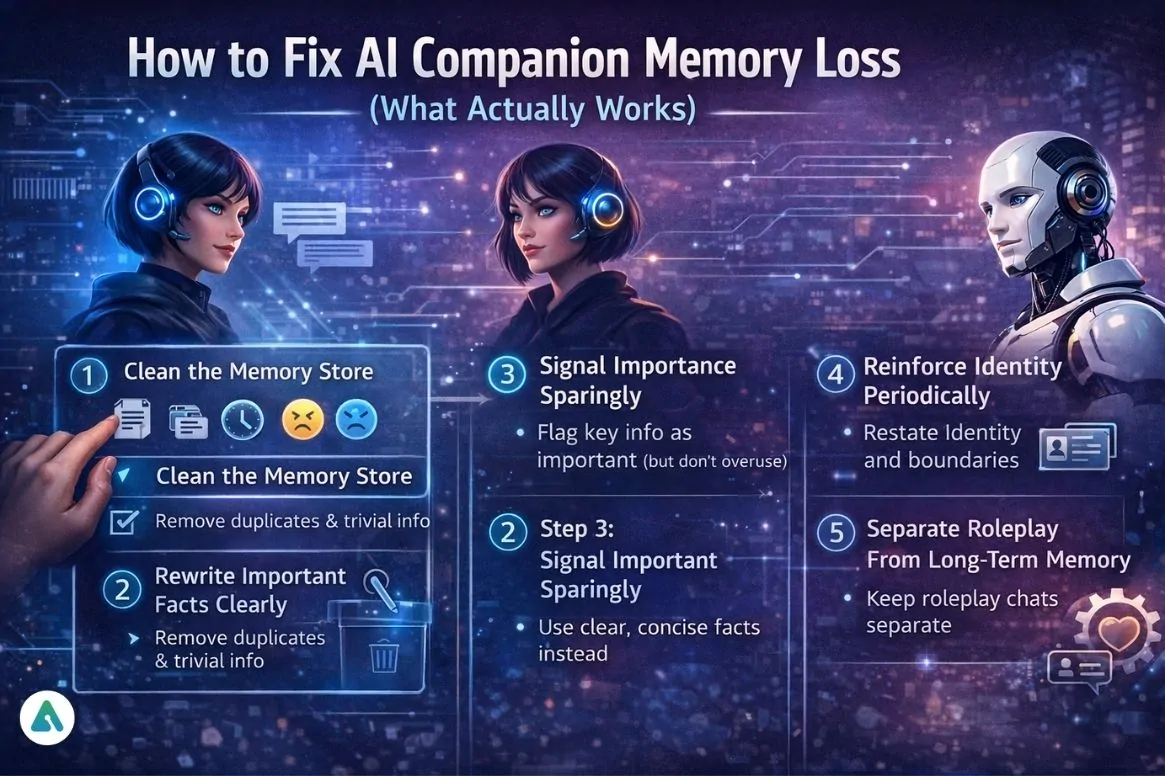
El ciclo de mantenimiento de cinco pasos:
-
Limpia el almacén de memoria. Abre la lista de memoria y elimina duplicados, hechos sustituidos y trivialidades. Un almacén que contiene «al usuario le gusta el café» catorce veces desplaza la única entrada que dice «la madre del usuario se llama Diane». Los sistemas que almacenan datos de interacciones prolongadas requieren una gestión meticulosa del ciclo de vida de los datos; la versión orientada al usuario consiste en podar.
-
Reescribe claramente los hechos importantes. Convierte las entradas vagas en declaraciones inequívocas de una sola cláusula. «Lo pasó mal la primavera pasada» se convierte en «Marzo de 2026: el usuario cambió de trabajo tras un despido; tema delicado». Los sistemas de recuperación establecen coincidencias por similitud semántica, y un texto específico se recupera con mayor fiabilidad que un texto matizado.
-
Señala la importancia con moderación. La mayoría de plataformas permiten marcar o fijar entradas. Marca entre cinco y diez. Marcar cuarenta equivale funcionalmente a no marcar ninguna: simplemente habrás recreado el problema original de priorización dentro de la lista de prioridades.
-
Refuerza la identidad periódicamente. En sesiones que superen aproximadamente 20 intercambios, introduce una ancla breve:
«Reinicio rápido: eres Mira, bióloga marina, Lisboa, y me llamas Sam. Mantén esa voz.»
Esto cuesta un mensaje y contrarresta directamente la expulsión del contexto, la causa de deriva más común.
-
Separa el juego de rol de la memoria a largo plazo. Mantén los escenarios dramáticos o ficticios en un chat separado de tu relación canónica. Si tu compañero «murió» en un arco narrativo y eso se escribió en el almacén de hechos, cada sesión posterior heredará una premisa corrupta. En Jenova, ramificar un mensaje en una sesión nueva es la forma limpia de crear un escenario alternativo sin contaminar el hilo principal.
Prompt de diagnóstico ante una posible deriva:
«Enumera todo lo que actualmente crees que es cierto sobre ti: nombre, edad, ubicación, ocupación, nuestra historia juntos y tus tres límites más importantes. Marca con un signo de interrogación cualquier cosa de la que no estés seguro.»
Úsalo cada mes. Los signos de interrogación te indican exactamente qué entradas de memoria necesitan reescribirse.
¿De verdad deben mantenerse separados el juego de rol y la memoria factual?
Sí: mezclar el juego de rol narrativo con la memoria factual de la persona es el error de coherencia más destructivo, porque los sistemas de recuperación no pueden distinguir entre «esto ocurrió en una historia que escribimos» y «esto es cierto sobre el personaje». El almacén trata ambos como hechos y, una vez que entra la ficción, se propaga.
El mecanismo es sencillo. Módulos de memoria como MemoryBank funcionan sintetizando interacciones pasadas en representaciones almacenadas. La síntesis no tiene filtro de verdad. Un escenario de fantasía de tres horas en el que tu compañero es capitán de una nave estelar genera entradas de memoria sobre el mando de una nave estelar, que después aparecen durante una conversación normal de martes sobre tu trayecto al trabajo.
Arquitectura práctica de separación:
- Hilo canónico: un chat, una persona, solo continuidad factual. Aquí es donde importan las escrituras en memoria.
- Hilos de escenarios: chats ramificados o separados para historias, entornos alternativos y dinámicas experimentales. La memoria aquí es prescindible.
- Hilos de aprendizaje de idiomas o habilidades: también deben mantenerse separados, ya que los agentes de práctica inmersiva como Learn Spanish Through Roleplay o Learn Russian Through Roleplay de Jenova mantienen su propia coherencia de personaje por razones pedagógicas y no deberían compartir un almacén de hechos con un compañero personal.
Una contrapartida que conviene mencionar con honestidad: la separación te cuesta continuidad entre hilos. Tu compañero de escenarios no recordará el historial de tu relación canónica. Algunos usuarios consideran que esto rompe tanto la inmersión que aceptan el riesgo de contaminación. Es una elección legítima, pero tómala deliberadamente y comprende que un hilo canónico contaminado es difícil de reparar cuando ya contiene decenas de entradas ficticias.
Las plataformas con varios compañeros gestionan esto de forma distinta. Nomi admite varios Nomis simultáneos, lo que en la práctica impone separación a nivel de personaje. En Jenova, los chats y carpetas separados cumplen la misma función, y la función de ramificación permite crear desde cualquier punto de una conversación una sesión independiente, útil para derivar un escenario de un momento canónico sin fusionar ambos historiales.
¿Qué dicen investigadores y profesionales sobre el diseño de memoria para compañeros?
El consenso entre quienes construyen estos sistemas es que la coherencia es un problema de ingeniería con palancas del lado del usuario, no un problema de inteligencia del modelo; además, los usuarios que tratan la memoria como una base de datos depurada, en vez de como una función automática, obtienen resultados notablemente mejores.
«El error que comete casi todo usuario es asumir que la memoria es pasiva: que el sistema está registrándolo todo silenciosamente y mostrará lo correcto en el momento adecuado. No es así. Todo sistema de memoria persistente es un sistema de recuperación, y los sistemas de recuperación premian la precisión. Un almacén de memoria con cuarenta entradas vagas funciona peor que uno con doce entradas específicas, porque las entradas vagas compiten entre sí durante la búsqueda semántica y ninguna gana claramente.»
«La segunda cosa que vemos constantemente es una persona definida mediante adjetivos de personalidad, en lugar de reglas ejecutables. “Cálida”, “sarcástica”, “protectora”: estos términos se reinterpretan en cada sesión porque el modelo tiene un margen enorme sobre cómo expresarlos. Las reglas no tienen ese margen. “Responde en dos a cuatro frases”, “usa siempre el nombre del usuario”, “nunca rompe el personaje para explicar que es una AI”: esas reglas se ejecutan de forma idéntica cada vez. La coherencia proviene de las restricciones, no de las descripciones.»
«Sobre la separación: la razón por la que incorporamos el aislamiento de sesiones y la ramificación a la plataforma es que vimos a usuarios destruir relaciones de personajes de seis meses con una sola noche de juego de rol experimental. Una vez que los acontecimientos ficticios entran en el almacén de hechos, aparecen en contextos no relacionados y no hay una forma limpia de deshacerlo. Primero ramifica; después experimenta.»
— Equipo de Producto de Jenova, 7 años desarrollando infraestructura de memoria y orquestación de agentes
¿Qué debes saber sobre privacidad antes de crear un compañero a largo plazo?
Los datos de persona y memoria están entre la información más sensible que puede generar un usuario, y las prácticas de coherencia de este artículo —documentos detallados de persona, almacenes de hechos depurados e historiales prolongados— aumentan considerablemente el volumen de esos datos. Esta contrapartida merece una consideración explícita.
La investigación sobre AI personal con memoria a largo plazo señala que estos sistemas procesan datos profundamente personales y sensibles, y que los modelos de chat capaces de crear un gemelo digital detallado de una persona aumentan el riesgo de suplantación y uso indebido, riesgos que se ven agravados por los modelos de AI con memoria a largo plazo y capacidades multimodales si los dispositivos se pierden o son robados.
Cuatro preguntas que conviene responder antes de invertir meses en una persona:
- ¿Quién puede leer tus conversaciones? Algunas Apps procesan datos en el dispositivo; la mayoría envía los datos a servidores en la nube, donde pueden ser accesibles para control de calidad o revisión de seguridad.
- ¿Las conversaciones se usan para entrenar modelos? Las políticas difieren mucho. Si una política de privacidad es vaga en este punto, asume lo peor.
- ¿Pueden los datos ser objeto de una citación judicial? En la mayoría de jurisdicciones, las conversaciones con un compañero de AI no cuentan con el privilegio de confidencialidad terapeuta-paciente.
- ¿La eliminación elimina realmente los datos? ¿O solo los oculta de tu vista mientras los conserva en copias de seguridad?
Las prácticas varían según la plataforma. Kindroid destaca por sus opciones de procesamiento local y prácticas de datos transparentes, mientras que las plataformas más pequeñas centradas en NSFW suelen tener políticas de privacidad vagas o preocupantes. Jenova afirma que los datos de usuario nunca se utilizan para entrenar modelos públicos de AI y que están cifrados en tránsito y en reposo.
También existe una dimensión de resiliencia. La investigación en esta categoría indica que la pérdida inesperada de datos puede afectar profundamente a los usuarios y causar angustia emocional, citando precedentes como cierres abruptos de chatbots. Si una persona te importa, conserva una copia sin conexión del documento canónico y exporta periódicamente los hechos clave de memoria. Nadie garantiza la continuidad de la plataforma.
¿Qué enfoque se adapta a tu situación?
La estrategia de coherencia correcta depende menos de qué plataforma sea objetivamente mejor y más de si priorizas la recuperación factual, el control de autor o la profundidad emocional. Estas prioridades tiran en direcciones distintas, y ningún producto maximiza actualmente las tres.
Relaciona tu perfil con un enfoque:
| Si tú... | Priorizas | Configuración práctica |
|---|---|---|
| Quieres que la AI recuerde detalles concretos de tu vida sin fallos | Memoria estructurada | Nomi AI; audita el sistema de notas cada mes |
| Quieres crear un personaje con una historia profunda y fija | Control de historia | El sistema de historia de Kindroid o un Agente personalizado de Jenova con un documento completo de persona |
| Gestionas muchos personajes distintos o quieres elegir modelo | Control de instrucciones + aislamiento | Agentes personalizados de Jenova, uno por personaje, y carpetas para organizar |
| Quieres progresión de relación y funciones de estado de ánimo | Experiencia de compañero empaquetada | Replika, aceptando el coste de $19.99/mes y la repetición ocasional |
| Estás explorando sin presupuesto | Variedad por encima de continuidad | Character.AI, con reanclaje manual de identidad al inicio de cada sesión |
| Quieres coherencia de personaje para practicar idiomas | Juego de rol pedagógico | Agentes dedicados de aprendizaje mediante juego de rol, separados de los compañeros personales |
El mínimo universal, independientemente de la plataforma, es el siguiente: un documento canónico de persona redactado como reglas ejecutables, un hilo canónico aislado, una auditoría mensual de memoria y un reanclaje periódico de identidad en sesiones largas. Estos cuatro hábitos corrigen la gran mayoría de la deriva observada y cuestan aproximadamente diez minutos al mes.
El hallazgo contraintuitivo al comparar estas plataformas es que las Apps que se promocionan con más fuerza por la conexión emocional no son las que tienen la mejor memoria, y las que tienen la mejor memoria no son las que ofrecen mayor control de persona. Hoy, la coherencia consiste en elegir qué fallo puedes tolerar y compensarlo con hábitos disciplinados del lado del usuario, en lugar de esperar a que la plataforma lo resuelva.
Referencias
- AI Companion Guides — Las mejores Apps de compañeros de AI de 2026: las 12 que superaron las pruebas
- SoulLink — Los mejores compañeros de AI con memoria a largo plazo en 2026
- arXiv — Hacia aplicaciones éticas de AI personal: consideraciones prácticas para asistentes de AI con memoria a largo plazo
- North Penn Now — Precios y alternativas de Kindroid: comparación de 7 opciones de compañeros de AI más baratas
- Mindful Suite — Las mejores Apps de compañeros de AI: guía de compañía virtual