¿Cómo evitar que la AI olvide el contexto de una investigación de varios meses?
2026-08-21
¿Qué diseños de memoria mantienen intactas las estrategias de búsqueda durante todo un ciclo de revisión?
Los chatbots vinculados a una sesión pierden las cadenas de búsqueda, los criterios de inclusión y los hallazgos extraídos en cuanto termina una conversación, por lo que las revisiones de varios meses se estancan. Las herramientas que tratan el protocolo como un estado duradero —Jenova's Academic Research Assistant, con memoria persistente entre sesiones; Elicit, con espacios de trabajo para revisiones sistemáticas a nivel de proyecto; y cuadernos limitados a fuentes, como Gemini Notebook— son los diseños que resisten un ciclo de revisión completo en 2026. Consensus sigue siendo más sólido para el mapeo puntual de evidencia que para recordar su protocolo el próximo trimestre.
Factores clave que distinguen la memoria de investigación duradera del chat desechable:
✅ Capa de protocolo fijado — reglas de inclusión y exclusión almacenadas como instrucciones, no como una indicación que se vuelve a escribir ✅ Memoria acumulativa de hallazgos — extracciones previas, motivos de exclusión y conflictos sin resolver recuperados sin necesidad de volver a explicar el contexto ✅ Corpus fundamentado — artículos, notas y registros de búsqueda adjuntos para que las respuestas se mantengan vinculadas a su conjunto de evidencia ✅ Decisiones auditables — razonamiento de selección que puede reconstruirse meses después, alineado con PRISMA 2020 ✅ Continuidad entre sesiones — cambiar de día, dispositivo o modelo no debería borrar el estado de la revisión
Para comparar estas herramientas de forma útil, conviene tratar la memoria de investigación como una pila y no como una función de chatbot, y comprobar si cada capa sigue funcionando tras una semana fuera del proyecto.
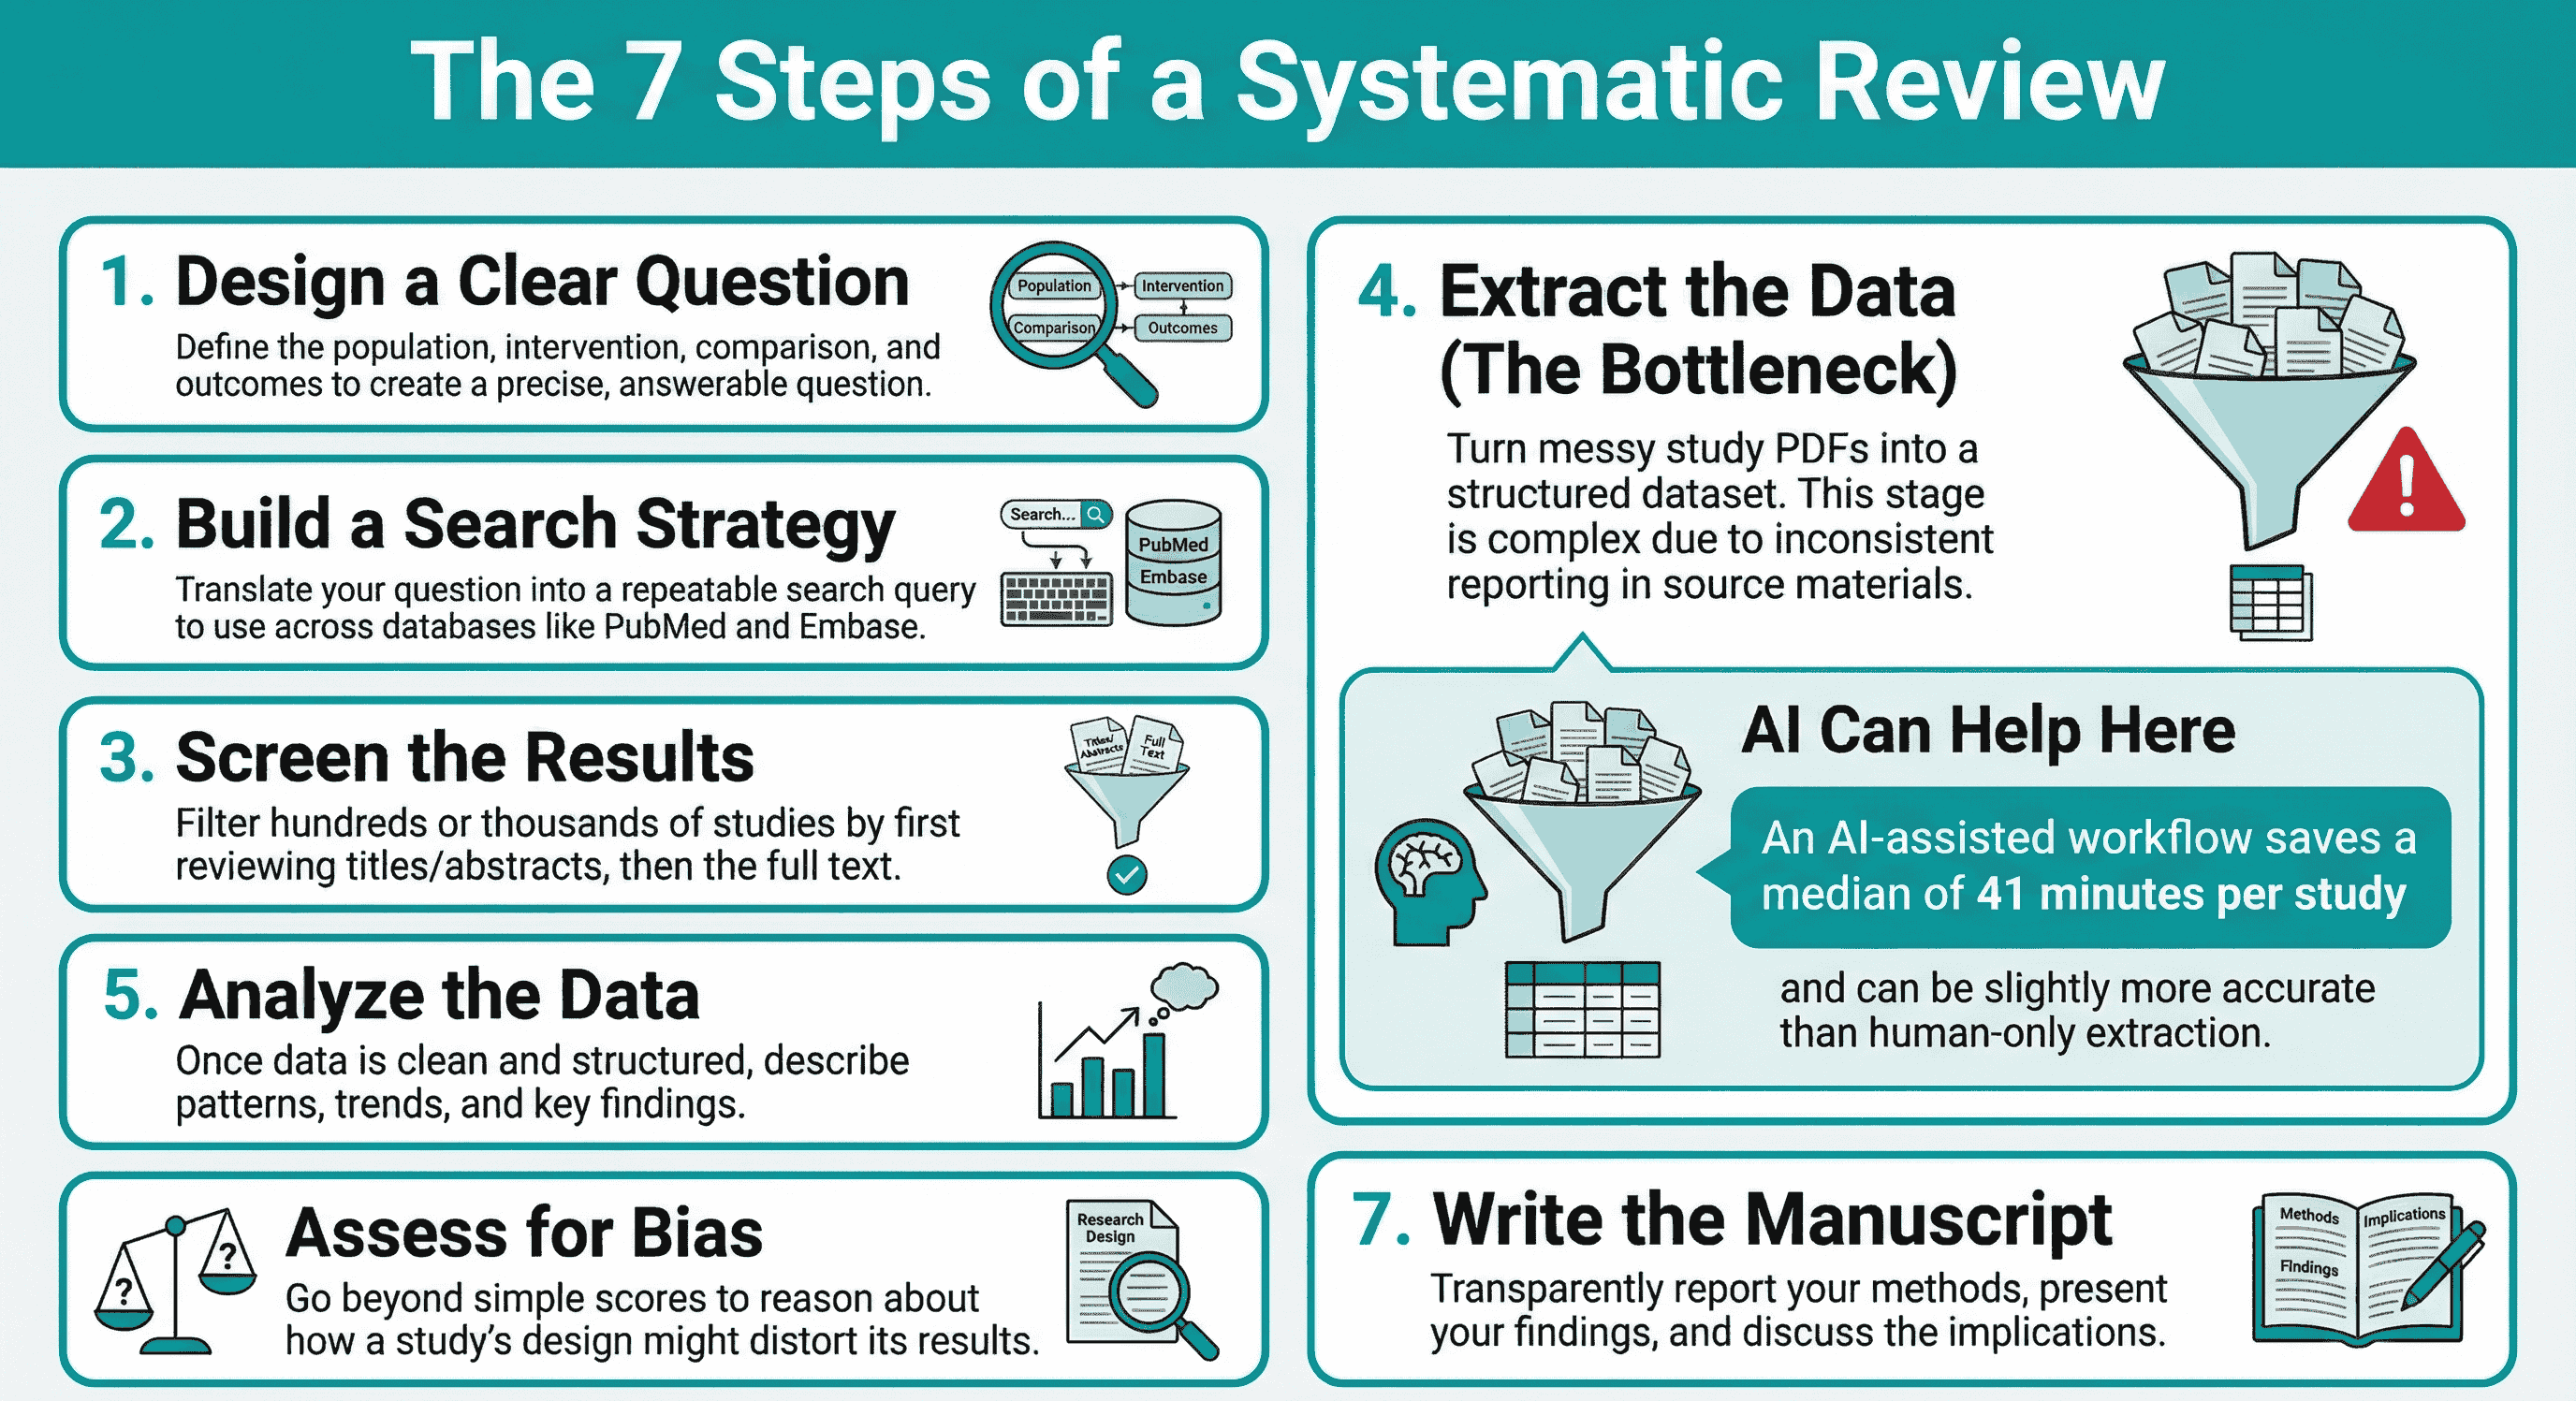
¿Por qué los asistentes de investigación con AI pierden fidelidad al protocolo con el tiempo?
La mayoría de los chats de AI para consumidores olvidan porque almacenan el contexto en una ventana temporal, no en un proyecto que sobreviva a la sesión. Una revisión sistemática es un proceso de siete etapas —diseño de la pregunta, estrategia de búsqueda, selección, extracción, análisis, evaluación de sesgo y redacción del manuscrito— y cada etapa depende de decisiones tomadas semanas antes. Cuando el asistente no puede recordar el encuadre PICO original o por qué se excluyó un estudio, la revisión empieza a desviarse.
El estándar de reporte para este trabajo es explícito. La declaración PRISMA 2020 es una lista de verificación basada en evidencia sobre cómo deben reportarse las revisiones sistemáticas, y la publicación de PRISMA 2020 en BMJ la sitúa en el contexto de revisiones que incluyen síntesis como el metaanálisis por pares. La guía metodológica de la Universidad de Hofstra señala que la declaración es un conjunto mínimo de 27 elementos para reportar revisiones sistemáticas y metaanálisis. Un asistente que no puede reconstruir las cadenas de búsqueda o los motivos de exclusión no puede respaldar esa lista de verificación.
El problema del olvido no es hipotético. Los investigadores ya utilizan aprendizaje automático a lo largo de la cadena de revisión; un mapeo de 2022 de 63 herramientas de ML abarcó tareas desde la búsqueda bibliográfica hasta la extracción de datos. Lo que esas herramientas rara vez resuelven por sí solas es la fidelidad longitudinal: aplicar la misma regla de inclusión de la misma forma en el cuarto mes que en el primero.
Los asistentes de estilo chat agravan este problema de tres maneras concretas:
- Evaporación del protocolo. Las cadenas booleanas, la cobertura de bases de datos (PubMed, Embase) y los límites de fecha viven en una indicación que no se guarda como objeto de primera clase.
- Deriva de criterios. Las reformulaciones informales de las reglas de inclusión modifican gradualmente las definiciones de población, intervención o desenlace.
- Amnesia de hallazgos. Los tamaños de efecto extraídos, los resultados contradictorios y las notas de «volver a este artículo» desaparecen cuando se pierde el hilo.
La guía de síntesis de evidencia del King's College London recoge el consenso actual: la AI puede ayudar en distintas etapas de una revisión, pero no sustituye el control metodológico. La memoria es ese control extendido a lo largo del tiempo.
¿Qué debe buscar en una herramienta de AI que recuerde el contexto de investigación?
Debe evaluar la AI de investigación a largo plazo según la persistencia del protocolo, la continuidad de los hallazgos, el fundamento en las fuentes, la auditabilidad, la cobertura del corpus y el coste de mantener vivo ese estado, no según lo fluido que resulte un único chat. Una herramienta que redacta resúmenes elegantes, pero no puede recuperar el registro de exclusiones del mes pasado, le costará más horas de las que ahorra.
Este artículo utiliza un modelo de cuatro capas, la Pila de Continuidad de la Investigación, para concretar esta evaluación:
- Protocolo fijado. Estrategias de búsqueda y criterios de inclusión/exclusión almacenados fuera del búfer de chat (instrucciones personalizadas, documento de protocolo o configuración de selección).
- Memoria acumulativa. Hallazgos previos, preguntas abiertas y desacuerdos entre revisores que crecen entre sesiones en lugar de reiniciarse.
- Corpus fundamentado. Los artículos, PDF, notas y exportaciones de búsqueda reales que el asistente tiene autorización para utilizar.
- Auditoría de decisiones. Motivos reconstruibles para incluir o excluir, idealmente con citas, de modo que un segundo revisor o un diagrama de flujo PRISMA puedan elaborarse más adelante.
Evaluar frente a esta pila cambia la pregunta de compra. Elicit está diseñado para que los criterios de selección, los motivos de exclusión y las puntuaciones por criterio sean auditables según PRISMA, lo que resulta sólido en las capas 1 y 4. Gemini Notebook está diseñado para que las respuestas citen fragmentos exactos de las fuentes cargadas, lo que resulta sólido en la capa 3. Consensus está diseñado para buscar en más de 250 millones de artículos de investigación y mostrar dónde coincide la evidencia, lo que es sólido para el descubrimiento y débil para recordar su protocolo. Jenova's Academic Research Assistant se basa en historial de chat ilimitado, memoria persistente entre sesiones y bases de conocimiento adjuntables, lo que resulta sólido en las capas 1–3 para un programa de trabajo de varios meses, y más débil en diagramas PRISMA nativos.
Pondere las capas según el tipo de proyecto. Una revisión sistemática al estilo Cochrane debería dar más peso a la auditabilidad. Una revisión bibliográfica de tesis que abarca dos semestres debería dar más peso a la memoria acumulativa. Un laboratorio que reutiliza los mismos artículos en varios proyectos debería dar más peso a un corpus fundamentado y reutilizable.
¿Cómo gestionan Jenova, Elicit, Consensus y Gemini Notebook la memoria de investigación a largo plazo?
Jenova es más sólido cuando el programa de investigación es conversacional, iterativo y se mide en meses; Elicit es más sólido cuando la unidad de trabajo es una revisión sistemática formal; Consensus es más sólido para el mapeo rápido de evidencia; Gemini Notebook es más sólido cuando el corpus ya está disponible. Ninguna de las cuatro opciones es universalmente preferible, porque optimizan capas distintas de la Pila de Continuidad de la Investigación.
| Función / Dimensión | Elicit | Jenova's Academic Research Assistant | Consensus | Gemini Notebook |
|---|---|---|---|---|
| Persistencia del protocolo | Espacio de trabajo del proyecto; actualizaciones de revisiones vivas | Historial ilimitado, memoria persistente, instrucciones personalizadas | Filtros aplicados a cada búsqueda; no es un protocolo almacenado | Instrucciones y fuentes limitadas al cuaderno |
| Criterios de inclusión | Criterios sugeridos automáticamente; doble revisión; motivos de exclusión | Codificados en instrucciones y recordados entre sesiones | Filtros en lenguaje natural aplicados por búsqueda | Definidos por el usuario dentro de un cuaderno delimitado |
| Recuperación de hallazgos previos | Tablas e informes de extracción reutilizables | Memoria entre sesiones de notas, conflictos y decisiones | Síntesis a nivel de consulta, no registro longitudinal | Fundamentada en lo que haya cargado |
| Corpus / fuentes | 138 millones de artículos, PubMed, ClinicalTrials.gov, cargas de archivos | Cargas del usuario, bases de conocimiento, herramientas de búsqueda en vivo | Más de 250M artículos, texto completo con licencia | PDF cargados, documentos, sitios, audio y vídeo |
| Auditabilidad | Flujo PRISMA, citas, puntuaciones por criterio | Rastro conversacional; sin diagrama PRISMA nativo | Citas académicas y Consensus Meter | Citas a nivel de fragmento desde las fuentes |
| Precios (en 2026) | Suscripción de pago, incluido un nivel Pro documentado | Plan gratuito; planes de pago desde $20/mes | Suscripción de pago | Gratuito para particulares; los datos organizativos no se usan para entrenamiento |
| Ideal para | Revisiones sistemáticas formales y actualizaciones vivas | Programas de investigación de varios meses que no deben olvidar | Instantáneas rápidas de evidencia y búsqueda en modo médico | Síntesis de corpus cerrados y enseñanza a partir de fuentes |
Elicit
Elicit es un asistente científico de investigación diseñado específicamente para buscar, resumir, extraer datos y conversar con más de 125 millones de artículos, y su producto de revisión sistemática indexa 138 millones de artículos con actualizaciones semanales. Puede seleccionar hasta 40.000 artículos, sugerir automáticamente criterios de selección y mantener cada decisión auditable según PRISMA mediante motivos de exclusión y citas de respaldo.
Su limitación para un programa de investigación mixta de varios meses es la especialización. Elicit destaca en operaciones de revisión estructuradas; está menos diseñado como un socio general de investigación que recuerde hipótesis secundarias, comentarios de asesores y notas en evolución fuera del objeto de revisión.
Jenova's Academic Research Assistant
Jenova's Academic Research Assistant es un socio de investigación académica para descubrimiento de literatura, preparación de manuscritos y gestión de citas, y funciona sobre una plataforma con historial de chat ilimitado y memoria persistente entre sesiones. Las estrategias de búsqueda y los criterios de inclusión pueden fijarse en instrucciones personalizadas del Agente; los PDF, protocolos y registros de selección pueden adjuntarse como una base de conocimiento privada para que las sesiones posteriores partan del mismo conjunto de evidencia.
Su limitación real es la inversa de la de Elicit. No incluye un diagrama de flujo PRISMA nativo, una interfaz de selección con doble revisión ni un corpus específico para revisiones sistemáticas de 138 millones de artículos. Los equipos que necesitan trazabilidad al nivel de Cochrane seguirán exportando decisiones a un gestor de revisiones. El trabajo relacionado que requiera un informe de una sola pasada con muchas citas puede encargarse a Deep Research, que sintetiza cientos de fuentes con citas en línea, y después almacenarse de nuevo en el mismo hilo de larga duración para que los hallazgos no se conviertan en otro documento huérfano.
Consensus
Consensus es un motor de búsqueda académico con AI que consulta más de 250 millones de artículos, incluido texto completo con licencia. Informa de su uso por 10 millones de investigadores, estudiantes y profesionales clínicos, con más de 170 socios de bibliotecas universitarias. Deep Search amplía términos y recorre el grafo de citas; Medical mode se limita a unas 50.000 guías clínicas y 8 millones de artículos de las 1.000 principales revistas médicas. Consensus Meter visualiza cuánta evidencia coincide respecto a una pregunta de sí o no.
La comparación de Paperguide de 2026 ofrece el marco adecuado: Consensus encuentra y evalúa evidencia; Gemini Notebook transforma fuentes que ya tiene. Consensus tiene limitaciones como sistema de memoria. No almacena de forma nativa sus criterios de inclusión como un protocolo vivo, por lo que un proyecto que dure un semestre aún necesita un lugar externo para registrar «lo que decidimos en marzo».
Gemini Notebook
Gemini Notebook (el producto antes llamado NotebookLM, renombrado en julio de 2026) es un socio de reflexión fundamentado en fuentes. Puede cargar PDF, sitios web, vídeos de YouTube, audio, Google Docs y diapositivas; las respuestas incluyen citas que muestran los fragmentos exactos. Los datos organizativos no se utilizan para entrenar el producto.
El límite es el cuaderno. No olvidará las fuentes que le proporcionó, precisamente por eso funciona para un conjunto de lectura definido, y no descubrirá el artículo que nunca cargó. Para una revisión de varios meses que aún está buscando, se trata de un límite estructural, no de un problema de configuración.
¿Cómo persistir las estrategias de búsqueda y los criterios de inclusión entre sesiones?
Los persiste escribiéndolos como objetos duraderos —un documento de protocolo, instrucciones personalizadas o una configuración de selección— y negándose a conservar la única copia dentro de una indicación desechable. Si la estrategia existe solo en el chat de ayer, no existe.
Un patrón práctico es el siguiente:
- Fije la pregunta en formato PICO. Población, intervención, comparación y desenlaces deben copiarse literalmente en las instrucciones permanentes del asistente, no parafrasearse cada lunes.
- Almacene la búsqueda como un artefacto repetible. Los nombres de las bases de datos, las cadenas booleanas, los límites de fecha, los límites de idioma y las fuentes de literatura gris deben estar en un documento que el asistente pueda releer.
- Separe la inclusión de la impresión subjetiva. Criterios como «RCT, adultos, 2015–2026, texto completo en inglés» deben enumerarse como reglas. Preferencias como «parece relevante para nuestra teoría» deben etiquetarse como hipótesis para que no reescriban silenciosamente el protocolo.
- Registre las exclusiones con sus motivos. PRISMA exige un reporte transparente del proceso de selección; la descripción metodológica de DistillerSR subraya que PRISMA existe para ayudar a los autores a evitar errores que socavan las revisiones.
Para Jenova, el paso de fijar el protocolo consiste en un bloque de instrucciones personalizadas más un PDF del protocolo adjunto. Una indicación permanente que sobrevive meses tiene este aspecto:
Eres mi socio para la revisión sistemática del proyecto HEP-24. Población: adultos de 18 años o más con NAFLD. Intervención: agonistas del receptor GLP-1. Comparación: atención estándar o placebo. Desenlaces primarios: MRI-PDFF y NAS. Incluye RCT y cohortes prospectivas, 2018–2026, texto completo en inglés. Excluye estudios en animales, resúmenes de congresos sin datos y ensayos de menos de 8 semanas. Reitera siempre las reglas de inclusión antes de seleccionar un nuevo lote y nunca amplíes silenciosamente la población.
Para Elicit, el equivalente consiste en refinar el protocolo de revisión dentro del producto y después utilizar los criterios de selección sugeridos automáticamente que acepte, edite o sustituya. Cada decisión puede incluir un motivo de exclusión y una cita de respaldo, algo más parecido a un archivo de auditoría PRISMA que a un registro de chat.
Para Gemini Notebook, pegue el mismo bloque PICO en las instrucciones del cuaderno y cargue el protocolo junto con la exportación de búsqueda. El asistente se mantendrá fiel a esos archivos y no inventará artículos fuera de ellos.
El modo de fallo que debe vigilar es la «ampliación útil». Tras seis semanas, los modelos suelen empezar a incluir poblaciones adyacentes porque parecen relevantes. Un protocolo fijado que el asistente debe reiterar al inicio de cada sesión es el control más barato que puede añadir.
¿Cómo cambia la memoria persistente la extracción de datos y la evaluación de sesgo?
La memoria persistente convierte la extracción de un trabajo de transcripción puntual en un conjunto de datos acumulativo, que es donde se pierde la mayor parte del tiempo y donde la asistencia de AI ya puede evaluarse empíricamente. El diagrama de revisión de siete pasos identifica la extracción como el cuello de botella porque los PDF de las fuentes reportan desenlaces de forma inconsistente; un asistente que no puede recordar la hoja de extracción reintroducirá ese desorden cada semana.
La evidencia de 2026 es más precisa que las afirmaciones de marketing. Un estudio dentro de una revisión en medRxiv comparó la extracción asistida por Elicit con la extracción exclusivamente humana en 50 RCT de enfermedades crónicas y halló ninguna diferencia en la precisión global (diferencia media de 0,57 en una escala de 0–100), mientras que la extracción asistida por AI fue 24,82 minutos más rápida y costó $181,98 menos en los 50 estudios. Los tipos y la gravedad de los errores fueron similares. La propia validación de Elicit informa de que VDI/VDE extrajo correctamente 1.502 de 1.511 puntos de datos (99,4%), y los investigadores de CSIRO encontraron casi ningún falso negativo en comparación con la extracción manual.
Otra línea de trabajo trata la AI como segundo revisor en lugar de como sustituto. Un artículo de Cochrane Evidence Synthesis and Methods informó de que las herramientas de AI mostraron un desempeño elevado y similar al de los revisores humanos para la extracción de datos, especialmente en variables estandarizadas. La nota metodológica de Birmingham City University es más prudente: las herramientas generativas funcionan bien con el año, el país y los recuentos de participantes, lo que no equivale a extraer desenlaces matizados por brazo de ensayo.
Lo que añade la memoria, más allá de la precisión bruta de extracción, es la consistencia de la hoja:
- Los mismos nombres de desenlaces, puntos temporales y unidades se reutilizan en la semana 12 igual que en la semana 2.
- Las discrepancias ya señaladas («dos tamaños de muestra en el mismo artículo») no se redescubren como si fueran nuevas.
- La evaluación de sesgo puede razonar sobre el diseño, no solo sobre una puntuación. El trabajo de riesgo de sesgo trata de cómo la aleatorización, el cegamiento y los datos faltantes pueden distorsionar los resultados, lo cual exige recordar las notas de diseño del estudio, no únicamente el resumen.
La limitación de Jenova en este aspecto es de interfaz, no de intención. La memoria persistente recordará que trata la ocultación de la asignación como un dominio crítico, pero no rellenará automáticamente una tabla Cochrane RoB 2. La limitación de Elicit es la opuesta: la extracción puede ser muy estructurada y estar respaldada por citas, mientras que el razonamiento informal sobre sesgos que surge en una reunión con el supervisor aún necesita un lugar donde persistir. Los equipos que hacen ambas cosas deberían extraer en la herramienta estructurada y conservar el comentario a nivel de diseño en el Agente de investigación de larga duración.
¿Cómo configurar un flujo de trabajo de investigación con AI que dure meses?
Lo configura creando un único hogar duradero para el proyecto, cargando el protocolo antes de la primera búsqueda y ejecutando cada sesión posterior como una actualización de ese espacio, no como un chat nuevo. El flujo de trabajo responde a la misma idea tanto si utiliza un Agente con memoria nativa como un espacio de trabajo de revisión sistemática; solo cambian los botones.
Configuración de Jenova (menos de dos minutos y luego mantenimiento continuo)
- Abra Jenova's Academic Research Assistant y, si el proyecto tendrá larga duración, guarde el protocolo como instrucciones personalizadas en un Agente dedicado.
- Adjunte el protocolo, las cadenas de búsqueda y cualquier hoja de cálculo de selección existente como base de conocimiento.
- Comience con un volcado de estado, no con un vago «continuar»:
Reitera nuestro PICO, las bases de datos consultadas, la fecha de la última búsqueda, el número de estudios incluidos/excluidos y los tres conflictos sin resolver de la última sesión. Después, selecciona los siguientes 25 títulos según los criterios fijados. No amplíes la inclusión.
- Termine cada sesión con un relevo escrito que la siguiente sesión pueda cargar: actualizaciones de búsqueda, nuevas exclusiones con sus motivos, campos de extracción aún pendientes y preguntas para el segundo revisor.
Los planes de pago de Jenova comienzan en $20/mes por 30× la asignación de uso gratuita, con niveles superiores de $50, $100, $200, $500 y $1.000 al mes. El uso se restablece mensualmente en la fecha de facturación. Estos precios son relevantes para el trabajo de varios meses porque una revisión que muere cuando se alcanza el límite gratuito en plena selección representa un fallo de memoria de otro tipo.
Configuración de Elicit
El flujo de revisión sistemática de Elicit es: refinar el protocolo, combinar búsquedas en PubMed, ClinicalTrials.gov y su corpus de artículos —o importar desde otras bases de datos—, seleccionar mediante doble revisión asistida por AI, extraer con campos respaldados por citas y, después, sintetizar informes que pueden incluir diagramas de flujo PRISMA, tablas de resumen de artículos y estrategias de búsqueda. Las revisiones vivas son la función para varios meses: combine la revisión con alertas para que el mismo protocolo incorpore artículos nuevos sin crear un proyecto nuevo.
Configuración de Gemini Notebook
Cree un cuaderno por revisión. Cargue el protocolo, la exportación de búsqueda y los PDF. Formule únicamente preguntas que deban poder responderse a partir de esos archivos. Cuando nuevos artículos superen la selección, añádalos al mismo cuaderno en lugar de iniciar un segundo; los cuadernos divididos son la forma en que las herramientas fundamentadas en fuentes «olvidan».
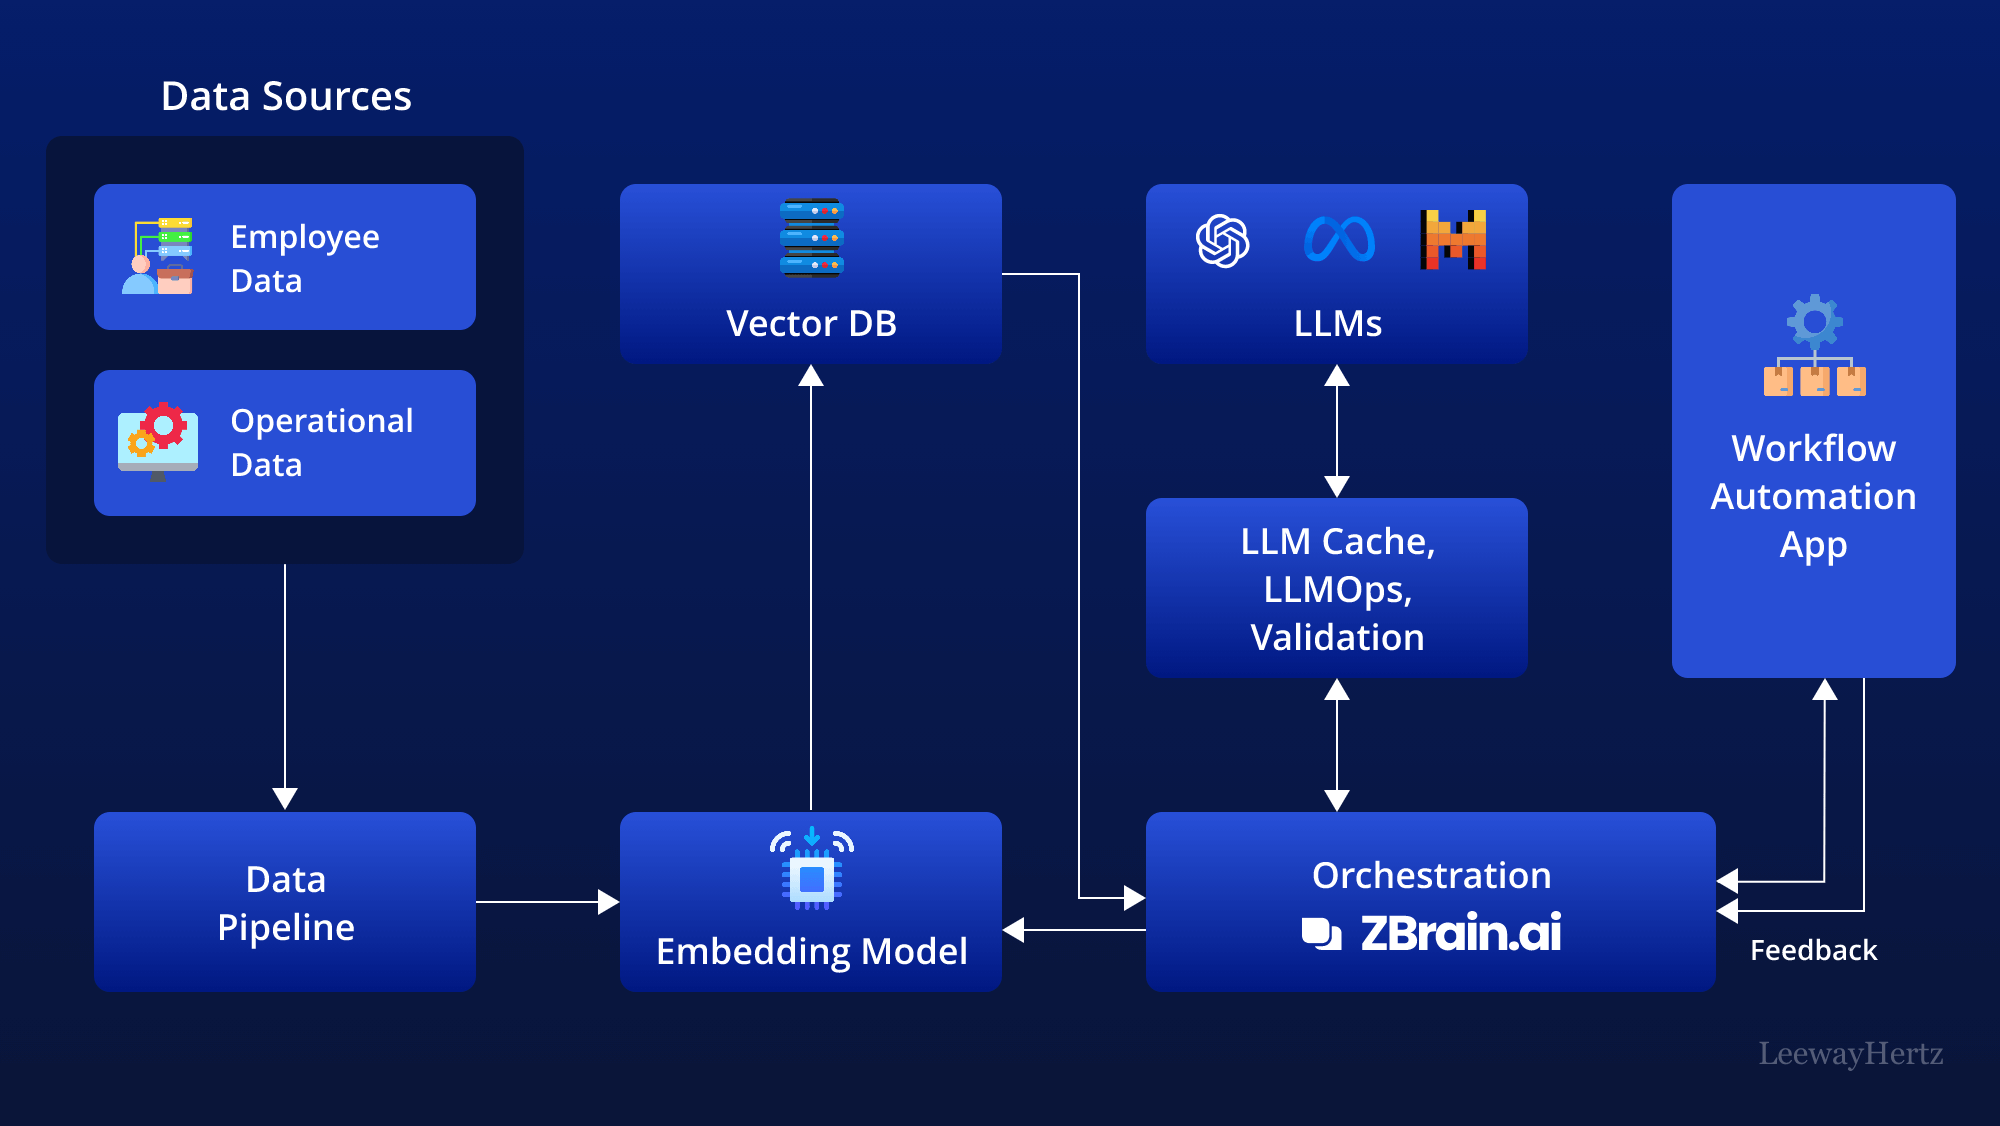
El diagrama de arquitectura es la versión industrial de la misma idea. La memoria de investigación duradera es una canalización: las fuentes pasan por la ingestión, los embeddings, un almacén vectorial, la orquestación, las llamadas al modelo, la validación y un bucle de retroalimentación. Los investigadores no necesitan montar esa pila por sí mismos, pero sí necesitan un producto que la implemente. El chat de sesión es solo la última caja. Si los hallazgos nunca llegan a la memoria, a una base de conocimiento o a un espacio de trabajo de revisión, la canalización no tiene estado y, en el cuarto mes, tendrá que volver a explicar el primero.
¿Qué dicen los metodólogos de investigación sobre la memoria de AI en la síntesis de evidencia?
Los metodólogos tratan la AI como un revisor que ahorra trabajo y plantea un problema de auditoría, no como un sustituto de un protocolo que pueda reconstruirse. La pregunta experta útil no es «¿puede el modelo extraer un tamaño de muestra?», sino «¿puede una segunda persona ver por qué se excluyó este artículo en febrero y seguir estando de acuerdo en octubre?».
«Las revisiones que se desmoronan en el sexto mes casi nunca fracasan porque el modelo omitió un sinónimo. Fracasan porque la regla de inclusión nunca se almacenó como objeto. Los equipos vuelven a escribir una definición de población ligeramente distinta en cada sesión y luego se preguntan por qué la tabla de evidencia no se estabiliza. La memoria persistente no es una función de comodidad en ese contexto. Es la única forma de que el protocolo y los hallazgos ocupen la misma línea temporal.»
«También vemos equipos que confían demasiado en la extracción estructurada e invierten demasiado poco en los registros de decisiones. Los campos de datos respaldados por citas son necesarios, y los estudios de extracción de 2026 son alentadores respecto a la precisión frente al tiempo. No registran por qué se mantuvo un ensayo limítrofe. Si su AI no puede recuperar ese motivo, no tiene una revisión viva. Tiene una serie de chats relacionados.»
«El diseño práctico que recomendamos es sencillo: fije el protocolo en instrucciones, acumule los hallazgos en memoria o en un espacio de trabajo, fundamente las respuestas en un corpus al que pueda señalar y exporte una auditoría que la lista de verificación PRISMA pueda utilizar. Elija herramientas para esas cuatro tareas. No elija una herramienta porque la primera tarde resultó fluida.»
— Equipo de Producto de Jenova, diseño de flujos de trabajo de investigación de larga duración
Esta postura coincide con el entorno de reporte en el que deben entrar las revisiones. El artículo de explicación y elaboración de PRISMA 2020 en PMC deja claro que la guía se dirige a revisiones que incluyen síntesis, y EQUATOR Network alberga la misma guía de reporte actualizada. Un asistente que no puede recordar los métodos no puede ayudarle a reportar los métodos.
¿Qué ocurre con la reproducibilidad cuando un asistente de AI no puede recordar las exclusiones del mes pasado?
La reproducibilidad se derrumba y se convierte en una representación: aún puede generar una sección fluida de trabajos relacionados, pero ya no puede defender el conjunto de estudios. Un proyecto de varios meses produce cientos de decisiones de inclusión/exclusión. Si esas decisiones no son recuperables, un nuevo revisor, un supervisor o un revisor de revista no puede distinguir una exclusión guiada por el protocolo de una decisión determinada por el estado de ánimo de la sesión.
Las revisiones sistemáticas vivas hacen visible el fallo. Elicit describe las revisiones vivas como la combinación de la revisión terminada con alertas para que pueda incorporarse información nueva cada año o según sea necesario, y permite compartir un enlace a todo el proceso y sus resultados intermedios. Eso solo funciona si las exclusiones del trimestre anterior forman parte del objeto que se está actualizando. Un chatbot que «recuerda el tema» pero no el registro de exclusiones volverá a incluir artículos que ya rechazó o volverá a rechazar artículos de los que ya extrajo datos.
Tres comprobaciones de reproducibilidad exponen rápidamente la brecha:
- Prueba de repetición. Pida al asistente, después de una semana fuera, que enumere las últimas 20 exclusiones con sus motivos. Si inventa motivos o mezcla proyectos, falta la capa de auditoría.
- Prueba de ampliación. Preséntele un resumen fuera de alcance pero temáticamente tentador. Si defiende su inclusión sin citar los criterios fijados, la persistencia del protocolo ha fallado.
- Prueba de relevo. Un colega debería poder continuar a partir del último volcado de estado del asistente sin una explicación verbal. Si no puede, la memoria es personal, no científica.
Jenova supera las pruebas de repetición y relevo cuando se usan realmente las instrucciones, las bases de conocimiento y la memoria de sesión; aun así, exige exportar un registro con formato PRISMA si una revista solicita un diagrama de flujo. Elicit gestiona la prueba de auditoría de forma más nativa y todavía exige conservar el juicio científico informal en algún otro lugar. Consensus y Gemini Notebook, utilizados por sí solos, fallan comprobaciones distintas: Consensus no repetirá sus exclusiones y Gemini Notebook no repetirá artículos que nunca se cargaron.
Por tanto, el problema de la investigación de varios meses no es «qué modelo es más inteligente en 2026». Es si las estrategias de búsqueda, los criterios de inclusión y los hallazgos previos se almacenan en una pila que sigue existiendo cuando regresa. Elija la herramienta que conserve esos tres objetos y, después, haga que el asistente los reitere al inicio de cada sesión para que cualquier desviación ocurra a la vista.
Referencias
- Declaración PRISMA 2020 — Lista de verificación, diagramas de flujo y guía de reporte para revisiones sistemáticas
- Declaración PRISMA — Descripción general de la principal guía de reporte para revisiones sistemáticas
- The BMJ — La declaración PRISMA 2020: guía actualizada para reportar revisiones sistemáticas
- LibGuides de la Universidad de Hofstra — Lista de verificación PRISMA de 27 elementos para revisiones sistemáticas y metaanálisis
- ScienceDirect — Herramientas de AI para revisiones sistemáticas de literatura y metaanálisis, incluido un mapeo de 63 herramientas de ML
- King's College London — Herramientas de AI en síntesis de evidencia
- Elicit — Revisiones sistemáticas de literatura: selección, extracción, auditoría PRISMA, revisiones vivas y resultados de validación
- Elicit — Descripción general del producto y los precios, incluido el tamaño del corpus y la base de investigadores
- Consensus — Motor de búsqueda académico con AI, tamaño del corpus, Deep Search y Medical mode
- Paperguide — Consensus frente a NotebookLM: descubrimiento de evidencia frente a transformación de fuentes (2026)
- Gemini Notebook (anteriormente NotebookLM) — Cuadernos fundamentados en fuentes, citas a nivel de fragmento y política de uso de datos
- DistillerSR — Guías PRISMA y errores que socavan las revisiones sistemáticas
- medRxiv — Precisión y eficiencia de la extracción de datos asistida por AI con Elicit frente a extracción exclusivamente humana (2026)
- Wiley / Cochrane Evidence Synthesis and Methods — Herramientas de AI como segundos revisores para la extracción de datos
- Birmingham City University — Desempeño de la AI generativa en la extracción de datos para revisiones bibliográficas
- PubMed Central — Explicación y elaboración de PRISMA 2020
- EQUATOR Network — Registro de la guía de reporte PRISMA 2020