¿Cómo puedo evitar que un asistente de investigación con AI invente citas falsas?
2026-08-21
¿Qué salvaguardas distinguen las herramientas de investigación con AI basadas en citas de los chatbots que alucinan?
La forma más fiable de impedir que un asistente de investigación con AI invente artículos es rechazar las herramientas que generan referencias de memoria, exigir que cada afirmación se vincule a un registro recuperado con un identificador verificable por máquina y comprobar cada cita frente a la fuente antes de incorporarla a un manuscrito. En 2026, esa combinación —recuperación fundamentada, comprobaciones de identificadores y verificación humana— es lo que separa herramientas de literatura como Jenova's Academic Research Assistant, Elicit, SciSpace, Consensus y Scite de los chatbots de uso general que todavía fabrican referencias con apariencia plausible.
Factores clave que realmente reducen las fuentes inventadas:
✅ Recuperación en lugar de recuerdo — el asistente debe buscar registros académicos indexados, no autocompletar una bibliografía a partir de datos de entrenamiento. ✅ Vinculación a identificadores — cada trabajo citado debe incluir un DOI, PMID, arXiv ID o URL de editor que pueda resolverse de forma independiente. ✅ Fidelidad, no solo existencia — un artículo real citado para respaldar un hallazgo que no contiene sigue siendo un fallo, como ha demostrado la investigación sobre evaluación de RAG. ✅ Precisión bibliográfica — nombres de autores, años, volúmenes e intervalos de páginas deben coincidir con el registro, no con una coincidencia aproximada inventada por el modelo. ✅ Un ciclo de verificación humana — Stanford Libraries y los principales manuales de estilo consideran al autor, no a la herramienta, responsable de cada cita.
Para comparar herramientas de forma útil, conviene tratar la integridad de las citas como un problema de arquitectura, en lugar de como un truco de redacción de prompts. El resto de esta guía describe esa arquitectura, los modos de fallo que pretende detectar y un flujo de trabajo que puedes aplicar con cualquier asistente.
¿Por qué aparecen citas de AI fabricadas en artículos publicados en 2026?
Las citas fabricadas ya no son una anécdota de aula. Están llegando a revistas, expedientes de subvenciones e índices de citas porque los investigadores pegan bibliografías de chatbots en manuscritos sin resolver cada referencia. Un análisis de Nature de 2026 estimó que decenas de miles de publicaciones de 2025 podrían contener referencias no válidas generadas por AI.
El patrón de contaminación es distintivo. El informático Guillaume Cabanac recibió una alerta de que uno de sus artículos había sido citado en el International Dental Journal —un campo que no se solapa con su trabajo sobre la detección de artículos fabricados— y descubrió que no reconocía su propia referencia. Así se propagan las citas fantasma: parecen estar bien formateadas, mencionan revistas de aspecto real y superan una lectura superficial.
Los casos documentados son lo bastante graves como para provocar retractaciones. Resnik y Hosseini resumen un artículo de Academic Ethics en el que 19 de 29 citas eran alucinadas, un artículo de PLOS ONE retirado posteriormente con 18 de 76 citas inventadas y una perspectiva de Digestive Diseases and Sciences en la que 12 de 14 referencias no existían. Un estudio de salud mental de 2025 sobre citas de GPT-4o concluyó que el 56 % contenía errores y aproximadamente una de cada cinco era totalmente alucinada.
La preocupación del profesorado es ahora casi universal. La investigación de College Board informa de que los docentes temen que el uso de AI esté socavando el pensamiento crítico, la escritura original y la integridad académica. Guías de bibliotecas como la de UNC Charlotte tratan ahora las citas alucinadas como un riesgo estándar de investigación, no como un caso excepcional.
La implicación para elegir una herramienta es directa. Si un asistente puede emitir una referencia APA o Vancouver con buena apariencia sin recuperar un registro activo, puede inventar un artículo que nunca existió, y ese artículo puede llegar a imprimirse.
¿Qué debes evaluar antes de confiar a un asistente de investigación con AI tu lista de referencias?
Debes evaluar un asistente de investigación con AI según una pila de integridad de citas de cinco partes: fuente de verdad, vinculación a identificadores, fidelidad entre afirmación y pasaje, precisión bibliográfica y un ciclo obligatorio de verificación humana. Las herramientas que obtienen buenos resultados en fluidez y malos resultados en esta pila no son seguras para listas de referencias, independientemente de lo pulida que parezca su prosa.
1. Fuente de verdad
Pregunta si las respuestas proceden de un corpus recuperado o de memoria paramétrica. Los sistemas aumentados por recuperación buscan en Google Scholar, PubMed, Semantic Scholar, Scopus o arXiv y después generan. Los chatbots sin recuperación predicen el siguiente token de una cita. Existen métricas de fidelidad precisamente porque la generación puede desviarse del contexto recuperado incluso cuando se produjo recuperación.
2. Vinculación a identificadores
Una terna de título, autor y año no es suficiente. Exige un DOI, PMID, PMCID o URL de editor, y resuélvelo por tu cuenta. Las referencias fantasma suelen fallar esta prueba de inmediato. Las coincidencias bibliográficas aproximadas —un artículo real con un volumen o intervalo de páginas erróneo— fallan al revisarlas por segunda vez.
3. Fidelidad entre afirmación y pasaje
La investigación de ACM sobre citas RAG concluyó que la corrección no es fidelidad: hasta el 57 % de las citas puede no respaldar la afirmación que supuestamente sustenta. Un artículo que existe pero no contiene el hallazgo es tan peligroso como un artículo inexistente, porque blanquea un resultado falso a través de un autor real.
4. Precisión bibliográfica
El orden de autores, año, revista, volumen, número y páginas deben coincidir con el registro. Las herramientas RAG sometidas a pruebas de administración de empresas han mostrado que los elementos fantasma totalmente fabricados pueden ser poco frecuentes, mientras que los pequeños errores bibliográficos siguen siendo comunes. Estos errores todavía rompen los índices de citas y pueden ocultar artículos intercambiados.
5. Ciclo de verificación humana
La política de revistas de APA, resumida por Stanford, establece que los autores deben verificar toda información y cita proporcionada por una herramienta de AI. Las directrices para investigadores de Wiley y la orientación de integridad de investigación de Harvard también asignan la divulgación y la precisión al autor humano. Ningún asistente de esta categoría elimina esa obligación.
Pondera la pila según la tarea. Las revisiones sistemáticas deben dar mayor peso a la fidelidad y a la vinculación a identificadores. La exploración inicial puede tolerar una recuperación más amplia si cada candidato seleccionado se verifica antes de citarse. Nunca des demasiado peso a la calidad de la prosa. Los párrafos fluidos son el mecanismo que hace convincentes las citas falsas.
¿Cómo se comparan las herramientas populares de investigación con AI en fiabilidad de citas?
Difieren drásticamente en si las referencias se recuperan de índices académicos o se generan desde la memoria del modelo, y esa única decisión de diseño predice la mayor parte del riesgo de citas fantasma. Los chatbots de uso general siguen siendo la opción de mayor riesgo para bibliografías. Los asistentes de investigación diseñados específicamente para ello reducen las referencias fantasma, pero aún pueden citar incorrectamente, registrar metadatos erróneos y exagerar lo que demuestra un artículo.
A partir de 2026, una comparación práctica es la siguiente:
| Función / Dimensión | Chatbots de uso general (p. ej., ChatGPT) | Elicit | SciSpace | Consensus | Scite | Jenova Academic Research Assistant |
|---|---|---|---|---|---|---|
| Fuente de evidencia | Principalmente memoria paramétrica, salvo que la navegación esté activada | Artículos recuperados, tablas de extracción | Recuperación en múltiples bases de datos (Google Scholar, PubMed, arXiv) | Artículos recuperados para preguntas empíricas | Índice de citas con contexto de apoyo y contraste | Descubrimiento de literatura en tiempo real en bases de datos y repositorios académicos |
| Riesgo de referencias fantasma | Alto; documentado en revistas y laboratorios | Bajo en estudios RAG sobre listas de referencias | Bajo en estudios RAG sobre listas de referencias | Basado en recuperación; aun así, verifica | Bajo para elementos dentro de su grafo de citas | Basado en recuperación; aún requiere comprobaciones independientes de DOI |
| Fidelidad entre afirmación y fuente | Débil sin pasajes recuperados | Más sólida para extracción estructurada | Más sólida cuando las respuestas citan artículos recuperados | Más sólida para preguntas empíricas de sí/no | Sólida para saber cómo se cita un artículo | Depende de los pasajes recuperados y de la elección de modelo; requiere comprobación humana |
| Precisión bibliográfica | Detalles inventados frecuentes | Se han notificado inexactitudes menores en auditorías RAG | Se han notificado inexactitudes menores en auditorías RAG | No verificada al nivel de auditoría de campo | Sólida en torno al contexto de citación | Hereda metadatos de los registros recuperados; aun así, puede desviarse en la prosa |
| Precios (en 2026) | Varían según el plan del proveedor | No verificado | No verificado | No verificado | No verificado | Nivel gratuito con uso limitado; planes de pago desde $20/mes |
| Mejor para | Redactar lenguaje, no crear una lista de referencias | Tablas de evidencia y extracción sistemática | Búsqueda bibliográfica amplia e interdisciplinaria | Respuestas rápidas a preguntas empíricas de sí/no | Validar si las citas respaldan o contradicen una afirmación | Descubrimiento de literatura de extremo a extremo, preparación de manuscritos y gestión de citas con memoria persistente |
Chatbots de uso general
Los chatbots destacan al crear esquemas y parafrasear, pero fallan al construir bibliografías. La auditoría de salud mental de GPT-4o citada anteriormente ofrece la cifra de advertencia: más de la mitad de las citas generadas contenían errores. Si una herramienta puede emitir una referencia de apariencia perfecta sin un registro activo, trata cada cita como no verificada.
Elicit
Elicit es más sólido cuando el trabajo consiste en examinar artículos y extraer métodos, resultados y limitaciones en una tabla. Las comparaciones independientes lo describen como más adecuado para flujos de trabajo rigurosos basados en evidencia que para búsquedas exploratorias rápidas. Su limitación es la densidad de cobertura: en un benchmark de 200 consultas realizado por SciSpace, Elicit devolvió 13,0 artículos muy relevantes por consulta frente a 26,3 de SciSpace Deep Review. Esa diferencia importa para la recuperación, no para el riesgo de citas fantasma.
SciSpace
SciSpace busca en múltiples bases de datos académicas y, en su propia evaluación de Deep Review, lideró la precisión desde P@3 hasta P@70. Esa amplitud ayuda con preguntas interdisciplinarias cuya evidencia se encuentra simultáneamente en PubMed, arXiv y Google Scholar. La limitación es metodológica: el benchmark principal fue ejecutado por SciSpace, aunque las etiquetas de relevancia procedían de tres modelos externos. Considera los benchmarks de proveedores como orientativos y verifica por tu cuenta los artículos seleccionados.
Consensus
Consensus está diseñado para responder preguntas científicas empíricas a partir de artículos, en lugar de redactar una revisión narrativa. En la misma prueba de 200 consultas, Consensus Deep obtuvo la mejor precisión en el primer resultado (P@1 = 0.5882) y después perdió esa ventaja a mayor profundidad en la lista. Es una sólida herramienta para encontrar puntos de partida y una opción menos potente para conjuntos extensos de cribado.
Scite
El activo distintivo de Scite es la inteligencia de citas: permite ver si artículos posteriores respaldan, mencionan o contradicen una afirmación determinada. Las comparaciones lo sitúan como una herramienta más limitada que una plataforma completa de operaciones de investigación, pero más sólida para la validación de evidencia. Si tu modo de fallo es «este artículo real no dice lo que afirmó el asistente», el contexto de citas al estilo de Scite es el instrumento adecuado.
Jenova Academic Research Assistant
Jenova's Academic Research Assistant está diseñado para académicos y estudiantes de doctorado que necesitan descubrimiento de literatura, además de apoyo para manuscritos y citas, en un único espacio de trabajo persistente. Puede buscar en tiempo real en las principales bases de datos y repositorios académicos, mantener la memoria del proyecto entre sesiones y redactar con modelos actuales en lugar de quedar limitado a un único proveedor. Esta combinación resulta útil cuando una revisión abarca semanas y el asistente debe recordar criterios de inclusión, artículos rechazados y DOI no resueltos.
No es un índice dedicado de contexto de citas, por lo que no sustituirá a Scite para mapas de respaldo frente a contraste. Tampoco es una cuadrícula de extracción diseñada específicamente para ese fin en el sentido de Elicit. La búsqueda en tiempo real también puede recuperar registros de baja calidad o poco adecuados que un modelo fluido interpreta en exceso. La regla operativa honesta es la misma que para toda herramienta de recuperación: úsala para encontrar y organizar candidatos, no para validar una bibliografía.
¿La generación aumentada por recuperación elimina por completo las referencias fantasma?
No. La generación aumentada por recuperación (RAG) reduce drásticamente los artículos totalmente inventados en la lista de referencias, pero no elimina los errores bibliográficos ni garantiza que un artículo recuperado respalde la oración a la que se adjunta. Por tanto, la prevención debe abordar tres modos de fallo diferentes, no uno solo.
Los tres modos son fáciles de confundir porque los tres producen «citas de apariencia plausible»:
- Referencias fantasma — el trabajo citado no existe.
- Deriva bibliográfica — el trabajo existe, pero los autores, el año, el volumen o las páginas son erróneos.
- Alucinación de contexto — el trabajo existe y los metadatos son en gran medida correctos, pero el asistente le atribuye un hallazgo que el artículo no contiene.
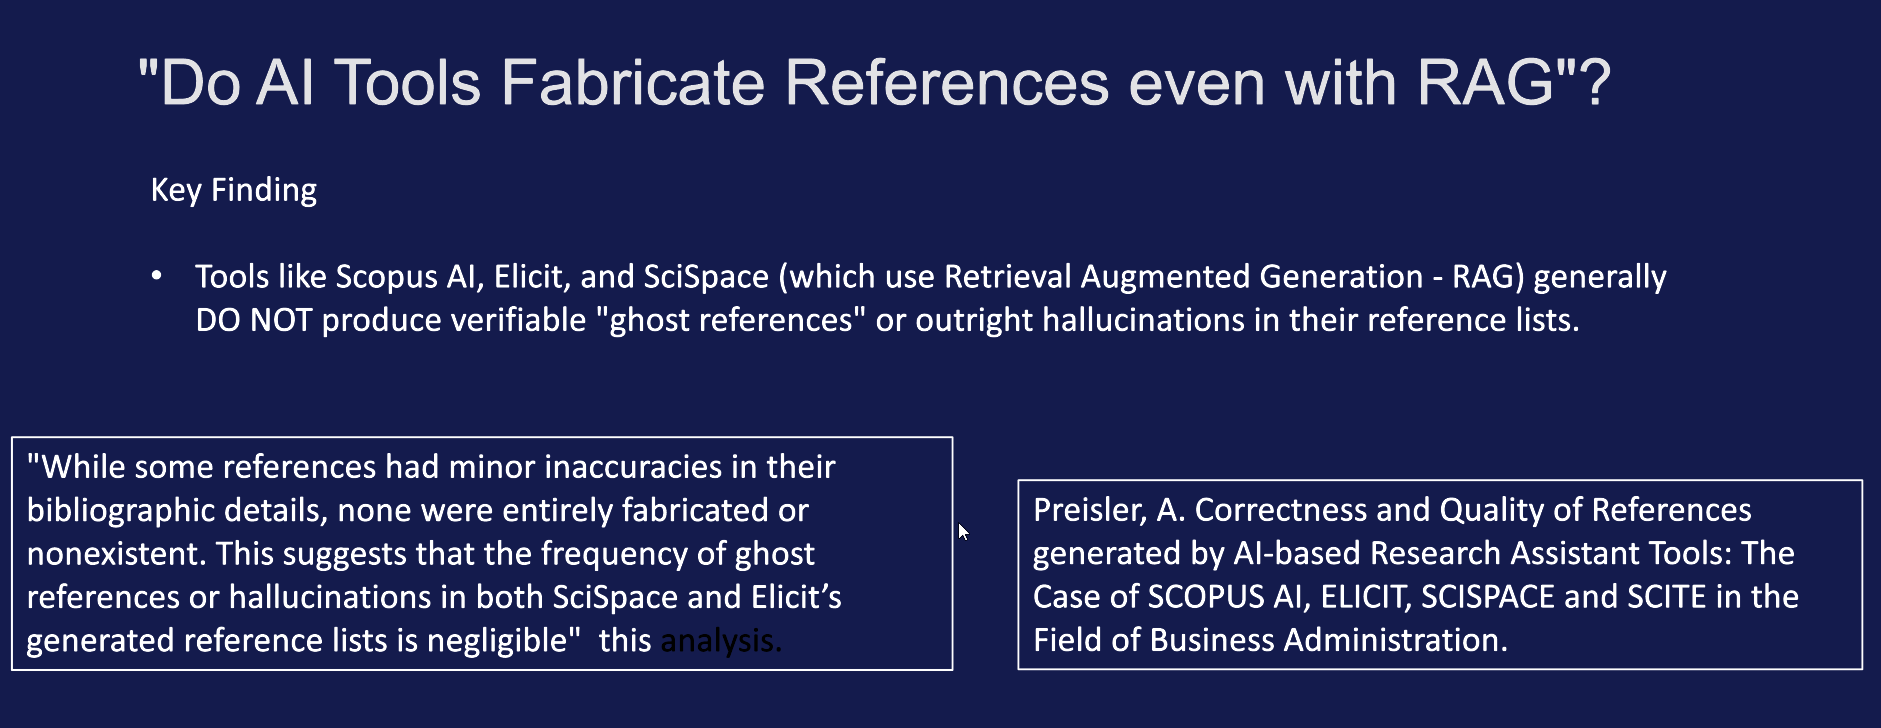
Un análisis de campo de Scopus AI, Elicit, SciSpace y Scite en administración de empresas determinó que las herramientas basadas en RAG generalmente no emitían referencias fantasma verificables. Aun así, aparecieron inexactitudes bibliográficas menores; las fuentes completamente inexistentes fueron insignificantes en esas listas generadas. Esa es la interpretación correcta de RAG: es un control sólido contra los fantasmas, no un sistema completo de calidad de citas.
La investigación sobre fidelidad explica el riesgo restante. Los marcos de evaluación de RAG separan la relevancia de la respuesta de la fidelidad: una respuesta puede ser pertinente y, aun así, no estar fundamentada en los pasajes recuperados. El hallazgo de ACM de que una gran proporción de las citas RAG puede carecer de fidelidad es la advertencia operativa. Si solo compruebas si un DOI se resuelve, detectarás fantasmas y pasarás por alto afirmaciones atribuidas erróneamente.
Los chatbots de uso general fallan en el primer modo. Los asistentes RAG fallan principalmente en el segundo y el tercero. Por ello, un flujo de prevención que solo pregunta «¿existe este artículo?» está incompleto para las herramientas que los investigadores deberían utilizar realmente.
¿Cómo verificas las citas que devuelve un asistente de investigación con AI?
Verifícalas con un protocolo de dos pasadas: primero resuelve el identificador y luego confirma que un pasaje específico respalda la afirmación. Omitir cualquiera de las dos pasadas es la forma en que las fuentes inventadas o mal utilizadas llegan a la publicación.
Pasada 1 — ¿Existe el registro?
- Copia exactamente el título, primer autor, año y DOI tal como fueron devueltos.
- Resuelve el DOI en un registro o página del editor. Si no hay DOI, busca el título exacto en Google Scholar, PubMed o el sitio de la revista, siguiendo el enfoque de búsqueda directa que recomiendan las guías de investigación.
- Rechaza cualquier elemento que no se resuelva, que se resuelva en un artículo diferente o que exista únicamente como una cita formateada por AI.
- Comprueba el orden de autores, año, volumen, número y páginas frente al registro del editor, no frente al bloque bibliográfico del asistente.
Pasada 2 — ¿Este artículo respalda esta oración?
- Abre el texto completo en PDF o HTML. Los resúmenes no bastan para afirmaciones causales, tamaños de efecto o lenguaje de «primera evidencia».
- Localiza el pasaje que supuestamente respalda la afirmación. Cítalo textualmente en tus notas.
- Marca la cita como de respaldo, mención o contraste: la distinción que Scite convierte en producto y que también puedes aplicar manualmente.
- Si el asistente parafraseó una limitación como un hallazgo o una hipótesis como un resultado, descarta la cita para esa oración.
Para Jenova's Academic Research Assistant, restringe la recuperación antes de generar siquiera una lista de referencias:
«Busca artículos revisados por pares y preprints sobre [tema], 2019–2026. Devuelve únicamente elementos con DOI o PMID. Para cada uno: título, autores, año, revista, identificador, hallazgo en una oración y un pasaje citado textualmente. Si no puedes recuperar un registro verificable, omite el elemento por completo. No completes ni adivines metadatos.»
Después, pasa los mismos artículos seleccionados por Elicit o SciSpace como segunda comprobación del corpus. El desacuerdo entre herramientas es una ventaja: señala artículos que un sistema clasificó pero que el otro no pudo recuperar.
El reportaje de Science sobre artículos científicos alucinados muestra por qué leer los títulos superficialmente no funciona. Un asistente puede citar correctamente un artículo real y luego inventar uno cercano en el mismo párrafo. La verificación debe realizarse elemento por elemento, no párrafo por párrafo.
¿Una cita alucinada podría considerarse mala conducta en investigación?
Sí, en un conjunto definido de casos; e incluso cuando no cumple la definición legal de mala conducta, puede provocar retractaciones, problemas con subvenciones y daños profesionales. El motivo para prevenirla no es la etiqueta. Es la responsabilidad legal y profesional.
Resnik y Hosseini sostienen que una cita alucinada puede calificarse como mala conducta demostrable en investigación conforme a la normativa federal de Estados Unidos cuando se cumplen tres condiciones: un investigador utilizó una herramienta generativa para producir citas inexistentes; esas citas funcionan como datos porque respaldan hallazgos, como en revisiones o estudios bibliométricos; y el investigador mostró indiferencia ante el riesgo de fabricación al no comprobar los resultados. Una referencia fantasma en una introducción narrativa es una mala práctica académica. Una referencia fantasma contabilizada como evidencia en una revisión sistemática se parece más a datos fabricados.
Los financiadores ya están tratando el problema como una cuestión operativa. En el verano de 2025, el personal de revisión de subvenciones de NIH recibió una avalancha de propuestas asistidas por AI, y la agencia ha indicado que el uso indebido de AI descubierto después de una adjudicación puede remitirse a revisión de integridad. El centro de integridad de investigación de Harvard reitera restricciones relacionadas: las herramientas de AI no pueden figurar como autoras, los revisores científicos pares de NIH tienen prohibido utilizar AI generativa para formular críticas y los autores deben divulgar cómo se utilizaron las herramientas.
Las revistas están convergiendo en la misma asignación de responsabilidad. La recopilación de Stanford de las normas de APA, MLA, Chicago e IEEE exige divulgar el contenido generado por AI y, en el caso de APA, verificar explícitamente por humanos las citas. La guía docente de Cornell también advierte que los algoritmos automatizados de detección de AI son demasiado poco fiables para constituir una estrategia de integridad. La detección posterior es un sustituto débil de la verificación previa al envío.
El estándar práctico es simple. Si no puedes señalar un registro resuelto y un pasaje de respaldo, la cita no pertenece al manuscrito, la presentación ni la subvención.
¿Qué dicen los especialistas en integridad de investigación sobre las citas generadas por AI?
Los especialistas tratan ahora las referencias inventadas como un fallo de proceso —usar un modelo generativo como biblioteca— en lugar de como un misterioso error del modelo que los usuarios no pueden anticipar. El consenso entre oficinas de integridad y estudios de citas es que RAG reduce los fantasmas, la verificación humana sigue siendo obligatoria y las bibliografías desatendidas de chatbots son imprudentes ante lo que ya se conoce sobre la tasa de fallo.
«El error que sigue llegando a las revistas no es que los modelos a veces adivinen. Es que los investigadores permiten que un modelo de lenguaje realice una tarea de catalogación para la que no está diseñado. Si el asistente no recuperó un registro, está completando un patrón bibliográfico, y los patrones completados son la forma de obtener un artículo de aspecto real en una revista de aspecto real con un DOI que no se resuelve. Cambiar a una herramienta de recuperación reduce drásticamente ese modo de fallo. No reduce el siguiente: citar un artículo real para un resultado que existe en el resumen del modelo y no en la sección de resultados.»
«Indicamos a los usuarios de investigación que sigan un flujo de trabajo de tres categorías. La categoría A se recupera y se comprueba por pasaje; esas citas pueden utilizarse. La categoría B se recupera, pero solo se comprueba en metadatos; permanece en una lista de lectura. La categoría C incluye cualquier elemento que el modelo emitió sin un identificador resoluble; se elimina, no se deja para “buscarlo más tarde”. Los equipos que omiten la categoría C porque el formato parece costoso son los que después descubren que 12 de 14 referencias nunca existieron. El coste de la pasada adicional es insignificante frente a una retractación o una remisión de integridad de subvenciones.»
— Equipo de Producto de Jenova, diseño de agentes de investigación con AI para flujos de trabajo académicos
Este consejo se alinea con las políticas de editoriales y universidades: nombra la herramienta, nombra la tarea que realizó y mantén al autor humano responsable de cada referencia. La orientación sobre integridad ya no es «evita la AI». Es «no subcontrates la existencia de tus fuentes».
¿Cómo realizas una revisión bibliográfica segura en citas con AI?
Realízala como una canalización con recuperación primero, extracción después y prosa al final, además de una puerta de verificación que ninguna oración pueda omitir. Invertir ese orden —redactar el argumento y luego pedir a un asistente que «añada citas»— es el patrón de prompt más asociado con las referencias fantasma.
Un flujo de trabajo que resiste el escrutinio de revistas y subvenciones:
- Redacta reglas de inclusión antes de buscar. Población, intervención, años, idiomas y tipos de estudio. Pega esas reglas en el asistente para que la memoria, si la herramienta la tiene, persista entre sesiones.
- Busca con dos herramientas de recuperación, no con una. Ejemplo de combinación: Jenova's Academic Research Assistant más Elicit o SciSpace. Conserva la unión de los resultados; no confíes en una sola lista clasificada.
- Fija un conjunto de candidatos con identificadores. Exporta título, autores, año, revista y DOI/PMID. Todo lo que no tenga identificador espera fuera del conjunto.
- Extrae, no resumas, a partir del texto completo. Métodos, muestra, resultados, limitaciones y una oración citada textualmente. Las tablas al estilo de Elicit son útiles aquí; los resúmenes narrativos son donde se infiltra la alucinación de contexto.
- Redacta a partir de la tabla de extracción. Si una oración no tiene una fila en la tabla, no recibe una cita y quizá no debería estar en el artículo.
- Divulga las herramientas. Sigue la recopilación de Stanford de las normas de los manuales de estilo: nombre de la herramienta, versión, fecha y función realizada, como búsqueda, extracción o edición lingüística.
- Realiza una revisión final de DOI sobre la bibliografía enviada. Esta última pasada detecta desviaciones de copiar y pegar y cualquier referencia que el modelo insertó durante la revisión.
Un prompt que mantiene a Jenova dentro de la canalización en lugar de utilizarlo en modo chatbot:
«Usando únicamente el conjunto de candidatos que cargué, redacta la sección de antecedentes. Cada oración empírica debe citar un DOI de ese conjunto y no debe introducir fuentes nuevas. Si una afirmación no está respaldada por las notas de extracción, márcala como UNSUPPORTED en lugar de citarla.»
Para SciSpace o Elicit, utiliza la vista de recuperación o extracción de cada herramienta para reconstruir la misma tabla y comparar filas. Cuando las tablas discrepen sobre un hallazgo, lee el PDF. El desacuerdo cuesta menos que una corrección posterior a la publicación.
La restricción que hace funcionar la canalización es tanto psicológica como técnica: nunca pidas a ningún asistente, incluso a uno sólido, que «proporcione referencias» para una prosa escrita sin fuentes. Ese prompt vuelve a convertir una herramienta de investigación en un generador de citas, que es precisamente el modo de fallo que toda esta pila está diseñada para evitar.
Referencias
- Nature — Las citas alucinadas están contaminando la literatura científica
- Accountability in Research (Resnik y Hosseini) — Citas alucinadas producidas por inteligencia artificial generativa
- Stanford Libraries — AI en la investigación académica: directrices de citación
- ACM Digital Library — La corrección no es fidelidad en la generación aumentada por recuperación
- DeepEval — Métrica de fidelidad para sistemas RAG
- Confident AI — Métricas de evaluación RAG: relevancia de respuesta, fidelidad y relevancia contextual
- Biblioteca de UNC Charlotte — Guía de investigación sobre citas alucinadas por AI
- Wiley — Directrices de AI para investigadores
- College Board — Preocupación del profesorado por que el uso de AI por estudiantes socave la integridad académica
- Integridad Académica y de Investigación de Harvard Medical School — AI en la investigación
- Cornell Center for Teaching Innovation — AI e integridad académica
- SciSpace — Benchmark de búsqueda bibliográfica de SciSpace frente a Elicit y Consensus en 200 consultas
- Paperguide — Comparación entre Elicit y SciSpace
- Paperguide — Comparación entre Elicit y Scite
- Science — Citar sin haber visto: cuando la AI alucina artículos científicos
- SciSpace — Comparación de productos SciSpace frente a Elicit