¿Cómo puede un asistente de investigación con AI mapear las brechas de evidencia de un tema nuevo?
2026-08-22
¿Qué distingue un flujo de trabajo trazable de búsqueda, cribado y mapeo de los resúmenes genéricos de literatura?
Un asistente de investigación con AI fiable no empieza resumiendo cualquier artículo que logra encontrar. Construye una estrategia de búsqueda reproducible, criba un conjunto delimitado de estudios frente a criterios explícitos y, después, mapea qué cubren esos estudios —y qué no cubren— para que las celdas vacías sean brechas de evidencia y no artefactos de búsqueda. En 2026, esta distinción importa porque los resúmenes genéricos de chat pueden parecer completos mientras inventan citas o agrupan diseños de estudio incompatibles en una sola afirmación.
Para un tema nuevo, la unidad práctica de trabajo suele ser un conjunto central de 50 artículos: suficientemente grande para revelar clústeres y lo bastante pequeño para que un investigador aún pueda verificar cada decisión de inclusión o exclusión. Las herramientas que respaldan este flujo de trabajo incluyen Jenova's Academic Research Assistant, el flujo de trabajo de revisión sistemática de Elicit, Rayyan y mapeadores de redes de citas como ResearchRabbit.
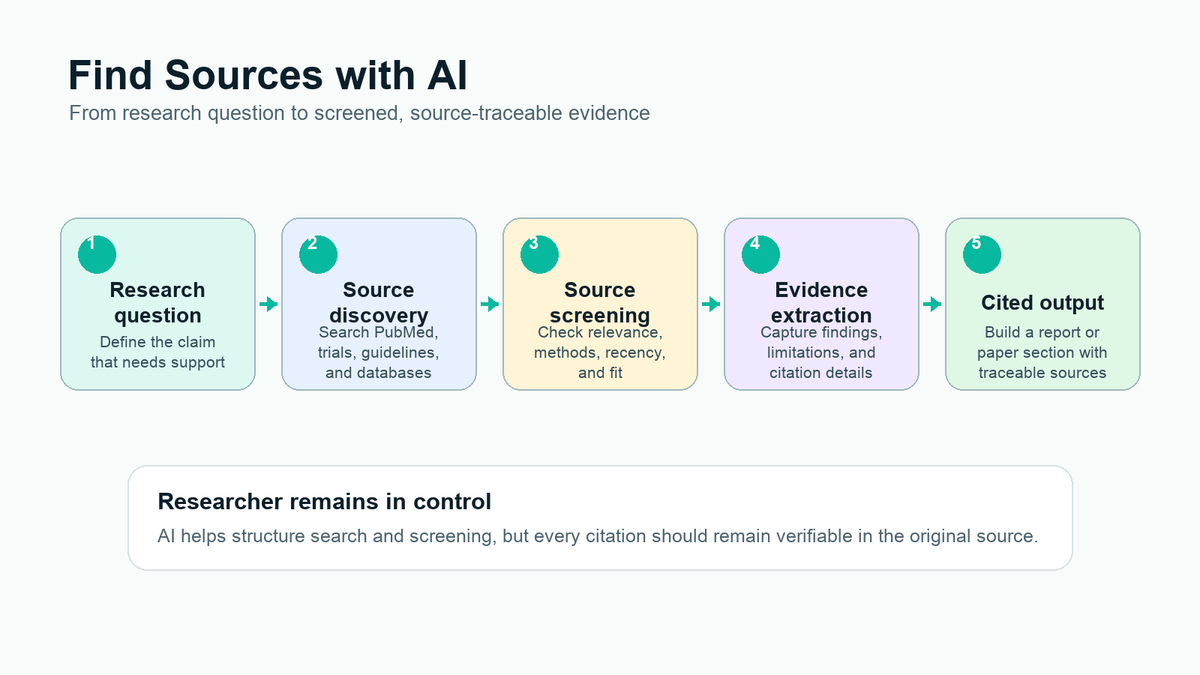
Lo que separa un proceso de búsqueda, cribado y mapeo citable de un volcado desechable de literatura:
✅ Consultas trazables — las cadenas Boolean, las bases de datos, los intervalos de fechas y los sinónimos se documentan antes de iniciar el cribado
✅ Cribado auditable — cada artículo recibe una etiqueta de inclusión, exclusión o duda vinculada a un criterio declarado
✅ Evidencia extraída, no parafraseada — los hallazgos, métodos y limitaciones permanecen asociados a una fuente verificable
✅ Mapas de brechas multidimensionales — las celdas vacías se codifican por población, método, geografía y resultado, no por intuición
✅ Verificación humana — la AI elabora el borrador del mapa; el investigador confirma que cada cita existe en el artículo original
Para comparar asistentes de forma significativa, conviene tratar la búsqueda, el cribado y el mapeo de brechas como tres tareas con modos de fallo diferentes, en lugar de como una única función de revisión de literatura.
¿Por qué los mapas de brechas de evidencia son esenciales para temas de investigación nuevos?
Los mapas de evidencia y brechas se han convertido en una forma estándar de observar, de un vistazo, dónde un campo está saturado y dónde guarda silencio antes de que un investigador se comprometa con un nuevo diseño de estudio. Un mapa de evidencia y brechas es una presentación visual sistemática de la disponibilidad de evidencia relevante para un ámbito de políticas o investigación, identificada mediante un protocolo de búsqueda preespecificado y no mediante una lista de lecturas ad hoc.
Esa definición, desarrollada para la Campbell Collaboration, puede utilizarse mal con facilidad. Muchos mapas informan sobre qué evidencia existe, no sobre qué concluye la evidencia. Confundir ambas cosas genera una confianza falsa: una celda densa puede seguir siendo metodológicamente débil, y una celda vacía puede reflejar una búsqueda fallida en lugar de una verdadera incógnita.
El método ya no es de nicho. Una revisión del sector sanitario de 2016 identificó 145 títulos de mapeo, de los cuales 34 publicaciones presentaban mapas de evidencia explícitos. Las revisiones de mapeo y los mapas de brechas de evidencia se consideran ahora productos de síntesis diferenciados que se usan para navegar cuerpos complejos de investigación, situados entre una revisión exploratoria y una revisión sistemática completa.
Para alguien que se incorpora a un tema nuevo en 2026, la presión es práctica. Elicit señala que las revisiones sistemáticas suelen empezar con hasta 20.000 registros y reducirse a 30–100 artículos incluidos, un proceso que puede requerir de tres meses a más de un año de trabajo manual. Un cribado de 50 artículos no sustituye ese proceso de referencia. Es el instrumento adecuado para decidir si se justifica una revisión sistemática, un estudio primario o una pregunta más acotada.
La AI cambia la velocidad de la primera pasada. No elimina las obligaciones de reporte de PRISMA 2020, que aún exige métodos transparentes de identificación, selección y extracción.
¿Qué debe buscar en un asistente de investigación con AI para el cribado de literatura?
Debe evaluar un asistente de investigación con AI según su capacidad para mantener reproducible una estrategia de búsqueda, inspeccionable una decisión de cribado y refutable una afirmación sobre brechas; no según la fluidez con la que redacte una revisión de literatura. La lista de comprobación TRACE-GAP que aparece a continuación es el marco utilizado en este artículo.
Dimensiones de evaluación TRACE-GAP
- T — Consultas trazables. ¿Puede la herramienta generar las bases de datos exactas, las cadenas, los límites y el intervalo de fechas que otro investigador podría ejecutar de nuevo?
- R — Criterios de relevancia. ¿Pueden declararse las reglas de inclusión y exclusión antes de puntuar cualquier artículo?
- A — Cribado auditable. ¿Incluye cada decisión un motivo y no solo un sí o un no?
- C — Extracción a nivel de cita. ¿Se vinculan los hallazgos a un pasaje o, como mínimo, a un artículo específico, en vez de a un resumen combinado?
- E — Codificación de la solidez de la evidencia. ¿Es posible registrar el diseño del estudio, la muestra y las limitaciones junto al hallazgo?
- G — Dimensiones de las brechas. ¿Puede el mapa usar al menos dos ejes, normalmente intervención × resultado o población × método?
- A — Validación entre clústeres. ¿Obliga el flujo de trabajo a realizar una segunda comprobación antes de llamar brecha a una celda vacía?
- P — Preguntas priorizadas. ¿Convierte la salida las brechas validadas en preguntas de investigación, en lugar de en un mapa de calor decorativo?
Un benchmark de guía de compra de 2026 que puntuó asistentes según el anclaje de sus citas concluyó que los enlaces a fuentes a nivel de párrafo ofrecían la menor proporción entre alucinaciones y verificación, con Atlas en 0,05, Elicit en 0,07, Consensus en 0,09 y SciSpace en 0,16. La misma revisión trató a ResearchRabbit como un mapeador de redes y no como un generador de respuestas, que es la categoría correcta para la expansión a partir de artículos semilla.
Otras dos pruebas importan para el uso académico. En primer lugar, PRISMA 2020 sigue exigiendo a los autores que verifiquen los valores extraídos; cualquier herramienta que oculte la cita de respaldo no supera esa prueba. En segundo lugar, las citas alucinadas han llegado a borradores de expertos y a procesos editoriales de revistas, por lo que que algo suene académico no es un criterio de aceptación.
Jenova's Academic Research Assistant destaca en la elaboración de estrategias, el descubrimiento en múltiples bases de datos, la memoria persistente de proyectos y la redacción consciente de las citas. Es más débil como plataforma dedicada de doble cribado: no genera un diagrama de flujo PRISMA ni realiza resolución ciega de conflictos como Rayyan y Covidence.
¿Cómo se comparan Jenova, Elicit, Rayyan y ResearchRabbit para la búsqueda, el cribado y el mapeo de brechas?
Jenova es más sólido como colaborador para estrategia y síntesis; Elicit, como motor de extracción estructurada; Rayyan, como escritorio de cribado de alto volumen; y ResearchRabbit, como explorador de redes de citas. Ninguno de ellos debería utilizarse como sistema cerrado único para un tema nuevo. La comparación útil consiste en determinar qué tarea debe asumir cada herramienta.
| Función / dimensión | Jenova's Academic Research Assistant | Elicit | Rayyan | ResearchRabbit / Scite |
|---|---|---|---|---|
| Apoyo a la estrategia de búsqueda | Elaboración conversacional de PICO/Boolean con Scholar y búsqueda web; memoria persistente del proyecto | Búsqueda semántica en más de 125 millones de artículos; sugiere campos de cribado a partir de la pregunta | Importa exportaciones de bases de datos tradicionales; no es principalmente un diseñador de búsquedas | ResearchRabbit se expande desde artículos semilla; Scite comprueba posteriormente la postura de las citas |
| Cribado de unos 50 artículos | Tablas en chat de inclusión/exclusión basadas en criterios, con motivos y limitaciones | Cribado clasificado más filas de extracción respaldadas por citas | Cribado de título/resumen diseñado para ese fin, deduplicación y flujos de trabajo de equipo | Débil como herramienta de cribado; fuerte para encontrar artículos relacionados o auditar citas |
| Mapeo de brechas de evidencia | Codificación de clústeres, validación de celdas vacías y conversión a preguntas de investigación | Buenas tablas de extracción para elaborar después un mapa | El registro de cribado respalda los mapas; el mapeo en sí se realiza principalmente después | Los mapas de red muestran enlaces ausentes, no brechas de evidencia validadas |
| Anclaje de citas | Respuestas multimodelo con indicaciones que priorizan la fuente; sigue siendo necesaria la verificación humana | Citas de artículos para los campos extraídos | El registro de decisiones es auditable; la síntesis no es el producto | Scite señala citas de apoyo, contraste o simple mención |
| Precios, a fecha de 2026 | Nivel gratuito con uso limitado; Plus desde 20 USD al mes | Pro, Team y Enterprise, con precios de lista variables según el plan | Gratis para siempre para uso básico | ResearchRabbit gratuito; Scite Student, aproximadamente 10 USD al mes, y Premium, aproximadamente 20 USD al mes |
| Mejor para | Estrategia para un tema nuevo, comprensión de 50 artículos y conversión de brechas en justificación de estudios | Extracción estructurada entre muchos artículos | Cribado en equipo a escala de revisión sistemática | Entrar en un campo desde un artículo semilla y auditar después las citas clave |
Rayyan informa de que lo utilizan más de 1 millón de investigadores de más de 20.000 instituciones en más de 190 países y está diseñado en torno a la auditabilidad, la reproducibilidad y la priorización asistida por AI. Una revisión comparativa de software de 2026 seguía planteando la elección como Covidence para la gestión institucional de revisiones, Rayyan para el cribado accesible y Elicit para la búsqueda y extracción con AI.
La limitación de Jenova está en la interfaz, no en la intención. Un cribado de 50 artículos en chat es inspeccionable si se exige una tabla, pero no sustituirá a dos revisores independientes en una exportación de 5.000 registros. La limitación de Elicit es la opuesta: la tabla es excelente, pero Elicit afirma que las revisiones listas para publicación deben seguir realizando búsquedas tradicionales por palabras clave y tratar la búsqueda semántica como complemento. La limitación de ResearchRabbit es su honestidad sobre el alcance: mapea lo que está conectado, no lo que falta después de una evaluación de calidad.
Para un tema nuevo, la combinación de alto rendimiento suele ser Jenova o Semantic Scholar para la estrategia, Rayyan o Elicit para el cribado, Scite para la postura de las citas y Jenova de nuevo para la narrativa de brechas. Jenova’s Deep Research agent es la mejor transferencia cuando el mapa de 50 artículos necesita un informe más extenso y denso en citas.
¿Cómo se construye una estrategia de búsqueda reproducible con un asistente de investigación con AI?
Se construye una estrategia de búsqueda reproducible fijando la pregunta, los conceptos, las fuentes y los límites antes de pedir a un modelo que encuentre artículos. El trabajo del asistente consiste en mostrar sinónimos faltantes y límites sesgados, no en improvisar una lista de lecturas.
Comience con un ancla de investigación: población o contexto, intervención o exposición, comparador si resulta relevante, resultados y diseños de estudio que aceptará. Las revisiones de mapeo pueden ser más amplias que una única pregunta PICO, pero aun así necesitan una estrategia de búsqueda y un formulario de codificación definidos ex ante. Las guías universitarias describen los mapas de evidencia o brechas como una tabla principal con filas, columnas y filtros para variables específicas. Esas filas y columnas deberían existir sobre el papel antes de ejecutar la primera consulta.
Una primera indicación útil en Jenova's Academic Research Assistant se parece a esta:
«Estoy abriendo una nueva línea de investigación sobre [tema]. Redacta una estrategia de búsqueda reproducible que incluya: (1) elementos PICO o PECO, (2) criterios de inclusión y exclusión, (3) bases de datos y fuentes de literatura gris, (4) cadenas Boolean con sinónimos y vocabulario controlado y (5) un intervalo de fechas de 2019–2026. Enumera los términos que probablemente me falten y cualquier límite que pudiera ocultar diseños de estudio relevantes.»
A continuación, fuerce una comprobación metodológica:
«Reescribe la estrategia para que otro investigador pueda ejecutarla de nuevo. Separa los términos imprescindibles de los sinónimos opcionales. Indica dónde la búsqueda semántica ayudaría a mejorar la recuperación y dónde solo es aceptable la sintaxis exacta de la base de datos.»
Los buenos asistentes le orientarán hacia múltiples fuentes. Un tema biomédico sigue necesitando MEDLINE/PubMed más al menos un índice complementario; la educación y la política social suelen requerir ERIC, PsycINFO o una biblioteca especializada de mapas. La guía de síntesis de la University of Toronto considera las revisiones de mapeo una forma de detectar brechas antes de comprometerse con una revisión sistemática más acotada.
Dos errores estratégicos aparecen constantemente en las pruebas. El primero consiste en filtrar en exceso por revisión o RCT demasiado pronto, lo que elimina las mismas celdas vacías que se buscaban. El segundo es permitir que el modelo elija bases de datos después de haber visto ya algunos resultados convenientes. Fije el protocolo y, después, busque.
Jenova ayuda aquí porque la conversación persiste entre sesiones y puede conservar en memoria el ancla, las cadenas y la lista de exclusiones. No sustituye una búsqueda revisada por un bibliotecario para una revisión sistemática destinada a una revista, y no debería pretenderse que lo haga.
¿Cómo se deben cribar unos 50 artículos clave sin perder rigor metodológico?
Debe cribar 50 artículos como un registro codificado de decisiones: una fila por estudio, un motivo por decisión y ningún artículo admitido porque el resumen parezca relevante. Cincuenta es un corpus de trabajo para un tema nuevo, no una afirmación de que la literatura se haya buscado exhaustivamente.
Adopte la disciplina del cribado sistemático incluso si todavía no está redactando una revisión PRISMA. PRISMA 2020 es la guía de reporte vigente para revisiones que identifican, seleccionan y sintetizan estudios. La lista de comprobación asociada de 27 elementos existe para hacer transparentes esos métodos. Su registro de 50 artículos no cumplirá una revisión sistemática completa, pero debería poder responder a las mismas preguntas básicas: qué se encontró, qué se conservó y por qué.
Una indicación de cribado práctica:
«Criba los siguientes 50 artículos frente a estos criterios de inclusión y exclusión. Para cada artículo, devuelve: decisión (incluir / excluir / dudoso), el único criterio que determinó la decisión, diseño del estudio, población, contexto, resultado principal y una limitación. Cita la frase que justificó la decisión. No añadas artículos que no estén en esta lista.»
Después, realice usted mismo una pasada de calibración sobre los primeros diez registros. Si el asistente y el investigador discrepan en más de dos o tres, los criterios siguen siendo ambiguos. Ajuste las definiciones de población, diseño y resultado antes de puntuar los cuarenta restantes.
Rayyan es el mejor instrumento cuando el conjunto crece o se une un segundo revisor. Las comparaciones independientes de Covidence y Rayyan han considerado durante mucho tiempo que ambas son plataformas viables de cribado para revisiones sistemáticas con modelos de colaboración diferentes. Elicit es el mejor instrumento cuando el siguiente paso es una tabla de datos: tamaño de muestra, dirección del resultado y campos metodológicos cumplimentados con citas de apoyo.
El límite honesto de Jenova es la ergonomía por lotes. El cribado basado en chat es rápido para 50 artículos cuidadosamente elegidos y torpe para 5.000 registros importados. Úselo para imponer criterios y extraer un libro de códigos coherente. Traslade el mismo libro de códigos a Rayyan o Elicit si el proyecto se convierte en una revisión formal.
Nunca permita que el modelo complete un PDF ausente. Si el texto completo no está disponible, la fila debe permanecer como unsure, no como include. Esa única regla evita la mayor parte del teatro de citas.
¿Cómo se convierten los artículos cribados en un mapa de brechas de evidencia validado?
Se convierte un conjunto cribado en un mapa de brechas codificando cada estudio incluido en dos o más dimensiones, marcando las celdas vacías como preliminares y, solo entonces, comprobando si esas celdas vacías resisten una segunda búsqueda. Una celda vacía que no se ha puesto a prueba es un residuo de codificación, no una justificación de investigación.
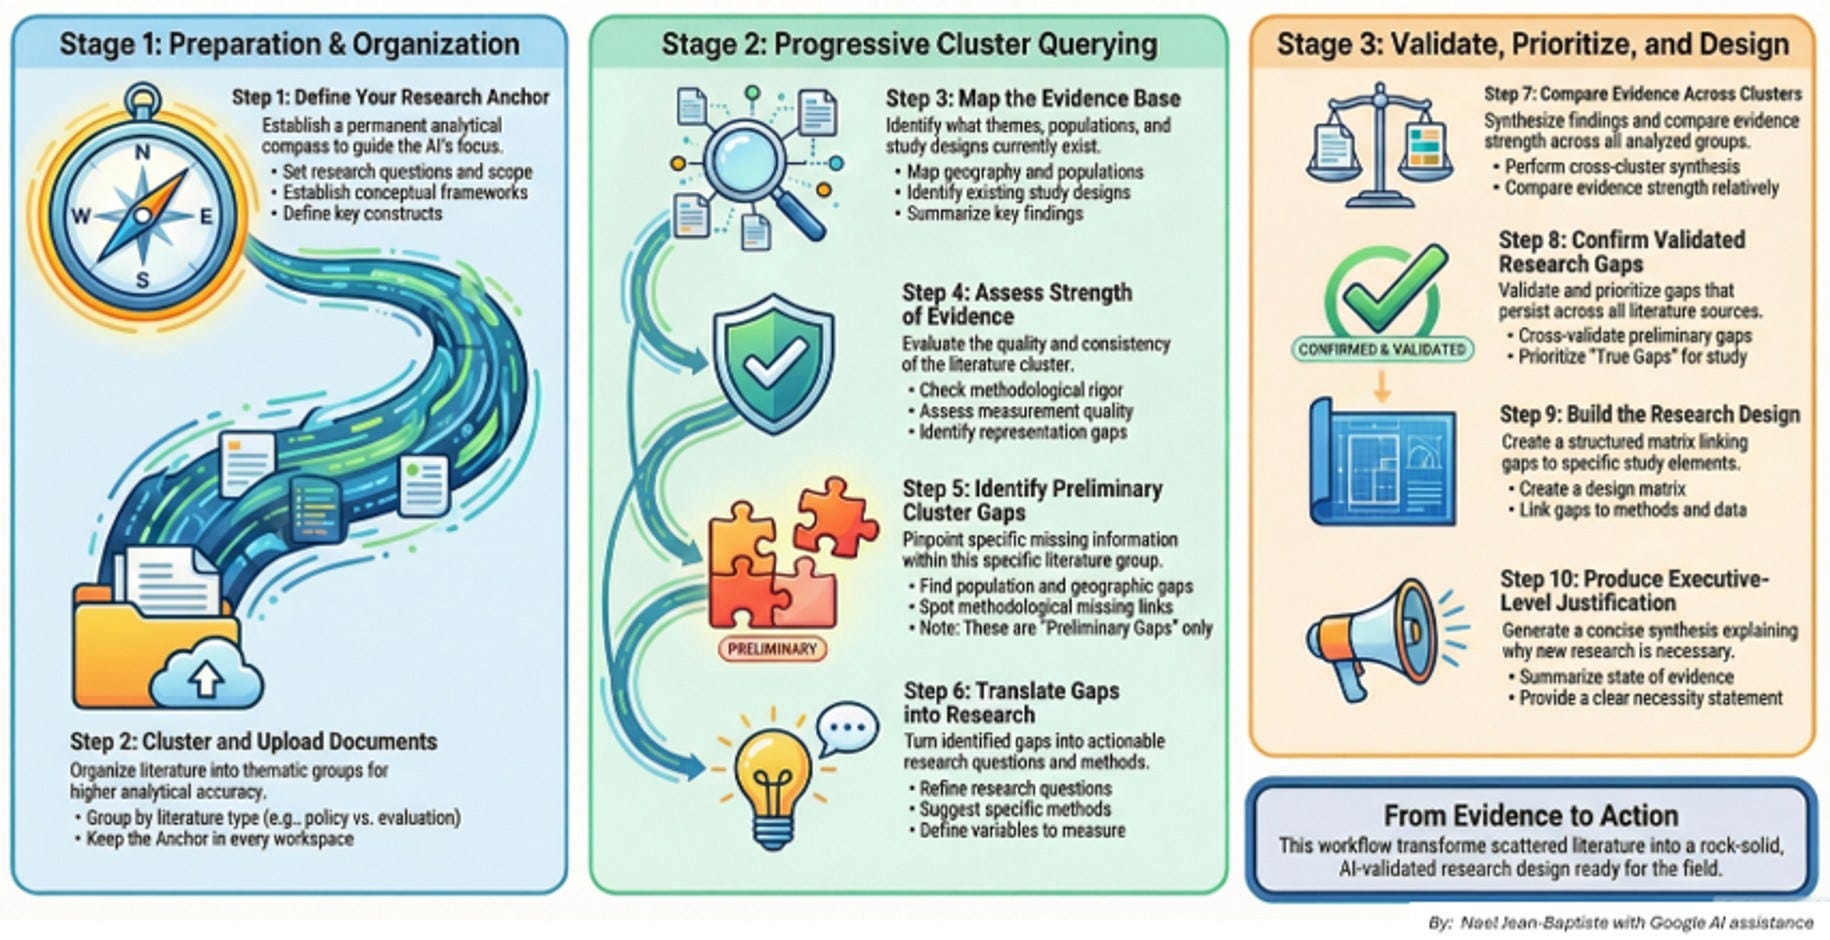
El flujo de trabajo de la figura anterior sigue la secuencia adecuada: prepare un ancla analítica, agrupe los documentos, evalúe la solidez de la evidencia, marque las brechas preliminares y, después, valide esas brechas entre clústeres antes de diseñar un estudio. Esto coincide con la forma en que se supone que deben funcionar los mapas formales. Los mapas interactivos de brechas de evidencia son herramientas visuales estructuradas para mostrar el volumen y las características de la evidencia, no pósteres de hipótesis preferidas.
Un mapa sólido suele necesitar al menos:
- Filas: intervenciones, exposiciones o preguntas de investigación
- Columnas: resultados, poblaciones o diseños de estudio
- Filtros: año, geografía, calidad y estado de publicación
- Contenido de las celdas: número de estudios, más una etiqueta aproximada de solidez, como revisión, ensayo, estudio observacional o protocolo
Pida al asistente que construya la primera matriz únicamente a partir de los artículos incluidos:
«Usando solo los estudios incluidos, construye una matriz de brechas con filas = [intervenciones o preguntas] y columnas = [resultados o poblaciones]. En cada celda, enumera el número de estudios, el diseño dominante y la actualidad. Marca las celdas vacías como Preliminares. Después, propone tres búsquedas de seguimiento que puedan refutar cada celda vacía, incluidos registros de ensayos y literatura gris.»
La validación es el paso que la mayoría de los textos sobre AI omiten. Las comparaciones metodológicas enfatizan que los mapas deben incluir estudios en curso procedentes de registros, aplicar evaluación crítica y actualizarse en aproximadamente tres años. Una celda que parece vacía en su conjunto de 50 artículos puede estar llena en un servidor de preprints o en un registro de protocolos.
Jenova resulta útil en esta fase porque puede conservar el libro de códigos, la matriz y los artículos rechazados en un mismo hilo y redactar después la nota sobre por qué este estudio es necesario únicamente a partir de brechas validadas. Interpretará en exceso las celdas vacías si se lo permite. Exija una búsqueda de refutación para cada brecha que planee financiar o describir por escrito.
Si el tema se convierte después en una revisión exploratoria, cambie el reporte a PRISMA-ScR, que especifica 20 elementos esenciales y 2 elementos opcionales. No adapte retrospectivamente un mapa casual de 50 artículos como si ya fuera una revisión exploratoria.
¿Cómo obtener el máximo valor de un flujo de trabajo de búsqueda, cribado y mapeo asistido por AI?
Obtendrá el máximo valor del flujo de trabajo si proporciona al asistente un protocolo fijado, un corpus delimitado y un presupuesto de verificación, y después rechaza toda afirmación que no pueda abrirse en el PDF original. La velocidad procede de una codificación coherente, no de omitir comprobaciones de texto completo.
Una secuencia operativa concisa:
- Redacte el ancla. Un párrafo que declare la afirmación que necesita respaldo, la población y qué contaría como evidencia que la refuta.
- Redacte y fije la búsqueda. Las bases de datos, cadenas, fechas y reglas de exclusión se incorporan a una nota fechada antes de que empiece el descubrimiento.
- Reúna 50 artículos con un propósito. Combine revisiones, ensayos recientes o estudios primarios y, al menos, algunos artículos de campos adyacentes para que el mapa no sea una ilusión de un único clúster.
- Cribe en una tabla. Incluya, excluya o marque como dudoso, con un criterio decisivo y una frase citada.
- Extraiga y luego evalúe. Los hallazgos, las limitaciones, el diseño y la muestra deben permanecer en campos separados.
- Mapee y después ataque las celdas vacías. Cada brecha preliminar recibe una segunda búsqueda diseñada para descartarla.
- Redacte a partir de la matriz. La frase de novedad del artículo debe nombrar la celda vacía validada, no una impresión vaga.
En Jenova, mantenga toda esa cadena en un proyecto para que el asistente no pueda cambiar silenciosamente los criterios de inclusión entre sesiones. Una indicación de seguimiento que evita desviaciones:
«Vuelve a aplicar los criterios de inclusión originales a este artículo nuevo. Si necesitas cambiar un criterio para incluirlo, detente y muéstrame el cambio propuesto en lugar de puntuar el artículo.»
Para Elicit, empiece por la pregunta de investigación, deje que el sistema sugiera campos de cribado y extracción y, después, modifique esos campos antes de ejecutar el conjunto completo. Para Rayyan, importe la exportación de la base de datos, configure etiquetas que coincidan con su libro de códigos y mantenga el clasificador de relevancia con AI como un orden de clasificación, no como una decisión.
Presupueste explícitamente el tiempo de verificación. Un objetivo viable para un conjunto central de 50 artículos es dedicar entre dos y cuatro minutos de comprobación humana por cada texto completo incluido, centrada en verificar que el hallazgo citado realmente aparece en el artículo y que el diseño se codificó correctamente. Sigue siendo mucho más barato que una extracción sin asistencia y es la única forma de cumplir con la expectativa de PRISMA de que los valores extraídos se verifiquen.
¿Qué dicen los metodólogos de investigación y los creadores de herramientas sobre el mapeo de evidencia asistido por AI?
Los metodólogos de investigación consideran los mapas de evidencia como gráficos de disponibilidad guiados por protocolos, mientras que los creadores de herramientas siguen descubriendo que la cita, y no la prosa, es la parte en la que la AI se equivoca. Ambos grupos convergen en la misma regla operativa: la AI puede estructurar la búsqueda y el cribado, pero el investigador sigue siendo responsable de cada celda del mapa.
«El modo de fallo que vemos con mayor frecuencia es tratar la celda vacía como un descubrimiento. Una celda vacía no es más que una hipótesis sobre evidencia ausente. Se convierte en una brecha validada después de haber comprobado los clústeres adyacentes, la literatura gris y los registros de protocolos, y de confirmar que la ausencia no es un artefacto de búsqueda. Si no se realizaron esas comprobaciones, no se tiene un mapa de brechas. Se tiene una visualización de la primera consulta.»
«En un cribado de 50 artículos, el ahorro de tiempo proviene de la codificación coherente, no de omitir el texto completo. La división útil del trabajo es sencilla: el asistente redacta la decisión de inclusión/exclusión, la fila de extracción y la primera matriz; el investigador dedica unos minutos por artículo incluido a confirmar que la cita existe y que el diseño no se ha mejorado en la reformulación. Eso sigue comprimiendo días de notas desordenadas en un único libro de códigos.»
«No presentaríamos una revisión sistemática para una revista basándonos solo en registros de chat. Las plataformas dedicadas de cribado siguen ganando en revisión dual, resolución de conflictos y diagramas PRISMA. El lugar donde un asistente conversacional de investigación aporta valor es antes: al fijar la pregunta, exponer límites de búsqueda sesgados, mantener visibles los artículos rechazados y convertir una celda vacía validada en una justificación precisa de estudio.»
— Equipo de Producto de Jenova, flujos de trabajo de investigación académica, 8 años desarrollando herramientas de investigación con AI trazables por fuente
Esa cautela coincide con el trabajo independiente. Las revisiones de sistemas generativos para la síntesis de literatura siguen encontrando capacidad real junto con límites de fiabilidad que hacen insegura una revisión no supervisada. La orientación sobre mapas sistemáticos de evidencia también subraya la categorización estructurada de la evidencia científica en lugar de la confianza narrativa. La restricción de mantener al investigador bajo control en el flujo de trabajo de fuentes de cinco pasos no es un eslogan. Es el paso de control de calidad del que depende el resto del método.
Referencias
- Saran y White — Mapas de evidencia y brechas: comparación de distintos enfoques (PMC)
- Khalil et al. — Metodología para revisiones de mapeo, mapas de evidencia y mapas de brechas (Research Synthesis Methods)
- Elicit — Presentación de Elicit Systematic Review
- PRISMA Statement — Guía de reporte PRISMA 2020
- Atlas Workspace — Mejores asistentes de investigación con AI: comparación de 2026 verificada frente a alucinaciones
- Fortune — Las alucinaciones de AI se infiltran en el trabajo científico experto, mayo de 2026
- LibGuide de Grainger de la University of Illinois — Revisiones exploratorias, revisiones de mapeo y mapas de evidencia o brechas
- Page et al. — La declaración PRISMA 2020 (The BMJ)
- University of Kansas Medical Center — PRISMA y estándares relacionados para revisiones
- Elicit — Flujo de trabajo de revisión sistemática diseñado para PRISMA 2020
- Rayyan — Plataforma de revisión sistemática impulsada por AI
- INRA.AI — Comparación entre Covidence, Rayyan y Elicit
- Bibliotecas de la University of Toronto — Revisiones de mapeo en la familia de síntesis de conocimiento
- Kellermeyer, Harnke y Knight — Comparación entre Covidence y Rayyan (PMC)
- EvalCommunity Academy — Mapeador interactivo de brechas de evidencia
- PRISMA — Extensión PRISMA para revisiones exploratorias
- Adel, Alateeq y Alshahrani — ¿Puede la AI generativa sintetizar la literatura de forma fiable? (AI & Society)
- Khalil et al. — Guía para realizar mapas sistemáticos de evidencia (Science of the Total Environment)