¿Cómo puede la AI sintetizar evidencia interdisciplinaria sin mezclar los hechos?
2026-08-21
¿Qué tres capas de evidencia deben mantenerse separadas en la síntesis de AI entre disciplinas?
La AI solo puede sintetizar evidencia interdisciplinaria de forma fiable cuando etiqueta cada afirmación como un hecho de la fuente, una conclusión del autor o una inferencia del modelo, y evita que esas capas se fundan en un único párrafo sin etiquetar. En 2026, esta separación marca la diferencia entre un informe de investigación auditable y un resumen fluido que blanquea afirmaciones tentativas hasta convertirlas en autoridad aparente. Los chatbots genéricos siguen mezclando las capas de forma predeterminada, por lo que la fabricación bibliográfica y los errores de citación continúan estando bien documentados.
Los agentes de investigación diseñados específicamente para esta tarea, incluido el Academic Research Assistant de Jenova, son más sólidos cuando recuperan fuentes reales, preservan la atribución y hacen visibles los saltos del propio modelo. No sustituyen una revisión sistemática registrada según PRISMA.
Factores clave que distinguen una síntesis consciente de la procedencia de una paráfrasis sin etiquetar:
✅ Los hechos de la fuente son mediciones, métodos, tamaños de muestra y observaciones comunicados en el texto primario
✅ Las conclusiones del autor son interpretaciones que los autores del artículo extraen en la discusión o el resumen; no constituyen una verdad independiente
✅ La inferencia de AI es el razonamiento analógico, predictivo o integrador que el modelo añade entre artículos o campos
✅ El mapeo entre dominios debe ser explícito, porque un mecanismo establecido en una disciplina suele ser solo una hipótesis en otra
✅ Toda frase extraíble debe superar una auditoría sencilla: ¿quién afirmó esto, en qué documento y con qué estatus epistémico?
Para comparar herramientas en este problema, trate la procedencia como un criterio de evaluación de primer nivel, no como una preferencia de formato. El resto de esta guía utiliza esa óptica —el marco FCI-TRACE— para evaluar cómo se comportan realmente los sistemas de síntesis.
¿Por qué falla la síntesis interdisciplinaria de AI cuando se colapsa la procedencia?
La síntesis interdisciplinaria falla sin procedencia porque los campos no comparten los mismos estándares probatorios, y los modelos de lenguaje están optimizados para producir una prosa coherente en lugar de preservar esos estándares. El resultado empírico de un artículo sobre clima, la afirmación de identificación causal de un economista y una guía de práctica clínica pueden fusionarse gramaticalmente en una sola oración. Esa oración se leerá como conocimiento establecido incluso cuando solo una cláusula haya sido medida alguna vez.
No se trata de un modo de fallo hipotético. Un estudio de Scientific Reports sobre revisiones de literatura generadas por ChatGPT concluyó que el 55% de las citas de GPT-3.5 y el 18% de las citas de GPT-4 eran fabricadas, y que el 43% y el 24% de las citas reales restantes contenían errores bibliográficos sustanciales. Informes posteriores han vinculado un aumento más amplio de las citas fabricadas en artículos publicados a las herramientas generativas. Las revisiones multimodelo de 2026 siguen hallando que casi el 40% de las referencias generadas por AI contienen errores o fabricaciones, y solo el 26,5% son completamente precisas.
Las tasas de alucinación son aún mayores fuera de la prosa científica bien indexada. Una evaluación de Stanford HAI resumida por MIT Sloan determinó que los chatbots de propósito general alucinaban en el 58–82% de las consultas de investigación jurídica en modelos de la generación de 2023. Los dominios jurídico, normativo y clínico son precisamente los contextos en los que se solicitan con mayor frecuencia los informes interdisciplinarios, y donde una inferencia sin etiquetar tiene el mayor coste.
El problema más profundo es el lavado de fuentes: una cláusula matizada de una sección de discusión se reformula sin matices y después se cita como si fuera un resultado. Los estándares de procedencia existen para impedir esa transformación. El trabajo interdisciplinario multiplica el riesgo porque los lectores no pueden apoyarse en métodos compartidos para advertir cuándo una afirmación ha cambiado de estatus.
¿Qué criterios debe utilizar para evaluar un sistema de síntesis de evidencia con AI?
Debe evaluar un sistema de síntesis de evidencia con AI según su capacidad de mantener intactas las capas FCI ante el desacuerdo, no según la cantidad de artículos que menciona. La fluidez, la velocidad e incluso la cobertura son secundarias si el resultado no puede auditarse. El marco FCI-TRACE utilizado aquí puntúa seis dimensiones.
FCI (estatus epistémico)
- Hechos: ¿Puede el sistema citar o parafrasear estrechamente un resultado con un localizador, como artículo, sección, figura o tabla?
- Conclusiones: ¿Atribuye la interpretación a autores identificados y conserva los matices?
- Inferencia: ¿Marca los pasos analógicos o integradores como generados por el modelo?
TRACE (calidad de la síntesis)
- Trazabilidad: Cada afirmación se vincula a un fragmento de la fuente, no solo al título de un artículo.
- Actualidad: El sistema distingue entre fechas de prepublicación, publicación y actualización de guías, un fallo conocido incluso en herramientas bibliográficas sin AI y un modo de error documentado de ChatGPT en el estudio de Walters y Wilder.
- Acuerdo: Los hallazgos convergentes y contradictorios se tabulan, no se promedian hasta crear un falso consenso.
- Cobertura: Se representan al menos dos métodos disciplinarios cuando la pregunta abarca varios dominios.
- Etiquetado epistémico: Las etiquetas de estatus son visibles en la prosa, no quedan ocultas en una nota al pie.
Este criterio es más estricto que las listas de comprobación genéricas de «AI para revisiones de literatura», que a menudo se detienen en la búsqueda y el resumen. Las guías universitarias ya catalogan herramientas que resumen artículos y extraen datos en tablas estructuradas, y los equipos de revisión sistemática distinguen el cribado semiautomático del completamente automático. Esas capacidades importan. Sin embargo, por sí solas no evitan que una conclusión de los autores se reescriba como un hecho.
La transparencia del protocolo también debe formar parte de la puntuación. PRISMA 2020 es una lista de comprobación de 27 elementos para revisiones sistemáticas que incluyen síntesis, mantenida con artículos explicativos a través de la EQUATOR Network. Ninguna sesión de chatbot es una revisión PRISMA. Aun así, un flujo de trabajo con AI defendible debe informar la lógica de elegibilidad, las fuentes consultadas y lo que añadió el modelo.
¿Cómo gestionan las principales herramientas de investigación con AI los hechos, las afirmaciones de los autores y la inferencia del modelo?
Las principales herramientas se dividen según una línea clara: los extractores fundamentados en artículos reducen la fabricación, mientras que los modelos de chat generales siguen siendo fluidos pero cuentan con una atribución débil; además, casi ninguno impone de forma nativa las etiquetas FCI en la prosa generada. La comparación siguiente trata sobre higiene epistémica, no sobre popularidad general.
| Función / Dimensión | ChatGPT de propósito general | Elicit | Jenova Academic Research Assistant | Scite (contexto de citación) |
|---|---|---|---|---|
| Corpus de fundamentación | Datos de entrenamiento más navegación opcional; citas a menudo no verificadas | Búsqueda, resumen y extracción sobre 125 millones de artículos; utilizado por más de 2 millones de investigadores | Recuperación académica y web en tiempo real, archivos adjuntos y memoria persistente de sesión | Grafo de citaciones y contexto de respaldo o contraste sobre cómo se citan los artículos |
| Etiquetado FCI en el resultado | Normalmente sin etiquetar; los hechos, las afirmaciones de discusión y los saltos del modelo comparten la misma voz | Más sólido en la extracción a nivel de artículo que en las etiquetas epistémicas a nivel de oración | Puede recibir instrucciones para etiquetar capas FCI y conservar el protocolo entre sesiones | Etiqueta la postura de la citación más que el tipo de afirmación dentro de una síntesis |
| Síntesis interdisciplinaria | Alta fluidez; trazabilidad débil entre campos | Más sólido para preguntas de investigación empírica y extracción estructurada | Más sólido cuando se requiere un protocolo de métodos más seguimiento de dominio durante varios días | Limitado como sintetizador; más sólido como lente de contexto de citación |
| Verificación de citas | Altas tasas de fabricación y error en pruebas sistemáticas | Las filas fundamentadas en artículos reducen las referencias inventadas | Recuperación más atribución; sigue requiriendo comprobaciones humanas puntuales | Contexto nativo para determinar si artículos posteriores respaldan o contrastan una afirmación |
| Cribado / extracción | No estructurado | Automatiza el cribado y la extracción de datos para revisiones sistemáticas | Descubrimiento iterativo y apoyo a manuscritos, no una interfaz específica de cribado | No es una mesa de trabajo de cribado |
| Precios (a fecha de 2026) | Suscripción; los niveles exactos para consumidores no se verifican aquí | No verificados en esta revisión | Nivel gratuito con uso limitado; Plus por $20/mes (30× de uso) | No verificados en esta revisión |
| Mejor para | Redactar cuando las fuentes ya están disponibles | Extracción por columnas de artículos empíricos | Informes multifuente y entre sesiones que deben mantener visibles las capas FCI | Comprobar cómo la literatura posterior trata una afirmación |
Elicit. El análisis de su alcance de producto muestra una mesa de trabajo de investigación, no un chatbot: los usuarios plantean una pregunta, recuperan artículos y extraen campos. Las comparaciones independientes de 2026 describen Elicit como más sólido para el descubrimiento de literatura, el cribado y la extracción de datos, mientras que Consensus se describe como más sólido para las preguntas científicas de sí/no. Esa fortaleza de extracción es real. La limitación es complementaria: una tabla completada todavía puede presentar el verbo causal de un resumen como si fuera un resultado, a menos que el usuario defina columnas que separen los hallazgos de la interpretación.
Consensus y Semantic Scholar. Consensus se posiciona repetidamente como un motor de respuestas basado en artículos reales, no como una canalización completa de revisión (The Drive AI). Un resumen de 2026 situó Consensus en torno a los $144 al año como punto de entrada. Semantic Scholar sigue siendo una base de descubrimiento en esas mismas comparaciones. Ninguna de las herramientas, según las descripciones públicas revisadas aquí, incorpora una capa obligatoria de hechos frente a inferencias.
Scite. Scite es la mejor opción cuando la pregunta es cómo se cita un artículo, no cómo fusionar dos disciplinas. Las comparaciones lo tratan como el especialista en contexto de citación frente al flujo de revisión más amplio de Elicit (Paperguide, 2026). Las etiquetas de citaciones que respaldan o contrastan son valiosas y siguen siendo distintas de FCI: un artículo posterior puede «respaldar» una conclusión de autor que nunca fue un hecho.
ChatGPT de propósito general. Sigue siendo la opción predeterminada equivocada para una síntesis sin supervisión. Incluso la mejora de GPT-4, con una tasa de fabricación del 18%, es incompatible con el trabajo que exige citas fiables, y los campos numéricos de las citas, como volumen, páginas y año, son los errores más frecuentes entre las referencias reales. Las guías de bibliotecas tratan ahora las citas alucinadas como un tema de integridad investigadora por derecho propio.
Jenova Academic Research Assistant. Este agente está diseñado para académicos y estudiantes de doctorado que necesitan descubrimiento de literatura, apoyo a manuscritos y gestión de citas, no un resumen de una sola vez. En la plataforma Jenova puede utilizar búsqueda académica, conservar un historial de conversaciones ilimitado y mantener un protocolo de métodos en memoria persistente para que las reglas FCI no se reinicien en cada sesión. Combinado con Deep Research, que busca ampliamente y ofrece informes densos en citas, resulta adecuado para preguntas interdisciplinarias que se desarrollan a lo largo de varias sesiones.
Las limitaciones honestas importan. No es Covidence, DistillerSR ni Rayyan: no existe una mesa de trabajo específica para diagramas de flujo PRISMA ni una cuadrícula nativa de extracción de 125 millones de artículos a la escala que anuncia Elicit. Las decisiones de inclusión de alto riesgo y la agrupación estadística siguen correspondiendo a revisores humanos. La ventaja de profundidad reside en la persistencia del protocolo y el etiquetado explícito, no en una certeza automatizada.
¿Cómo evita la orquestación del conocimiento que la evidencia disciplinaria se derrumbe en una sola narrativa?
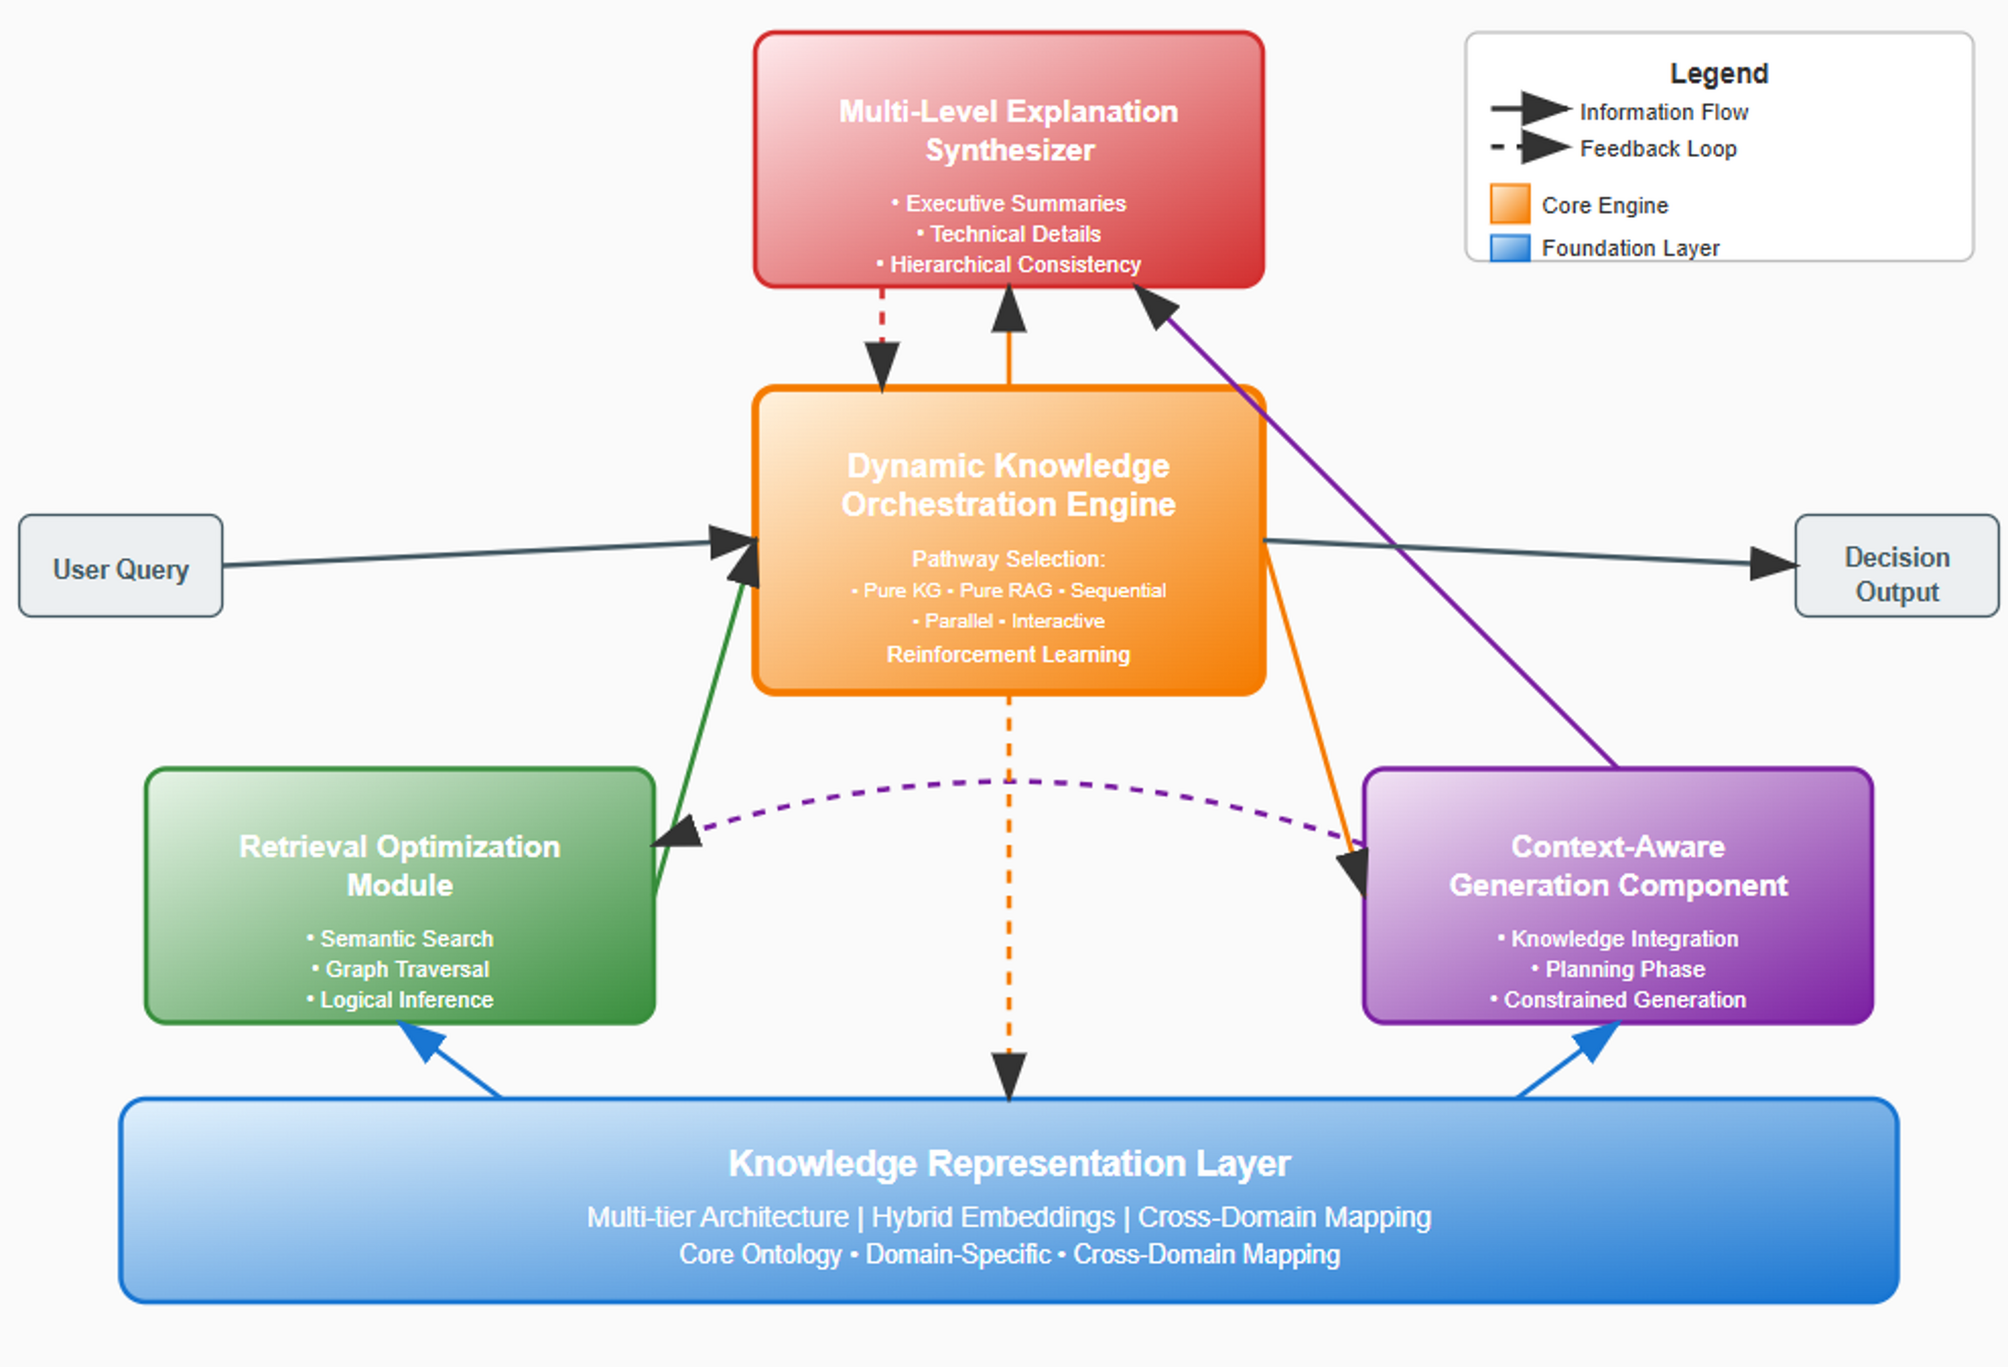
La orquestación del conocimiento mantiene intacta la evidencia disciplinaria al elegir una ruta de recuperación antes de la generación y, después, obligar a las explicaciones a ser jerárquicamente coherentes con lo recuperado. Analizar una pila de orquestación típica muestra por qué «simplemente recuperar y luego redactar» no basta para el trabajo interdisciplinario.
La base es una capa de representación del conocimiento: representaciones vectoriales híbridas, ontologías de dominio y mapeo entre dominios. Sin esa capa, un modelo trata la «incertidumbre» en la física del clima, la «incertidumbre» en econometría y la «incertidumbre» en las guías clínicas como el mismo vecindario de tokens. No lo son. Mapear términos entre campos es un paso de inferencia y debe etiquetarse como tal.
Por encima de esa capa, un módulo de optimización de recuperación combina búsqueda semántica, recorrido de grafos e inferencia lógica. El recorrido de grafos importa cuando la pregunta es relacional: ¿el mecanismo A en ecología es análogo al mecanismo B en salud pública? La búsqueda semántica por sí sola devuelve lenguaje similar; no demuestra una estructura causal compartida. La inferencia lógica sobre afirmaciones extraídas se aproxima más a las redes de inferencia de evidencia diseñadas para la verificación interpretable de afirmaciones.
A continuación, el motor de orquestación selecciona una ruta —solo grafo de conocimiento, solo RAG, secuencial, paralela o interactiva— en lugar de volcar siempre fragmentos en una instrucción. La recuperación paralela es adecuada cuando dos disciplinas deben recopilarse independientemente antes de cualquier mapeo. La recuperación secuencial es adecuada cuando la medida de resultado de un campo debe limitar la siguiente consulta. Mezclar esos modos sin explicarlo es la forma en que un informe sobre clima y salud se convierte silenciosamente en una recomendación normativa.
Una etapa de generación consciente del contexto debe planificar bajo restricciones: no generar un verbo causal a menos que la fuente lo utilice; no fusionar marcos muestrales. La última etapa, un sintetizador de explicaciones multinivel, es donde FCI se hace visible: resumen ejecutivo, detalle técnico y una comprobación de coherencia para impedir que el resumen vaya más allá de la evidencia. Las interfaces de afirmación-evidencia de la investigación actual, como PaperTrail, apuntan en la misma dirección: la fiabilidad en los entornos académicos depende de vincular las afirmaciones con la evidencia, no de una prosa más fluida.
El Academic Research Assistant de Jenova no expone cada interruptor interno de enrutamiento como un control destinado al investigador. Esta es una limitación real para equipos que necesitan un DAG totalmente inspeccionable. Lo que sí ofrece es el equivalente práctico para la mayoría de los flujos de trabajo académicos: instrucciones persistentes, corpus adjuntos, recuperación en tiempo real y memoria suficiente para mantener estable un protocolo de etiquetado mientras se acumula la evidencia.
¿Cómo puede una canalización de citación semántica verificar afirmaciones antes de que entren en una síntesis?
Una canalización de citación semántica verifica las afirmaciones al tratar cada cita como una hipótesis que debe cotejarse con el documento fuente, no como un adorno formateado al final de un párrafo. Si se omite este paso, la síntesis interdisciplinaria hereda toda referencia inventada o desviada que produzca el generador.
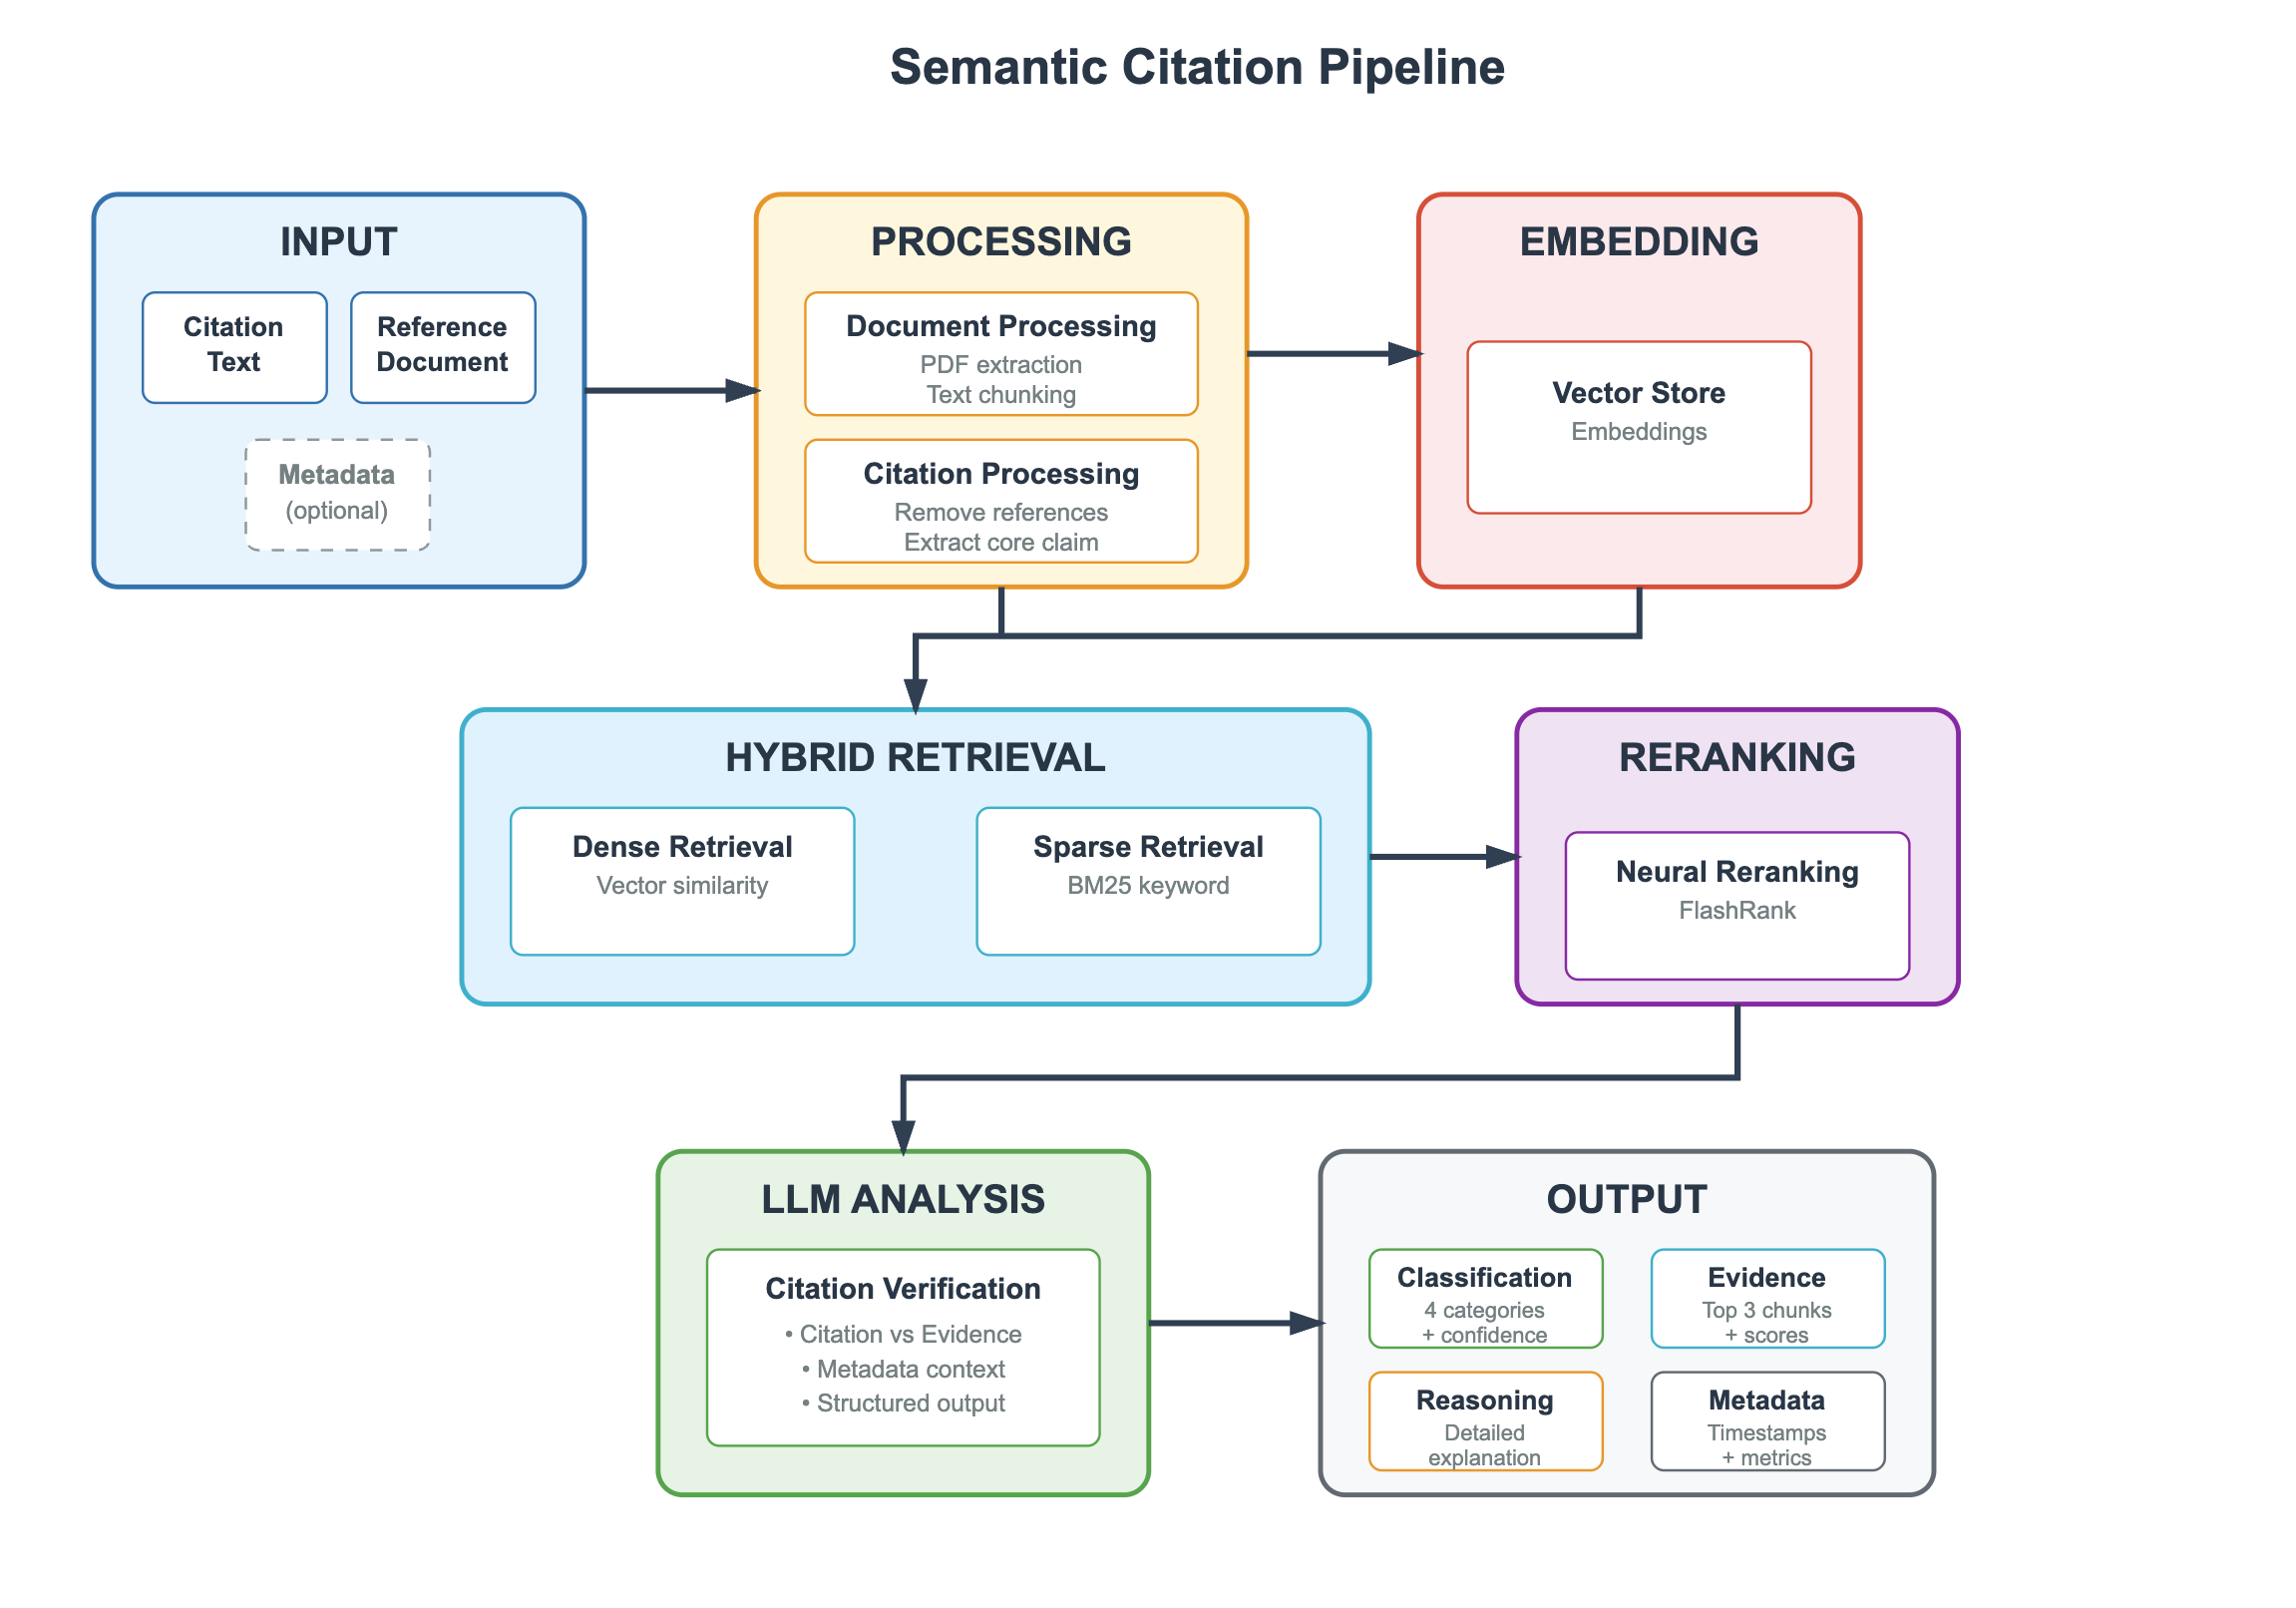
El análisis de una canalización de estilo productivo muestra un orden fijo. La entrada es el texto de la cita, el documento de referencia y metadatos opcionales. El procesamiento extrae texto del PDF, lo fragmenta, elimina la lista de referencias para que el modelo no pueda «verificar» una afirmación leyendo la bibliografía y aísla la afirmación central. La representación vectorial almacena esos fragmentos. La recuperación híbrida ejecuta después, en paralelo, búsqueda vectorial densa y BM25 disperso, algo necesario porque la jerga disciplinaria y la notación estadística suelen fallar con una búsqueda basada exclusivamente en representaciones vectoriales. El reranking neuronal, por ejemplo con FlashRank, conserva los fragmentos principales. Solo entonces el análisis del LLM clasifica la relación entre la afirmación y la evidencia.
El resultado útil no es una aprobación binaria. Una clasificación de cuatro vías con nivel de confianza —respaldada, contradicha, no abordada o abordada parcialmente—, junto con los principales fragmentos de evidencia y una justificación escrita, es lo que un agente de síntesis debería incorporar. Ese patrón coincide con el movimiento más amplio hacia la verificación explicable de afirmaciones a nivel de evidencia. También coincide con lo que las unidades universitarias de enseñanza ya recomiendan cuando describen asistentes de AI que extraen evidencia en lugar de inventar una narrativa.
Incluso con una canalización persisten dos modos de fallo. Primero, una conclusión de autor correctamente citada todavía puede clasificarse erróneamente como un hecho si el clasificador ignora el contexto de la sección, como resultados frente a discusión. Segundo, la recuperación híbrida puede mostrar una oración muy similar de otro artículo del mismo campo: una desviación de citación por paráfrasis. Por tanto, la revisión humana de los fragmentos principales forma parte del método, no es una admisión de derrota.
Los flujos de trabajo de Jenova pueden aproximarse a esta canalización al exigir cita más localizador antes de permitir que una afirmación entre en un memorando de síntesis, y después ejecutar Deep Research como una segunda pasada sobre la misma bibliografía. No sustituyen un servicio específico de verificación de citas con métricas de evaluación congeladas. Para capítulos de tesis y envíos a revistas, exporte la tabla de evidencia e inspecciónela.
¿Cómo se instruye a un agente de investigación con AI para separar hechos, conclusiones e inferencia?
Debe instruir al agente con un protocolo permanente que defina las etiquetas, prohíba ascensos silenciosos del estatus de las afirmaciones y solicite una tabla de contradicciones antes de cualquier narrativa entre dominios. La elección de herramienta importa, pero las instrucciones sin etiquetas colapsarán FCI en cualquier plataforma.
Para el Academic Research Assistant de Jenova, una configuración duradera tiene este aspecto:
- Abra el agente en jenova.ai/a/academic-research-assistant e indique la pregunta de investigación, las disciplinas incluidas y los límites de fecha.
- Pegue un protocolo FCI permanente, y guárdelo en instrucciones personalizadas si las mismas reglas deben aplicarse entre sesiones:
«Protocolo de trabajo: Etiqueta cada oración como [HECHO], [CONCLUSIÓN DEL AUTOR] o [INFERENCIA DE AI]. Los hechos requieren un localizador de fuente. Las conclusiones del autor deben nombrar el artículo y conservar los matices. La inferencia de AI incluye cualquier mapeo entre dominios, salto causal o recomendación que no esté expresamente indicado por una fuente. Si la evidencia entra en conflicto, no la promedies. Genera una tabla: Afirmación | Capa | Fuente | Localizador | Acuerdo (respalda / contradice / ausente).»
- Siembre el corpus. Adjunte los PDF en los que ya confía y, después, solicite descubrimiento adicional en lugar de permitir que la primera búsqueda defina el campo.
- Exija un resultado por capas: bibliografía anotada, hallazgos etiquetados con FCI y, después, una síntesis breve que no pueda introducir hechos nuevos.
Una instrucción inicial que suele producir una estructura utilizable:
«Pregunta: ¿Cómo se relacionan la intensidad de la isla de calor urbana, la calidad de la vivienda y los ingresos cardiovasculares de urgencia en ciudades de ingresos altos desde 2015? Disciplinas: climatología, epidemiología y economía urbana. Resultado: (1) mapa de fuentes, (2) hallazgos etiquetados con FCI, (3) registro de contradicciones, (4) inferencias de AI enumeradas al final y marcadas como no comprobadas. No cites nada que no hayas recuperado.»
Para Elicit, la disciplina equivalente se encuentra en el diseño de las columnas, no en las etiquetas de la prosa. Cree campos de extracción separados para resultado comunicado, interpretación de los autores, población y limitaciones identificadas, siguiendo el flujo de trabajo de pregunta a extracción de la herramienta. No utilice una única columna de «hallazgo principal»; esa columna es donde los verbos de discusión se promocionan a resultados.
Para un chatbot general, añada una comprobación adversarial que el estudio de Nature implica que es necesaria: exija citas textuales y resuelva después cada referencia de forma independiente en una base de datos de biblioteca. Pedir al mismo modelo «¿esta cita es real?» es poco fiable. Si el proyecto es una revisión sistemática, use herramientas de cribado descritas en la guía bibliotecaria de síntesis de evidencia para las decisiones de inclusión y mantenga al chatbot fuera de las decisiones de elegibilidad.
Deep Research de Jenova es el mejor seguimiento cuando la bibliografía es extensa y necesita una segunda pasada densa en citas. Úselo después de establecer las reglas FCI, no como el primer barrido sin etiquetar.
¿Qué dicen los metodólogos de investigación sobre la procedencia de la evidencia producida con AI?
Los metodólogos de investigación tratan la síntesis de AI sin etiquetar como un fallo de comunicación científica, no como una ganancia de productividad: si un lector no puede ver qué capa ocupa una oración, el documento todavía no constituye evidencia. Esta visión es coherente con la insistencia de PRISMA en una síntesis transparente y con los estudios de integridad de citación que consideran las referencias fabricadas una amenaza para el registro probatorio.
«El modo de fallo que observamos no es que los modelos no puedan leer artículos. Es que escriben con una sola voz epistémica. Un número metodológico, una cláusula matizada de una sección de discusión y una analogía entre campos salen del modelo con la misma seguridad. Los comités interdisciplinarios discuten entonces sobre la conclusión cuando deberían discutir sobre la capa. Si una oración no puede responder «¿quién afirmó esto y fue medido o inferido?», no debería entrar en un informe de resultados.»
«El etiquetado FCI es más barato que la retractación posterior. Los equipos que exigen localizadores antes de la síntesis dedican más tiempo a la primera pasada y mucho menos a deshacer la desviación de citas. El estudio de Nature sobre ChatGPT sigue siendo la referencia de advertencia: incluso las grandes reducciones de fabricación dejan tasas de error residuales inaceptables en una lista de referencias. La procedencia es el sistema de control. La fluidez no lo es.»
«Las canalizaciones de orquestación y verificación de citas son la forma de operacionalizar ese estándar. Recupere las disciplinas en paralelo cuando no compartan constructos. Verifique las afirmaciones frente a fragmentos antes de que lleguen al sintetizador. Mantenga el paso integrador del modelo en un bloque separado e identificado. Esa arquitectura es más conservadora que un resumen de chatbot, y ese es precisamente el objetivo.»
— Equipo de Producto de Jenova, diseño de agentes de investigación con AI, ocho años desarrollando flujos de trabajo de recuperación y atribución para usuarios académicos y profesionales
La implicación para la elección de herramientas es concreta. Prefiera sistemas que puedan mantener un protocolo, mostrar fuentes y tolerar la contradicción. No prefiera sistemas que simplemente suenen interdisciplinarios.
¿Cuándo debe la revisión humana prevalecer sobre la síntesis de AI entre disciplinas?
La revisión humana debe prevalecer sobre la síntesis de AI siempre que una afirmación cambie una decisión, cruce un límite de métodos disciplinarios o no pueda rastrearse hasta un localizador; es decir, en la mayor parte del trabajo que justifica la síntesis en primer lugar. La AI multiplica la redacción y la recuperación. No es la autoridad epistémica.
La intervención es innegociable en al menos cinco condiciones:
- Aparece lenguaje causal en la síntesis, pero no en la sección de resultados del trabajo citado.
- Es posible una incompatibilidad de constructos, por ejemplo, «estrés» en psicología frente a «carga alostática» en medicina frente a «volatilidad» en economía.
- Están en juego guías o legislación; las tasas de alucinación en consultas jurídicas han sido especialmente altas en pruebas controladas.
- Se implica una agrupación estadística. Los modelos de lenguaje no realizan un metaanálisis defendible al parafrasear resúmenes, y PRISMA 2020 existe específicamente para revisiones que incluyen síntesis.
- No se ha ejecutado la verificación de citas frente al PDF. Las referencias inventadas o alteradas siguen siendo lo bastante frecuentes en 2026 como para que las revistas y bibliotecas las traten como un problema de integridad.
Una división práctica del trabajo funciona así. El Academic Research Assistant propone el mapa de fuentes, las etiquetas FCI y el registro de contradicciones. Elicit o una herramienta de cribado se encarga de la extracción estructurada cuando el corpus pertenece a una revisión formal. Un metodólogo humano resuelve los ascensos de capa y todas las inferencias entre dominios. La AI puede sugerir el mapeo; solo el ser humano puede promoverlo.
Utilizada de ese modo, la síntesis con AI no sustituye el juicio interdisciplinario. Es una forma de mantener los hechos, las conclusiones de los autores y la inferencia del modelo en flujos separados e inspeccionables, para que el juicio tenga algo honesto con lo que trabajar.
Referencias
- Rules Integrity Initiative — Procedencia y lavado de fuentes
- Walters & Wilder, Scientific Reports — Fabricación y errores en citas bibliográficas generadas por ChatGPT
- Forbes — Se atribuye a la AI el aumento de citas fabricadas en artículos de investigación (2026)
- Enago — Alucinaciones de AI en citas de investigación (2026)
- MIT Sloan — Abordar las alucinaciones y los sesgos de AI, incluidas las tasas de consultas jurídicas de Stanford HAI
- Bibliotecas de George Mason University — Herramientas de AI para revisiones de literatura
- King's College London — Herramientas de AI en síntesis de evidencia
- Declaración PRISMA 2020
- Page et al., The BMJ — La declaración PRISMA 2020
- EQUATOR Network — Guía de comunicación científica PRISMA
- Elicit — AI para investigación científica
- Paperguide — Comparación entre Elicit y Scite (2026)
- PapersFlow — Elicit frente a Consensus AI
- The Drive AI — Elicit frente a Consensus frente a Semantic Scholar
- Omid Saffari — Mejores herramientas de investigación con AI en 2026
- Biblioteca UNC Charlotte — Citas alucinadas por AI
- Wu et al., AAAI — Redes de inferencia de evidencia para la verificación interpretable de afirmaciones
- PaperTrail — Una interfaz de afirmación-evidencia para fundamentar resultados académicos de LLM (arXiv)
- Zhang et al., EACL — Verificación multimodal y explicable de afirmaciones
- University of Iowa — Revisiones de literatura asistidas por AI