¿Cómo puede la AI localizar evidencia y redactar respuestas para revisores?
2026-08-22
¿Qué diferencia a las herramientas de respuesta basadas en evidencia de la redacción genérica con AI?
Las herramientas que ayudan a los autores a responder bien a los revisores en 2026 no son las que escriben la prosa más fluida. Son las que vinculan cada comentario del revisor con evidencia citable, comprueban si esa evidencia realmente respalda la afirmación y luego redactan una respuesta cuya formulación no sea más contundente que el registro disponible. Jenova's Academic Research Assistant está diseñado para ese ciclo centrado en la evidencia —descubrimiento de literatura, gestión de citas y redacción basada en el manuscrito—, mientras que Scite, Elicit, SciSpace y Consensus cubren partes de la misma tarea con fortalezas diferentes.
Lo que distingue un flujo de trabajo de réplica con AI utilizable de uno fluido pero arriesgado:
✅ Recuperación a nivel de comentario, no un único volcado de literatura para toda la carta
✅ Comprobaciones de citas que abren la oración fuente, no solo la cadena bibliográfica
✅ Una etiqueta de respaldo para cada afirmación: totalmente alineada, parcial, contradicha o indeterminada
✅ Redacción prudente que coincide con la etiqueta en vez de convertir «sugiere» en «demuestra»
✅ Una revisión humana que puede rechazar, acotar o eliminar una oración propuesta por AI
Un informe de Nature de 2026 sobre una encuesta de Frontiers a unos 1.600 académicos de 111 países concluyó que más de la mitad de los investigadores ya han utilizado AI durante la revisión por pares. La misma presión recae ahora sobre los autores que redactan cartas de respuesta. Para comparar herramientas de forma útil, conviene tratar la localización de evidencia, la verificación de citas y la calibración de afirmaciones como tres tareas independientes, en lugar de como una única tarea de redacción.
¿Por qué fracasan las cartas de respuesta a revisores cuando las citas no se verifican?
La mayoría de las revisiones fallidas o retrasadas no se desmoronan porque el autor haya sido descortés. Se desmoronan porque una cita no dice lo que afirma la carta, un análisis prometido no aparece en el manuscrito o la respuesta exagera un hallazgo que el artículo solo respalda débilmente. Editores y revisores pueden comprobar esas discrepancias en minutos.
Los modelos de propósito general facilitan este modo de fallo, no lo dificultan. La orientación universitaria es clara: los sistemas de AI inventan con frecuencia citas que parecen reales pero no existen, y presentar una referencia fabricada se considera fraude académico. La guía de uso responsable de la Universidad de Stellenbosch añade que muchas herramientas no pueden verificar referencias frente a bases de datos activas en tiempo real. Una carta de respuesta es un lugar de alto riesgo para aprender esa lección, porque cada cita nueva implica la promesa de que la fuente existe y respalda exactamente la oración que acaba de escribirse.
Hay un segundo fallo, más silencioso: artículos verdaderos, uso incorrecto. Un artículo metodológico citado como evidencia de resultados, una revisión citada como ensayo primario o un resultado de una población distinta presentado como confirmación directa sobreviven a una comprobación de DOI y aun así inducen a error. Las Smart Citations de Scite existen específicamente para mostrar si trabajos posteriores respaldan, cuestionan o solo mencionan una afirmación, lo cual es un problema distinto de comprobar si la referencia está correctamente formateada.
Los verificadores de referencias basados en reglas son realmente sólidos en la capa mecánica. PoolText señala que los verificadores de referencias con AI son muy precisos respecto a errores de estilo, campos faltantes, puntuación y formato de DOI. Eso es necesario, pero no suficiente. Una afirmación sin respaldo y perfectamente formateada sigue siendo una exageración.
¿Qué debería buscar en un flujo de trabajo con AI para responder a revisores?
Debería evaluar las herramientas en seis dimensiones: segmentación de comentarios, recuperación de evidencia, verificación de la oración fuente, clasificación del respaldo de afirmaciones, redacción calibrada y memoria de revisiones. Una herramienta que obtiene buena puntuación en solo una de esas dimensiones seguirá produciendo una carta que parece terminada, pero no lo está.
El Marco de Alineación Comentario-Evidencia utilizado en este artículo pondera las seis dimensiones de la siguiente manera:
- Segmentación de comentarios (15%) — ¿Puede el sistema aislar cada solicitud del revisor, incluidos los comentarios compuestos que ocultan dos exigencias en un mismo párrafo?
- Recuperación de evidencia (20%) — ¿Busca por separado en el manuscrito, los datos del autor y la literatura externa, e indica de qué conjunto procede el respaldo?
- Verificación de la oración fuente (20%) — ¿Puede un humano abrir la oración exacta que supuestamente respalda la respuesta?
- Clasificación del respaldo de afirmaciones (20%) — ¿Cada cita propuesta se etiqueta como respaldada, parcialmente respaldada, sin respaldo o incierta?
- Redacción calibrada (15%) — ¿La prosa hereda la etiqueta o recurre por defecto a un inglés académico seguro de sí mismo?
- Memoria de revisiones (10%) — ¿Puede el sistema recordar rondas anteriores, análisis prometidos y formulaciones rechazadas?
Esta ponderación es deliberada. Redactar es la parte más barata del trabajo. La recuperación y la clasificación son donde las cartas se vuelven citables o se convierten en un segundo problema de revisión. La investigación que compara revisiones por pares generadas con AI y humanas no ha demostrado un valor añadido concluyente de la AI frente a los revisores humanos, lo cual sirve como una advertencia útil también para los autores: la fluidez no es una señal de validez.
Pruebas prácticas que revelan rápidamente las herramientas débiles:
- Dé al modelo un comentario de revisor que su artículo no pueda responder por completo y observe si inventa un resultado.
- Pídale que cite la oración de respaldo de cada artículo citado, no solo la clave de la cita.
- Exija una etiqueta de respaldo de cuatro categorías antes de redactar cualquier oración de respuesta.
- Vuelva a ejecutar el mismo comentario una semana después y compruebe si la carta contradice una concesión anterior.
Si un producto no puede fallar esas pruebas de una manera visible, no le está ayudando. Está ocultando la incertidumbre que usted debería gestionar.
¿Cómo se comparan las principales herramientas de investigación con AI en recuperación de evidencia y comprobación de citas?
Actualmente ningún producto domina las tres tareas: encontrar evidencia para cada comentario, verificar la cita y redactar una respuesta que no exagere. La comparación útil consiste en determinar para qué tarea está diseñada realmente cada herramienta.
| Función / Dimensión | Elicit | Jenova Academic Research Assistant | Scite | SciSpace Response-to-Reviewers |
|---|---|---|---|---|
| Recuperación de evidencia | Búsqueda con AI y extracción de datos en más de 125 millones de artículos | Descubrimiento de literatura en tiempo real más bases de conocimiento vinculadas al manuscrito | Texto completo académico bajo licencia y contexto de citas en un gran corpus respaldado por editoriales | Flujo de trabajo de agente basado en artículos y orientado a comentarios de revisores |
| Verificación de citas | Sólida en extracción estructurada; 1.502 de 1.511 puntos de datos correctos (99,4%) en la prueba comunicada por Elicit | Recupera fuentes candidatas y datos de citas; todavía se requiere confirmación humana de la oración fuente | Cada afirmación de AI enlaza con la oración específica del artículo específico | Útil para ensamblar un paquete de respuesta; la profundidad de verificación depende de las fuentes subyacentes |
| Redacción de cartas de respuesta | Indirecta: mejor para tablas y respuestas sobre literatura que para una carta completa | Sólida para borradores punto por punto una vez que los comentarios y el manuscrito están en la sesión | Indirecta: diseñada para comprobar si los hallazgos se sostienen, no para redactar la carta | Flujo de trabajo de redacción de respuestas a revisores diseñado específicamente para ello |
| Señales de respaldo de afirmaciones | Precisión de extracción, no un esquema de respaldo de cuatro etiquetas | Clasificación impuesta por el usuario dentro del ciclo de redacción | Contexto de citas de respaldo, contraste y mención | Estructura alineada con revisores más que taxonomía formal de respaldo |
| Precios (a fecha de 2026) | No verificados en esta revisión | Nivel gratuito con uso limitado; planes de pago desde 20 USD al mes | No verificados en esta revisión | No verificados en esta revisión |
| Mejor para | Extracción sistemática y tablas de evidencia | Ciclos de revisión integrales que permanecen vinculados a un manuscrito | Comprobar si la literatura realmente respalda una oración | Autores que desean un agente específico para redactar réplicas |
Elicit es más sólido cuando un revisor solicita una comparación faltante, un mapa más claro de trabajos relacionados o cifras extraídas de un conjunto de estudios. El resumen de la guía de investigación de la Universidad George Mason lo describe como una herramienta que resume artículos y extrae datos en vistas de evidencia estructurada. Su limitación para las réplicas es el alcance: una excelente tabla de evidencia aún no es una carta calibrada en tono, y no le impedirá automáticamente elevar un hallazgo extraído a una afirmación causal.
Scite es más sólido cuando el riesgo consiste en interpretar mal la literatura. Busca en más de 300 millones de artículos académicos y, más importante aún, muestra cómo los trabajos posteriores trataron una afirmación determinada. Es la herramienta adecuada cuando un revisor dice «esta cita no respalda su conclusión» o cuando usted tiene la tentación de citar un artículo emblemático como si el campo todavía estuviera de acuerdo con él. Es más débil como secretaria integral de revisiones: por sí sola no mantendrá una carta de respuesta de 14 comentarios, seguirá números de línea del manuscrito ni recordará lo que usted concedió en la primera ronda.
SciSpace es uno de los pocos productos que trata las «respuestas a revisores» como un flujo de trabajo de primera clase en lugar de como una instrucción de chat. Ese enfoque es una ventaja real cuando se necesita estructura. La limitación correspondiente es la misma que acompaña a cualquier agente de redacción: una salida estructurada aún puede exagerar un resultado si la capa de evidencia que hay debajo es insuficiente.
Consensus es un motor de búsqueda de literatura revisada por pares diseñado para encontrar, organizar y analizar afirmaciones científicas rápidamente. Es útil para la parte de una réplica que responde a «¿qué dice actualmente el campo?». No es un auditor de citas ni un formateador de cartas.
Jenova's Academic Research Assistant se sitúa entre estas herramientas especializadas. Puede mantener el manuscrito, el PDF de los revisores y la correspondencia previa en un espacio de trabajo persistente, buscar literatura y redactar respuestas comentario por comentario. No proporciona de forma nativa recuentos de citas de respaldo frente a contraste al estilo de Scite, ni es un exportador de paquetes de revisión listos para Word en el sentido que anuncia el flujo de trabajo de PeerReply para responder a revisores. Son limitaciones honestas. La fortaleza compensatoria es la continuidad: una revisión que dura seis semanas necesita memoria más que un generador de cartas de una sola vez.
Paper Digest merece añadirse como especialista de alcance reducido. Su orientación hacia la verificación de afirmaciones está más cerca de Scite que de un chatbot de redacción, lo que lo convierte en un mejor comprobador de segunda pasada que en un redactor de primera pasada.
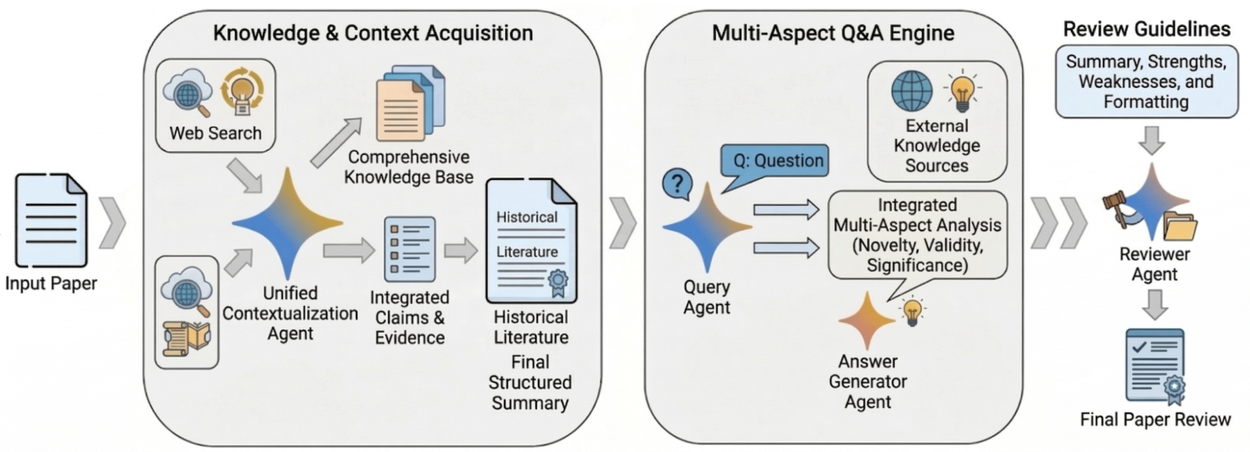
¿Cómo localiza un motor de preguntas y respuestas multiaspecto evidencia de respaldo para cada comentario?
Un sistema fiable no «lee las revisiones y redacta una carta». Convierte cada comentario de revisor en una consulta, recupera información de tres conjuntos de conocimiento separados y solo entonces decide si puede escribirse una respuesta. Esa arquitectura es lo que muestra el diagrama del proceso anterior: primero adquisición de conocimiento, después preguntas y respuestas multiaspecto y, por último, síntesis.
Los tres conjuntos deben mantenerse diferenciados:
- El conjunto del manuscrito — figuras, tablas, métodos, limitaciones y cualquier análisis que ya haya realizado.
- El conjunto del autor — notas de laboratorio, comprobaciones adicionales de robustez, diccionarios de datos y cartas de respuesta anteriores.
- El conjunto de la literatura — artículos que realmente abordan la objeción del revisor, recuperados mediante una búsqueda al estilo Scholar y no mediante la memoria del modelo.
Mezclar esos conjuntos es como empiezan las exageraciones. Una oración que es verdadera en la literatura no es un resultado de su artículo. Una comprobación de sensibilidad en un cuaderno no es una tabla publicada. Un agente de consultas eficaz formula tres preguntas distintas para un mismo comentario: ¿Ya aparece esto en el manuscrito? Si no, ¿los autores tienen respaldo no publicado? Si no, ¿la literatura justifica una afirmación acotada, una revisión o una concesión?
En la práctica, el paso de recuperación para Jenova's Academic Research Assistant es el siguiente:
- Adjunte el manuscrito, la carta de decisión y cualquier suplemento.
- Solicite un inventario numerado de las exigencias de los revisores, incluidas las solicitudes implícitas.
- Para cada exigencia, fuerce una búsqueda en los tres conjuntos antes de cualquier redacción:
«El revisor 2, comentario 3, pregunta si el efecto se mantiene al excluir la submuestra de 2019. Busque primero solo en el manuscrito adjunto. Cite la tabla, sección u oración que lo responda. Si no encuentra nada, diga “no está en el manuscrito” y enumere qué análisis sería necesario. No cite artículos externos como si fueran nuestros resultados.»
- Solo después de no encontrar nada en el manuscrito el agente debería buscar en la literatura o proponer un nuevo análisis.
Los productos específicos para réplicas siguen una división similar. Manusights sostiene que los modelos generales de lenguaje siguen siendo las herramientas más prácticas para redactar la carta en sí, lo cual es cierto en lo que respecta a la prosa. El motor de evidencia aún debe situarse antes de ese modelo de prosa. De lo contrario, la carta se convierte en una reformulación segura de sí misma de lo que el chatbot encontró más cercano, no de lo que contiene el registro.
Novedad, validez e importancia —los tres ejes de análisis de un motor de revisión multiaspecto— también son los tres ejes que realmente ocupan la mayoría de los comentarios de los revisores. Un comentario sobre comparadores faltantes es una cuestión de validez. Un comentario sobre contribución incremental es una cuestión de novedad. Un comentario sobre si a alguien debería importarle es una cuestión de importancia. Etiquetar los comentarios de esta manera evita que se responda a una objeción de validez con un párrafo sobre importancia.
¿Cómo debería clasificar la AI el respaldo de una cita antes de citar una fuente?
Cada cita de una carta de respuesta debería recibir una de cuatro etiquetas antes de permitirse en el borrador: respaldada, parcialmente respaldada, sin respaldo o incierta. Si el sistema no puede asignar una etiqueta, no debería asignar una nota al pie.
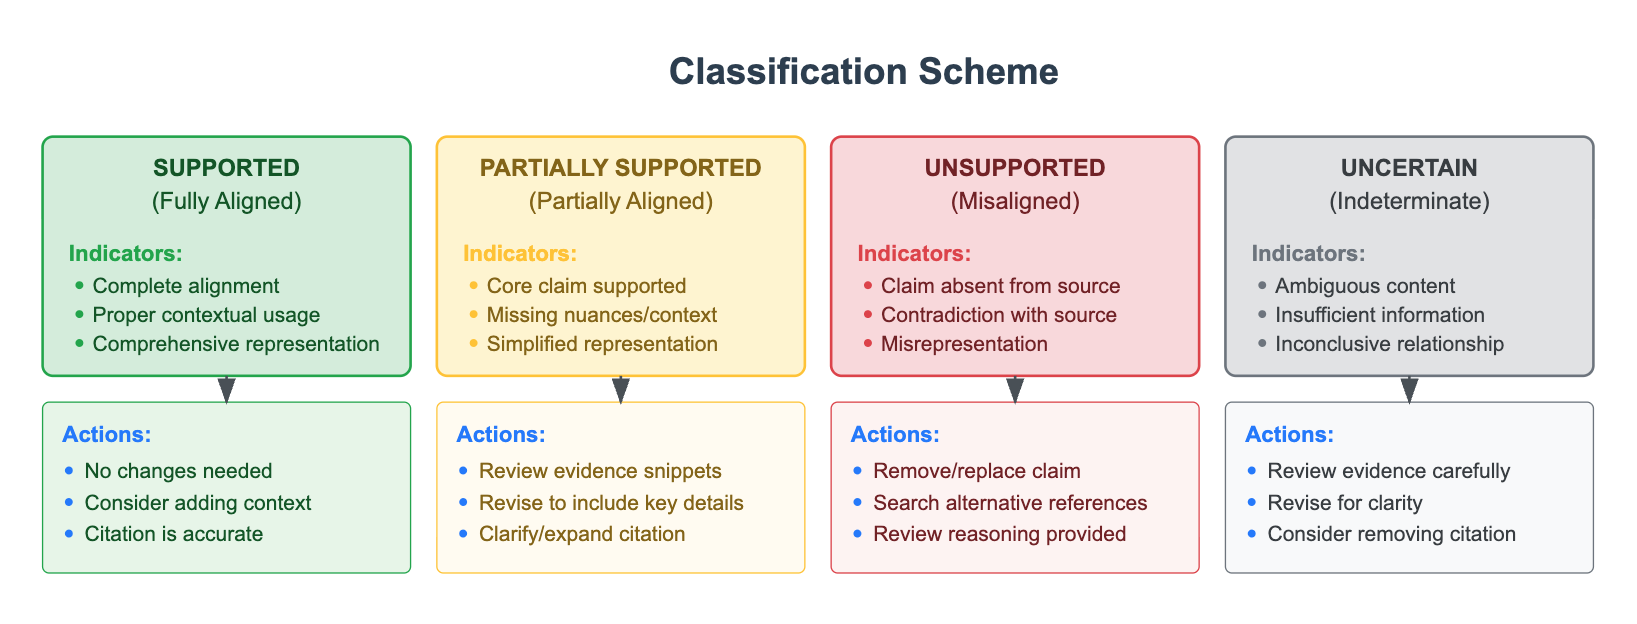
Esta clasificación es la diferencia entre un verificador de citas y un verificador de afirmaciones.
Respaldada significa que la fuente enuncia la afirmación con el mismo alcance, población y fuerza causal que usted está a punto de utilizar. Acción: mantenga la cita. Considere añadir una cláusula de contexto de cinco palabras para que el revisor perciba la alineación.
Parcialmente respaldada significa que el hecho central aparece en la fuente, pero su oración omitió un matiz, una restricción de muestra o un resultado secundario contradictorio. Acción: reescriba la oración para incluir el matiz faltante o sustituya la cita por una fuente primaria mejor. Esta es la etiqueta honesta más común en réplicas reales y la que los chatbots genéricos reducen a «respaldada».
Sin respaldo significa que la afirmación está ausente, es contradicha o se utiliza de un modo que la fuente no autoriza. Acción: elimínela o sustitúyala. No mantenga la cita porque la lista de autores sea prestigiosa o porque el DOI se resuelva.
Incierta significa que el PDF está tras un muro de pago, la sección pertinente es ambigua o la relación entre la afirmación y la fuente no puede determinarse a partir del texto disponible. Acción: abra el artículo o elimine la cita. La incertidumbre no es una forma leve de respaldo.
Scite operacionaliza un esquema cercano a este a escala de literatura al mostrar si artículos posteriores respaldan, cuestionan o discuten un hallazgo. Eso es invaluable para las citas externas. No clasifica sus propias oraciones nuevas frente a sus propias figuras. Para las afirmaciones internas del manuscrito, el esquema de cuatro etiquetas debe aplicarlo el propio flujo de trabajo de redacción.
Una instrucción que impone el esquema:
«Para cada oración que propongas en la respuesta al revisor 1, muestra: (1) la oración, (2) la cita, (3) una cita textual de la fuente o el manuscrito, (4) una etiqueta: Respaldada / Parcialmente respaldada / Sin respaldo / Incierta, y (5) la reescritura que exige esa etiqueta. No incluyas ninguna oración etiquetada como Sin respaldo. Reescribe cada oración Parcialmente respaldada antes de mostrármela.»
La comparación de Columbia Journalism Review sobre motores de búsqueda con AI encontró fallos sistemáticos en las citas incluso cuando las fuentes nombradas eran marcas conocidas. Las herramientas académicas son mejores que los motores de respuesta de web abierta en esta dimensión, pero el modo de fallo es el mismo: se utiliza el nombre de una publicación de confianza como sustituto de una oración comprobada. La puerta de cuatro etiquetas existe para detener esa sustitución.
¿Cómo redactar una respuesta punto por punto sin exagerar las conclusiones?
Se redacta después de que existan las etiquetas y se deja que la etiqueta elija el verbo. «Muestra», «demuestra» y «prueba» se reservan para afirmaciones respaldadas con alcance coincidente. Las afirmaciones parcialmente respaldadas reciben «es consistente con», «aborda parcialmente» o «se mantiene bajo [restricción indicada]». Las afirmaciones inciertas no reciben verbos. Reciben un plan o una eliminación.
Un esquema limpio de carta de respuesta se ve así:
- Reformule el punto del revisor en lenguaje neutral.
- Indique qué hizo: ya estaba en el artículo, se analizó recientemente o se concedió.
- Señale una ubicación: página, línea, tabla, figura o suplemento.
- Cite trabajos externos solo si el comentario se refiere a la literatura y únicamente con una etiqueta de respaldo.
- Cierre con el cambio exacto en el manuscrito o con una razón acotada por la que no hizo uno.
Jenova's Academic Research Assistant puede mantener ese esquema a lo largo de una carta extensa si le proporciona la restricción desde el principio:
«Redacta la respuesta al revisor 2 usando únicamente elementos Respaldados y elementos Parcialmente respaldados ya reescritos de la tabla de evidencia. Utiliza la lista de verbos que te proporcioné. Cada párrafo debe incluir un localizador del manuscrito o una concesión explícita. No presentes experimentos futuros como si estuvieran terminados. No describas la sección de discusión de un artículo citado como si fuera nuestro resultado.»
Para SciSpace o un modelo general utilizado como redactor de cartas, debe pegarse la misma restricción, porque los productos de redacción optimizan la exhaustividad y la cortesía. La exhaustividad es la forma en que aparecen análisis fantasma. La cortesía es la forma en que un desacuerdo se eleva a «estamos de acuerdo y ahora hemos demostrado».
La cautela no es decorativa. Es una característica de fidelidad. Las expresiones de cautela útiles son específicas:
- Matices de alcance: «en esta muestra», «bajo la especificación lineal», «entre participantes con seguimiento completo»
- Matices epistémicos: «consistente con», «no descarta», «proporciona respaldo preliminar»
- Matices de proceso: «ahora informamos», «hemos añadido», «no podemos probarlo con el diseño actual»
Las elevaciones prohibidas en un borrador de réplica incluyen convertir una correlación en un efecto, una comprobación de robustez en una replicación, un resultado no significativo en «ninguna diferencia» y una única cita de respaldo en «está bien establecido». La orientación sobre redacción académica asistida por AI subraya que los autores siguen siendo responsables de comprobar que el texto generado coincide con las afirmaciones reales del manuscrito. Las revistas difieren sobre la divulgación, pero el resumen de The Conversation sobre las normas editoriales indica que la ayuda mecánica rutinaria puede no requerir cita, mientras que el contenido sustantivo generado por AI a menudo sí la requiere. Una carta de respuesta que contiene interpretaciones de la literatura redactadas por un modelo suele pertenecer al segundo caso.
La guía práctica de ProofreaderPro para cartas de respuesta acierta respecto a la estructura y el tono. La estructura y el tono no son la parte difícil. Lo difícil es negarse a responder a un comentario con más contundencia de la que permite su tabla. Si el revisor pidió una estrategia de identificación causal que usted no tiene, el borrador honesto es un párrafo sobre limitaciones y, si es viable, un análisis más débil pero identificado; no una reformulación más segura de la regresión original.
Una instrucción de segunda pasada que detecta exageraciones:
«Compara cada párrafo de respuesta con la tabla de evidencia. Señala toda oración cuyo verbo sea más fuerte que su etiqueta de respaldo. Señala toda cita que no esté acompañada de una cita textual. Señala toda promesa que no corresponda a una edición del manuscrito registrada.»
¿Qué dicen los especialistas en integridad de la investigación sobre las réplicas asistidas por AI?
Los investigadores que trabajan en integridad de la revisión por pares vuelven una y otra vez al mismo punto: la AI puede acelerar la recuperación y el formato, pero el autor sigue siendo responsable del valor de verdad de cada oración que se envía al editor.
«El fallo que observamos rara vez es una coma ausente en la lista de referencias. Es una oración que es un nivel epistémico demasiado fuerte para el artículo que cita. Un modelo recompensado por ser útil cerrará esa brecha por usted a menos que se lo prohíba. El control más barato es arquitectónico: recuperar, etiquetar y luego redactar. Si invierte ese orden, la carta contendrá afirmaciones que solo intentará justificar más tarde.»
«Las herramientas de citas inteligentes cambiaron el coste de comprobar si el campo todavía cree en un artículo. No cambiaron el coste de comprobar si su propia Tabla 3 respalda el verbo del párrafo 6 de la respuesta. Esa segunda comprobación sigue siendo un humano leyendo un número junto a una oración. Los autores que la omiten no están ahorrando tiempo. Lo están tomando prestado de la siguiente ronda de revisión.»
«También aconsejamos a los equipos mantener un registro de rechazos. Cada vez que el modelo quiera decir “mostramos” y la etiqueta sea solo parcial, anoten la oración rechazada. Después de dos o tres artículos, verán las exageraciones predeterminadas de su laboratorio: normalmente verbos causales, generalizaciones más allá de la muestra y citas de revisiones como si fueran ensayos. Las instrucciones personalizadas son simplemente una forma de codificar ese registro.»
— Equipo de Producto de Jenova, diseño de flujos de trabajo académicos, ocho años dando soporte a sistemas de manuscritos y citas
Ese consejo coincide con la literatura de investigación sobre AI en la propia revisión. Una revisión de PMC sobre AI en la revisión por pares subraya que los revisores aún deben evaluar críticamente el contenido generado por AI antes de cualquier decisión. La misma obligación se aplica cuando la AI está del lado del autor en la carta de decisión. Se advierte específicamente a los autores que utilizan modelos de la clase ChatGPT en correspondencia de revisión por pares que contrasten las sugerencias con las afirmaciones centrales del manuscrito y la integridad de la investigación.
La prueba práctica de Editage sobre AI en respuestas de revisión por pares es útil menos por una clasificación de ganador absoluto que por el patrón que revela: los modelos pueden juzgar si una respuesta parece completa y, sin embargo, seguir siendo débiles para determinar si la respuesta es verdadera. Parecer completa es la propiedad que hace que las cartas se presenten demasiado pronto.
¿Cuándo debería anular una respuesta a un revisor redactada por AI?
Debería anular el borrador siempre que la etiqueta de respaldo sea más débil que la oración, siempre que el comentario solicite un juicio que el modelo no pueda fundamentar o siempre que estar de acuerdo le comprometa con una afirmación que no pueda defender en la siguiente ronda. Anular no es una ruta excepcional, sino la ruta normal.
Anule de inmediato en estos casos:
- El agente cita un artículo que usted no ha abierto.
- El agente responde a una crítica metodológica con texto adicional en la introducción y sin una nueva prueba.
- El agente trata una mala interpretación del revisor como una petición de más citas en lugar de una reescritura de su explicación.
- El agente «encuentra» un análisis que no está en el repositorio.
- El agente está de acuerdo con dos revisores que han solicitado análisis incompatibles y no ha señalado el conflicto.
- El agente utiliza un artículo de revisión para sustentar una afirmación empírica primaria.
Algunos comentarios nunca deberían delegarse por completo. Las solicitudes sobre ética de la investigación, acceso a datos, conflictos de interés y si un resultado tiene importancia clínica o para políticas públicas requieren una decisión humana sobre aquello que está dispuesto a respaldar. La AI puede reunir los documentos. No puede aceptar responsabilidad por ellos.
También existe un problema inverso creciente: los autores ahora se encuentran con comentarios de revisores que parecen haber sido generados por AI. La respuesta correcta sigue siendo centrada en la evidencia. Reformule la solicitud científica procesable dentro del comentario, ignore el relleno genérico y responda a la solicitud que pueda documentar. Emparejar una revisión con apariencia de AI con una carta con apariencia de AI simplemente duplica el texto sin fundamento en el expediente.
Un cierre viable con humanos en el circuito para cada comentario:
- Lea la oración del revisor y escriba usted mismo un resumen de seis palabras.
- Acepte o rechace la fila de evidencia del agente antes de mirar el párrafo redactado.
- Si rechaza la fila, no edite el párrafo. Devuelva al agente a la recuperación.
- Si acepta una fila Parcialmente respaldada, edite usted mismo el verbo.
- Solo entonces incorpore el párrafo a la carta.
Utilizados de esta manera, Jenova's Academic Research Assistant, Scite, Elicit y un agente de redacción específico como SciSpace son complementarios, no intercambiables. Las herramientas de recuperación reducen la probabilidad de que pase por alto un artículo. La clasificación reduce la probabilidad de que lo utilice mal. Las herramientas de redacción reducen la probabilidad de que la carta esté desorganizada. Ninguna de ellas reduce la probabilidad de exageración a menos que usted se niegue a redactar a partir de afirmaciones sin etiqueta.
El estándar que vale la pena mantener es lo bastante simple como para colocarlo encima de la ventana de instrucciones: si no puede señalar una oración, tabla o concesión que justifique el verbo, la oración no pertenece a la respuesta.
Referencias
- Nature — Más de la mitad de los investigadores ya utilizan AI para la revisión por pares
- Biblioteca de la Universidad de Pretoria — Gestión de citas y riesgos de alucinación de AI
- Universidad de Stellenbosch — Directrices para el uso responsable de AI en la redacción académica
- Scite — Smart Citations y verificación de afirmaciones a nivel de oración
- PoolText — Lo que la AI puede y no puede hacer en la revisión por pares, incluida la comprobación de referencias
- ScienceDirect — Comparación de revisiones por pares generadas con AI y humanas
- Elicit — Búsqueda de literatura con AI y precisión de extracción comunicada
- Bibliotecas de la Universidad George Mason — Herramientas de AI para revisiones de literatura
- SciSpace — Flujo de trabajo del agente Response to Reviewers
- Consensus — Búsqueda con AI en literatura revisada por pares
- PeerReply — Flujo de trabajo de respuesta punto por punto y paquete de revisión
- Paper Digest — Verificación de afirmaciones frente a evidencia académica
- Manusights — Las mejores herramientas de AI para responder a revisores
- Columbia Journalism Review — Motores de búsqueda con AI y fallos de citas
- PMC — Redacción académica asistida por inteligencia artificial
- The Conversation — Directrices de editoriales sobre AI en artículos de revistas
- ProofreaderPro — Cómo redactar una carta de respuesta a revisores con ayuda de AI
- PMC — Inteligencia artificial en la revisión por pares
- PMC — Cómo navegar la revisión por pares con ChatGPT 4
- Editage — Pruebas de AI en respuestas de revisión por pares
- ResearchGate — Debate sobre comentarios de revisores generados por AI