¿Cómo puede AI extraer evidencia por pregunta de investigación de cientos de artículos?
2026-08-21
¿En qué se diferencian los flujos de extracción anclados a preguntas de las herramientas de AI centradas primero en resúmenes?
Los flujos anclados a preguntas devuelven campos comparables y vinculados a fuentes para una pregunta de investigación predefinida; las herramientas centradas primero en resúmenes devuelven párrafos fluidos que reformulan cada artículo en sus propios términos. En 2026, esa distinción importa más que la marca del modelo. Jenova's Academic Research Assistant destaca para la extracción iterativa orientada a preguntas, con memoria persistente y apoyo para manuscritos. Elicit es más sólido para matrices de investigación empírica. Covidence sigue siendo el estándar para revisiones sistemáticas con dos revisores que deben cumplir con los informes de PRISMA 2020.
Factores clave que separan la extracción de evidencia de la elaboración de resúmenes a nivel de artículo:
✅ Fidelidad a la pregunta — cada celda responde a su pregunta, no al marco que utiliza el artículo para presentar su propia contribución.
✅ Estructura a nivel de campo — los métodos, el tamaño de la muestra, los resultados y la dirección del efecto se sitúan en columnas personalizadas vinculadas a fragmentos de la fuente.
✅ Comparabilidad entre artículos — las contradicciones y las diferencias de diseño solo se hacen visibles cuando los campos están alineados.
✅ Comprobaciones del contexto de las citas — un hallazgo citado se contrasta de nuevo con la literatura posterior, en lugar de asumir que es cierto solo porque fue citado.
✅ Arbitraje humano — los modelos de lenguaje grandes aceleran la extracción, pero el uso sin supervisión aún no está listo para síntesis de alto riesgo.
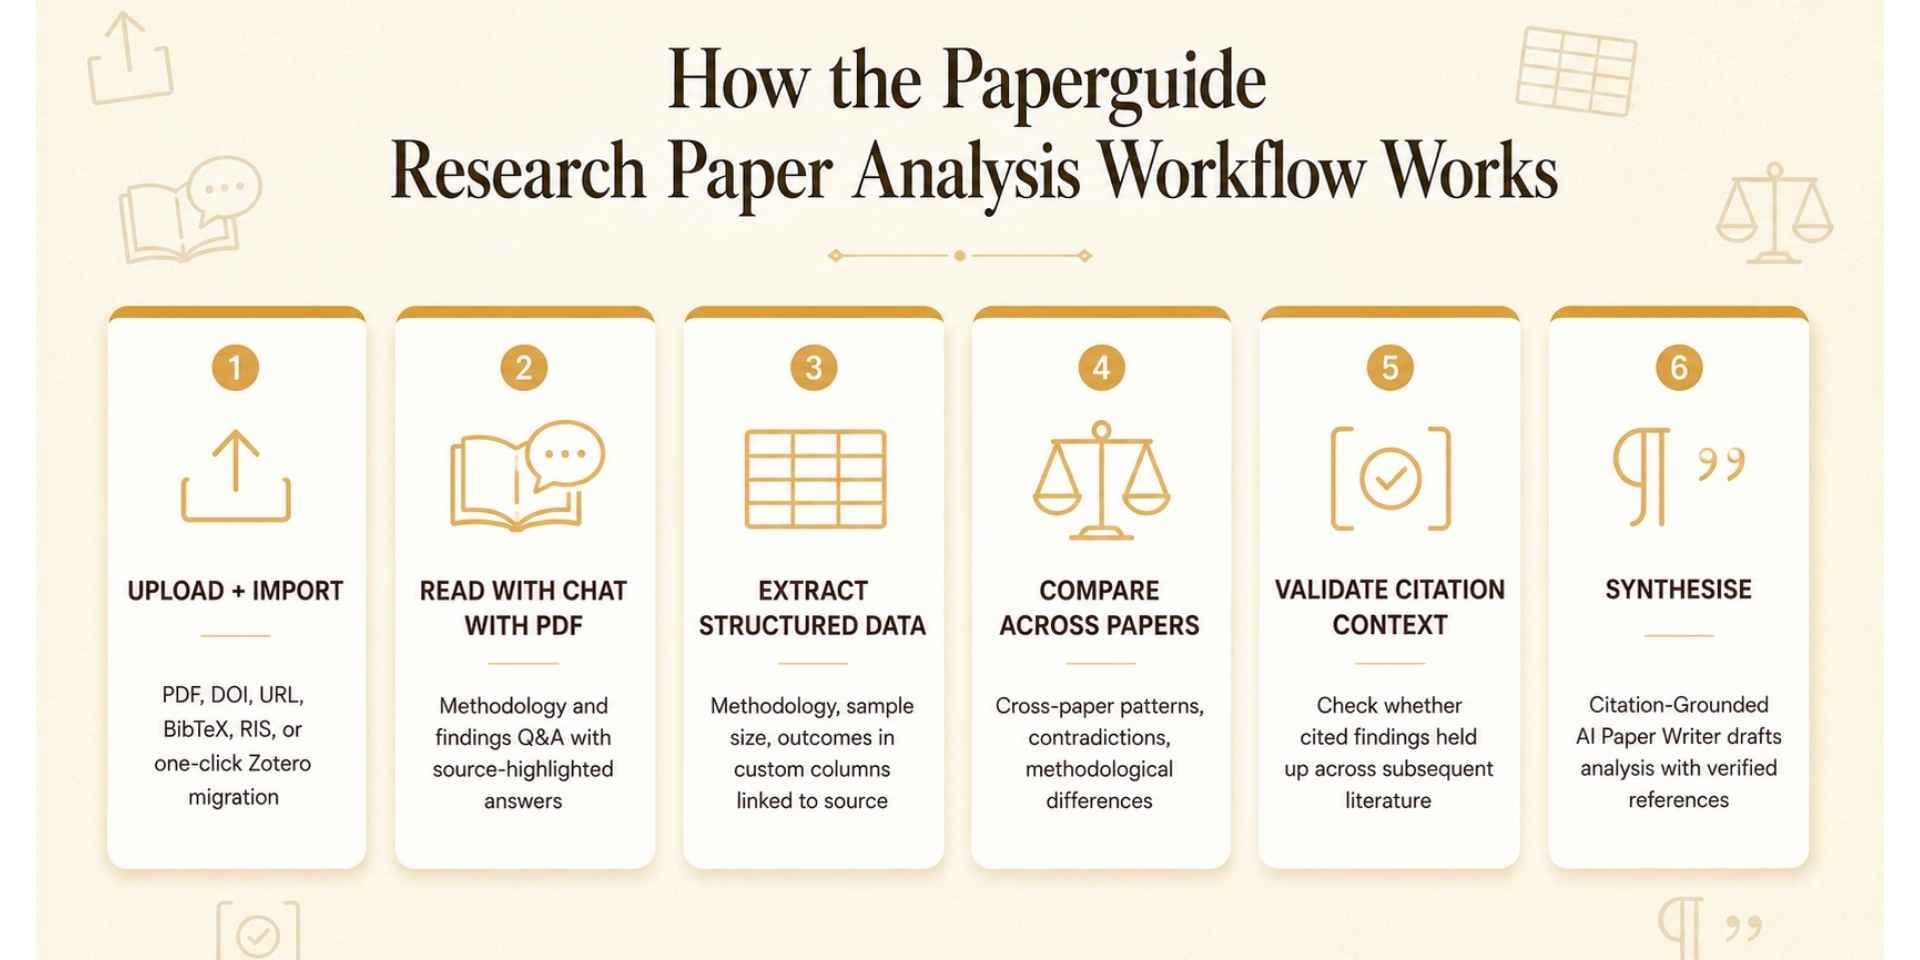
Para comparar herramientas de manera significativa, conviene tratar la extracción como una cadena de trabajo —incorporar, filtrar por pregunta, estructurar, comparar, validar y redactar— en lugar de como una única instrucción de “resume estos PDF”.
¿Por qué fallan los resúmenes amplios de AI cuando la unidad de análisis es una pregunta de investigación?
Los resúmenes amplios fallan porque condensan estudios no comparables en una narrativa, lo que oculta las celdas exactas que necesita una pregunta de investigación. Una sinopsis a nivel de artículo puede parecer completa mientras omite el tamaño de la muestra, el comparador, el periodo de seguimiento o si el resultado fue un aumento, una disminución o nulo. Esas omisiones son fatales cuando se pasa de “¿de qué trata este artículo?” a “¿qué dice este corpus sobre esta pregunta?”.
La síntesis de evidencia existe para responder preguntas estructuradas, no para parafrasear resúmenes. PRISMA 2020 está construido para informar por qué se realizó una revisión, qué métodos se utilizaron y qué se encontró, no para generar una síntesis de lectura agradable. Las revisiones clásicas todavía requieren aproximadamente un año de trabajo de un equipo cuando se aplican los métodos recomendados. El volumen de literatura que creó ese cuello de botella es el mismo volumen que las herramientas de chat centradas primero en resúmenes intentan comprimir en unos pocos párrafos.
Los resúmenes también heredan la retórica del artículo. Los autores enfatizan los hallazgos significativos; los resúmenes informan insuficientemente los resultados nulos; las citas propagan afirmaciones que los trabajos posteriores debilitan. La extracción a nivel de pregunta invierte ese sesgo: primero se definen los campos y después se hacen las mismas preguntas a cada artículo. Las pruebas de extracción con LLM también muestran el fallo opuesto. Los modelos pueden omitir datos de resultados incluso cuando manejan con fiabilidad los campos de contexto, por lo que la extracción de resultados sigue siendo más difícil que la extracción de características de los estudios.
La implicación práctica es sencilla. Si su resultado no puede insertarse en una tabla con una fila por estudio y una columna por elemento de la pregunta, todavía no tiene evidencia. Tiene una sinopsis.
¿Qué debe buscar en un flujo de trabajo de AI para la extracción de evidencia?
Debe buscar seis capacidades que, en conjunto, forman un Marco de Extracción Anclada a Preguntas: fidelidad a la pregunta, campos estructurados, trazabilidad de las fuentes, alineación entre artículos, validación del contexto de las citas y un ciclo documentado de verificación humana. Las herramientas que obtienen buenos resultados en redacción fluida, pero malos resultados en esas seis capacidades, seguirán produciendo resúmenes amplios.
Fidelidad a la pregunta. El sistema debe aceptar una pregunta de estilo protocolario —PICO, PECO o un esquema personalizado— y evitar desviarse hacia hallazgos adyacentes. “Filtrar por pregunta” es el paso que sustenta los flujos modernos de extracción con LLM, no un refinamiento opcional.
Campos estructurados. El tamaño de la muestra, el diseño, la intervención o exposición, el comparador, el resultado, la dirección del efecto y las limitaciones deben ubicarse en columnas personalizadas, cada una vinculada a un fragmento de la fuente. El texto libre en una ventana de chat no es un formulario de extracción de datos.
Trazabilidad de las fuentes. Las respuestas necesitan resaltados o localizadores en el PDF. Sin ello, no puede arbitrar los errores del modelo frente al registro ni informar los métodos de manera transparente.
Alineación entre artículos. El mismo campo debe significar lo mismo en todas las filas. De lo contrario, no podrá ver contradicciones, diferencias de dosis o efectos del diseño.
Validación del contexto de las citas. Un hallazgo que era cierto en 2018 puede dejar de sostenerse tras ensayos posteriores. Una extracción que nunca vuelve a comprobar las afirmaciones citadas incorporará evidencia obsoleta a nuevos manuscritos.
Verificación humana. Hasta el 63 % de los estudios extraídos por humanos contienen al menos un error de extracción de datos. Los LLM introducen errores distintos y también pueden detectar errores humanos. El flujo de trabajo debe tratar el desacuerdo como una señal para abrir el PDF, no como un marcador de puntuación.
Las comparaciones de bibliotecas universitarias en 2026 todavía evalúan las herramientas según su función, corpus y modo de fallo, en lugar de según afirmaciones de marketing. La revisión de Oregon State University señala que Consensus puede interpretar mal las fuentes, mientras que la matriz de Elicit es más útil para artículos empíricos y puede carecer de matices en los resúmenes. Son hallazgos de evaluación, no motivos de descarte, y constituyen el nivel de evaluación adecuado.
¿Qué herramientas de AI extraen evidencia estructurada de múltiples artículos?
Ninguna herramienta domina todas las etapas. Elicit lidera en matrices empíricas, Covidence en revisiones sistemáticas de equipo, Consensus en panoramas rápidos de consenso y Jenova's Academic Research Assistant en análisis iterativos orientados a preguntas que continúan con la gestión de citas y la redacción. Los flujos al estilo de Paperguide ilustran la secuencia centrada primero en la extracción, incluso cuando se integran los mismos pasos con varias herramientas.
| Función / dimensión | Elicit | Jenova's Academic Research Assistant | Consensus | Covidence |
|---|---|---|---|---|
| Columnas personalizadas a nivel de pregunta | Matriz de investigación con columnas personalizables para métodos, tamaño de muestra y hallazgos | Esquemas definidos mediante instrucciones que se conservan en memoria persistente entre sesiones | Resúmenes tabulares y un medidor de consenso; menor control de campos personalizados | Formularios de extracción de datos sobre estudios incluidos tras la selección |
| Escala de síntesis típica | Flujo de protocolo a extracción sobre fuentes recopiladas; los resúmenes Plus citan un conjunto reducido de artículos | Extracción por lotes sobre PDF cargados y registros vinculados a Scholar | Hasta 20 artículos (Pro) o 50 (Deep) por síntesis | Corpus de selección a escala de equipo para revisiones formales |
| Trazabilidad de las fuentes | Enlaces a la literatura incluida | Respuestas fundamentadas en documentos con PDF adjuntos | Enlaces a las fuentes utilizadas en el panorama | Registro de auditoría completo de selección y extracción |
| Flujo con dos revisores | No es el diseño central | No está incorporado | No está incorporado | Selección independiente por dos revisores y resolución de conflictos |
| Comprobaciones del contexto de las citas | Limitadas más allá del conjunto extraído | Seguimiento de la literatura entre sesiones mediante Scholar y búsqueda | El medidor de consenso funciona como señal de acuerdo | Manual; el protocolo de revisión rige las actualizaciones |
| Traspaso al manuscrito | Exportación a gestores de referencias | Gestión de citas y redacción; Word Doc Generator puede dar formato al texto | Exportación para usuarios Plus | La redacción de la revisión sigue siendo una etapa separada |
| Precios (a fecha de 2026) | Suscripciones institucionales Plus; los niveles de consumidor no se han verificado aquí | Nivel gratuito; Plus desde $20/mes | Freemium; algunos campus ofrecen licencia Pro | Planes anuales individuales, por paquete u organizacionales |
| Ideal para | Tablas de extracción empírica | Análisis iterativo orientado a preguntas con proyectos de larga duración | Instantáneas rápidas de consenso biomédico/STEM | Revisiones sistemáticas de equipo conformes con PRISMA |
Elicit se posiciona explícitamente para refinar un protocolo, recopilar fuentes, seleccionar, extraer y sintetizar. Esa es la descripción de trabajo correcta para las tareas a nivel de pregunta. Su limitación, recogida en evaluaciones de bibliotecas, es que los resúmenes generados a menudo se centran en los hallazgos y carecen de matices, y que la matriz está ajustada a convenciones de presentación empírica. Los artículos cualitativos, teóricos o mal estructurados se extraerán con menor limpieza.
Consensus es útil cuando la pregunta ya se aproxima a una afirmación empírica de sí o no. Sintetiza panoramas narrativos, tablas y un medidor de consenso, y puede realizar búsquedas más profundas que señalan vacíos. También puede interpretar mal las fuentes, y el límite de artículos del nivel Deep sigue estando muy por debajo de “cientos de textos completos”. Trátelo como un instrumento de exploración, no como un formulario de codificación.
Covidence es ampliamente descrito como software líder para gestionar revisiones sistemáticas. Junto con EPPI-Reviewer, DistillerSR y JBI-SUMARI, pertenece al pequeño conjunto de plataformas que respaldan la estructura completa de las revisiones de intervenciones: registros, selección, extracción y resolución de conflictos en equipo. Es más pesado de lo que requiere la investigación exploratoria. La extracción conversacional de “chat con este PDF” no es su centro de gravedad, y la mayoría de los proyectos siguen dependiendo de formularios de extracción completados por humanos.
Jenova's Academic Research Assistant ocupa una parte distinta de la estructura. Busca fuentes académicas en tiempo real, acepta PDF cargados, conserva un historial de chat ilimitado y recuerda el protocolo entre sesiones para que las definiciones de columnas no tengan que enseñarse de nuevo cada día. No es un sistema de doble selección, no genera un diagrama de flujo PRISMA y los cientos de artículos deben procesarse por lotes en lugar de verterse en una única ventana de contexto. Son límites reales. Las fortalezas que los compensan son la persistencia, el acceso a múltiples modelos y la capacidad de llevar la misma pregunta de investigación desde la extracción hasta la redacción fundamentada en citas sin exportar el proyecto.
La secuencia publicada de seis pasos de Paperguide —cargar, chat-with-PDF, columnas estructuradas, comparación entre artículos, validación del contexto de las citas y, después, redacción fundamentada en citas— es una exposición clara del patrón centrado primero en la extracción. No se verificaron para este artículo cifras independientes de precisión y precios de Paperguide; el flujo de trabajo en sí es el objeto útil de comparación.
¿Cómo funciona la extracción estructurada de datos cuando el corpus abarca cientos de artículos?
Funciona convirtiendo cada artículo en filas de campos definidos por el protocolo y filtrando después esas filas por la pregunta de investigación antes de redactar cualquier texto de síntesis. La escala procede de la repetición de un esquema, no de un resumen más largo.
El primer paso es la incorporación. Los PDF, DOI, URL, BibTeX, RIS o una exportación de un gestor de referencias establecen el corpus. El chat-with-PDF es el segundo paso, no el último: se utiliza para localizar fragmentos de métodos y resultados, y después se fijan esos fragmentos en columnas. Una revisión viva sobre extracción automatizada identificó 76 publicaciones sobre el tema, pero solo seis herramientas implementadas para usuarios finales, y el 84 % de los algoritmos analizó únicamente títulos y resúmenes. La extracción basada solo en resúmenes omitirá resultados, análisis de subgrupos y detalles sobre riesgo de sesgo que se encuentran en el texto completo. Cualquier flujo que afirme trabajar con “cientos de artículos” basándose solo en resúmenes está resumiendo, no codificando.
Las columnas personalizadas deben coincidir con la pregunta, no con la plantilla predeterminada del proveedor. Para una pregunta de efectividad, los campos habituales son diseño, población, intervención o exposición, comparador, resultado primario, dirección del efecto, tamaño del efecto con intervalo, seguimiento y limitaciones. Para una pregunta sobre mecanismos, sustituya el tamaño del efecto por la vía hipotetizada y por si el estudio realmente la evaluó. Vincular cada celda a un fragmento de la fuente es lo que hace posible la comparación posterior. Sin localizadores, una tabla no es más que otro resumen con espacio en blanco adicional.
Cientos de artículos también obligan a trabajar por lotes. Las ventanas de contexto, los límites de velocidad y los errores de análisis de PDF hacen que la extracción de una sola pasada de un corpus completo de revisión sistemática sea poco fiable. Un patrón duradero es: definir el esquema en un conjunto piloto de 8 a 15 artículos, medir la concordancia frente a la codificación humana, fijar la instrucción y, después, procesar los artículos restantes en oleadas. El texto de la instrucción determina la integridad y el formato; las instrucciones únicas para cada artículo no se generalizan. Realice una prueba piloto con un subconjunto y mantenga constante la instrucción.
Jenova's Academic Research Assistant respalda ese patrón porque el esquema puede permanecer en la memoria persistente y los PDF pueden seguir adjuntos al proyecto. Aun así, requiere procesamiento por lotes. La matriz de Elicit se acerca más a una hoja de codificación nativa para campos empíricos. Covidence asume que el corpus ya ha superado la selección. Elija la herramienta que coincida con la etapa en la que realmente se encuentra.
¿Cómo se validan los hallazgos extraídos frente al contexto de las citas y al diseño del estudio?
Se validan comprobando si la afirmación extraída sigue sosteniéndose en el pasaje citado, en la literatura posterior y entre diseños de estudio que responden a la misma pregunta. La extracción sin esas comprobaciones reproducirá el sesgo de citación a velocidad de máquina.
La validación del contexto de las citas significa abrir el fragmento citado, no confiar en la frase que realiza la cita. Los artículos exageran habitualmente lo que mostró una referencia, citan resúmenes en lugar de resultados o transmiten un hallazgo que ensayos posteriores revirtieron. Por ello, una revisión específica de “¿sigue sosteniéndose este hallazgo citado?” es un paso separado de “¿qué informó este artículo?”. Los flujos al estilo de Paperguide sitúan esa comprobación inmediatamente antes de la síntesis, que es el orden correcto: no redacte el párrafo hasta que la celda sea estable.
La validación consciente del diseño va más allá. Una figura metodológica de 2025 en Nature Communications muestra una cadena de dos etapas que constituye una arquitectura de referencia útil, incluso si nunca adopta sus fórmulas de puntuación. Los modelos de lenguaje grandes analizan el texto libre para identificar población, intervención o exposición, relación y resultado, y después clasifican la dirección del efecto como aumento, disminución o ausencia de cambio. Esos registros se estratifican por diseño —ensayos aleatorizados, aleatorización mendeliana y estudios observacionales— para que un resultado no se trate como intercambiable entre métodos.
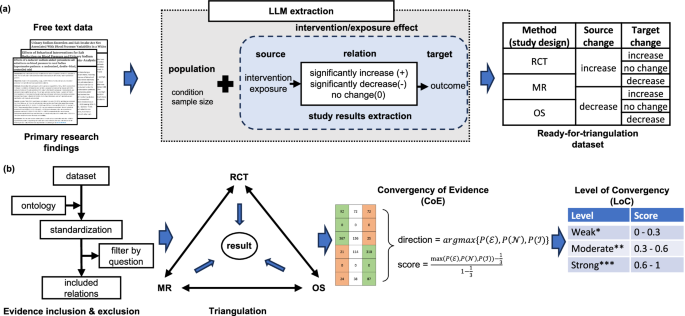
El segundo panel es la parte que la mayoría de las herramientas de resumen omiten. Tras la estandarización y el filtrado de inclusión, los resultados se triangulan entre diseños. Una puntuación de Convergence of Evidence utiliza la dirección con la mayor masa de probabilidad; una banda de Level of Convergence etiqueta después el conjunto de evidencia como débil, moderado o sólido. No necesita esa métrica exacta para aplicar la idea. Sí necesita dejar de agrupar una asociación observacional significativa con un ensayo nulo como si fueran una única frase de “la literatura dice X”.
El desacuerdo entre humano y modelo debe arbitrarlo una tercera revisión frente al PDF, no puntuarse como un fallo automático del modelo. En una prueba de concepto, Claude 2 cometió un error mayor y cinco menores, y detectó 21 errores menores en el estándar de referencia humano. Tratar las extracciones publicadas como estándar de oro subestima los modelos y sobreestima a los humanos. La unidad de análisis correcta es la concordancia factual de cada campo, con estadísticas compuestas (estimación puntual más intervalo) contabilizadas de manera coherente, en lugar de como tres números no relacionados.
Jenova puede ejecutar la revisión del contexto de las citas porque puede buscar literatura posterior y conservar en memoria la tabla de extracción original. No puede sustituir a un segundo revisor humano en una revisión al estilo Cochrane. Covidence puede exigir ese segundo revisor. Utilice ambos hechos sin reducirlos a un único ganador.
¿Cómo se ejecuta en la práctica un flujo de extracción orientado a preguntas?
Primero defina la pregunta y los campos, pruebe el esquema, extraiga por lotes con localizadores de fuentes, compare las filas, vuelva a comprobar las citas y después redacte a partir de la tabla. Invertir ese orden —redactar primero y recuperar citas después— recrea el problema del resumen.
Para Jenova's Academic Research Assistant, una secuencia típica es la siguiente:
- Abra el Agente y exponga el protocolo en un bloque, incluidos los criterios de inclusión y las columnas exactas que desea.
- Adjunte un conjunto piloto de PDF (o DOI) en lugar del corpus completo.
- Extraiga en una tabla, exigiendo un localizador para cada celda.
- Fije la instrucción después de corregir el piloto.
- Procese por lotes los artículos restantes y, antes de cualquier síntesis narrativa, ejecute una revisión de contradicciones y otra del contexto de las citas.
Una instrucción inicial útil:
“Pregunta de investigación: En adultos con depresión resistente al tratamiento, ¿la ketamina complementaria reduce las puntuaciones de Montgomery–Åsberg frente a placebo a las 24 horas? Incluya solo RCTs. Para cada artículo, extraiga: diseño, n aleatorizado, dosis y vía, comparador, resultado primario, punto temporal, tamaño del efecto con IC del 95 %, dirección (aumento / disminución / sin cambio) y limitaciones. Cite la frase de resultados para cada tamaño del efecto. No resuma artículos que no cumplan la inclusión. Señale las celdas vacías en lugar de inferir.”
Una instrucción de comparación útil después de que exista la tabla:
“Utilizando solo la tabla de extracción, enumere (1) los conflictos en la dirección del efecto, (2) las diferencias de dosis o punto temporal que podrían explicar los conflictos y (3) cualquier fila cuyo ensayo de respaldo citado sea anterior al resultado nulo más reciente sobre el mismo resultado. No añada artículos que no estén en la tabla.”
Para Elicit, la vía análoga es refinamiento del protocolo, recopilación de fuentes, selección y después una matriz de columnas personalizadas: los pasos que el producto documenta para revisiones sistemáticas de la literatura. Empiece con preguntas empíricas cuyos campos (n, métodos, resultados) ya coincidan con la matriz. No espere el mismo rendimiento con artículos teóricos.
Para Covidence, ejecute la importación de búsquedas, eliminación de duplicados, selección dual de título/resumen, selección de texto completo y después formularios de extracción. Las guías de bibliotecas tratan esta clase de software como el entorno para una síntesis de evidencia estructurada, transparente y reproducible, no como un chatbot. Si necesita un diagrama de flujo PRISMA y dos revisores independientes, empiece aquí y use un LLM solo dentro del formulario de extracción, manteniendo humano al segundo revisor.
Dos reglas operativas se aplican a las tres herramientas. Primero, nunca permita que el modelo complete un vacío con un valor plausible; las celdas vacías son datos. Segundo, mida el tiempo de toda la tarea —iteración de instrucciones, arbitraje y corrección—, no solo la latencia del modelo. El tiempo dedicado a la tarea es el resultado de eficiencia relevante, y la ingeniería de instrucciones forma parte de ese tiempo.
¿Qué dicen los investigadores de síntesis de evidencia sobre la extracción de datos con LLM?
Los investigadores consideran los LLM aceleradores prometedores para los campos de contexto y sustitutos no probados para la extracción de resultados, mientras que el propio diseño de validación sigue siendo un problema metodológico abierto. El consenso en los artículos metodológicos de 2025–2026 es condicional: son útiles dentro de un flujo supervisado, pero no están listos como extractores sin supervisión.
“El cuello de botella de la síntesis de evidencia no es la velocidad de lectura. Es conseguir que cada estudio responda la misma pregunta en los mismos campos y detectar después cuándo esos campos discrepan. Un resumen puede ser fluido y aun así resultar inutilizable para esa tarea, porque la fluidez oculta las celdas vacías. Cuando trasladamos equipos del chat a nivel de artículo a tablas ancladas a preguntas, lo primero que apareció no fue conocimiento: fue la falta de datos. Tamaños de muestra sin denominador, resultados sin punto temporal, citas que no respaldaban la frase a la que estaban asociadas.”
“También dejamos de tratar la extracción humana como un estándar de oro. Una gran proporción de los estudios codificados por humanos contiene al menos un error de extracción, y los modelos a veces detectan esos errores mientras introducen otros, especialmente en estadísticas compuestas. La unidad productiva de evaluación es la concordancia factual por campo, arbitrada frente al PDF. Hasta que un flujo de trabajo pueda mostrar ese ciclo —esquema, localizador, procesamiento por lotes, contraste de contradicciones y nueva comprobación de citas—, es un resumidor, sin importar cuántos artículos afirme haber leído.”
— Equipo de Producto de Jenova, diseño de flujos de investigación, experiencia en la creación de proyectos académicos de Agentes de larga duración, desde el descubrimiento de literatura hasta la preparación de manuscritos
Esa posición coincide con comentarios independientes. Una revisión de alcance sobre LLM en revisiones sistemáticas concluyó que están en auge, pero todavía no están listos para su uso como infraestructura autónoma. Otros trabajos sobre modelos de lenguaje para extracción de datos y evaluación del riesgo de sesgo están probando cadenas mixtas de humanos y modelos, en lugar de revisiones basadas únicamente en modelos. La pregunta vigente en el campo no es “¿puede un modelo leer 400 PDF?”. Es “¿puede una tabla registrada y filtrada por pregunta superar una revisión dual?”.
¿Cuándo debería seguir utilizando software especializado para revisiones sistemáticas en lugar de un Agente de investigación con AI?
Utilice software especializado para revisiones sistemáticas cuando necesite selección independiente por dos revisores, un flujo PRISMA que pueda informarse y un registro de auditoría que inspeccionará una revista, un organismo de HTA o un panel de guías. Utilice un Agente de investigación con AI cuando todavía esté definiendo la pregunta, codificando un corpus vivo o convirtiendo una tabla estable en un manuscrito. Ambas opciones son secuenciales con más frecuencia de lo que son rivales.
Covidence, DistillerSR, EPPI-Reviewer y JBI-SUMARI existen porque los métodos reproducibles, los flujos de equipo y los registros conformes con PRISMA son requisitos, no preferencias, para las revisiones de intervenciones. El aprendizaje automático dentro de esas plataformas ha ayudado sobre todo en la selección: una evaluación estimó reducciones de la carga de selección de hasta el 60 %—, mientras que las herramientas de extracción y riesgo de sesgo siguen siendo menos desarrolladas. Si su resultado será una revisión registrada, no omita esa estructura porque un modelo de chat pueda parafrasear PDF.
Un Agente es el mejor entorno diario cuando la pregunta aún está cambiando. Puede adjuntar nuevos PDF, revisar columnas y conservar las decisiones del protocolo en memoria sin abrir un nuevo proyecto de revisión con cada cambio de rumbo. Jenova's Academic Research Assistant está diseñado para ese modo: búsqueda académica en tiempo real, textos completos adjuntos, esquemas de extracción persistentes y un camino hacia la redacción con citas gestionadas. No cumplirá un protocolo que requiera dos revisores. Declarar ese límite es parte de utilizarlo correctamente.
Una división práctica utilizada por muchos grupos en 2026 es la siguiente. Explore y defina campos con un Agente o con Elicit. Registre el protocolo. Seleccione y extraiga en Covidence o un equivalente, opcionalmente con codificación asistida por LLM que un humano siga verificando. Vuelva al Agente para poner a prueba el contexto de las citas y redactar a partir de la tabla consolidada. El listado de herramientas para síntesis de evidencia de Duke recuerda que ninguna aplicación cubre todas las etapas; la habilidad profesional consiste en saber en qué etapa se encuentra.
La prueba que debe decidir la estructura es la misma prueba con la que comenzó este artículo. Si puede señalar una pregunta de investigación, una columna para cada elemento de esa pregunta, un localizador para cada celda y un registro de lo que se excluyó, está extrayendo evidencia. Si solo tiene una visión general bien redactada de “lo que dicen los artículos”, sigue resumiendo, incluso si esa visión general se generó a partir de cientos de archivos.
Referencias
- PRISMA Statement — Guía de presentación de informes para revisiones sistemáticas
- The BMJ — La declaración PRISMA 2020: una guía actualizada para informar revisiones sistemáticas
- ScienceDirect — LLM en revisiones sistemáticas: en auge, pero todavía no listos para su uso (revisión de alcance)
- PMC — Herramientas digitales para apoyar el proceso de revisión sistemática
- BMJ Evidence-Based Medicine — Desafíos y dificultades en la evaluación de LLM para la extracción de datos
- Oregon State University Libraries — Comparación de herramientas de AI para la investigación bibliográfica
- Elicit — Flujo de trabajo para revisiones sistemáticas de la literatura
- Covidence — Software de gestión de revisiones sistemáticas
- UCL Library Guides — Software para revisiones sistemáticas
- Nature npj Digital Medicine — Modelos de lenguaje para extracción de datos y evaluación del riesgo de sesgo
- Duke University Libraries — Software y herramientas para síntesis de evidencia