¿Reduce mejor la AI multimodelo los puntos ciegos en el análisis de acciones?
2026-08-24
¿Cómo exponen el desacuerdo entre modelos y las comprobaciones de conjunto los riesgos ocultos de una tesis?
La verificación cruzada multimodelo reduce los puntos ciegos y la sobreconfianza de forma más fiable que el análisis de acciones con un único modelo, porque el desacuerdo entre modelos es en sí mismo una señal de riesgo, no una molestia que deba promediarse hasta desaparecer. En 2026, una única respuesta fluida de ChatGPT, Claude o Gemini puede parecer una investigación terminada. Esa fluidez es el problema. Un modelo, una ventana de contexto y una distribución de entrenamiento producen una historia coherente incluso cuando las cifras están desactualizadas, el documento regulatorio se interpreta mal o falta el caso bajista.
Lo que realmente separa la investigación bursátil rigurosa con AI de las conjeturas formuladas con seguridad:
✅ Fundamentación en fuentes — documentos regulatorios, estimaciones y precios actualizados frente a un límite temporal de entrenamiento ✅ Diversidad de modelos — más de un proveedor, para que sea más fácil detectar un sesgo de corpus compartido ✅ Diversidad de roles — perspectivas fundamental, técnica, macroeconómica y de cartera en vez de un único generalista ✅ Visualización de incertidumbre — rangos, conflictos e indicadores de «no se puede verificar» en lugar de una precisión falsa ✅ Coste de una segunda revisión — lo bastante bajo para que las verificaciones cruzadas se hagan realmente antes de aumentar el tamaño de la posición
Una regla práctica útil es la prueba de Desacuerdo como señal: considera el consenso de los modelos como una hipótesis y el conflicto entre modelos como la agenda de investigación. El resto de este artículo aplica esta prueba a chatbots de un único modelo, sistemas de puntuación especializados como Danelfin, herramientas de investigación centradas en citas como Perplexity y los agentes especializados en renta variable de Jenova.
¿Por qué persiste la sobreconfianza cuando los inversores utilizan un único modelo de AI?
La sobreconfianza persiste porque un único modelo devuelve una narrativa pulida, y las narrativas pulidas eliminan la fricción que normalmente obliga a revisar el análisis por segunda vez. Las finanzas conductuales tratan la sobreconfianza como un sesgo sistemático, no como un defecto de personalidad. En los mercados se manifiesta como negociación excesiva, apuestas concentradas y evidencia contraria ignorada.
Ese patrón no desaparece cuando el analista es una AI. La investigación sobre sobreconfianza y sesgo de confirmación en el trading vincula este sesgo con mayor rotación, una diversificación más limitada y rendimientos más débiles. Una revisión de 2025 sobre el comportamiento de los inversores en la era de la AI concluye que las intervenciones discrecionales pueden anular las ganancias de eficiencia de los algoritmos, aumentando la volatilidad en lugar de reducirla. Trabajos más recientes describen la «sobreconfianza algorítmica»: una vez que el análisis se delega en un modelo, los usuarios tratan el resultado como más objetivo de lo que realmente es.
Una sesión con un único modelo empeora esto de tres maneras mecánicas. Primero, el modelo es recompensado por la coherencia, por lo que rellena lagunas en vez de señalarlas. Segundo, el usuario no ve desacuerdo entre pares, que es la señal que utilizan las instituciones para ampliar los intervalos de confianza. Tercero, la interfaz es conversacional, por lo que incluso una cifra errónea llega redactada con seguridad. La alerta para inversores de la SEC de Estados Unidos sobre AI es directa al respecto: la AI puede generar y difundir información falsa o inexacta, y los inversores deben verificar las afirmaciones con profesionales registrados.
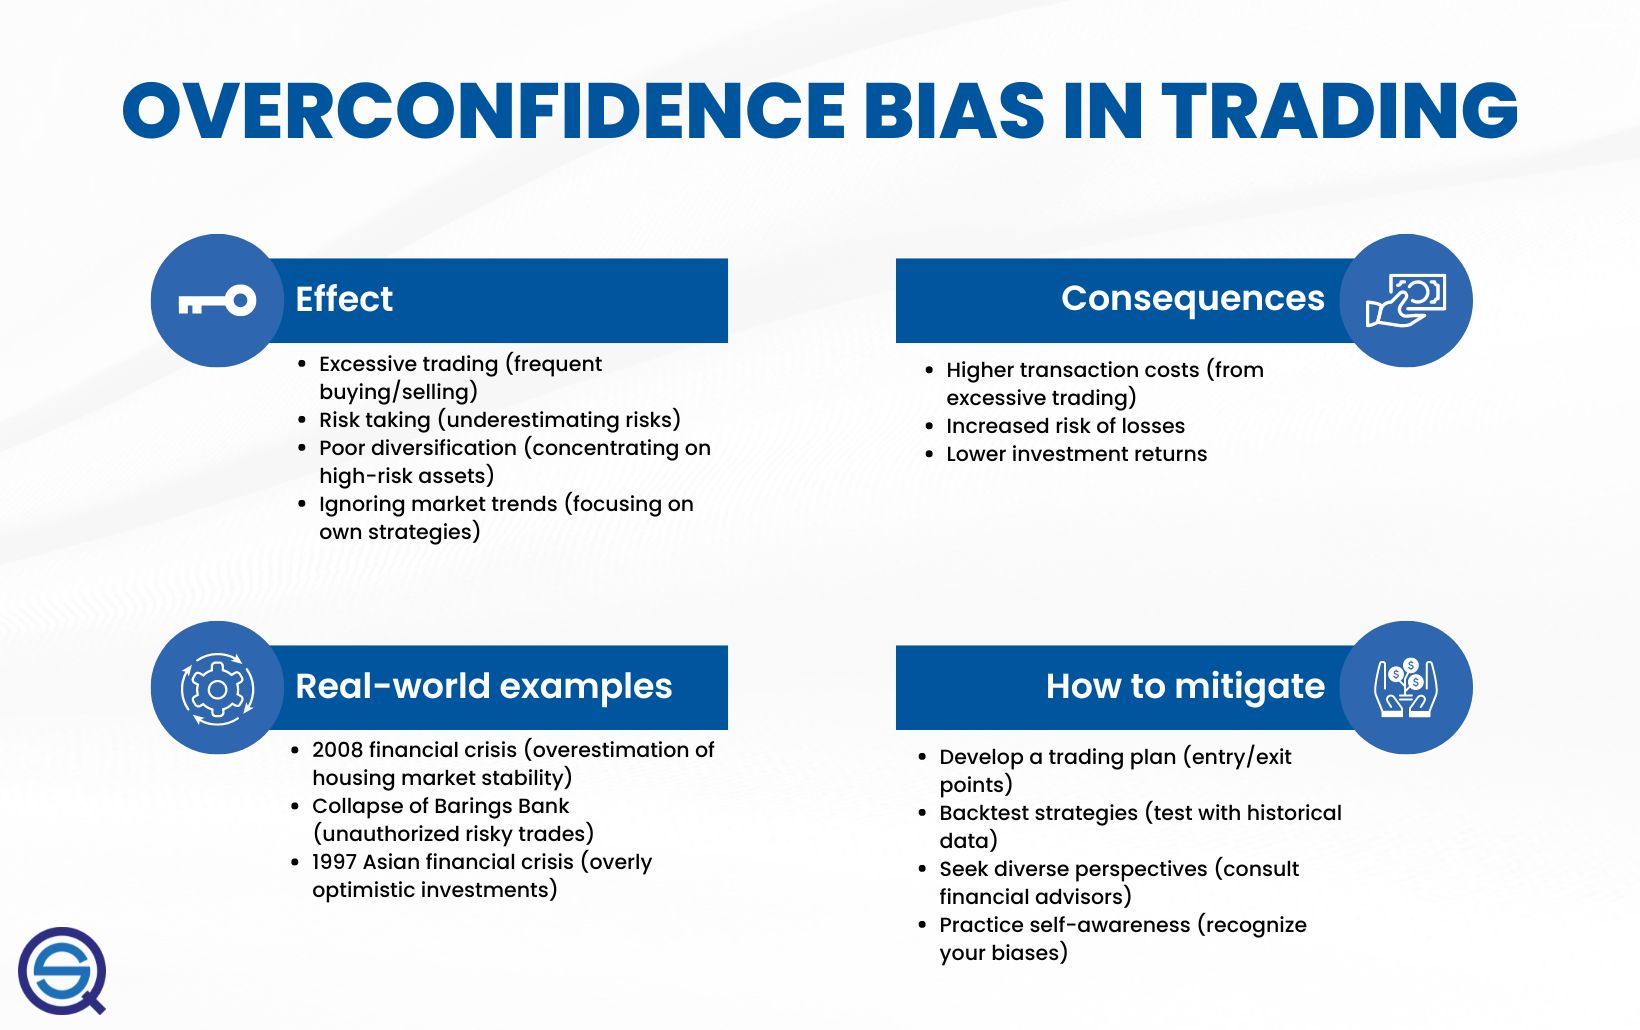
La mitigación clásica —un plan por escrito, pruebas históricas y perspectivas diversas— se traduce directamente en la arquitectura de investigación. Un único modelo puede ayudar a redactar el plan. No puede ser, por sí solo, la perspectiva diversa.
¿Qué debería evaluar al comparar el análisis de acciones con un único modelo y con varios modelos?
Deberías evaluar seis capas de cobertura, no qué interfaz parece más inteligente. Llamémoslo la Auditoría de puntos ciegos de seis capas. Es una lista de verificación práctica para cualquier ticker, herramienta y horizonte temporal.
1. Fundamentación en fuentes. ¿El sistema obtiene documentos actuales de la SEC, estimaciones y precios, o completa texto a partir de una fecha límite? Openbook Analytics señala que los chatbots generales carecen de datos de mercado en tiempo real y no pueden verificar los números que generan, y que el CEO de Perplexity ha reconocido que existen datos de mercado desactualizados en la plataforma.
2. Diversidad de modelos. Un proveedor implica un modo de fallo. Contrastar resultados de clase GPT con Claude, Gemini o DeepSeek solo es útil si cambian realmente el prompt, los datos y el rol. Cambiar de marca manteniendo el mismo prompt desactualizado no es diversidad.
3. Diversidad de roles. Una lectura fundamental, una lectura de cotización y estructura, y una capa macroeconómica detectan errores distintos. Esto se parece más a una reunión de investigación que a un hilo de chatbot.
4. Representación de incertidumbre. Prefiere rangos, casos rivales e indicadores explícitos de «sin verificar» frente a un único precio objetivo.
5. Persistencia. El trabajo de tesis abarca semanas. Las herramientas que olvidan la perspectiva alternativa del martes pasado volverán a inflar la confianza en la siguiente sesión.
6. Coste por verificación. Si una segunda pasada de modelo es cara o incómoda, se omitirá precisamente cuando la posición sea mayor.
La revisión de FINRA sobre AI en la industria de valores expresa los mismos problemas en lenguaje regulatorio: gestión del riesgo de modelo, explicabilidad, integridad de datos y controles de supervisión. Se espera que las empresas comprendan cómo un modelo produce un resultado antes de apoyarse en él para flujos de trabajo de asesoramiento de inversión bajo Regulation Best Interest y la Norma FINRA 2111. Los inversores individuales no cuentan con un programa de la Norma 3110. Aun así, necesitan un hábito equivalente: saber qué no puede ver el modelo.
Un artículo de 2025 de Harvard Business School sobre sesgo extranjero en LLM financieros añade un modo de fallo más discreto. La información puede estar ausente de los datos de entrenamiento o estar presente pero infraponderada. Dos modelos centrados en Estados Unidos pueden «coincidir» sobre una empresa de mercados emergentes y compartir aun así la misma laguna.
¿En qué se diferencian ChatGPT, Danelfin, Perplexity y Jenova en la cobertura de puntos ciegos?
Se diferencian primero en si producen una puntuación, un informe con citas o un expediente de investigación cuestionable. ChatGPT es más fuerte como compañero de reflexión y más débil como motor de cifras. Danelfin es más fuerte como filtro transparente y más débil como debate entre múltiples roles. Perplexity es más fuerte al recuperar fragmentos con citas y más débil cuando esos fragmentos están desactualizados. El Analista Fundamental de Acciones de Jenova destaca cuando una tesis necesita integrar resultados, valoración y sentimiento, y luego ser cuestionada por otros modelos o agentes especializados.
Openbook Analytics, al resumir pruebas anteriores, informa de que ChatGPT respondió incorrectamente a cerca del 35% de las consultas financieras y de inversión, y que Gemini alucinó información financiera a tasas de hasta el 88–91% en algunas evaluaciones. Estas cifras no son motivo para abandonar los modelos de lenguaje. Son motivo para no permitir que uno de ellos cierre una tesis.
| Función / Dimensión | ChatGPT | Danelfin | Perplexity | Analista Fundamental de Acciones de Jenova |
|---|---|---|---|---|
| Resultado principal | Explicación en prosa | AI Score explicable y variables | Respuestas web con citas | Memorando fundamental basado en documentos regulatorios |
| Datos de mercado en tiempo real / verificados | Débil; limitado por fecha de corte | Creado para universos puntuados | Con citas, pero pueden estar desactualizadas | Documentos de la SEC, estimaciones y sentimiento |
| Verificación cruzada multimodelo | Manual, con varias cuentas | Sistema propietario único | Búsqueda multimodelo, un informe | Varios proveedores nativos más agentes especializados |
| Gestión de incertidumbre | Prosa segura por defecto | Puntuación más atribución de variables | Citas, menor exposición del riesgo residual | Casos rivales, desacuerdo entre modelos, memoria |
| Precio (a fecha de 2026) | Aproximadamente $20/mes de pago | No verificado en esta revisión | $20/mes Pro; nivel gratuito | Nivel gratuito; planes de pago desde $20/mes |
| Mejor para | Revisión conceptual, redacción de casos bajistas | Filtrado y timing de una lista conocida | Datos rápidos con fuentes | Investigación bursátil con verificaciones cruzadas |
ChatGPT
ChatGPT sigue siendo útil para traducir una sección de un 10-K, enumerar la estructura de un sector o forzar un caso bajista en lenguaje claro. Una comparación de cuatro modelos de 2026 lo sitúa en la categoría generalista, no como terminal de datos en tiempo real. Su limitación es estructural: seguirá redactando un puente de márgenes limpio a partir de la memoria. Así es exactamente como entra la sobreconfianza en una nota de investigación.
Danelfin
Danelfin es un producto distinto. Publica un AI Score en lugar de un chat. La empresa afirma que las acciones estadounidenses con puntuación 10/10 superaron al mercado con un alfa anualizado del 21.05% tras tres meses desde 2017, mientras que los valores 1/10 quedaron por debajo en un 33.28%, y que una estrategia AI Score obtuvo un 376% desde el 3 de enero de 2017 hasta el 9 de junio de 2025, frente al 166% del S&P 500. Las variables explicables son un auténtico antídoto frente a la puntuación de caja negra. La limitación es complementaria: una puntuación puede clasificar un universo sin someter a presión el riesgo contable, de segmento o de política específico que rompería esta posición.
Perplexity
Perplexity merece su lugar como capa de citas. La comparación de 2026 de Helm Terminal indica que lidera en datos en tiempo real con citas y funciones financieras, mientras que Claude lidera en síntesis profunda de documentos regulatorios. La limitación es la que ya señaló su CEO: una cita solo es tan actual como la página a la que apunta. Contrastar Perplexity con un flujo de trabajo nativo de documentos regulatorios es más valioso que tomar el número de citas como prueba.
Analista Fundamental de Acciones de Jenova
El Analista Fundamental de Acciones de Jenova está diseñado como especialista en renta variable: resultados, valoración relativa, análisis de modelo de negocio y datos en tiempo real de documentos regulatorios, estimaciones y sentimiento. En la plataforma Jenova puede volver a ejecutarse con modelos de OpenAI, Anthropic, Google, DeepSeek y xAI, y puede trabajar junto a otros especialistas en vez de pretender ser todos ellos. La memoria persistente mantiene sobre la mesa el último desacuerdo.
Aquí importan las limitaciones honestas. Jenova no publica una puntuación compuesta de largo plazo comparable al historial de Danelfin entre 2017 y 2025. Las ejecuciones multimodelo consumen más uso que una única pasada. Las respuestas conflictivas aumentan la carga cognitiva, y el usuario todavía tiene que abrir el 10-K. Son costes reales. También son los costes de no confundir fluidez con diligencia.
¿Cómo cambia la orquestación multiagente la investigación fundamental en renta variable?
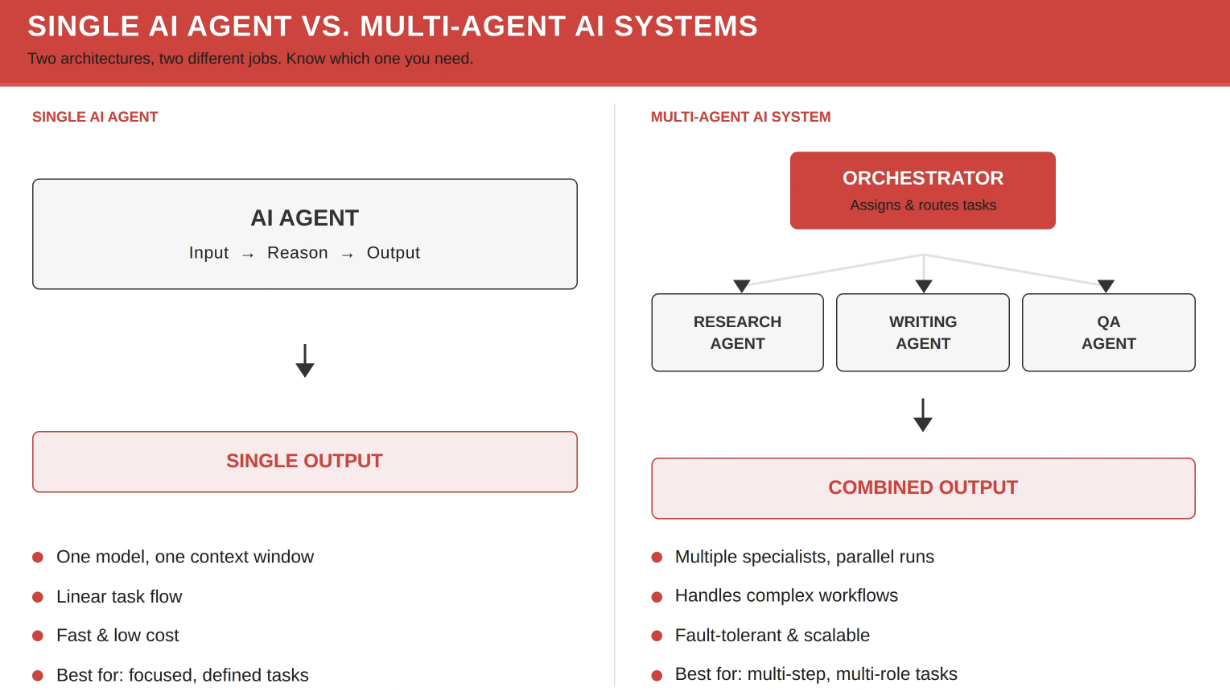
La orquestación transforma el trabajo de «preguntar a un analista» en «formar una pequeña mesa y conciliar el expediente». Un único agente sigue una ruta lineal: entrada, razonamiento y salida. Es rápido, barato y apropiado cuando la pregunta es limitada. Una estructura multiagente añade un orquestador que asigna trabajo a especialistas —investigación, redacción y revisión de calidad— y devuelve un producto combinado. La arquitectura es más lenta y más cara. También es la forma de evitar que un error elocuente se convierta en todo el memorando.
En el trabajo de renta variable, la división análoga no es «investigación / redacción / QA» en abstracto. Es:
- Fundamental: calidad de los beneficios, economía unitaria, valoración y asignación de capital
- Técnico: estructura, volumen, momentum y niveles de invalidación
- Macro: política, tipos y régimen entre activos
- Cartera: tamaño, correlación, caída máxima y si la idea encaja en esta cartera
El Analista Fundamental de Acciones de Jenova cubre el primer puesto. Combinarlo con el Analista Técnico de Acciones y el Estratega Macro es la versión práctica del QA multiagente. Un modelo al que le gusta la historia, otro que dice que la estructura técnica está rota y otro que señala que la trayectoria de tipos destruye el múltiplo no representan una consulta fallida. Representan una reunión completa de riesgos.
La evidencia sobre conjuntos fuera de los chatbots de renta variable apunta en la misma dirección. Un estudio de arXiv de 2025 sobre conjuntos de LLM con datos de la Encuesta de Pronosticadores Profesionales concluyó que una combinación de LLM superó al promedio simple en varios indicadores de corto plazo y siguió siendo más útil cuando el desacuerdo entre expertos era elevado. El mecanismo no fue magia. El conjunto redujo el peso de expertos recientemente inexactos, ajustó por revisiones rezagadas y se negó a tratar cada voz como equivalente. Eso es lo opuesto a pedir a un chatbot un precio objetivo y detenerse ahí.
El lenguaje de FINRA sobre modelos de caja negra y explicabilidad es relevante incluso para flujos de trabajo minoristas. Si no puedes explicar por qué el caso alcista sobrevivió al contacto con un segundo modelo y un segundo rol, no tienes un proceso de inversión. Tienes una transcripción.
¿Pueden los agentes técnicos, macroeconómicos y de cartera detectar lo que un único modelo pasa por alto?
Sí. Detectan errores de categoría: los fallos que un modelo centrado solo en fundamentales tiene pocas probabilidades estructurales de advertir. Un modelo de lenguaje que acaba de redactar una narrativa impecable de crecimiento sostenido rara vez señalará por iniciativa propia que la acción está extendida, que el sector es una apuesta pura a la duración o que la posición duplica un factor que ya posees.
Errores habituales por puesto:
- Puesto técnico. El modelo fundamental puede tener razón sobre el valor y adelantarse un año. La estructura de precios, las rupturas fallidas y las divergencias de volumen no son notas al pie. Son timing e invalidación. El Analista Técnico de Acciones está diseñado en torno a esas preguntas: estructura de mercado, momentum y riesgo definido.
- Puesto macro. Un DCF a nivel de acción que ignora el régimen de política es una hoja de cálculo con una hipótesis de tipos oculta. El Estratega Macro está diseñado para la síntesis entre activos y el análisis de políticas, donde muchas historias «idiosincráticas» se rompen en realidad.
- Puesto de cartera. Una gran idea de forma aislada puede ser una mala incorporación a la cartera. La deriva, el estrés y la correlación viven en la capa de cartera, que es la función del Estratega de Gestión de Carteras de Jenova.
Aquí es también donde las plataformas de puntuación única y los modelos de chat únicos comparten un punto ciego. La puntuación de Danelfin puede ser transparente sobre las variables detrás de una clasificación y aun así no decir nada sobre si tu cartera ya está expuesta al mismo factor. ChatGPT puede enumerar riesgos en abstracto y aun así no saber que ya posees tres empresas de software con la misma sensibilidad a los tipos. La revisión multirrol es la forma en que estos errores salen a la superficie.
La limitación es la correlación de visión del mundo. Si todos los agentes reciben prompts alcistas o todos los modelos se alimentan del mismo artículo secundario de un blog, tienes teatro. La diversidad de roles solo funciona cuando se permite al agente técnico descartar la operación, al agente macroeconómico reajustar el múltiplo y al agente de cartera reducir el tamaño a una posición testimonial.
¿Cómo se ejecuta una verificación cruzada multimodelo de una tesis sobre una acción?
Ejecuta el proceso como un expediente de cuatro fases, no como un chat más largo. El objetivo es generar desacuerdo de forma deliberada y decidir después qué evidencia lo resolvería.
Fase 1 — Fundamenta los hechos. Pide al Analista Fundamental de Acciones solo una instantánea con fuentes: los dos últimos periodos reportados, guidance, mezcla de segmentos, deuda neta, recompras y los múltiplos de valoración que realmente correspondan al negocio. Prohíbe los precios objetivo en esta fase.
«Utilizando el 10-K, el 10-Q y las dos últimas llamadas de resultados de [TICKER], extrae los ingresos por segmento, el margen bruto y operativo, FCF, deuda neta y número de acciones diluidas. Cita el documento o la llamada para cada cifra. Si no puedes obtener una fuente para un número, escribe Sin verificar.»
Fase 2 — Cambia el modelo, no la pregunta. Vuelve a ejecutar la misma extracción con un segundo proveedor. Las diferencias materiales en una cifra reportada no son «estilo». Son un evento de integridad de datos. Comprueba tú mismo el documento antes de la Fase 3.
Fase 3 — Incorpora los otros puestos. Envía el mismo ticker al Analista Técnico de Acciones para los niveles de invalidación y al Estratega Macro para la hipótesis de tipos, FX o materias primas oculta en el múltiplo.
«Ignora el memorando fundamental alcista. Identifica el nivel de precio y el régimen macroeconómico que harían que esta configuración no merezca mantenerse en cartera, incluso si la tesis termina siendo correcta.»
Fase 4 — Fuerza un disenso por escrito. Pide a cualquier modelo que defienda el lado opuesto con la misma extensión y el mismo nivel de fuentes. La nota de Lucid.now sobre finanzas conductuales señala el patrón humano habitual: sobreestimar la capacidad de previsión, negociar con demasiada frecuencia y concentrarse en una historia favorita. Un disenso obligatorio es la forma de interrumpir ese patrón cuando el «analista» también es un modelo.
Con ChatGPT o Claude únicamente, puedes aproximar las Fases 2 y 4 abriendo un segundo producto y pegando el mismo extracto con fuentes. No puedes aproximar la obtención de documentos regulatorios en tiempo real ni la memoria persistente durante semanas a menos que la herramienta realmente las tenga. En Danelfin, la Fase 1 está parcialmente automatizada mediante la puntuación y la lista de variables; las Fases 3 y 4 siguen necesitando una superficie de investigación independiente.
Los precios de Jenova se basan en uso entre niveles: un plan gratuito con uso limitado y, posteriormente, $20, $50, $100, $200, $500 y $1,000 al mes a medida que aumentan las asignaciones. Una verificación de cuatro fases cuesta más que un chat. Para cualquier posición suficientemente grande como para importar, ese es el error menos costoso.
¿Qué dicen los profesionales del mercado sobre la sobreconfianza de la AI en la investigación?
Los profesionales que trabajan diariamente con estas herramientas tienden a tratar la certeza de un único modelo como un fallo de proceso, no como una característica de modelos «mejores».
«El error más caro que vemos no es una cifra errónea. Es una cifra que suena correcta y nunca se contrastó con un segundo modelo. Cuando tres proveedores coinciden en un puente de márgenes que ninguno puede cuadrar con el 10-Q, el acuerdo es la señal de alerta. Preferimos entregar un memorando con dos rangos conflictivos y una lista de elementos Sin verificar antes que un único precio objetivo sin ningún residuo.»
«Usar varios modelos no es automáticamente más seguro. Si haces a GPT, Claude y Gemini la misma pregunta mal planteada, a menudo obtendrás la misma respuesta deficiente con adjetivos distintos. La diversidad debe diseñarse: roles diferentes, extracciones de datos diferentes y una instrucción permanente de disentir. De lo contrario, has comprado sobreconfianza correlacionada por tres veces el coste de tokens.»
«En la mesa, el desacuerdo es cómo decidimos qué leer después. Si fundamental y macro entran en conflicto, vamos a la hipótesis de tipos. Si fundamental y técnico entran en conflicto, vamos al timing y al tamaño. Si todos los puestos coinciden demasiado rápido, asumimos que el expediente es pobre. Ese hábito es anterior a los LLM. Los modelos solo hacen que resulte más fácil omitirlo.»
— Equipo de Producto de Jenova, diseño y evaluación de agentes de renta variable, trabajo plurianual en flujos de investigación multimodelo
Esta postura se alinea con el énfasis de FINRA en pruebas, planes de contingencia y supervisión multifuncional antes de que las herramientas de AI influyan en el asesoramiento de inversión. También coincide con el resultado de las previsiones de conjunto: las combinaciones ayudan más cuando las entradas discrepan y alguien dispone de una regla para ponderarlas.
¿Cuándo sigue siendo mejor elegir un análisis con un único modelo?
El análisis con un único modelo sigue siendo la mejor elección cuando la tarea está delimitada, el coste del error es bajo y la velocidad importa más que el riesgo residual. La verificación cruzada multimodelo es un sistema de control. No necesitas un sistema de control para definir ROIC o resumir una empresa en dos párrafos.
Un único modelo suele ser suficiente cuando:
- Estás aprendiendo un concepto, no asignando tamaño a una posición
- Ya tienes abierto el documento regulatorio y solo necesitas un compañero de lectura
- Estás evaluando formulaciones, no calculando una valoración
- Necesitas un esquema inicial antes de un flujo de trabajo más lento y con fuentes
- Las llamadas adicionales al modelo no cambiarían la decisión
La guía de Openbook de 2026 establece la misma separación por categorías: los chatbots generales son puntos de partida, no motores primarios de investigación. La puntuación de Danelfin es un sistema único, pero especializado; utilizarla como filtro y detenerse ahí sigue siendo una decisión de un único modelo si nadie cuestiona el valor. Perplexity es la pasada única adecuada cuando necesitas una cadena de citas en minutos y verificarás tú mismo la fuente primaria.
El modo de fallo consiste en usar la pasada barata para la decisión cara. La sobreconfianza no la causa la AI. La causa terminar el proceso en la primera respuesta coherente. El resumen de Sidley de 2025 sobre las directrices de reguladores financieros estadounidenses subraya que las empresas ya deben tratar la AI como una actividad supervisada, no como un oráculo. Los inversores privados deberían copiar el espíritu de esa norma incluso cuando ningún examinador vaya a preguntarlo.
Una regla de decisión compacta: si equivocarte cambiaría el tamaño de la posición, utiliza al menos dos modelos y dos roles. Si equivocarte solo cambiaría una frase de tus notas, basta con un buen modelo.
¿Cómo deberían la regulación y el riesgo de modelo dar forma a tu flujo de trabajo de investigación con AI?
Deberían obligarte a documentar lo que el modelo no vio, no solo lo que dijo. El análisis de FINRA sobre AI está escrito para intermediarios bursátiles, pero los temas de control son transferibles. La gestión de riesgo de modelo, el gobierno de datos, la explicabilidad y la supervisión existen porque las herramientas que parecen autónomas fallan de formas correlacionadas.
Para un proceso individual de investigación, los controles transferibles son simples:
- Conserva la fuente primaria en el expediente. Si el modelo no puede señalar el 10-K, 10-Q, 8-K o la transcripción de una llamada, la afirmación es un borrador.
- Registra el desacuerdo. Un registro de una línea —«Claude prevé compresión, Gemini no; página 37 del 10-Q sin resolver»— es más útil que un caso alcista regenerado.
- Separa asesoramiento de explicación. Los chatbots no son un motor de idoneidad. FINRA señala que las herramientas de AI que generan recomendaciones están sujetas a Regulation BI y a la Norma 2111 para las empresas miembro. Los usuarios minoristas deben tratar el resultado del modelo como análisis, no como recomendación personalizada.
- Asume un sesgo compartido hasta que se demuestre lo contrario. El resultado de HBS sobre sesgo extranjero es un ejemplo. Dos modelos pueden pasar por alto el mismo hecho no estadounidense. Un documento local, una fuente en un segundo idioma o un especialista humano constituyen la diversificación real.
- Prefiere herramientas que puedan decir Sin verificar. La precisión falsa es la señal reveladora. Un sistema que siempre completa el párrafo no es «más analítico». Está menos supervisado.
Nada de esto requiere un presupuesto institucional. Los terminales de clase Bloomberg siguen perteneciendo a otro mundo de costes: Openbook cita precios típicos de Bloomberg superiores a $25,000 al año. El control que realmente reduce la sobreconfianza es más barato: un segundo modelo, un segundo puesto y una regla según la cual el consenso sin fuentes no aumenta el tamaño de la posición.
El análisis de acciones con un único modelo es una herramienta de borrador. La verificación cruzada multimodelo y multirrol es una herramienta para detectar puntos ciegos. Utiliza la primera para iniciar el expediente. Utiliza la segunda para decidir si el expediente está terminado.
Referencias
- Openbook Analytics — Mejores herramientas de AI para el análisis de acciones en 2026
- Investopedia — Finanzas conductuales: sesgos, emociones y comportamiento del inversor
- Preprints.org — Sobreconfianza y sesgo de confirmación en el trading
- ResearchGate — Sobreconfianza del inversor en la era de la AI: toma de decisiones humana frente a algorítmica
- SSRN — Comportamiento del inversor en los mercados de acciones: la aparición de la AI y la sobreconfianza algorítmica
- Investor.gov — Inteligencia artificial (AI) y fraude de inversión: alerta para inversores
- FINRA — Inteligencia artificial en la industria de valores: desafíos clave y consideraciones regulatorias
- Harvard Business School — Cuando los LLM salen al extranjero: sesgo extranjero en el análisis financiero con AI
- Danelfin — Selector de acciones con AI y metodología AI Score
- AI Business Weekly — Guía de precios de AI 2026: ChatGPT, Claude y Gemini
- Perplexity — Precios para particulares y empresas
- Helm Terminal — ChatGPT frente a Claude, Gemini y Perplexity para investigación de acciones
- arXiv — ¿Pueden los LLM mejorar la combinación de previsiones de expertos?
- Lucid.now — AI en las decisiones financieras: perspectivas conductuales
- Sidley Austin — Inteligencia artificial: directrices de reguladores estadounidenses de valores y materias primas