Generador de voces de personajes: voces AI para juegos, historias y cine
2026-09-06
Jenova te ayuda a diseñar personajes distintivos, escribir diálogos que se puedan interpretar y preparar prompts listos para producción para cualquier generador de voces de personajes. En septiembre de 2026, los sistemas de voz con AI pueden copiar un timbre en segundos, pero la mayoría de los resultados sigue sonando genérica porque la escritura que hay detrás no tiene personalidad. La interpretación de voz en estudio continúa siendo lenta y costosa para los equipos indie, mientras que una pasada superficial de conversión de texto a voz aplana todos los roles hasta dejarlos con la misma cadencia.
- ✅ Personalidades coherentes con el personaje a lo largo de historias extensas y ciclos de juego
- ✅ Diálogos escritos para hablarse, no solo para leerse en una página
- ✅ Prompts estructurados para modelos de voz modernos y localización
- ✅ Compatibilidad con guiones, cómics, música y roleplay en un único flujo creativo
Para entender por qué esto importa, observa lo que los creadores realmente necesitan de un generador de voces de personajes: no otro control deslizante llamado «feliz», sino una voz que pertenezca a alguien. El cuello de botella rara vez es el motor de renderizado. Es el trabajo de personaje, la interpretación de las líneas y la frontera ética entre una actuación original y una imitación no autorizada.
Respuesta rápida: ¿qué es un generador de voces de personajes?
Un generador de voces de personajes es un sistema de AI que produce voces diferenciadas y específicas para cada personalidad, de modo que cada papel suene como una persona distinta. Los creadores lo usan para juegos, historias, vídeos y accesibilidad, pero la voz solo funciona si el personaje ya está definido.
Capacidades clave:
- Timbre, ritmo y rango emocional distintos para cada personaje
- Guiones y prompts que resisten la conversión de texto a voz sin sonar como un GPS
- Roleplay con una coherencia de personaje consolidada antes de generar nada
- Flujos de trabajo de personajes originales que evitan clonar a personas reales sin consentimiento
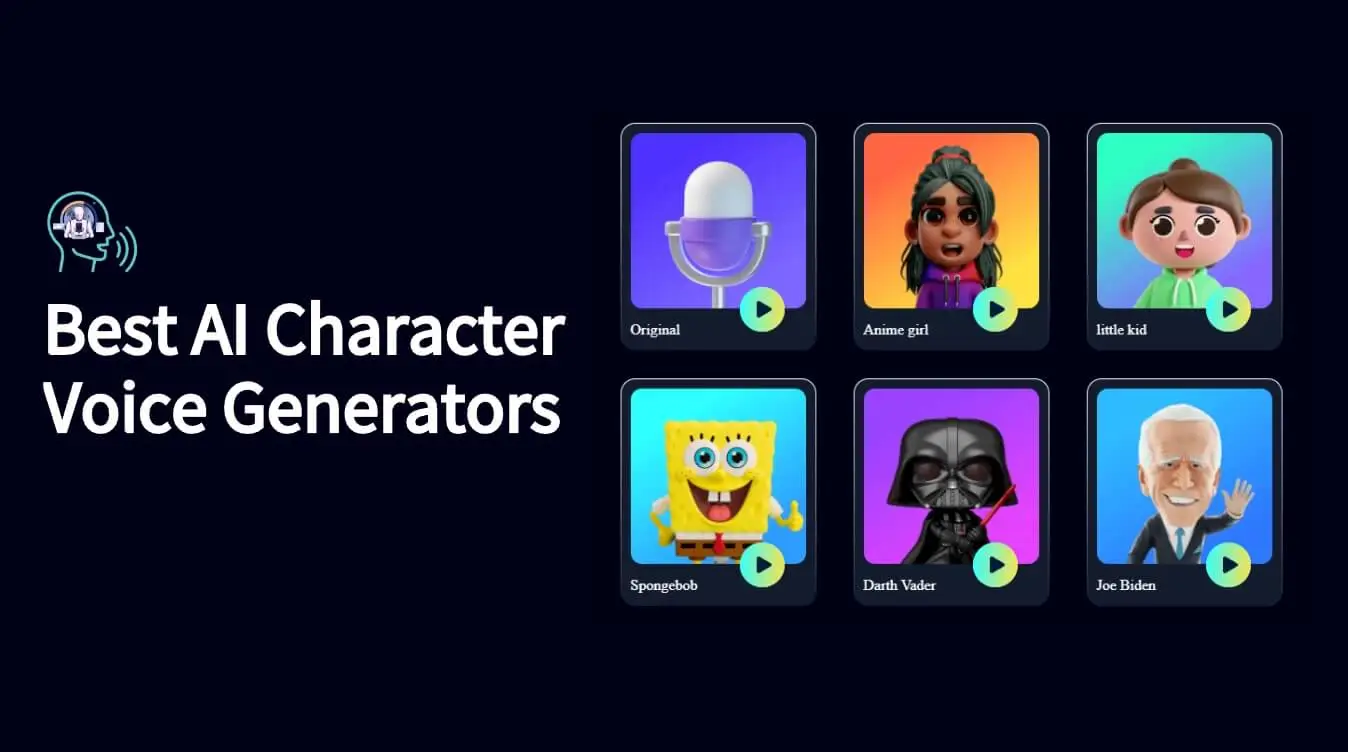
Por qué la mayoría de los generadores de voces de personajes aún suenan genéricos
La demanda de voz sintética ya no es experimental. Las empresas de investigación ahora siguen la generación de voz AI como un mercado propio, no como una función secundaria de los chatbots.
USD 6,4 mil millones — Tamaño del mercado global de generadores de voz AI en 2025, con crecimiento previsto desde USD 8,36 mil millones en 2026
USD 19,09 mil millones — Mercado de reconocimiento de habla y voz en 2025, previsto en USD 23,70 mil millones en 2026
Ese gasto está llegando a los juegos, la localización, el vídeo social y el audio para clientes. El uso de Voice AI creció 9 veces en 2025, y el 84 % de las organizaciones encuestadas planeaba aumentar sus presupuestos de tecnología de voz. Pero comprar un motor de renderizado no compra una actuación. Acceder a una voz que el público recuerde sigue siendo frustrantemente difícil:
- Cada personaje hereda el mismo ritmo, patrón de respiración y tono de «asistente servicial»
- Las sesiones de estudio son demasiado lentas y caras para las largas colas de NPC, repartos de YouTube y doblajes semanales de webtoons
- Las líneas escritas para la página se desmoronan al hablarse: se acumulan las cláusulas, mueren los chistes y se destrozan los nombres
- Los clones de celebridades y políticos generan riesgos legales y de confianza, incluso cuando la interfaz los pone a un clic de distancia
- Los equipos alternan entre un escritor, un ingeniero de prompts, un compositor y una herramienta de voz sin una biblia de personaje compartida
La misma voz, con otro nombre
Un generador de voces de personajes puede cambiar el tono y aun así fracasar en la identidad. Los oyentes perciben la actitud, no solo la frecuencia: cómo un villano retrasa una consonante, cómo un niño precipita un chiste o cómo una capitana cansada baja el volumen al final de un informe. La investigación sobre habla consciente de la emoción y específica de personajes procedente de cómics y generación de voz multicarácter guiada por texto vuelve siempre al mismo hallazgo: el modelo necesita contexto del personaje, no solo un objetivo de forma de onda. Sin una personalidad escrita, obtienes disfraz, no actuación.
La barrera de costes para equipos indie y medianos
Los protagonistas humanos siguen llevando las escenas emocionalmente complejas. El problema de producción es la cola larga: miles de saludos de NPC, variantes localizadas y pronunciaciones del nombre del jugador. El análisis del sector sobre la voz AI ética en juegos describe un reparto híbrido entre humanos y AI —actores para las escenas principales, síntesis para el volumen— y señala que los equipos indie ahora pueden localizar a decenas de idiomas en semanas en lugar de meses. Eso solo ayuda si las líneas de origen se pueden pronunciar y la ficha del personaje es estable. De lo contrario, pagas por multiplicar audio mediocre.
Guiones que nunca se pensaron para ser escuchados
La prosa novelística y el texto de interfaz se enfrentan a la boca. Las cláusulas anidadas, los acrónimos sin explicar y los nombres de fantasía impronunciables fuerzan al modelo a patrones de acentuación robóticos. Un generador de voces de personajes interpretará fielmente una mala línea. La solución está antes: frases más breves, grafías fonéticas, indicaciones escénicas emocionales y diálogos que un intérprete realmente pueda decir de un solo aliento.
Consentimiento, clonación y plataformas que invitan a problemas
Los sistemas que funcionan sin ejemplos previos pueden replicar un timbre en unos tres segundos. Esa velocidad es útil para réplicas con consentimiento y personajes originales. Es peligrosa cuando una biblioteca muestra figuras públicas o mascotas con copyright como preajustes. La FTC ha dejado claro que no existe una exención de AI respecto a la legislación vigente de protección al consumidor, y ha utilizado el Voice Cloning Challenge y una Impersonation Rule para combatir el audio engañoso. En los juegos, el Interactive Media Agreement de julio de 2025 se aprobó con un 95,04 % de apoyo e hizo innegociable el consentimiento escrito para la replicación de voz. Si tu proceso no puede demostrar el consentimiento, no generes la voz.
Esto es exactamente para lo que se creó Jenova: la inteligencia de personaje que rodea al generador, no un atajo para esquivar la ley.
La solución de Jenova
Un generador de voces de personajes convierte texto en audio. Jenova hace que ese texto merezca ser interpretado. Defines quién habla, cómo piensa, qué jamás diría y cómo debe caer una línea; después entregas un prompt y un guion limpios al modelo de voz que uses. Las plataformas de audio especializadas renderizan formas de onda; esta plataforma construye a la persona que hay detrás de la forma de onda.
| Enfoque tradicional | Jenova |
|---|---|
| Reservar un estudio, esperar las sesiones y regrabar cada ajuste | Fichas de personaje y borradores pronunciables en una sola sesión de trabajo |
| Una voz TTS con un nuevo nombre visible | Personalidad, dicción y pulsos emocionales escritos para cada papel |
| Clonar una voz famosa y esperar que nadie lo note | Personajes originales, réplicas con consentimiento y uso documentado |
| Escritor en una pestaña, notas de prompts en otra y compositor en una tercera | Agentes conectados para historia, prompts, cómics, música y entrega |
| Localización plana que ignora el humor y el ritmo | Líneas estructuradas para encajar en sílabas y adaptarse culturalmente |
Biblias de personaje antes de tocar el audio
Empieza por la identidad, no por un preajuste. El Name Generator produce nombres culturalmente coherentes y pronunciables, un filtro práctico que muchos procesos de voz omiten hasta que un modelo se atraganta con un grupo de consonantes. Combínalo con el Writing Assistant para fijar la dicción: nivel máximo de vocabulario, palabras prohibidas, bromas recurrentes y la metáfora a la que un personaje siempre recurre. Cuando existen esas restricciones, cualquier generador de voces de personajes tiene algo específico que interpretar.
Diálogo construido para la boca
El Film Screenwriter trata las líneas como comportamiento cronometrado: interrupción, silencio y subtexto. Ese oficio se transfiere directamente a frases de juego, drama vertical y cómics doblados. Obtienes acotaciones que un modelo de voz puede seguir, como «por lo bajo, luego más luminosa», en lugar de etiquetas vagas como «triste». Para la narración móvil serializada, el Microdrama Screenwriter mantiene los finales de suspense lo bastante cortos como para pronunciarlos sin quedarse sin aliento.
Ejemplo de indicación que puedes pegar en un generador:
“Léelo como la capitana Ilya Voss, de unos 50 años, con una voz grave y áspera desde el pecho. Nunca sube el volumen cuando se enfada: habla más despacio. Línea: «Trajiste el mapa. No trajiste el tiempo». Pausa después de mapa. Sin sonrisa.”
Prompts que sobreviven al contacto con un modelo
La mayoría de las «malas voces AI» son malas instrucciones. El Prompt Generator transforma una biblia de personaje en texto preparado para el modelo: notas de acento, edad, espacio de grabación, arco emocional y prompts negativos, como «sin cadencia de locutor, sin sonrisa en las vocales». Esa es la diferencia entre una ficha de biblioteca llamada «Anime Girl» y una persona que casualmente es animada.
Imagen, música y el resto de la escena
La voz es una capa. El Graphic Designer crea el rostro que el oído espera. Manga Creator, Comic Creator y Webtoon Creator producen arte secuencial cuyos movimientos labiales y ritmo de viñetas puedes musicalizar. El Music Composition Assistant y el Lyric Writer dan a los personajes motivos y líneas cantables para que la voz hablada y la canción pertenezcan al mismo mundo.
Mientras que las API de voz especializadas se concentran en renderizar audio, Jenova se especializa en la escritura, los prompts y la continuidad que determinan si alguien querrá escuchar ese audio una segunda vez.
Agentes de AI especializados para el trabajo de voces de personajes
Prueba Jenova gratis, sin tarjeta de crédito. Estos agentes cubren las tareas que se encuentran inmediatamente antes y después de un generador de voces de personajes.
Roleplay Game Master
Si necesitas escuchar a un personaje en el lenguaje antes de sintetizarlo, esta es la sala de ensayo. La memoria ilimitada mantiene estable la dicción, los secretos y las relaciones entre sesiones, el equivalente textual de un modelo de voz consolidado.
- Pone a prueba las frases recurrentes hasta que suenan inevitables
- Mantiene separadas las voces del grupo y los NPC en campañas largas
- Produce líneas dentro del personaje que puedes incorporar directamente a un generador
Film Screenwriter
Úsalo cuando la voz tenga que sostener la trama, no solo aportar sabor. La estructura, los objetivos de escena y el oficio del diálogo evitan que las actuaciones se conviertan en exposición con un acento gracioso.
- Pulsos y conflictos que justifican los cambios emocionales en el audio
- Líneas cortas fáciles de regrabar para juegos y anuncios
- Desarrollo de personaje que sobrevive a un doblaje de doce episodios
Prompt Generator
Los modelos de voz son tan buenos como la indicación que reciben. Este agente escribe prompts para sistemas de texto, imagen, música y vídeo, incluidos los modelos de voz por los que ya pagas.
- Bloques de prompts coherentes para cada personaje, de modo que los episodios coincidan
- Descriptores de emoción y espacio que los modelos realmente siguen
- Perfeccionamiento iterativo cuando una toma vuelve demasiado brillante o demasiado lenta
Writing Assistant
El caballo de batalla para biblias, narración y reescrituras de «esto debería sonar como ellos». Se adapta al formato y al público para que una descarga de trasfondo y un insulto de taberna no compartan el mismo ritmo de frase.
- Revisión editorial de pronunciabilidad y nivel de lectura
- Correspondencia de tono entre texto de misiones, tráilers y notas de actualización
- Colaboración cuando ya tienes un borrador que casi funciona
Music Composition Assistant
Un generador de voces de personajes se ocupa del habla. Este agente se ocupa de la base musical que la acompaña: motivos, armonía y notas de arreglo que puedes entregar a una DAW o a otro modelo.
- Leitmotivs vinculados a papeles específicos
- Mapas de tempo que dejan espacio para el diálogo
- Orientación consciente de la teoría para que el tema de un villano no choque con un registro vocal
Public Speaking Coach
Cuando tú eres la persona que interpreta, o cuando necesitas dirigir a una, este agente trabaja la entrega, la ansiedad y el público. Es la contraparte humana del habla sintética: respiración, pausa y énfasis que después puedes codificar en un prompt.
- Marcas de ritmo y acentuación que se transfieren a etiquetas TTS
- Ensayo de preguntas y respuestas y lecturas en directo para transmisiones híbridas
- Notas sobre lo que una línea provoca en quien escucha, no solo sobre cómo suena
Cómo funciona realmente un flujo de trabajo con un generador de voces de personajes
No necesitas un estudio primero. Necesitas una persona en la página, una línea que pueda decirse y un prompt que no se contradiga.
Paso 1: define a la persona, no el preajuste
Escribe edad, estatus, cuerpo y una regla que nunca rompa. Genera un nombre pronunciable y después una biblia de 150 palabras. Si dos personajes pueden intercambiar líneas sin que nadie lo note, todavía no tienes dos voces.
“Crea una biblia de personaje para Ryn Calder, 17 años, mensajera fluvial, siempre cortés con la carga y grosera con los capitanes. Frases cortas. Sin jerga surgida después de que ardiera su aldea. Dame tres líneas que nunca diría.”
Paso 2: escribe las líneas para respirar, no para la página
Lleva la escena al Writing Assistant o al Film Screenwriter. Elimina las cláusulas anidadas. Escribe los nombres difíciles fonéticamente entre corchetes. Añade una nota de interpretación que el modelo pueda ejecutar.
“Reescribe este párrafo de trasfondo como seis líneas habladas por Ryn, con un máximo de doce palabras cada una y una pausa marcada antes de la última línea.”
Paso 3: convierte la biblia en un prompt para el generador
Entrega las mismas restricciones al Prompt Generator. Especifica el espacio de grabación, la distancia al micrófono, la emoción en una escala de 1–5 y qué debe evitar. Guarda un bloque por personaje para que el episodio cuatro no se desvíe.
“Convierte la biblia de Ryn en un prompt para modelo de voz: contralto adolescente, seca, reverberación de almacén interior, ritmo 1.05x, sin sonrisa, sin final de locutor. Incluye prompt negativo.”
Paso 4: haz coincidir rostro, viñeta y música
Incorpora la misma biblia a los agentes visuales y musicales para que la imagen y la base concuerden con la voz. Un rostro de dibujo animado brillante sobre una interpretación fúnebre es como el público decide que el audio es falso, incluso cuando el modelo es preciso.
Paso 5: ensaya en el teléfono y luego renderiza
Jenova funciona con paridad completa de funciones en web, iOS y Android. Lee la línea en voz alta durante el trayecto, marca el tropiezo, reescribe y solo entonces pégala en tu generador de voces de personajes. La toma adicional más barata es la que nunca tuviste que grabar.
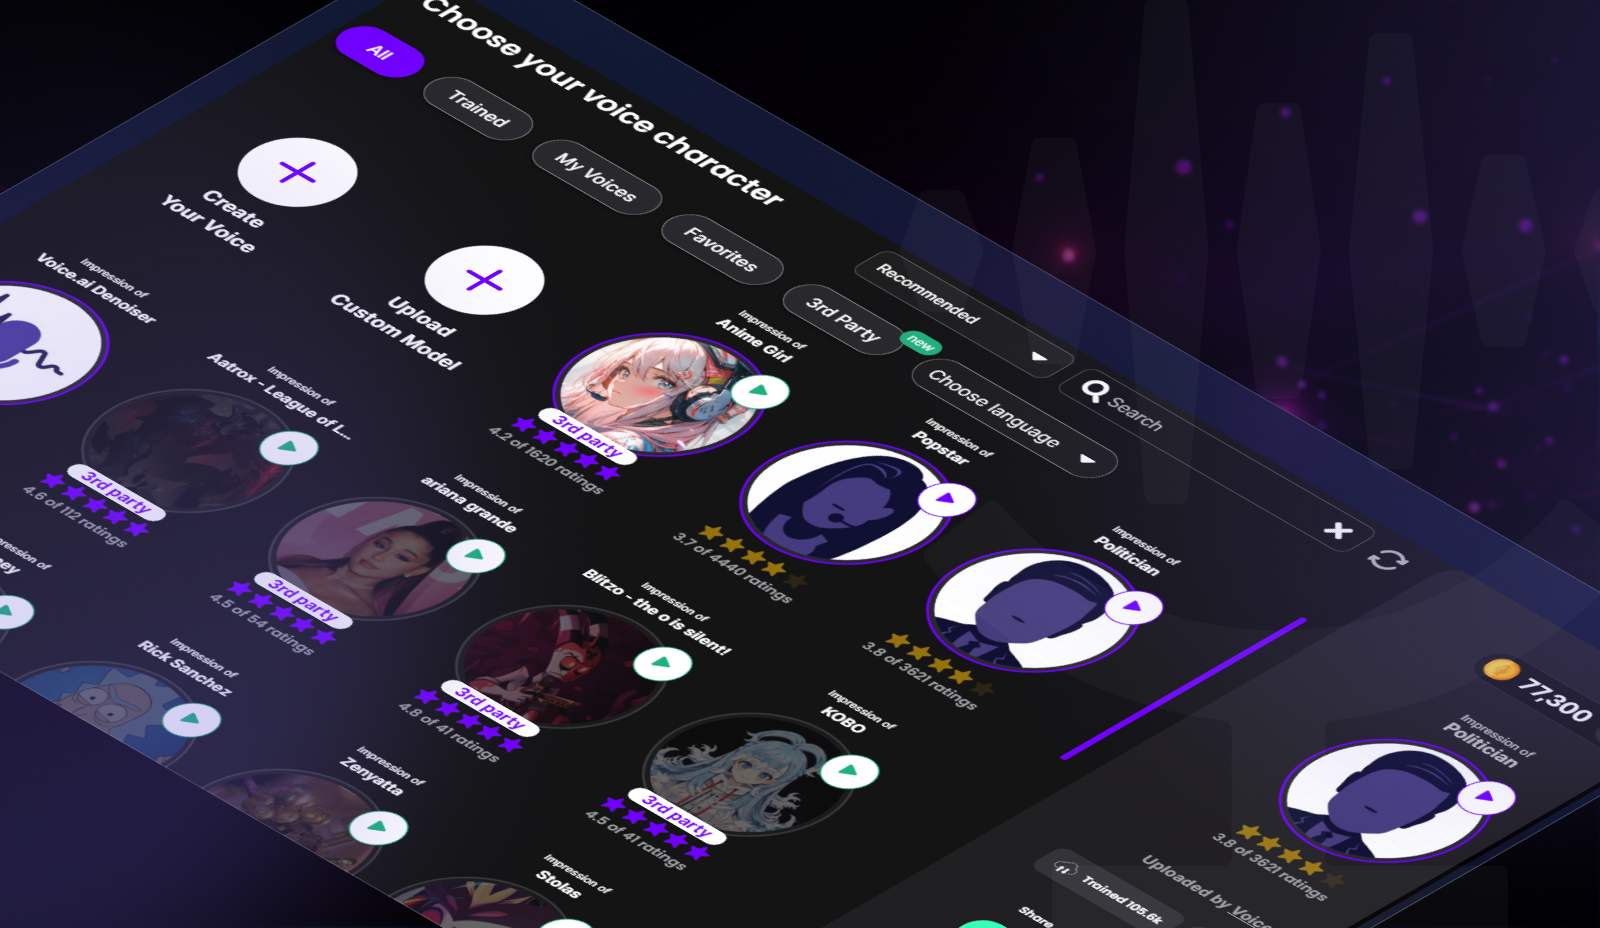
Resultados y casos de uso
🎮 NPC de juegos indie sin presupuesto de estudio
Escenario: Un RPG de 12 horas necesita 4.000 líneas no principales, además de la pronunciación del nombre del jugador.
Enfoque tradicional: Sesiones sindicalizadas para los protagonistas, silencio o frases recicladas para todos los demás y localización programada para «algún día».
Jenova: Las escenas principales siguen siendo humanas. La cola larga recibe biblias, líneas pronunciables y prompts estables para que tu generador de voces de personajes pueda cubrir NPC de bienvenida, tenderos y NPC de rumores sin clonar a una celebridad.
- Fichas de personaje que evitan que un herrero suene como un mago
- Líneas breves preparadas para localización
- Bloques de prompts que puedes versionar como código
🎬 Doblaje de webtoons y cómics
Escenario: Una serie vertical semanal quiere episodios de audio sin esperar a un reparto completo.
Enfoque tradicional: Dobles de aficionados con micrófonos dispares o un único narrador que interpreta todos los papeles.
Jenova: Webtoon Creator y Comic Creator mantienen la continuidad visual mientras el guionista separa las voces por viñeta. Cada papel recibe su propio prompt para que el generador no tenga que adivinar.
- Líneas cronometradas por viñeta en lugar de bloques de prosa
- Repartos diferenciados para protagonistas y multitud
- Indicaciones musicales que dejan espacio para el habla
📱 Práctica de idiomas que suena a alguien
Escenario: Vas de camino y quieres conversación, no una voz de libro de texto.
Enfoque tradicional: Ejercicios de una App con un único tutor sintético y sin memoria de tus errores.
Jenova: Learn English Through Roleplay te sitúa en una escena con un personaje coherente. Después puedes dar voz a esas mismas líneas en un generador para practicar escucha, siempre como personajes originales y no como imitaciones.
- Memoria que evita que el barista se reinicie en cada sesión
- Modismos dentro de situaciones que realmente volverás a usar
- Sesiones móviles que caben en un trayecto en tren
🎙️ Repartos para pódcasts y redes sociales de marca
Escenario: Un canal de producto necesita cada semana una persona anfitriona, un acompañante escéptico y un aviso legal leído de forma directa.
Enfoque tradicional: La misma voz de la persona fundadora para cada segmento o un profesional independiente que no puede trabajar los jueves.
Jenova: El Social Media Content Generator redacta guiones nativos para cada plataforma; los agentes de escritura y prompts evitan que la persona anfitriona y su acompañante se fusionen. Renderizas en tu herramienta de voz con licencia, no con un clon no autorizado de una figura pública.
- Secciones recurrentes con dicción estable
- Avisos legales escritos para hablarse, no para leerse por encima
- Ganchos adaptados a Shorts, Reels y episodios completos
Preguntas frecuentes
¿Qué es un generador de voces de personajes?
Un generador de voces de personajes es software que transforma texto en habla con una identidad elegida —edad, tono, acento y emoción— para que los distintos papeles no compartan una sola cadencia. El modelo de audio proporciona el timbre. La escritura del personaje, la dirección escénica y los prompts proporcionan a la persona. Las herramientas de Jenova se sitúan en ese lado de la escritura: biblias, diálogo e instrucciones listas para el modelo que puedes pegar en cualquier sistema de voz con licencia.
¿Los generadores de voces de personajes son gratuitos?
Muchas aplicaciones de voz ofrecen un nivel gratuito limitado y cobran por clips más largos, derechos comerciales o voces clonadas. Jenova tiene un plan gratuito con funciones principales y niveles de pago si necesitas más uso. Presupuesta dos costes: el trabajo creativo —guiones, prompts y continuidad— y el motor de renderizado —minutos de audio y licencias de voz—. El consentimiento y las condiciones comerciales de las voces clonadas son independientes del precio de suscripción; lee ambos antes de publicar.
¿Cómo hago que las voces de personajes AI suenen únicas?
Da a cada papel una regla, un límite de vocabulario y un hábito físico; después escribe líneas que no podrían intercambiarse. Incluye esas restricciones en el prompt siempre: espacio, ritmo, emoción y un prompt negativo contra la cadencia de locutor. El Prompt Generator está diseñado para esa indicación. Si dos personajes siguen sonando idénticos después de un buen prompt, el problema está en la biblia, no en el control deslizante.
¿Es legal clonar la voz de una persona real?
No como norma, ni como un preajuste humorístico. Necesitas un consentimiento claro y registrado para el uso que realmente pretendes darle, además de las normas de derechos de imagen y copyright aplicables en tu jurisdicción. La FTC trata la clonación engañosa de voz AI como un problema de protección al consumidor, no como una novedad. Los acuerdos de juegos y entretenimiento exigen cada vez más consentimiento escrito e informes de uso. Crea personajes originales o réplicas con licencia. No extraigas la voz de un político, actor o cantante porque un panel lo haya hecho fácil.
¿Puedo ejecutar este flujo de trabajo en mi teléfono?
Sí. Jenova está diseñado para web, iOS y Android con las mismas capacidades principales, incluida la conversión de voz a texto cuando prefieres dictar una nota en lugar de escribir durante un trayecto. Redacta una línea en el tren, ajústala, genera el prompt y después renderiza en tu herramienta de voz de escritorio si allí es donde se encuentran tus modelos con licencia.
¿En qué se diferencia de la conversión de texto a voz común?
La TTS común lee palabras. Un generador de voces de personajes intenta interpretar un papel. La interpretación sigue dependiendo de la escritura: identidad, conflicto y dirección. Jenova no reemplaza tu motor de audio con licencia. Produce el trabajo de personaje que ese motor necesita mediante agentes como Roleplay Game Master y Film Screenwriter, para que no pagues por escuchar al mismo becario servicial con seis disfraces.
Conclusión
Un generador de voces de personajes solo es tan bueno como la persona que le pides que sea. Los mercados de voz AI crecen rápidamente, los modelos pueden fijar un timbre en segundos y los reguladores ya han rechazado la idea de que «lo hizo la AI» sea una defensa. El camino práctico es más concreto y mejor: personajes originales, réplicas con consentimiento, escritura pronunciable y prompts que puedas reproducir.
Diseña el papel, escribe la respiración y después genera la toma. Empieza con Jenova y luego lleva esas líneas a la herramienta de voz en la que ya confías.
Explora más de este mismo flujo de trabajo con Roleplay Game Master, Writing Assistant y Prompt Generator. Cuando el personaje está claro, la voz tiene adónde ir.
Para desarrolladores: Cada agente de este artículo está disponible mediante programación a través de la Jenova API: integra biblias de personaje, generación de diálogo y prompts para modelos de voz en tu aplicación con una única integración. Documentación completa →