¿Son más fiables los asistentes especializados de investigación con AI que los chatbots?
2026-08-22
¿Cómo separan la trazabilidad y la fundamentación a la AI de investigación de los chatbots?
Los asistentes especializados de investigación académica son más fiables que los chatbots de AI generales para la trazabilidad de citas y la extracción de evidencia porque recuperan información de índices académicos, vinculan las afirmaciones con pasajes identificables y exponen el contexto de respaldo o contradicción. Los chatbots generales generan lenguaje bibliográfico fluido a partir de patrones de entrenamiento, por lo que todavía inventan autores, títulos, DOI y hallazgos que no pueden rastrearse hasta una fuente.
La brecha de fiabilidad no tiene que ver con la calidad de la redacción. Tiene que ver con si una afirmación puede auditarse.
Factores clave que distinguen la asistencia de investigación citable de la prosa de los chatbots:
✅ Recuperación antes de la generación — las respuestas se elaboran a partir de artículos indexados, en lugar de basarse únicamente en la probabilidad del siguiente token ✅ Atribución a nivel de pasaje — cada hallazgo extraído apunta a una oración, tabla o sección, no solo al título de un artículo ✅ Visibilidad de contradicciones — se muestran trabajos posteriores que respaldan, cuestionan o solo mencionan una afirmación, en vez de aplanarlos en un único resumen ✅ Extracción estructurada — los métodos, las muestras, los resultados y las limitaciones se incorporan a campos comparables en lugar de presentarse como párrafos parafraseados ✅ Procedencia verificable por personas — cada resumen, cita y hallazgo extraído puede abrirse y contrastarse con la fuente original
Para comparar estas herramientas de forma útil en 2026, conviene tratar la fiabilidad de las citas como una propiedad de ingeniería, no como una promesa de marca. El resto de este artículo evalúa los chatbots y los asistentes de investigación según esa propiedad.
¿Por qué la fiabilidad de las citas se ha convertido en un problema de integridad de la investigación?
La fiabilidad de las citas se ha convertido en un problema de integridad de la investigación porque la AI generativa ya se utiliza a escala de publicación, mientras que los modelos generales todavía fabrican referencias que parecen lo bastante reales como para superar una revisión superficial. La adopción por parte de estudiantes e investigadores aumentó de forma marcada en 2025, y las citas fabricadas ya no son un error anecdótico. Están entrando en actas de congresos, manuscritos y grafos de citas.
La encuesta estudiantil de 2025 del Higher Education Policy Institute determinó que el uso de herramientas de AI generativa para evaluaciones aumentó del 53% al 88% en un año. Un informe relacionado sobre la misma encuesta indicó que el 92% de los estudiantes utiliza ahora AI de alguna forma, frente al 66% en 2024. Ese volumen importa porque una referencia falsa plausible es más difícil de detectar que una referencia inexistente.
Un análisis de 2026 en Energy Research & Social Science informó de que ChatGPT produjo 178 referencias para propuestas de investigación, 69 de las cuales carecían de DOI válidos. El mismo artículo citó una revisión de GPTZero de 4.841 artículos de NeurIPS 2025 que confirmó al menos 100 citas alucinadas en 53 artículos aceptados. La revisión por pares de múltiples expertos no las detectó.
El mecanismo ya está bien descrito. Una alucinación de AI es un resultado fluido que es falso o carece de fundamento. Las guías de bibliotecas universitarias señalan que los chatbots pueden inventar una cita completa: autor, título y revista. Science ha argumentado que los modelos están entrenados para producir una respuesta incluso cuando no saben cuál es. Cuando la instrucción es «cita fuentes», el modelo busca patrones de estilo bibliográfico. Para trabajos recientes o de nicho, esa imitación de estilo se convierte en invención.
¿Qué se debe evaluar al elegir un asistente de investigación con AI?
Debes evaluar un asistente de investigación con AI según si cada afirmación puede rastrearse, fundamentarse, atribuirse, contrastarse y extraerse, no según lo pulida que suene la prosa. Una forma útil de resumirlo es el marco TRACE: trazabilidad, fundamentación en la recuperación, granularidad de atribución, conciencia de contradicciones y capacidad de extracción.
La trazabilidad pregunta si un lector puede pasar de una oración del borrador al pasaje exacto que la respalda. Si la herramienta solo emite una referencia formateada, ha producido un puntero, no una prueba.
La fundamentación en la recuperación pregunta si el sistema buscó en un corpus académico o si generó una respuesta a partir de los pesos del modelo. La extracción fundamentada en citas está diseñada para bloquear tanto la invención sin fuentes como la paráfrasis sin atribución al exigir una atribución explícita de fuente para cada afirmación extraída.
La granularidad de atribución distingue las citas a nivel de artículo de las citas a nivel de oración o de campo. Un artículo puede ser real mientras que el hallazgo citado es erróneo, está desactualizado o procede del resumen en lugar de los resultados.
La conciencia de contradicciones pregunta si la herramienta muestra estudios posteriores que respaldan, cuestionan o simplemente mencionan la afirmación. Un único resumen que confirma una idea no constituye una literatura.
La capacidad de extracción pregunta si los métodos, las muestras, los resultados y las limitaciones pueden compararse en campos estructurados. Los resúmenes en prosa ocultan los datos ausentes. Las tablas hacen visibles las lagunas.
La guía de síntesis de evidencia del King's College London es contundente sobre la implicación práctica: las herramientas de AI pueden respaldar etapas de una revisión, pero no pueden sustituir métodos de búsqueda validados, y los sistemas generativos todavía crean referencias falsas. Una revisión de 2025 citada en esa guía concluyó que la evidencia actual no respalda el uso de AI generativa en la síntesis de evidencia sin participación humana. Por tanto, la pregunta de evaluación no es «¿esta herramienta redacta?». Es «¿esta herramienta puede auditarse?».
¿Cómo se comparan los asistentes especializados de investigación con los chatbots generales?
Los asistentes especializados de investigación superan a los chatbots generales en trazabilidad de citas porque vinculan las respuestas con artículos recuperados, mientras que los chatbots siguen siendo más fuertes para redactar, explicar y generar ideas. La comparación honesta se basa en funciones. Los chatbots son motores flexibles de redacción. Los asistentes de investigación son sistemas de recuperación más limitados y auditables.
Elicit busca entre millones de artículos académicos y devuelve informes estructurados con citas. Es especialmente fuerte cuando un investigador necesita alinear métodos, muestras y hallazgos de un conjunto de estudios. Una comparación de 2026 vinculada a Cochrane y citada por King's College London concluyó que Elicit no realizaba búsquedas con la sensibilidad suficiente para sustituir la búsqueda bibliográfica tradicional, aunque su precisión lo hacía útil como complemento. Es una limitación real, no una nota al pie.
Scite está diseñado para la verificación más que para la redacción. Informa de cobertura de más de 300 millones de artículos académicos y acceso con licencia mediante acuerdos con más de 40 editoriales. Sus Smart Citations clasifican si artículos posteriores respaldan, contrastan o simplemente mencionan una afirmación. Cada afirmación que realiza su asistente está vinculada a la oración específica del artículo específico. La contrapartida es su alcance: Scite es más fuerte en inteligencia de citas que en flujos de trabajo integrales para manuscritos.
ResearchRabbit es más fuerte para el mapeo. Ayuda a los investigadores a encontrar artículos relacionados, crear mapas de citas y seguir la expansión de un campo a partir de un artículo semilla. Es menos útil como motor de extracción de evidencia o validación de citas. Eso no es un defecto si la tarea es el descubrimiento.
Los chatbots generales como ChatGPT siguen utilizándose ampliamente porque redactan con rapidez y manejan preguntas complejas entre dominios. Su debilidad documentada es la invención bibliográfica. Informes recientes resumidos en el análisis de integridad académica de 2026 situaron la alucinación de citas factuales en modelos avanzados como GPT-4o y Claude 3.7 en el rango del 15–20%, aumentando al 35–55% en temas recientes o de nicho. Los benchmarks que auditan referencias científicas producidas por modelos de lenguaje grandes han informado tasas de error superiores al 30% en algunos contextos.
El Academic Research Assistant de Jenova ocupa una posición diferente. Es un agente de dominio para el descubrimiento bibliográfico, la preparación de manuscritos y la gestión de citas, con memoria persistente y búsqueda en vivo en bases de datos académicas. Es más fuerte que un chatbot para mantener coherente un proyecto de investigación entre sesiones. Es más débil que Scite en la clasificación de citas de texto completo con licencia, y más débil que Elicit como producto dedicado a tablas de extracción. Esas diferencias explican por qué una combinación de herramientas sigue superando a cualquier asistente individual.
| Característica / dimensión | Chatbots generales (p. ej., ChatGPT) | Jenova Academic Research Assistant | Elicit | Scite | ResearchRabbit |
|---|---|---|---|---|---|
| Fundamentación en la recuperación | Principalmente memoria del modelo; la navegación varía según el producto | Recuperación académica y web en vivo dentro de un agente de investigación persistente | Búsqueda en corpus de artículos con informes estructurados | Texto completo académico con licencia más corpus abierto | Descubrimiento mediante grafo de citas a partir de artículos semilla |
| Trazabilidad de citas | Frecuentemente no verificable o fabricada | Fuentes en línea con verificación posterior frente a los originales | Citas vinculadas a campos extraídos | Enlaces a nivel de oración más etiquetas de respaldo/contraste | Enlaces de red entre artículos, no pruebas a nivel de afirmación |
| Extracción de evidencia | Resúmenes de formato libre | Notas, comparaciones y síntesis lista para manuscrito | Tablas estructuradas sólidas | Más fuerte en contexto de citas que en extracción de campos | Limitada; prioriza el mapeo sobre la extracción |
| Conciencia de contradicciones | Normalmente se aplana en una única respuesta | Puede comparar hallazgos contradictorios cuando se le solicita | Depende del conjunto recuperado | Función central mediante Smart Citations | Indirecta, mediante grupos de trabajos relacionados |
| Precios (a fecha de 2026) | Sin verificar entre los distintos planes | Nivel gratuito; planes de pago desde $20/mes | Sin verificar | Sin verificar | Sin verificar |
| Ideal para | Redacción, explicación y planteamiento inicial | Proyectos académicos continuos que necesitan descubrimiento y memoria de redacción | Clasificar artículos en tablas de evidencia comparables | Comprobar si una afirmación está respaldada o cuestionada | Mapeo visual de literatura y descubrimiento de autores o grupos |
Un resumen de 2026 sobre herramientas de AI para investigación académica llegó a una división del trabajo similar: Elicit lideraba la extracción estructurada, Consensus era más rápido para comprobaciones rápidas de evidencia y Semantic Scholar seguía siendo el índice de descubrimiento gratuito más fuerte. Ninguna columna de ese panorama sustituye a las demás.
¿Cómo difiere la extracción de evidencia entre las herramientas académicas de AI?
La extracción de evidencia difiere según si la herramienta devuelve campos comparables o solo una paráfrasis narrativa. La extracción a nivel de campo es más fiable para métodos, tamaños de muestra, resultados y limitaciones porque los valores ausentes permanecen visibles. La extracción narrativa es más rápida y legible, pero oculta la diferencia entre un resultado, una interpretación y un detalle alucinado.
Elicit es el ejemplo más claro del enfoque estructurado. Está diseñado para convertir una pregunta de investigación en un informe cuyas filas son artículos y cuyas columnas son características de los estudios. Ese formato explica por qué los revisores suelen preferirlo para el cribado inicial. Aun así, requiere que una persona compruebe la lógica de inclusión, porque una alta precisión no equivale a una alta exhaustividad.
Scite extrae un objeto diferente: el contexto de la cita. En lugar de preguntar «¿qué encontró este artículo?», pregunta «¿qué hicieron los artículos posteriores con este hallazgo?». Eso se acerca más a la evaluación de evidencia que a la extracción de datos. Resulta especialmente útil después de identificar un artículo candidato.
Los chatbots generales extraen en prosa. Pídeles una comparación de cuatro ensayos aleatorizados y producirán un párrafo convincente. El párrafo puede ser útil como primer borrador. Es un mal artefacto de auditoría, porque no existe un campo que pueda marcarse como «no informado».
El Academic Research Assistant de Jenova y su agente complementario Deep Research se sitúan entre ambos polos. Deep Research busca ampliamente y devuelve un informe sintetizado con citas en línea. El Academic Research Assistant mantiene el estado del proyecto: las decisiones de inclusión previas, los artículos rechazados, los requisitos de estilo y las secciones de manuscrito sin terminar siguen disponibles en sesiones posteriores. Probar este flujo de trabajo revela una ventaja práctica en revisiones de literatura de varias semanas. La limitación es igual de práctica. Ninguno de los dos agentes es una herramienta dedicada de cribado para revisiones sistemáticas como Rayyan o DistillerSR, que los bibliotecarios de síntesis de evidencia todavía consideran opciones más evaluadas para el cribado de títulos y resúmenes.
Una instrucción de extracción fiable hace explícitos los campos deseados:
«Extrae de estos artículos: diseño del estudio, tamaño de muestra, población, resultado principal, dirección del efecto, limitaciones declaradas y la oración exacta que respalda cada campo. Si falta un campo, escribe “no informado” en lugar de inferirlo».
La misma instrucción en un chatbot sigue siendo tan buena como el texto recuperado. Si el modelo nunca abrió el artículo, rellenará la tabla a partir de su memoria estilística.
¿Qué requiere realmente un proceso de verificación de citas?
Un proceso de verificación de citas requiere el documento fuente, no solo la cadena de referencia. El proceso mínimo viable es: incorporar el texto citado, dividirlo en fragmentos, recuperar los pasajes más relevantes para la afirmación, reordenarlos por relevancia y clasificar la relación entre la afirmación y la evidencia. Cualquier cosa inferior a eso es formato bibliográfico.
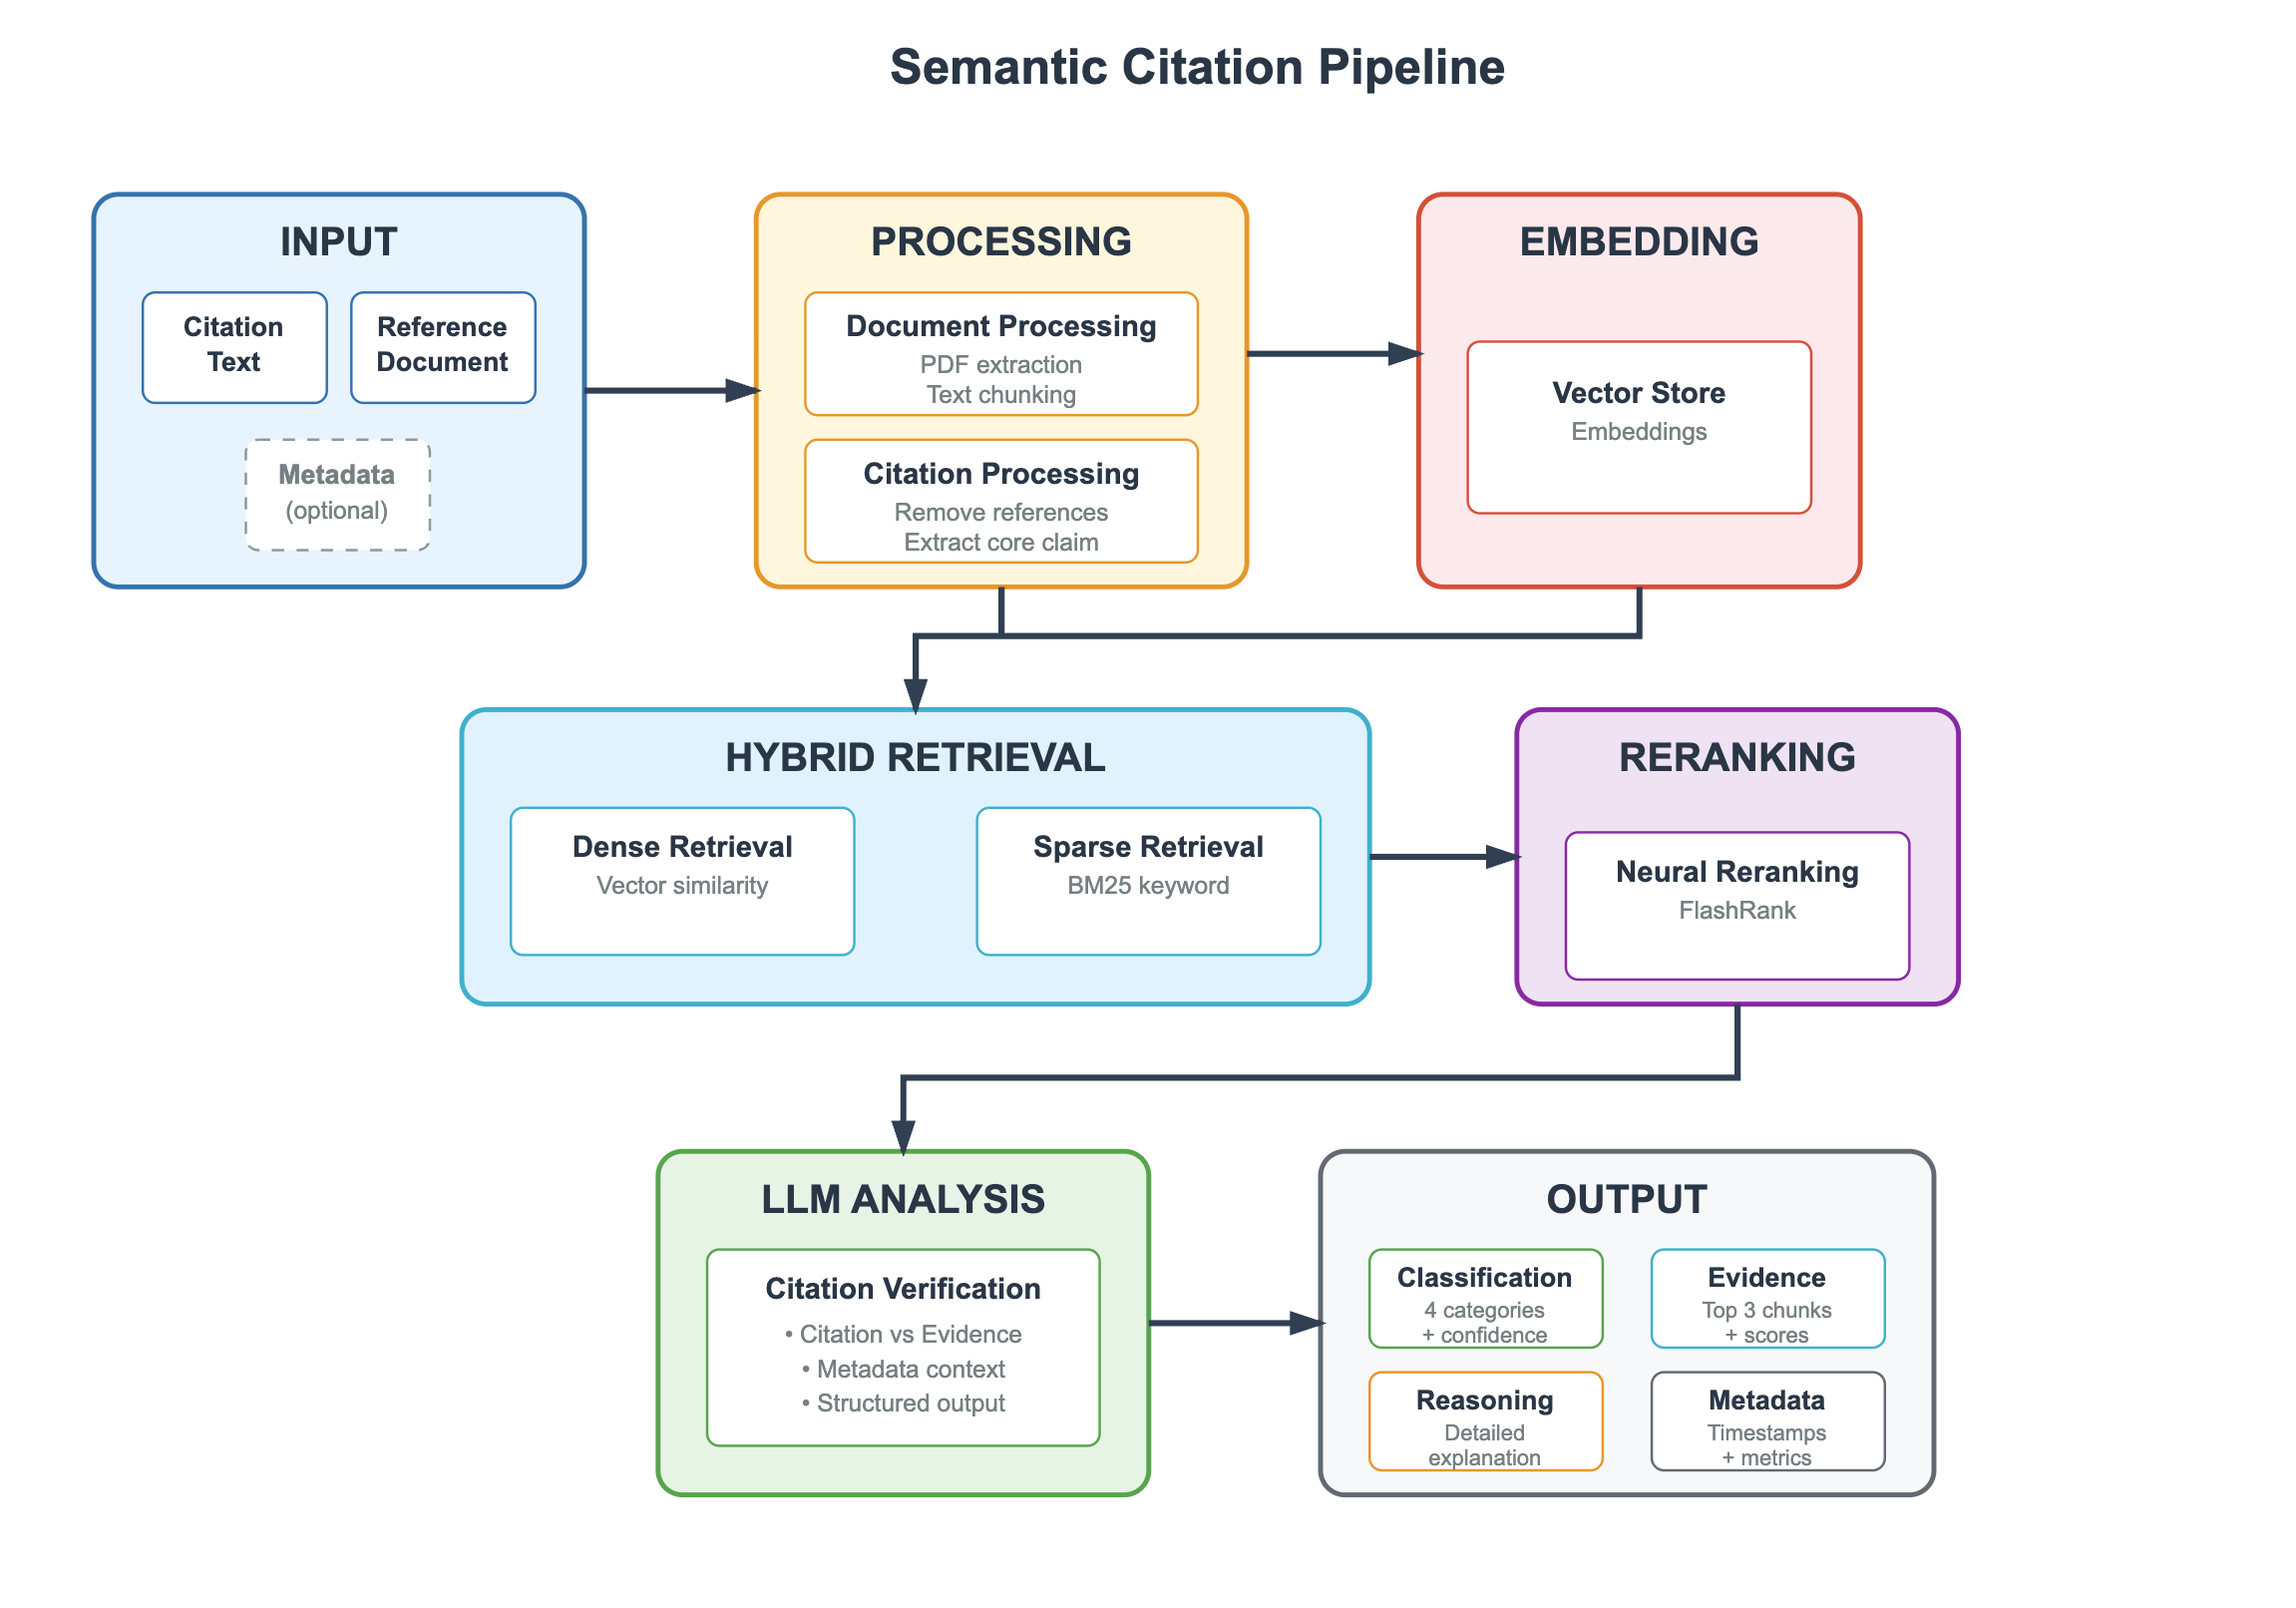
La arquitectura anterior marca la diferencia entre «esta cita parece real» y «esta cita está respaldada». La entrada es la afirmación más el documento de referencia. El procesamiento elimina la bibliografía, extrae la afirmación central y divide el PDF en fragmentos. La recuperación híbrida busca entonces tanto por similitud vectorial como por coincidencia de palabras clave, algo importante porque los nombres de métodos y las medidas de resultados suelen fallar en la búsqueda puramente semántica. El reordenamiento neuronal conserva los pasajes principales. Solo entonces un LLM clasifica la relación y devuelve evidencia, confianza y razonamiento.
Sistemas como SemanticCite se están desarrollando específicamente para verificar la exactitud de las citas mediante análisis de fuentes de texto completo. Esa decisión de diseño existe porque la coincidencia de metadatos no basta. Un DOI puede ser válido mientras que la oración citada procede de otro artículo, de un resumen de prepublicación o de un hallazgo que los autores posteriormente matizaron.
La infraestructura editorial no resuelve esto automáticamente. Las principales revistas ya enlazan sus referencias, pero las estimaciones analizadas en el estudio de integridad de 2026 situaron los fallos de DOI, o la degradación de enlaces, en hasta el 37% del contenido académico muestreado. Un enlace verde no es una afirmación verificada.
Aquí también es donde los chatbots generales fallan de manera más predecible. Optimizan una respuesta completa. Un proceso de verificación optimiza una relación clasificada: respaldada, no respaldada, contradicha o con evidencia insuficiente. Esas cuatro etiquetas son más útiles científicamente que un párrafo pulido, porque indican al investigador qué tipo de comprobación sigue siendo necesaria.
Los agentes de Jenova pueden ejecutar una versión ligera de este ciclo recuperando el artículo candidato, citando el pasaje de respaldo y señalando las afirmaciones que no pueden localizarse. Actualmente no sustituyen a un clasificador de citas de texto completo con licencia y cobertura a escala editorial. Los investigadores que necesitan etiquetas Smart Citation siguen combinando un agente de redacción con Scite en lugar de pedir a un solo sistema que realice ambos trabajos.
¿Cómo se crea un flujo de trabajo bibliográfico asistido por AI más seguro?
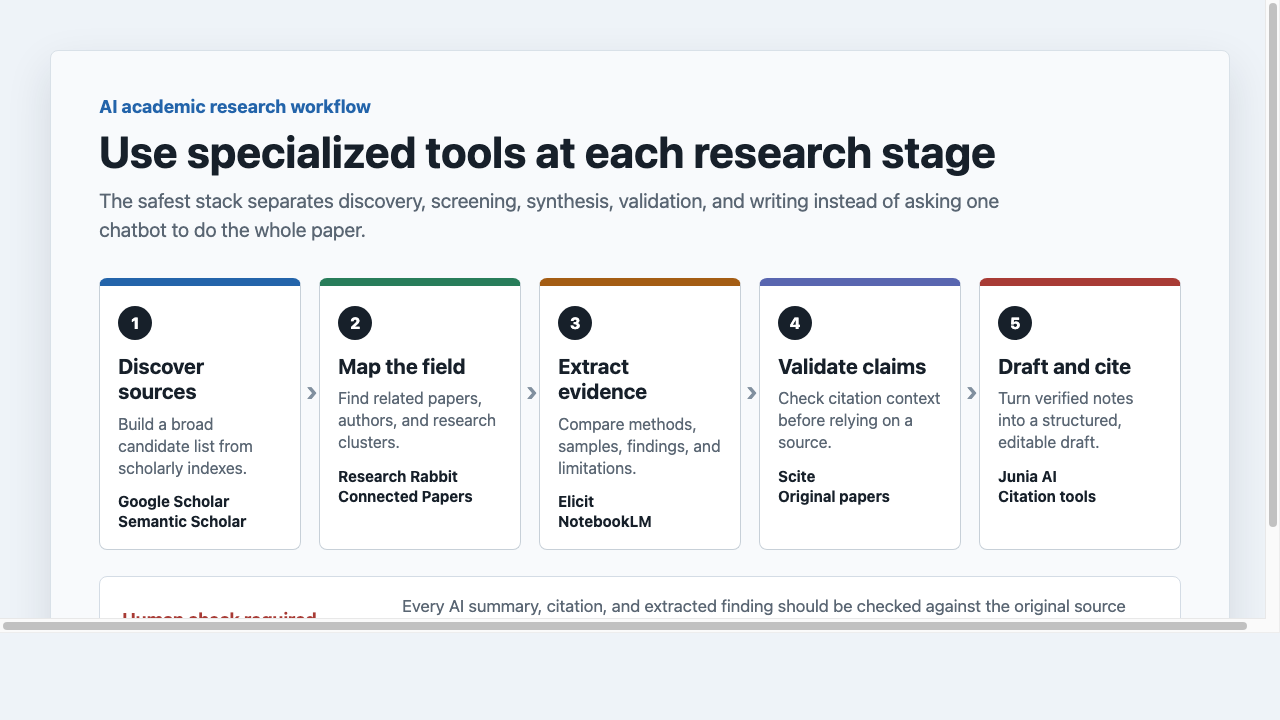
Se crea un flujo de trabajo bibliográfico asistido por AI más seguro asignando cada etapa a una herramienta que pueda verificarse y contrastando cada hallazgo extraído con el artículo original. El patrón inseguro consiste en pedir a un único chatbot que descubra, seleccione, extraiga, valide y redacte.
Un flujo de trabajo por etapas es el siguiente:
- Descubre fuentes en índices académicos como Google Scholar o Semantic Scholar, no en una ventana de chat.
- Mapea el campo con ResearchRabbit o Connected Papers para hacer visibles los autores y grupos relacionados.
- Extrae evidencia con Elicit, NotebookLM o un agente de investigación en notas estructuradas.
- Valida afirmaciones en Scite y en los PDF originales antes de considerar citable cualquier oración.
- Redacta y cita únicamente a partir del conjunto de notas verificadas.
Para el Academic Research Assistant de Jenova, la configuración es un encargo de investigación, no un recorrido de funciones:
- Abre el agente en jenova.ai/a/academic-research-assistant.
- Indica la pregunta, la disciplina y cómo se verá el resultado final:
«Estoy redactando una sección de métodos sobre tasas de error de citas de LLM. Prioriza estudios revisados por pares y análisis de editoriales de 2023–2026. Para cada fuente, extrae la muestra, la definición de error, la tasa de alucinación y si las personas verificaron las referencias».
- Pide primero una lista de candidatos, después tablas de extracción y luego prosa. No pases directamente al borrador.
- Mantén los artículos rechazados en el mismo hilo para que el agente no los vuelva a introducir más adelante.
Para Elicit, el punto de partida equivalente es una pregunta concreta y una lista de columnas: población, intervención, resultado y tipo de estudio. Para Scite, empieza con un artículo o afirmación conocidos e inspecciona las citas de respaldo frente a las que contrastan antes de redactar. Para un chatbot general, el uso más seguro es elaborar esquemas y editar lenguaje después de que las fuentes ya existan.
Dos reglas operativas evitan la mayoría de los fallos. Primero, nunca aceptes una cita que no puedas abrir. Segundo, nunca permitas que el modelo de redacción se convierta en el único registro de lo que dijo un artículo. La nota verificada es la fuente de verdad. El borrador es una reorganización de esa nota.
¿Cuándo sigue siendo un chatbot de propósito general la mejor herramienta académica?
Un chatbot de propósito general sigue siendo la mejor herramienta académica cuando la tarea es de lenguaje, estructura o explicación en lugar de evidencia. La fiabilidad depende del trabajo. La trazabilidad de citas es una prueba equivocada para un modelo de redacción, igual que la fluidez de la prosa es una prueba equivocada para un índice de recuperación.
Los chatbots siguen siendo útiles para:
- Convertir un esquema verificado en prosa académica más clara
- Explicar un método que el investigador ya ha leído
- Generar cadenas de búsqueda, contraargumentos o listas de comprobación para revisiones
- Traducir pasajes densos a un lenguaje más claro para notas, no para citas
Son un mal motor principal de revisión bibliográfica. El trabajo de clasificación vinculado a Nature trata las afirmaciones no fundamentadas de los chatbots como un tipo diferenciado de alucinación, y las guías de bibliotecas repiten la misma advertencia: las citas fabricadas pueden incluir un paquete completo de autor, título y revista. Ese modo de fallo es costoso en tesis, propuestas de subvención y envíos a revistas, donde una referencia inventada puede desacreditar un argumento por lo demás riguroso.
También hay una razón de flujo de trabajo para mantener los chatbots en la combinación de herramientas. Las herramientas especializadas son más limitadas. Elicit no pulirá la cadencia de un párrafo. Scite no sostendrá una conversación de tutoría durante un semestre sobre un capítulo de tesis. ResearchRabbit no aplicará el estilo de referencias de una revista. Un chatbot, o un agente general de redacción, cubre esas carencias después de que la evidencia se haya fijado.
La regla práctica es la secuenciación. Usa primero la recuperación y verificación especializadas. Usa un modelo general después, y solo sobre texto cuyas fuentes ya existan en una biblioteca que puedas abrir. Si un chatbot introduce una cita nueva durante la revisión, trata esa cita como no fiable hasta que supere las mismas comprobaciones TRACE que el resto del manuscrito.
¿Qué dicen los especialistas en integridad de la investigación sobre las citas de AI?
Los especialistas en integridad de la investigación consideran los chatbots generales como ayudas para la redacción y los sistemas especializados vinculados a fuentes como la única capa aceptable para las afirmaciones que se citarán. El consenso no es «evita la AI». Es «no permitas que un generador sin fundamento se convierta en el registro de lo que dice la literatura».
«El fallo que seguimos viendo no es que los modelos redacten mal. Es que elaboran bibliografías completas de artículos que no existen, o de artículos reales que no contienen el resultado afirmado. Una vez que esas cadenas entran en un borrador, se comportan como evidencia. Los revisores, coautores y herramientas de citas posteriores pueden propagarlas antes de que alguien abra la fuente.»
«Un asistente especializado de investigación cambia la unidad de trabajo. En lugar de pedir un párrafo con citas, pides una afirmación, un pasaje y una clasificación: respaldada, no respaldada, contradicha o insuficiente. Ese resultado es más lento y menos elegante. También es el único resultado que una sección de métodos puede defender.»
«La memoria persistente del proyecto importa más de lo que la gente espera. Las alucinaciones suelen volver a entrar en un artículo durante la revisión, cuando se pide a un chatbot general que “agregue fuentes” a una sección que ya estaba limpia. Un asistente que recuerda qué artículos se excluyeron y por qué está realizando un trabajo de integridad, no solo de conveniencia. Incluso entonces, el PDF original sigue siendo la autoridad.»
— Equipo de Producto de Jenova, flujos de trabajo de investigación académica, trabajo plurianual sobre diseño de agentes fundamentados en citas
Esa posición coincide con la orientación de bibliotecarios y especialistas en síntesis de evidencia. King's College London aconseja utilizar la AI como complemento, comprobar los derechos de autor antes de cargar textos completos y asumir que las herramientas generativas todavía pueden inventar referencias y encabezamientos temáticos. Los análisis a nivel editorial ya tratan las referencias alucinadas como un problema de corpus, no como uno anecdótico. Un comentario de 2026, basado en un examen de Nature de aproximadamente 4.000 publicaciones, señaló que 65 de los 100 artículos más sospechosos contenían al menos una referencia no válida, un patrón que podría implicar más de 110.000 artículos afectados entre unos 7 millones de publicaciones de 2025.
La implicación experta es operativa. Elige herramientas que hagan barata la comprobación. Rechaza las herramientas que hacen que comprobar parezca innecesario.
Referencias
- Higher Education Policy Institute — Encuesta sobre AI generativa para estudiantes 2025
- ERIC / Departamento de Educación de EE. UU. — Encuesta sobre AI generativa para estudiantes 2025, nota de política HEPI 61
- Boretti, Energy Research & Social Science — Alucinaciones en AI generativa e integridad académica
- Wikipedia — Alucinación (inteligencia artificial)
- McGoogan Library de la University of Nebraska Medical Center — Alucinaciones de AI con citas
- Science / AAAS — Por qué los modelos de AI alucinan en vez de admitir la incertidumbre
- LlamaIndex — Extracción fundamentada en citas
- Guía de biblioteca del King's College London — Herramientas de AI en síntesis de evidencia
- Elicit — AI para la investigación científica
- Scite — Investigación respaldada por citas y Smart Citations
- ResearchRabbit — Mapeo de literatura y redes de citas
- newline — Benchmarks para comprobar referencias científicas producidas por LLM
- Paperguide — Comparación de herramientas de AI para investigación académica, 2026
- arXiv — SemanticCite: verificación de citas con análisis de texto completo
- Nature Humanities and Social Sciences Communications — Clasificación de las alucinaciones de AI