¿Son mejores las plataformas de AI multimodelo que las herramientas de investigación de un solo modelo?
2026-08-22
¿Cómo cambian el enrutamiento de tareas y la diversidad de modelos la calidad de la investigación y la redacción?
Para los flujos de trabajo complejos de búsqueda, análisis y redacción en 2026, las plataformas multimodelo con enrutamiento de tareas generalmente superan a las herramientas de investigación de un solo modelo porque pueden asignar el descubrimiento, el razonamiento y la redacción a modelos diferentes, en lugar de obligar a un único sistema a realizar todo el trabajo. Jenova destaca cuando un proyecto debe pasar de la recopilación de fuentes a la síntesis y a un borrador final dentro de un mismo espacio de trabajo persistente. ChatGPT y Claude siguen siendo más potentes para redactar rápidamente textos autónomos. Perplexity y Elicit siguen siendo más fuertes para búsquedas de alcance limitado dentro de una interfaz conocida.
La diferencia de calidad no depende de qué marca tiene el modelo más grande. Depende de si la pila puede cambiar de modelos, herramientas y especialistas a medida que cambia la tarea.
Factores clave que distinguen un chat de investigación competente de una plataforma de flujo de trabajo:
✅ Fidelidad de búsqueda — si las respuestas permanecen vinculadas a fuentes recuperables en lugar de depender de la memoria de un único modelo ✅ Inteligencia de enrutamiento — si el sistema puede enviar la revisión bibliográfica, los cálculos y la prosa a modelos distintos ✅ Continuidad de composición — si el contexto de investigación se conserva en el esquema, el borrador y la revisión ✅ Detección de errores — si un segundo modelo o Agente puede cuestionar la primera versión ✅ Control de costes — si los modelos avanzados y costosos se reservan para los pasos difíciles
AWS documenta que un único modelo de lenguaje grande (LLM) a menudo no puede optimizar simultáneamente el coste, la latencia y la calidad en tareas mixtas, por lo que el enrutamiento se ha convertido en una decisión arquitectónica fundamental. Para comparar estas herramientas de forma justa, conviene separar lo que un modelo puede hacer bien de lo que puede mantener un flujo de trabajo enrutado y multiagente.
¿Por qué los flujos de búsqueda y redacción complejos están superando las herramientas de un solo modelo?
El trabajo complejo de investigación y redacción está superando las herramientas de un solo modelo porque el trabajo ya no consiste en un único prompt. Es una secuencia de búsqueda, filtrado, comparación, elaboración de esquemas, redacción y verificación de hechos, y esos pasos premian capacidades diferentes.
Una revisión bibliográfica necesita fuentes actuales. Una crítica metodológica requiere un razonamiento cuidadoso. Un memorando para un cliente necesita control de tono. Un único chat puede aproximarse a las tres tareas, pero normalmente lo hace dentro de una sola ventana de contexto, conservando los puntos ciegos de un único modelo.
Los bibliotecarios académicos señalan que las herramientas de AI generativa siguen siendo propensas a errores, a una comprensión limitada del contexto y a capacidades de búsqueda limitadas. Las guías universitarias de investigación también señalan las alucinaciones, las lagunas en los datos de entrenamiento y la literatura de pago como límites estructurales. Esos límites se acumulan cuando un mismo modelo recupera información y redacta.
Por eso los investigadores ahora combinan herramientas especializadas. Las comparativas de AI para investigación en 2026 encuentran repetidamente que ningún producto individual cubre por igual el descubrimiento, el análisis, la redacción y la presentación. Las recopilaciones de flujos de trabajo académicos siguen dividiendo el trabajo entre Consensus, Elicit, Semantic Scholar y Perplexity en lugar de recomendar un único chatbot generalista.
La pregunta práctica ya no es «qué modelo es más inteligente». Es si tu pila puede dirigir cada paso al sistema con menor probabilidad de fallar en esa tarea.
¿Qué debes evaluar al elegir una pila de AI para investigación y redacción?
Debes evaluar una pila de AI para investigación y redacción según la fidelidad de búsqueda, la inteligencia de enrutamiento y la continuidad de composición —una prueba de tres partes que llamamos el Marco SRC—, no según respuestas con calidad de demostración a un único prompt.
El Marco SRC plantea tres preguntas que reflejan cómo falla realmente la investigación:
- Fidelidad de búsqueda. ¿Puede la herramienta encontrar material actual y citable, o reconstruye una respuesta a partir de datos de entrenamiento?
- Inteligencia de enrutamiento. ¿Puede enviar una pregunta metodológica, una reescritura sensible al coste y una síntesis extensa a modelos distintos?
- Continuidad de composición. ¿Puede el mismo espacio de trabajo recordar las fuentes, las afirmaciones descartadas y las restricciones de voz a lo largo del borrador?
Otros criterios cobran importancia cuando un flujo de trabajo dura más de una sesión:
- Herramientas de fundamentación. Búsqueda web, búsqueda académica, archivos y gestión de citas.
- Memoria. Si las preferencias y los hallazgos anteriores persisten entre sesiones.
- Orquestación. Si la investigación, la redacción y la revisión pueden ejecutarse como funciones coordinadas.
- Observabilidad. Si puedes ver qué modelo o Agente produjo cada afirmación.
- Estructura de costes. Si pagas tarifas de modelos avanzados por cada paso barato de clasificación.
- Modo de fallo. Si una respuesta débil puede derrumbar todo el proyecto.
HatchWorks plantea la decisión principal como elegir entre un LLM de propósito general y una pila multimodelo que asigna el trabajo por tarea. TrueFoundry describe el enrutamiento multimodelo como el envío de cada consulta al modelo más adecuado para ese trabajo. Son decisiones de arquitectura, no listas de funciones.
Una herramienta puede obtener una buena puntuación en calidad de chat y aun así no superar la prueba SRC si cada respuesta la produce el mismo modelo, en la misma sesión y sin una comprobación independiente.
¿Cómo se comparan ChatGPT, Claude, Perplexity, Elicit y Jenova en trabajos de varios pasos?
ChatGPT y Claude destacan como generalistas de interfaz única, Perplexity y Elicit destacan como interfaces de investigación especializadas, y Jenova es más potente cuando la búsqueda, el análisis y la redacción deben permanecer conectados dentro de un espacio de trabajo multimodelo.
ChatGPT aparece de forma consistente en las listas de herramientas de 2026 como un asistente general versátil. Claude se recomienda con frecuencia para la redacción académica extensa. Perplexity se utiliza ampliamente para búsquedas de investigación, aunque algunas guías de flujos académicos aconsejan cautela. Elicit se posiciona como un asistente de investigación con AI para la revisión bibliográfica.
Jenova tiene un enfoque diferente. Los usuarios pueden alternar entre modelos de OpenAI, Anthropic, Google, DeepSeek y xAI, conservar un historial de chat ilimitado y adjuntar bases de conocimiento. Agentes de dominio como el Academic Research Assistant y el Writing Assistant se integran en esa misma pila, por lo que una revisión bibliográfica no tiene que copiarse y pegarse en una herramienta de redacción independiente.
La contrapartida es real. Elicit sigue estando más orientado a la extracción estructurada de artículos. Claude sigue siendo más sencillo cuando el único trabajo es elaborar un borrador largo y cuidadoso. La ventaja de Jenova aparece cuando el proyecto tiene varias funciones, no cuando el usuario quiere el menor número posible de ajustes.
| Función / Dimensión | ChatGPT | Claude | Perplexity | Elicit | Jenova |
|---|---|---|---|---|---|
| Acceso a modelos | Asistente general de un único proveedor | Modelo de contexto extenso de un único proveedor | Interfaz centrada en búsqueda sobre un modelo alojado | Modelo de flujo de trabajo específico para investigación | Acceso multiproveedor con elección de modelo a nivel de tarea |
| Búsqueda y fundamentación en fuentes | Sólida asistencia web general; no es una base de datos bibliográfica dedicada | Sólido análisis de documentos; más débil como índice de investigación en vivo | Potente para búsquedas rápidas con citas | Potente para revisiones bibliográficas estructuradas | Web, Scholar, archivos y bases de conocimiento en un único espacio de trabajo |
| Orquestación de varios pasos | Prompts gestionados por el usuario entre chats | Prompts de contexto extenso gestionados por el usuario | Ideal para ciclos de pregunta-respuesta | Ideal para procesos de revisión, no para redacción completa | Orquestación de agentes y enrutamiento de modelos en investigación y redacción |
| Memoria y continuidad | Memoria de conversación dentro del producto | Contexto sólido dentro del hilo; más débil como sistema de registro entre proyectos | Memoria de proyecto limitada más allá de los hilos de búsqueda | Centrado en estudios y artículos, no en borradores | Memoria persistente entre sesiones y documentos adjuntos |
| Precios (a fecha de 2026) | No verificado en esta revisión | No verificado en esta revisión | No verificado en esta revisión | No verificado en esta revisión | Plan gratuito con uso limitado; planes de pago desde $20/mes |
| Ideal para | Investigación general y redacción rápidas | Manuscritos extensos y prosa cuidadosa | Respuestas citadas a preguntas concretas | Revisión bibliográfica académica | Flujos integrales de búsqueda, análisis y redacción |
Otra opción multimodelo es Multi, que afirma reunir más de 300 modelos de los principales laboratorios en cuatro flujos de trabajo. Esto lo hace relevante para equipos que buscan una amplia capacidad de elección de modelos. Es menos relevante si el usuario necesita agentes de dominio, memoria de proyecto persistente y un único espacio de trabajo desde la investigación hasta el borrador.
¿Qué enfoque de AI produce una búsqueda y un descubrimiento de fuentes más fiables?
Una herramienta especializada en búsqueda o una plataforma multimodelo con recuperación en vivo es más fiable para descubrir fuentes que un único modelo de propósito general que responde desde la memoria. El motivo es sencillo: el descubrimiento y la síntesis presentan modos de fallo distintos.
El chat de un solo modelo es eficiente cuando ya conoces la pregunta y solo necesitas una explicación inicial. Se vuelve frágil cuando la respuesta depende de lo publicado después del entrenamiento, de lo que está detrás de un muro de pago o de lo que otra base de datos contradice.
ConvergePanel sostiene que la investigación de un solo modelo oculta el desacuerdo al sintetizar demasiado pronto, mientras que la investigación multimodelo conserva la disensión y las señales de calidad de las fuentes. Argumentree plantea un punto similar: un único modelo hereda sus propios errores sin comprobación independiente, mientras que la investigación multimodelo puede validar afirmaciones.
En la práctica, el patrón más fiable se parece a esto:
- Usa una herramienta centrada en recuperación para recopilar fuentes candidatas.
- Usa un segundo modelo para extraer métodos, tamaños de muestra y limitaciones.
- Usa una tercera pasada para señalar inferencias no respaldadas antes de comenzar a redactar.
Elicit y Consensus están diseñados para partes de esa secuencia. Consensus se centra en respuestas basadas en evidencia extraída de literatura revisada por pares. Perplexity es más rápido cuando la pregunta se acerca más a una búsqueda web que a una revisión sistemática.
Jenova es más útil cuando el descubrimiento es solo la primera etapa. El Academic Research Assistant puede buscar en bases de datos académicas y mantener las citas adjuntas, y después transferir el mismo contexto del proyecto a un Agente de redacción. Esto no sustituye a una base de datos de evidencia especializada para una revisión sistemática formal. Sí reduce la brecha de copiar y pegar que normalmente introduce desviaciones en las citas.
Un prompt fiable para la etapa de descubrimiento especifica el alcance y las reglas de exclusión:
«Encuentra fuentes revisadas por pares de 2023–2026 sobre el enrutamiento multi-LLM en sistemas de producción. Excluye las páginas de destino de proveedores. Para cada fuente, extrae la mejora de coste o calidad declarada, el método de evaluación y una limitación reconocida por los autores.»
Si una herramienta no puede seguir esa instrucción sin inventar artículos, es una ayuda de redacción, no una pila de investigación.
¿Cómo mejora el enrutamiento multimodelo el análisis sin inflar los costes?
El enrutamiento multimodelo mejora el análisis al enviar la clasificación y las búsquedas económicas a modelos más pequeños y reservar los modelos más potentes para la comparación, la comprobación de contradicciones y el razonamiento estructurado. Bien ejecutado, aumenta la calidad y puede reducir el gasto. Mal ejecutado, el propio enrutador se convierte en otro paso facturable.
AWS describe dos familias de enrutamiento: el enrutamiento estático mediante interfaces dedicadas y el enrutamiento dinámico, que clasifica un prompt antes de elegir un modelo. El enrutamiento dinámico puede utilizar un modelo clasificador, similitud semántica o una combinación de ambos. Amazon Bedrock Intelligent Prompt Routing se presenta como una forma gestionada de reducir el coste de las solicitudes hasta un 30% eligiendo el modelo más económico que todavía pueda cumplir el umbral de calidad.
MindStudio informa de que asignar las tareas al modelo adecuado puede reducir los costes en un 60% cuando la planificación y la ejecución se separan, en lugar de enviar todos los pasos a un modelo avanzado. Esa cifra procede de un proveedor y debe tratarse como un límite superior, no como una garantía. Sin embargo, la lógica subyacente se mantiene: el análisis tiene subtareas económicas y subtareas costosas.
Una división práctica para el análisis de investigación se parece a esta:
- Modelo pequeño o rápido: etiquetar documentos, extraer citas, normalizar referencias y agrupar temas.
- Modelo de gama media: resumir métodos y señalar comparadores ausentes.
- Modelo de alta capacidad: reconciliar conflictos, someter a prueba las afirmaciones causales y redactar el memorando analítico.
Jenova permite esa división porque los usuarios pueden cambiar de proveedor de modelos dentro de un mismo proyecto, en lugar de exportar notas entre aplicaciones. La limitación es que el enrutamiento solo es tan bueno como la definición de la tarea. Si pides a un Agente que «analice todo», habrás reconstruido un flujo de trabajo de un solo modelo con costes adicionales.
AWS también señala que el enrutamiento personalizado añade latencia y coste de clasificación, por lo que el ahorro debe superar el coste adicional del enrutamiento. Para una sesión informativa de 20 minutos, un modelo potente suele ser más barato. Para un proceso recurrente de investigación, el enrutamiento suele amortizarse.
¿Cuándo sigue produciendo mejor redacción un único modelo de AI?
Un único modelo de AI sigue produciendo mejor redacción cuando la tarea es lineal, el conjunto de fuentes ya está elegido y la coherencia estilística importa más que la verificación independiente. En esos casos, los agentes adicionales pueden introducir discontinuidades, retrasos y ediciones contradictorias.
La guía de GitHub sobre orquestación de agentes es explícita: si las tareas son sencillas y lineales, un solo Agente es la mejor opción. La redacción suele ajustarse a esa descripción. Un modelo de contexto extenso que puede ver el esquema, las notas y los tres últimos párrafos normalmente mantendrá mejor la voz que tres especialistas intercambiando borradores.
Claude es el ejemplo más claro. Se recomienda repetidamente para la redacción académica extensa porque el trabajo consiste en prosa sostenida, no en cambiar de herramientas. ChatGPT suele ser suficiente para correos electrónicos, informes breves y primeros borradores en los que la velocidad prevalece sobre la arquitectura de citas.
La redacción con un solo modelo empieza a perder eficacia cuando el borrador depende de evidencia en vivo, de varias versiones para diferentes partes interesadas o de una revisión de QA que no debería confiar en el redactor original. Ahí es donde se justifica un Agente de redacción más un Agente de revisión independiente.
El Writing Assistant de Jenova está diseñado para la zona intermedia de ese espectro: adaptarse a un formato y una audiencia, mantener una voz estable y permanecer dentro de un espacio de trabajo que ya contiene la investigación. No es automáticamente mejor que Claude para un ensayo autónomo. Es más potente cuando el borrador debe seguir utilizando las mismas fuentes, exclusiones y terminología recopiladas anteriormente.
Un encargo de redacción para un solo modelo también debe ser preciso:
«Utilizando únicamente las ocho fuentes que ya están en este proyecto, redacta un texto explicativo de 900 palabras para responsables de producto. No añadas citas nuevas. Mantén un nivel de lectura no técnico. Señala cualquier afirmación que no esté respaldada por las notas adjuntas.»
Si tu tarea de redacción puede especificarse así de claramente, un modelo no es una concesión. Es la arquitectura correcta.
¿En qué se diferencian las arquitecturas de un solo agente y multiagente para los flujos de investigación?
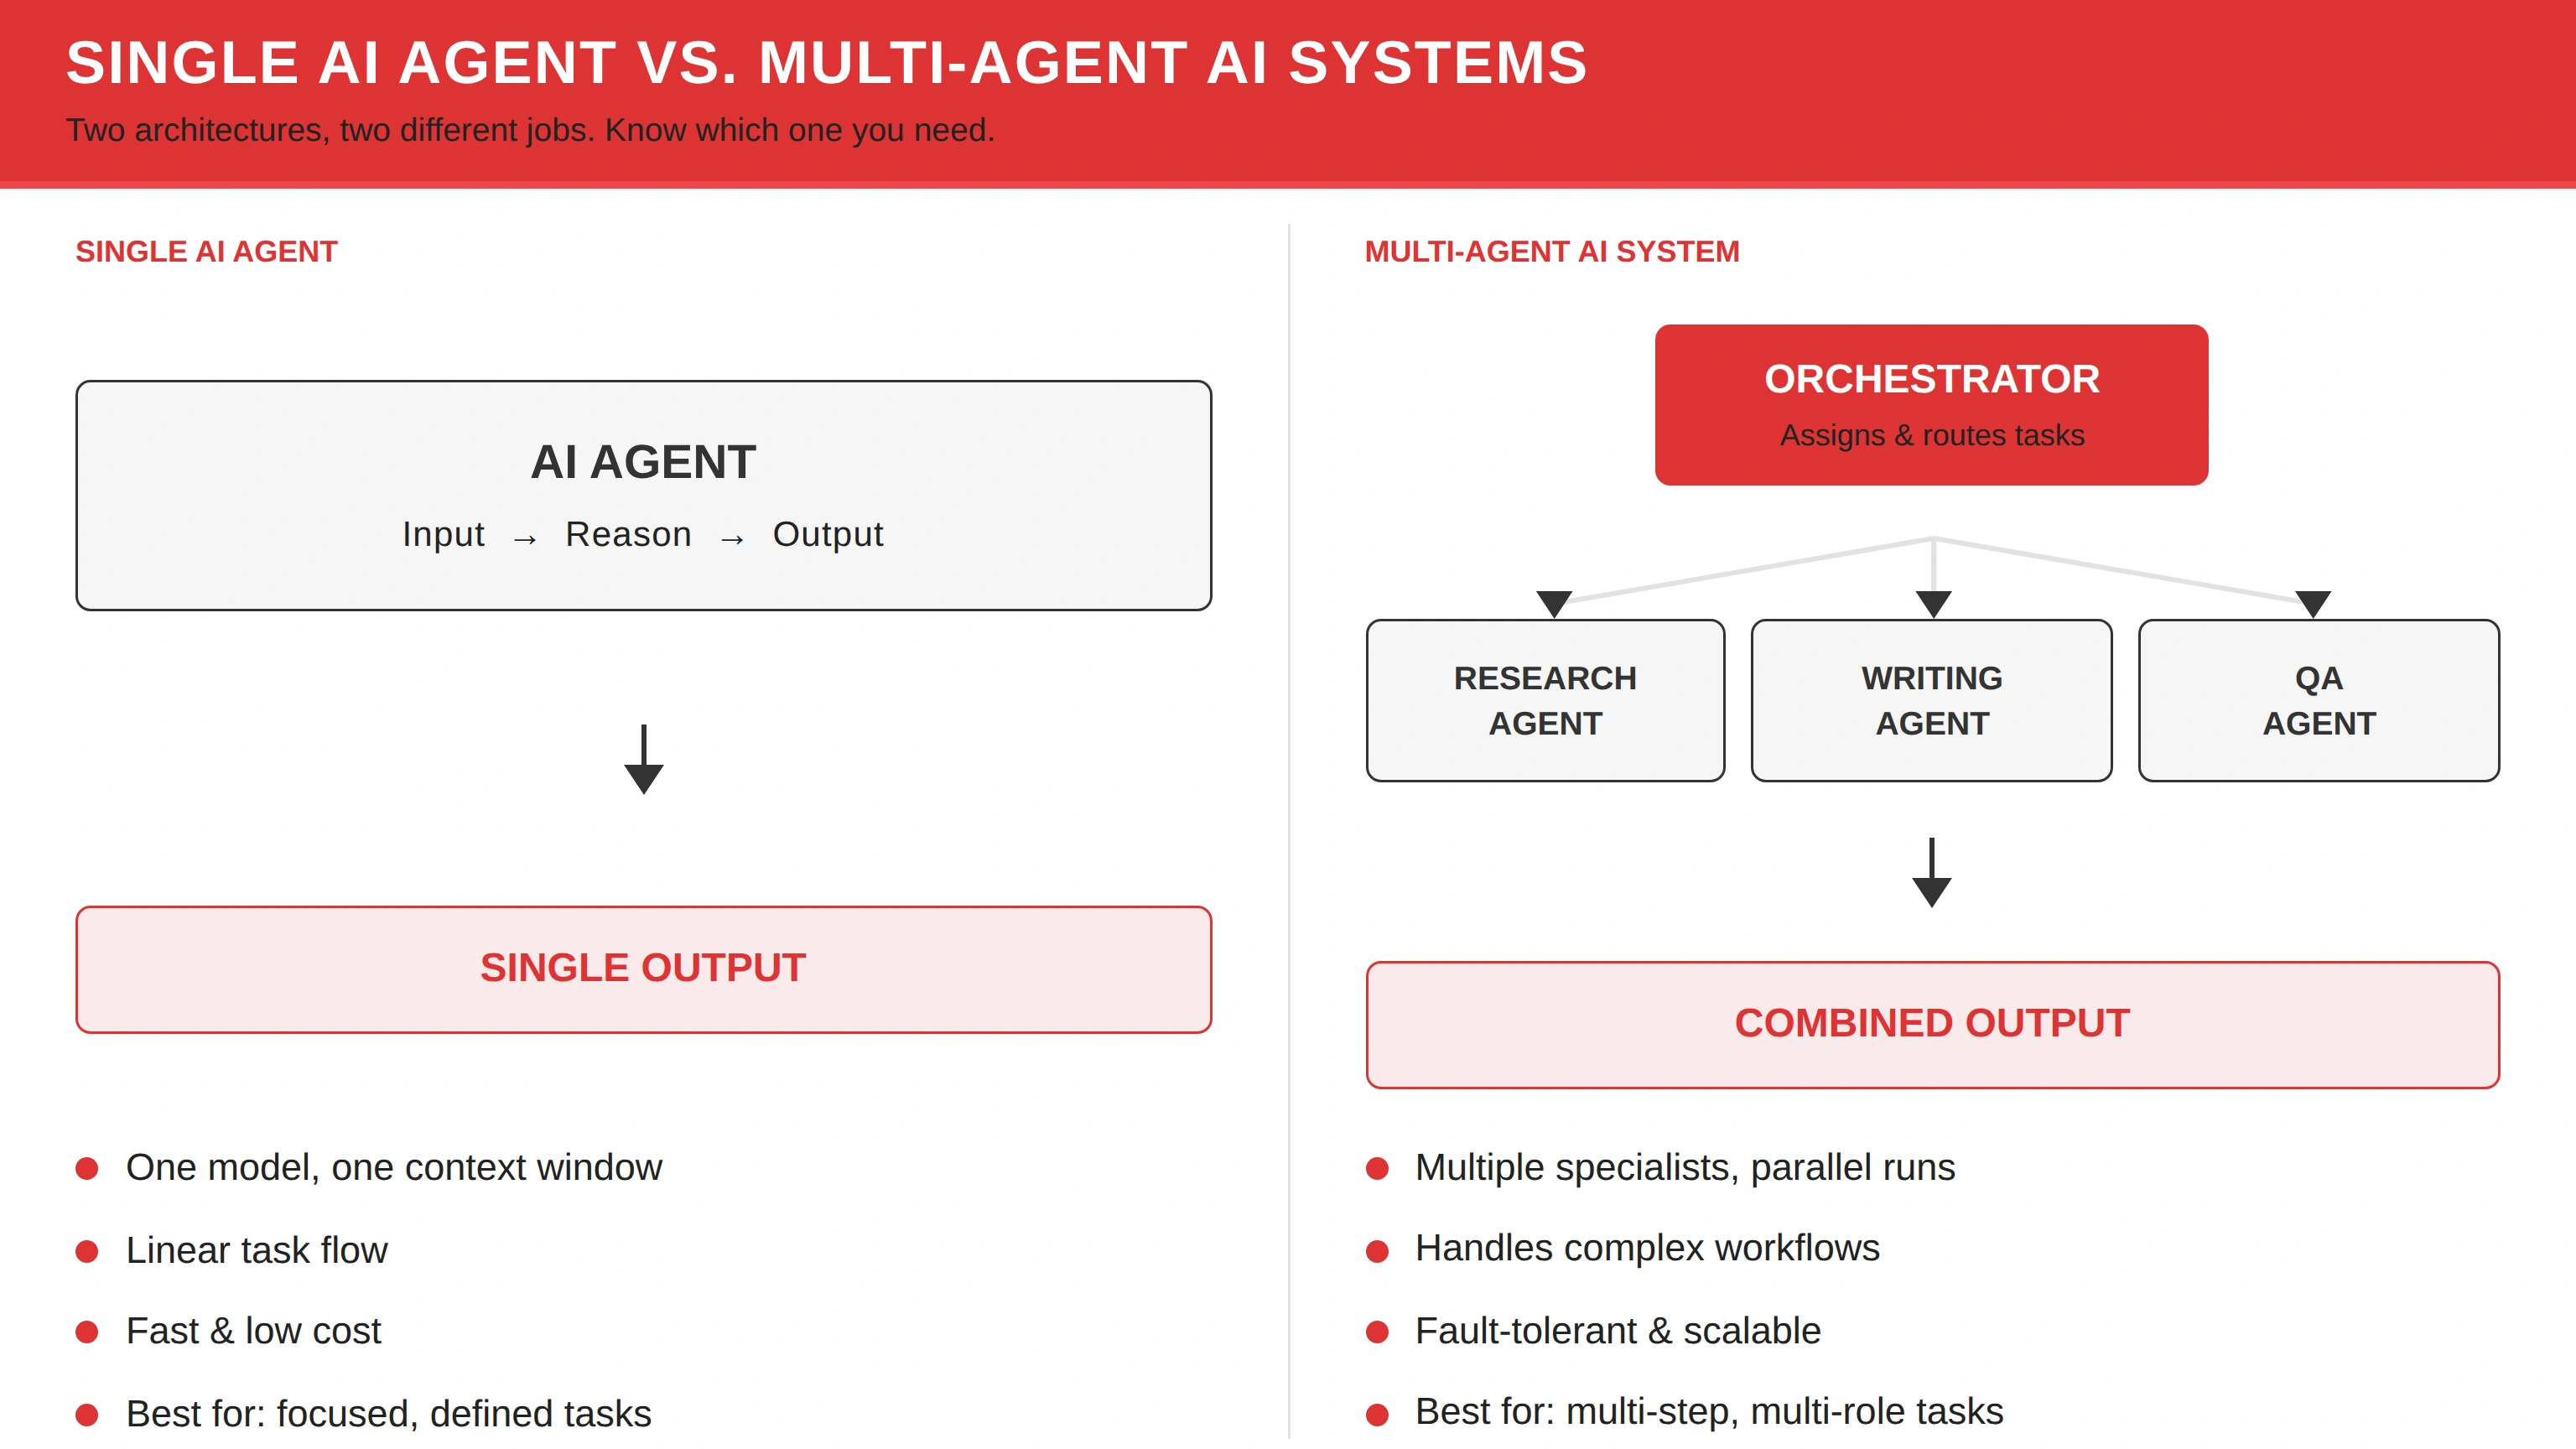
Un sistema de un solo agente utiliza un modelo y una ventana de contexto en un ciclo lineal de entrada-razonamiento-salida, mientras que un sistema multiagente utiliza un orquestador para asignar funciones especializadas como investigación, redacción y QA. El primero es más rápido y económico para tareas definidas. El segundo es más tolerante a fallos en trabajos de varios pasos.
La orquestación de agentes de AI es la capa de control que coordina múltiples agentes autónomos hacia un objetivo compartido, incluidos el estado, los permisos y los puntos de control humanos. Esto es diferente de simplemente tener varios agentes y de la orquestación ordinaria de AI, que solo secuencia modelos y API. Kimi describe el mismo patrón en términos de flujo de trabajo: un Agente investiga, otro planifica y otro redacta.
El contraste arquitectónico se aprecia con mayor claridad en la producción académica. En abril de 2026, Google Research describió PaperVizAgent como un sistema de cinco agentes —recuperador, planificador, estilista, visualizador y crítico— que obtuvo 60,2 frente a una base humana de 50,0 en generación de figuras. Un sistema complementario, ScholarPeer, utiliza múltiples agentes para fundamentar la revisión por pares en literatura en vivo, en lugar de tratar la revisión como una generación de texto de una sola vez. Esos resultados no demuestran que toda pila multiagente sea mejor. Sí muestran por qué la especialización más la crítica puede superar a un único prompt.
Los costes son igual de concretos. Los sistemas multiagente necesitan protocolos explícitos, más infraestructura y límites de gasto. Sin orquestación, los agentes pueden duplicar el trabajo, entrar en conflicto o reintentarlo hasta que el gasto se dispare. Los sistemas de un solo agente tienen el riesgo opuesto: un único fallo termina el trabajo.
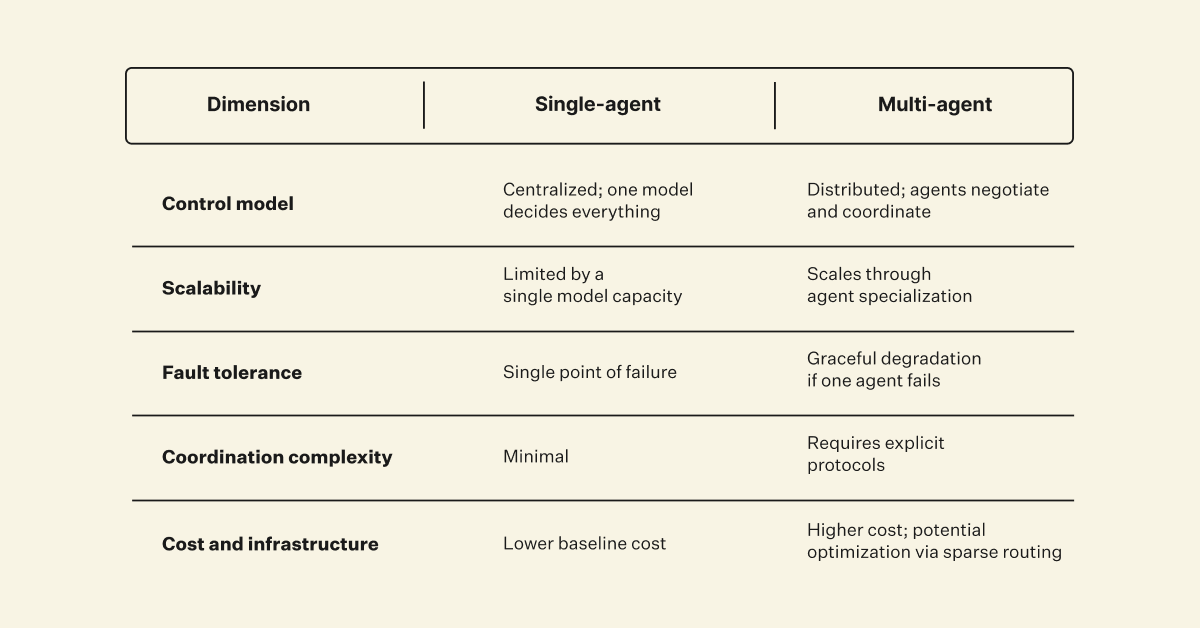
Para investigación y redacción, la regla útil es el número de funciones. Si el trabajo tiene una función, utiliza un Agente. Si el trabajo tiene un investigador, un redactor y un revisor, utiliza un sistema orquestado, o acepta que tú eres el orquestador.
¿Cómo se construye un flujo de trabajo completo de investigación y redacción asistido por AI?
Construyes un flujo de trabajo completo de investigación y redacción asistido por AI separando el descubrimiento, el análisis y la composición, y eligiendo una herramienta de un solo modelo o una plataforma enrutada para cada capa, en lugar de un único chat para todo el proyecto.
Una secuencia duradera se parece a esta:
- Define la decisión. Escribe la pregunta que debe responder el documento final, además de lo que la refutaría.
- Recopila fuentes con una herramienta centrada en recuperación. Utiliza Elicit o Consensus para revisión a nivel de artículo, Perplexity para informes a escala web o el Academic Research Assistant de Jenova cuando el mismo espacio de trabajo deba conservar las citas.
- Analiza con un segundo modelo. Extrae métodos, desacuerdos y nivel de confianza, no solo resúmenes.
- Redacta con un especialista en escritura. Utiliza Claude para un manuscrito autónomo o el Writing Assistant de Jenova cuando el borrador deba seguir vinculado a la memoria del proyecto.
- Realiza una pasada de QA adversarial. Pide a un modelo diferente que cuestione las citas, la cronología y las afirmaciones excesivas.
- Cierra el documento. Exporta solo después de eliminar o rebajar las afirmaciones sin respaldo.
En Jenova, esa secuencia puede mantenerse en una sola cuenta. Un usuario puede empezar con el Academic Research Assistant, cambiar de modelo para la fase analítica y continuar con el Writing Assistant o con el SEO Blog Generator si la salida es un artículo público. La memoria persistente y los archivos adjuntos reducen la pérdida habitual de restricciones entre herramientas.
Un buen prompt de transferencia entre investigación y redacción deja claro lo que no debe cambiar:
«Aquí está el paquete de fuentes y las afirmaciones que ya rechazamos. Redacta la sección de análisis para una audiencia de responsables de políticas. Cada párrafo necesita una fuente que se mantenga vigente. Si una afirmación es una inferencia, etiquétala como inferencia. No recuperes las afirmaciones rechazadas.»
En una herramienta de un solo modelo, el mismo flujo de trabajo sigue siendo posible. Simplemente te conviertes en el enrutador: nuevos chats, notas pegadas y un modelo de QA manual. Puede ser el diseño adecuado para trabajos ocasionales. Se vuelve frágil cuando el proyecto dura semanas o incluye varios tipos de documentos.
Jenova no es la forma más sencilla de elaborar un resumen puntual. Su ventaja es que el flujo de trabajo anterior no requiere tres suscripciones y un sistema personal de anotaciones para mantener las piezas alineadas.
¿Qué dicen los equipos de infraestructura de AI sobre las pilas de un solo modelo frente a las multimodelo?
Los equipos de infraestructura de AI generalmente consideran que las herramientas de un solo modelo son la opción predeterminada correcta para el trabajo lineal, y que las plataformas multimodelo son la opción predeterminada correcta cuando un flujo de trabajo tiene funciones especializadas, restricciones de coste o un paso de revisión independiente.
«El error de investigación más caro que vemos no es elegir el modelo avanzado equivocado. Es usar un modelo como investigador, analista y editor, y luego confiar en la fluidez del párrafo final. Cuando el mismo sistema inventa una fuente y después redacta la frase que depende de ella, no existe una alarma interna. Un segundo modelo no garantiza la verdad, pero sí crea una oportunidad para discrepar.»
«El enrutamiento merece la complejidad solo cuando puedes nombrar los trabajos. “Investiga esto y redáctalo” sigue siendo un solo trabajo. “Recopila artículos candidatos, extrae métodos, reconcilia conflictos, redacta y luego cuestiona las citas” son cinco trabajos. Los equipos que se saltan esa descomposición compran un diagrama multiagente y aun así ejecutan un único prompt.»
«Los argumentos de coste son reales, pero funcionan en ambos sentidos. El trabajo publicado de Amazon sobre enrutamiento muestra que enviar cada solicitud al modelo más potente desperdicia dinero, y los informes de proveedores que hablan de ahorros del 30% al 60% son plausibles cuando se separan la clasificación y la redacción. El fallo contrario también es habitual: un orquestador, un clasificador y tres especialistas gastan más de lo que habría gastado un único modelo cuidadoso en un memorando breve.»
— Equipo de Producto de Jenova, arquitectura de flujos de trabajo de AI, 8 años desarrollando sistemas de agentes multimodelo
Esta visión coincide con la literatura pública de ingeniería. AWS trata el enrutamiento multi-LLM como una respuesta a tipos de tareas mixtas, no como una mejora universal. GitHub considera necesaria la orquestación cuando proliferan los agentes, no antes. El consenso de los expertos es condicional: añade modelos cuando el trabajo tiene puntos de separación. No añadas modelos para adornar una tarea sencilla.
¿Cuándo deberías seguir utilizando una herramienta de investigación de un solo modelo?
Deberías seguir utilizando una herramienta de investigación de un solo modelo cuando la pregunta está delimitada, las fuentes ya están disponibles, el plazo es corto y no necesitas un segundo sistema para auditar el primero. En esas condiciones, el enrutamiento multimodelo añade costes de coordinación sin aportar mucha más verdad.
Mantente con ChatGPT o Claude cuando estés:
- Explicando un concepto conocido en lugar de trazar una bibliografía.
- Reescribiendo un documento en el que ya confías.
- Explorando el tono, la estructura o el orden de los argumentos.
- Trabajando en una única sesión sin transferencia a otro miembro del equipo.
Mantente con Perplexity o Elicit cuando estés:
- Formulando una pregunta concreta que necesita citas.
- Revisando resúmenes antes de una lectura más profunda.
- Realizando una revisión bibliográfica que se redactará en otro lugar.
Pasa a una plataforma de enrutamiento de tareas multimodelo cuando se cumplan dos o más de estas condiciones:
- El proyecto combina búsqueda, análisis y redacción final.
- La salida debe conservar una trazabilidad de fuentes entre borradores.
- Necesitas modelos diferentes para extracción, razonamiento y prosa.
- El trabajo se repite con la frecuencia suficiente para que importe un flujo reutilizable.
- Una cita errónea tendría un coste elevado.
Jenova encaja en esa segunda lista. Es más débil como sustituto del flujo de extracción de artículos de Elicit y más débil que Claude como redactor discreto de contexto extenso. Es más potente cuando esos trabajos deben realizarse juntos, con memoria, elección de modelo y agentes especializados en un mismo lugar.
Por tanto, la decisión no es «un solo modelo frente a multimodelo» como una prueba de lealtad. Es si tu flujo de trabajo todavía se parece a una conversación o ya se parece a una línea de producción. Las conversaciones pertenecen a un modelo. Las líneas de producción pertenecen a un enrutador.
Referencias
- Blog de AWS Machine Learning — Estrategias de enrutamiento multi-LLM para aplicaciones de AI generativa en AWS
- Biblioteca de The Chicago School — Herramientas y recursos de inteligencia artificial: ventajas y limitaciones
- Biblioteca de la University of the District of Columbia — Usos y limitaciones de la AI generativa
- PapersFlow — La mejor AI para investigadores en 2026: 10 herramientas comparadas por categoría
- Thesify — Las mejores herramientas de AI para investigación académica en 2026
- HatchWorks AI — Casos de uso de modelos de lenguaje grandes: un LLM frente a múltiples modelos
- TrueFoundry — Enrutamiento multimodelo: optimiza las tareas de AI de forma eficiente
- Synthesia — Las 12 mejores herramientas de AI para 2026
- AnswerThis — Las 10 mejores herramientas de AI para investigadores en 2026
- Zerve — Herramientas de AI para investigación en 2026: revisión bibliográfica y análisis
- Multi — Una tarea, el flujo de trabajo de AI adecuado
- ConvergePanel — La mejor herramienta de AI multimodelo para investigación
- Argumentree.AI — Investigación de AI multimodelo frente a un solo modelo
- MindStudio — Cómo reducir los costes un 60% asignando las tareas al modelo adecuado
- Recursos de GitHub — ¿Qué es la orquestación de agentes de AI?
- Kimi AI — Orquestación de agentes de AI: tipos, pasos y ventajas
- Google Research — Presentación de dos agentes de AI para mejores figuras y revisión por pares