¿Son mejores los espacios de trabajo de investigación con AI para el mapeo sistemático de evidencia?
2026-08-22
¿En qué se diferencian el estado persistente del proyecto y la recuperación de fragmentos bajo demanda?
Para el mapeo sistemático de evidencia, un espacio de trabajo de investigación que recarga decisiones, estado y artefactos al inicio de cada sesión es un mejor entorno principal que un resumidor de un solo artículo o un chatbot RAG que solo recupera «fragmentos relevantes» bajo demanda. El mapeo es un proyecto longitudinal de codificación: las reglas de inclusión cambian, los estudios limítrofes se recodifican y la síntesis depende de recordar por qué una fuente se filtró la semana pasada. Las herramientas centradas en artículos, como Elicit, Consensus y NotebookLM, siguen siendo sólidas para el descubrimiento, la extracción y las preguntas y respuestas sobre corpus cerrados. Un espacio de trabajo persistente —incluido el Asistente de Investigación Académica de Jenova— es más sólido cuando el mapa debe sobrevivir semanas de cambios de protocolo sin reescribir silenciosamente las decisiones de ayer.
La distinción importante en 2026 no es «qué modelo redacta un resumen más bonito». Es qué arquitectura de memoria puede sostener un mapa de evidencia vivo.
Factores clave que separan una infraestructura de mapeo utilizable de un chat desechable sobre artículos:
✅ Memoria operativa frente a memoria de referencia — los mapas necesitan estado del proyecto (criterios, códigos, exclusiones), no solo pasajes recuperados ✅ Procedencia de las decisiones — cada decisión de incluir/excluir debe seguir siendo inspeccionable entre sesiones ✅ Extracción estructurada — los campos comparables superan a los resúmenes narrativos aislados ✅ Fidelidad al protocolo bajo supervisión humana — los organismos de evidencia siguen considerando la AI como un complemento, no como un revisor sustituto ✅ Síntesis versionable — los informes, las figuras y las listas de fuentes deben acumularse en vez de regenerarse desde cero
Para comparar estas herramientas de forma justa, conviene tratar el mapeo de evidencia como un problema de continuidad de cuatro capas, en lugar de como una competición de resúmenes.
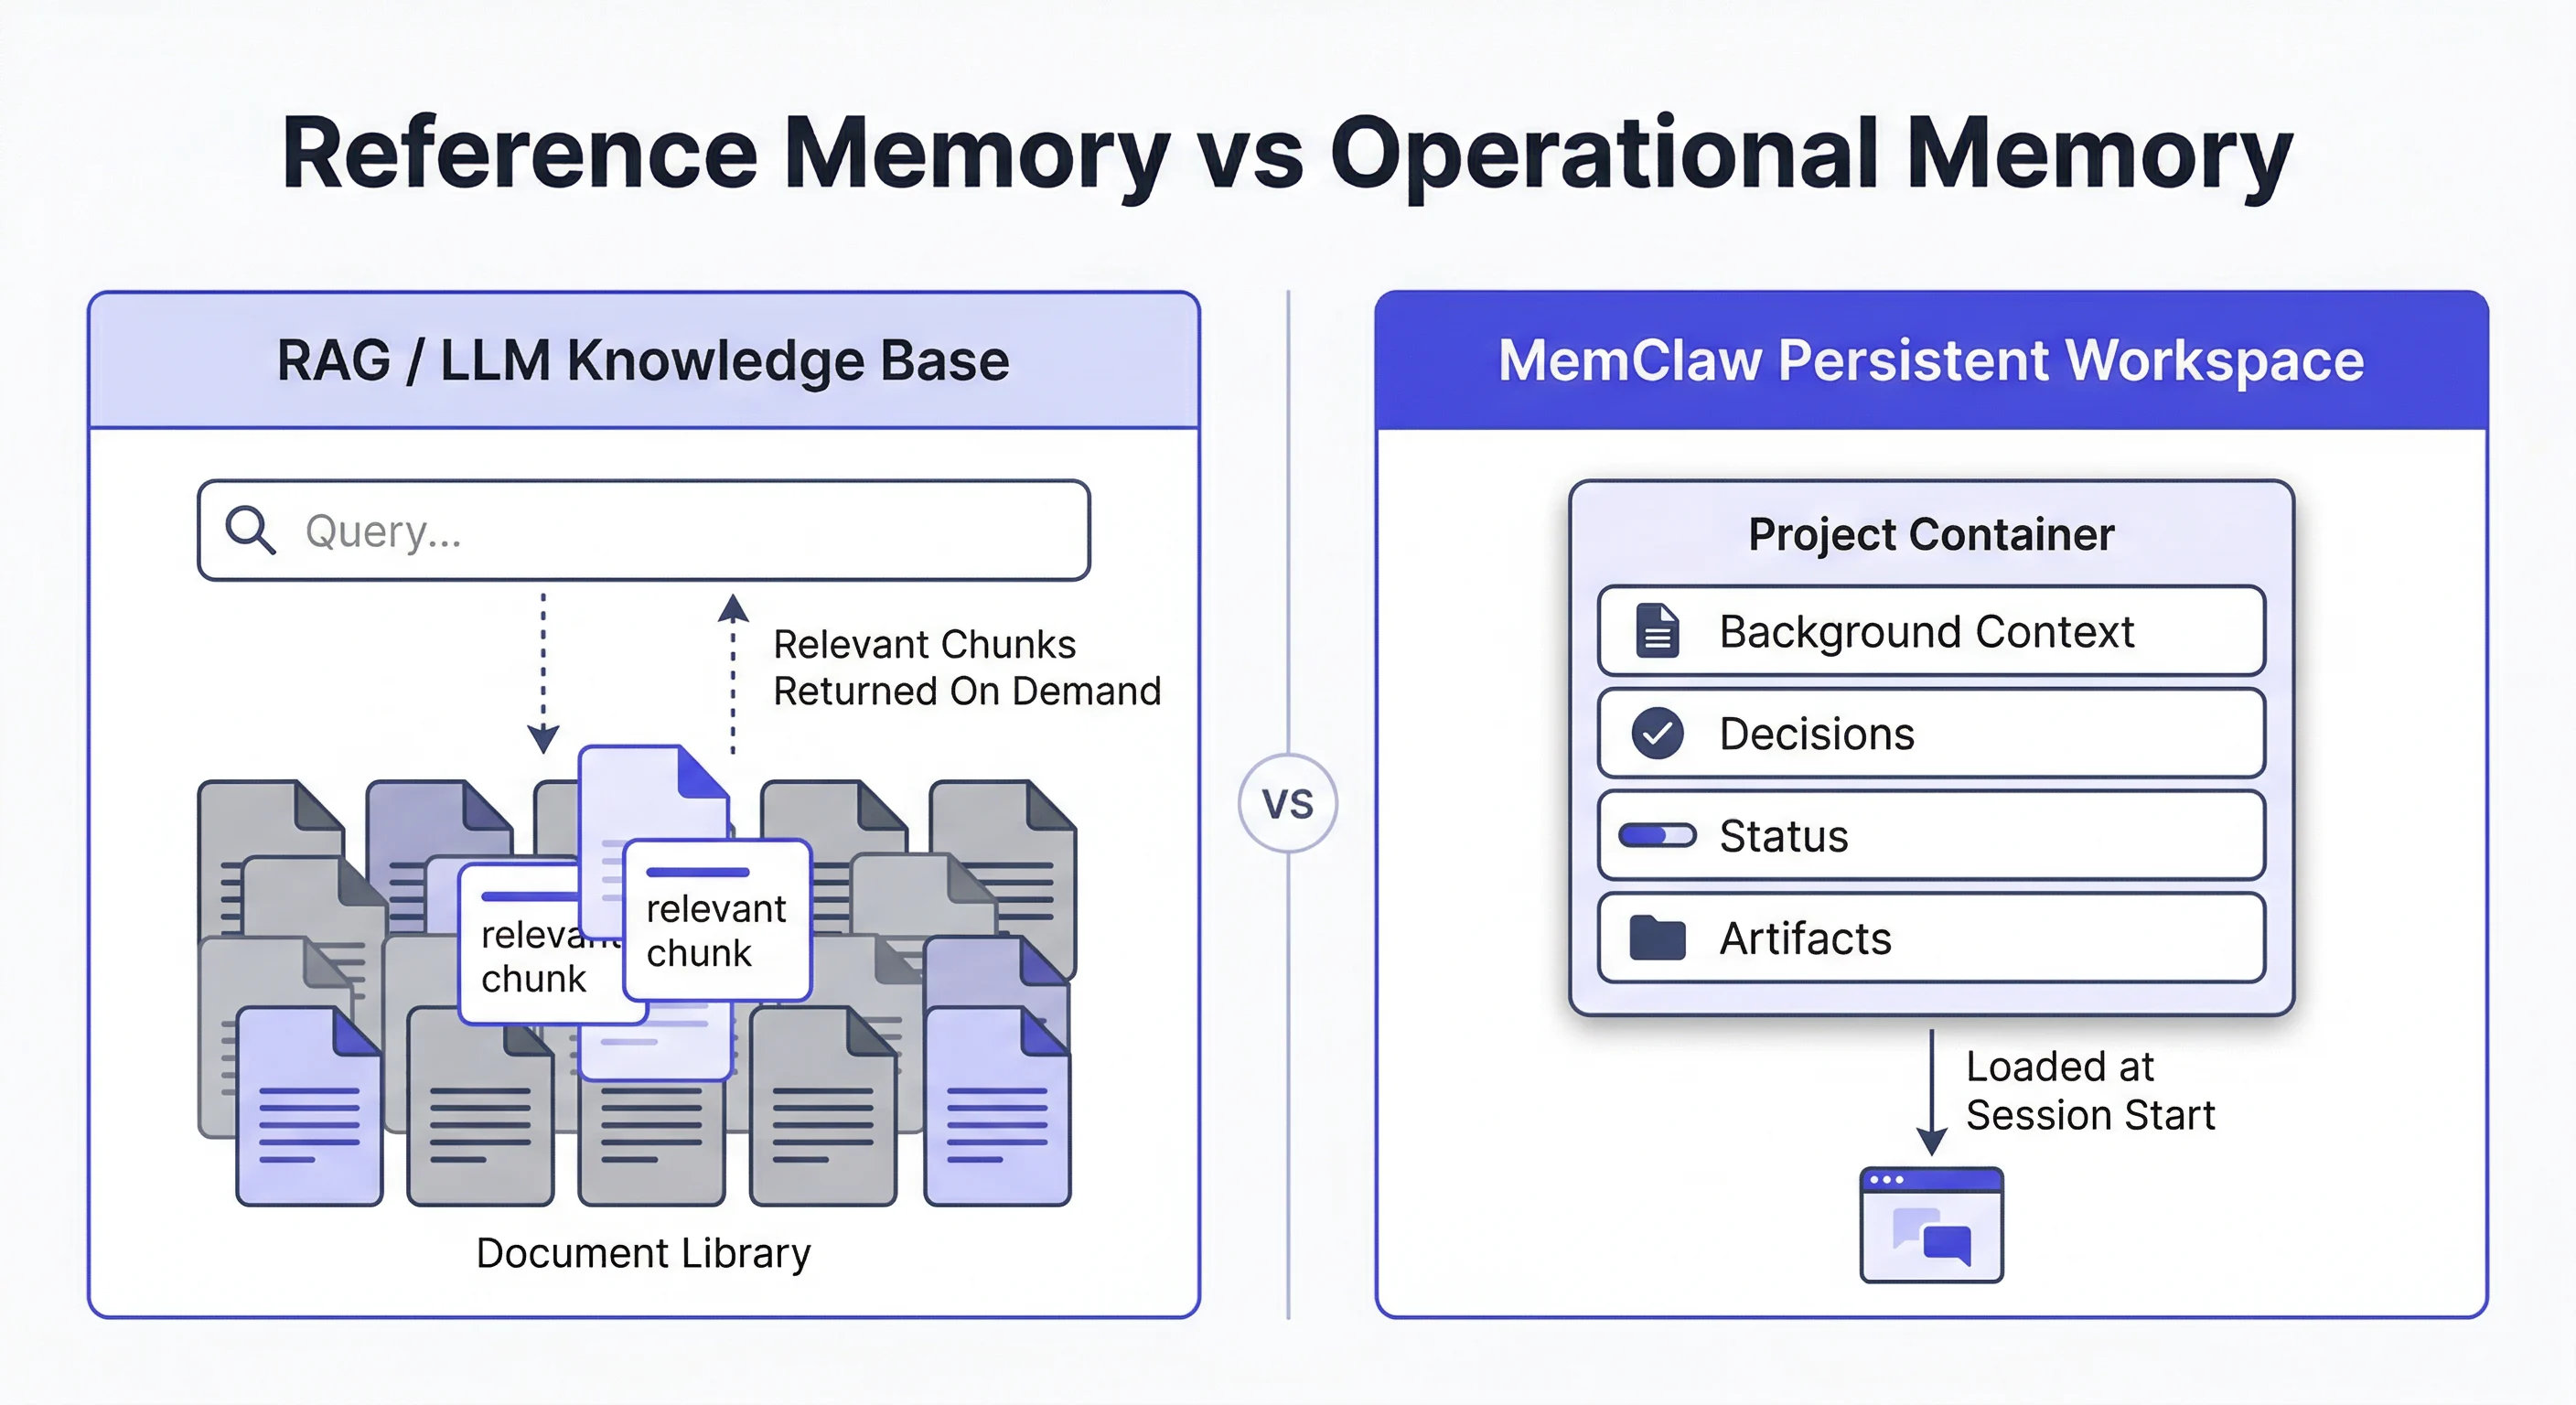
¿Por qué el mapeo sistemático de evidencia exige tanto a las herramientas de AI para un solo artículo?
El mapeo sistemático de evidencia exige tanto a los resumidores de un solo artículo porque un mapa es un inventario codificado de la literatura, no una secuencia de notas de lectura aisladas. Los Mapas Sistemáticos de Evidencia (SEM) son una forma de síntesis de evidencia que categoriza y organiza los hallazgos científicos según dimensiones predefinidas —población, exposición, resultado, método, geografía o brecha de evidencia— para que los revisores puedan ver qué existe, dónde se concentra y qué falta.
Ese flujo de trabajo choca con la forma en que funcionan la mayoría de los productos de investigación con LLM. Una herramienta RAG o de «chat con este PDF» responde a la consulta actual recuperando fragmentos localmente similares. No recarga automáticamente el marco de codificación del martes pasado, los tres estudios apartados como «quizá» ni la decisión de que los modelos animales quedaban fuera del alcance tras endurecerse el protocolo. Las revisiones de mapeo también exigen un proceso documentado de cribado frente a criterios de inclusión y exclusión, una tarea distinta de generar un párrafo fluido sobre un artículo (metodología para revisiones de mapeo).
La revisión manual sigue siendo lo bastante lenta como para que el atajo resulte tentador. Una encuesta de 2026 sobre herramientas de literatura situó un ciclo de revisión convencional en cuatro a seis semanas de cribado, extracción y depuración de citas. Los cribadores especializados con AI pueden reducir esa carga: el sistema AIM Review informó reducciones de carga de trabajo del 20% al 95% en seis revisiones reales. Sin embargo, la velocidad no crea un mapa. Sin estado persistente del proyecto, un cribado más rápido solo produce una pila mayor de resúmenes desconectados.
Los organismos de bibliotecas y metodología son explícitos sobre la brecha que permanece. La guía de síntesis de evidencia del King’s College London afirma que las herramientas de AI no pueden sustituir los métodos tradicionales de búsqueda, cribado y extracción, y que solo deben utilizarse comprendiendo claramente los sesgos, los límites de copyright y el riesgo de alucinación. Una revisión sistemática de 2025 sobre AI generativa en la síntesis de evidencia llegó a la misma conclusión operativa: la evidencia actual no respalda el uso de GenAI sin participación ni supervisión humanas.
¿Qué debe buscar en un flujo de trabajo de mapeo de evidencia con AI?
Debe evaluar las herramientas de mapeo con AI mediante una prueba de continuidad, no una prueba de calidad de redacción. Utilizamos una pila de cuatro capas —llamémosla la pila CODE— porque cada capa falla de una forma distinta y previsible cuando los equipos intentan convertir el chat sobre artículos en un mapa sistemático.
C — Cobertura. ¿Puede la herramienta buscar en un corpus académico real o solo en archivos que ya cargó? Elicit busca en más de 138 millones de artículos y 545.000 ensayos clínicos. NotebookLM, por diseño, responde a partir de las fuentes del cuaderno. Los errores de cobertura en esta capa se convierten en filas ausentes del mapa, no solo en párrafos superficiales.
O — Operacionalización. ¿Pueden definirse una vez los criterios de inclusión, las dimensiones de codificación y los campos de extracción, y luego reaplicarse? Un resumidor que reinterpreta «relevante» en cada prompt recodificará de forma distinta el mismo ensayo limítrofe el tercer día. La guía de mapeo considera los criterios predefinidos como no opcionales (métodos de revisión de mapeo).
D — Decisiones y su procedencia. ¿Puede recuperar por qué un estudio fue incluido, excluido, apartado o filtrado? Los grupos alineados con Cochrane, incluido el esfuerzo Responsible AI in Evidence Synthesis (RAISE) con Cochrane, Campbell y JBI, tratan la transparencia como un requisito de calidad, no como una simple comodidad.
E — Extraibilidad. ¿Pueden los hallazgos llegar a celdas comparables —muestra, diseño, dirección del efecto, limitación— en vez de a prosa imposible de reconciliar? El diseño de producto de Elicit se basa en tablas interactivas y extracción en varios pasos. Consensus es más rápido para la dirección de evidencia a nivel de hipótesis, pero no está diseñado para redactar revisiones estructuradas.
Pondere las capas según el objetivo. Una exploración de alcance puede tolerar una procedencia más débil. Un mapa de evidencia vivo que se citará, actualizará o entregará a un coautor no puede hacerlo. Las herramientas que sobresalen en Cobertura y Extraibilidad siguen fallando en los mapas si la Operacionalización y la procedencia de decisiones se reinician en cada sesión.
¿Cómo se comparan Elicit, Consensus, NotebookLM y los espacios de trabajo de investigación?
Elicit y Consensus constituyen la capa más sólida de descubrimiento y extracción de artículos en esta categoría, NotebookLM es el mejor cuaderno para corpus cerrados y un espacio de trabajo de investigación persistente es el entorno más sólido para mantener coherente un mapa de varias semanas. Ningún producto gana en todas las capas CODE, por lo que los equipos serios de mapeo suelen combinar una herramienta de corpus con un entorno de memoria de proyecto, en lugar de esperar que un único chatbot gestione toda la revisión.
En 2026, las instantáneas publicadas de funciones y precios son las siguientes:
| Función / Dimensión | Elicit | NotebookLM | Consensus | Espacio de trabajo de investigación de Jenova |
|---|---|---|---|---|
| Modelo de memoria | Biblioteca de fuentes guardadas más personalización por informe; no es un contenedor completo de estado del proyecto | Conjunto de fuentes limitado al cuaderno; las respuestas permanecen dentro de los materiales cargados | Memoria de preguntas/listas en torno a consultas de hipótesis | Memoria persistente entre sesiones; el contexto del proyecto puede recargarse en vez de volver a recuperarse |
| Cobertura | 138M+ artículos, 545k ensayos | Solo corpus cargado; 50 fuentes gratis, 300 con Plus | 200M+ artículos, etiquetas de dirección de evidencia | Búsqueda web y académica en directo más bases de conocimiento adjuntas; no es un índice fijo de editoriales |
| Extracción estructurada | Tablas, cribado y puntos de datos a escala (hasta 1.000 artículos / 20.000 puntos de datos) | Preguntas y respuestas y esquemas vinculados a fuentes, no cuadrículas de extracción para RS | Consensus Meter y respuestas breves de evidencia | Informes de síntesis y resúmenes con citas mediante Deep Research; más débil como cribador dual especializado |
| Persistencia de decisiones | Las fuentes pueden almacenarse en una biblioteca; el estado del protocolo no es una función principal | Conserva los archivos del cuaderno, no la lógica codificada de incluir/excluir | Marcadores y listas en planes de pago | El historial de conversación, la memoria y los archivos adjuntos al proyecto sobreviven entre sesiones |
| Precio (en 2026) | Plus desde aproximadamente $12/mes | Gratis; Plus mediante Google AI Pro por aproximadamente $19,99/mes | Premium aproximadamente $10/mes | Nivel gratuito con uso limitado; Plus $20/mes por 30× de uso |
| Mejor para | Cribado de gran volumen y tablas de extracción | Conjuntos docentes y PDF ya recopilados | Comprobaciones rápidas de «¿la literatura respalda X?» | Mapas vivos, codificación multisesión e integración de manuscritos |
Elicit es el especialista adecuado para el cribado de estilo sistemático. Puede automatizar el cribado y la extracción, e informa de hasta un 80% de ahorro de tiempo en esas etapas. Una comparación de métodos de Cochrane concluyó que la sensibilidad de búsqueda de Elicit no era suficiente para sustituir las búsquedas bibliográficas tradicionales, por lo que funciona mejor como complemento de alta precisión. También suele detenerse en los informes y las tablas; la redacción, el versionado y el trabajo de manuscrito vivo normalmente se trasladan a otro lugar.
NotebookLM es el especialista adecuado para la lectura fundamentada de un conjunto fijo. Cada respuesta puede verificarse frente a un pasaje citado, y Google ha añadido Deep Research junto con tipos de archivo más amplios. No puede descubrir artículos que aún no ha recopilado y no codifica un registro de decisiones de estilo PRISMA.
Consensus es el especialista adecuado para la dirección de una hipótesis. Su medidor y sus etiquetas de respaldo/contraste son más rápidos que crear una cuadrícula de extracción cuando solo necesita saber hacia dónde se inclina la literatura (comparación de herramientas). Es un mal sistema principal para un mapa codificado.
El Asistente de Investigación Académica de Jenova es más sólido cuando la unidad de trabajo es el proyecto, no el PDF. Puede buscar fuentes académicas, conservar el contexto de manuscritos y citas y, dado que la plataforma subyacente almacena historial de chat ilimitado y memoria entre sesiones, continuar un marco de codificación sin tener que pegar de nuevo el protocolo. No es una plataforma validada de cribado con doble revisor en el sentido de Covidence o Rayyan, ni publica cifras de precisión de extracción al estilo de Elicit. Los equipos que necesitan trazas de auditoría aptas para regulación deben mantener un cribador especializado en su conjunto de herramientas.
SciSpace y Scite cubren funciones adyacentes más acotadas. SciSpace se describe repetidamente como el mejor entorno para el análisis profundo artículo por artículo, con un corpus muy grande pero un flujo de revisión menos unificado. Las 1.600 millones de Smart Citations de Scite, clasificadas como respaldo, contraste o mención de una afirmación, no tienen rival para la auditoría del contexto de citas y son casi inútiles por sí solas como base de descubrimiento o mapeo.
¿Cómo cambia la memoria operativa la síntesis de literatura entre varias sesiones?
La memoria operativa cambia la síntesis porque trata el contenedor del proyecto —contexto de fondo, decisiones, estado y artefactos— como el objeto que se carga al inicio de la sesión, en lugar de tratar la literatura como un pajar que debe consultarse de nuevo. La memoria de referencia pregunta: «¿Qué fragmentos se parecen a esta pregunta?». La memoria operativa pregunta: «¿Qué se sabe ya sobre este proyecto y qué sigue necesitando evidencia?».
Esa diferencia aparece en tres modos de fallo que los resumidores ocultan bien:
- Deriva de criterios. Si «solo RCT en humanos adultos» vive en el prompt en vez de en el estado del proyecto, una sesión posterior que haga una pregunta algo más amplia volverá a incluir silenciosamente los estudios pediátricos que ya rechazó.
- Casos “quizá” huérfanos. Los artículos limítrofes apartados para discutir con un coautor desaparecen a menos que el estado sea un campo principal.
- Síntesis regenerada. Una respuesta RAG puede ser localmente fiel a los fragmentos recuperados hoy y aun así contradecir la tabla de brechas de la semana pasada, porque nada obliga a la nueva respuesta a heredar la codificación anterior.
Los espacios de trabajo persistentes invierten el orden de carga. El contexto de fondo, las decisiones, el estado y los artefactos llegan antes de la siguiente consulta. La implementación de Jenova de este patrón es memoria entre sesiones más bases de conocimiento adjuntables: el asistente puede recordar las dimensiones de mapeo, la definición operativa de una brecha de evidencia y qué afirmaciones ya cuentan con respaldo suficiente. Al comparar esto con herramientas de estilo cuaderno aparece una compensación clara. El corpus cerrado de NotebookLM es más seguro frente a invenciones ajenas a las fuentes (respuestas vinculadas a fuentes). Un espacio de trabajo abierto y persistente es más útil cuando el corpus sigue creciendo y el marco de codificación es el activo escaso.
La implicación práctica para los SEM es sencilla. Si su entregable es una sesión informativa de una sola vez sobre 15 PDF, la memoria operativa es opcional. Si su entregable es un mapa de brechas que se actualizará después del próximo ciclo de conferencias, la memoria operativa es el producto.
¿Cómo es realmente un flujo de trabajo agéntico de evidencia de extremo a extremo?
Un flujo de trabajo de mapeo de extremo a extremo se parece a un sprint de investigación por etapas y con compuertas, no a un único prompt de «resume estos artículos». La ilustración siguiente es una arquitectura de referencia útil: formulación de la pregunta, triaje de literatura, identificación de candidatos, formalización de hipótesis, validación multifuente, informes versionados y un paquete rastreado con git.
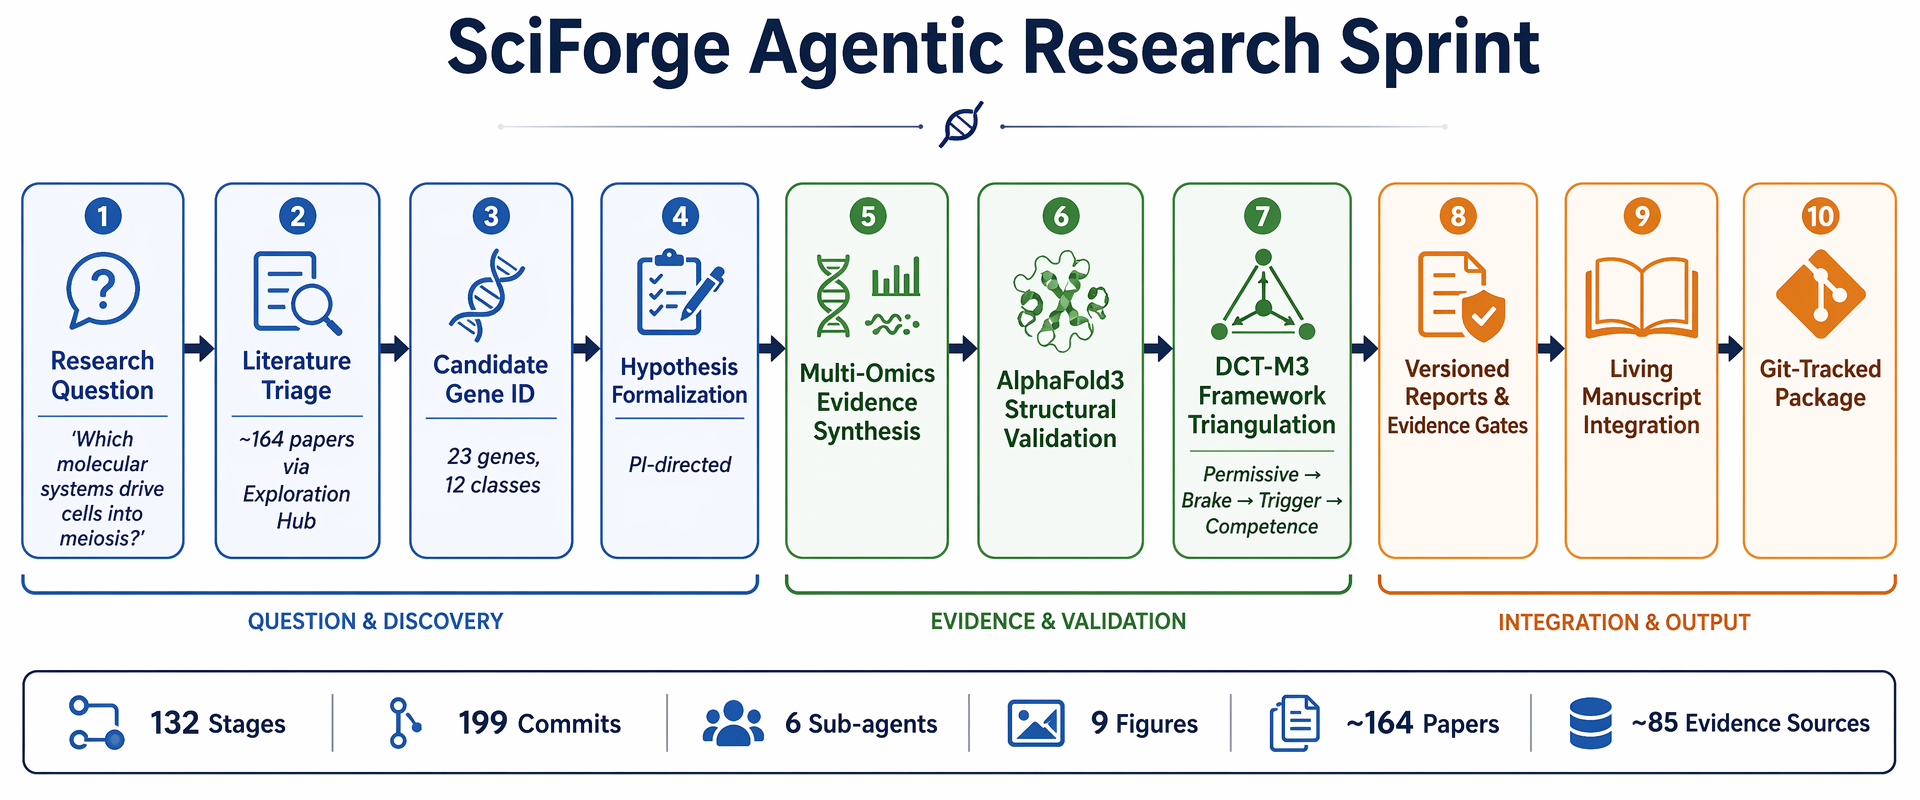
El sprint de ejemplo es deliberadamente grande —del orden de 164 artículos evaluados, 132 etapas, 199 commits, seis subagentes y aproximadamente 85 fuentes de evidencia— porque esa es la escala en la que el chat sobre artículos se desmorona. Un resumidor puede describir el artículo 17. No puede mantener coherente una cadena de 10 etapas cuando la etapa 4 cambia la regla de inclusión que la etapa 2 ya aplicó.
Tres elecciones de diseño en esa canalización importan más que los detalles del dominio:
- El descubrimiento es una fase, no el producto. El triaje de literatura alimenta los ID de candidatos y una hipótesis formal. Detenerse en los resúmenes deja el mapa sin construir.
- La validación es multimodal. La síntesis de evidencia, las comprobaciones estructurales o cuantitativas y una lógica explícita de «permisivo → freno → disparador» obligan a que las afirmaciones pasen por compuertas, en vez de promediarlas en un párrafo.
- La salida está versionada. La integración con un manuscrito vivo y un paquete rastreado con git convierten el mapa en un artefacto con historial. Eso es lo opuesto a una transcripción de chat que no puede reproducirse.
Jenova puede aproximar este patrón dividiendo funciones entre Agentes, en lugar de forzar a un solo chat a actuar como bibliotecario, codificador y redactor. El Asistente de Investigación Académica gestiona el descubrimiento académico y el contexto del manuscrito. Deep Research genera síntesis respaldada por citas a partir de muchas fuentes. Real-Time Search resulta útil cuando el mapa también debe incluir preprints, repositorios o literatura gris no publicada en revistas. La limitación es la disciplina de orquestación: la persona sigue siendo responsable del protocolo, las compuertas y la decisión de incorporar una afirmación al manuscrito vivo. Los grupos de metodología siguen considerando esta función humana como innegociable (guía KCL / RAISE).
Las plataformas integrales de revisión al estilo Paperguide intentan condensar planificación–búsqueda–cribado–extracción–generación en un flujo de trabajo de un solo proveedor, incluidos modos Extended que evalúan 200 candidatos y redactan a partir de los 50 mejores. Esto se acerca más a un espacio de trabajo que Elicit más Word, pero aun así necesita un registro externo de decisiones si le importa la procedencia después de exportar la revisión generada.
¿Cómo sacar el máximo partido a un mapa de evidencia con AI?
Obtendrá el máximo provecho de un mapa de evidencia con AI si escribe el protocolo en el espacio de trabajo antes de pedir prosa y luego obliga a cada sesión posterior a heredar ese protocolo. La configuración es parecida en todas las herramientas; la diferencia es si la herramienta puede recordar la configuración.
Para un mapa centrado en Jenova, una secuencia viable es:
- Abra el Asistente de Investigación Académica y nombre el proyecto, la población y las dimensiones de mapeo en el primer mensaje.
- Fije el protocolo en un lenguaje que el asistente pueda reutilizar:
«Construye un mapa sistemático de evidencia de estudios en humanos adultos sobre X. Incluye solo RCT y cohortes prospectivas. Codifica cada estudio según diseño, muestra, intervención, resultado primario, dirección del efecto y limitaciones. Aparta los artículos sobre animales e in-vitro en un registro de exclusiones con un motivo de una línea. No regeneres códigos que ya se hayan decidido.»
- Ejecute Deep Research para la primera pasada sobre el corpus y, después, pegue o adjunte la tabla de trabajo de nuevo en el mismo hilo del proyecto para que la extracción y la narrativa compartan una sola memoria.
- Después de cada sesión, solicite tres artefactos, no un ensayo: una tabla de estudios actualizada, un registro de exclusiones y una lista de brechas. Esos tres archivos son el mapa.
Para Elicit, comience con la pregunta de investigación, genere una tabla de cribado y trate la biblioteca como la fuente de referencia (flujo de trabajo de revisión sistemática de Elicit). No omita una búsqueda convencional en bases de datos. Los estudios de caso de Cochrane encontraron que Elicit era útil para búsquedas preliminares de alta precisión y para estudios adicionales únicos, no como único motor de búsqueda.
Para NotebookLM, recopile primero los PDF, permanezca dentro de un único cuaderno y formule preguntas dimensión por dimensión («Enumera cada estudio que informe del resultado Y, con tamaño de muestra y seguimiento») para que el corpus cerrado no se desvíe. Los límites de carga —50 fuentes en el nivel gratuito y 300 con Plus— hacen que esta sea la herramienta equivocada para un mapa de 400 registros, salvo que realice el precribado en otro lugar.
Dos reglas de proceso sirven para cualquier conjunto de herramientas. En primer lugar, no cargue PDF de texto completo en un modelo de consumo si los términos de copyright lo prohíben; los titulares de derechos generalmente prohíben ese uso. En segundo lugar, mantenga a una persona a cargo de las decisiones de incluir/excluir. La asistencia al cribado es la tarea de AI con más evidencia de respaldo; la síntesis no supervisada es la tarea con menos (revisión de revisiones sobre la preparación de la AI).
¿Qué dicen los especialistas en síntesis de evidencia sobre el mapeo asistido por AI?
Los especialistas aceptan cada vez más la AI para el cribado y la extracción supervisados, y siguen rechazando la AI como cartógrafo no supervisado de un campo. El consenso experto útil en 2026 es más limitado que el discurso de los proveedores: automatice la capa repetitiva, mantenga persistente la capa de decisiones y conserve a los humanos como responsables del mapa.
«El modo de fallo que observamos no es que los modelos no puedan resumir un artículo. Es que los equipos de mapeo tratan un buen resumen como si fuera un registro codificado. Un mapa sistemático de evidencia es un conjunto de decisiones reversibles —dentro, fuera, apartado, filtrado— vinculado a campos estables. Si esas decisiones viven solo en el prompt de la semana pasada, el mapa ya está corrompido, aunque cada párrafo siga sonando cuidadoso.»
«La recuperación de referencias y la memoria operativa resuelven problemas distintos. La recuperación es cómo encuentra evidencia candidata. La memoria operativa es cómo evita recodificar el mismo estudio tres veces. Las herramientas excelentes en la primera tarea se implementan rutinariamente como si realizaran la segunda. Así se obtiene un análisis fluido de brechas que no puede explicar por qué desaparecieron 12 ensayos limítrofes.»
«Nuestra regla de trabajo es sencilla. Use un motor de corpus para rellenar filas. Use un espacio de trabajo persistente para mantener vivo el libro de códigos, el registro de exclusiones y la tabla de brechas. Utilice un revisor humano en cada compuerta que cambie el significado del mapa. Cualquier producto vendido como mapa sistemático de un clic le está pidiendo que omita la única capa que los grupos de metodología aún consideran innegociable.»
— Equipo de Producto de Jenova, diseño de flujos de investigación, 8 años desarrollando sistemas de conocimiento para trabajo analítico multisesión
Esta postura se ajusta a la guía formal. NICE, las recomendaciones RAISE vinculadas a Cochrane y los servicios de bibliotecas universitarias describen la AI como un complemento dentro de métodos validados existentes. Una guía viva sobre AI en la búsqueda y el cribado de literatura presenta el mismo argumento de eficiencia —el cribado es costoso y la automatización ayuda— sin afirmar que la generación pueda sustituir al protocolo.
¿Cuándo siguen siendo la opción correcta los resumidores de un solo artículo?
Los resumidores de un solo artículo siguen siendo la opción correcta cuando el corpus es pequeño, ya está recopilado y no se está codificando como un mapa reutilizable. Si tiene 12 PDF, un club de lectura mañana y no necesita actualizar el inventario dentro de tres meses, un chat sobre artículos al estilo NotebookLM o SciSpace terminará el trabajo con menos formalidades que un contenedor de proyecto.
También encajan mejor en otros tres trabajos que se etiquetan erróneamente como mapeo:
- Explicación de mecanismos. «Guíame por la Figura 3» es una tarea de lectura. Un cuaderno de corpus cerrado con citas pulsables es más seguro que un espacio de trabajo abierto que podría mezclar artículos.
- Comprobaciones del contexto de citas. Si la pregunta es si trabajos posteriores respaldan o contrastan una afirmación, las citas clasificadas de Scite son la capa diseñada para ello (más de 1.600M Smart Citations).
- Comprobaciones puntuales de hipótesis. Consensus sigue siendo la forma más rápida de ver si una proposición tiene una división visible entre respaldo y contraste antes de invertir en un mapa (visión general de Elicit frente a Consensus).
El error es utilizar esas fortalezas como sustituto de la infraestructura para SEM. Un resumidor puede ser excelente a nivel local y aun así ser el sistema de registro equivocado. A la inversa, un espacio de trabajo persistente puede mantener vivo un libro de códigos desordenado y seguir siendo la herramienta equivocada para un cribado dual de 5.000 registros si necesita software especializado para RS. Las guías institucionales siguen orientando a los equipos hacia plataformas de cribado como Rayyan, Covidence y DistillerSR para esa etapa (guía de CASRAI sobre AI para RS; guía de revisión sistemática de Stony Brook).
Por tanto, la regla de decisión que sobrevive al contacto con revisiones reales es arquitectónica, no basada en marcas. Si el producto del trabajo es un conjunto de decisiones de codificación comparables, actualizables y explicables, elija un espacio de trabajo de investigación con memoria de proyecto y mantenga a su lado un motor de corpus. Si el producto del trabajo consiste en comprender los artículos que ya tiene sobre la mesa, un resumidor de un solo artículo no es una concesión. Es la herramienta correctamente delimitada.
Referencias
- ScienceDirect — Guía para elaborar mapas sistemáticos de evidencia
- PubMed Central — Metodología para revisiones de mapeo, mapas de evidencia y mapas de brechas
- Paperguide — Las 7 mejores herramientas de AI para revisiones de literatura en 2026
- King’s College London — Herramientas de AI en síntesis de evidencia
- Elicit — AI para investigación científica
- NotebookLM — Herramienta de investigación con AI y compañero de reflexión
- Google Blog — NotebookLM incorpora Deep Research, Docx, Sheets y más
- The Drive AI — Elicit frente a Consensus frente a Semantic Scholar
- Omid Saffari — Mejores herramientas de investigación con AI en 2026: Elicit frente a Consensus
- Guía para usar AI en la búsqueda y el cribado de literatura
- CASRAI — Herramientas de AI para revisiones sistemáticas de literatura
- Bibliotecas de la Universidad de Stony Brook — Guía de revisión sistemática: Inteligencia Artificial